
AIがMREの常識を変える?深層学習U-Net Transformerによる組織硬度測定の高速化と精度向上
解説対象論文: A U-Net Transformer for magnetic resonance elastography
International Journal of Computer Assisted Radiology and Surgery|被引用数: 0(2026年9月21日時点)
磁気共鳴エラストグラフィー(MRE)は、非侵襲的に組織の硬さを定量化することで、肝線維化などの疾患診断に重要な役割を果たす画像技術です。しかし、従来のインバージョン技術は計算コストが高く、ノイズに弱いという課題がありました。本研究では、この課題を解決するため、U-NetとTransformerを組み合わせた新しい深層学習アーキテクチャ「U-Net Transformer (UNT)」を提案し、MRE再構成の高速化と安定化を目指しています。オープンソースのシミュレーションフレームワークを用いて大規模なデータセットを生成し、データ駆動型学習と物理情報学習の双方でUNTの性能を検証。その結果、UNTは既存の最先端機械学習モデルを上回る再構成精度を示しました。本記事では、この画期的なAI技術がMREの臨床応用にもたらす可能性について、詳しく解説します。
はじめに:MREの現状と課題
どうも、Beyond the Pixelです。今回は、組織の硬さを非侵襲的に定量化する重要な医療画像技術である磁気共鳴エラストグラフィー(MRE)の最新研究をご紹介します。MREは肝線維化などの疾患診断に不可欠ですが、従来のインバージョン(変位場から硬度マップを計算する処理)技術、例えば代数的なヘルムホルツインバージョン(AHI)や有限要素法(FEM)は、計算コストが高く、ノイズに弱いという課題を抱えていました。これにより、MREの臨床応用は限定的にならざるを得ないのが現状です。従来のMREでは、局所的な組織の均一性を仮定するため、臓器の境界面でアーティファクトが発生しやすく、計測ノイズにも非常に敏感です。より洗練された反復モデルベースのインバージョン手法(FEMなど)は精度が高いものの、処理に数時間から一日かかることもあり、臨床でのスケーラビリティを妨げていました。このような背景から、MREの再構成を高速化し、安定性を高める高性能な深層学習代替手法が求められています。
新たなアプローチ:U-Net Transformer (UNT) の登場
この研究では、MREの再構成を加速し、安定化させる高パフォーマンスな深層学習手法として、U-Net Transformer (UNT) という新しいアーキテクチャが提案されています。UNTは、畳み込みニューラルネットワーク(CNN)が持つ局所的な帰納的バイアスと、Transformerが持つ広域な文脈認識能力をハイブリッド化することで、MRE再構成の精度向上を目指しています。CNNは画像内の近接するピクセル間の関係を捉えるのが得意ですが、遠く離れたピクセル間の複雑な関係性を捉えるのは苦手です。一方、Transformerはデータ全体の関係性を効率的に学習できますが、局所的な詳細を見逃すことがあります。UNTはこれらの強みを組み合わせることで、両方の特性を同時に捉える頑健なアーキテクチャを実現しました。このモデルは、入力として2次元の変位場を受け取ります。U-Netエンコーダーが段階的なダウンサンプリングと畳み込み処理を通じて、空間パターンと階層的特徴を抽出します。その後、最小解像度の特徴マップがTransformerに渡され、マルチヘッドアテンション層によって空間ドメイン全体で情報交換を行い、広域な特徴の相互作用を強化します。最終的に、U-Netデコーダーが空間次元を復元し、抽出された特徴を洗練させ、硬度マップなどの物理量を再構成します。U-Net Transformerニューラルオペレーターの2次元データ向けモデルアーキテクチャを
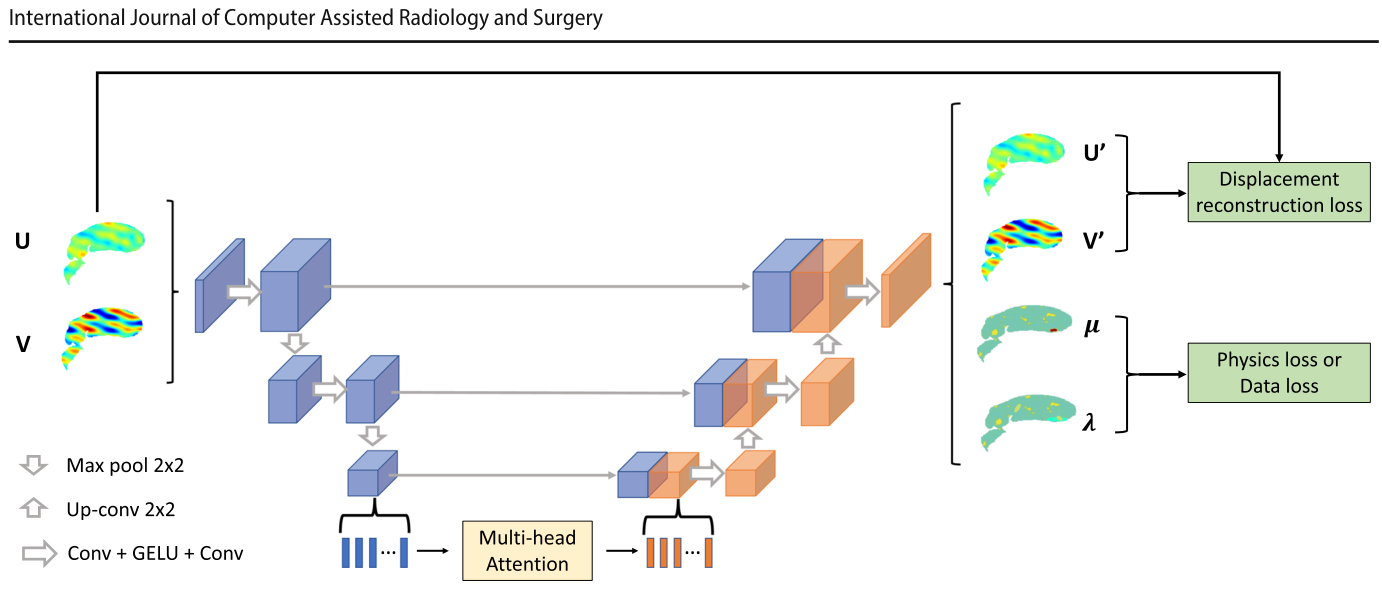
に示します。この研究は、AI駆動型MREインバージョンの標準的な基盤を確立し、放射線診断におけるリアルタイムAI支援型臨床意思決定支援への検証済み経路を提供します。
研究手法:大規模データセットと2つの学習戦略
この研究の重要な貢献の一つは、大規模な合成データセットを生成するためのオープンソースの物理ベースシミュレーションフレームワークの開発です。このフレームワークは、LiTSデータセットからの現実的な肝臓と腫瘍の形状に、臨床情報に基づいた硬度事前分布を組み合わせることで、ベンチマークデータセットを生成します。具体的には、200のCTボリュームと肝臓および腫瘍のバイナリマスクを含むLiTSデータセットから肝臓の形状を抽出し、非アルコール性脂肪性肝疾患(NAFLD)の対象者データから得られた腹部MREデータに基づき、ガウス過程を用いて肝臓の硬度分布をモデル化しました。その結果生成された肝臓の剪断弾性率と変位場の例を
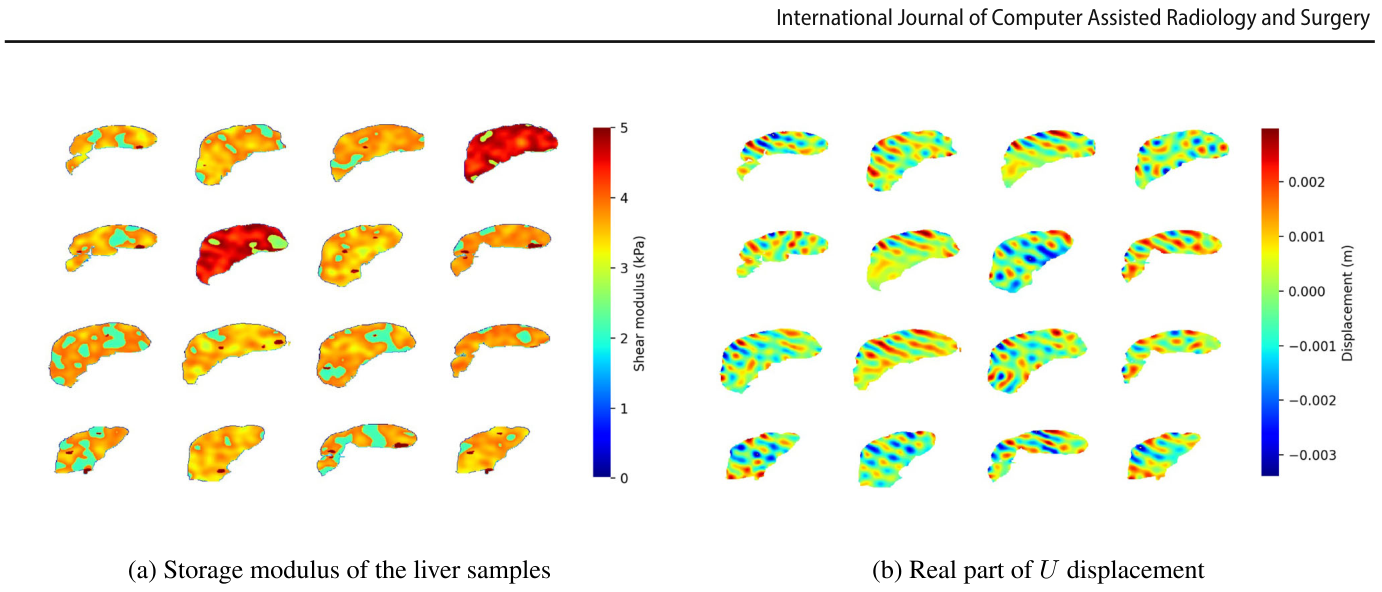
に示します。腫瘍領域には固定された硬度を割り当て、周囲の背景は異なる硬度を設定しています。合計で2次元および3次元の各ケースで300サンプルが生成されました。
モデルトレーニングには、データ駆動型学習と物理情報学習の2つの異なるアプローチが採用されました。データ駆動型学習は、大規模な合成データセットが利用可能な場合に用いられ、教師あり学習として、モデルの予測した硬度マップが実際の硬度マップにどれだけ近いかで学習します。一方、物理情報学習は、実際の対象者のデータのように正解の硬度値が利用できないシナリオに対応するために、MREの基礎となる物理方程式を学習プロセスに組み込みます。このアプローチは、予測される硬度マップと変位場が物理法則を満たすように保証します。
モデルの性能評価では、ノイズの影響も詳細に研究されています。モデルはノイズのないデータと5%のガウスノイズを含むデータでトレーニングされ、現実世界に近い条件を反映しています。ノイズレベルの異なる変位場の可視化を
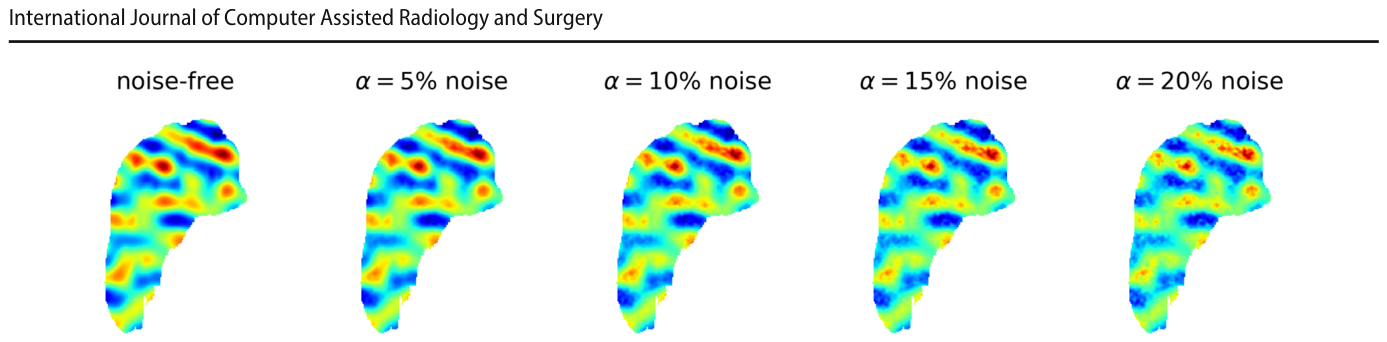
に示します。
実験結果:UNTの優れた性能と学習方法の考察
数値実験の結果、データ駆動型学習は予測精度において物理情報学習を一貫して上回ることが示されました。提案されたUNTアーキテクチャは、既存の最先端機械学習モデルと比較して、顕著に高い再構成精度を示しています。各ベースラインモデルと提案モデルUNTの性能比較(ノイズフリーおよび5%ノイズ条件下での相対L2誤差)を
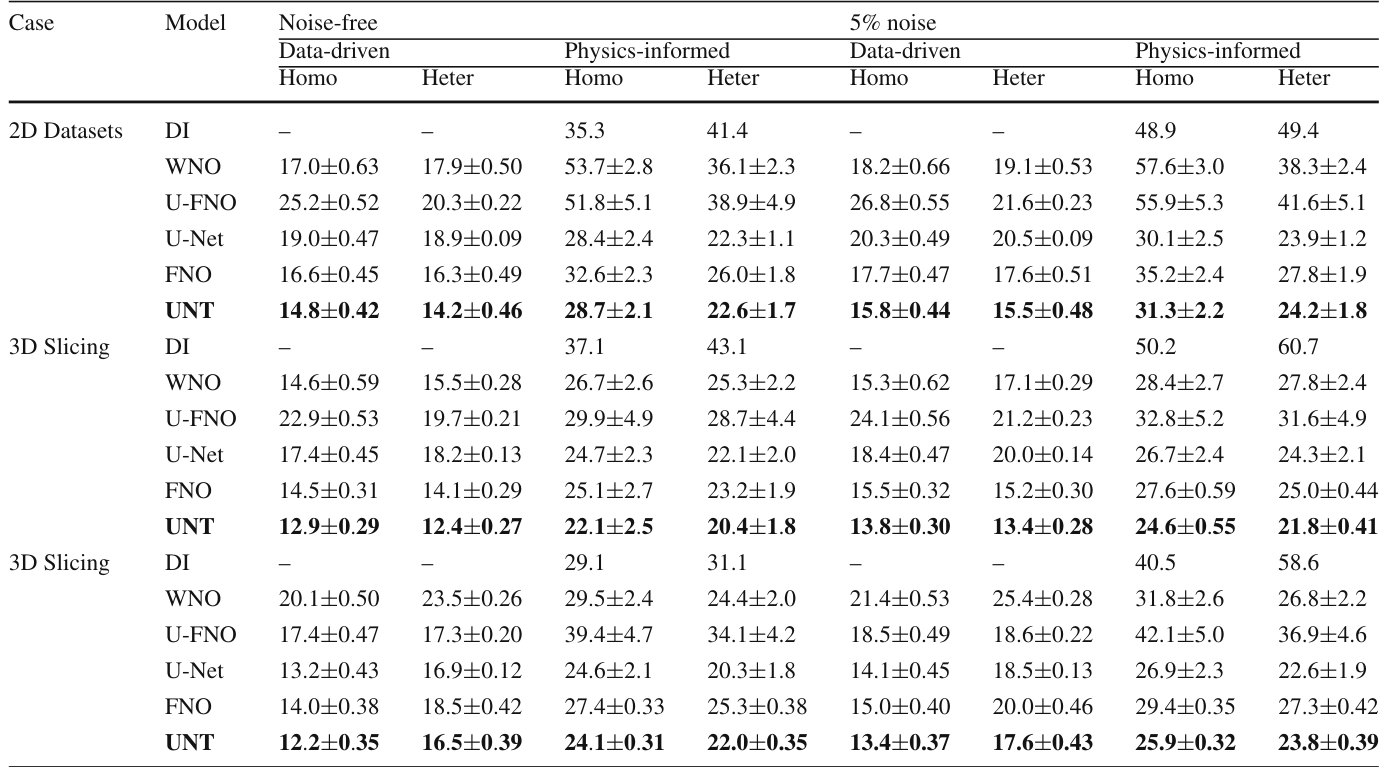
に示します。特に、AIモデルはノイズのないシナリオでは従来のダイレクトインバージョン(DI)に匹敵する精度を達成しますが、5%ノイズ条件下ではDIを上回る顕著な性能優位性を示しています。データ駆動型トレーニングは、絶対誤差の面で物理情報トレーニングを常に凌駕しており、これは大規模データセットを活用した機械学習モデルの開発が、モデル仮定に敏感な物理情報学習に頼るよりも、一般的に頑健で安全なアプローチであることを示唆しています。
また、均質なケース(健康な肝臓を表す)では、物理情報学習がデータ駆動型学習よりも有意に悪い結果を示しました。これは、非圧縮性(ポアソン比0.5)の仮定下でのトレーニング中にPDE損失が安定した勾配を提供できなかったことが原因と考えられます。このことは、このような仮定を用いる従来のインバージョン手法の限界を示しており、臨床上の誤診につながる可能性も指摘されています。
全体として、均質なケースでは誤差が大きくなる傾向が見られました。これは、高硬度領域が少なく、局所的な肝臓の硬さの小さな領域をモデルが捉えるのが難しいことに起因すると考えられます。異種PDEデータセットを用いたデータ駆動型UNTのトレーニングサンプルとテストサンプルにおける予測と正確な硬度マップの比較が
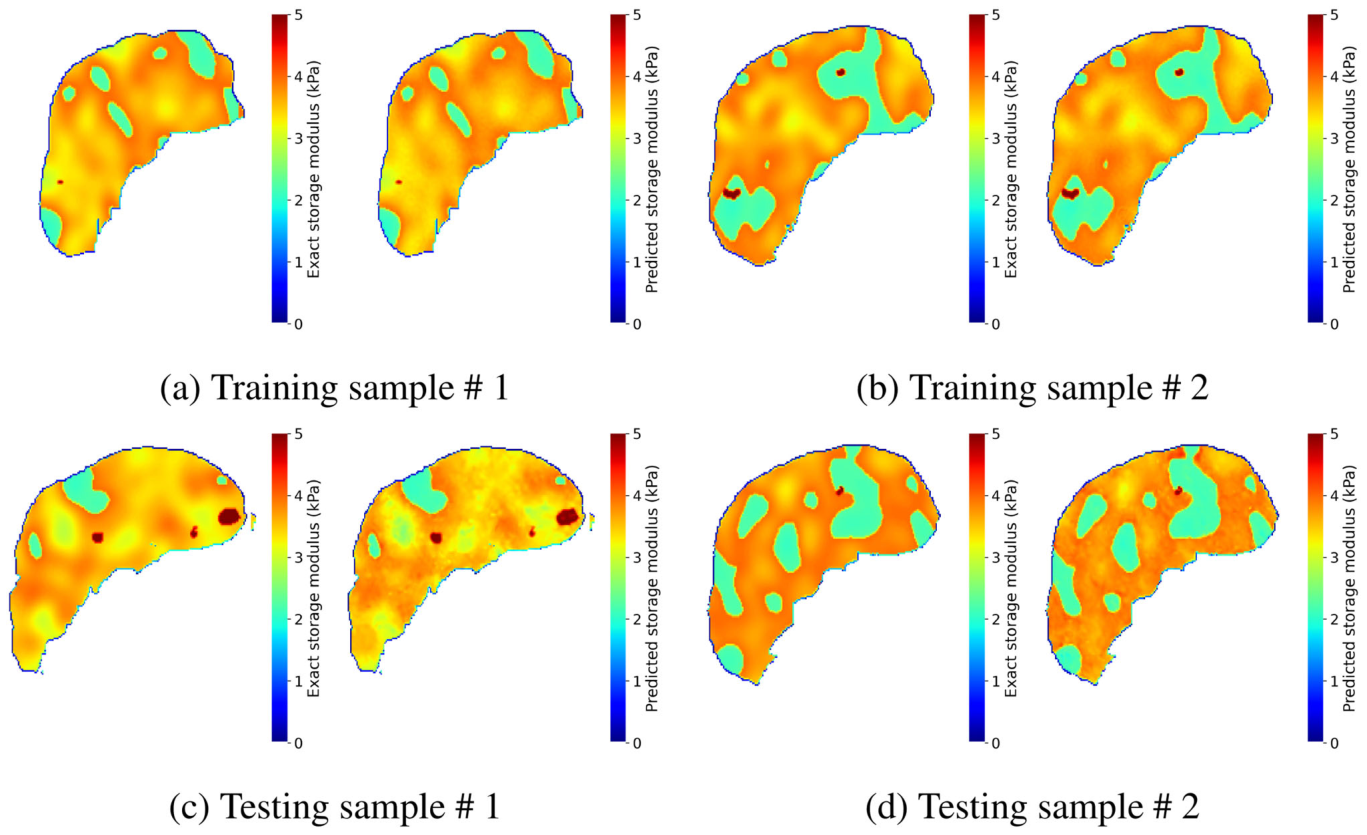
に示されており、データ駆動型アプローチが高い再構成忠実度と強い汎化能力を示すことが分かります。一方で、
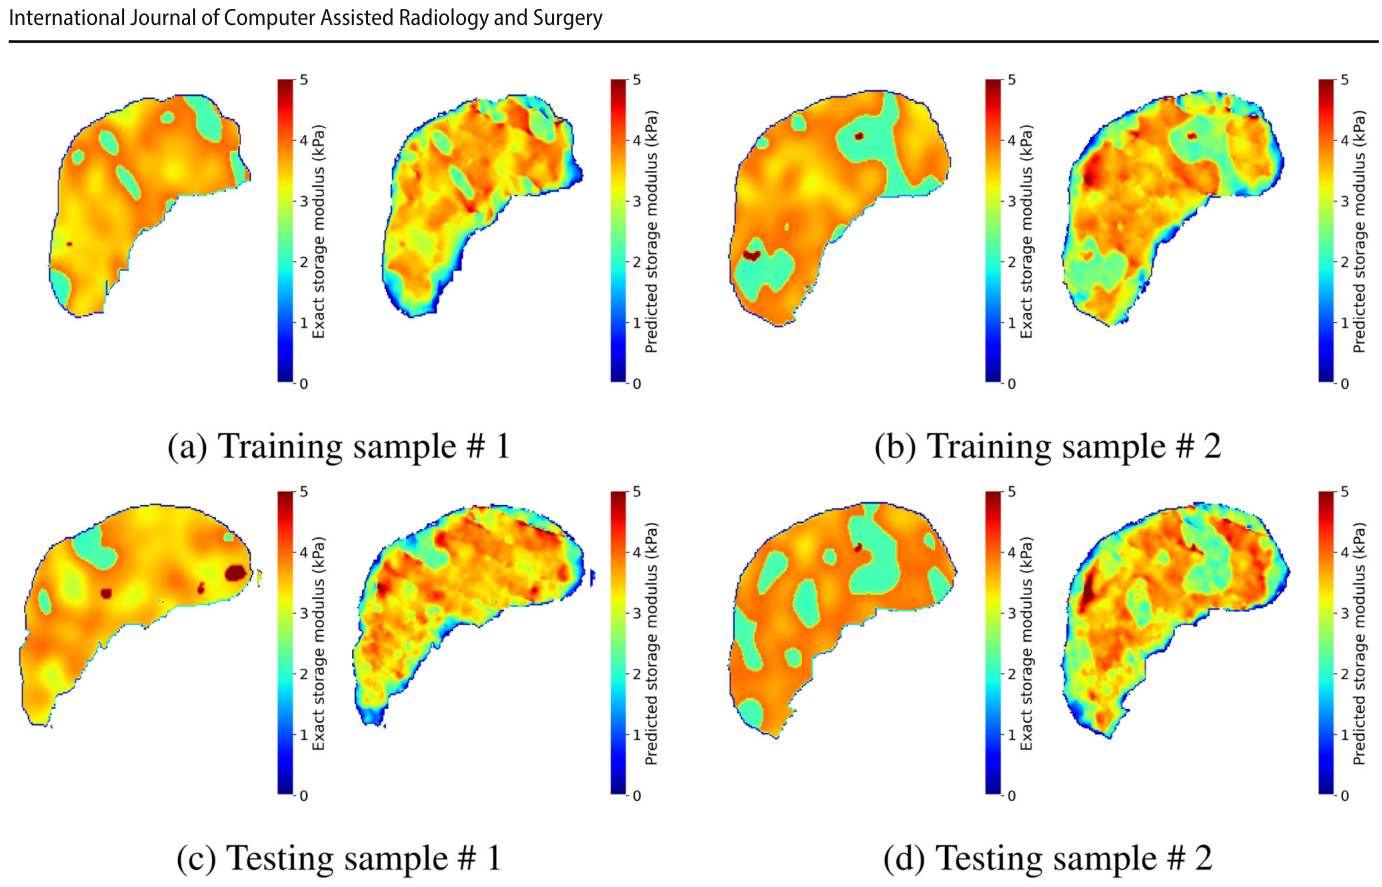
に示される物理情報に基づくUNTの結果は、ノイズに対する感度が高いことを示しており、テストサンプルでは特に顕著な不一致が見られます。正確な硬度マップが滑らかで明確な高硬度領域を示すのに対し、物理情報モデルはノイズが多く、鮮明な境界を解決するのに苦労しています。健康な肝臓を示す均質なデータセットでは、
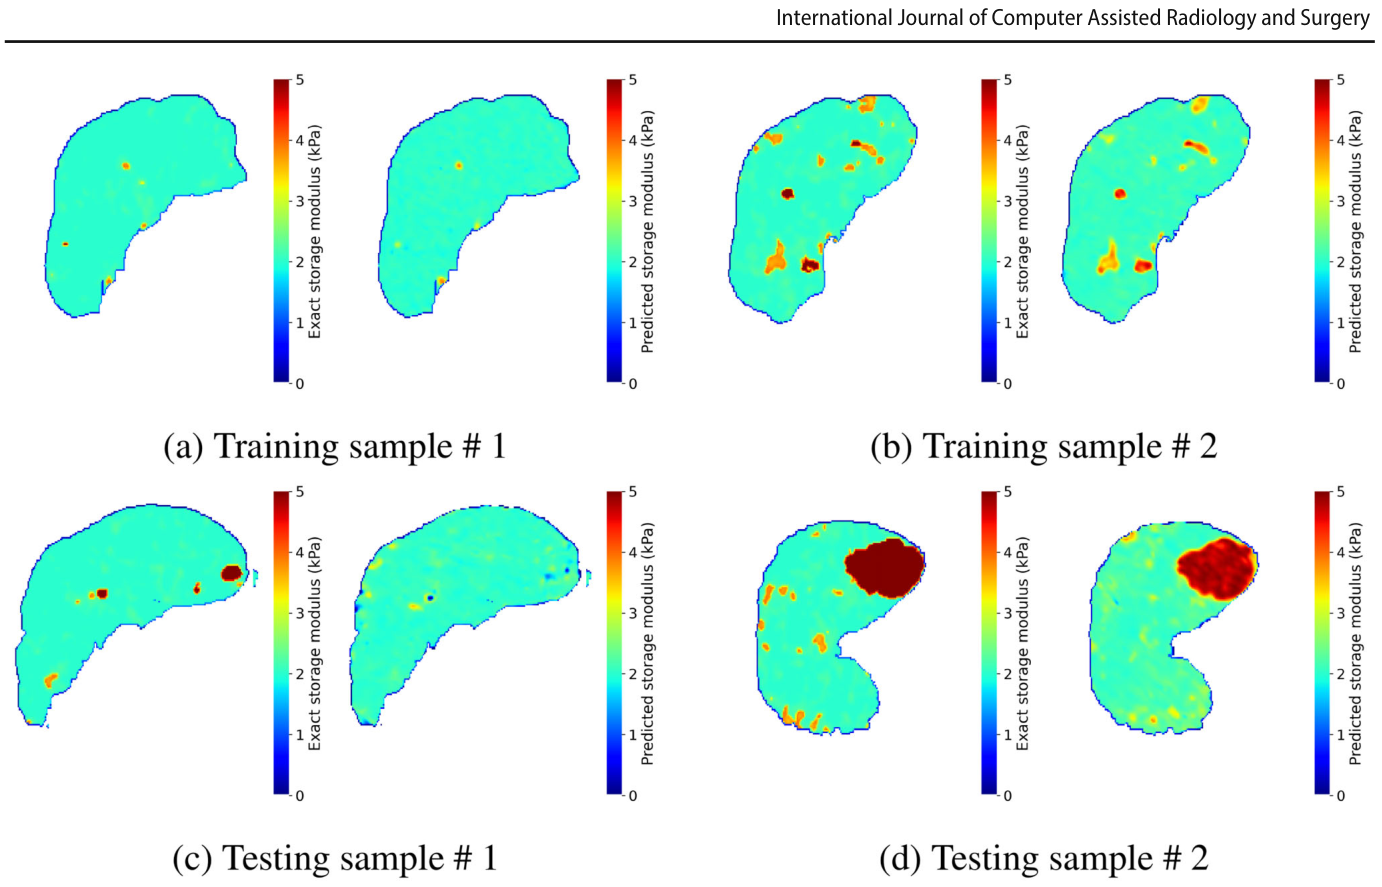
に示されているように、データ駆動型UNTはトレーニングサンプルではほぼ完璧な再構成を提供しますが、未見のテストデータでは苦戦する様子が伺えます。特に、テストサンプル#2では、主要な硬度異常を特定しつつも、より広範な健康な組織領域にシャープで非物理的なアーティファクトやピクセル化されたノイズを導入しています。均質なデータセットにおける物理情報に基づくUNTの予測は、
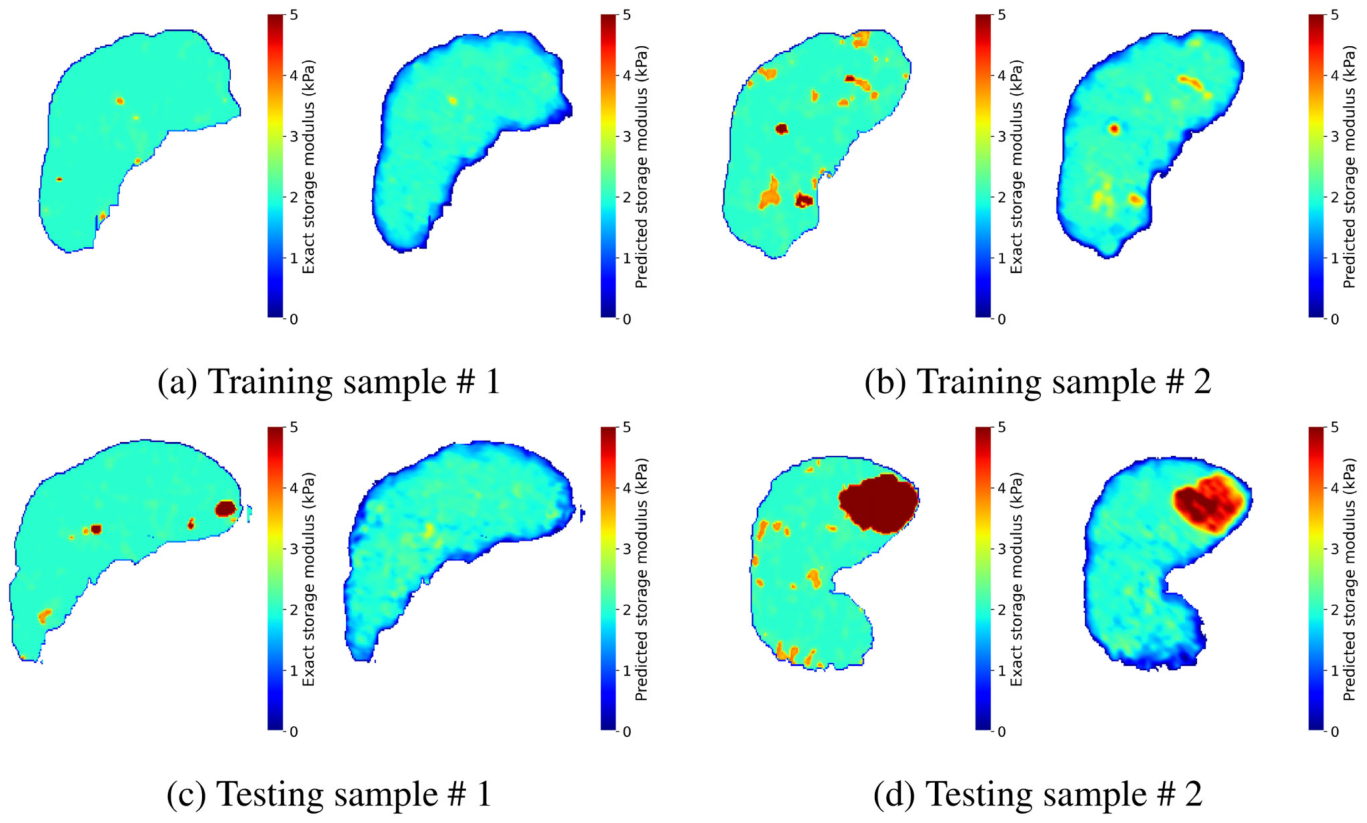
に示されており、硬度値が過小評価される臓器境界付近での精度低下が顕著です。これらの結果は、主として健康なデータで訓練されたモデルが、ノイズ条件下での局所的な病理に対して十分に汎化できない可能性を示唆しています。
疎なデータ環境での課題とファインチューニング
実際の臨床現場では、トレーニングデータが限られていることが多いため、限られたデータ可用性下でのモデル性能評価は重要です。UNTの頑健性を検証するため、トレーニングサンプル数を50、100、150と変化させて性能を評価しました。UNTモデルの平均L2相対誤差を
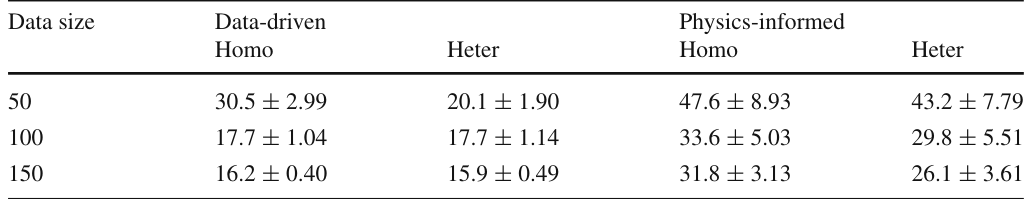
に示します。データ駆動型UNTは、トレーニングセットが小さい場合でも比較的安定した性能を維持するのに対し、物理情報に基づくUNTはデータ不足に敏感で、50サンプルでは誤差が急増しました。これは、データ駆動型モデルのために高品質なトレーニングデータをより多く生成することの利点を強調しています。
限られたデータセットでトレーニングされたモデルは汎化能力が低い可能性があるため、物理情報に基づくファインチューニング戦略が有望です。これは、モデルが事前学習された後、新しい対象者固有の変位データを用いてファインチューニングを行うことで、予測精度をさらに向上させるアプローチです。このファインチューニングプロセスにより、モデルは埋め込まれた物理的制約を活用しつつ、個々の解剖学的および機械的変動に適応できます。物理情報に基づくファインチューニングの効果は
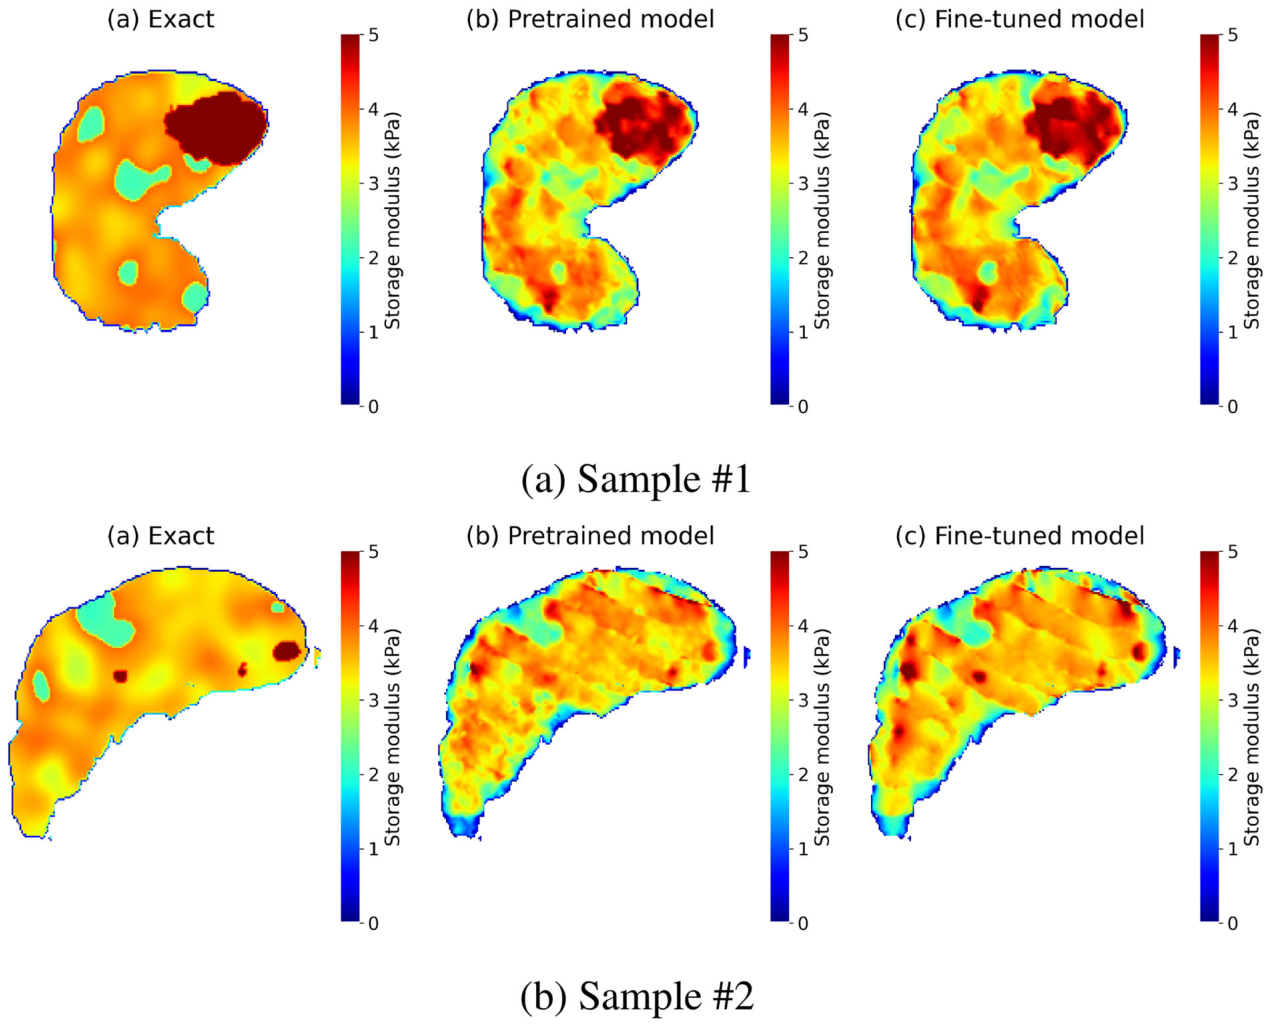
に示されており、ファインチューニングされたモデルは、事前学習済みモデルと比較して、高コントラスト硬度領域の局所化が改善されていることが分かります。ただし、全体的な改善は限定的であり、ファインチューニングが提供できる性能向上には限界があることも示唆されています。
ノイズレベルとシミュレーション特性への頑健性
測定ノイズの追加がモデルの精度を低下させることは、モデルやトレーニングパラダイムに依存することが示されています。様々なノイズレベル(5%、10%、20%)における全ベースラインモデル予測の平均相対L2誤差(2Dケース)が
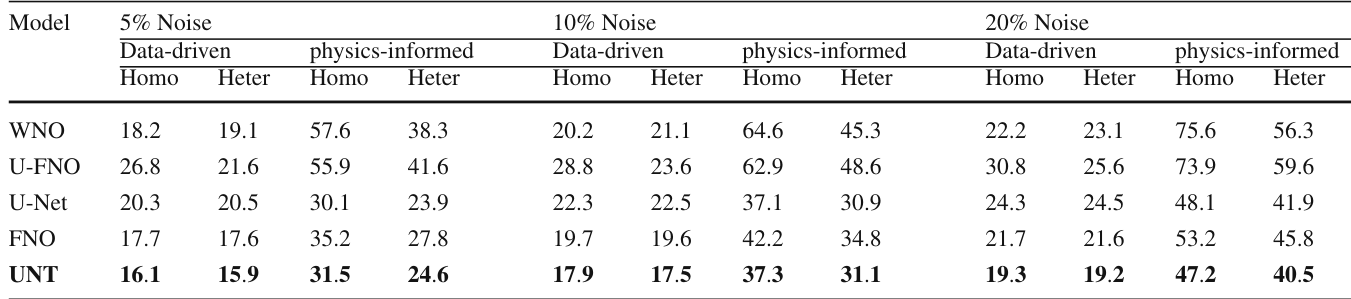
に示されています。ノイズが5%から10%に増加した場合、データ駆動型モデルでは誤差の増加は穏やかですが、物理情報モデルは大幅に感度が高くなります。20%ノイズでもこの傾向は持続し、データ駆動型モデルの誤差は適度に増加する一方、物理情報モデルの誤差は急激に増大します。
また、理想的なシミュレーションと生体内での観測の間のドメインシフトに対するモデルの頑健性を評価するため、より現実的な波動伝播特性を組み込んだ合成データセットの更新による影響も調査されました。長い波長、強化された減衰、圧縮汚染、完全なラメ弾性といった現実的な物理特性を導入した更新後のデータセットでも、モデルは一貫した予測精度を達成しました。ベースラインシミュレーションと、長い励起波長、高い減衰、境界圧縮オフセットを持つ更新された物理強化データセットを用いて生成された変位場スナップショットの比較をに示します。これらの結果は、提案されたフレームワークが様々な波動ダイナミクスに対して効果的に汎化し、生体内のシナリオを模倣する複雑で減衰した波動パターンにも頑健であることを示しています。
研究の意義と今後の展望
この研究は、MREにおけるAI駆動型インバージョンの標準的な基盤を確立し、放射線診断におけるリアルタイムAI支援型臨床意思決定支援への検証済み経路を提供するものです。特に、UNTアーキテクチャと付属のシミュレーションフレームワークは、AIによるMREインバージョンの進展における重要な一歩となります。
しかし、この研究にはいくつかの限界点も存在します。第一に、シミュレーションが単純化された物理モデルに基づいている点です。より現実的な粘弾性や異方性物質の挙動、対象者固有の境界条件などを組み込むことで、生体内組織の複雑さをより正確に捉えることが必要です。第二に、合成データセットは包括的であるものの、実際に対象者から得られたMREデータでの検証が不足しており、モデルの臨床的頑健性を評価する上での限界となります。第三に、計算上の制約により、高解像度の2Dケースとダウンサンプリングされた3Dドメインにデータセットが限定されています。日常的な臨床導入のためには、空間的忠実度を維持したまま、フル解像度の体積MREへの移行が不可欠です。最後に、対象者固有のファインチューニング戦略の効果をさらに高めるため、より高度な物理情報学習アルゴリズムの探求も今後の課題として挙げられます。
用語集
- MRE (Magnetic Resonance Elastography): 磁気共鳴画像法(MRI)を利用して、生体組織の硬さ(弾性)を非侵襲的に測定する技術です。
- 組織硬度 (Tissue Stiffness): 組織の弾性や硬さを表す機械的特性で、肝線維化などの疾患診断に重要な情報となります。
- U-Net Transformer (UNT): 畳み込みニューラルネットワーク(U-Net)とTransformerの長所を組み合わせた新しい深層学習モデルアーキテクチャです。
- 深層学習 (Deep Learning): 多層のニューラルネットワークを用いて、データから特徴を自動的に学習し、複雑なパターン認識や予測を行う機械学習の一種です。
- インバージョン(Inversion): MREで計測された組織の変位(動き)のデータから、その組織の硬さを示すマップを計算するプロセスです。
- 物理情報学習 (Physics-informed training): モデルの学習プロセスに物理法則や方程式を組み込むことで、データが少ない場合でも物理的に一貫性のある予測を可能にする手法です。
- データ駆動型学習 (Data-driven training): 大量のデータから直接特徴やパターンを学習し、予測や分類を行う機械学習のアプローチです。
- ニューラルオペレーター (Neural Operator): 物理シミュレーションにおける偏微分方程式の解を、入力関数から出力関数へ直接マッピングするように学習する深層学習モデルです。
- 肝線維化 (Liver Fibrosis): 肝臓の慢性的な損傷や炎症により、肝臓の組織が硬くなる状態を指します。進行すると肝硬変に至ります。
- 疎なデータ (Sparse-data): 臨床現場のように、モデルのトレーニングや検証に利用できるデータ量が限られている状況を指します。
- ファインチューニング (Fine-tuning): 大規模データで事前学習されたモデルを、特定のタスクや少量のデータに合わせて微調整し、性能を向上させる手法です。
- ラメ定数 (Lamé parameters): 材料の弾性特性を記述するための2つのパラメータ(剪断弾性率μと第一ラメ定数λ)です。
コメントを残す