深層学習が腹部骨盤DSAの解剖学的部位特定を自動化:血管内治療の精度向上へ

· 論文解説

🎧 この記事を音声で聴く(AI生成Podcast)

解説対象論文: Deep Learning Models for Automatic Classification of Anatomic Location in Abdominopelvic Digital Subtraction Angiography
Journal of Imaging Informatics in Medicine|被引用数: 6(2026年8月25日時点)

デジタルサブトラクションアンギオグラフィ(DSA)における腹部骨盤の複雑な血管構造の解剖学的部位特定は、血管内治療の成功に不可欠です。しかし、DSA画像には情報スパース性という課題が存在します。本記事では、深層学習がこの課題を克服し、どのようにDSA画像から解剖学的部位を高精度に自動識別できるのかについて、最新の研究論文を基に詳しく解説します。

研究サマリー(FINER & PICO)
Feasible実施可能性 既存のDSA画像データと深層学習技術を用いて、腹部骨盤DSAの解剖学的部位特定が可能であることを示しました。
Ethical倫理面 本研究は遡及的に収集されたデータに基づいており、IRBによる倫理承認免除が認められました。
Interesting面白さ DSAデータ内の情報スパース性という課題に対し、手動と自動の両アプローチで効果的に対処し、高精度な部位特定を実現した点が新規です。
Novel新規性 腹部骨盤DSAにおける解剖学的部位特定への深層学習の適用、特にMILモデルによる情報スパース性の自動管理は新規性があります。
Relevant切実さ 血管内治療における診断支援、レポート作成、コーディングの自動化に寄与し、専門家のワークフローを効率化する可能性を秘めています。
Measurable測定可能性 多クラス分類精度を主要評価項目とし、適合率、再現率、F1スコアも合わせて統計的にモデル性能を評価しました。
Modifiable派生・改善 MILモデルのアテンションメカニズムは、診断に重要な画像フレームの自動識別の精度を高める上で調整可能な要素を提供します。
Structured文章構造 研究は目的、方法、結果、考察が明確に記述されており、モデル評価には統計的手法が用いられた構造化されたデザインです。
PICO / PECO対象・介入・比較・結果 P: 腹部骨盤DSAデータ中の血管構造、I: 深層学習アルゴリズム(モードモデル、MILモデル)、C: 全データセットで訓練されたモードモデル、O: 解剖学的部位の自動分類精度。

はじめに:DSAにおける解剖学的部位特定とAIの可能性

どうも、Beyond the Pixelです。血管造影検査、特にデジタルサブトラクションアンギオグラフィ(DSA)は、血管内の異常を特定し、血管内治療のような低侵襲な手技を行う上で不可欠なツールです。しかし、腹部骨盤領域のDSA画像は、血管構造の多様性、呼吸による動きのアーティファクト、腸の蠕動運動、造影剤の排泄など、多くの課題を抱えています。これらの要因は画像の判読を難しくし、診断に重要なフレーム(画像)がシーケンス全体のごく一部にしか存在しない「情報スパース性」という問題を引き起こします。本日は、これらの課題に対し、深層学習がどのように腹部骨盤DSAの解剖学的部位特定を自動化し、高い精度を達成できるかを探った興味深い研究をご紹介します。

研究の概要:腹部骨盤DSAにおける深層学習モデルの評価

本研究の目的は、腹部骨盤DSAシーケンスにおいて解剖学的部位を自動的に識別するための深層学習アルゴリズムを評価することでした。

データ収集と準備

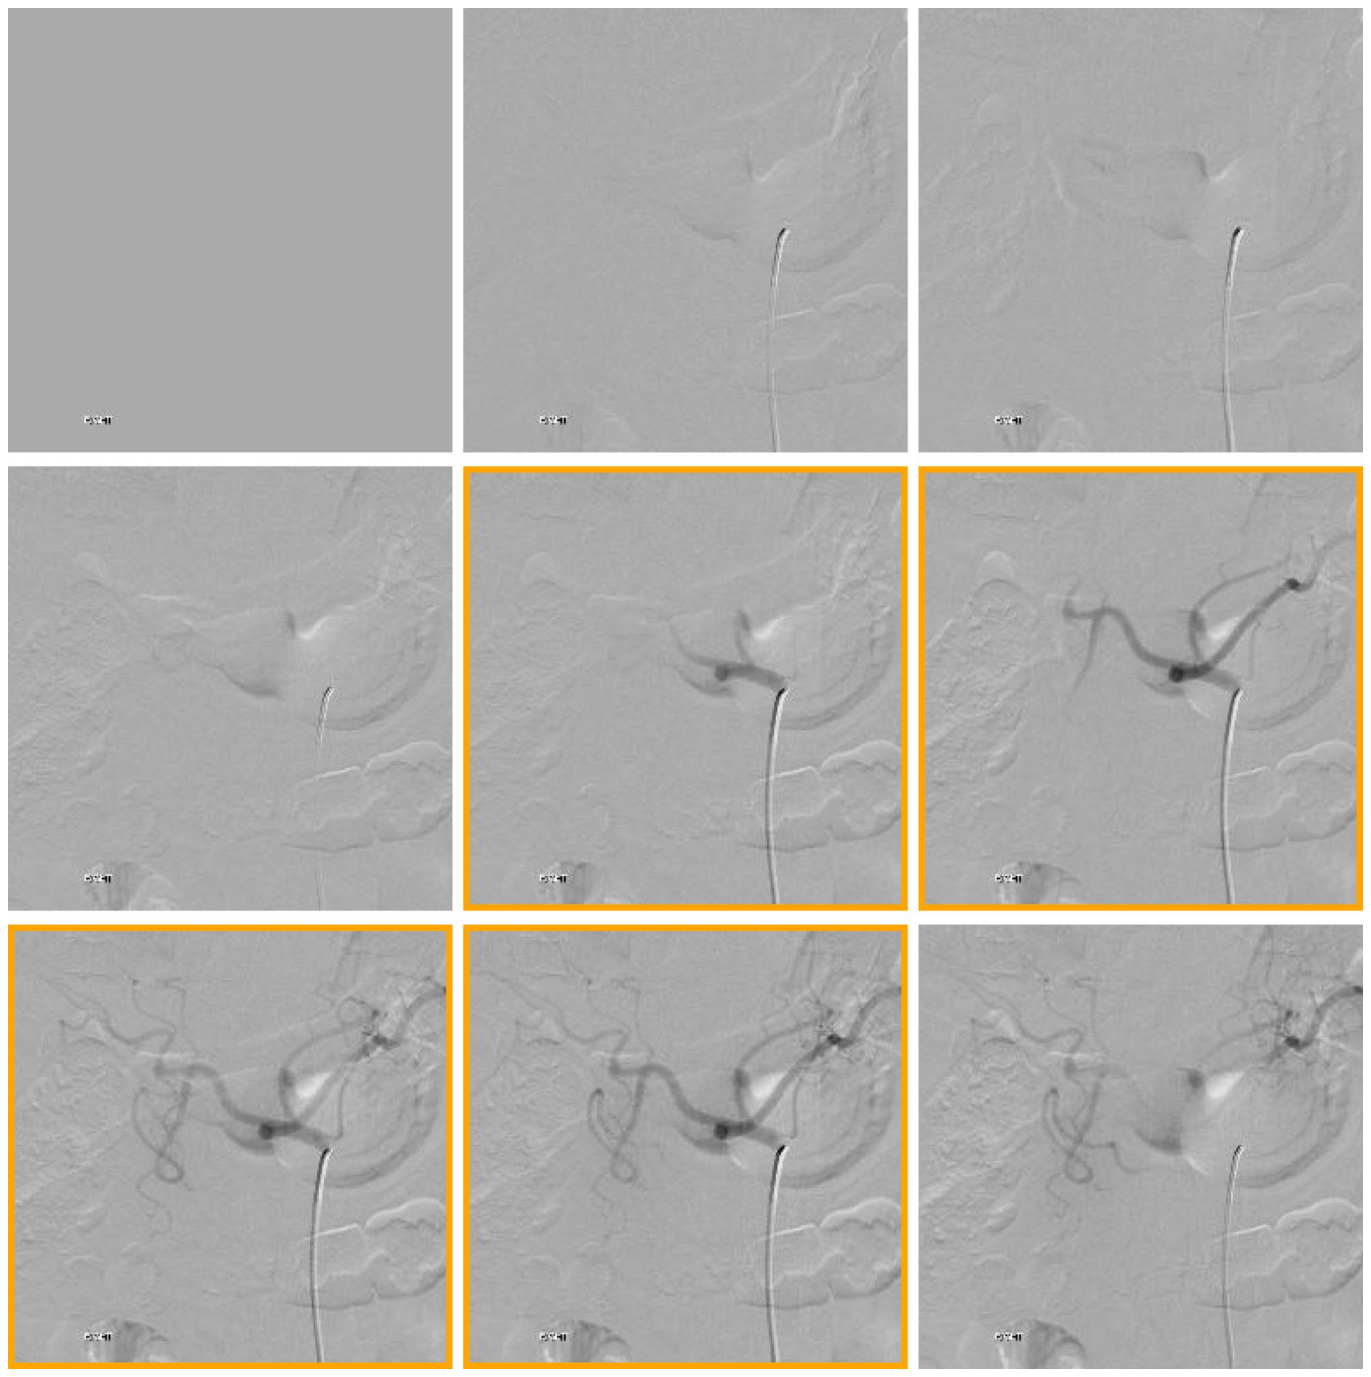
この研究では、2010年から2020年の間に三次医療施設で実施された血管内治療から遡及的に収集されたDSAデータが使用されました。腹部大動脈、腹腔動脈、上腸間膜動脈、下腸間膜動脈、および両側の外腸骨動脈のDSAシーケンスについて、解剖学的部位がラベリングされました。さらに、各シーケンス内で親血管と最初の分岐が造影されている「Key」画像も手動でラベリングされました。

Figure 1
Figure 1. Fig. 1 “Key” image labeling. A 9-image sequence with “key” images framed in gold. All images in an angiographic sequence in which the par- ent vessel and first bifurcation and opacified are labeled “key”解説: この図は「Key」画像の手動ラベリングを示しています。9枚の画像シーケンスの中で、親血管と最初の分岐が造影されている診断上重要な「Key」画像が金色の枠で示されています。

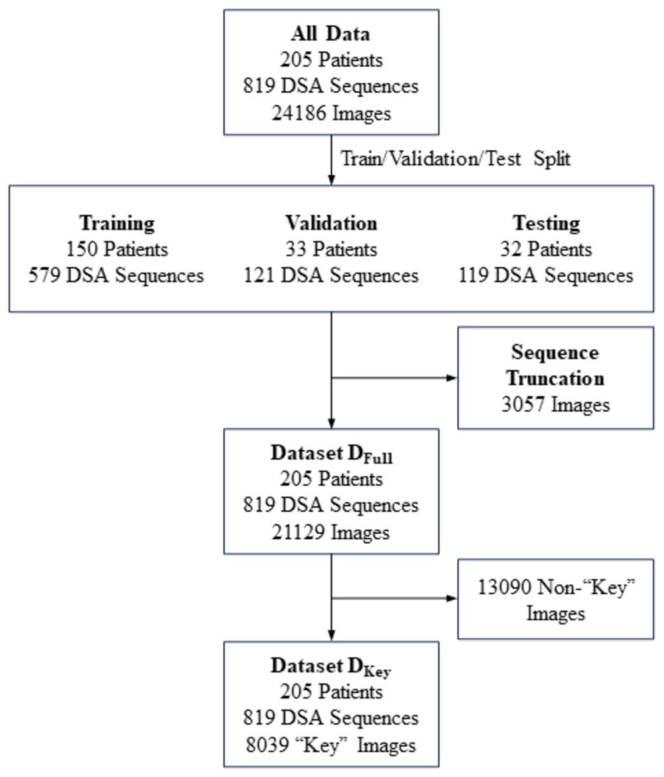
訓練、検証、テストには、205名の対象者と276件の手技から得られた合計819の固有の血管造影シーケンスが含まれました。データの漏洩を防ぐため、対象者レベルで分割されました。

Figure 2
Figure 2. Fig. 2 Datasets for training, validation, and testing. The angio- graphic sequences were split randomly into training (70%), validation (15%), and test (15%) sets, each containing non-overlapping patients. Sequences with more than 50 images were truncated at 50 images. Dataset ­DFull is comprised of all individual images from the 205 unique patients and 276 procedures after splitting into training, vali- dation, and test sets and sequence truncation. Dataset ­DKey is a subset of ­DFull comprised of the “key” images only for each sequence解説: このフローチャートは、モデルの訓練、検証、テストに使用されたデータセットの構成を示しています。205名の対象者からの819のDSAシーケンスが、訓練、検証、テストセットに分割され、それぞれ「Key」画像と非「Key」画像を含むDFullと「Key」画像のみのDKeyが構築されました。

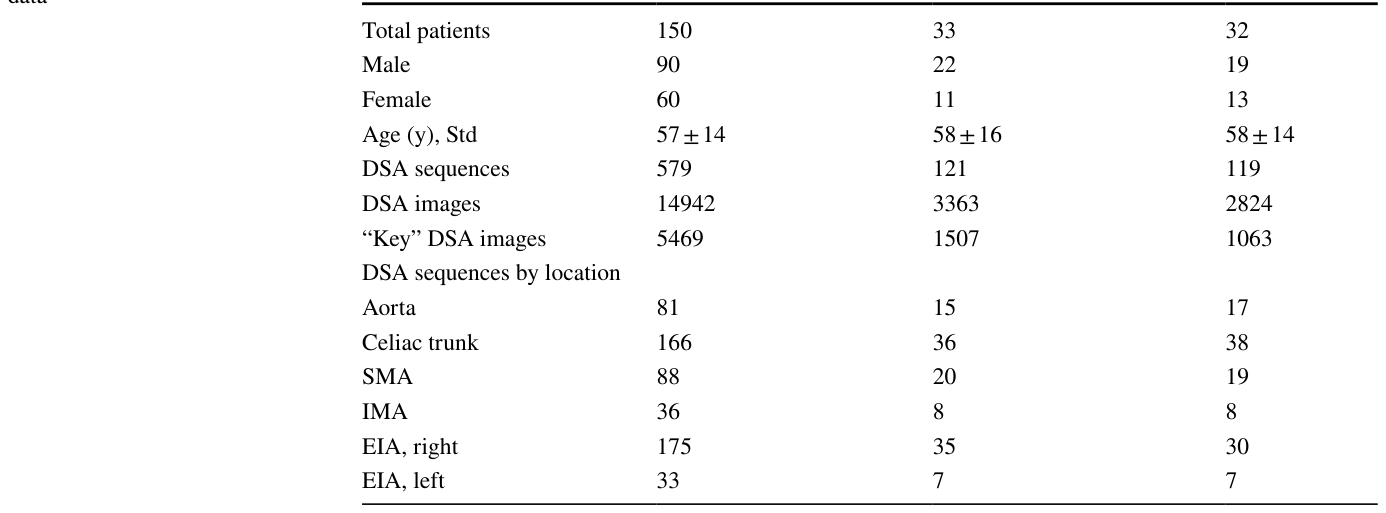
データは訓練セット150名、検証セット33名、テストセット32名で構成されており、各セットの対象者特性とDSAシーケンスの内訳が示されています。

Table 1
Table 1. Table 1 Characteristics of the data Training dataset Validation dataset Testing dataset解説: この表は、訓練、検証、テストの各データセットにおける対象者特性とDSAシーケンスの数、および解剖学的部位ごとのDSAシーケンスの内訳をまとめたものです。

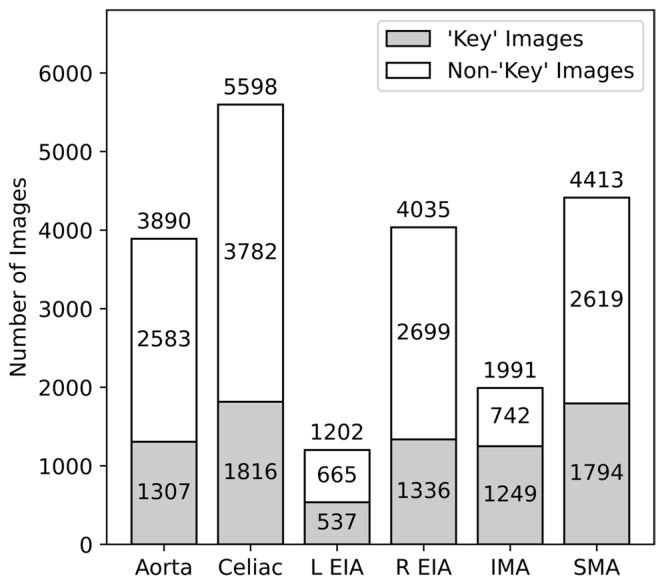
合計21,129枚の画像のうち、手動で「Key」とラベリングされた診断情報を持つ画像は8039枚、全体の38.0%に過ぎませんでした。これは、DSAデータにおける顕著な情報スパース性を示しています。各解剖学的部位ごとの「Key」画像と非「Key」画像の割合も分析されました。

Figure 4
Figure 4. Fig. 4 Information density. Diagnostic “key” images represent images demonstrating opacification of the index artery and the first downstream bifurcation such that the location may be inferred. The remainder of the images are labeled non-“key.” The images are grouped by label class. R, right; L, left; EIA, external iliac artery; IMA, inferior mesenteric artery; SMA, superior mesenteric artery解説: この棒グラフは、診断上重要な「Key」画像と非「Key」画像の数を、解剖学的部位ごとに示しています。データセット全体の情報スパース性、すなわち「Key」画像が総画像数の少数であることが視覚化されています。

深層学習モデルの構築

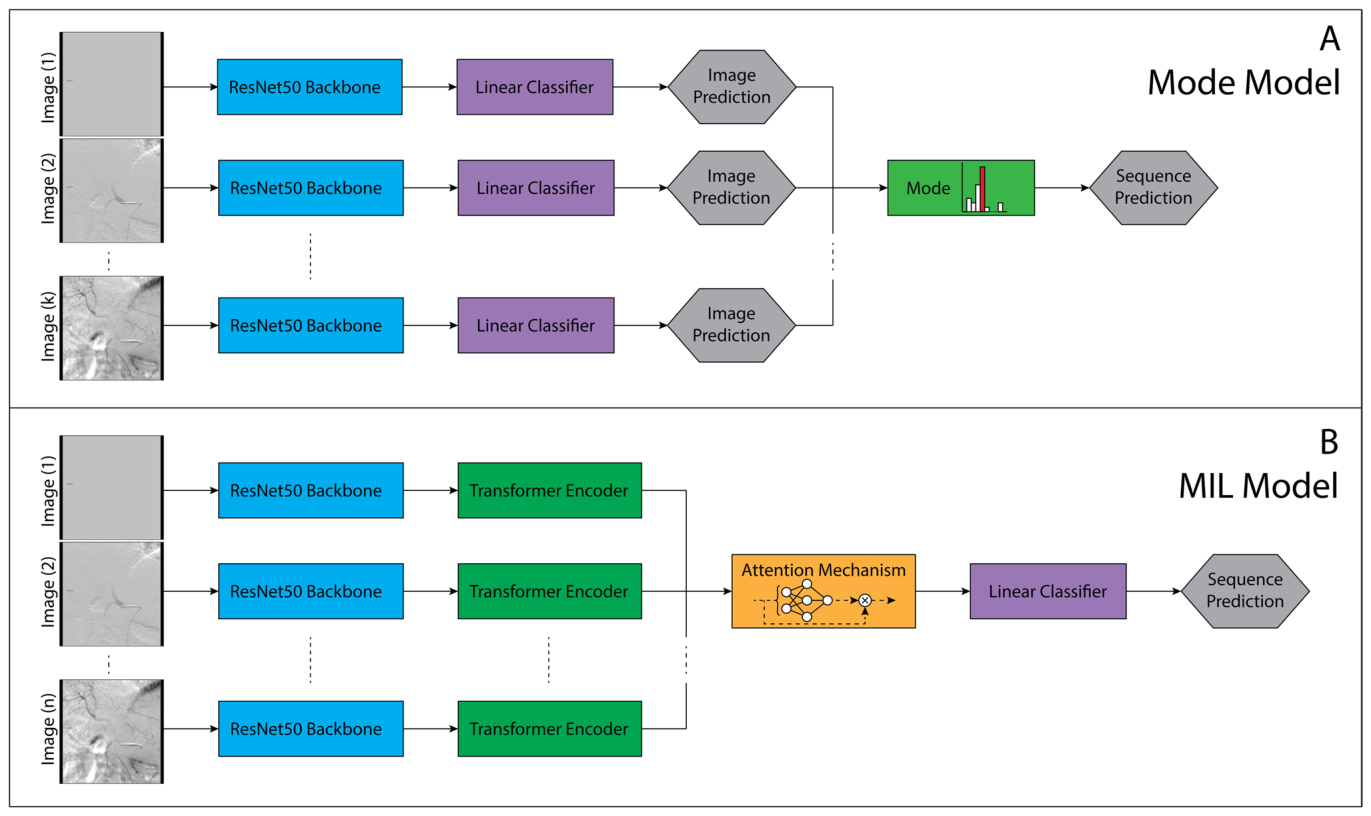
本研究では、解剖学的部位分類のために2種類の深層学習アーキテクチャが開発されました。一つは「モードモデル(Mode Model)」で、個々の画像の予測を集約する手法です。もう一つは「マルチプルインスタンスラーニング(MIL: Multiple Instance Learning)モデル」で、アテンションメカニズム(注意機構)を用いて各画像の分類への寄与度を重み付けします。

Figure 3
Figure 3. Fig. 3 Schematic representations of the deep learning model architectures. A Mode Model. The angiographic location of individual images is predicted using a ResNet50 convolutional neural network (CNN) and fully connected linear classifier. The model accepts a DSA sequence of an arbitrary number of k images. The prediction for the DSA sequence is calculated by the mode of the individual predictions. B MIL Model. The extracted features of images from ResNet50 CNN are supplied to a transformer encoder and subsequently an attention mechanism. The model accepts a sequence of n images, where for sequences < n, the sequence is padded with blank images. The model predicts the anatomic location of the sequence and the “key” diagnostic images within the sequence based upon the attention weights解説: この図は、開発された深層学習モデルのアーキテクチャの概略図です。Aはモードモデルを示し、個々の画像予測を集約してシーケンス予測を行います。BはMILモデルを示し、ResNet50からの特徴をトランスフォーマーエンコーダとアテンションメカニズムを通してシーケンス分類を行います。
  • モードモデル(Mode Model): 個々の画像から解剖学的部位を予測するために、ResNet50という畳み込みニューラルネットワーク(CNN)をベースモデルとして使用しました。このモデルは、全データセット(DFull)で訓練されたMode ModelFullと、「Key」画像のみのデータセット(DKey)で訓練されたMode ModelKeyの2種類が開発されました。
  • MILモデル(Multiple Instance Learning Model): DSAシーケンス全体の分類において、診断に重要なフレームを自動的に特定できるアテンションメカニズムを活用しました。このMILモデルは、ResNet50を特徴抽出のバックボーンとして使用し、トランスフォーマーエンコーダとアテンションメカニズムを組み合わせて、多クラス分類を行います。

モデルの性能は、主要評価項目である多クラス分類精度を用いて評価され、McNemarの検定によって比較されました。

注目すべき研究結果:高精度な自動部位特定

研究の結果、深層学習モデルは腹部骨盤DSAの解剖学的部位特定において高い精度を示すことが明らかになりました。

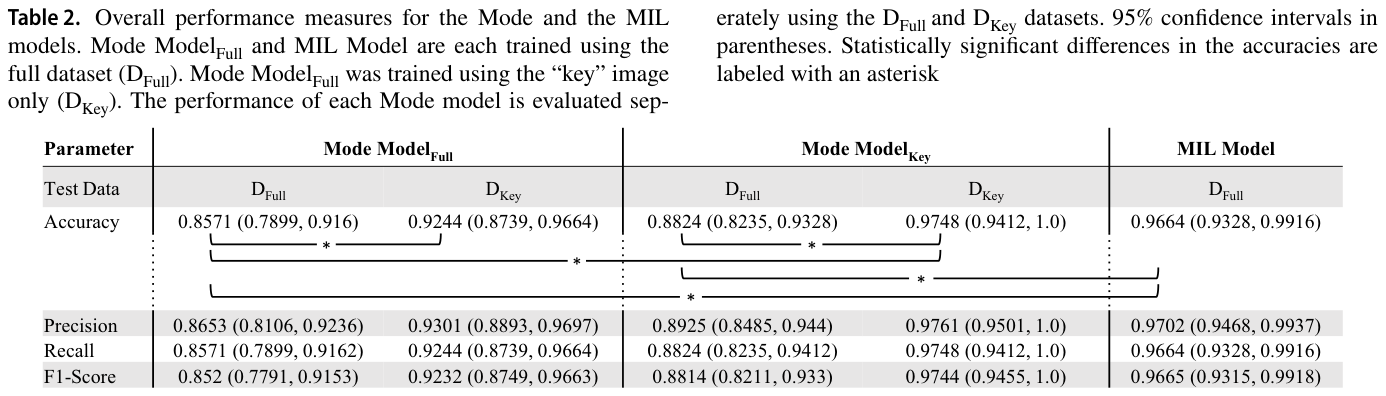
  • 「Key」画像で訓練・テストされたMode ModelKeyは、多クラス分類精度0.975(95% CI 0.941–1)を達成しました。
  • 全データで訓練・テストされたMILモデルは、多クラス分類精度0.966(95% CI 0.932–0.992)を達成しました。

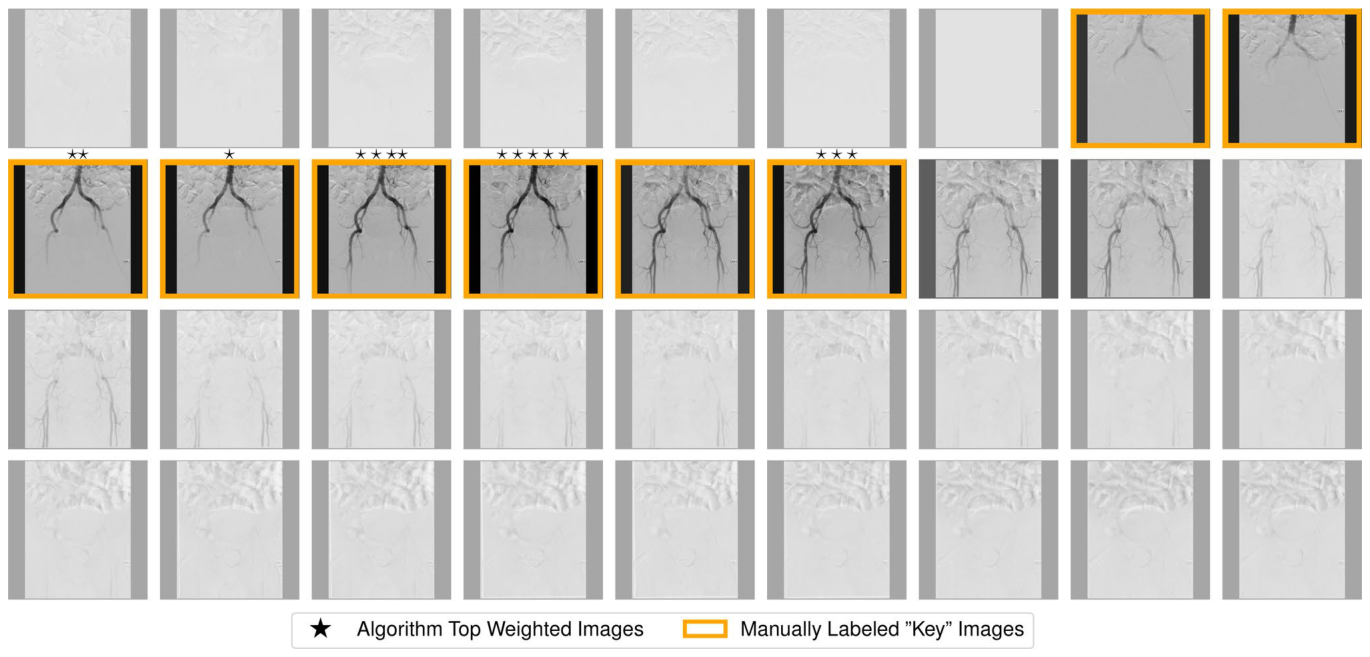
興味深いことに、「Key」画像で訓練・テストされたMode ModelKeyと、全データで訓練・テストされたMILモデルのいずれも、全データセットで訓練・テストされたMode ModelFullを統計的に有意に上回る性能を示しました(p < 0.001)。MILモデルは、手動でラベリングされた「Key」画像と平均92.5%のオーバーラップを持つ上位5枚の画像を自動的に特定できることも示されました。

Figure 6
Figure 6. Fig. 6 Comparison of manually labeled “key” images to weights of the MIL model attention mechanism. The opacity of each image in the DSA sequence of the aorta varies directly with the MIL algorithmically generated weights. Images with stars above represent the top five weighted images by the MIL model, with the star count correlating to the assigned weight. The manually labeled “key” images are framed in gold解説: この図は、MILモデルのアテンションメカニズムによって割り当てられた重みと、手動でラベリングされた「Key」画像との比較を示しています。各画像の不透明度は、MILアルゴリズムが生成した重みに直接対応しており、星の数は重みの高さを表しています。手動でラベリングされた「Key」画像は金色の枠で囲まれています。

全体的な性能指標を見ると、MILモデルはMode ModelFullと比較して、すべての性能指標で統計的に有意な改善を示しました。

Table 2
Table 2. Table 2. Overall performance measures for the Mode and the MIL models. Mode ­ModelFull and MIL Model are each trained using the full dataset ­(DFull). Mode ­ModelFull was trained using the “key” image only ­(DKey). The performance of each Mode model is evaluated sep-解説: この表は、モードモデルとMILモデルの全体的な性能指標(精度、適合率、再現率、F1スコア)を、95%信頼区間とともに示しています。DFullデータセットとDKeyデータセットで評価された各モードモデルの性能が比較されており、統計的に有意な差にはアスタリスクが付いています。

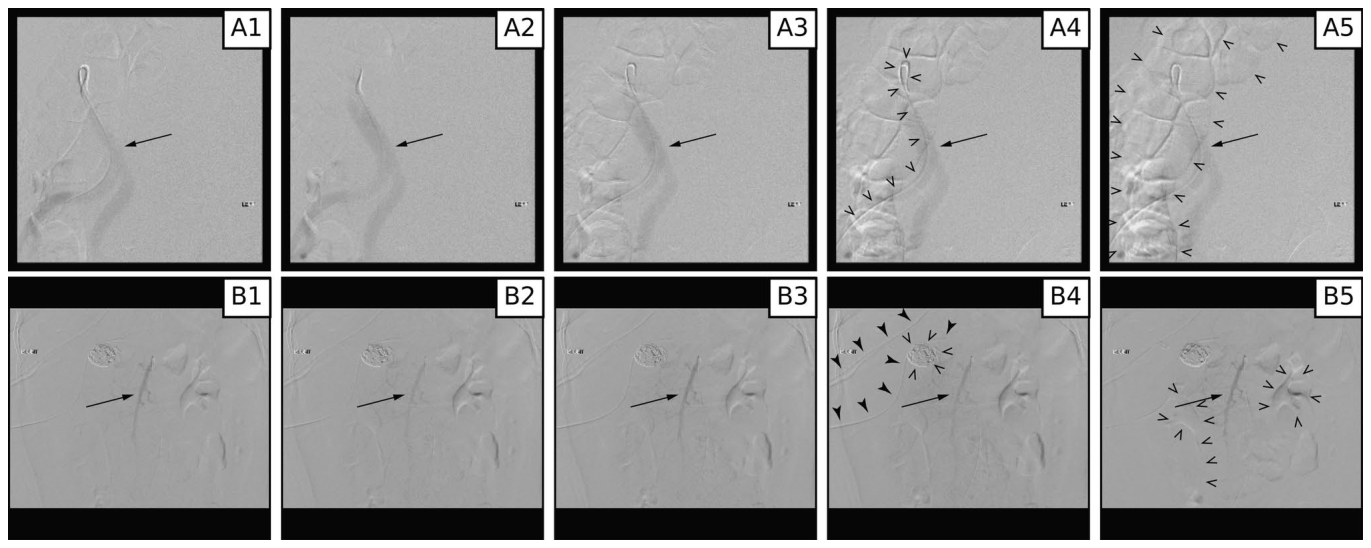
誤分類されたDSAシーケンスの例を見ると、動きのアーティファクトや造影剤の濃度変動が課題であることが示唆されました。これらのアーティファクトは画像の品質を低下させ、造影された血管と背景とのコントラストを減少させることがあります。

Figure 5
Figure 5. Fig. 5 “Key” images from DSA sequences of the aorta (A) and superior mesenteric artery (B) misclassified by the MIL algorithm. Variable contrast within the vessels is highlighted by arrows in all frames (A and B). Multiple artifacts are created by motion including the angiographic catheter (open arrowheads, frame A4), bowel (open arrowheads, frame A5), internal hardware (open arrowheads, frame B4), overlying support hardware (solid arrowheads, frame B4), and renal contrast excretion (open arrowheads, frame B5)解説: この図は、MILアルゴリズムによって誤分類された大動脈(A)と上腸間膜動脈(B)のDSAシーケンスにおける「Key」画像を示しています。各フレームに矢印で示された血管内の造影剤の変動や、動きのアーティファクト(カテーテル、腸、内部ハードウェア、腎臓の造影剤排泄)が強調されています。

この研究が示唆することと今後の展望

本研究は、深層学習アルゴリズムが腹部骨盤DSAにおいて解剖学的部位を高精度に識別できることを実証しました。特に、診断に重要な情報が限られているDSAデータ特有の「情報スパース性」という課題に対し、手動ラベリング、およびアテンションメカニズムによる自動識別という2つのアプローチで効果的に対処できることが示されました。

手動で「Key」画像をラベリングする方法は高い分類性能をもたらしましたが、そのコストは非常に高く、大規模なデータセットへの適用には大きな障壁となります。一方、MILモデルのアテンションメカニズムは、個々の画像を明示的にラベリングすることなく、解剖学的部位と診断に重要な「Key」画像フレームの両方を学習できる点で画期的です。このMILモデルは、手動でフィルタリングされた「Key」画像セットで訓練されたモードモデルに匹敵する分類精度を達成しました。

この解剖学的分類アルゴリズムは、将来的にレポート生成の自動アシスト、コーディングおよび請求の自動化、そして完全自動DSA解釈システムの中核的な構成要素として、多くの臨床応用が期待されます。血管造影画像の解釈は、特定の血管領域に固有の血流ダイナミクスを理解することに基づいているため、これらのアルゴリズムは不可欠な最初のステップとなるでしょう。

研究にはいくつかの限界点もあります。データは単一施設から収集されており、単一ベンダーの画像装置で取得されたものです。遡及的なデータ収集は、血管解剖や病態のスペクトルに関してバイアスを生じる可能性があります。また、臓器移植後の血管解剖(例えば、腎臓移植後の腎動脈と内腸骨動脈の吻合)のような術後の血管解剖を有する対象者は明示的に除外されました。モデル開発に使用されたデータは、手動ラベリングに要する時間によって制約され、比較的小規模でした。今後、より大規模でバランスの取れたデータセットを用いることで、さらに性能が向上する可能性があります。現在の分類アルゴリズムは、腹部と骨盤の主要な一次構造に限定されていますが、将来の研究では、より多くの一次および二次血管構造への分類を拡大することが目標とされています。

用語集

  • 深層学習 (Deep Learning): 人間の脳の構造を模倣した多層のニューラルネットワークを用いる機械学習手法。画像認識や自然言語処理で優れた性能を発揮する。
  • デジタルサブトラクションアンギオグラフィ (DSA: Digital Subtraction Angiography): 造影剤を注入した血管画像を、造影剤注入前の画像から差し引くことで、骨などの背景ノイズを除去し、血管のみを鮮明に表示するX線撮影法。
  • 血管内治療 (Endovascular procedures): カテーテルなどの細い管を血管内に挿入し、体内の血管や臓器の疾患を治療する低侵襲な手技。
  • 解剖学的部位特定 (Anatomic localization): 身体の構造が画像上のどこにあるかを正確に特定すること。診断や治療計画に不可欠。
  • 情報スパース性 (Information sparsity): データ中に有用な情報が少なく、大部分が関連性の低い情報や空白である状態。DSAでは診断に重要なフレームが限られることを指す。
  • “Key”画像: 親血管と最初の分岐が造影されている、診断上重要な一連の画像。
  • モードモデル (Mode Model): 個々の画像の予測結果を多数決(最頻値)で集約し、シーケンス全体の分類結果とする深層学習モデルの一種。
  • マルチプルインスタンスラーニング (MIL: Multiple Instance Learning): 複数のインスタンス(画像)を含む「バッグ」(シーケンス)に対して、バッグレベルのラベルのみが与えられている状況で学習する機械学習パラダイム。個々のインスタンスにラベルが付いていない場合に有効。
  • アテンションメカニズム (Attention Mechanism / 注意機構): 深層学習モデルが、入力データ(この場合は画像シーケンス内の個々の画像)の中で、より重要性の高い部分に焦点を当てて重み付けを行う仕組み。
  • ResNet50: 画像認識タスクで広く使用される、深層学習モデルの一種である畳み込みニューラルネットワーク(CNN)のアーキテクチャ。
  • トランスフォーマーエンコーダ (Transformer Encoder): 自然言語処理の分野で発展した、シーケンスデータ内の要素間の関係性を捉えるための深層学習モジュール。
  • 多クラス分類精度 (Multiclass classification accuracy): 複数のカテゴリ(解剖学的部位)にデータを分類するタスクにおいて、正しく分類されたデータの割合。
  • McNemarの検定 (McNemar’s test): 2つの関連する分類器(モデル)の性能を比較するための統計的仮説検定。
powered by visionary imaging services, inc.
免責事項

発行 Beyond the Pixel 編集部(Visionary Imaging Services, Inc.)

編集責任者 小林 達明(診療放射線技師/博士(情報学)) ORCID

本記事は生成 AI を用いて作成しています。公開後に気づいた誤りは編集部が随時修正します。

論文の引用・解釈の方針は免責事項をご覧ください。

コメントを残す

メールアドレスが公開されることはありません。 ※ が付いている欄は必須項目です