
連合学習における医用画像セグメンテーションの課題:実世界ラベルノイズへの対応と最適なAI手法選択
解説対象論文: Federated Medical Image Segmentation under Real-World Label Noise: A Benchmark Suite for Noisy Label Learning Method Selection
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月3日時点)
医用画像診断において、AI(人工知能)はセグメンテーション(画像内の特定領域の自動識別)を通じて病変の検出や治療計画に不可欠な役割を果たしています。しかし、この重要な技術の発展には大量の高品質なデータが必要不可欠です。機密性の高い医療データを一元化することなく、複数の施設が協力してAIモデルを訓練することを可能にする「連合学習(Federated Learning)」は、この課題を克服する有力な手段として注目されています。しかし、現実世界では、異なる施設間でアノテーション(ラベル付け)のばらつきや誤り、すなわち「ラベルノイズ」が存在し、連合学習の性能を著しく低下させる可能性があります。本記事では、この実世界のラベルノイズ問題に対処するための、革新的なベンチマークスイートについてご紹介します。
連合学習と医用画像セグメンテーション、そして隠れた課題「ラベルノイズ」
どうも、Beyond the Pixelです。医用画像診断において、AI(人工知能)はセグメンテーション(画像内の特定領域の自動識別)を通じて病変の検出や治療計画に不可欠な役割を果たしています。これは、自動診断の支援や、コンピューター支援手術、放射線治療計画など、さまざまな臨床ワークフローの基盤となります。この重要な技術の発展には大量の高品質なデータが必要不可欠ですが、機密性の高い医療データを一元化することなく、複数の施設が協力してAIモデルを訓練することを可能にする「連合学習(Federated Learning, FL)」は、この課題を克服する有力な手段として注目されています。FLは、各施設が持つ機密性の高いデータを共有することなく、モデルの更新情報のみをやり取りすることで協力的な学習を実現します。
しかし、現実世界では、専門家によるアノテーション(ラベル付け)のばらつきや誤り、あるいは自動生成されたラベルの不完全さなど、いわゆる「ラベルノイズ」が頻繁に発生します。このラベルノイズは、輪郭の不一致、構造の欠落や追加、あるいは誤ったクラスラベルなど、様々な形で現れます。例えば、CT画像上の腫瘍の輪郭を専門家が正確になぞった「ラベル」が、別の専門家では異なる輪郭になることがあります。このようなノイズは、AIモデルの学習性能を著しく低下させ、最終的に診断の信頼性や治療計画の正確さに悪影響を及ぼす可能性があります。
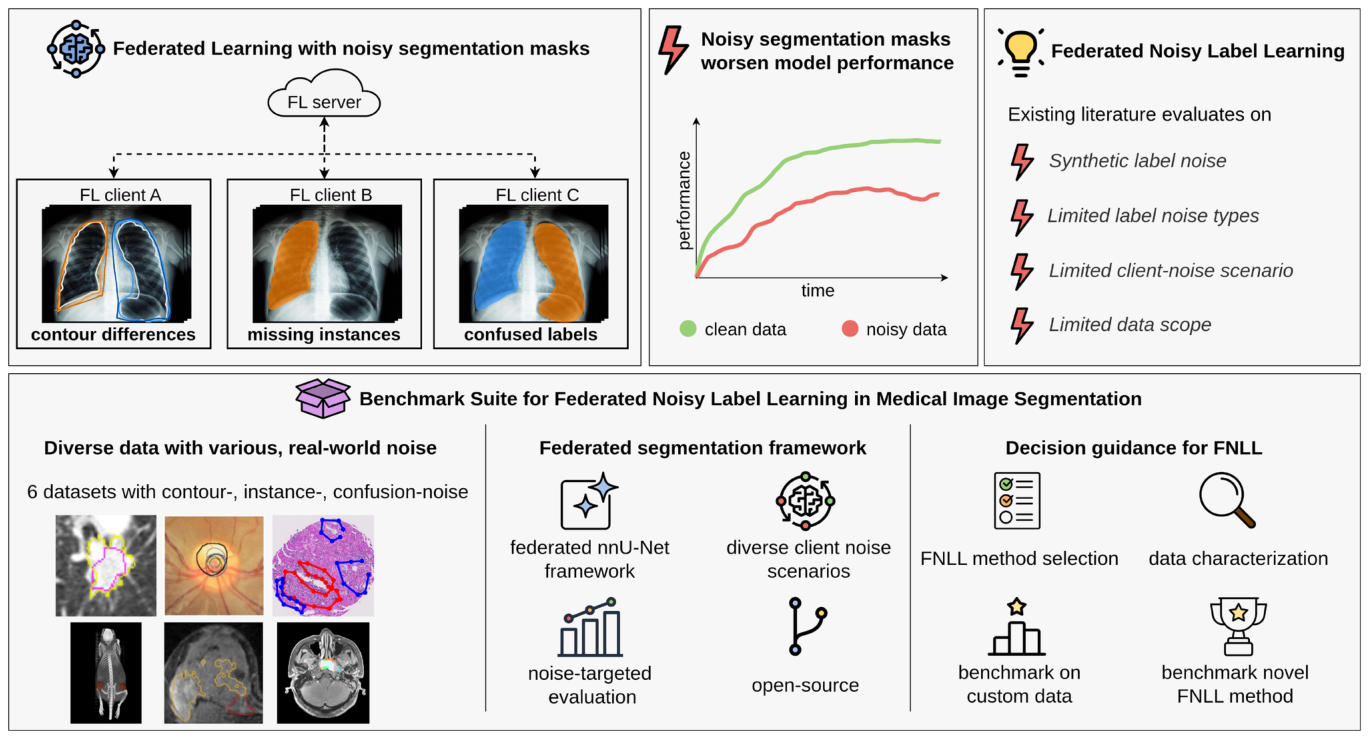
FL環境では、この問題はさらに複雑になります。複数の施設が独立してデータ収集やラベル付けを行うため、データやアノテーションの多様性が自然に増加します。さらに、FLのプライバシー保護の性質上、データやラベルの集中検査が制限されるため、ノイズの検出や軽減が困難になり、ノイズのあるクライアント(参加施設)が、そうでないクライアントの学習を阻害し、モデル全体の性能を劣化させる可能性があります。このような課題に対処するため、「連合ノイズラベル学習(Federated Noisy Label Learning, FNLL)」が開発されてきましたが、既存の評価は主に人工的なノイズや単純化された設定に基づいていることが多く、実世界での適用における有効性の判断が難しいという課題がありました。
実世界におけるFNLLのギャップを埋めるベンチマークスイート
本研究は、この実世界でのFNLL評価のギャップを埋めるため、包括的なベンチマークスイートを導入しています。このスイートは、多種多様な実世界のノイズデータセット、現実の展開に関連するクライアントノイズシナリオ、そしてラベルノイズに特化した評価方法を組み合わせることで、FNLL手法の体系的な評価と、情報に基づいた手法選択を支援します。このベンチマークスイートは、以下の4つの主要な統合コンポーネントで構成されています。
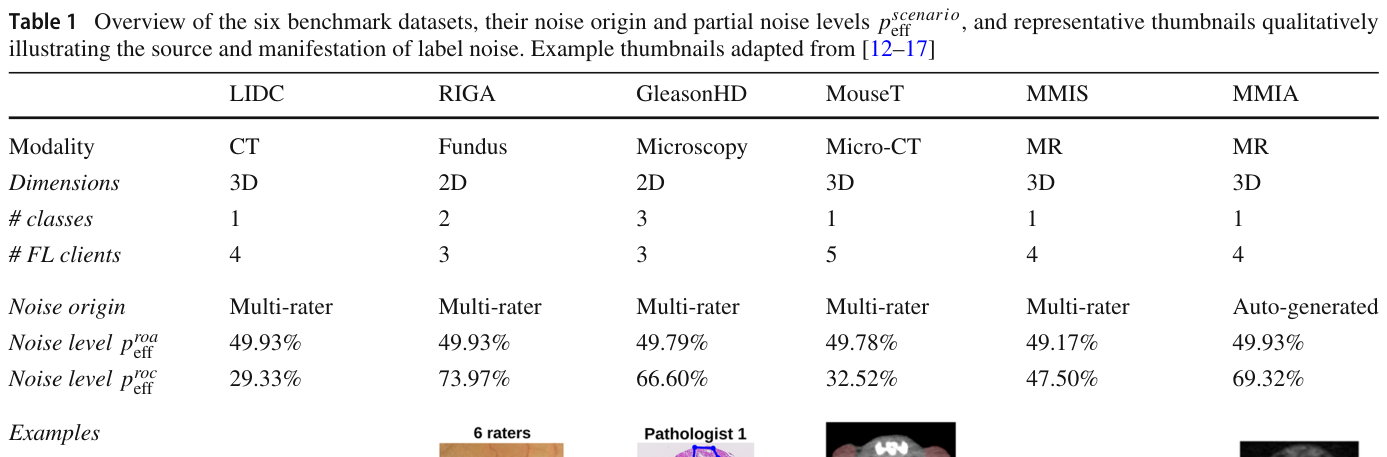
- 実世界のラベルノイズを持つ6つの医用画像セグメンテーションデータセット: これらのデータセットは、胸部CT、網膜眼底写真、前立腺組織病理顕微鏡画像、マウス腫瘍のマイクロCT、多臓器MRイメージングなど、多様な臨床領域とモダリティをカバーしています。これらのデータセットには、複数の専門家によるアノテーションのばらつきや、自動生成されたラベルに起因する実世界でのラベルノイズが内在しています。
- nnU-Netベースの連合セグメンテーションフレームワーク: これは、nnU-Netを連合学習向けに適合させたもので、最先端のFNLL手法と、展開に関連する様々なクライアントノイズシナリオを統合しています。
- ラベルノイズに特化した評価プロトコル: データセットやノイズ設定が異なっても、公平な比較を可能にするための評価プロトコルが設計されています。一般的なセグメンテーション性能はDiceスコアで評価され、特定のノイズタイプ(輪郭の不一致、ターゲットの欠落・追加、クラス混同)に対するロバストネスは、それぞれHD95、インスタンスレベルF1、クラス混同スコアで評価されます。
- 実用的な意思決定ガイド: 観測されたラベルノイズ特性に基づき、適切なFNLL戦略を選択するための実用的なガイドが提供されます。
このベンチマークスイートは、オープンソースとして公開されており、今後の研究者が再現可能な評価、データセット固有のラベルノイズ特性評価、そして新しいデータセットや手法への拡張を可能にするコミュニティリソースとなることを目指しています。
データセットとラベルノイズの詳細分析
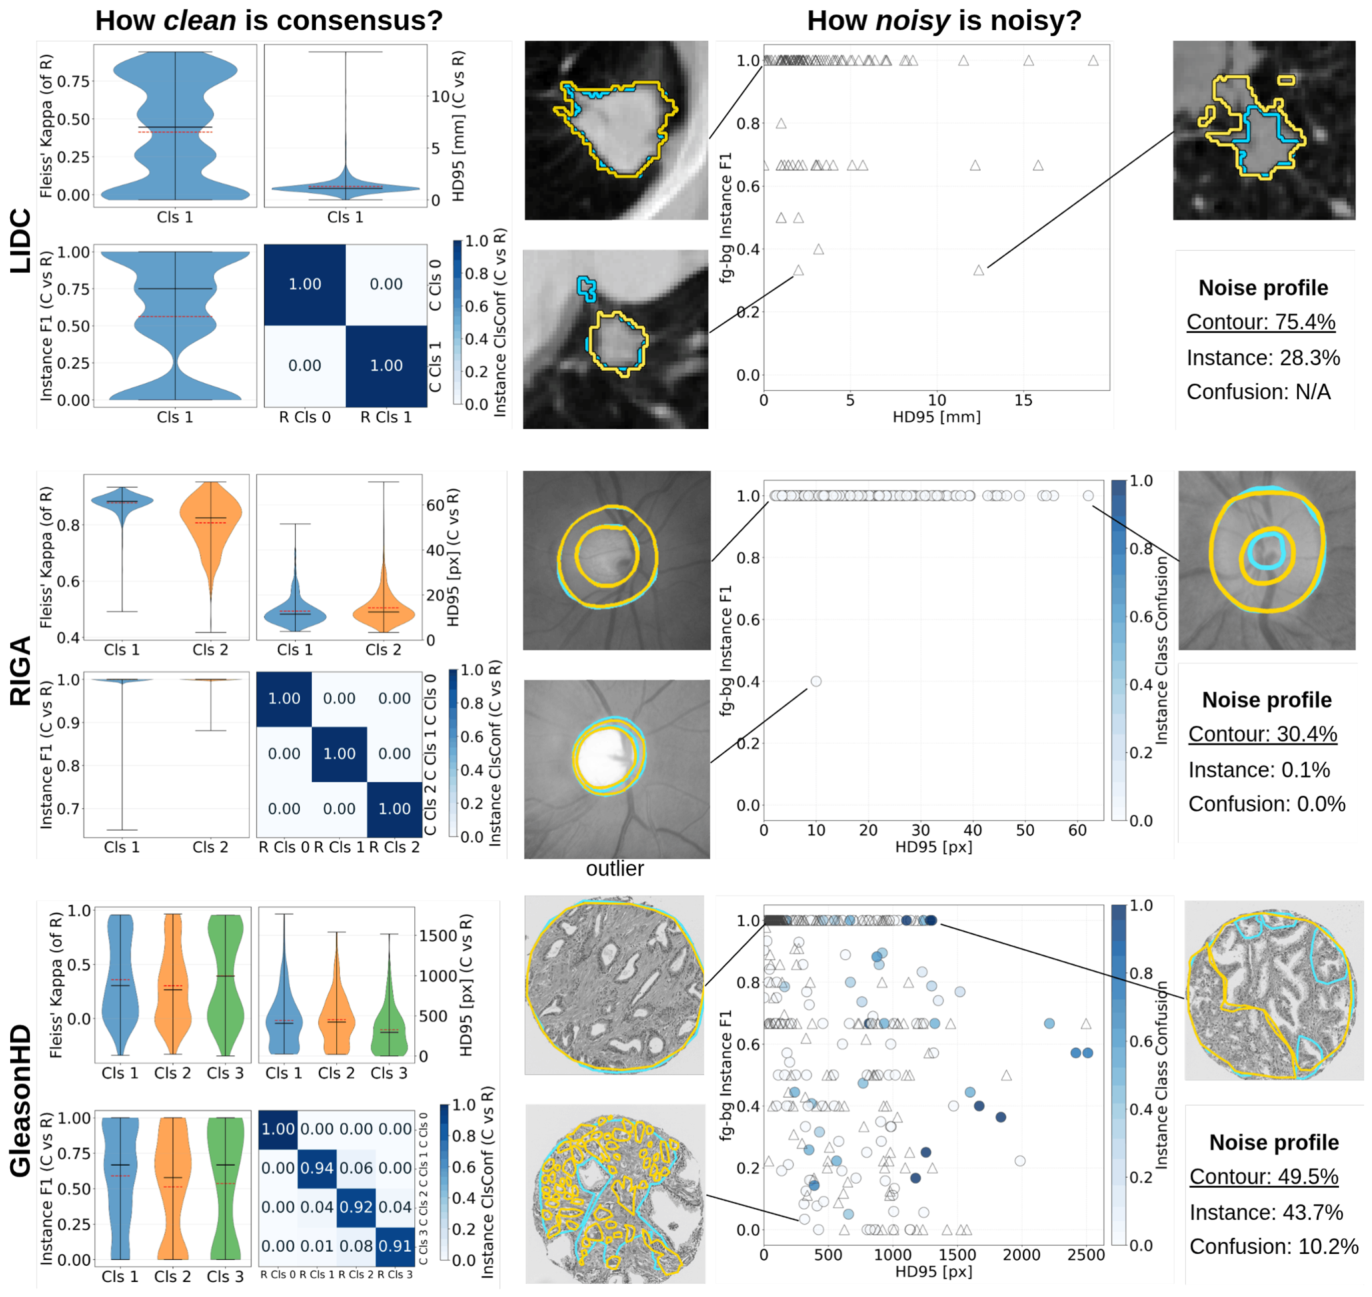
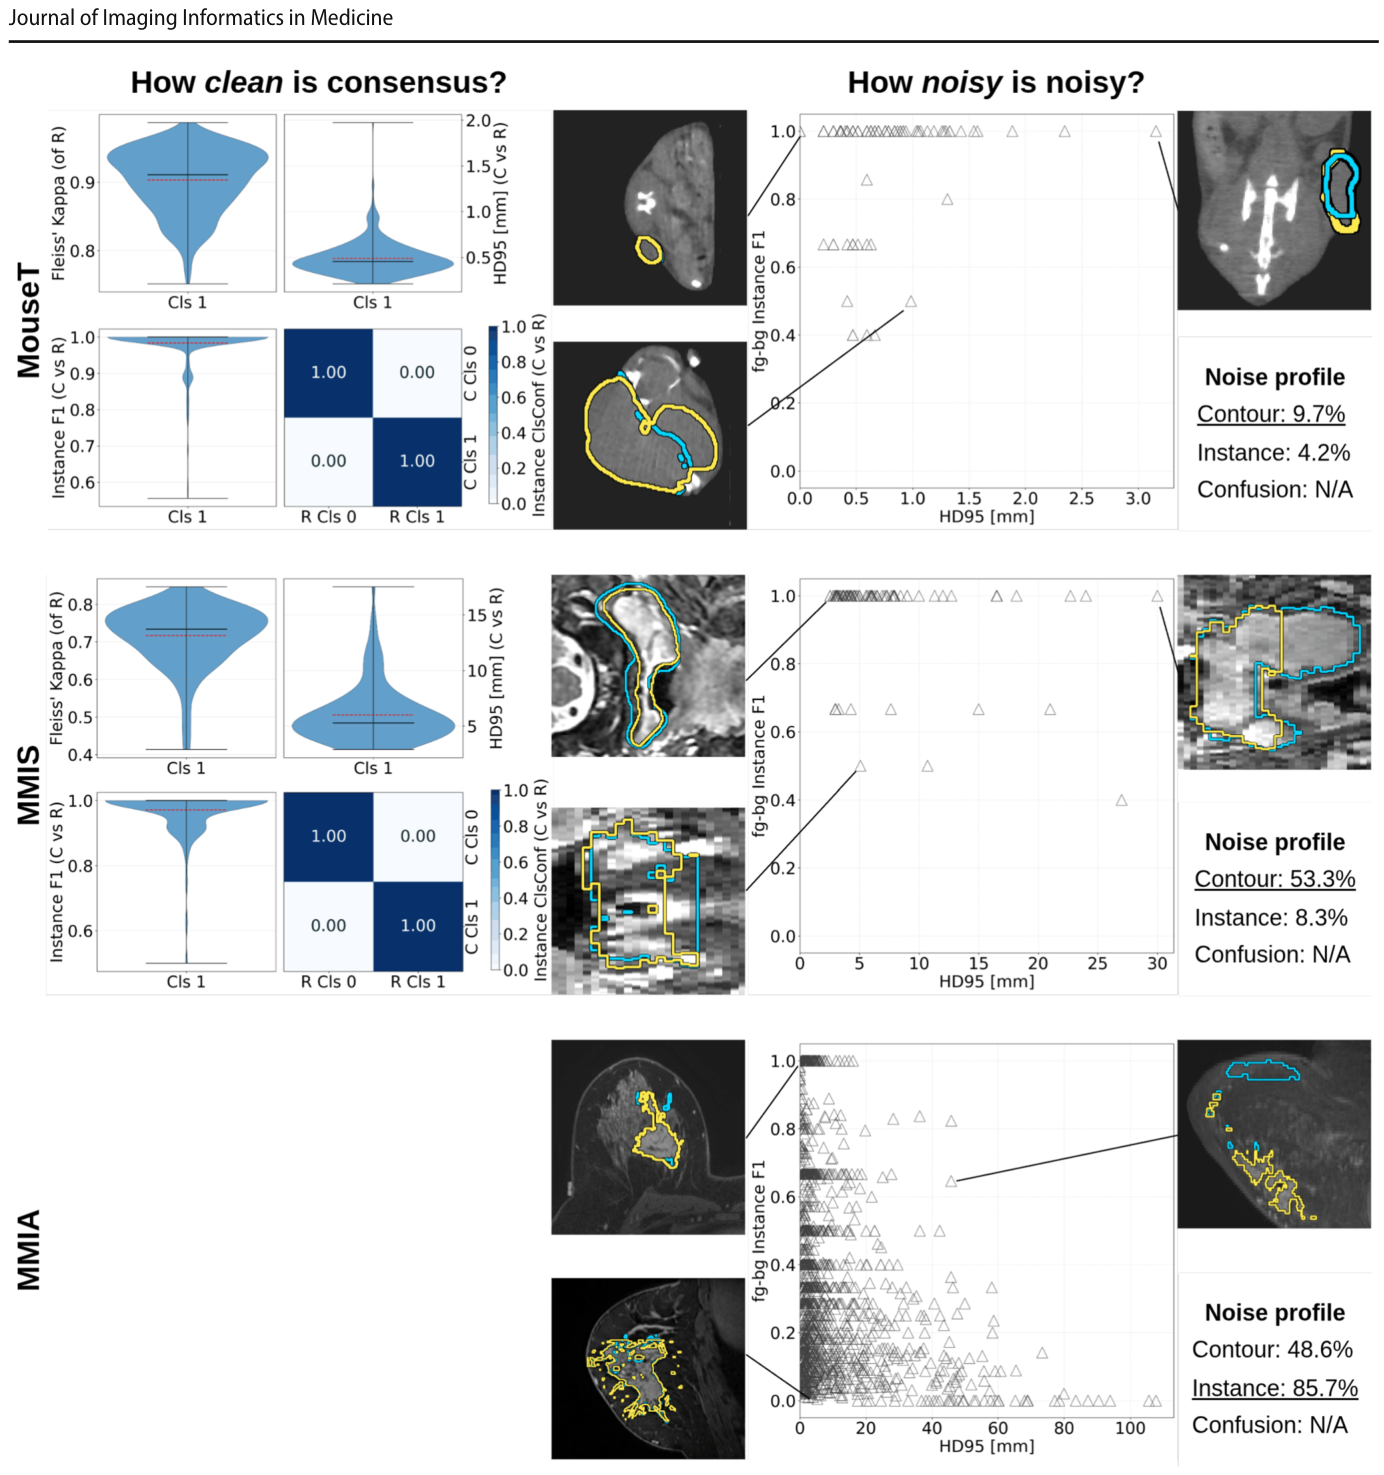
この研究では、ベンチマークに含まれる6つのデータセット(LIDC、RIGA、GleasonHD、MouseT、MMIS、MMIA)について、コンセンサスマスクの品質とノイズのあるマスクの特性を詳細に分析しています。
、
-
コンセンサスの品質: データセットによってコンセンサスの品質には大きな差が見られました。RIGAとMouseTは、専門家間の評価や専門家とコンセンサスの評価で高い一致度を示し、最もクリーンなコンセンサスマスクを有していました。LIDCとMMISは中間的な品質で、主に輪郭の一貫性(HD95)にばらつきがありました。GleasonHDは最もコンセンサスの清潔度が低く、専門家間の不一致が顕著で、クラス混同がより頻繁に発生していました。MMIAは専門家によるクリーンなアノテーションが提供されているため、この分析からは除外されています。
-
ノイズの特性: 定量的なノイズプロファイルは、データセット固有の明確な特徴を示しました。RIGAは主に輪郭ノイズが支配的で、インスタンスノイズやクラス混同ノイズはごくわずかでした。LIDCとMMISは主に輪郭ノイズが見られましたが、追加でインスタンスレベルのエラーも存在しました。MouseTは全体的にノイズの発生率が比較的低いデータセットでした。MMIAはインスタンスレベルのエラーが支配的で、これは自動生成されたノイズラベルと一致する結果です。GleasonHDは最も不均一なプロファイルを示し、輪郭ノイズ、インスタンスノイズ、クラス混同ノイズが組み合わさっていました。
FNLL手法の比較ベンチマーク結果
このベンチマークスイートを用いて、代表的なFNLL手法(FedA3I、IOP-FL、FedCorr、FedSelect)と、標準的な連合学習ベースラインであるFedAvgの性能を比較評価しました。
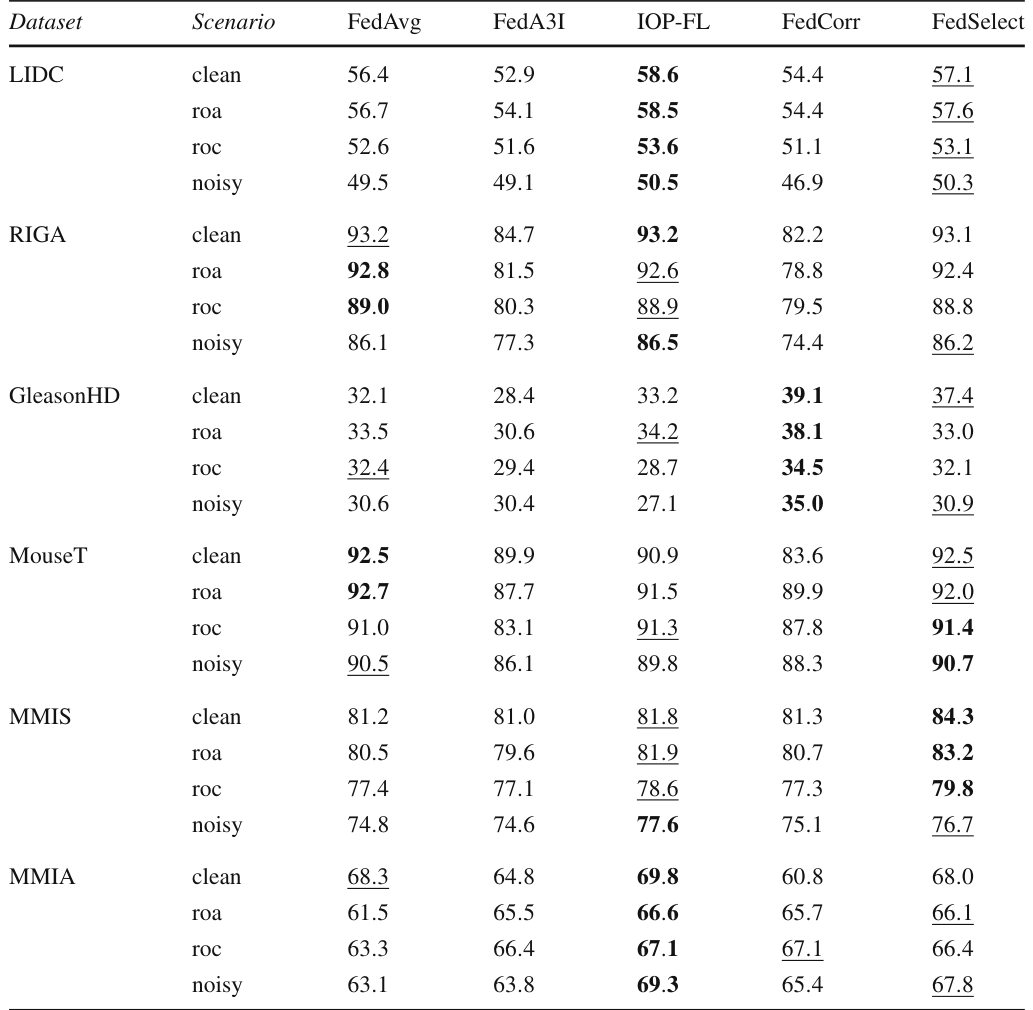
- 全体的な性能: データセットとクライアントノイズシナリオ全体で、FedSelectが最も安定して高い性能を示し、全体的に最も強力なFNLL手法であることが明らかになりました。IOP-FLも有力な競合手法であり、個々のデータセット・シナリオの比較では多くのケースで最も高いDiceスコアを達成しました。一方、FedAvgは依然として強力なベースラインであり、他のFNLL手法よりも優れた性能を示すこともありました。FedCorrはデータセットによって性能向上にばらつきがあり、FedA3Iは全体的に最も弱い性能を示し、しばしばFedAvgよりも改善が見られませんでした。
、
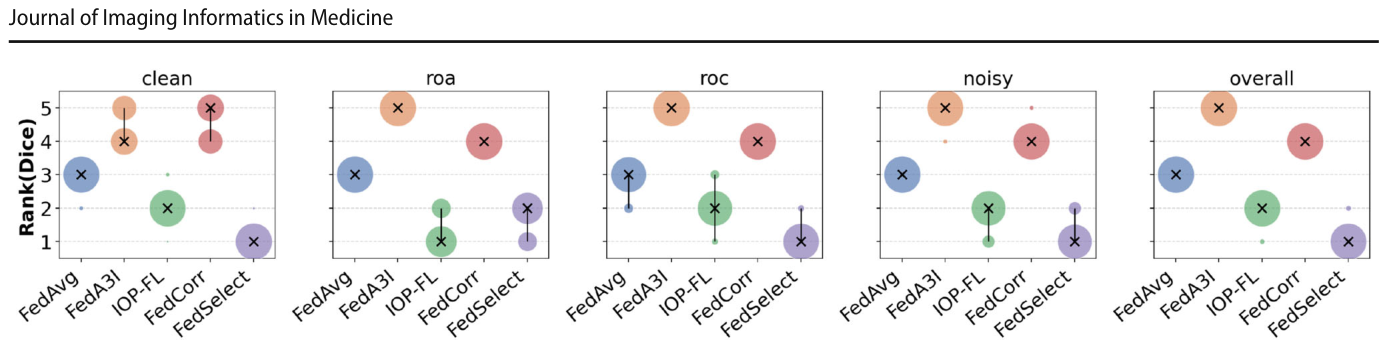
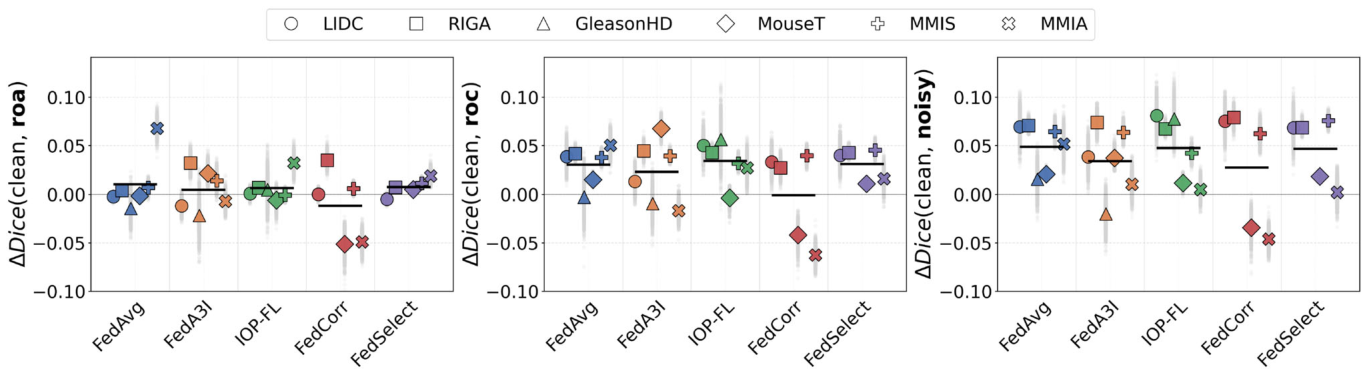
- ノイズの種類とロバストネス: クライアントノイズシナリオは「クリーン(clean)」「ノイズあり(noisy)」「一部のクライアントがノイズあり(roc)」「すべてのクライアントに一部ノイズあり(roa)」の4つが設定されました。クリーンなデータと比較したDiceスコアの低下を分析した結果、どのノイズシナリオでも性能低下は限定的でしたが、シナリオと手法によって差が見られました。特に、クライアント内の約50%のサンプルがノイズを持つroa設定では、比較的軽微な性能劣化に留まり、クライアント内での部分的なノイズに対するロバストネスが示唆されました。一方、一部のクライアント全体がノイズを持つrocシナリオや、すべてのクライアントが完全にノイズを持つnoisyシナリオでは、より大きな性能低下が見られました。
- ノイズタイプ別性能: ノイズタイプに特化した評価指標(HD95、F1、クラス混同)で分析した結果、FedSelectは3つのノイズタイプすべてにおいて最も一貫した性能を示しました。
- 輪郭の不一致(HD95): FedSelectが全体的に最も優れており、FedAvgを安定して上回る唯一のFNLL手法でした。
- ターゲット構造の欠落または追加(インスタンスF1): FedSelectが再び全体的に首位となり、IOP-FLとFedAvgがそれに続きました。
- ラベルのスワップ(クラス混同): GleasonHDデータセットのみがこのノイズタイプを対象としましたが、FedSelectが全体的に最も優れており、FedCorrがそれに続きました。ただし、GleasonHDは専門家間の強い不一致によりコンセンサスが限られているため、この結果は慎重に解釈する必要があります。
これらの結果を基に、ラベルノイズのタイプとクライアントノイズのシナリオに応じたFNLL手法選択の意思決定ガイドが作成されました。
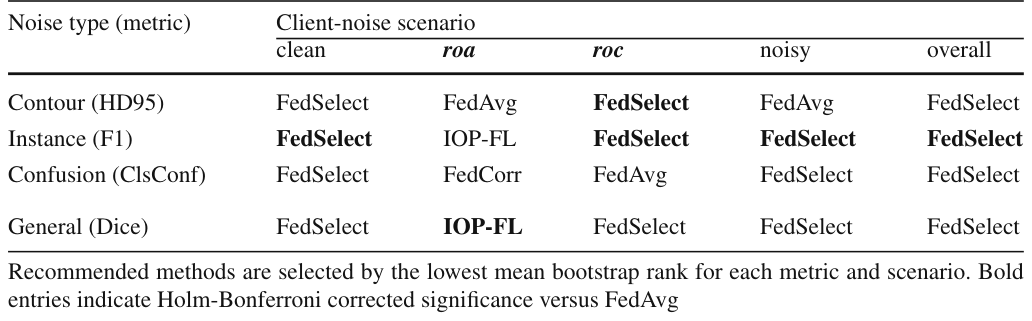
このガイドでは、FedSelectが堅実なデフォルトとして推奨される一方、特定の状況ではFedAvgやIOP-FLがより好ましい選択肢となる可能性が示されています。
実践的な活用と今後の展望
このベンチマークスイートは、FNLL手法のセグメンテーション性能だけでなく、通信コスト、計算オーバーヘッド、収束挙動といった実用的な側面も評価しています。通信コストは、すべての手法でnnU-Netのチェックポイント交換が支配的であり、手法固有のメタデータによるオーバーヘッドはごくわずかでした。計算オーバーヘッドは手法によって異なり、FedA3IとIOP-FLはベースラインに近く、FedCorrは中程度のオーバーヘッド、FedSelectはサンプルスコアリング、重み付け、メタモデル更新の繰り返しにより最も高コストでした(データセットによっては最大43.5~67.4%増加)。
「最適な」FNLL手法の選択は、セグメンテーション性能だけでなく、計算リソースの制約も考慮する必要があります。計算リソースに制約がない設定では、前述の性能に基づく意思決定ガイドが直接適用できますが、リソースが限られる場合は、IOP-FLやFedAvgといった計算効率の高い代替案を検討することが推奨されます。
このベンチマークスイートは、単なる比較研究に留まらず、以下の4つの主要なユースケースをサポートする拡張可能なリソースとして設計されています。
- 多施設アノテーションデータセットにおけるラベルノイズの特性評価。
- 特定のノイズのある展開設定に適したFNLL手法の選択。
- 新たに提案されたFNLLアルゴリズムを、既存の多様な手法に対して標準化された条件でベンチマーク評価すること。
- プライベートまたは新たに統合されたデータセットで、利用可能な最良のFNLL手法を評価すること。
研究の限界と今後の展望:
このベンチマークスイートは広範なデータセットと手法をカバーしていますが、いくつかの限界も存在します。データセットとノイズの網羅性は完全ではなく、超音波やPET、内視鏡などのモダリティ、血管や放射線治療ターゲットといったセグメンテーションタスク、より多様なアノテーションノイズパターンを持つプライベート展開データセットは含まれていません。また、ノイズタイプごとの網羅性には偏りがあり、輪郭ノイズに関する結論は最も確実ですが、インスタンスレベルノイズについてはより限定的であり、クラス混同や重度の混合ノイズ設定に関する結論は予備的なものです。
今後の研究では、このスイートに追加のデータセット、モダリティ、ノイズプロファイル、クライアント異質性設定、および手法を拡張することが求められます。また、ローカルウェイトの乖離、クライアントドリフト、FNLL手法の誤動作による自己強化エラーなど、手法固有のシステムレベルの挙動に関する詳細な調査も必要です。このリリースされたベンチマークリソースと貢献ワークフローは、まさにこのようなコミュニティ主導の拡張を支援することを目的としています。
結論
本研究は、実世界の多様なノイズデータセット、臨床的に関連性の高いクライアントノイズシナリオ、およびターゲットに特化した評価を組み合わせた、クロスサイロ医用画像セグメンテーションにおけるFNLLのためのベンチマークスイートを提示しました。データセット分析により、このスイートが複数の実用的に関連するセグメンテーションラベルノイズタイプをカバーし、データセットとノイズ体制全体での手法の挙動を解釈するための文脈を提供することが示されました。評価されたデータセット、手法、クライアントノイズ構成の範囲内では、FedSelectが全体的に最も強力な性能を達成し、IOP-FLが最も競合力のある代替手段でした。しかし、強力なFedAvgベースラインに対する性能向上は、データセット、ノイズ、およびシナリオに依存することが明らかになりました。
意思決定ガイドと技術コスト分析を合わせることで、このベンチマークは、より複雑なFNLL手法の普遍的な優位性を仮定するのではなく、実用的でコストを考慮したFNLL手法の選択を支援します。より広範なAIの文脈において、FNLLは慎重なアノテーション実践の代替ではなく、大規模な多施設モデル訓練のための追加的なロバストネス層として捉えるべきです。FNLLは、FLのプライバシーとラベル品質の問題に対処し、制限されたデータアクセス下でラベルノイズを軽減することを目的としており、本研究の結果は、FNLLが特定の手法、ノイズ、およびシナリオに依存する設定でロバストネスを向上させることができることを示しています。将来のロバストなFLパイプラインは、ローカルな品質管理と標準化、プライバシー保護型のラベル品質特性評価、および安定した連合インフラにおけるFNLL手法を組み合わせることで、直接的なデータ共有なしに信頼性の低い訓練信号を軽減すべきでしょう。このリリースされたスイートは、ラベルノイズ特性評価、公平な手法比較、エビデンスに基づいたFNLL手法選択、および新しいデータセットと手法の統合のための再利用可能な基盤を提供することで、医用画像セグメンテーションにおけるFNLLのコミュニティ主導の進歩を支援することを目指しています。
用語集
- 連合学習 (Federated Learning, FL): 複数の施設が互いにデータを共有することなく、モデルの更新情報のみを交換することでAIモデルを共同で訓練する学習手法。
- 医用画像セグメンテーション: 医用画像の中から臓器や病変などの特定の領域を自動的に識別し、その境界を区別する技術。
- ラベルノイズ: AIモデルの学習に使用される正解データ(アノテーション)に含まれる不正確さや誤り。専門家間の不一致やヒューマンエラーなどで発生する。
- 連合ノイズラベル学習 (Federated Noisy Label Learning, FNLL): 連合学習の環境下で、分散されたデータに存在するラベルノイズの影響を軽減するための学習手法。
- コンターの不一致: セグメンテーションにおいて、複数の専門家が同じ対象の輪郭を異なる形でアノテーションすること。
- インスタンスの欠落/追加: セグメンテーションにおいて、特定の構造(インスタンス)がアノテーションから欠落していたり、本来ない構造が追加でアノテーションされていたりするノイズ。
- クラス混同: セグメンテーションにおいて、あるクラスの対象が別のクラスとして誤ってアノテーションされるノイズ。
- FedAvg: 連合学習における基本的なモデル集約(Aggregation)手法。各クライアントのローカルモデルを平均化してグローバルモデルを更新する。
- FedA3I: ノイズ認識型集約手法の一つ。クライアントごとのセグメンテーション傾向を推定し、品質を考慮してモデル更新を層ごとに集約する。
- IOP-FL: ノイズにロバストな個別化(Personalization)手法の一つ。ローカルとグローバルの勾配情報を組み合わせて、クライアント固有の最適な学習を誘導する。
- FedCorr: ラベル修正手法の一つ。ノイズのあるクライアントを特定し、グローバル予測を用いて選択されたラベルを修正するパイプラインを持つ。
- FedSelect: サンプル選択手法の一つ。メタ学習を用いて重要度を認識し、信頼性の高いサンプルとクライアントを優先的に選択することでラベルノイズを軽減する。
- nnU-Net: 医用画像セグメンテーションにおける高性能なモデルフレームワーク。データ駆動型の自己構成により、多様なセグメンテーションタスクに適応できる。
- Diceスコア: セグメンテーション性能を評価する一般的な指標の一つ。予測結果と正解ラベルの重なり度合いを示す(値が高いほど良い)。
- HD95 (Hausdorff Distance 95th percentile): セグメンテーション結果の輪郭(境界)の誤差を評価する指標。予測と正解の境界間の距離の95パーセンタイル値(値が低いほど良い)。
- F1スコア: 欠落または追加されたターゲット構造の検出精度を評価する指標。特に、インスタンスレベルで予測と正解の一致度を示す(値が高いほど良い)。
コメントを残す