
臨床AI時代の精密医療:診断ラベル、疾患定義、エビデンスの課題とAIの役割
解説対象論文: Clinical AI and Precision Medicine: Philosophical Questions About Labels, Disease, and Evidence
Journal of Medical Systems|被引用数: 0(2026年9月15日時点)
精密医療は、個々の対象者の特性に合わせたケアを目指すものとして、その実現にAIが不可欠とされています。しかし、AIの導入は、疾患の定義、診断の閾値設定、エビデンスの評価といった、医療が長年抱えてきた哲学的課題を浮き彫りにします。本論文は、AIがこれらの暗黙の仮定を明確にし、単なる分類から意思決定中心の精密医療へと焦点をシフトさせるツールとして、いかに貢献できるかを探求しています。
はじめに:AI時代の精密医療における深遠な問い
どうも、Beyond the Pixelです。精密医療は、個々の対象者の特性に合わせた予防、診断、治療を目指すものとして期待されています。しかし、この壮大な目標の達成には、技術的な課題だけでなく、医療における分類、疾患概念、エビデンスといった、これまで暗黙のうちに運用されてきた概念に関する哲学的問いへの深い考察が不可欠です。本コメント論文は、臨床AIの進化が、これらの概念的な曖昧さを具体的な設計上の選択肢として明確にし、評価し、見直すための強力なツールとなり得ることを提示しています。専門家が日々の臨床で直面する課題は、連続的な生理学的変数を「診断」という二値的なカテゴリに分類する際の客観性の欠如です。この分類は、時間、資源、リスク許容度といった制約下での意思決定であり、その後の治療方針や経過観察を左右します。AIはこれらの選択自体を解消するものではありませんが、そのトレードオフを可視化し、特にコーディング目的で構築されたラベルが臨床ケアに再利用される際に生じる問題を浮き彫りにします。本稿では、臨床AIが直面する医療分類、疾患概念、エビデンスという三つの主要な課題に焦点を当て、これらが単なる技術的問題ではなく、医療がカテゴリを定義し、閾値を設け、行動を正当化し、十分なエビデンスを決定する方法に関する哲学的問題であることを論じます。AIは、臨床判断の代替ではなく、これらの前提を十分に明示し、検証し、修正するためのツールとして機能します。これは、ラベル中心のケアから、不確実性を認識し、時間と共に変化する「意思決定中心の精密医療」への転換を意味します。診断は修正可能な仮説として扱われ、分類は意図された臨床用途に合わせて設計され、エビデンスは透明で監査可能な推論として扱われるべきであると提唱されています。現代の医療システムでは、AIの出力がトリアージ、記録、リスク予測、ケアパスウェイに組み込まれており、その評価には目的に合ったラベル、縦断的な評価、監査可能な推論が求められます。分類や代理エンドポイントの誤りは、安全性、公平性、臨床上の信頼に影響を及ぼす可能性があるため、AIモデルが開発に使用した臨床ラベルや代理エンドポイントが、設定や対象者グループ間で同じ臨床概念を忠実に表しているかどうかの確認が不可欠です。
医療分類はエビデンス基盤
医療分類と用語(例えば、報告や請求のためのICD(International Classification of Diseases)や、臨床表現のためのSNOMED CT(Systematised Nomenclature of Medicine Clinical Terms))は、調和と相互運用性のツールとして機能します。これらはコミュニケーション、償還、サーベイランスを標準化しますが、「同じ」疾患とは何かについて、目的特有の仮定を内在しています。この点が重要となるのは、同じラベルが、集団報告、ベッドサイドでの意思決定支援、研究コホートの定義といった、それぞれ異なる粒度、妥当性、説明範囲を要求するタスクに日常的に使用されているためです。臨床AIは、ラベルとその意図された用途との間のミスマッチを定量化できます。診断コードで訓練された教師ありモデルは、これらのコードの構造と限界を継承します。ラベルがサーベイランスや請求のために最適化されている場合、モデルは臨床的に観察される疾患ではなく、符号化された疾患を学習してしまう可能性があります。臨床記述、検査結果、画像、波形、ウェアラブル信号、縦断的なケアパターンなどを含むマルチモーダルデータや非構造化データは、表現型の文脈、専門家の不確実性、時間的経過、治療反応を保持することができ、これらは符号化されたラベルでは省略される可能性があります。しかし、これらのデータもまた、記録の実践、コピー&ペーストされたテキスト、評価へのアクセス格差、専門家の判断を反映しています。マルチモーダルAIは「ラベル圧縮」を減らすことはできますが、臨床概念の定義、データの出所記録、意図された用途の特定といった必要性をなくすものではありません。さらなる複雑さとして、異なる設定間での「意味のずれ(semantic drift)」があります。同じ臨床症状が、地域のワークフロー(継続的な病態登録と遭遇時診断)、インセンティブ構造、確認検査の利用可能性に応じて異なる方法で符号化されることがあります。用語間のマッピングはこれを軽減できますが、概念的な不一致を解決するわけではありません。例えば、ICDコード化された診断とSNOMED CTの臨床概念、そしてUMLS(Unified Medical Language System)でのマッピングを合わせることはできますが、請求ラベルとメカニズム的表現型との間に誤った等価性の感覚を生み出し、不一致を隠蔽することさえあります。開発者にとって、これは単なる言葉の問題ではありません。ラベルの選択とマッピングの決定は、AIアルゴリズムの性能、移植性、そしてその後の公平性に影響を与える可能性があります。これらの懸念は、抽象的な用語定義に限定されるものではなく、電子カルテの表現型特定、リスク予測、トリアージ、集団健康管理、マルチモーダルモデリングといった日常的な臨床情報学タスクにも現れます。
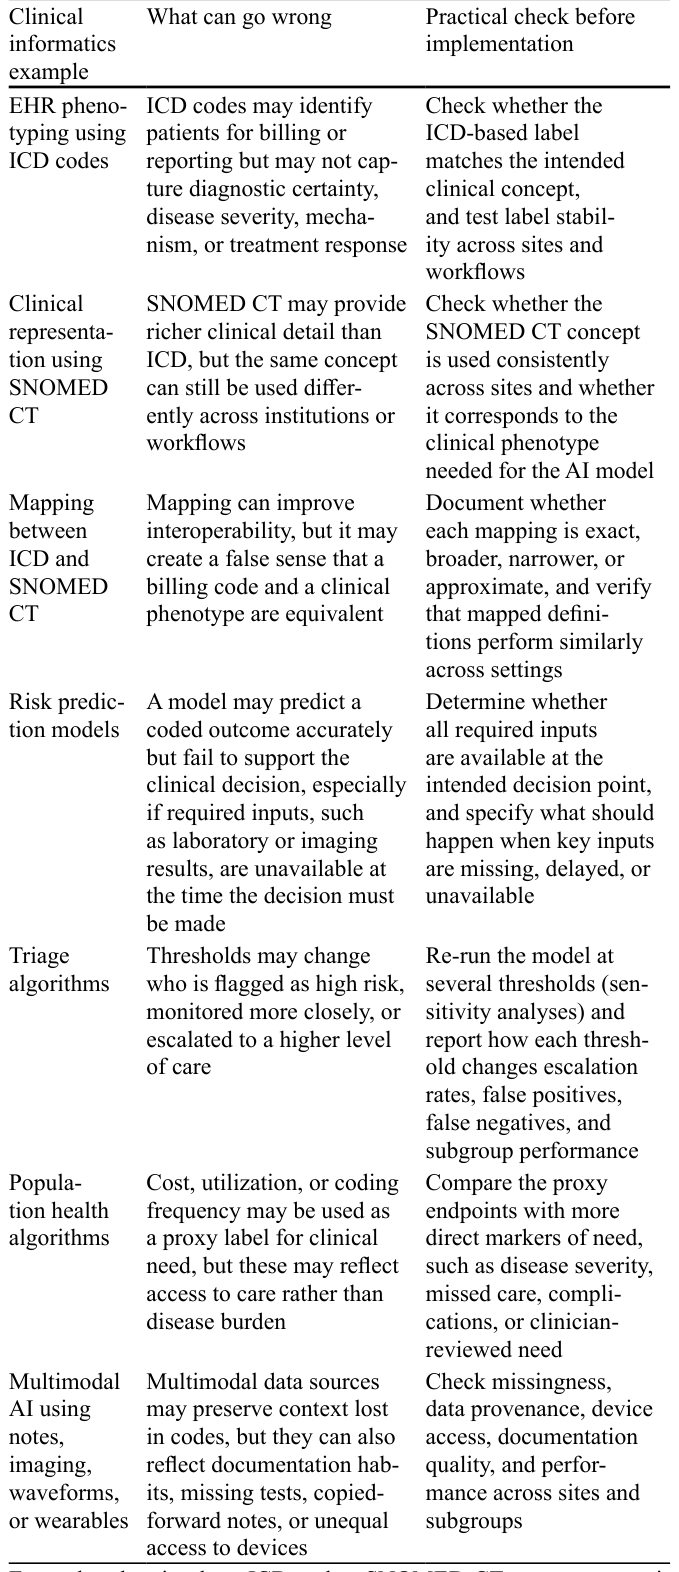
は、ICDコード、SNOMED CTの概念、用語マッピング、閾値、代理アウトカム、マルチモーダルデータがAIモデルの学習内容と、実装前にどのように検証されるべきかを具体的な例で示しています。
疾患の連続性:閾値、価値、AIが明確にできること
医療の哲学者は、疾患が純粋に生物学的に定義できるのか(自然主義)、それとも必然的に評価的な要素を含むのかについて、長らく議論してきました。Boorseの自然主義的説明は、疾患を種特有の機能に対する機能不全に焦点を当てていますが、Wakefieldの「有害な機能不全」分析は、疾患を機能不全と有害性の両方を含むハイブリッドなものとして扱っています。これらの議論は、血圧、血糖値、駆出率、骨密度、症状スケールなど、連続的な量的測定値から導かれる多くの診断が、カテゴリカルなラベルとして現れるため、日々の臨床業務で表面化します。しかし、臨床的な行動が離散的である以上、閾値は不可避です。哲学的および臨床的な問いは、その閾値が臨床意思決定を支援するのか、それとも臨床的に重要な異質性を覆い隠すのかという点です。Jutelによる過体重と肥満の歴史は、境界が時間とともにどのように変化し、その後の臨床的および社会的な結果に影響を与えるかを示しています。閾値の影響を測定可能にする3つの評価戦略があります。第一に、閾値感度分析は、カットオフ値の変更が診断、治療適格性、偽陽性、偽陰性、サブグループパフォーマンスにどのように影響するかを示します。第二に、マルチモーダルおよび縦断的モデルは、ラベル付けされた状態内の異質性を特定できます。例えば、同じ診断コードを共有しながらも、メカニズム、経過、または治療反応が異なる対象者グループの存在などです。第三に、意思決定分析法は、代替の閾値または表現が、経過観察、治療、治療強化、または予防資源の割り当てといった臨床的に関連する選択肢を改善するかどうかを評価できます。この意味で、AIは判断の必要性をなくすものではなく、分類に基づく判断の結果を可視化するものです。
分類を超えて:連続的・多次元的な疾患表現と継続的な疾患評価
疾患が多次元的で連続的であるならば、カテゴリカルな診断は精密医療にとって不十分な表現である可能性があります。PetersenとUrsinは、複雑な状態を診断クラスに強制的に当てはめることは「情報ボトルネック」を生み出し、臨床的に意味のある変動性を捨てることになり、モデル開発の「ゴールデンスタンダード」として扱われた場合に、歴史的および社会的な偏見を伝播させる可能性があると主張しています。彼らは「継続的疾患評価(Continuous Disease Assessment)」を提案しています。これは、重症度、進行、治療反応を生理学的空間における進化する推定値としてモデル化し、診断を終点ではなく修正可能な仮説として扱うものです。縦断的モデリング、マルチモーダル表現学習、時系列予測は、検査結果、画像、ウェアラブル信号、臨床テキストといった異種データストリームから潜在状態と軌跡を推定できます。ここでの主要な哲学的転換は、疾患を単なるコードのクラスとの関連付けではなく、不確実性下での状態推定として扱うことです。これは、専門家が時間と共に信念を更新する方法に近く、精密医療の目指すものとより一致しています。継続的評価は、行動に結びついている場合に最も有用です。対象者固有の軌跡推定は、経過観察の間隔、予防閾値、治療強化のタイミングを情報に基づいて決定できます。これらは通常、臨床推論では暗黙のうちに行われています。不確実性と共に軌跡を表示することは、臨床計画の継続、強化、または修正を支持する証拠も具体化します。
概念工学:AIが疾患概念の修正を促すとき
精密医療には、説明と介入を支援する疾患概念が必要です。ネットワーク医療は、疾患の表現型を相互作用する生物学的ネットワークの産物として扱い、疾患モジュールや経路レベルの組織を定義することで、この転換の基盤を提供します。AIは、共通の軌跡や治療反応を持つサブグループを特定したり、併存疾患構造を捉える表現を学習したり、代替分類が予測や臨床意思決定を改善するかどうかを評価したりすることで、これらの概念を操作的に活用できます。したがって、AIは単一の普遍的な疾患分類を定義するためではなく、目的に特化した疾患表現を評価するために使用されるべきです。サーベイランス、償還、メカニズム発見、治療選択、予後、予防資源の割り当てなど、異なる目的には異なる表現が適切である可能性があります。
エビデンスも分類問題:AIが意見の相違と不確実性を明確に
エビデンスベースド医療は、利用可能な最善のエビデンスに基づいて臨床意思決定を行うことを目指しますが、エビデンスには評価と解釈が必要です。エビデンスは、評価方法とツール、バイアスフレームワーク、そして関連性と適用可能性に関する判断を通じて作成され、ランク付けされます。経験的研究は、同じ研究に異なる評価ツールを適用すると、異なる判断が生じる可能性があり、同じツール内でも意見の一致が限定的であることが示されています。現代のフレームワークは、これらの判断を標準化しようとしています。GRADE(Grading of Recommendations, Assessment, Development and Evaluations)は、エビデンスの確実性と推奨の強さを評価するための構造化されたアプローチを提供します。RoB 2(the revised Cochrane Risk of Bias tool for randomized trials)は、ランダム化、意図された介入からの逸脱、欠測データ、アウトカム測定、選択的報告などの領域でバイアス評価を操作的に行います。PROBAST(Prediction model Risk Of Bias ASsessment Tool)は、予測モデル研究に対して同様の構造を提供し、バイアスのリスクと適用可能性に焦点を当てています。そして、AI予測モデルがエンリッチメント、事前スクリーニング、エンドポイント支援、またはリスク予測に使用される場合には、PROBAST+AIが特に関連性が高いとされています。AIツールは、研究の特徴を抽出し、感度分析を可能にし、不確実性を明示することで、エビデンス評価を支援できます。しかし、吟味しにくいワークフローに評価ルールを組み込むこともできます。LLM(Large Language Model)がエビデンスのスクリーニング、要約、または品質評価に使用される場合、モデル出力の再現性が測定されるべきです。出力の安定性は、そのバージョン、プロンプトの構造、エビデンスのソース、モデル設定、使用日、推論環境、および繰り返しの実行によって変動する可能性があります。したがって、LLM支援評価は、これらの条件を報告し、モデルの繰り返し実行の安定性を測定し、出力がエビデンス判断に影響を与える場合には、専門家による裁定を含めるべきです。臨床AIに対するエビデンスの強さはまだ不均一です。多くのシステムは、主に回顧的または観察的な検証によって支持されており、予測が管理をどのように変え、アウトカムを改善するかについての前向きな評価は限られています。この懸念は、周術期や小児麻酔、心臓病学のレビューによって示されており、バイアスのリスク、限られた外部検証、不確実な一般化可能性がAIアルゴリズムの臨床統合への障壁として特定されています。GRADEのような視点がここで役立ちます。研究のバイアスのリスクが高い場合、外部妥当性が不確実な場合、またはアウトカムが対象者にとって重要なエンドポイントではなく代理である場合は、信頼度が低下すべきです。AIツールはエビデンスの評価と説明責任を支援するかもしれませんが、明確な意図された使用声明、事前指定された評価計画、そして可能であれば臨床的影響の前向き評価の必要性をなくすものではありません。
診断、因果関係、そしてエンドポイント
診断的推論は単なるラベルの割り当てではありません。StanleyとHannaは、診断をアブダクションによる仮説生成と反駁として記述しています。専門家は説明を提案し、識別力のあるエビデンスを求め、データが蓄積されるにつれて修正し、診断を暫定的で修正可能なものとして扱います。新しいエビデンスが出現するにつれて診断はしばしば修正されるため、臨床AIは不確実性を報告し、新しいデータによる更新を支援し、一回限りの診断精度を提供するだけでなく、対象者の時間の経過に伴う経過と予測を整合させるべきです。精密医療は予測以上のものを必要とします。どの介入がどの対象者に役立つかについての行動可能な理解を必要とします。哲学的にも、これは因果関係の要件です。RussoとWilliamsonは、健康科学における因果関係の主張は、通常、メカニズム的エビデンスと差分生成(確率的)エビデンスの両方に依存し、どちらか一方だけでは不十分であると主張しています。因果推論フレームワーク(例えば、疫学で開発された反事実的推論)は、関連と介入効果の区別を形式化し、観察データから因果関係の主張を導き出すために必要な仮定を明確にします。しかし、AIモデルのエンドポイントが代理である場合に中心的な脆弱性が生じます。Obermeyerらは、将来の医療費を健康ニーズの代理として使用すると、医療費が罹患率ではなくアクセスや支出の差を反映するため、実質的な人種的偏見を生み出す可能性があることを示しました。したがって、エンドポイント、データソース、およびサブグループのパフォーマンスが直接検証されない場合、モデルは測定されたエンドポイントに対して正確であっても、臨床ニーズを誤分類する可能性があります。したがって、エンドポイントの特定は主要な方法論的ステップとして扱われるべきです。開発者は、関心のある臨床概念を定義し、いかなる代理エンドポイントも正当化し、その代理がサブグループや設定間で同様に振る舞うかどうかを評価すべきです。デジタルツールやケア利用へのアクセス格差といった構造的な不平等を反映する差異がある場合、統計的調整だけでは不十分です。モデルの出力がアクセスや利用ではなく臨床ニーズを反映するように、測定と展開を再設計する必要があります。
精密医療にとっての意味合いと実践的アプローチ
これらの議論を総合すると、「意思決定中心の精密医療」が目指すべき方向性として浮かび上がってきます。第一に、臨床業務は「ラベルの正確性」から「不確実性下での軌跡推定と行動」へと移行します。第二に、分類は、サーベイランス、償還、意思決定支援、治療選択といった目的に合わせて明確に設計され、単一の普遍的な分類法ではなく、表現間のマッピングを重視します。第三に、AIモデルが臨床上の信頼を獲得するためには、エビデンスは仮定、エンドポイント定義、バイアス制御が可視化された、監査可能なプロセスとなります。
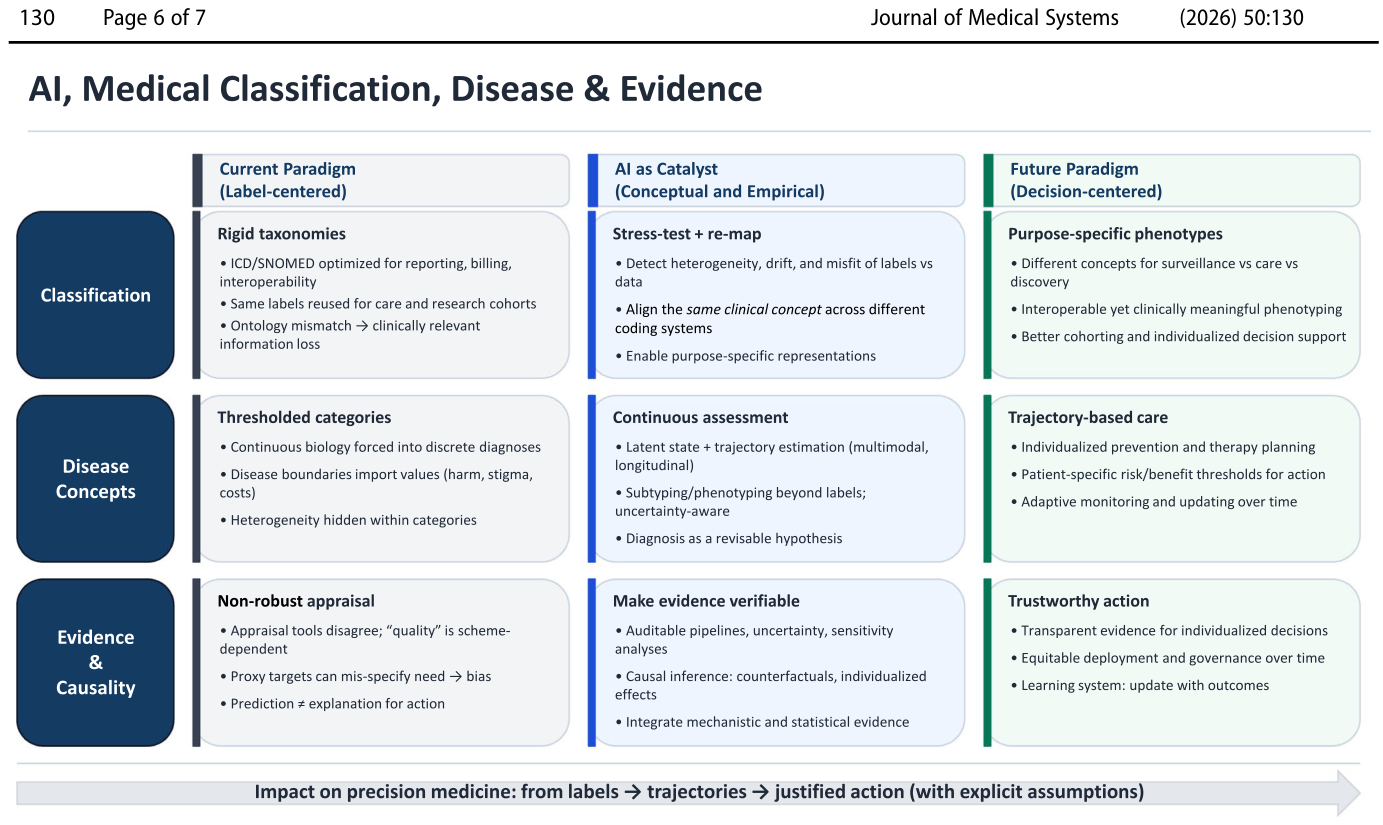
本図は、AIが医療における哲学的問いを探求する手段となり、意思決定中心の精密医療を推進する様子を示しています。分類、疾患概念、エビデンスと因果関係の側面から、現在のパラダイム(ラベル中心)からAIを触媒とした未来のパラダイム(意思決定中心)への移行を図示しています。この実装アプローチは、モデル開発者だけでなく、専門家や医療システムによっても運用可能です。
モデル開発者の役割:
- モデルが支援することを意図している臨床意思決定(診断、トリアージ、モニタリング、治療強化、予防、資源配分など)を明確に定義します。
- 関心のある臨床概念を定義し、モデルが直接測定を使用しているか、または代理ラベルを使用しているかを明記します。医療費、利用頻度、コーディング頻度、専門家の記録などの代理ラベルが使用される場合、開発者はその妥当性を説明し、サイトや対象者グループ間で同様に機能するかどうかを評価すべきです。
- モデルのラベル、入力、出力が、異なる電子カルテシステム、コーディング慣行、ワークフロー、対象者集団を含む様々な設定で安定しているかどうかを評価します。
- 評価には、ラベルの正確性だけでなく、意思決定に関連するアウトカムを含めるべきです。例えば、モデルがケアを変更するか、リスクのキャリブレーションを改善するか、見逃された診断や遅延診断を減らすか、より安全な治療決定を支援するか、公平性を改善するか、といった点です。
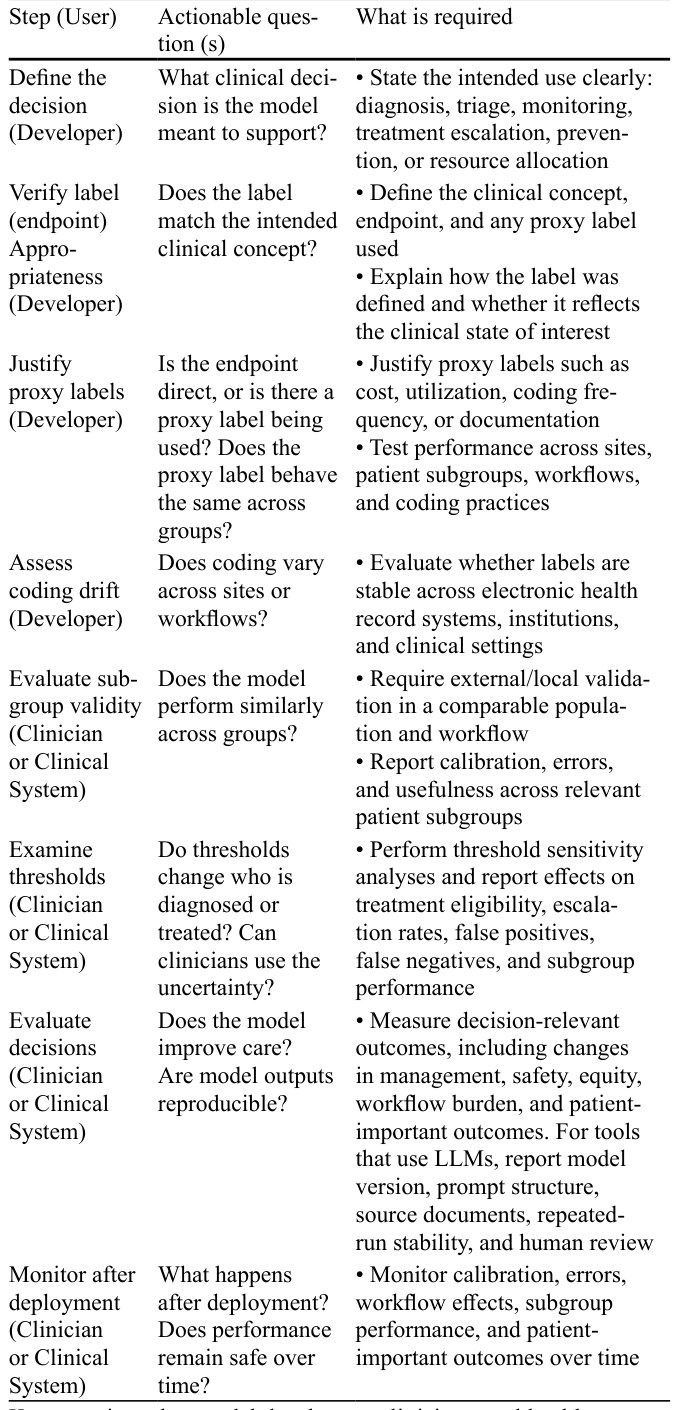
本表は、精密医療における臨床AIを実装するための実践的な問いを示しています。モデル開発者、専門家、医療システムが、AIツールが意図する臨床意思決定と整合しているか、設定や対象者グループ間で評価されているか、安全性、公平性、有用性について経時的に監視されているかを評価するための主要な質問が記載されています。
専門家と医療システムの役割:
- AIツールを導入する前に、そのツールがどのような意思決定を支援するために設計されているのか、開発中にどのようなラベルやエンドポイントが使用されたのか、自身の集団と同様の集団で外部検証が行われたのか、サブグループのパフォーマンスが報告されているのか、不確実性が専門家が利用できる形で示されているのか、といった問いを投げかけるべきです。
- LLMを使用するツールについては、モデルのバージョン、プロンプトの構造、ソース文書セット、繰り返し実行の安定性、および専門家によるレビュープロセスが報告されているかどうかも確認すべきです。
- 導入後には、キャリブレーション、エラー、サブグループのパフォーマンス、ワークフローへの影響、対象者にとって重要なアウトカムを時間と共に監視する必要があります。この見方では、実装はモデル開発の最終段階ではなく、エビデンスプロセスそのものの一部であるとされます。
結論
AIは、医療における分類、疾患、およびエビデンスに関する概念的な曖昧さを、検証可能で管理可能な設計上の選択肢に変えることで貢献できます。生理学をコードに圧縮する際に失われる情報を定量化し、連続的な状態および軌跡推定を支援し、エビデンス評価をより透明にすることができます。精密医療のためには、臨床AIは、明確な臨床概念、監査可能なエビデンスパイプライン、および目的に特化した疾患表現を使用して開発および評価されるべきです。本論文のキーメッセージは以下の通りです。
* 医療ラベルと用語は目的別に構築されたインフラであり、それに訓練されたAIは「符号化された疾患」を学習し、臨床的に重要な情報損失を定量化できる。
* 多くの病態は連続的で多次元的な状態として振る舞う。AIは、離散的な疾患クラスよりも、精密な意思決定をよりよく支援する縦断的な状態および軌跡推定を可能にする。
* エビデンス評価自体が分類問題である。AIは透明性と感度分析を改善できるが、評価ルールとエンドポイントは明示的で異議申し立て可能でなければならない。
* 精密医療は、AIモデルの性能を「ラベルの正確性」のみでなく、「意思決定に関連するアウトカム」と「公平性に配慮したエンドポイント」に対して評価すべきである。
用語集
- ICD (International Classification of Diseases): 疾病や関連する健康問題の国際的な分類システムで、主に統計報告や医療費請求に使用されます。
- SNOMED CT (Systematised Nomenclature of Medicine Clinical Terms): より詳細な臨床情報を表現するための包括的な医療用語体系です。
- UMLS (Unified Medical Language System): 異なる医療用語体系間のマッピングを可能にし、それらを統合するためのシステムです。
- 代理エンドポイント (Proxy Endpoint): 目的とする臨床アウトカムを直接測定する代わりに、それに代わる測定しやすい指標です。
- マルチモーダルデータ (Multimodal Data): 電子カルテの記述、画像、検査結果、ウェアラブルデバイスの信号など、複数の種類のデータを組み合わせたものです。
- 連続的疾患評価 (Continuous Disease Assessment): 疾患を固定された診断クラスではなく、重症度、進行、治療反応が時間とともに変化する連続的な状態として捉える評価方法です。
- ネットワーク医療 (Network Medicine): 疾患の表現型が、生体内の相互作用する生物学的ネットワークの産物であると考えるアプローチです。
- GRADE (Grading of Recommendations, Assessment, Development and Evaluations): エビデンスの確実性と推奨の強さを評価するための構造化されたアプローチです。
- RoB 2 (Risk of Bias tool for randomized trials): ランダム化比較試験におけるバイアスのリスクを評価するための改訂ツールです。
- PROBAST (Prediction model Risk Of Bias ASsessment Tool): 予測モデル研究におけるバイアスのリスクと適用可能性を評価するためのツールです。
- PROBAST+AI: AI予測モデルを対象としたPROBASTの拡張版で、品質、バイアスのリスク、適用可能性を評価するツールです。
- LLM (Large Language Model): 大規模なテキストデータで訓練されたAIモデルで、文章の生成や理解に用いられます。
コメントを残す