
胸部X線AIの最前線:CXR-LT 2026チャレンジが拓く長尾分布と未学習疾患診断の未来
解説対象論文: CXR-LT 2026 challenge: Multi-center long-tailed and zero shot chest X-ray classification
Medical Image Analysis|被引用数: 0(2026年10月2日時点)
医療画像診断、特に胸部X線(CXR)の分野では、AI技術の導入が目覚ましい進歩を遂げています。しかし、現実世界の臨床現場では、ごく一般的な疾患から非常に稀な疾患まで、さまざまな頻度の所見が混在しています。さらに、AIが訓練時に遭遇しなかった未知の疾患にも対応できる「オープンワールド」な能力が求められます。これらの課題に対処するため、CXR-LT 2026チャレンジが開催されました。このチャレンジは、長尾分布下の疾患分類、未知の所見に対するゼロショット汎化、そして多施設データセットでのモデルの堅牢性という、現代のCXR AIが直面する最も複雑な問題に焦点を当てています。本記事では、この画期的なチャレンジの目標、採用されたデータセット、評価方法、そして得られた主要な知見を詳しく解説し、今後の医療AIの方向性を探ります。
はじめに:現実世界の胸部X線診断AIが直面する課題
どうも、Beyond the Pixelです。医療画像診断において、胸部X線(CXR)は最も広く利用されているモダリティの一つです。しかし、CXRの所見は病変の種類によって発生頻度が大きく異なり、ごく一部の一般的な異常が大部分を占める一方で、多くの臨床的に重要な異常は稀にしか現れません。このような「長尾分布」(long-tailed distribution)は、標準的な深層学習モデルにとって根本的な課題を提示します。一般的なモデルは頻繁なクラス(Headクラス)に予測を偏らせる傾向があり、稀だが重要な「尾」(Tailクラス)に属する疾患の認識精度が低くなりがちです。さらに、実際の臨床環境は常に新しい所見が現れる「オープンワールド」(open-world)な性質を持っており、AIシステムは訓練時に学習していない未知の疾患にも対応できる必要があります。既存のベンチマークは、単一施設からの閉鎖的なクラスセットに依存することが多く、稀な疾患の有病率や新しい所見の出現を捉えきれていません。
これらの課題に対処するため、CXR-LTチャレンジシリーズが立ち上げられました。CXR-LT 2023は長尾分布下の多疾患分類のベンチマークを確立し、稀な疾患認識における主要な課題を特定しました。CXR-LT 2024ではラベル空間が拡大され、未知の所見への汎化能力を研究するための「ゼロショット」(zero-shot)タスクが導入されました。そして今回、CXR-LT 2026チャレンジは、これらの成功の上に構築され、より現実世界の臨床条件を反映するための新たな進化を遂げました。この最新版では、PadChestとNIH Chest X-rayという二つのデータセットからなる「多施設データセット」(multi-center dataset)が導入され、合計14万5,000枚以上の画像が含まれています。さらに、開発セットとテストセットはすべて専門家によってアノテーションされており、レポートから抽出されたラベルよりも信頼性の高い、臨床的に根拠のある評価を可能にしています。本記事では、このCXR-LT 2026チャレンジの概要を詳しく解説し、主要なタスク、データセット、評価結果、そして現在のAIシステムが抱える課題について深掘りしていきます。
CXR-LT 2026チャレンジの二つの主要なタスク
CXR-LT 2026チャレンジでは、現実世界の臨床ニーズに対応するため、二つの異なる中核タスクが定義されました。これらは、AIモデルが既知の疾患に対してどれだけ堅牢に分類できるか、そして訓練時には遭遇しなかった未知の疾患にどれだけ汎化できるかを評価することを目指しています。
タスク1: 長尾分布下の多疾患分類
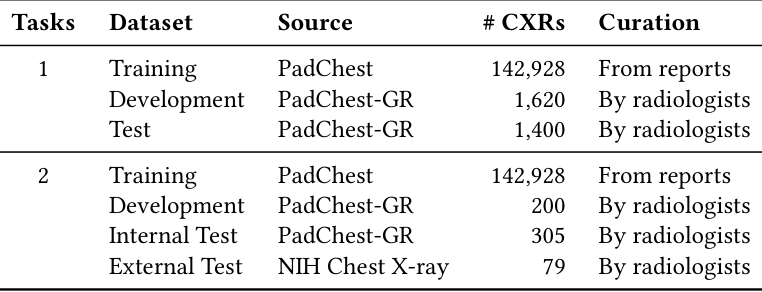
最初のタスクは、長尾分布下のCXR所見を認識するモデルの能力を評価します。参加者は、30種類の「既知の」(seen)疾患カテゴリーの有無を予測することが求められました。このラベルセットは、これまでのCXR-LTチャレンジから引き継がれた20クラスに、臨床的に一般的な異常をより良く捉えるためにPadChestデータセットから追加された10クラスを加えて構成されています。これにより、構造的異常、肺疾患、医療機器など、頻繁な所見から稀な所見まで幅広い胸部所見を網羅しています。モデルは、レポート由来のラベルが付与されたPadChestの大規模訓練データセットを使用して訓練されました。評価は、より信頼性の高い評価を確実にするため、専門家によってアノテーションされたPadChest-GRデータセットで行われました。
タスク2: 未学習疾患への汎化(ゼロショット学習)
二番目のタスクは、モデルが明示的な教師なしに、これまでに見たことのない疾患カテゴリーを認識する能力を評価します。このラベルセットはPadChest-GRから派生し、CXR-LT 2024で導入された「分布外」(out-of-distribution, OOD)の分類に基づいています。比較可能性を維持するため、以前のチャレンジと同じ5つのOODカテゴリーが保持され、さらに「甲状腺腫」(Goiter)という新たな所見が追加され、合計6つの「未学習の」(unseen)カテゴリーが含まれました。訓練中、モデルはタスク1と同じデータセットを使用しますが、これら6つの所見に関するラベルは受け取りません。このタスクの目標は、モデルが学習済みの視覚的表現を活用して、新しい疾患カテゴリーに汎化できるかを評価することです。この設定は、訓練中に明示的にアノテーションされなかった異常にモデルが遭遇する可能性のある現実的な臨床展開を反映しています。評価は、PadChest-GRからの内部テストセットと、NIH ChestX-rayデータセットからの外部テストセットの両方で行われ、異なるデータソース間でのモデルの堅牢性を評価しました。
データセットの詳細と評価プロトコル
CXR-LT 2026データセットは、PadChestとNIH ChestX-rayという二つの公開データソースから構築されており、大規模な訓練と臨床的に現実的な条件下での厳密な評価をサポートするように設計されています。特に、多施設間でのデータ変動が考慮されています。
訓練データとして使用されたPadChestは、142,928枚のCXR画像とスペイン語の放射線レポートから構成されており、レポートから自動抽出された疾患ラベルにより大規模な「弱教師あり学習」(weakly supervised learning)を可能にしています。評価には、専門家によってアノテーションされたPadChest-GRが使用され、タスク1では1,620枚の開発セットと1,400枚のテストセット、タスク2では200枚の開発セットと305枚の内部テストセットが用意されました。さらに、タスク2の汎化能力を評価するため、NIH ChestX-rayデータセットから79枚の外部テストセットが構築されました。NIHデータセットはPadChestとは異なる取得プロトコル、対象者集団、およびラベリング特性を持つため、自然な「分布シフト」(distribution shift)を導入し、施設間でのモデルの堅牢性を評価するのに役立ちます。
ラベル収集と倫理的配慮
ラベル収集は二段階のアノテーション戦略に従い、モデル開発のための大規模な弱教師あり学習と、評価のための専門家レベルのアノテーションを組み合わせています。訓練セットのラベルはPadChestに付随する構造化された英語所見ラベルから派生しており、これはPadChestデータセット作成者によって元のスペイン語レポートから抽出されたものです。開発セットと内部テストセットのラベルは、専門家によって手動でレビューされたPadChest-GRのアノテーションから導き出されています。NIH ChestX-rayからの外部テストセットについては、二段階の専門家判定プロトコルが用いられ、各画像が複数の専門家によって独立してレビューされました。この研究ではすべて公開されている匿名化されたデータセットのみを使用しており、新たな対象者データは収集されていません。
評価指標とチャレンジのタイムライン
CXR-LT 2026は、重度のクラス不均衡下での多疾患分類に焦点を当てています。この設定では、AUROC(受信者操作特性曲線下面積)のような標準的な評価指標は、長尾分布データセットにおける多数の陰性サンプルに性能が大きく影響されるため、誤解を招く可能性があります。この問題に対処するため、主要な評価指標として「平均適合率」(mean Average Precision, mAP)が採用されました。mAPは各クラスで独立して平均適合率を計算し、全クラスでマクロ平均をとることで、長尾分布下の多疾患設定においてより信頼性の高い性能測定値を提供します。補助的な指標として、AUROC、F1スコア、期待較正誤差(Expected Calibration Error, ECE)なども報告されました。チャレンジは、訓練フェーズ(2025年11月24日)、開発フェーズ(2025年12月1日~2026年1月19日)、最終評価フェーズ(2026年1月20日~2026年2月4日)という段階的なタイムラインで進行しました。
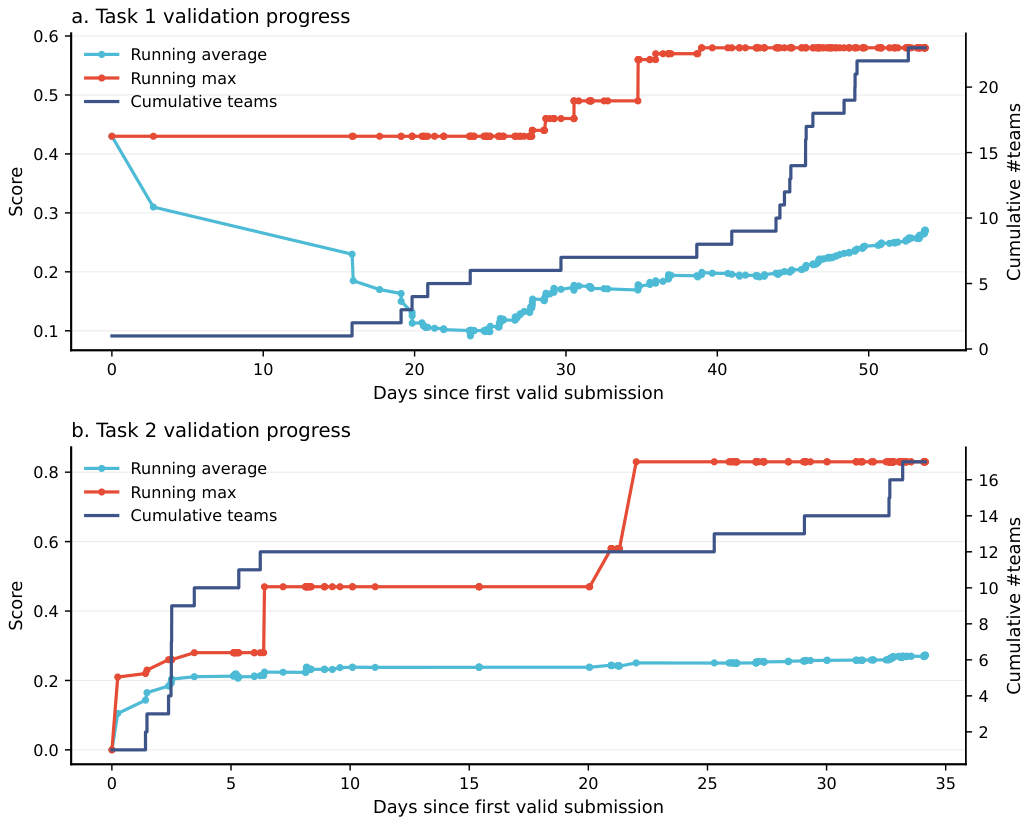
公平性を確保するため、外部データや公開されている事前学習済みモデルの使用は許可されましたが、CXR-LT 2026の開発セットやテストセットの画像で訓練されていないことが条件でした。タスク2では、より厳格なルールが適用され、6つのOODターゲットラベルを含む画像を教師あり学習に使用したり、これらのOODカテゴリに関する画像や同様のラベル監督を用いて事前学習されたモデルを使用したりすることは許可されませんでした。これにより、これらのOOD関連ラベルは教師あり訓練中に「未学習」であることが保証されました。
主要な結果と課題
CXR-LT 2026チャレンジから、いくつかの重要な観察結果が得られました。
参加手法の多様性
タスク1とタスク2で上位性能を示した手法は、それぞれ異なるアプローチを採用していました。
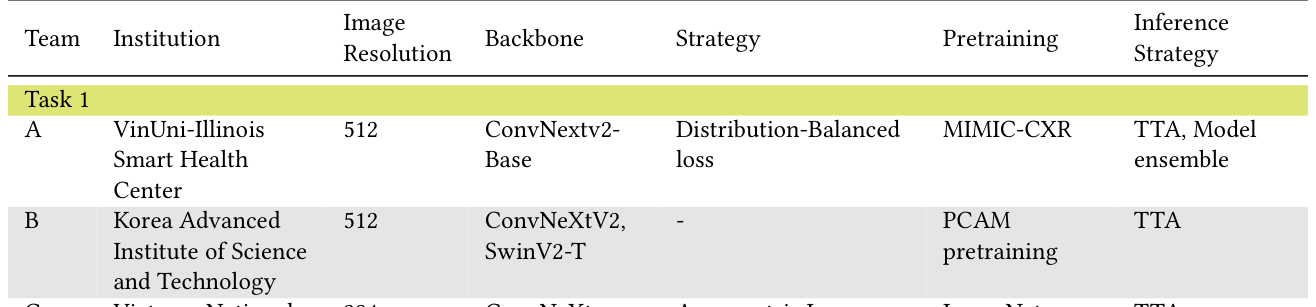
タスク1では、ほとんどの手法が畳み込みニューラルネットワーク(CNN)またはTransformerを基盤とし、長尾分布の影響を軽減するための損失再重み付けやサンプリング戦略などの技術を組み合わせていました。一方、タスク2では、「ビジョン言語モデル」(vision-language model)が主流であり、画像とテキストの共同表現を活用してオープンワールド汎化を実現していました。これらのアプローチは通常、プロンプトベースの推論やメトリックベースのマッチング戦略を採用しています。
性能の不均衡と較正の課題
最も性能の高い手法は一般的な所見に対して高いランキング性能を達成しましたが、長尾分布下の疾患においてはチーム間で大きな性能差が残りました。疾患頻度が低いカテゴリーでは、一貫して性能が低下する傾向が見られ、現在の手法が稀な異常の視覚パターンを捉えるのに依然として苦労していることを示唆しています。
また、異なる評価指標間での明確な不一致も観察されました。mAPやAUROCで高い性能を示すモデルが、F1スコアやリコールでは必ずしも高い分類性能を達成しないことが示されました。これは、予測の「較正」(calibration)と最適な閾値設定における違いを示唆しています。多くのモデルが最適な較正を示さなかったことも明らかになり、臨床現場で意思決定支援に不可欠な信頼性の高い確率推定が依然として課題であることを浮き彫りにしました。
オープンワールド環境での汎化の限界
モデルが訓練データに含まれていない未知の疾患カテゴリーを認識する必要があるオープンワールド環境では、性能が大幅に低下しました。ビジョン言語モデルがゼロショット性能を向上させたものの、全体的な結果は、新しい疾患概念への汎化能力が依然として限定的であることを示唆しています。この発見は、現在の教師あり学習アプローチと現実世界の臨床要件との間にギャップがあることを強調しています。
ロバスト性分析とデータ変動への感度
モデルのロバスト性(堅牢性)を評価するために、テスト時における「摂動」(perturbation)に対する追加分析が行われました。摂動とは、入力データに小さな変動を加えることを指します。この分析では、上位性能を示すモデルでさえ、入力の変動に対して依然として敏感であることが示されました。
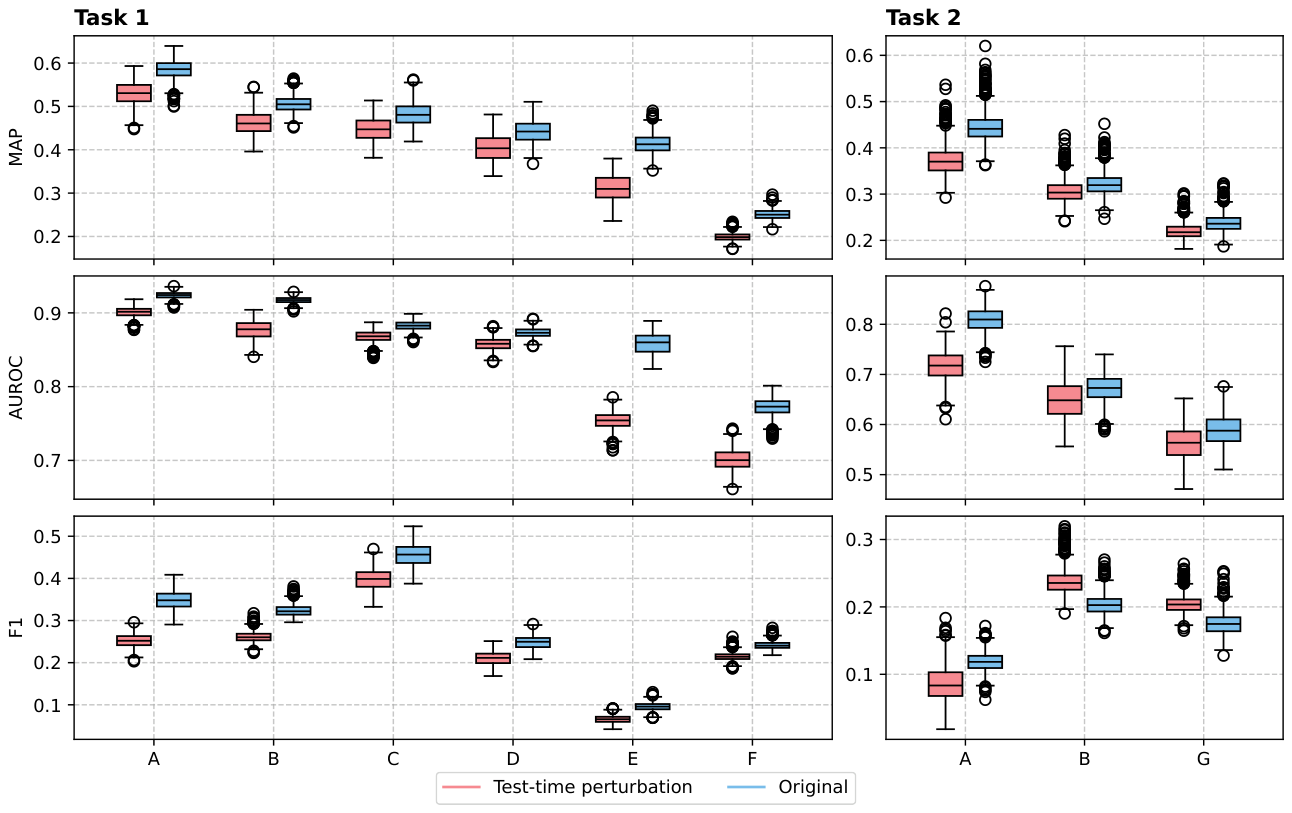
mAPやAUROCなどのランキングベースの指標でより顕著な性能低下が見られ、摂動が主に相対的なランキングに影響を与えることが示唆されました。
保持されたサブセットでの評価
さらに、利用可能なデータから構築された「保持された」(held-out)サブセットでモデル性能の安定性が評価されました。
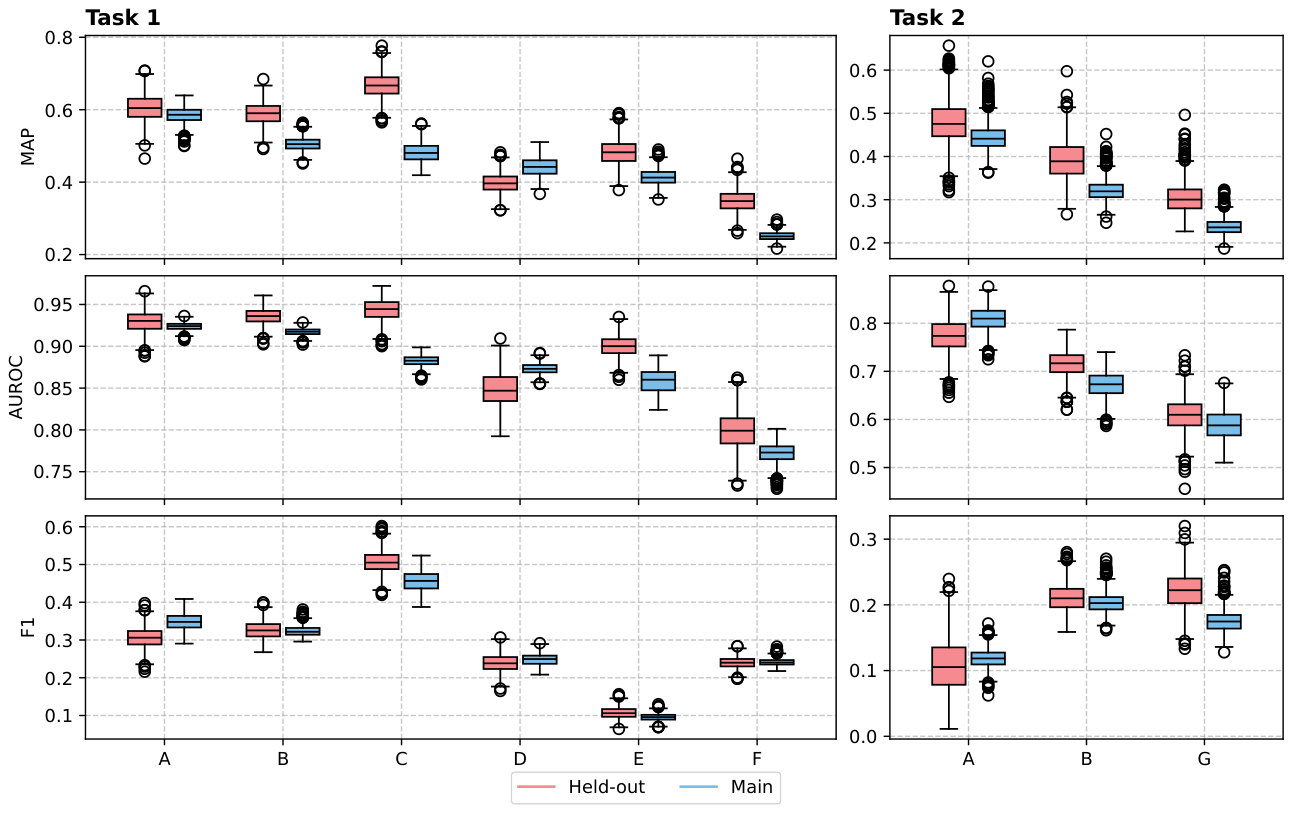
大規模な評価セットで良好な性能を示した手法は、保持されたサブセットでも高いスコアを達成する傾向があり、手法のランキングが異なるデータサンプル間で概ね安定していることが示されました。しかし、保持されたサブセットでの性能は、メインの評価セットよりも低い傾向が見られ、これはデータ構成の違いやサブセットのサンプルサイズが小さいことに起因する可能性があります。
疾患頻度と多施設汎化
疾患頻度によるモデル性能を詳細に分析したところ、疾患頻度が低いほどモデル性能が一貫して低下することが確認されました。正常および一般的な疾患カテゴリーではほとんどの手法が高い性能を達成しましたが、稀な疾患や超稀な疾患では性能が顕著に低下しました。これは、CXR分析における長尾認識の課題が依然として残っていることを浮き彫りにしています。
多施設汎化については、タスク2においてPadChest-GRの内部テストセットよりもNIH ChestX-rayの外部テストセットの方が、すべての参加手法でmAPが高くなるという興味深い結果が得られました。この原因は、両データセットのクラス有病率、ケース構成、ビューポジション、画像解像度、強度分布における実質的な違いに起因すると考えられます。NIHサブセットは、臨床的に明確な稀な所見をより多く含むように意図的に強化されていた可能性があり、この結果は外部ソースでの評価が本質的に容易であることや、多施設汎化の課題が完全に解決されたことを意味するものではありません。
考察と今後の展望
CXR-LT 2026チャレンジは、放射線AIにおける長尾認識、確率較正、データ変動に対するロバスト性、および多施設汎化といった、いくつかの未解決の課題を浮き彫りにしました。これらの課題に対処するには、より優れた表現学習、較正方法の改善、そして臨床設定間の分布シフトを明示的に考慮するアプローチが必要となるでしょう。
このベンチマークにはいくつかの限界もあります。第一に、NIH ChestX-rayサブセットは外部ソースでの評価を提供しましたが、79ケースと比較的小規模であり、稀なタスク2の所見を意図的に豊富に含んでいました。したがって、これは初期の多施設ストレステストとして解釈されるべきであり、現実世界の外部性能の決定的な推定値ではありません。より広範なケーススペクトル、マッチしたクラス分布、標準化されたアノテーションプロトコルを備えた大規模な外部コホートが、多施設汎化をより完全に特徴づけるために必要となるでしょう。第二に、大規模なPadChest訓練セットは、レポート由来の弱教師ラベルに依存しています。この設計は、現実的な弱教師あり条件でのスケーラブルなモデル開発を可能にしますが、レポート解析、不確実または否定された所見、類義語マッピング、およびレポートレベルの記述と画像レベルの異常との不完全な整合性により、ラベルにノイズが含まれる可能性があります。第三に、CXR-LT 2026は、外部データと事前学習済みモデルを非重複ルールとタスク2のOODラベル制限の下で許可しました。このポリシーは現代の放射線AIの実践を反映していますが、これはリーダーボードの性能が、モデルアーキテクチャと損失設計だけでなく、外部事前学習の規模とドメイン関連性、プロンプトエンジニアリング、ファインチューニングの選択、およびアンサンブルを含む、提出されたシステム全体を比較していることも意味します。これらの限界は、ベンチマークの結果を解釈する際に考慮されるべきであり、より大規模な外部テストセット、より詳細なデータ異質性分析、およびラベルノイズを減らすための継続的な努力を伴う将来のチャレンジ版を動機づけるものです。
結論として、CXR-LT 2026ベンチマークは、長尾認識、確率較正、データ変動へのロバスト性、および多施設汎化を含む放射線AIのいくつかの未解決の課題を浮き彫りにしました。これらの問題に対処することは、表現学習の改善、より良い較正方法、および臨床設定間の分布シフトを明示的に考慮するアプローチを必要とすると考えられます。このベンチマークは、これらの問題を現実的な条件下で研究し、よりロバストで臨床的に適用可能なモデルを開発するための統一されたテストベッドを提供します。
用語集
- 長尾分布: データセット内で一部の項目(疾患)が非常に多く出現し、多くの他の項目は稀にしか出現しない分布のこと。AIモデルが稀な項目を学習しにくい課題がある。
- オープンワールド: AIモデルが訓練時に見たことのない新しいクラスやデータに遭遇する可能性のある現実世界の環境。
- ゼロショット: AIモデルが訓練時に明示的なラベルなしに、未知のカテゴリーや概念を認識する学習方法。
- 多施設データセット: 複数の異なる医療施設や機関から収集されたデータを含むデータセット。AIモデルの汎化能力を評価するために重要。
- 多疾患分類: 一つの画像に対して複数の異なる疾患の有無を同時に予測する分類タスク。
- 弱教師あり学習: アノテーションが不正確であったり、詳細が少なかったりする「弱い」ラベル情報を用いてモデルを訓練する手法。
- 分布シフト: 訓練データとテストデータの間に統計的な特性の差異があること。AIモデルの性能低下につながる可能性がある。
- 平均適合率 (mAP): 多クラス分類や物体検出で用いられる評価指標。各クラスの適合率を計算し、その平均をとることで、特にクラス不均衡がある場合に有用。
- AUROC: 受信者操作特性曲線下面積。二値分類モデルの性能を評価する指標で、真陽性率と偽陽性率の関係をグラフ化した曲線の下の面積。
- 期待較正誤差 (ECE): AIモデルの予測確率が実際の事象の頻度とどれだけ一致しているかを示す指標。低いほどモデルが信頼できることを示す。
- ビジョン言語モデル: 画像(ビジョン)とテキスト(言語)の両方の情報を統合して処理するAIモデル。
- 摂動: データに意図的に加える小さな変更やノイズ。AIモデルのロバスト性(堅牢性)を評価するために用いられる。
- 保持されたサブセット: 訓練や主要な評価には使用されず、モデルの汎化性能や安定性を検証するために別途確保されたデータの一部。
コメントを残す