
胸部X線レポート自動生成の最前線:BLIX-Rayが拓く新時代
解説対象論文: BLIX-Ray: Chest X-Ray Report Generation with Vision-Language Models and Reinforcement Learning
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年10月21日時点)
放射線レポート作成の負担軽減と精度向上を目指し、AIモデル「BLIX-Ray」が登場しました。このモデルは、視覚と言語を融合した最新技術と強化学習を組み合わせ、胸部X線画像から質の高いレポートを自動生成します。本記事では、この革新的な技術がどのように機能し、医療現場にどのような変革をもたらす可能性を秘めているのかを詳しく解説します。
導入 – 放射線レポート作成の課題と自動化の必要性
どうも、Beyond the Pixelです。医療における画像診断は、病気の早期発見や治療方針の決定に不可欠です。中でも胸部X線撮影(CXR)は世界で最も頻繁に行われる画像検査であり、数多くの生命を脅かす疾患のスクリーニング、診断、管理に必要とされています。しかし、これらの医療画像を解釈し、詳細な放射線レポートを作成するには、高度な専門知識と細部への注意が必要であり、放射線専門家にとって大きな負担となっています。手動でのレポート作成は、専門家内および専門家間でのばらつき(intra-labeler and inter-labeler variability)を引き起こし、診断結果や対象者の治療の一貫性を損なう可能性があります。また、専門家の集中力や判断の変化も課題となります。これらの課題に対処するため、胸部X線画像に特化した自動放射線レポート生成モデルの必要性が高まっています。AIによる自動化は、ワークフローの優先順位付け、臨床的意思決定支援、大規模なスクリーニング、そして全世界的な対象者の健康増進に多大なメリットをもたらすことが期待されています。
BLIX-Rayとは?革新的なアプローチ
この研究では、放射線レポート作成の課題を解決するため、胸部X線画像用の自動レポート生成モデル「BLIX-Ray」が提案されています。BLIX-Rayは、Vision-Language Model(VLM)と呼ばれる視覚情報(画像)とテキスト情報(言語)を統合的に処理するAIモデルを活用し、転移学習と強化学習を組み合わせることで、精度の高いレポート生成を目指しています。BLIX-Rayは、医療現場におけるレポート作成の効率化と標準化を支援する可能性を秘めています。
Vision-Languageモデル(VLM)と転移学習の融合
BLIX-Rayの中心にあるのは、事前学習済みのBLIPモデルです。BLIPは、画像とテキストの豊富な表現を抽出し、整合するために設計されたVLMで、本研究では転移学習のアプローチを用いています。転移学習とは、あるタスクで学習済みのモデルの知識を、別の関連タスクに適用する学習手法です。BLIX-Rayは、このBLIPモデルを医療画像ドメインに特化するようにファインチューニングすることで、複雑な視覚情報とテキスト情報を効果的に結びつけ、医学的に関連性の高いレポートを生成します。このファインチューニングの過程では、BLIPの事前学習された知識を保持しつつ、X線画像からのドメイン固有の特徴抽出や医療言語理解・生成能力を高めるために、一部の層のみを訓練可能にしています。
強化学習(RL)による最適化
BLIX-Rayの性能をさらに向上させるために、強化学習(RL)が導入されています。強化学習とは、エージェントが環境との相互作用を通じて試行錯誤し、報酬を最大化するように行動を学習する機械学習の一種です。このアプローチでは、レポート生成の評価指標であるCIDErを報酬関数として直接最適化します。CIDErは、参照レポートとのn-gramの一致度を評価する指標で、特に稀で情報量の多いn-gram(連続する単語の並び)に高い重要度を与えるため、正確な専門用語が不可欠な医療レポート作成に適しています。この強化学習によって、モデルは文脈的に正確で、専門家が作成した参照レポートにより合致するレポートを生成するように学習が進められます。具体的には、ポリシー勾配アルゴリズムを用いてモデルパラメータを更新し、CIDErスコアが高いレポートの生成を促します。これは、従来の教師あり学習のみでは捉えきれない、臨床的に意味のある基準に生成を合わせることを可能にします。
評価と優れた性能
BLIX-Rayモデルの有効性を検証するため、著者らは2つの公開データセット、Indiana University Chest X-ray Collection(IU-Xray)とCheXpert Plusを用いて評価を行いました。これらのデータセットは、それぞれ胸部X線画像とそれに対応する放射線レポートのペアを含んでいます。CheXpert Plusデータセットは、223,228組のユニークな放射線レポートと胸部X線画像から構成され、特に詳細な「Findings(所見)」セクションに焦点を当てて評価されました。一方、IU-Xrayデータセットは、7470枚の画像と3955件のレポートを含み、広く採用されている80%/20%の訓練・テスト分割プロトコルに従って評価されました。
評価指標とBLIX-Rayの強み
レポート生成の品質を評価するために、Bilingual Evaluation Understudy (BLEU)、Recall-Oriented Understudy for Gisting Evaluation (ROUGE-L)、Consensus-based Image Description Evaluation (CIDEr)、Metric for Evaluation of Translation with Explicit Ordering (METEOR)、Bidirectional Encoder Representations from Transformers (BERTScore)の5つの主要な指標が用いられました。これらの指標は、生成されたレポートが参照レポートとどれだけ類似しているかを多角的に評価します。実験の結果、BLIX-RayはCheXpert Plusデータセットにおいて、CIDEr(0.4894)、METEOR(0.1582)、BERTScore(0.8407)で最高スコアを達成しました。また、IU-Xrayデータセットにおいても、CIDEr(0.6534)とBERTScore(0.8765)で他の比較手法を上回る結果を示しています。
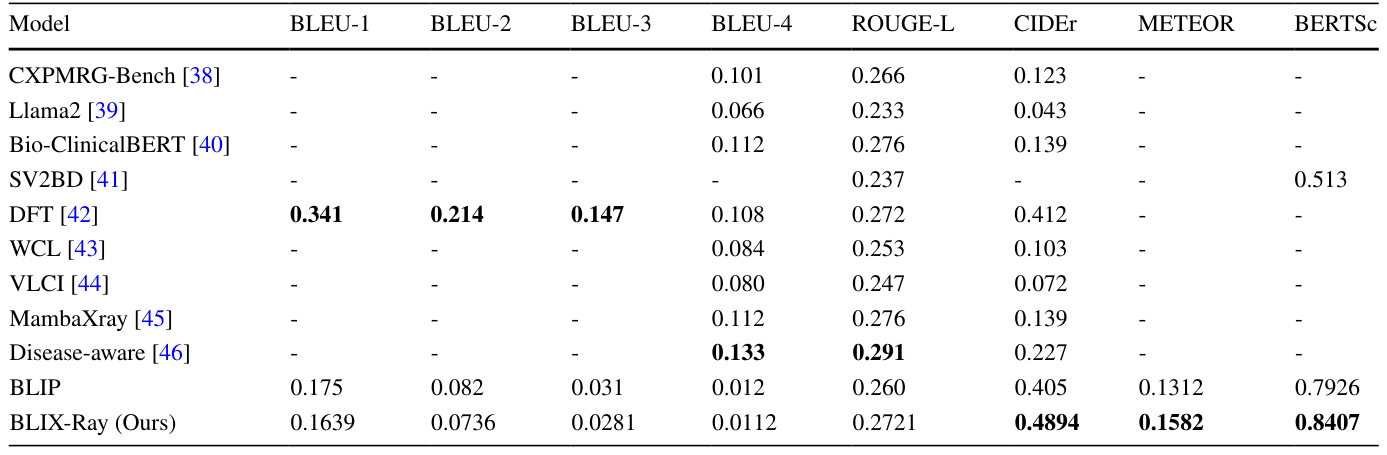
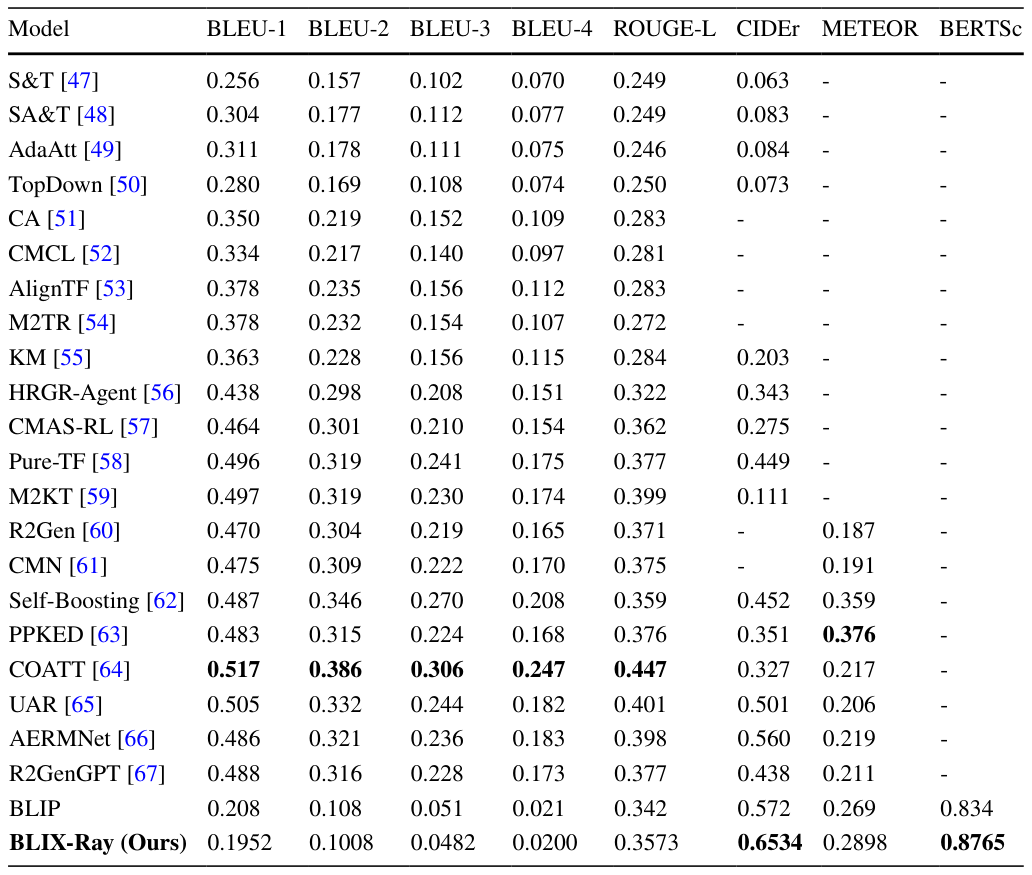
これらの結果は、BLIX-Rayが特に「レポートレベルの合意」と「意味的類似性」を重視する指標において、強力な性能を発揮することを示しています。これは、生成されたレポートが参照レポートと内容や意味において高い整合性を持つことを意味します。
n-gramベース指標との違い
興味深いことに、BLIX-RayはBLEUスコアでは一部のベースラインモデルや教師あり学習のみのBLIPモデルよりもわずかに低い値を示しました。この現象は、BLEUのようなn-gramベースの指標が、生成テキストと参照テキストの厳密なn-gram(連続する単語の並び)の重複度を測るのに対し、CIDErやBERTScoreは、より内容の合意や意味的な類似性を評価するという、各指標の特性の違いを浮き彫りにしています。例えば、BLEUは「小さい左胸水が見られる」と「軽度の左胸水が観察される」という二つの表現が意味的には同じでも、単語が異なるために低いスコアを与えてしまう可能性があります。しかし、CIDErはTF-IDF(term frequency-inverse document frequency)重み付けにより、一般的でない重要な医学用語の重複を重視するため、このような状況でも高いスコアを出す傾向があります。BERTScoreは文脈埋め込みを用いて意味的類似性を評価するため、表現の揺れに強く、より正確な意味的評価が可能です。このことは、医療レポート生成のような専門性の高い分野では、単語レベルの表面的な一致だけでなく、内容の正確性や臨床的妥当性を捉えるための多角的な評価が重要であることを示唆しています。
実際のレポート例と今後の展望
BLIX-Rayの性能をより深く理解するため、著者らは生成されたレポートの定性的評価も行っています。
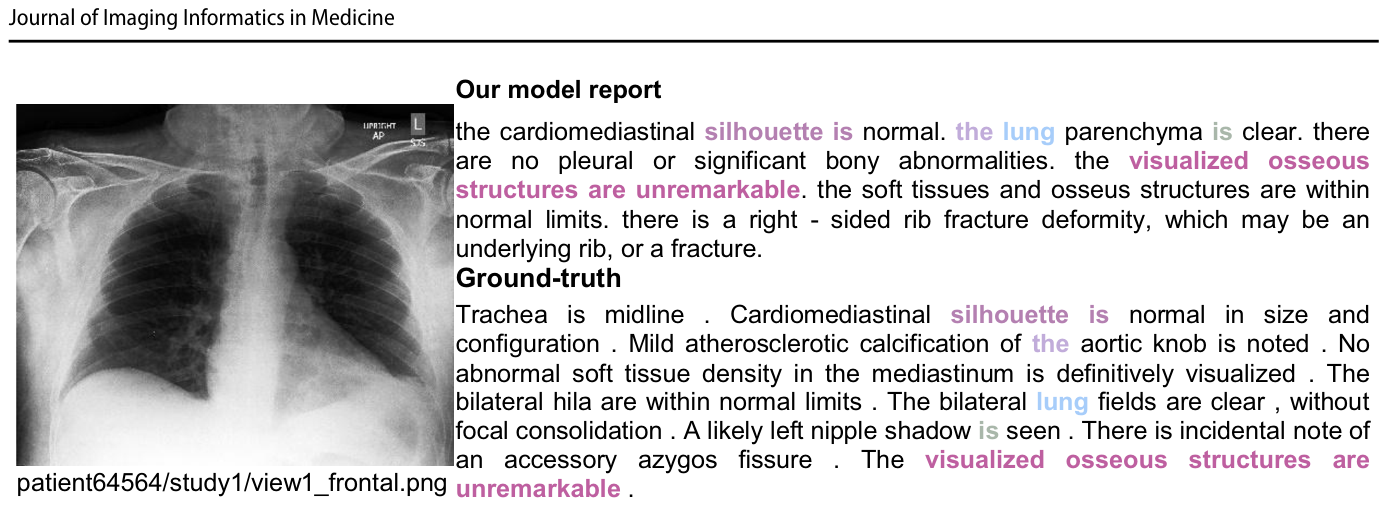
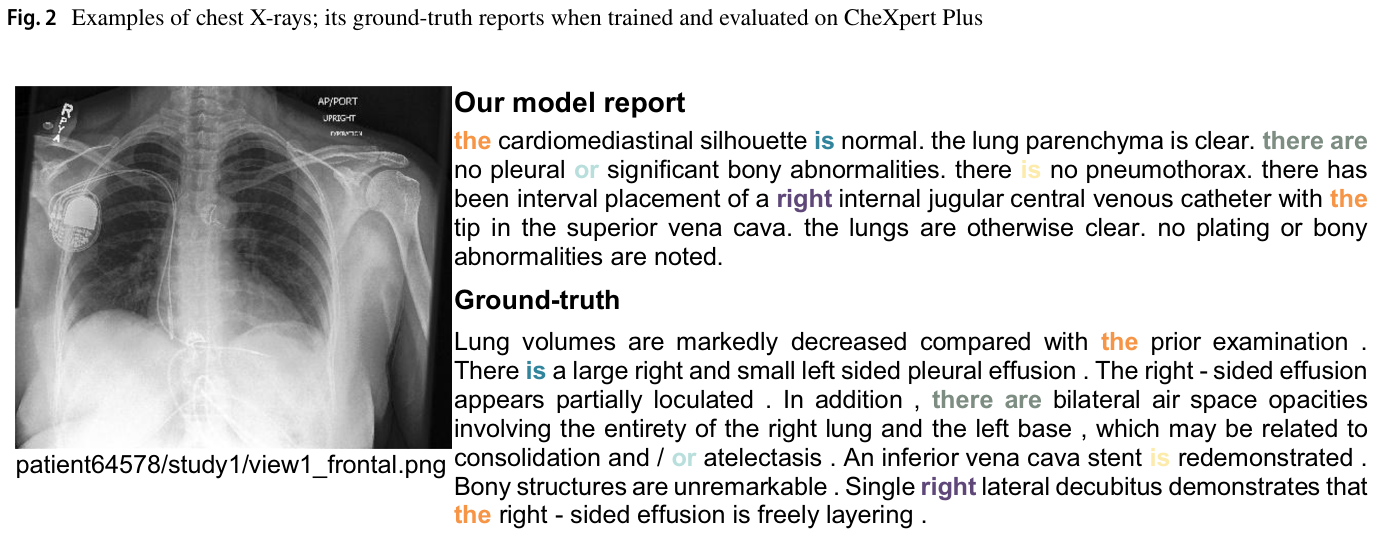
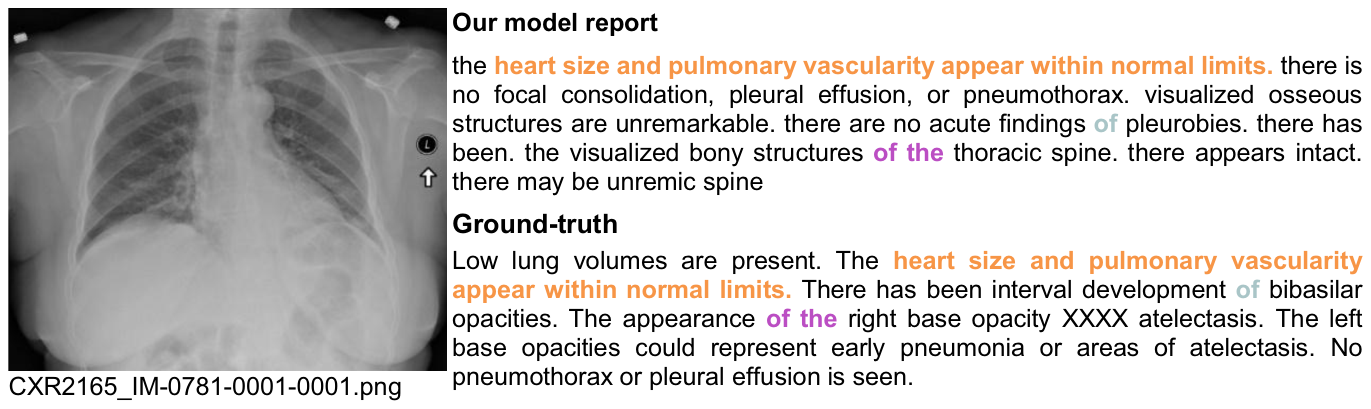
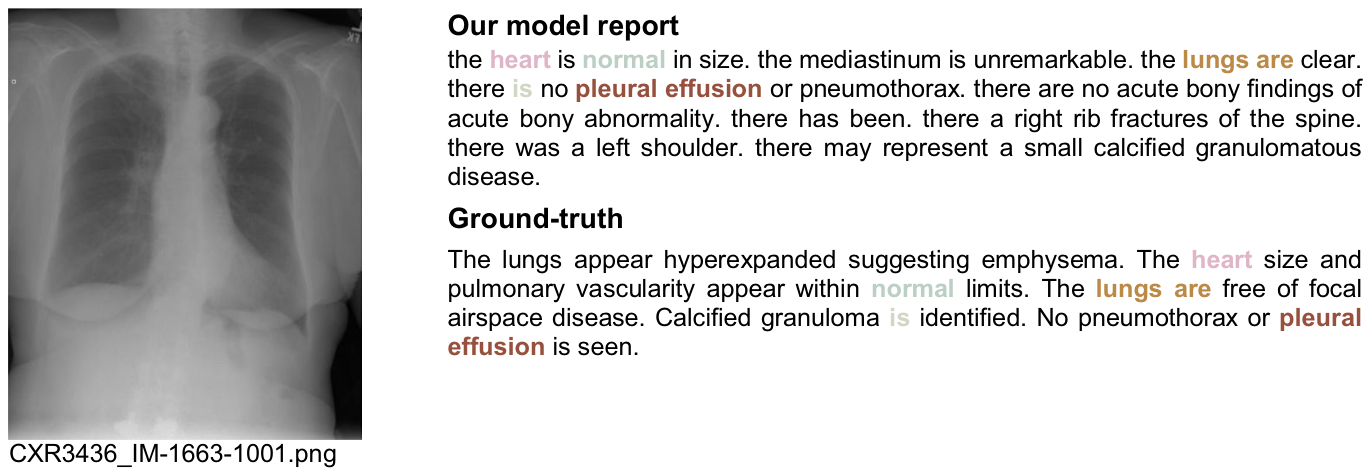
これらの図は、胸部X線画像と、それに対する専門家によるゴールデンスタンダードレポート、そしてBLIX-Rayが生成したレポートの例を示しています。正常な所見の胸部X線画像に対するレポートは、一般的に流暢で構文的に正しく、標準的な放射線レポートの用語に近いものでした。しかし、より複雑な所見や最適な状態ではない画像、あるいは医療デバイス(カテーテル、ペースメーカー、胸腔チューブなど)が存在するケースでは、いくつかの課題が特定されました。例えば、モデルは右内頚静脈カテーテルを報告できなかったり、小規模および中規模の胸水を認識できなかったり、右側のペースメーカーを内頚静脈カテーテルと誤認識したりしたケースがありました。また、脊椎の変性所見を常に言及できなかったり、異常の左右を誤認識したりする事例も観察されました。
モデル改善のための推奨事項
これらの定性的分析に基づき、著者らはモデルの診断信頼性とレポートの一貫性を向上させるためのいくつかの戦略を推奨しています。これには、一貫したレポート構造と標準化された表現にモデルを触れさせるための「標準化されたレポートテンプレート」の使用が含まれます。また、「層別化された訓練データセット」として、最適な技術で取得された正常な検査、明確な異常所見を伴う検査、微妙または議論の余地のある所見を伴う検査、最適な技術ではない複雑な診断を伴う検査など、多様なデータでモデルを訓練することが提案されています。さらに、「医療ライン、チューブ、デバイスへの露出強化」として、留置デバイス(例:中心静脈カテーテル、ペースメーカー、胸腔チューブ)の識別と正確な局所化に関するターゲット訓練が重要であるとされています。最後に、「左右認識の改善」として、解剖学的な側面の認識を強化する技術を導入し、臨床的に重大な影響を及ぼす可能性のある左右エラーを軽減することが推奨されています。
まとめ:AIがもたらす放射線レポートの未来
BLIX-Rayの研究は、事前学習済みVision-Language Modelと強化学習の組み合わせが、胸部X線レポートの自動生成において大きな可能性を秘めていることを示しました。このモデルは、放射線専門家のレポート作成負担を軽減し、診断パイプラインの遅延を解消するだけでなく、専門家内および専門家間のレポートのばらつきを減少させ、診断結果の一貫性と信頼性を向上させることが期待されます。強化学習によるタスク固有の言語評価指標の直接最適化は、教師あり学習だけでは達成できないレポートの品質向上に貢献しています。BLIX-Rayは、限られた医療データセットの規模と変動性という課題に対し、転移学習によって汎用的なVLMの知識を活用することで対応しています。また、最近リリースされたCheXpert Plusを含む複数のデータセットで強力な結果を達成し、そのアプローチの汎用性も実証されました。BLIX-Rayは、既存の大規模な医療VLMと競合するものではなく、むしろ補完的な軽量かつ計算効率の良いフレームワークとして、自動化された標準的な放射線レポート作成を支援するVLMの可能性を明確に示しています。
用語集
- Vision-Language Model (VLM): 視覚情報(画像)とテキスト情報(言語)を統合的に処理するAIモデル。
- 転移学習 (Transfer Learning): あるタスクで学習済みのモデルの知識を、別の関連タスクに適用する学習手法。
- 強化学習 (Reinforcement Learning, RL): エージェントが環境との相互作用を通じて試行錯誤し、報酬を最大化するように行動を学習する機械学習の一種。
- BLIP: 画像とテキストの連携に優れた事前学習済みVision-Language Modelの一つ。
- ファインチューニング (Fine-tuning): 事前学習済みモデルを、特定のタスクのデータセットに合わせて再訓練し、性能を向上させるプロセス。
- CIDEr: 参照レポートとのn-gramの一致度を評価する指標で、重要な単語にはTF-IDF重み付けを行う。
- BERTScore: 文脈埋め込みを用いて、生成されたテキストと参照テキストの意味的類似性を評価する指標。
- BLEU: n-gramの重複に基づいて、生成テキストと参照テキストの語彙的類似性を評価する指標。
- ROUGE-L: 最長共通部分列に基づいて、生成テキストと参照テキストの類似性を評価する指標。
- METEOR: n-gramの一致だけでなく、同義語、語幹、単語の順序も考慮してテキストの言語品質を評価する指標。
- n-gram: テキストから抽出される、連続するN個の単語の並び。
- ゴールデンスタンダード: 評価や比較の基準として用いられる、最も信頼性の高い、または確立された標準。
コメントを残す