
機械学習で小児インフルエンザの重症化を予測:解釈可能なAIモデルの活用
解説対象論文: Using interpretable machine learning models to predict the occurrence of severe influenza in hospitalized children: a retrospective cohort study
BMC Medical Informatics and Decision Making|被引用数: 0(2026年10月6日時点)
インフルエンザは、特に小児において深刻な健康上の脅威となります。重症化を早期に予測し、適切な治療計画を立てることは、対象者の健康を守る上で非常に重要です。本研究では、機械学習モデルとSHAP法という解釈可能なAI技術を組み合わせ、入院中の小児インフルエンザ対象者の重症化リスクを予測するモデルを開発しました。このアプローチにより、モデルの予測根拠を専門家が理解しやすくなり、個別化された医療提供への道を開きます。
はじめに:インフルエンザと予測の重要性
どうも、Beyond the Pixelです。インフルエンザは毎年、世界中で多くの人々、特に小児や高齢者といった脆弱な層に大きな影響を与える感染症です。世界保健機関(WHO)の推計によると、年間300万から500万人が重症化し、29万から65万人が呼吸器関連で亡くなっています。特に5歳未満の小児はインフルエンザウイルスに対する感受性が高く、入院率も成人より著しく高いため、感染後の重症化や死亡のリスクが非常に高くなります。このような背景から、インフルエンザの重症化リスクを効率的かつ実用的に予測するモデルを開発することは、対象者の管理を改善し、治療戦略を最適化するために不可欠です。近年、大規模で複雑なデータセットの分析において、機械学習(ML)という、大規模で複雑なデータセットからパターンを学習し、予測や意思決定を行うための技術が強力なツールとして注目されています。電子医療記録(EMR)という、対象者の病歴、診断、治療、検査結果などを電子的に記録・管理するシステムを活用したMLモデルは、様々な疾患の予測モデル開発に大きな期待を寄せています。しかし、これらのモデルは「ブラックボックス」問題と呼ばれるように、予測の根拠が不明瞭であるという課題を抱えることがあります。この課題に対処するため、SHAP(SHapley Additive exPlanation)法という、機械学習モデルの「ブラックボックス」問題を解決し、個々の特徴量がモデルの予測にどの程度寄与したかを解釈するための手法が導入され、MLモデル内の個々の変数の寄与を解釈する洞察を提供します。小児の重症ケア予測モデルにおいてSHAP法の応用に関する研究はまだ不足している現状があります。この研究では、著者らはランダムフォレスト(RF)モデルアルゴリズムという、複数の決定木を組み合わせ、それらの結果を平均することで予測を行う機械学習アルゴリズムを用いて8つの特徴量を組み込んだモデルを開発し、小児インフルエンザ対象者の重症度評価と管理のための、シンプルかつ堅牢な予測プラットフォームを構築しました。
研究方法:データから予測モデルへ
この後ろ向きコホート研究という、過去の医療記録やデータを用いて、特定の要因と疾患の発生や経過との関連を遡って調査する研究デザインでは、電子医療記録(EMR)システムからデータを抽出しました。対象者は南京小児病院に入院した28日から14歳までのインフルエンザ様症状の小児で、2022年1月1日から2023年5月31日までに診断基準を満たした人々でした。対象者は疾患の重症度に基づいて軽症群と重症群に分類されました。重症例の定義には、3日以上続く高熱、呼吸促迫(呼吸回数の増加)、安静時の酸素飽和度93%以下、呼吸窮迫の兆候、精神状態の変化や痙攣、食事拒否や脱水症状の兆候などが含まれます。最終的に、軽症群322名と重症群114名の合計436名のインフルエンザ対象者が分析に含まれました。
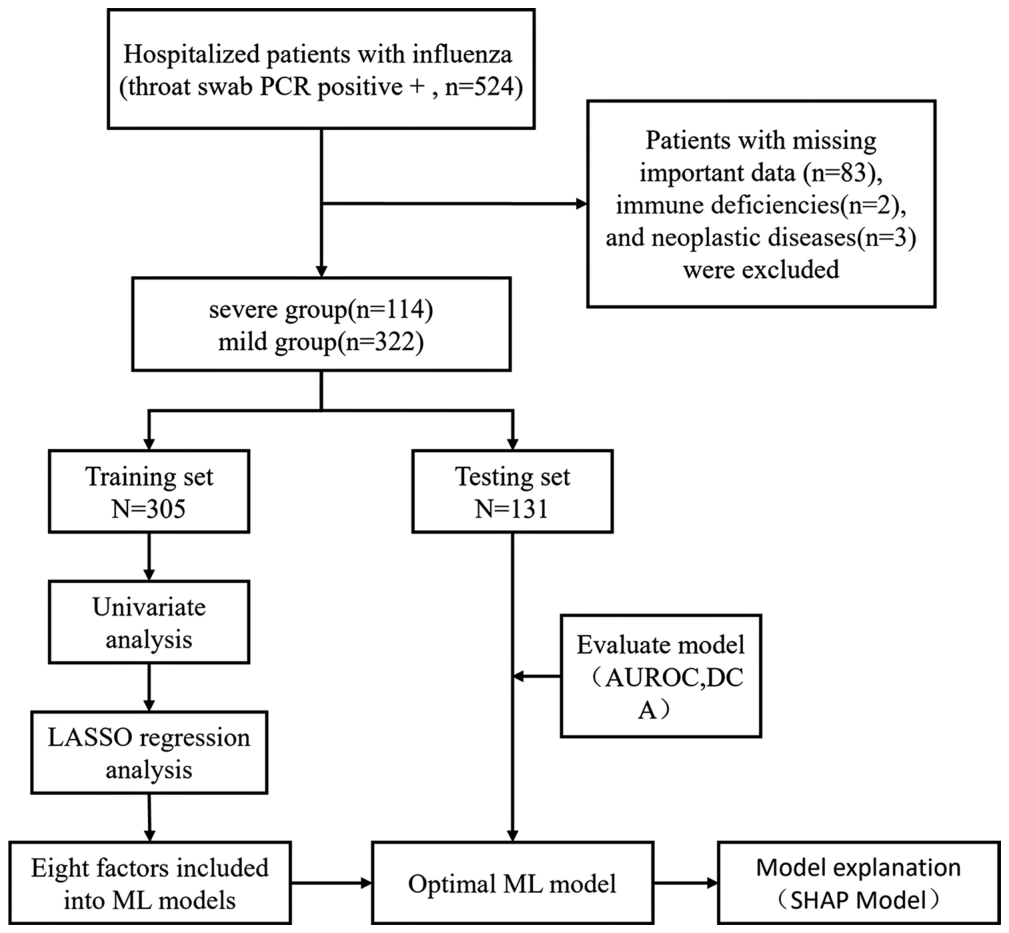
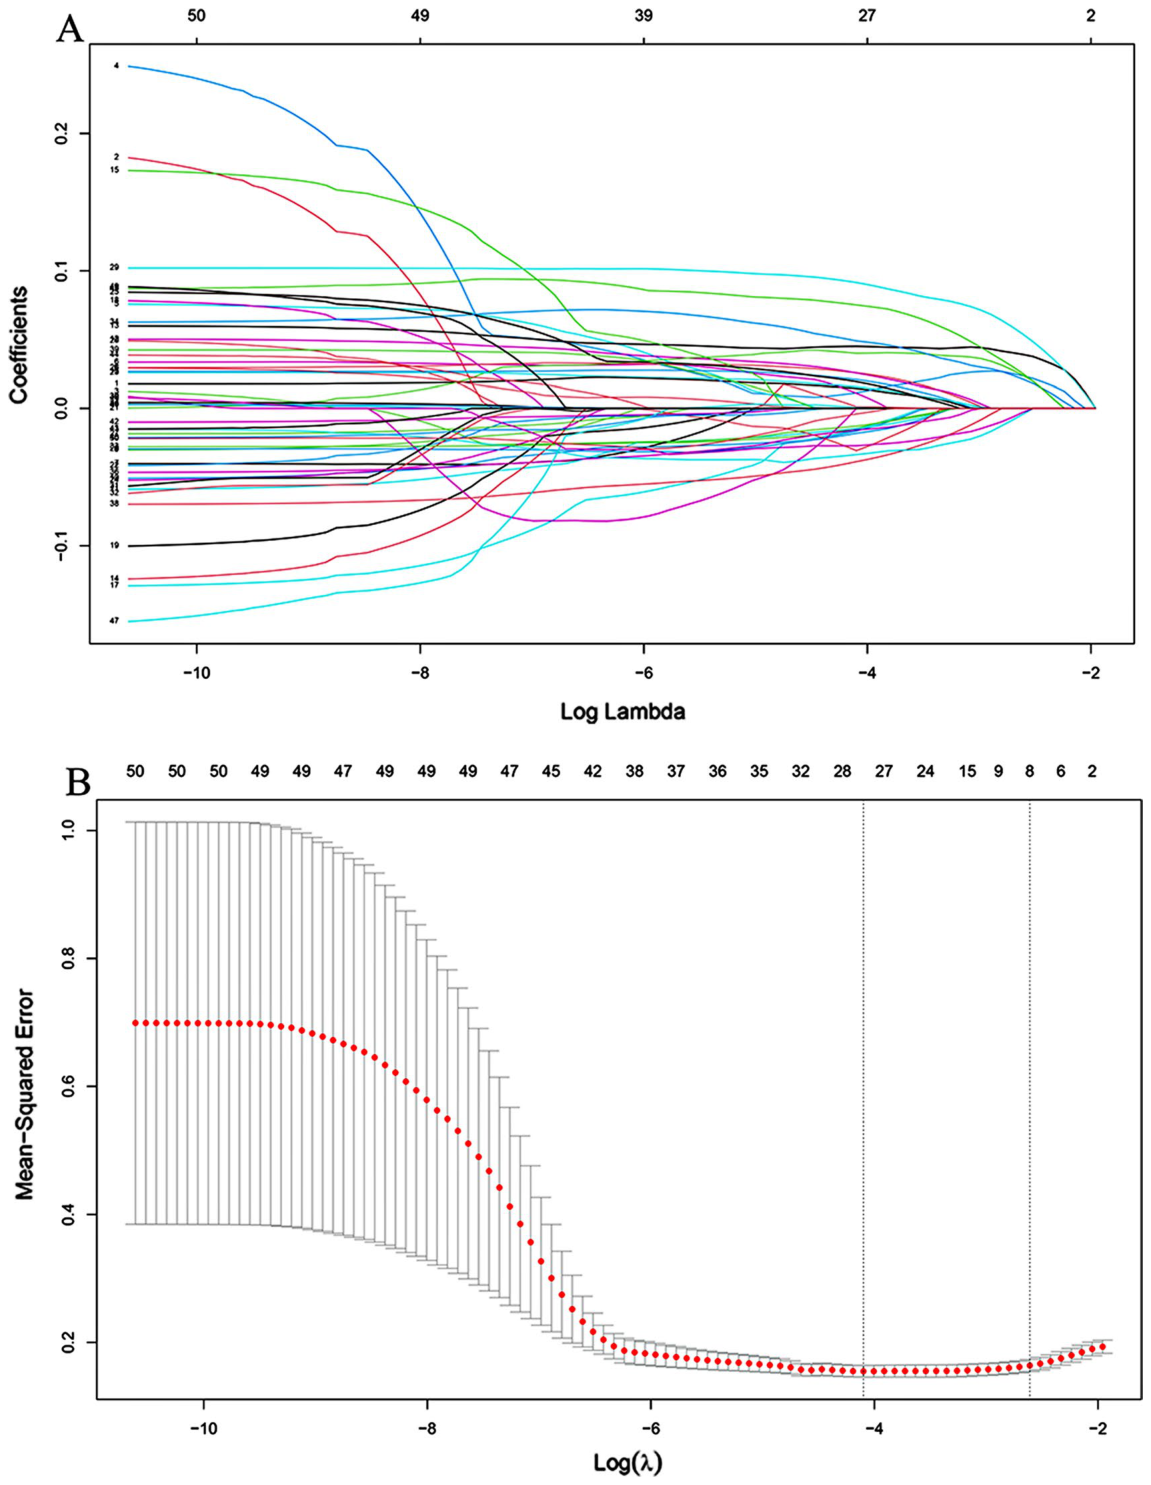
データ収集は、対象者の入院後24時間以内に行われ、人口統計学的情報(性別、年齢)、臨床的特性(入院期間、基礎疾患、最高体温)、病歴(基礎疾患の既往、ノイラミニダーゼ阻害薬の使用歴)、および検査所見(血算、プロカルシトニン(PCT)、凝固プロファイル、生化学検査、液性免疫検査、細胞性免疫検査など)が含まれました。臨床データの20%以上が欠損している対象者、免疫不全、腫瘍性疾患の診断を受けた対象者は除外されました。欠損値の処理と予測変数の選択においては、欠損データが25%未満の変数は、ランダムに欠損していると仮定して補完(imputation)されました。交絡因子を制御するため、単変量解析(p < 0.05)で有意であった変数は、トレーニングセットにおいてLASSO(Least Absolute Shrinkage and Selection Operator)法という、統計モデルにおける変数選択と正則化の手法で、予測に重要な特徴量を自動的に選択し、過学習を防ぐ手法を用いてさらに分析されました。このアプローチにより、予測因子の選択が洗練され、過学習のリスクが軽減されました。
予測モデルの構築と評価には、LightGBM、ランダムフォレスト(RF)、サポートベクターマシン(SVM)、決定木(DT)、ニューラルネットワーク(NNLM)、AdaBoostの6つの異なる機械学習モデルが用いられました。各モデルの最適なハイパーパラメータは、グリッドサーチと5分割交差検定を組み合わせて決定されました。その後、テストセットでモデルの性能が評価されました。さらに、臨床での適用性を考慮し、6つのモデルの意思決定曲線分析(DCA)も行われました。SHAP法は、モデルにおける特徴量の重要性と個々の寄与を明らかにするために用いられ、各特徴量がモデルの予測に与える影響を特定しました。
研究結果:優れた予測性能と重症化リスク因子
最終的に分析に含まれたのは、入院した小児インフルエンザ対象者436名で、重症群114名、軽症群322名でした。性別、年齢、最高体温、体重にはグループ間で有意な差は観察されませんでした。インフルエンザA型が優勢な株であり、重症例の76.32%を占めました。入院前のノイラミニダーゼ阻害薬という、インフルエンザウイルスの増殖を阻害する抗ウイルス薬の使用は重症群で有意に低く、死亡率は17.54%でした。
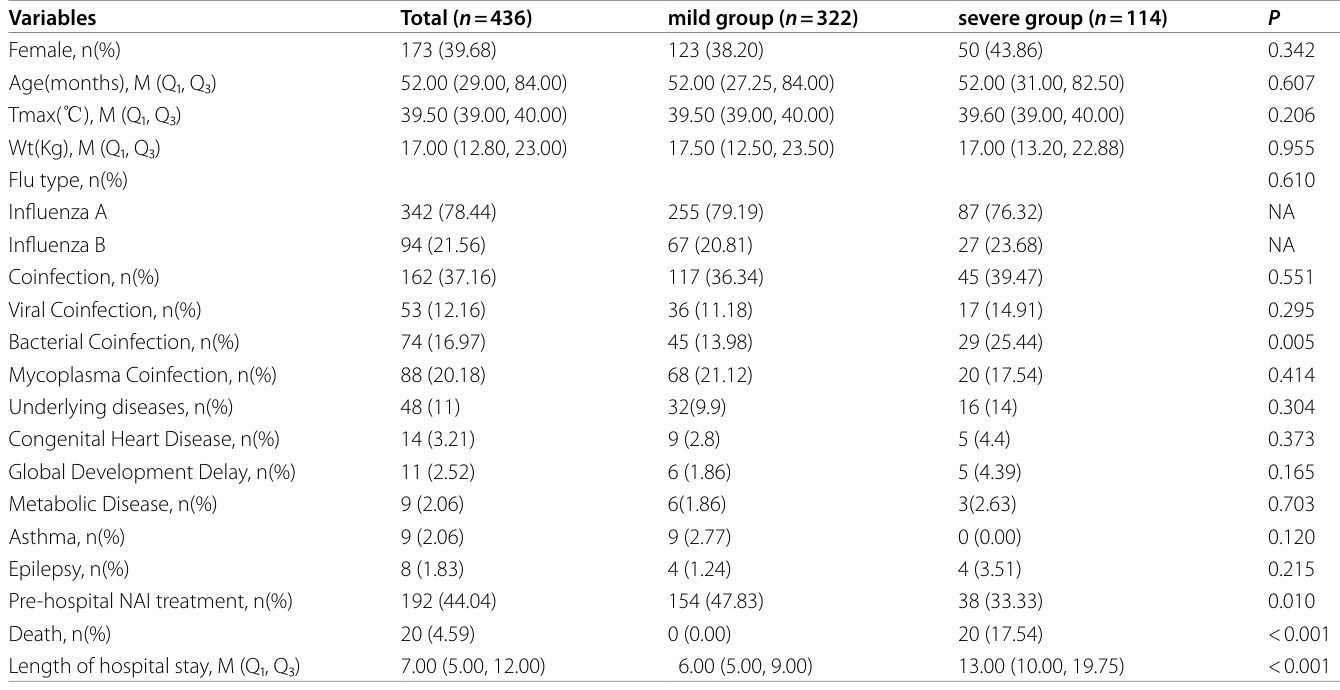
また、重症対象者の入院期間は有意に長かった(p < 0.05)です。対象者の37.16%が他の病原体による併存感染(coinfection)を有しており、細菌性併存感染は重症例で有意に高い割合でした(p < 0.05)。主要な細菌性病原体はインフルエンザ菌、次いで黄色ブドウ球菌、肺炎球菌でした。
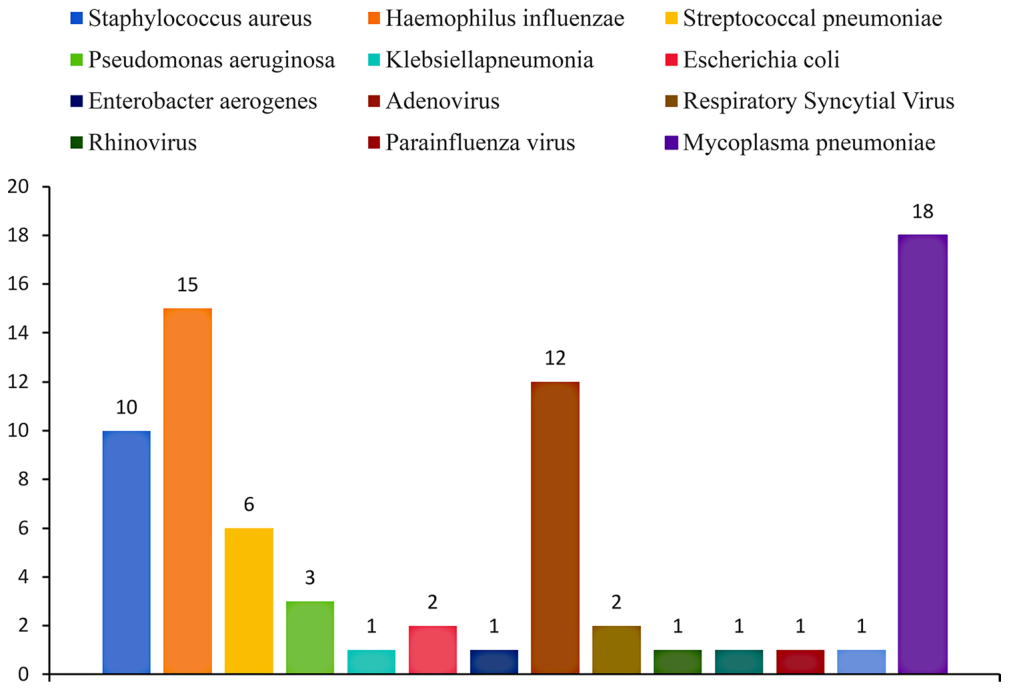
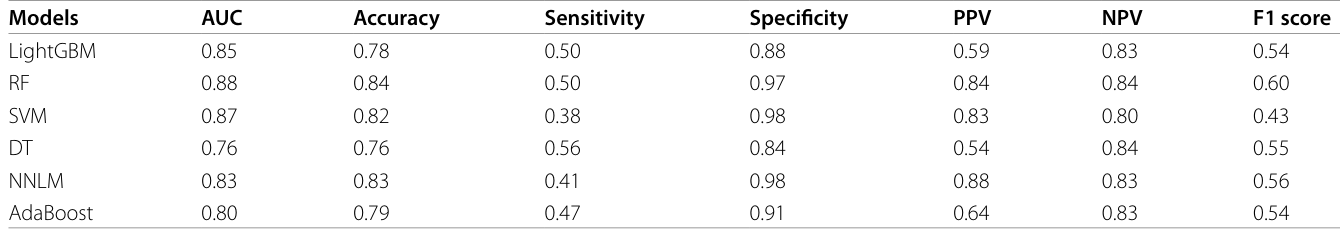
ウイルス性またはマイコプラズマ肺炎による併存感染については、グループ間に有意差は見られませんでした。基礎疾患は対象者の11%に存在し、最も一般的なのは先天性心疾患と広汎性発達遅延でしたが、グループ間に有意差はありませんでした(p > 0.05)。キー変数のスクリーニングでは、データセットはトレーニングセットに70%(305名)、検証セットに30%(131名)がランダムに分割され、両セット間に有意差はありませんでした。単変量解析により、トレーニングセットの検査所見において46の因子が両グループ間で有意な差を示しました(p < 0.05)。LASSO回帰を用いてこれらの有意な因子を分析した結果、好中球割合(NEUT%)、プロカルシトニン(PCT)、アスパラギン酸アミノトランスフェラーゼ(AST)、血糖値(Glu)、血中尿素窒素(BUN)、補体C3、B細胞割合、CD4+T細胞数の8つの潜在的な予測因子が特定されました。6つの機械学習アルゴリズム(LightGBM、RF、SVM、DT、NNL、AdaBoost)の性能を評価したところ、RFモデルが最高の予測性能を示しました(AUROC 0.88)。AUROC(Area Under the Receiver Operating Characteristic curve)は、分類モデルの性能を評価する指標の一つで、予測の識別能力を0から1の範囲で示し、値が高いほど性能が良いとされます。具体的には、LightGBMが0.85、SVMが0.87、DTが0.76、NNLが0.83、AdaBoostが0.80でした。
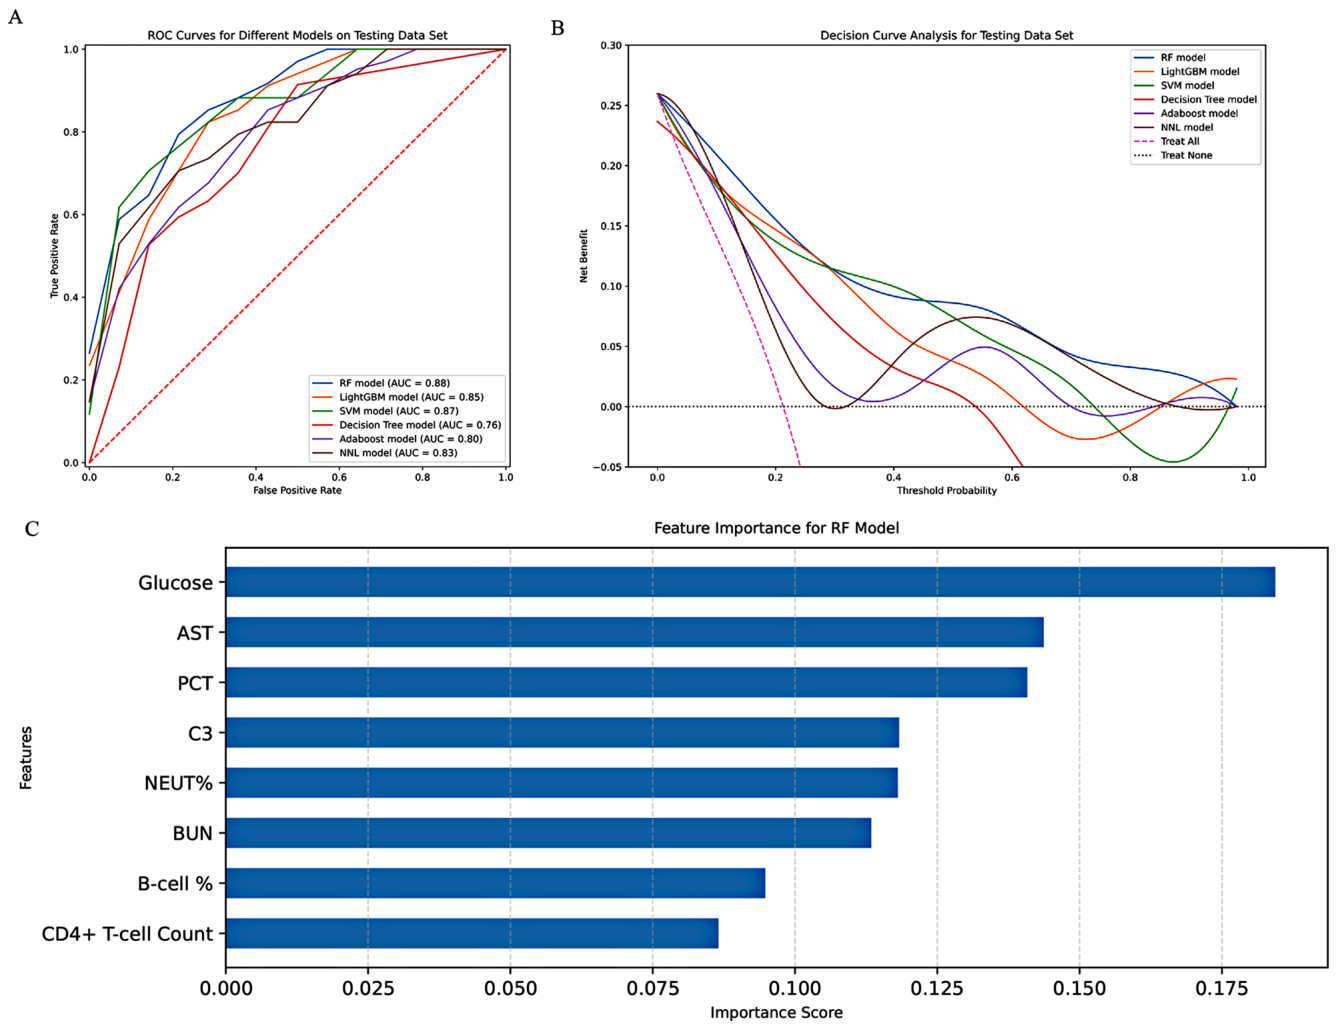
DCA(意思決定曲線分析)においても、RFモデルの純利益は他の機械学習モデルを大幅に上回りました。純利益は、意思決定曲線分析(DCA)において用いられる指標で、誤った診断によって生じる害と、正しい診断によって得られる利益のバランスを考慮し、臨床的な介入の正当性を評価します。SHAP法を用いたRFモデルの解釈により、予測モデルにおける入力特徴量の重要度を順位付けし、解釈することが可能になりました。血糖値がすべての予測範囲で最も高い予測値を示し、次いでAST、B細胞割合(B-cell%)、PCT、CD4+T細胞数、NEUT%、BUN、C3の順でした。
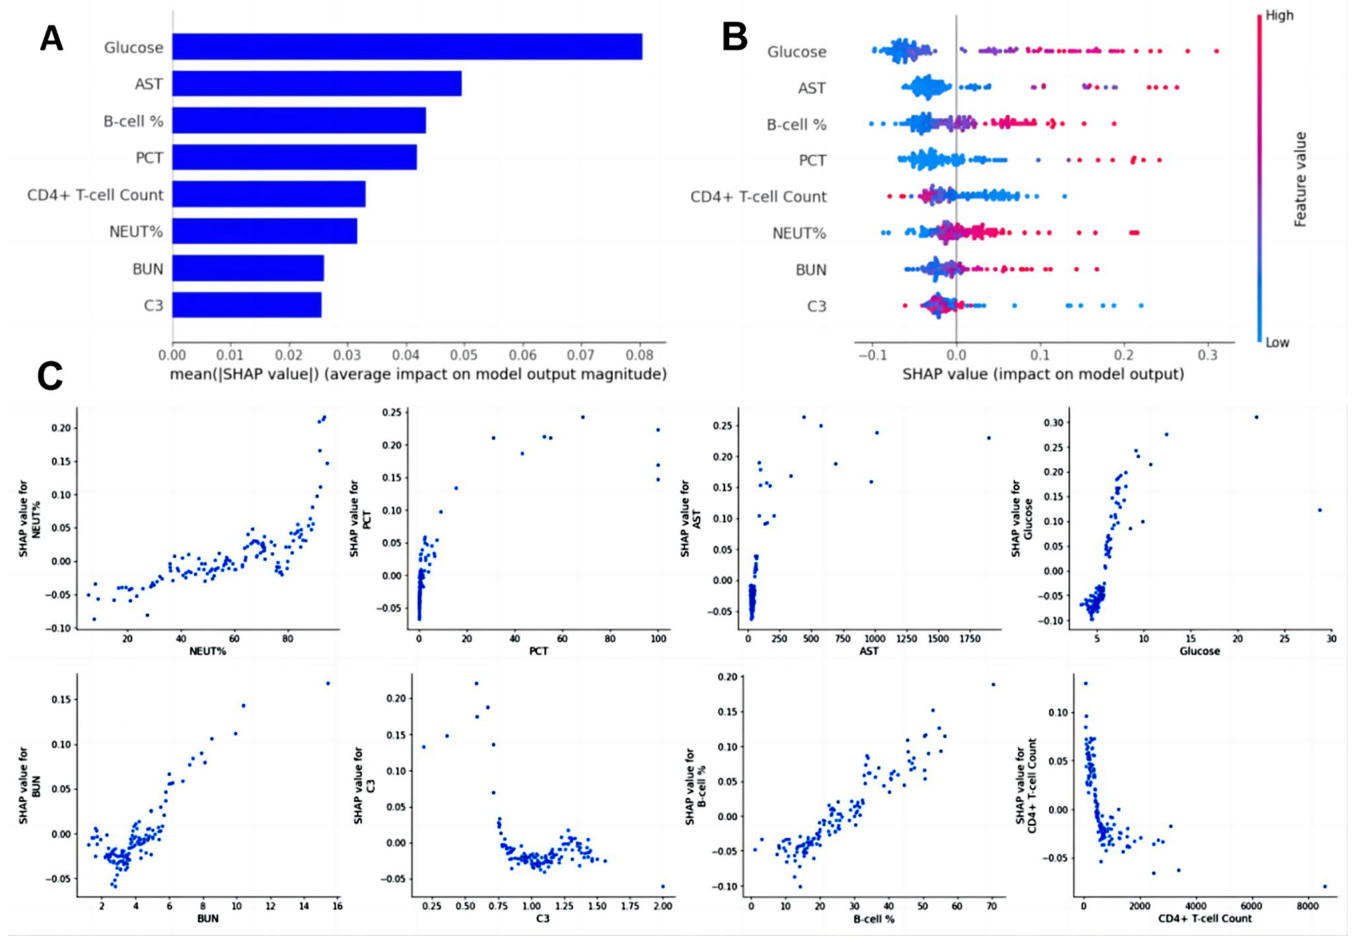
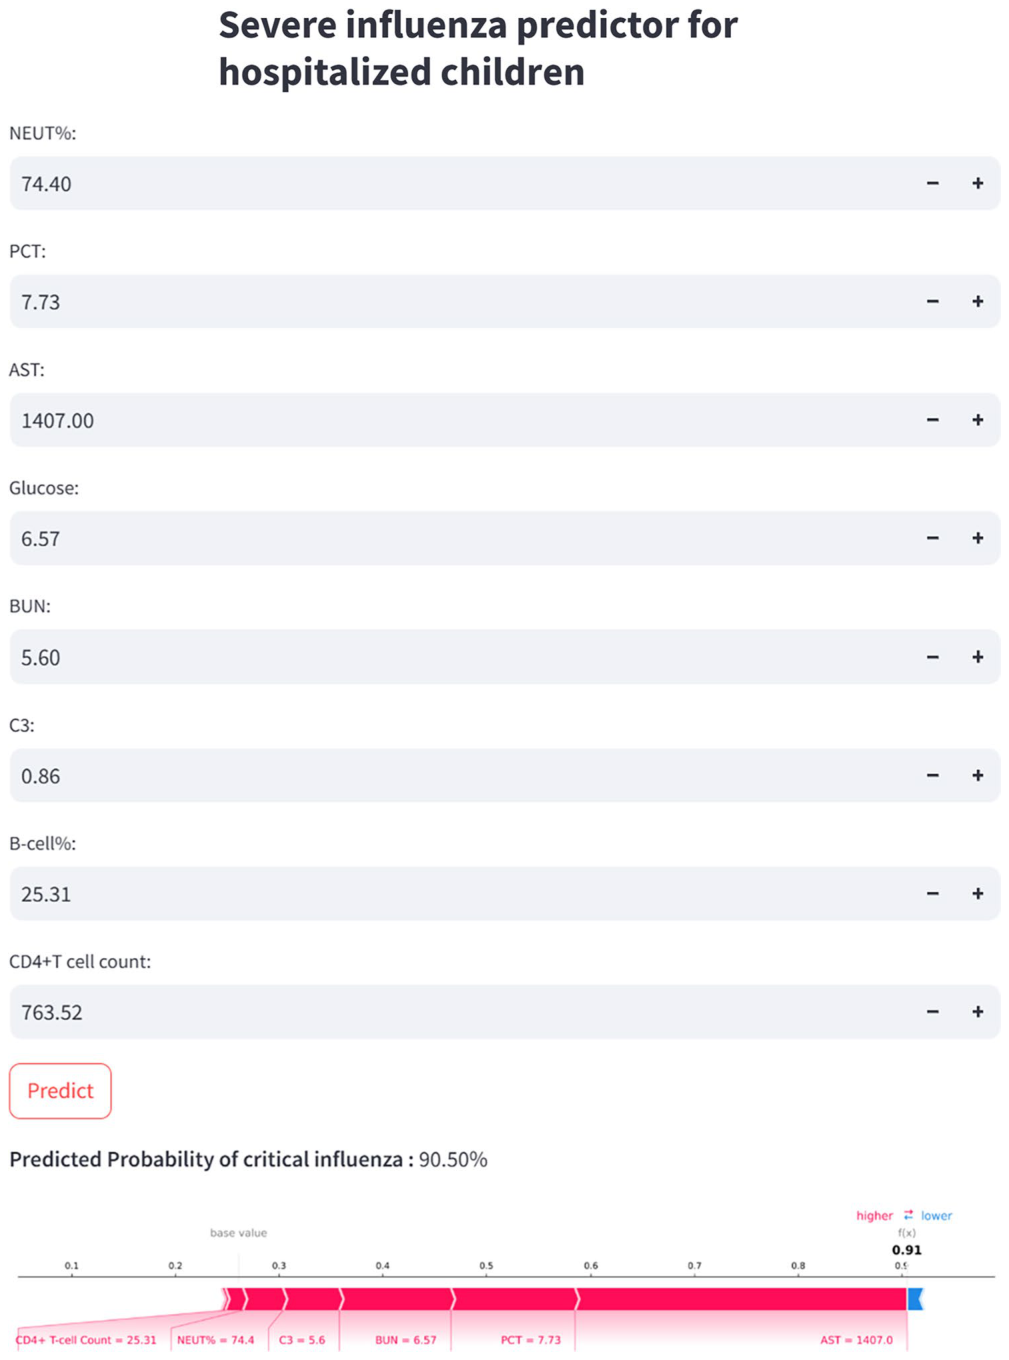
SHAP値は、血糖値、AST、B細胞割合、PCT、NEUT%、BUNの増加が重症化の発生に正の影響を与え、CD4+T細胞数およびC3の増加が非重症化に負の影響を与えることを明らかにしました。このランダムフォレストモデルを活用し、著者らは臨床現場で入院中のインフルエンザ小児の重症化リスクを個別予測するためのウェブアプリケーションを開発しました。
考察:予測モデルが示す重症化のメカニズム
この後ろ向きコホート研究では、入院中の小児インフルエンザ対象者の重症化リスクを予測するため、6つの機械学習アルゴリズムが開発および検証されました。他のモデルと比較して、ランダムフォレストモデルが最高のAUROCを示しました。また、意思決定曲線分析(DCA)は、ランダムフォレストモデルが最高の臨床的利益を提供することを示しています。この結果は、様々な閾値確率において、ランダムフォレストモデルが他の機械学習モデルよりも高い純利益を示すことを定量的に裏付けています。さらに、著者らはSHAP法を用いてランダムフォレストモデルを解釈しました。これにより、専門家がモデルの意思決定プロセスをよりよく理解し、予測結果の利用を促進することができます。この研究では、電子医療記録から豊富な臨床検査データが得られました。単変量解析とLASSO回帰を適用することで、8つの重症化予測因子が特定されました。SHAP法による機械学習の可視化は、高血糖、AST、B細胞割合、プロカルシトニン(PCT)、好中球割合(NEUT%)、血中尿素窒素(BUN)の増加、およびCD4+T細胞数、補体C3の減少が、小児の重症インフルエンザ発生を予測する上で重要な因子であることを明らかにしました。ランダムフォレストモデルの順列重要度((図4)C)とSHAPによる重要度分析((図5)A)に基づくと、重症インフルエンザに関連する最も重要な因子は血糖値の上昇でした。過去の研究でも、インフルエンザ感染においてグルコース代謝が重要であることが示されています。インフルエンザウイルス感染は、宿主のグルコース代謝を増強することで「サイトカインストーム」という、免疫システムが過剰に活性化され、大量のサイトカインが放出されることで、全身の臓器に炎症や損傷を引き起こす状態を引き起こす可能性があります。さらに、インフルエンザウイルス感染中のグルコース利用を阻害すると、マウスにおいて組織機能不全と死を引き起こすことが示されています。インフルエンザウイルスは最初に上気道の細胞を標的とし、疾患が進行するとさらに下気道へと感染が拡大します。対象者の約30~40%が急性肺炎を発症し、その後の炎症の拡大が全身性炎症反応を引き起こし、多臓器不全に至る可能性があります。これは、本研究で重症インフルエンザ感染小児においてASTとPCTの顕著な増加が見られた理由を説明します。疾患の経過中、直接的な感染に加えて、ウイルスに対する宿主の免疫応答も重症化の重要な原因となります。研究により、インフルエンザ感染時に検出される好中球の増加は、より重症な感染と関連していることが示されています。これは、好中球細胞外トラップの過剰形成、好中球性炎症、およびアポトーシス(プログラム細胞死)の遅延によるものと考えられます。過剰な好中球の活性化は、有害な転帰につながる可能性があります。本研究では、重症群におけるBリンパ球(B-cell%)の割合が軽症群よりも高く、これは過去の報告と一致しており、重症群におけるTリンパ球の著しい減少に起因する可能性があります。しかし、Bリンパ球とインフルエンザの重症度との関連性に関する報告はまだ少なく、さらなる研究が必要です。補体系は、ウイルスを中和し、適応免疫を調節することで、宿主のインフルエンザウイルスに対する抵抗力に重要な役割を果たします。補体C3は、インフルエンザウイルス感染に対する宿主の防御的液性免疫応答を高める上で鍵となります。C3の欠乏は、肺における特異的なCD4+およびCD8+エフェクターT細胞の動員を阻害する可能性があります。動物実験では、補体C3の欠如がインフルエンザウイルスのクリアランスを遅らせ、死に至らせる可能性があることが示されています。CD4+T細胞は、宿主免疫応答、特にインフルエンザウイルス感染の予防と制御において重要な役割を果たします。動物実験では、CD4+T細胞が低ウイルス量での感染に対して効果的に防御することが示されています。さらに、ヒトの研究では、以前の感染時に活性化されたウイルス特異的CD4+T細胞が疾患の重症度を軽減する可能性があることが示されています。適応免疫応答において、ナイーブなCD4+T細胞は、抗原提示細胞上の主要組織適合性複合体(MHC)によって提示されたウイルス抗原を認識します。これらの細胞はTh1、Th2、Th17、Treg、Tfhを含む様々なタイプに分化します。CD4+T細胞は、CD8+T細胞の感染部位への移動を指示する調節的役割を果たします。CD8+T細胞と樹状細胞によって提示されたウイルス抗原との相互作用は、ウイルス特異的CD8+T細胞の活性化につながります。さらに、活性化されたCD4+T細胞はB細胞の活性化と分化を促進します。濾胞ヘルパーT細胞(Tfh)は、ケモカイン受容体CXCR5を発現し、二次リンパ器官のB細胞濾胞に局在し、胚中心応答の生成と維持に関与し、最終的に長寿命の記憶B細胞の発達を誘導します。CD4+T細胞は、様々なサイトカインを産生し、他の免疫細胞や非免疫細胞との相互作用を調整することにより、インフルエンザウイルス感染に起因する肺の炎症や損傷に大きな影響を与えます。Th1細胞は、IL-2、IFN-γ、TNF-α/βを放出し、マクロファージの活性化、一酸化窒素産生、CD8+T細胞増殖、B細胞活性化を促進し、微生物病原体の破壊と食作用を導きます。しかし、過剰なTNF-γは極端な炎症反応を誘導し、組織損傷を引き起こす可能性があります。Th2細胞によって産生されるIL-4、IL-5、IL-13などのサイトカインは、B細胞に抗体産生を刺激します。マウスモデルでは、IL-4はS.インフルエンザ/肺炎球菌併存感染において保護的役割を示すことが示されています。それにもかかわらず、インフルエンザ感染後のIL-5分泌の亢進は、肺における好酸球の長期的な蓄積を引き起こす可能性があります。加えて、インフルエンザ感染は、IL-10やアンフィレグリン(AREG)などのエフェクター分子を用いることで免疫抑制と組織修復を媒介する、堅牢な制御性T細胞(Treg)を誘導します。本研究では、重症の小児において細菌性併存感染の割合が有意に増加することも明らかになりました。インフルエンザ菌、黄色ブドウ球菌、肺炎球菌が最も頻繁に検出された病原体でした。細菌性併存感染は、インフルエンザ疾患の進行を悪化させ、死亡率を高めます。以前の研究では肺炎球菌が主要な細菌として特定されましたが、近年では黄色ブドウ球菌の検出率が上昇し、米国で最も一般的な併存感染として浮上しています。インフルエンザウイルスによって誘導されるIL-10とI型インターフェロン(I-IFN)の強い発現は、細菌クリアランスを促進するCD4+T細胞の重要なサブセットであるヘルパーT細胞-17(Th17細胞)の細胞応答を阻害します。
まとめと今後の展望
著者らは、入院したインフルエンザ小児の重症化リスクを推定するための、説明可能なランダムフォレスト予測モデルを開発しました。SHAP法を導入することで、モデルの予測可能性と解釈可能性が向上し、専門家が小児における重症インフルエンザの早期特定と介入を行う上で役立つことが期待されます。このモデルは、個別化された治療計画を立てるための貴重なツールとなり、医療現場での応用が望まれます。今後の研究では、より大規模なデータセットでの検証や、リアルタイムでの予測システムへの統合が期待されます。
用語集
- 機械学習 (ML): 大規模で複雑なデータセットからパターンを学習し、予測や意思決定を行うための技術。
- 電子医療記録 (EMR): 対象者の病歴、診断、治療、検査結果などを電子的に記録・管理するシステム。
- SHAP (SHapley Additive exPlanation) 法: 機械学習モデルの「ブラックボックス」問題を解決し、個々の特徴量がモデルの予測にどの程度寄与したかを解釈するための手法。
- ランダムフォレスト (RF) モデル: 複数の決定木を組み合わせ、それらの結果を平均することで予測を行う機械学習アルゴリズム。高い予測性能を持つ。
- 後ろ向きコホート研究: 過去の医療記録やデータを用いて、特定の要因と疾患の発生や経過との関連を遡って調査する研究デザイン。
- LASSO (Least Absolute Shrinkage and Selection Operator) 法: 統計モデルにおける変数選択と正則化の手法で、予測に重要な特徴量を自動的に選択し、過学習を防ぐ。
- AUROC (Area Under the Receiver Operating Characteristic curve): 分類モデルの性能を評価する指標の一つで、予測の識別能力を0から1の範囲で示す。値が高いほど性能が良い。
- DCA (Decision Curve Analysis) / 意思決定曲線分析: 予測モデルの臨床的有用性を評価する手法。様々な閾値確率における純利益を比較し、モデルが治療介入の意思決定にどれだけ貢献するかを示す。
- 純利益 (Net Benefit): 意思決定曲線分析(DCA)において用いられる指標で、誤った診断によって生じる害と、正しい診断によって得られる利益のバランスを考慮し、臨床的な介入の正当性を評価する。
- サイトカインストーム: 免疫システムが過剰に活性化され、大量のサイトカイン(免疫細胞間の情報伝達物質)が放出されることで、全身の臓器に炎症や損傷を引き起こす状態。
- ノイラミニダーゼ阻害薬: インフルエンザウイルスの増殖を阻害する抗ウイルス薬。
コメントを残す