
撮像時間短縮DaTSCAN SPECTにおける深層学習による画質復元
解説対象論文: Acquisition Time–Specific Deep Learning–Guided Image Quality Restoration in Accelerated I-123 DaTSCAN Brain SPECT on a Ring-Shaped CZT-Based Camera
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月3日時点)
I-123 DaTSCAN脳SPECTはパーキンソン病の診断に有用ですが、撮像時間の短縮は画質低下を招き、診断的価値を損なう可能性があります。本研究では、深層学習(DL)を用いて短時間撮像のDaTSCAN SPECT画像の画質を向上させることを目指しました。これにより、診断的価値を維持しながら対象者の負担軽減とスキャナーのスループット向上に貢献する可能性が示されました。
導入:DaTSCAN SPECTの課題と深層学習の可能性
どうも、Beyond the Pixelです。パーキンソン病の診断や経過観察において、I-123 DaTSCAN脳SPECT(単一光子放射型コンピューター断層撮影)は非常に有効なツールとして知られています。この撮像法は、線条体におけるドーパミントランスポーター(DaT)の密度を画像化することで、パーキンソン病のような運動障害の鑑別診断に役立ちます。しかし、標準的なSPECTプロトコルでは、十分な画質と診断の信頼性を得るために、通常15分以上と比較的長い撮像時間を必要とします。この長い撮像時間は、特に高齢の対象者や認知機能が低下した対象者にとって、不快感、疲労、不安といった問題を引き起こす可能性があります。これにより、対象者の動きが生じやすくなり、結果として画質が低下し、診断に支障をきたすことさえあります。また、撮像時間が長くなると、1日に撮像できる対象者の数が制限され、医療施設の運用効率も低下するという課題があります。このような背景から、診断的価値を損なうことなく、対象者の快適性と臨床効率を向上させるSPECT撮像プロトコルの最適化が求められています。直感的な解決策の一つは、SPECTの撮像時間を短縮することです。しかし、撮像時間を短縮すると検出されるカウント数が減少し、ノイズが大きく、コントラストが低く、信号対ノイズ比(SNR)が低下した画像になります。これらの低カウント画像は、信頼性の高い視覚的解釈や定量的分析には不十分であり、既存のハードウェアベースのノイズ除去アプローチや再構成後のフィルターでは、限られた改善しか得られません。近年、医療画像分野では深層学習(DL)が革新的なツールとして登場し、画像再構成やノイズ除去、セグメンテーション、画像合成など、さまざまなタスクで成功を収めています。特に、アテンション機構やトランスフォーマーベースのモジュールをDLモデルに統合することで、長距離の依存関係や文脈的関係をモデル化する能力が向上し、核医学画像における微細な解剖学的詳細の復元に貢献しています。本研究は、加速したI-123 DaTSCAN脳SPECT画像の画質を向上させる深層学習ベースのアプローチを提案することを目的としました。具体的には、低カウントの短時間撮像画像をフルタイムの画像に変換するために設計された、アテンション機構を強化したU-Netモデルとトランスフォーマーコンポーネントを開発し評価しました。このモデルは、高速SPECT撮像における情報損失を効果的に回復させ、診断的価値を損なうことなく画像のノイズを低減できる可能性があります。
研究方法:データ生成から深層学習モデルの訓練まで
本研究では、GE StarGuide CZTベースのフルリングSPECT/CTカメラで標準的な15分の撮像時間でスキャンされた85名の対象者のデータを使用しました。対象者のデモグラフィック情報は
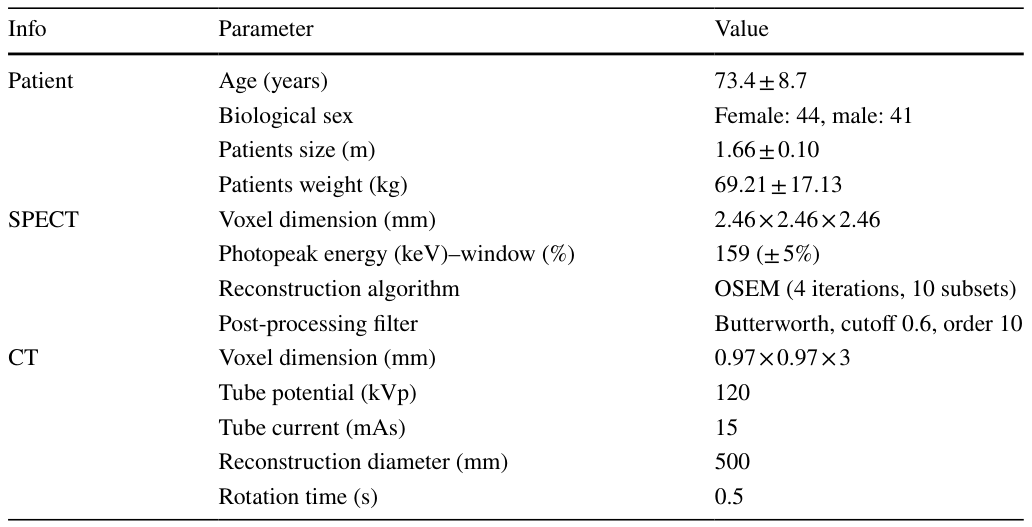
に示されています。高速撮像プロトコルをシミュレートするため、生のリットモードデータは元の撮像時間の20%、25%、50%に遡及的にアンダーサンプリングされ、臨床ルーチンプロトコルを使用して再構成されました。この際、オーダーサブセット期待値最大化(OSEM)再構成アルゴリズムが用いられ、8回の反復と4つのサブセット、解像度回復、CT画像による減弱補正が適用されました。再構成されたフルタイム画像と高速撮像画像(高速1/5、1/4、1/2)はNIFTI画像形式に変換され、さらなる処理が行われました。前処理ステップでは、CT画像を用いて脳全体と体輪郭を特定しました。DaTSCAN SPECTアトラスは、各対象者固有の解剖学的構造に合うように、3段階の登録プロセス(剛体登録後に変形可能登録)を経てフルタイムSPECT画像に登録されました。また、Hammersmithアトラス(83の関心領域で構成)も同様に登録されました。画像とセグメンテーションマスクは目視で確認され、不正確な場合は登録パラメーターが修正されました。画像はDLモデルが対象者データに集中できるよう、頭蓋骨領域にクロップされ、99パーセンタイルでの正規化が行われました。画像登録とセグメンテーションのステップは
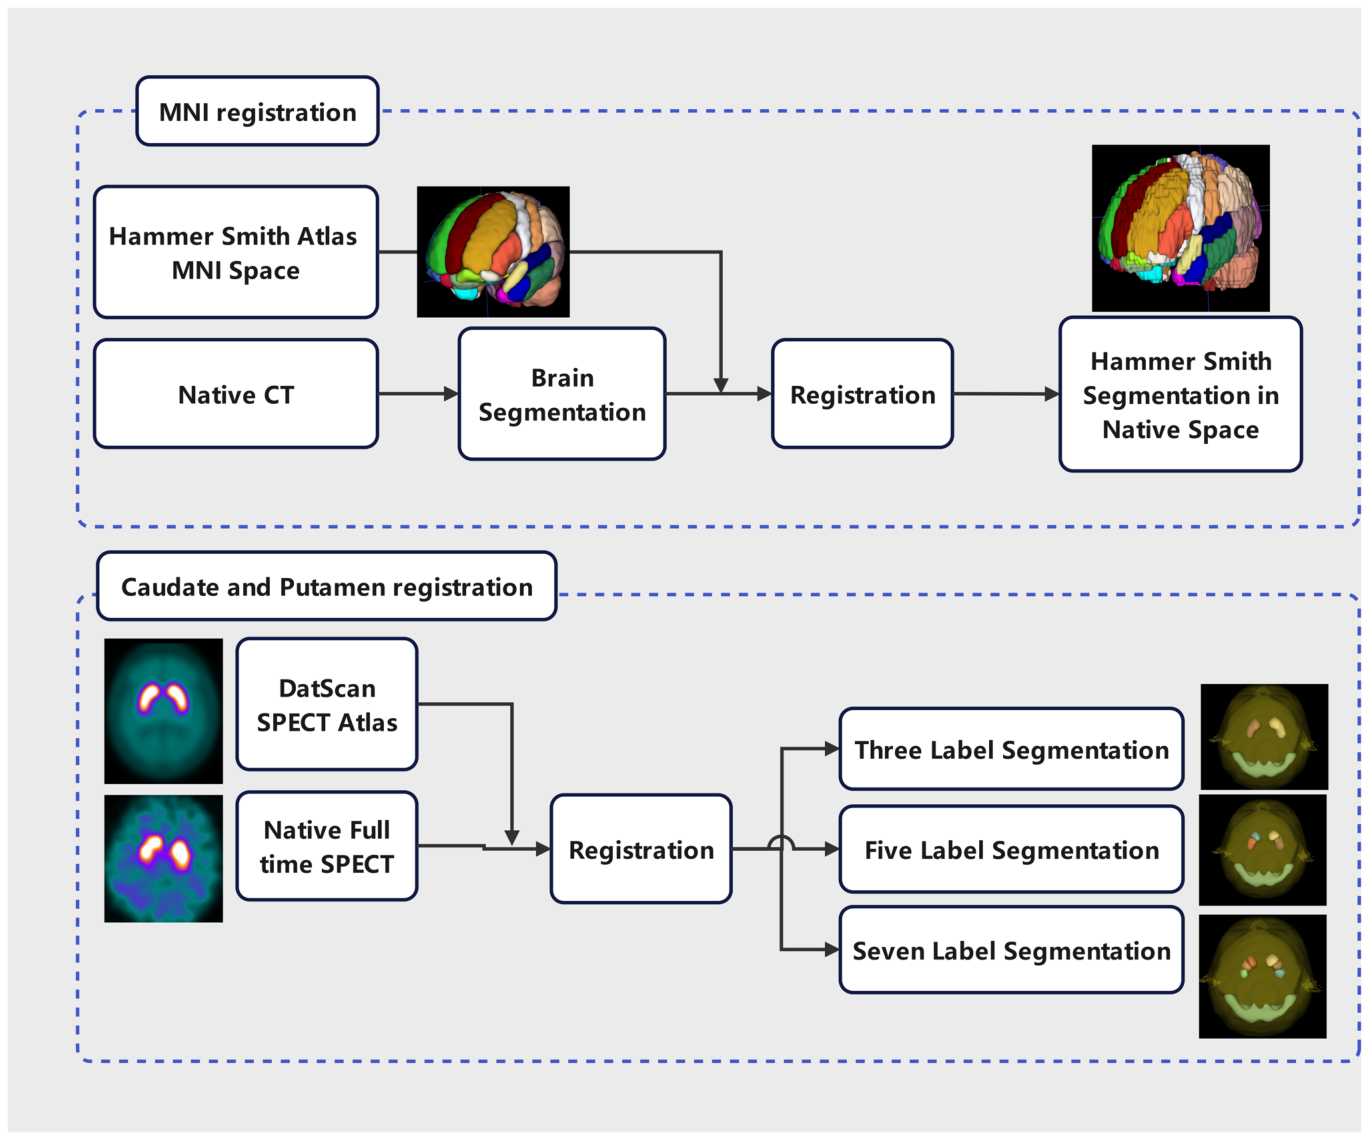
に示されています。深層学習モデルは、MONAIおよびPyTorchライブラリを用いてPythonで実装されました。アテンション機構とトランスフォーマーモジュールを組み込んだ修正U-Net DLアーキテクチャが、低カウント画像をフルタイムに相当する画像に変換するために訓練されました。モデルの重みは、入力と出力画像が同じドメインとモダリティに属するため、アイデンティティマッピングにバイアスをかける関数で初期化されました。また、SPECT画像は非負のボクセル値のみで構成されるため、Leaky_ReLU活性化関数は標準のReLU活性化関数に置き換えられました。訓練には、元のボクセル間隔2.46×2.46×2.46mmの3D画像から抽出された96×96×96ボクセルの3Dパッチが使用されました。カスタム検証指標は、ボクセルごとの構造類似性指標(SSIM)、ピーク信号対ノイズ比(PSNR)、平均絶対誤差(MAE)、平均絶対パーセンテージ誤差(MAPE)の加重組み合わせとして定義されました。また、臨床的に重要な領域にDLモデルの焦点を合わせるため、尾状核と被殻のセグメンテーション内の画像MAPEとMAEも組み込まれました。Adam最適化とL1損失関数が使用され、訓練は100エポック継続されました。85の画像は15のテストグループに分割され、残りの70ケースは5分割交差検定を用いてモデルの訓練に使用されました。訓練された5つのモデルは、それぞれ外部テストセットで推論され、予測画像はボクセル値の平均化によって結合されました。これらのステップの概要は
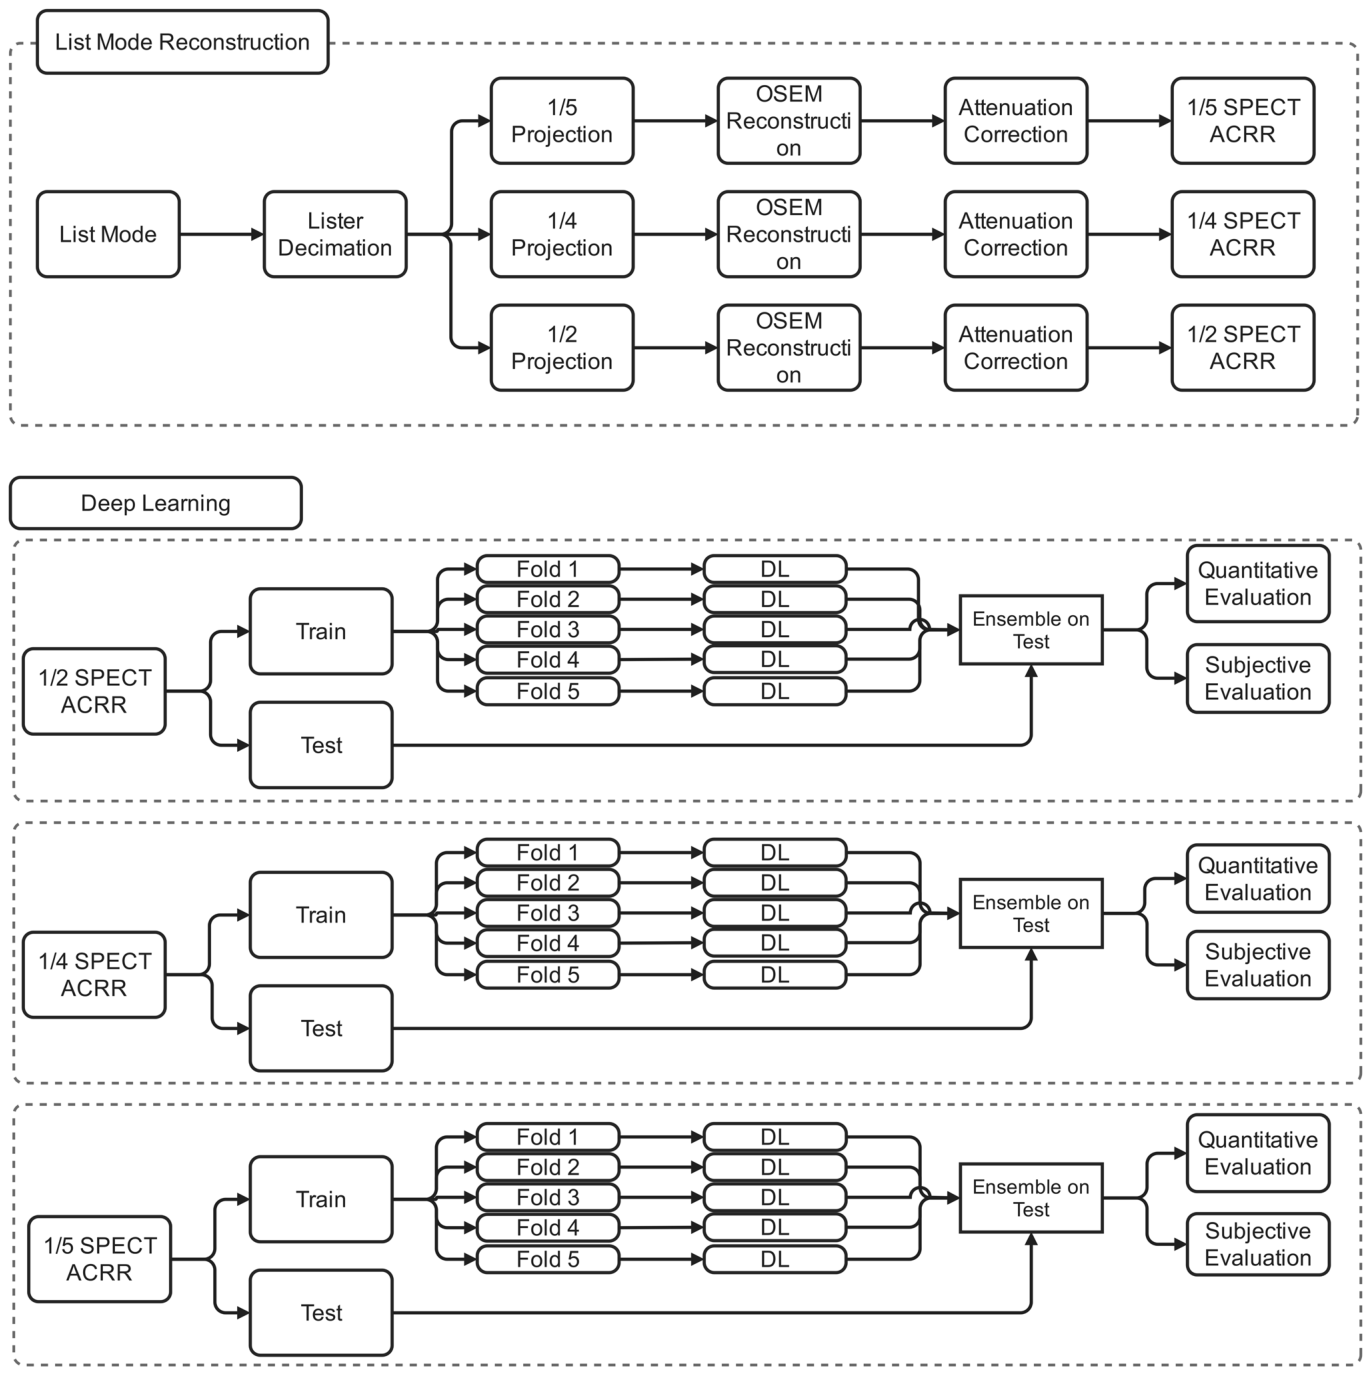
に示されています。
結果:深層学習による画質の大幅な改善
本研究の結果、深層学習(DL)予測画像は、短縮された撮像時間の画像と比較して、画質の全体的な改善、ノイズの低減、そしてフルタイム撮像画像との高い類似性を示しました。具体的には、テストセットの4名の対象者からの代表的な軸方向スライス画像が
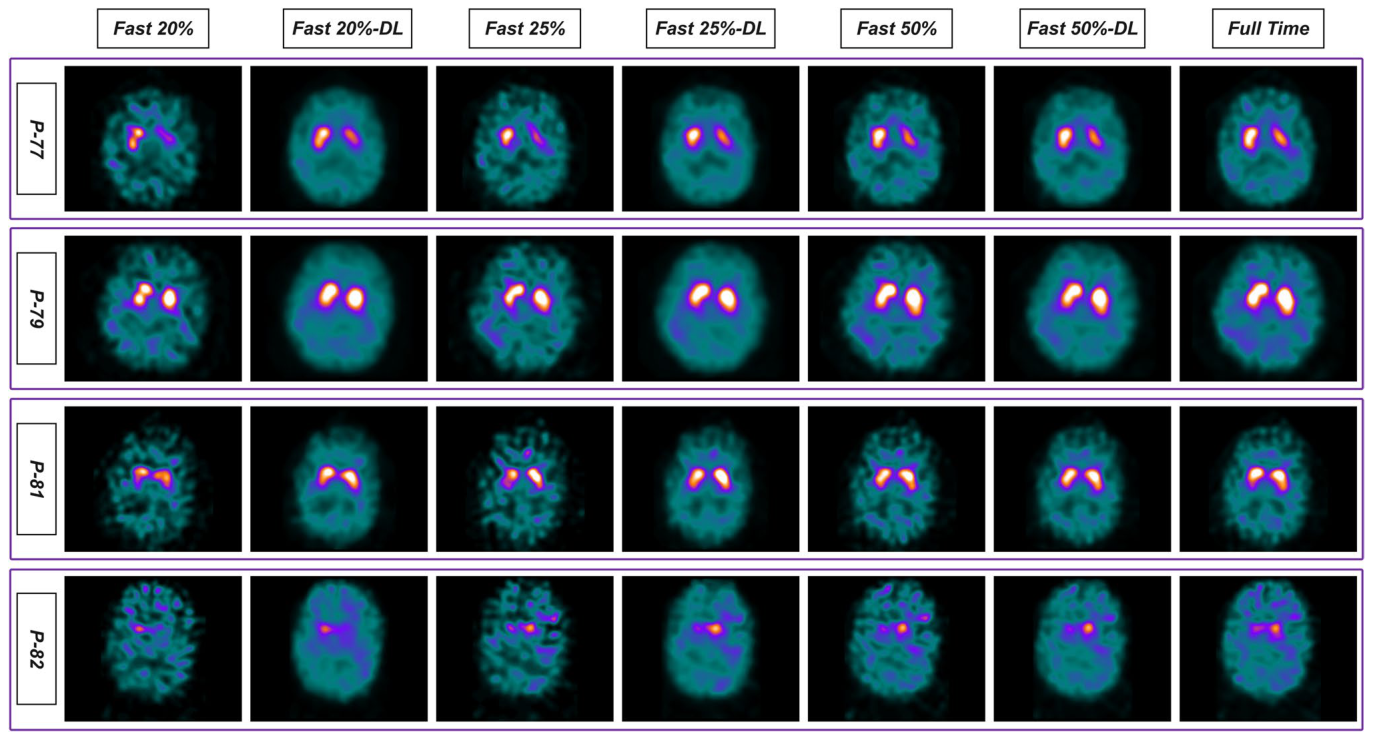
に示されており、DL予測画像がノイズを低減し、フルタイム撮像と良好な視覚的一致を保っていることが確認できます。これに対し、短時間撮像画像(特にFast 20%とFast 25%)では、ノイズの大きさ、ノイズの質感、構造パターン、解剖学的構造に顕著な変化が見られ、臨床的解釈を誤導し、誤診につながる可能性がありました。定量的な評価では、体輪郭外のボクセルを除いた画像全体のボクセルごとの指標が計算されました。平均絶対パーセンテージ誤差(MAPE)は、DLモデルを使用することで、すべての高速撮像時間(20%、25%、50%)において、高速撮像画像と比較して統計的に有意な改善(p値0.05未満)を示しました。例えば、1/5撮像時間の画像ではMAPEが約30%から約18%に、1/4撮像時間の画像では約26%から約16%に低減されました。MAE、SSIM、PSNRも、RMSEの一部の例外を除き、すべての時間レベルで改善しました。これらのボクセルごとの指標の詳細は
にまとめられており、そのボックスプロットは
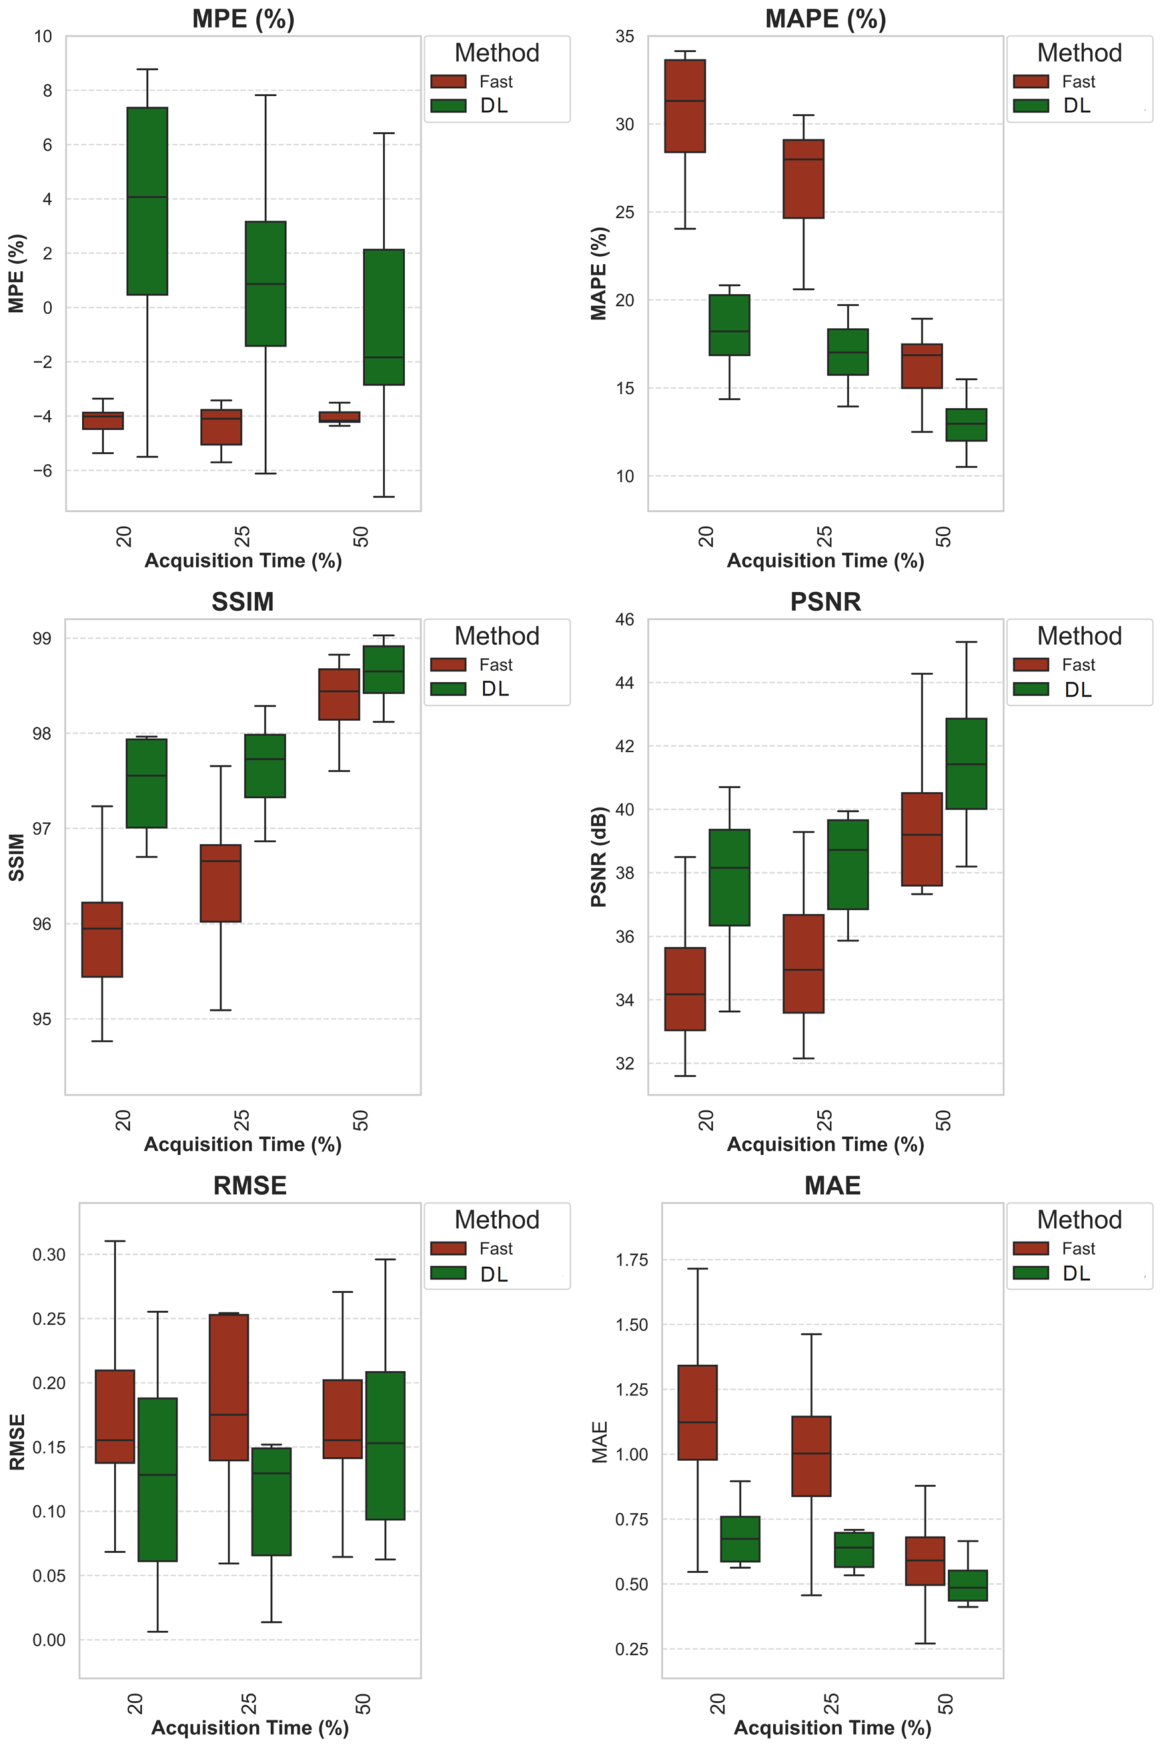
に示されています。(表2)と(図4)に示すように、DL予測画像ではすべての性能指標において顕著な改善が見られました。領域ごとの定量的評価指標は
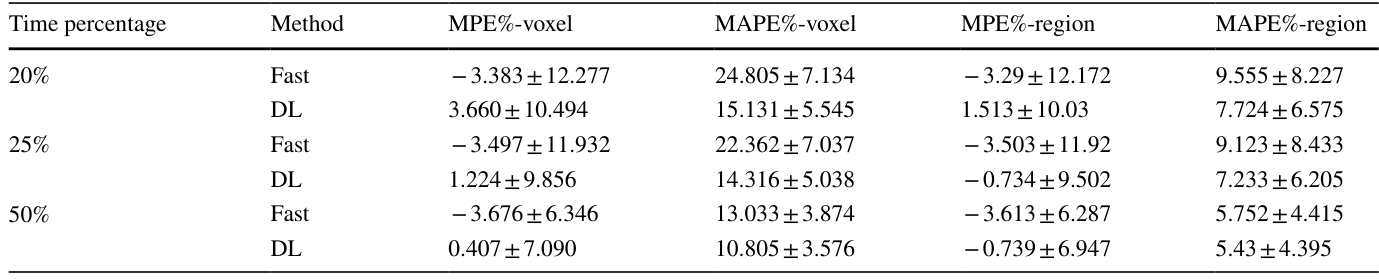
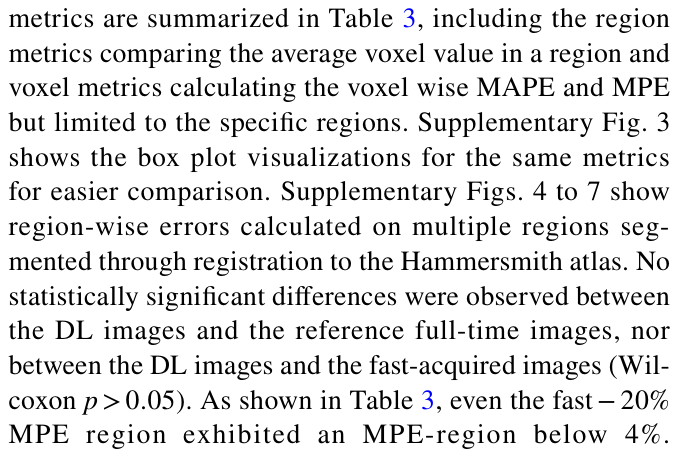
に要約されています。DL画像とフルタイムリファレンス画像の間、またはDL画像と高速撮像画像の間で統計的に有意な差は観察されませんでした(Wilcoxon p > 0.05)。質的な評価では、2名の核医学専門家が盲検下で画像品質と診断信頼度を5段階リッカート尺度で評価しました。結果は
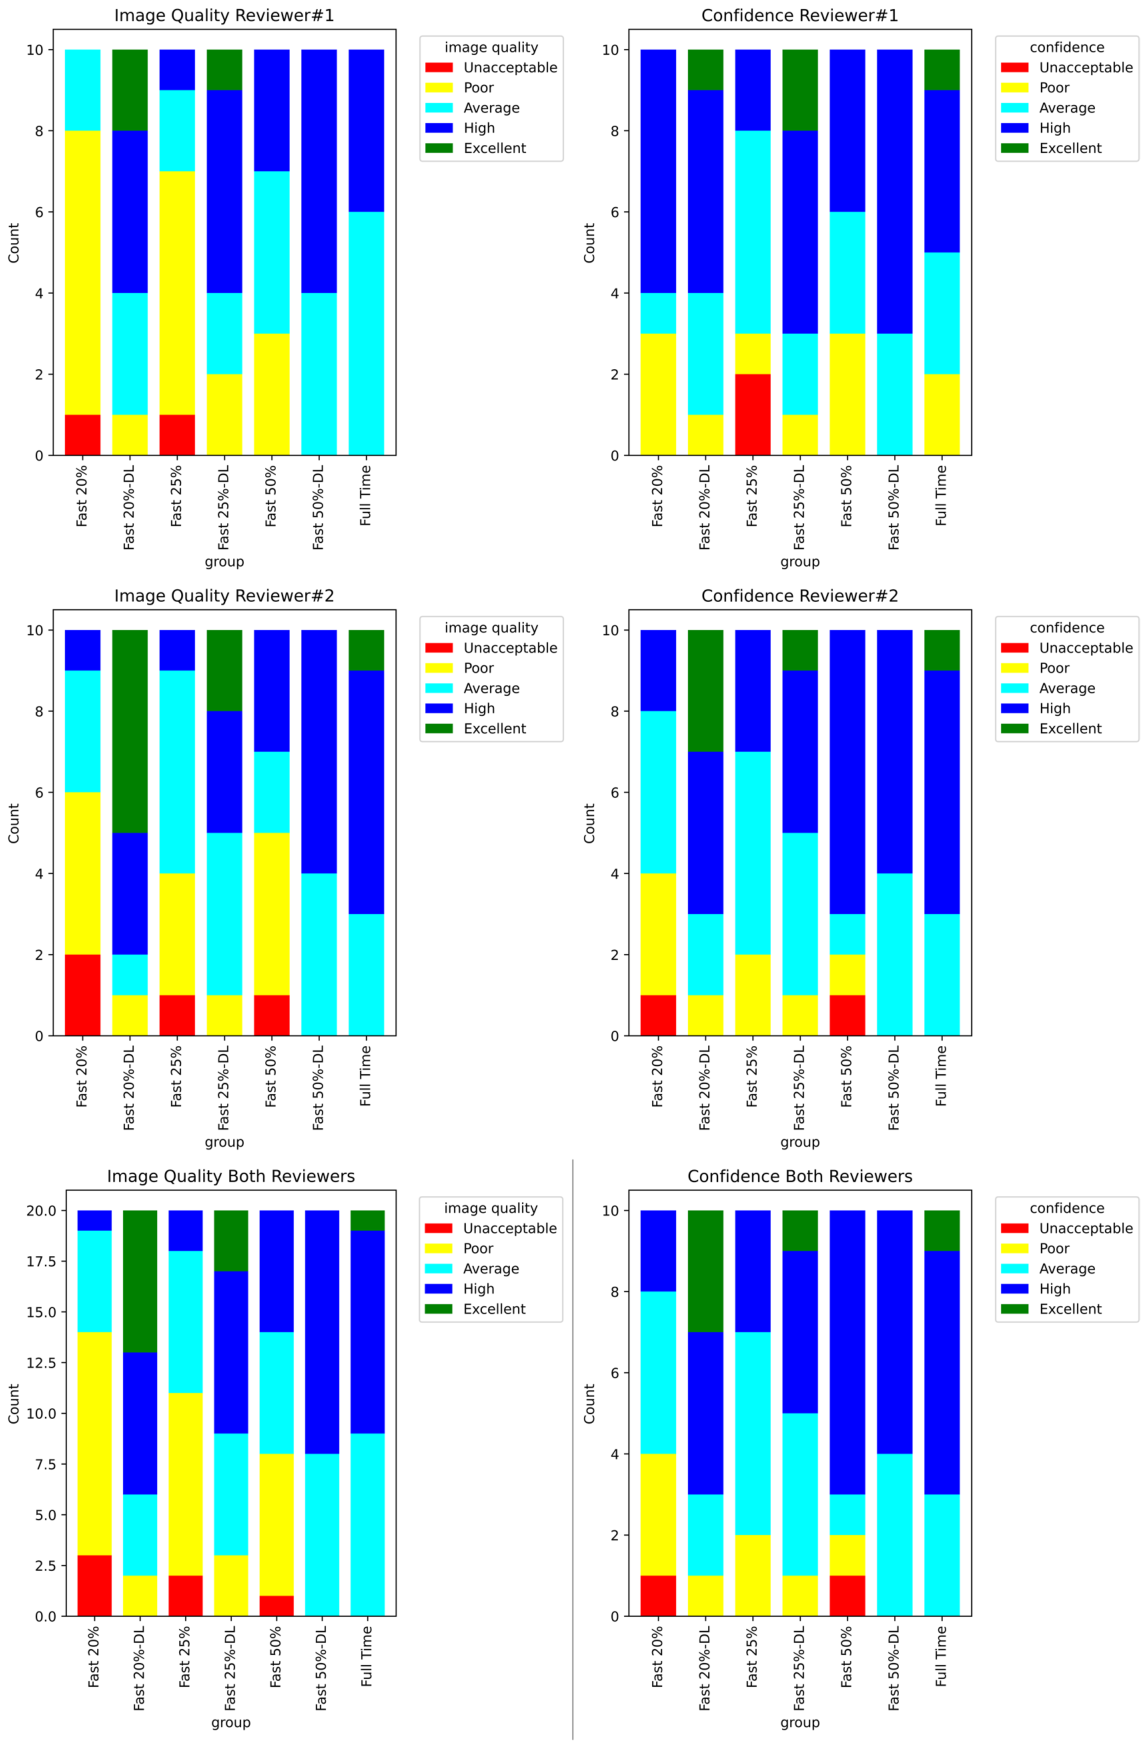
に示されており、DL予測画像は高速撮像画像に比べて、知覚される画質と診断信頼度の両方で明らかに優れていると判断されました。DL予測画像で「許容できない」画質や診断信頼度のものはなく、低撮像時間での「不十分な」画質のものはわずかでした。専門家間の評価の一致度(ICC)は0.62と良好な一致が認められました。高速撮像画像は、一部のケースで誤診を引き起こしました。特に、Fast 20%画像では30%の偽陽性率、Fast 25%画像では25%の偽陽性率と10%の偽陰性率、Fast 50%画像では20%の偽陽性率が見られました。対照的に、DL予測画像ではこれらの誤診率が大幅に低減され、Fast 20% DL予測画像では5%の偽陰性率と5%の偽陽性率、Fast 25% DL予測画像およびFast 50% DL予測画像ではそれぞれ5%の偽陰性率にとどまりました。これは、DL予測画像がより滑らかな外観を持つため、微細な病変関連の特徴を不明瞭にする可能性があるためと考えられます。
考察:撮像時間短縮のメリットと深層学習の貢献
SPECT撮像時間の短縮は、対象者、技師、および紹介・報告専門家を含む医療画像に関わる複数のグループにメリットをもたらします。中でも、主要な臨床的利益は対象者レベルで観察されます。撮像時間の短縮は、対象者の快適性と忍容性を向上させ、動きによるアーチファクトの可能性を減らし、それによって画像の診断的価値を維持します。これらの考慮事項は、特に高齢の対象者や認知機能障害のある対象者、意識レベルが低下した対象者にとって重要です。彼らは長時間撮像中に不随意運動を起こしやすく、動きによる画像劣化のリスクが高いからです。初期のSPECTシステムは、長い撮像時間と限られた画質に関連しており、診断信頼性を制限する要因となっていました。その後の検出器技術、撮像戦略、再構成アルゴリズムの進歩により、撮像時間と放射線被曝量を大幅に削減しつつ、画質と診断性能を同時に向上させることが可能になりました。これらの技術開発は、より堅牢な臨床解釈、対象者の快適性の向上、安全な画像撮像ワークフローに貢献しています。フルリングCZT SPECT装置は、これらの革新技術の多くを組み合わせた好例です。最近では、VeritonフルリングスキャナーのようなフルリングCZTシステムに実装されたDLベースの画像強化手法が臨床現場で評価され、骨SPECTスキャンで約50%の撮像時間短縮を可能にすることが示されています。これらの研究では、体格の大きな対象者においては画像強化性能を慎重に解釈する必要があることが指摘されていますが、頭部の大きさにおける個人差は、全身の体格指数(BMI)の変動よりもはるかに小さいです。本研究では、より高速に撮像された脳DaTSCAN SPECTスキャンの画質を向上させる深層学習モデルを開発しました。最適な結果を確実にするために、最先端の画像処理とAIアルゴリズムを使用しました。画質は、脳全体のボクセルごとの分析や、DaTSCANの解釈において臨床的に最も関連性の高い線条体に特に焦点を当てた領域ごとの評価を含む、複数の定量的指標を用いて系統的に評価されました。さらに、DL予測画像の臨床的有用性は、2名の専門家による盲検評価によって評価されました。彼らは独立して画質と診断信頼度を評価し、画像データと日常的に適用される被殻対尾状核比(PCR)を用いて診断を下しました。提案されたモデルは、定量的指標と質的な専門家評価の両方で一貫した性能を示しました。本研究の臨床目標は、SPECT DaTSCAN本来の診断性能を向上させることではなく、撮像時間を短縮した画像が、ゴールデンスタンダードであるフルタイムスキャンと同等の診断品質に復元できるかどうかを判断することでした。診断的に関連のある情報が、単なる画像の外観だけでなく、保存されているかを評価するため、専門家は主観的な画質を評価しただけでなく、尾状核対被殻比に基づいて診断を下し、定量的指標とともに診断信頼度と診断そのものの変化を捉えることができました。これは、静止できない、または長時間のスキャンに耐えられない対象者、および放射線防護のため、または注射された放射能の部分的な皮下漏出によって生じる低カウント研究に直接関連しています。なお、現在の知見は遡及的な専門家ベースのデザインから得られたものであり、臨床導入の前には前向きな多施設検証が必要となります。DL予測画像で計算された定量的指標は、より高い標準偏差を示す傾向がありましたが、不安定な予測や個々のモデルからの潜在的な外れ値の影響を軽減するため、アンサンブル学習戦略を採用し、5つの交差検定フォールドすべての出力を平均しました。DL U-Netモデルの既知の効果として、画像変換およびノイズ除去タスクにおいて、予測画像が過度に滑らかに見えることがあり、これがDL予測画像使用時の偽陰性診断の一因となる可能性があります。しかし、これらのケースは限定的であり、主に20%および25%の撮像時間で発生しました。GPUでの推論時間は、出力の結合を含めて10秒未満であり、現在の商用ソフトウェアの再構成が約1分かかることを考慮すると、臨床設定で許容可能です。
研究の限界と今後の展望
本研究にはいくつかの限界があります。第一に、訓練および検証ケースの数が限られており、すべてのデータが単一施設で取得されました。しかしながら、合計85ケースというコホートは、他のSPECTアプリケーションにおける同様のタスクを扱ったこれまでの研究のほとんどよりも大規模です。本研究の重要な限界は、外部検証が欠如している点です。すべてのデータは単一施設および単一スキャナープラットフォームから得られており、低カウント画像はリストモードデータを再サンプリングすることによって生成されたもので、実際の撮像時間短縮プロトコルで取得されたものではありません。したがって、本研究の知見は概念実証として解釈されるべきであり、より広範な臨床的主張をする前に、前向きな多施設検証が必要となります。私たちはモデルと推論手順、およびプログラミングスキルの低いユーザーや臨床専門家向けに使いやすいSlicer 3Dモジュールを公開しました。モデルはStarGuideデータで訓練されましたが、このアプローチは従来のデュアルヘッドSPECTシステムにも転用可能である可能性があります。しかし、ハードウェアと再構成の違いにより、再訓練と検証が必要です。これを容易にするため、訓練済みモデルと推論パイプラインは公開されており、興味のある研究者が自身のシステムでこの手法を評価したり、転移学習の初期重みとして使用したりすることが可能です。リストモードの生データをデシメートすることは、実際の撮像時間短縮をシミュレートする最も信頼性が高く現実的な方法です。これは、各対象者を2回スキャンする(1回は長時間、1回は短時間)という方法に劣らないものです。本研究では、撮像時間短縮の効果のみを方位角あたりの時間という観点から評価し、StarGuide画像再構成プロセスの技術的な問題と複雑な性質のため、投影数削減の影響は検討しませんでした。また、マスクはトレーニング段階でのみ使用されたため、潜在的な不正確さはトレーニング効率に影響を与える可能性がありますが、訓練済みモデルが新しいケースに適用される推論段階には影響しないことに留意すべきです。
結論:診断的価値を維持した高速DaTSCAN SPECTへの道
本研究では、高速撮像DaTSCAN脳SPECT画像のための深層学習ベースの強化モデルを開発しました。これにより、診断画質と臨床解釈性を維持しながら撮像時間の短縮を目指しました。撮像時間固有のモデル、ボクセルごとの指標、領域ごとの指標、および臨床的に関連性の高い線条体計測を訓練および評価フレームワークに統合することで、提案されたアプローチは、フルタイム撮像と同等の定量的および質的性能を持つ画像を一貫して生成しました。これらの知見は、診断信頼性を損なうことなく撮像時間を半分に短縮する可能性を支持するものであり、DL支援撮像が対象者の体験を向上させ、動きによるアーチファクトを減らし、核医学手順における運用効率を最適化する潜在的な可能性を強調しています。この閾値(50%短縮)を超えた短縮は、診断信頼性が維持されない可能性があるため、慎重にアプローチすべきです。
用語集
- SPECT: 単一光子放射型コンピューター断層撮影。放射性同位元素から放出されるガンマ線を検出し、体内の3次元分布を画像化する核医学検査。
- DaTSCAN: I-123イオフルパンを用いたSPECT撮像で、ドーパミントランスポーターの分布を可視化し、パーキンソン病などの診断に利用される。
- 深層学習 (DL): 多層のニューラルネットワークを用いる機械学習の一種で、データから複雑なパターンを自動的に学習する技術。
- U-Net: 医療画像分野で広く用いられる深層学習モデルのアーキテクチャ。画像セグメンテーションやノイズ除去に特に有効。
- アテンション機構: 深層学習モデルが入力データ内の重要な部分に焦点を当てることを可能にするメカニズム。
- トランスフォーマー: アテンション機構に基づいて構築された深層学習モデルのアーキテクチャ。長距離の依存関係のモデリングに優れる。
- CZTベースカメラ: テルル化カドミウム亜鉛(CZT)半導体検出器を使用したSPECTカメラ。高感度で高いエネルギー分解能を持つ。
- OSEM: オーダーサブセット期待値最大化。核医学画像の再構成に用いられる反復アルゴリズムの一種で、高速な画像生成が可能。
- MAPE: 平均絶対パーセンテージ誤差。予測値と実際の値の誤差をパーセンテージで表した指標。
- SSIM: 構造類似性指標。2つの画像の輝度、コントラスト、構造の類似性を評価する指標で、人間の視覚による知覚に近い評価が可能。
- PSNR: ピーク信号対ノイズ比。画像品質を評価する指標の一つで、元の画像と処理された画像の類似度をデシベル単位で示す。
- MAE: 平均絶対誤差。予測値と実際の値の絶対差の平均。
- 線条体: 脳の主要な部分の一つで、運動制御や報酬学習に関与する。被殻と尾状核を含む。
- 被殻: 線条体の一部で、運動機能に関与する。DaTSCANでドーパミントランスポーターの密度が評価される重要な領域。
- 尾状核: 線条体の一部で、学習、記憶、運動制御に関与する。被殻と同様にDaTSCANで評価される。
- PICO: エビデンスに基づく医療における臨床疑問の定式化フレームワーク(対象者, 介入, 比較, 結果)。
- FINER: 研究課題の評価基準(実行可能か Feasible, 倫理的か Ethical, 興味深いか Interesting, 新規性があるか Novel, 関連性があるか Relevant)。
コメントを残す