
手術ロボットの精度を革新:PICOモデルによる6DoF手術器具姿勢推定のブレークスルー
解説対象論文: PICO: Projection-Informed Consistency Optimisation for 6DoF surgical tool pose estimation
International Journal of Computer Assisted Radiology and Surgery|被引用数: 0(2026年9月26日時点)
現代の医療現場では、手術ロボットの活用が急速に進んでいますが、その精度と安全性をさらに高めるためには、手術器具の正確な位置と向き(6自由度姿勢)をリアルタイムで把握することが不可欠です。しかし、既存の技術には、誤差の蓄積や外部マーカーへの依存といった課題がありました。本記事では、これらの壁を打ち破るべく開発された画期的なAIモデル「PICO」をご紹介します。PICOは、単一の段階で姿勢を直接推定し、画像認識の精度と速度を両立させることで、未来の手術ロボットに新たな可能性をもたらします。
手術ロボットの「目」を強化する:PICOモデルとは?
どうも、Beyond the Pixelです。現代の外科手術において、ロボット技術の導入は飛躍的な進歩をもたらしています。特に、手術ロボットが組織と安全に相互作用し、高度な自動化を実現するためには、手術器具の正確な「姿勢推定」が不可欠です。姿勢推定とは、物体が3次元空間内でどのような位置にあり、どのような向きになっているかを特定する技術を指します。現在広く利用されているda Vinci® Surgical Systems(dVSS)などのロボットアームは、アームの関節角度から姿勢を推定する「運動学に基づくアプローチ」を採用していますが、ケーブルの弛みや摩擦、複数の関節にわたる誤差の蓄積により、最大1.02mmもの誤差が生じることがあります。これは手術環境では許容できない精度であり、神経や血管などの重要な構造に意図しない損傷を与えるリスクを伴います。このような課題に対し、画像認識に基づく手法は、手術環境の動的な変化にも対応できる可能性を秘めていますが、多くは外部マーカーやトラッカーに依存したり、リアルタイムの堅牢性に欠ける2段階の姿勢推定法であるという限界がありました。手術室での外部マーカーの使用は、滅菌作業や視野の遮蔽といった問題から現実的ではありません。本稿では、これらの課題を克服するために提案された、リアルタイムで高精度な6自由度(6DoF)手術器具姿勢推定を可能にする画期的なエンドツーエンド学習モデル「PICO」について、その詳細を解説します。
PICOモデルの革新的なアプローチ:マルチタスク学習と幾何学的整合性
「PICO(Projection-Informed Consistency Optimisation)」モデルは、手術器具の6自由度(6DoF)姿勢推定を単一の段階で直接行う「エンドツーエンド学習可能なモデル」として設計されています。これは、中間的な特徴を予測してから最終的な姿勢を推定する従来の2段階のアプローチとは異なります。PICOの核となるのは、「マルチタスク学習」と、2Dおよび3D空間における「幾何学的整合性」を強制する2つの「代理タスク」の導入です。マルチタスク学習とは、一つのニューラルネットワークが複数の関連するタスク(この場合はセグメンテーション、深度推定、姿勢回帰)を同時に学習する手法です。これにより、各タスクが互いに情報を共有し、全体としての性能と堅牢性が向上します。具体的には、PICOモデルは、入力された単眼RGB画像から、手術器具の「セグメンテーションマスク」(画像中の器具の領域を示す二値マスク)と「深度マップ」(画像中の各ピクセルまでの距離を示す情報)を予測するとともに、器具の「並進パラメータ」(3次元空間での位置)と「回転パラメータ」(3次元空間での向き)を直接回帰(数値を予測)します。このモデルの訓練フレームワークの概要は
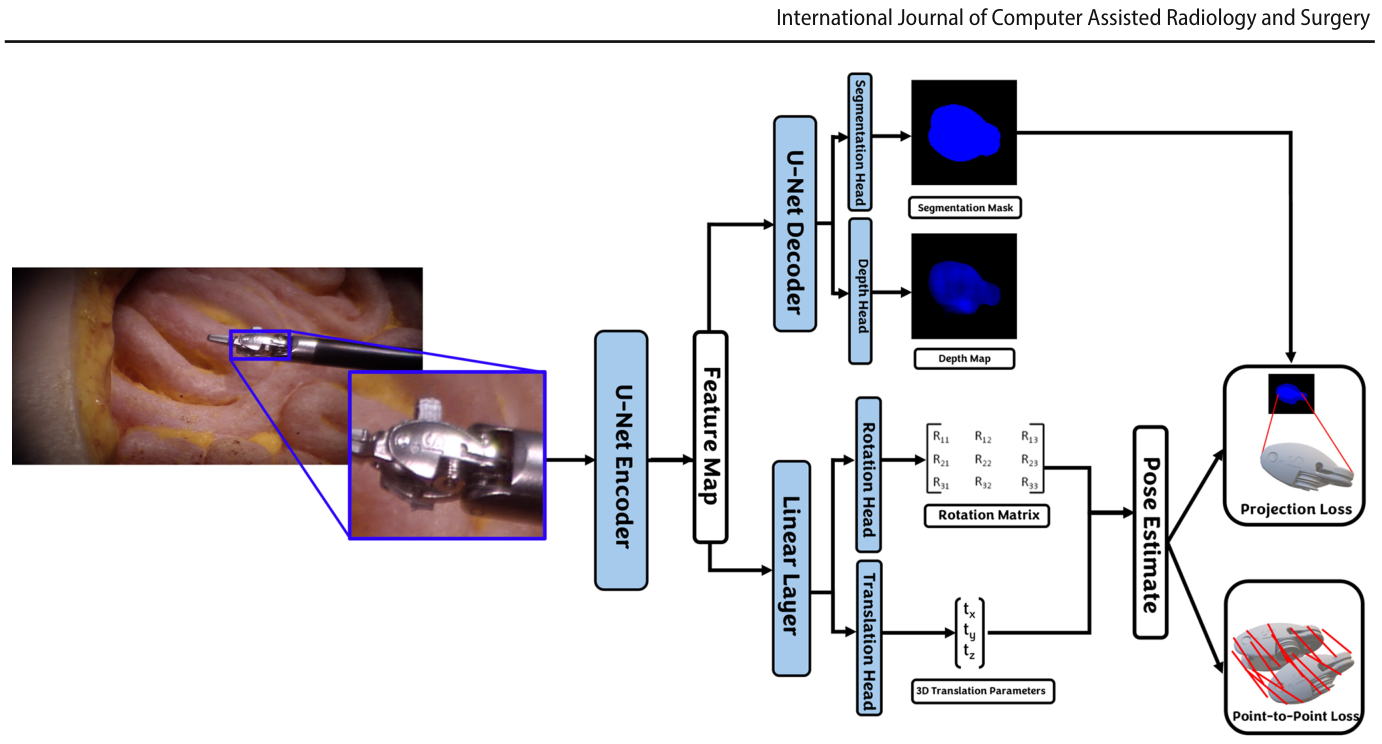
で示されています。さらに、PICOは以下の2つの代理タスクを導入しています。
- 投影損失(Projection Loss):予測された姿勢に基づいて3D器具モデルを2D画像平面に投影し、その結果生成される二値マスクと、モデルが予測したセグメンテーションマスクとの間の幾何学的整合性を強制します。これにより、2Dの見た目と3Dモデルの空間的な整合性が保たれます。
- 点間損失(Point-to-Point Loss):予測された姿勢と正解の姿勢をそれぞれ3D器具モデルの点群に適用し、対応する点間の「二乗平均平方根誤差(RMSE)」を最小化します。これにより、3D空間における器具の形状と位置の整合性が促進されます。
これらの代理タスクは、モデルがより正確で堅牢な姿勢推定を行うための重要な手がかりを提供します。特に、従来の2段階手法が抱えていた、中間予測における誤差の蓄積や計算オーバーヘッドによるリアルタイム性能の低下といった問題を、エンドツーエンドの単一段階で解決することを目指しています。
PICOモデルの仕組み:詳細なアーキテクチャと損失関数
PICOモデルは、入力されたクロップ済み単眼RGB画像から手術器具の6DoF姿勢を推定するために、マルチタスク学習フレームワークを採用しています。まず、ResNet-50をエンコーダバックボーンとするU-Netスタイルのアーキテクチャを用いて、入力画像から特徴量を抽出します。抽出された特徴マップは、デコーダネットワークを経て、セグメンテーションと深度予測のための個別のヘッドへと送られます。同時に、エンコーダの特徴量は線形層を通過した後、姿勢推定のための回転および並進回帰ヘッドへと送られます。
並進予測タスクは、さらに2つのサブタスクに分けられます。一つは画像内の器具ジョイントの2D (x,y) ピクセル座標の予測、もう一つはカメラからの深度(z)の予測です。回転は3×3行列として直接回帰され、特異点のない一意な3D空間表現を保証するために特異値分解(SVD)を用いて有効な回転行列に射影されます。
ネットワークの学習には、以下に示す複数の損失関数を組み合わせた「マルチタスク損失関数」が用いられます。
- セグメンテーション損失(Segmentation Loss):予測されたセグメンテーションマスクと正解のマスク間の「Dice損失」を計算し、セグメンテーション性能を向上させます。
- 深度損失(Depth Loss):単眼深度推定のために設計された「スケール不変損失」を使用し、ピクセルごとの誤差と相対的な深度関係を考慮します。
- 投影損失(Projection Loss):予測姿勢から生成される投影された2D二値マスクと、予測されたセグメンテーションマスク間のDice損失を計算し、2D画像空間と3Dモデル空間のアラインメントを保証します。
- 点間損失(Point-to-Point Loss):予測姿勢と正解姿勢で変換された3Dモデルの点群間のRMSEを最小化し、3D空間における整合性を促進します。
- 回転損失(Rotation Loss):回転行列間の角度距離を測定する「測地線損失関数」を使用し、より直感的な回転予測の尺度を提供します。
- 並進損失(Translation Loss):予測された並進と正解の並進の(x,y)成分およびz成分について、それぞれRMSEを最小化します。
これらの損失項の組み合わせにより、2Dと3Dの両方のドメインにわたる包括的な教師信号が提供され、ネットワークは予測された器具の見た目と根底にある3D幾何学的形状との整合性を保ちながら、正確な6DoF姿勢を学習することができます。
PICOモデルの評価と性能:リアルタイムでの堅牢性
著者らは、PICOモデルの性能を「SurgRIPEデータセット」を用いて評価しました。このデータセットには、2種類の外科用器具(大型ニードルドライバー(LND)とメリーランドバイポーラ鉗子(MBF))の単眼RGB画像が含まれ、遮蔽されたケースとされていないケースの両方でテストが行われました。性能評価には、標準的な6DoF姿勢推定指標である「並進誤差」(mm単位の距離誤差)、「回転誤差」(度単位の角度誤差)、および「ADD指標」(器具の直径の10%未満の平均距離を持つ点群の割合)が用いられました。
PICOモデルは、すべての4つのテストデータセット(LND、LND遮蔽、MBF、MBF遮蔽)において、一貫して強力な性能を示しました。特に回転精度においては、遮蔽下であっても第2位にランクインする優れた結果を達成しました。これは、他の多くの手法(PVNetなど)と比較して、特に遮蔽されたケースで競争力のある並進性能も示しています。
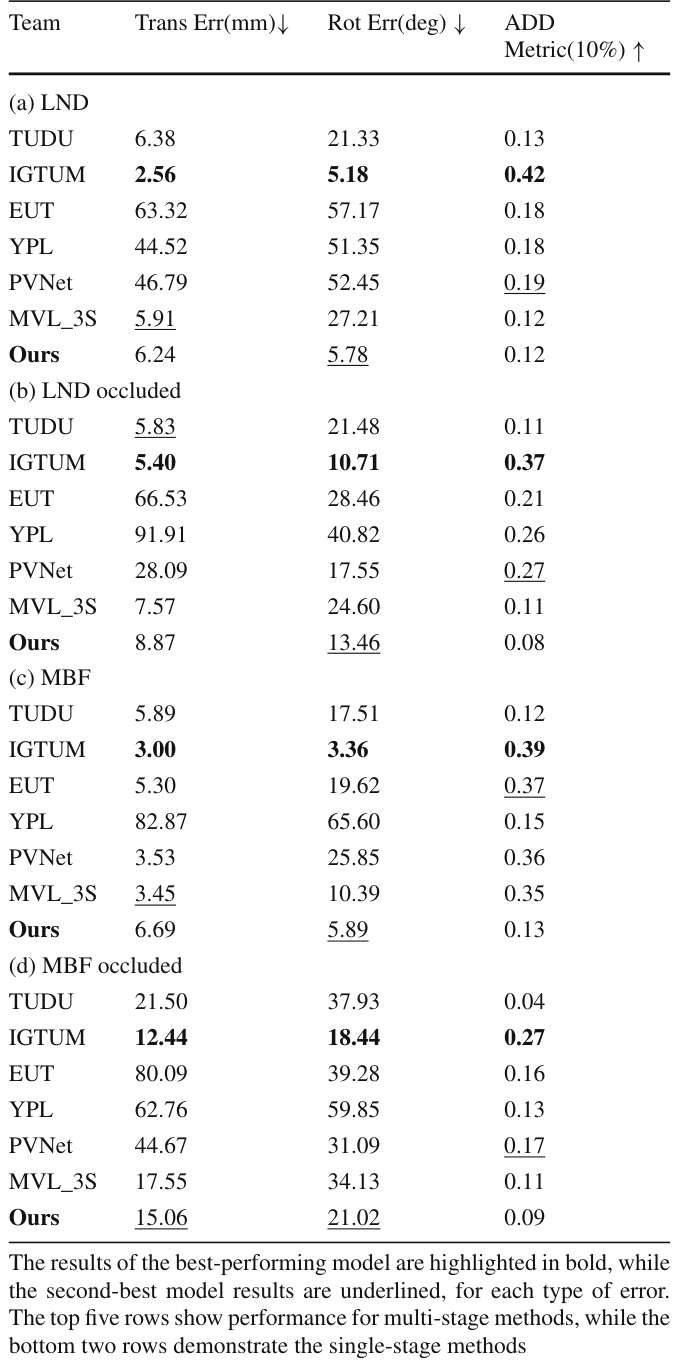
は、SurgRIPEチャレンジで評価されたさまざまなモデルの性能を比較したものです。この表から、PICOモデルが特に回転誤差において競合他社、特に他の単一段階手法と比較して大幅な改善を達成していることがわかります。
注目すべきは、PICOモデルが単一段階(エンドツーエンド)アプローチでありながら、多くの2段階アプローチに匹敵する、あるいはそれ以上の精度を達成している点です。さらに、計算効率の観点からも優れており、コンシューマーレベルのNVIDIA Tesla T4 GPUで約33フレーム/秒(FPS)の推論時間を実現しています。これは、リアルタイム処理の目安とされる30 FPSを上回るものであり、動的な手術環境におけるリアルタイムアプリケーションへの適用可能性を明確に示しています。
また、著者らは損失関数における各要素の影響を評価するためのアブレーションスタディも実施しました。
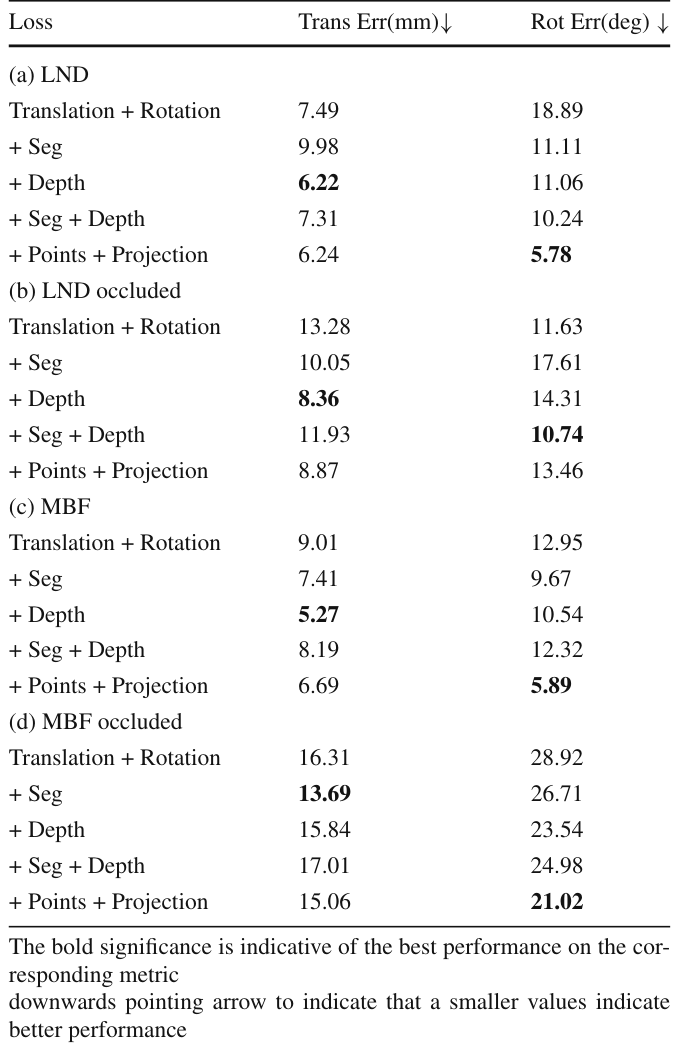
に示されているように、個別の補助タスク(深度とセグメンテーション)は特定の姿勢成分に効果を発揮しますが、それらを組み合わせただけでは常に性能が向上するわけではありませんでした。しかし、投影損失と点間損失という2つの幾何学的整合性代理タスクを導入することで、これらのトレードオフが解消され、モデル全体の性能が大幅に向上することが示されました。
PICOモデルが、並進誤差や回転誤差がより大きい他の手法よりも低いADDスコアを達成していることから、ADD指標が単独では両方の誤差指標に反映されない特定の失敗モードを捉えている可能性が示唆されました。
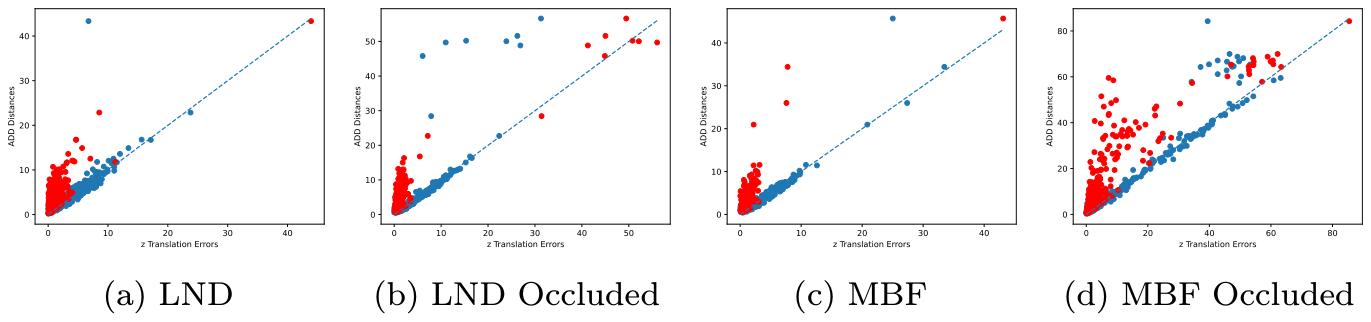
は、xy平面と深度方向(z)の並進誤差とADD距離の関係を示しています。これを見ると、z方向の誤差がADD距離と強い単調関係にあることが明らかになり、ADD距離が深度誤差の大きさに敏感であることが示されています。これは、深度誤差がADDスコアの主要な制限要因であることを意味します。
PICOモデルの限界と今後の展望
PICOモデルは多くの有望な結果を示していますが、いくつかの限界も存在します。まず、長方形ではない画像クロップを固定された正方形の解像度にリサイズする際、わずかなアスペクト比の歪みが生じる可能性があります。これは、検出された器具の周囲にクロップを厳密に中央に配置することで軽減されていますが、完全に排除されるわけではありません。次に、擬似深度マップの生成方法にも課題があります。3Dメッシュからランダムにサンプリングされた点を最も近いピクセルに割り当てる方法は、真の可視表面の近似に過ぎず、穴を近隣の深度値で埋めることは、オブジェクトの境界を滑らかにし、幾何学的に非現実的な深度推定を導入する可能性があります。
また、手術領域におけるグラウンドトゥルース姿勢アノテーション付きデータセットの利用可能性が限られていることも、研究の限界です。SurgRIPEデータセットが現状では唯一公開されており、このため、競合する手法との比較は、対応するベンチマークチャレンジ論文で報告された結果に限定され、完全に再現可能な実装に基づくものではありません。さらに、未知の器具や手術環境への汎化性には依然として課題があり、今後の研究ではデータ拡張やドメイン適応の必要性が指摘されています。
これらの課題にもかかわらず、PICOモデルはリアルタイム、マーカーレスな6DoF手術器具姿勢推定に向けた有望な道筋を示しています。今後の改善は、深度モデリングの精度向上と、ドメイン適応やデータ拡張を通じて、未知の器具や手術環境、シナリオへの汎化能力を高めることに焦点を当てるでしょう。
まとめ:手術ロボットの安全性と効率性を高めるPICOの貢献
本稿では、単眼RGB画像から手術器具の6DoF姿勢を高精度かつ堅牢に推定するという課題に取り組みました。この問題は、遮蔽や限られた幾何学的情報のために空間推論が困難となる手術環境において特に重要です。著者らが提案したPICOモデルは、マルチタスク学習を活用し、セグメンテーションと深度を共同で予測しながら、回転と並進のパラメータを直接回帰する、 novel なリアルタイムのエンドツーエンド学習アプローチです。さらに、2Dおよび3D空間における幾何学的整合性を強制する、投影損失と点間損失という2つの代理タスクを導入することで、姿勢推定の堅牢性と精度を向上させています。SurgRIPEデータセットを用いた実験結果は、PICOが既存の手法に対して競争力のある並進および回転精度を達成すること、特に遮蔽された環境でのその堅牢性を実証しました。これは、学習プロセスにおける幾何学的整合性の組み込みが重要であることを強調しています。PICOの単一段階フレームワークは、他の単一段階手法と比較して回転精度を大幅に向上させ、また多段階手法とも競争力を保ちつつ、約33 FPSの実行時間で動作するため、リアルタイム手術アプリケーションへの適用可能性も示しています。PICOモデルは、手術ロボットの将来において、より安全で効率的な自動化の実現に向けた重要な一歩となるでしょう。
用語集
- 姿勢推定: 物体が3次元空間内でどのような位置にあり、どのような向きになっているかを特定する技術。
- 6自由度 (6DoF): 3つの並進(前後、左右、上下)と3つの回転(ロール、ピッチ、ヨー)の計6つの運動の自由度で、物体の位置と向きを完全に記述する概念。
- 運動学に基づくアプローチ: ロボットアームの関節角度など、機械の内部的な情報から物体の姿勢を推定する方法。誤差が蓄積しやすいという課題がある。
- 画像認識に基づく手法: カメラで撮影した画像データを用いて、物体の姿勢を推定する方法。外部環境の変化にも対応しやすい。
- 外部マーカー/トラッカー: 物体の姿勢を特定するために、対象物に物理的に取り付けられる目印や追跡装置。
- 2段階の姿勢推定法: まず画像からキーポイントやセグメンテーションなどの特徴を検出し、その後に検出された特徴を用いて姿勢を計算する手法。
- エンドツーエンド学習可能なモデル: 入力から出力までを一貫した単一のネットワークで処理し、全体として学習・最適化するモデル。
- マルチタスク学習: 一つのニューラルネットワークが複数の関連するタスク(例:セグメンテーション、深度推定、姿勢回帰)を同時に学習する手法。
- セグメンテーションマスク: 画像内で特定の物体が占めるピクセル領域を識別し、二値(物体か背景か)または多値(複数の物体クラス)で示す画像。
- 深度マップ: 画像中の各ピクセルがカメラからどのくらいの距離にあるかを示す情報を持った画像。
- 並進パラメータ: 3次元空間における物体の位置(X, Y, Z座標)を表す数値。
- 回転パラメータ: 3次元空間における物体の向き(ロール、ピッチ、ヨーなどの角度)を表す数値。
- 回帰: 入力データから連続的な数値(この場合は並進や回転のパラメータ)を予測する機械学習タスク。
- 代理タスク: 主要なタスクの直接的な監督が難しい場合に、そのタスクの学習を補助するために設定される、関連性の高い別のタスク。
- 幾何学的整合性: 物体の2D画像表現と3Dモデル表現の間で、形状や位置関係が矛盾なく一致していること。
- 投影損失: 予測された3D姿勢に基づいて3Dモデルを2D画像平面に投影した結果と、画像認識モデルが予測したセグメンテーションマスクとの間の誤差を測る損失関数。幾何学的整合性を強制する。
- 点間損失: 予測された姿勢で変換された3Dモデルの点群と、正解の姿勢で変換された3Dモデルの点群との間の距離誤差を測る損失関数。3D空間での整合性を促進する。
- SurgRIPEデータセット: 手術器具の6DoF姿勢推定のために用意された、単眼RGB画像を含む公開データセット。
- オクルージョン/遮蔽: 画像において、対象となる物体の一部または全体が他の物体によって隠されてしまう現象。
- U-Netスタイルのアーキテクチャ: セグメンテーションタスクで広く用いられる、エンコーダとデコーダからなる対称的なニューラルネットワーク構造。
- ResNet-50エンコーダバックボーン: U-Netなどのモデルで画像から特徴量を抽出するために使用される、ResNetファミリーの「ResNet-50」という種類の畳み込みニューラルネットワーク。
- Dice損失: 主に画像セグメンテーションタスクで用いられる損失関数で、予測されたセグメンテーションマスクと正解のマスクとの重なり度合いを評価する。
- スケール不変損失: 単眼深度推定のために設計された損失関数で、絶対的な深度スケールの変動に影響されず、相対的な深度関係を正確に学習することを目指す。
- 測地線損失関数: 回転行列間の角度距離を測定する損失関数で、通常のユークリッド距離よりも回転の誤差をより正確に反映する。
- 二乗平均平方根誤差 (RMSE): 予測値と実際の値の差の二乗の平均の平方根であり、誤差の大きさを評価する指標。
- ADD指標: 物体姿勢推定の評価指標の一つで、グラウンドトゥルース姿勢と予測姿勢で変換された点群間の平均距離を測定し、その距離が器具直径の10%未満であるインスタンスの割合を評価する。
- 推論時間: 学習済みのモデルが新しい入力データに対して予測を行うのにかかる時間。
- FPS (Frames Per Second): 1秒間に処理できる画像のフレーム数を示す指標で、リアルタイム処理の性能を表す。
コメントを残す