
心臓MRI報告書におけるAI活用:LGE記載の質向上への影響
解説対象論文: Impact of Documentation Aids on the Inclusion of Salient Left-Ventricular Late Gadolinium Enhancement Characteristics in Cardiac Magnetic Resonance Imaging Impressions
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年10月31日時点)
心臓磁気共鳴画像法(CMR)における遅延ガドリニウム造影(LGE)は、心筋症の診断と予後予測に不可欠なバイオマーカーです。しかし、LGEのパターン、分布、重症度といった重要な特性が、日常のCMR報告書で一貫して記載されていないという課題があります。本研究は、構造化報告書と大規模言語モデル(LLM)支援による所見生成が、このLGE報告の完全性と一貫性をどのように改善できるかを評価しました。本記事では、この研究の知見を基に、AIが医療画像診断報告の質をどのように向上させうるかを探ります。
はじめに:心臓MRI報告の課題とAIへの期待
どうも、Beyond the Pixelです。心臓磁気共鳴画像法(CMR)における「遅延ガドリニウム造影(LGE)」は、虚血性心筋症(ICM)や非虚血性心筋症(NICM)の診断と予後予測において極めて重要なバイオマーカーです。LGEは心筋の線維化や瘢痕化を検出するゴールデンスタンダードとされており、そのパターン、分布、程度は致死性不整脈や心血管イベントの強力な予測因子であることが示されています。しかし、日常のCMR報告書において、このLGEの重要な特性(パターン、分布、重症度)の記載が必ずしも完全かつ一貫しているわけではありません。これは、CMRが提供する広範な情報と、明確で簡潔な報告が求められるというニーズの間で、しばしばバランスが取れていないことに起因します。報告書の不完全さや不明確さは、最適な臨床管理の機会を逃すことにもつながりかねません。この課題に対処するため、構造化報告書(標準化されたフォーマットを使用)や大規模言語モデル(LLM)を用いたAI支援報告など、様々なアプローチが提案されています。本記事では、オープンアクセス論文「Impact of Documentation Aids on the Inclusion of Salient Left-Ventricular Late Gadolinium Enhancement Characteristics in Cardiac Magnetic Resonance Imaging Impressions」に基づき、これらの補助ツールがLGE報告の質にどのような影響を与えるかを深掘りします。
研究の目的:LGE報告の課題解決に向けて
この研究の目的は、臨床的なCMR報告書におけるLGE報告の一貫性と完全性を評価し、構造化報告書とAI支援による所見生成の導入が、これらの報告におけるギャップをどの程度埋めることができるかを検討することでした。具体的には、報告書の形式、専門家の専門分野、およびAI支援による生成が、臨床的なCMR所見におけるLGEのパターン、分布、重症度の伝達にどのように影響するかを明らかにすることで、LGE記載の明確性と詳細を改善する機会を特定することを目指しました。
研究方法:AIと人間による報告書評価
この遡及的観察研究では、まず人間の専門家によるLGE記載習慣を評価するため、828件の非構造化CMR報告書(1990年~2023年)と400件の構造化CMR報告書(2024年~2025年、構造化報告が広範に導入された時期以降)が分析されました。これらの報告書から、LGEのパターン(心内膜下、心筋内、全層性、心外膜性)、分布(限局性、斑状、びまん性、冠動脈分布)、重症度(軽度、中等度、広範囲/重度)の記載が特定されました。重症度は心筋量の割合(5%以下、6~14%、15%以上)で定義されています。記載の有無は、MedTatorというウェブベースのアノテーションツールを用いて、認定心臓専門家の監督のもと、2名の研修医が手動で注釈付けを行いました。
次に、大規模言語モデル(LLM)支援による所見生成が、LGE属性の記載を改善できるかを評価するため、Llama 3.1 8Bモデルを27,000件の構造化CMR報告書でファインチューニングし、9650件のCMR所見を生成しました。さらに、構造化された所見と非構造化された所見で訓練された量子化低ランク適応(QLoRA)アダプターを用いて、LLMの報告挙動が評価されました。生成された所見のLGE属性(重症度、パターン、分布の記述)は、MedGemma 27bという別のLLMを外部ジャッジとして用いてスコアリングされました。
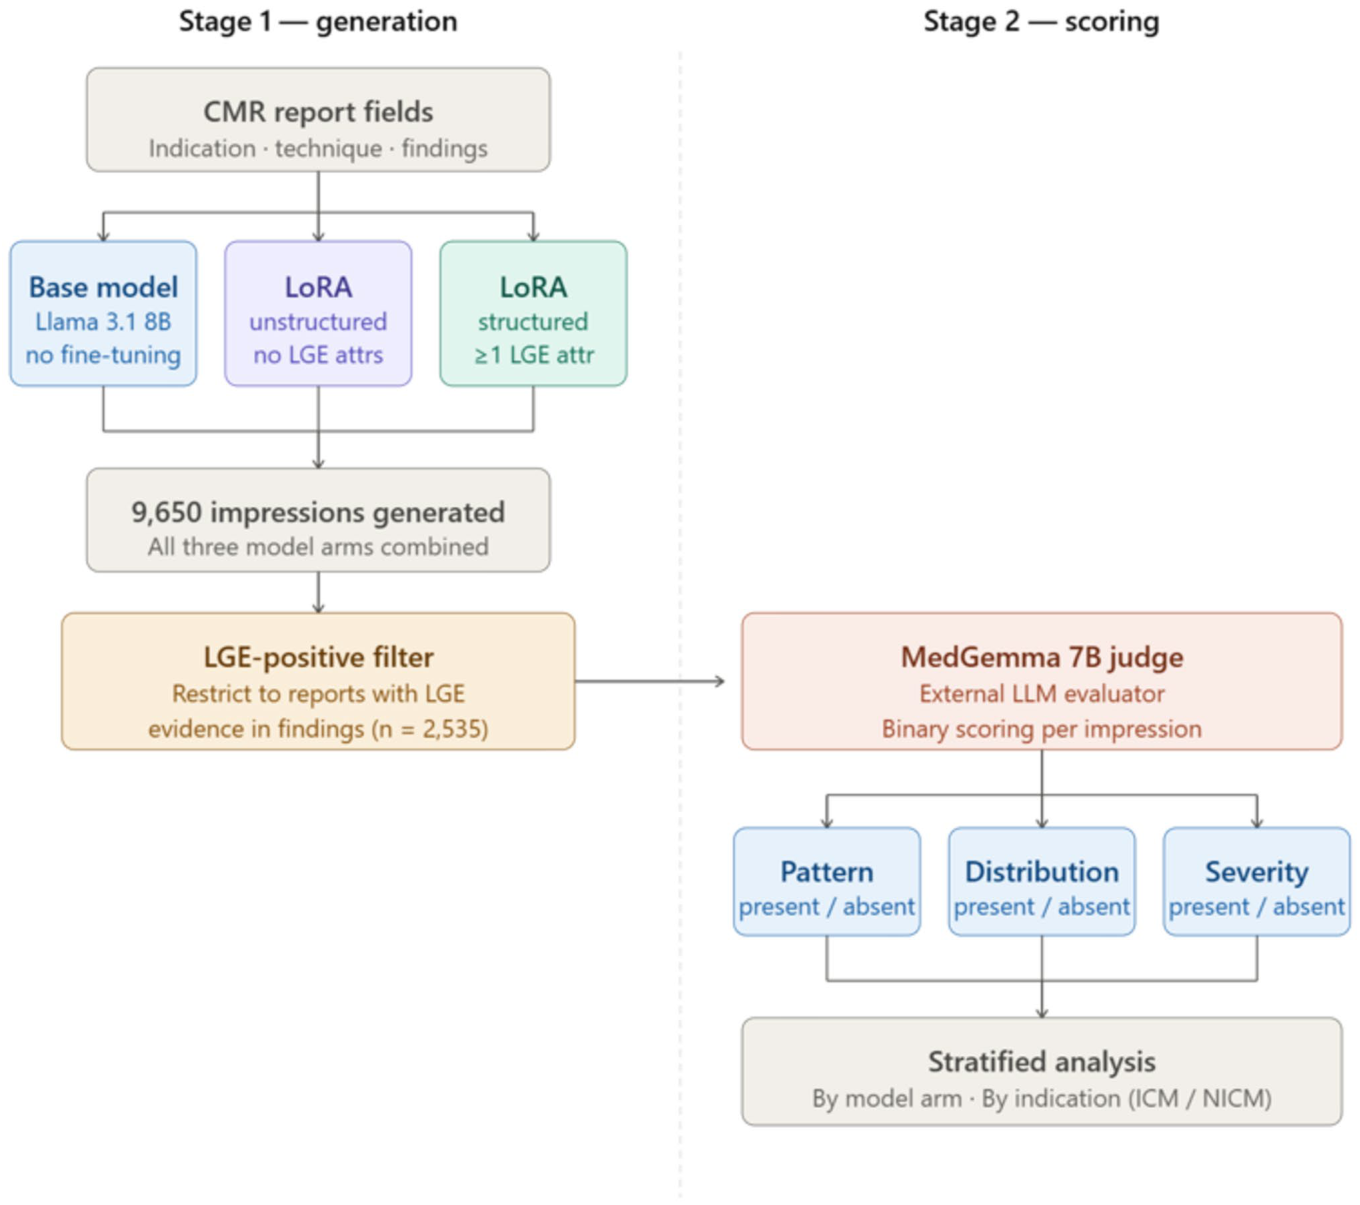
この図は、LLMによるLGE属性評価の2段階分析パイプラインを示しています。
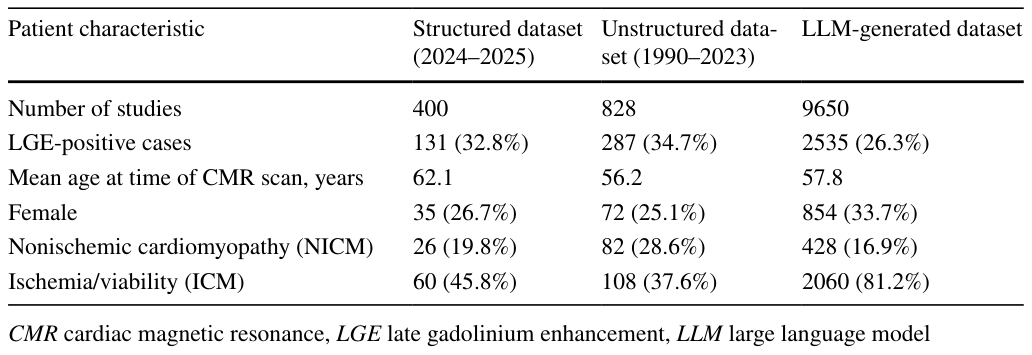
この表は、構造化、非構造化、およびLLM生成データセットにおける対象者の基本特性を示しています。対象者の年齢中央値、性別、および心筋症の種類(NICM、ICM)の割合が記載されており、LLM生成データセットではICMの割合が81.2%と最も高くなっています。
LGE報告における構造化報告書の力
LGE陽性症例において、構造化報告書はLGEパターンを非構造化報告書よりも有意に高い頻度で記載していました(全体で85.5% vs. 61.0%、ICMサブグループで90.0% vs. 69.4%)。しかし、LGEの分布(全体で53.4% vs. 49.5%)や重症度(全体で42.0% vs. 41.1%)の記載においては、構造化報告書と非構造化報告書との間に有意な差は見られませんでした。これは、構造化報告書がLGEパターン記載の改善には有効であるものの、LGE分布と重症度の記載におけるギャップは埋めきれていないことを示しています。また、報告を行う専門家の専門分野別(心臓専門家 vs. 放射線専門家)および個々の専門家間でもLGE報告のばらつきが認められました。構造化データセットでは、心臓専門家が放射線専門家よりもLGE重症度をより頻繁に記載していましたが、その他の属性では有意差はありませんでした。非構造化データセットでは、個々の専門家間でLGEパターンと重症度の報告に有意差があり、構造化データセットではLGE分布と重症度の報告に有意差が見られました。
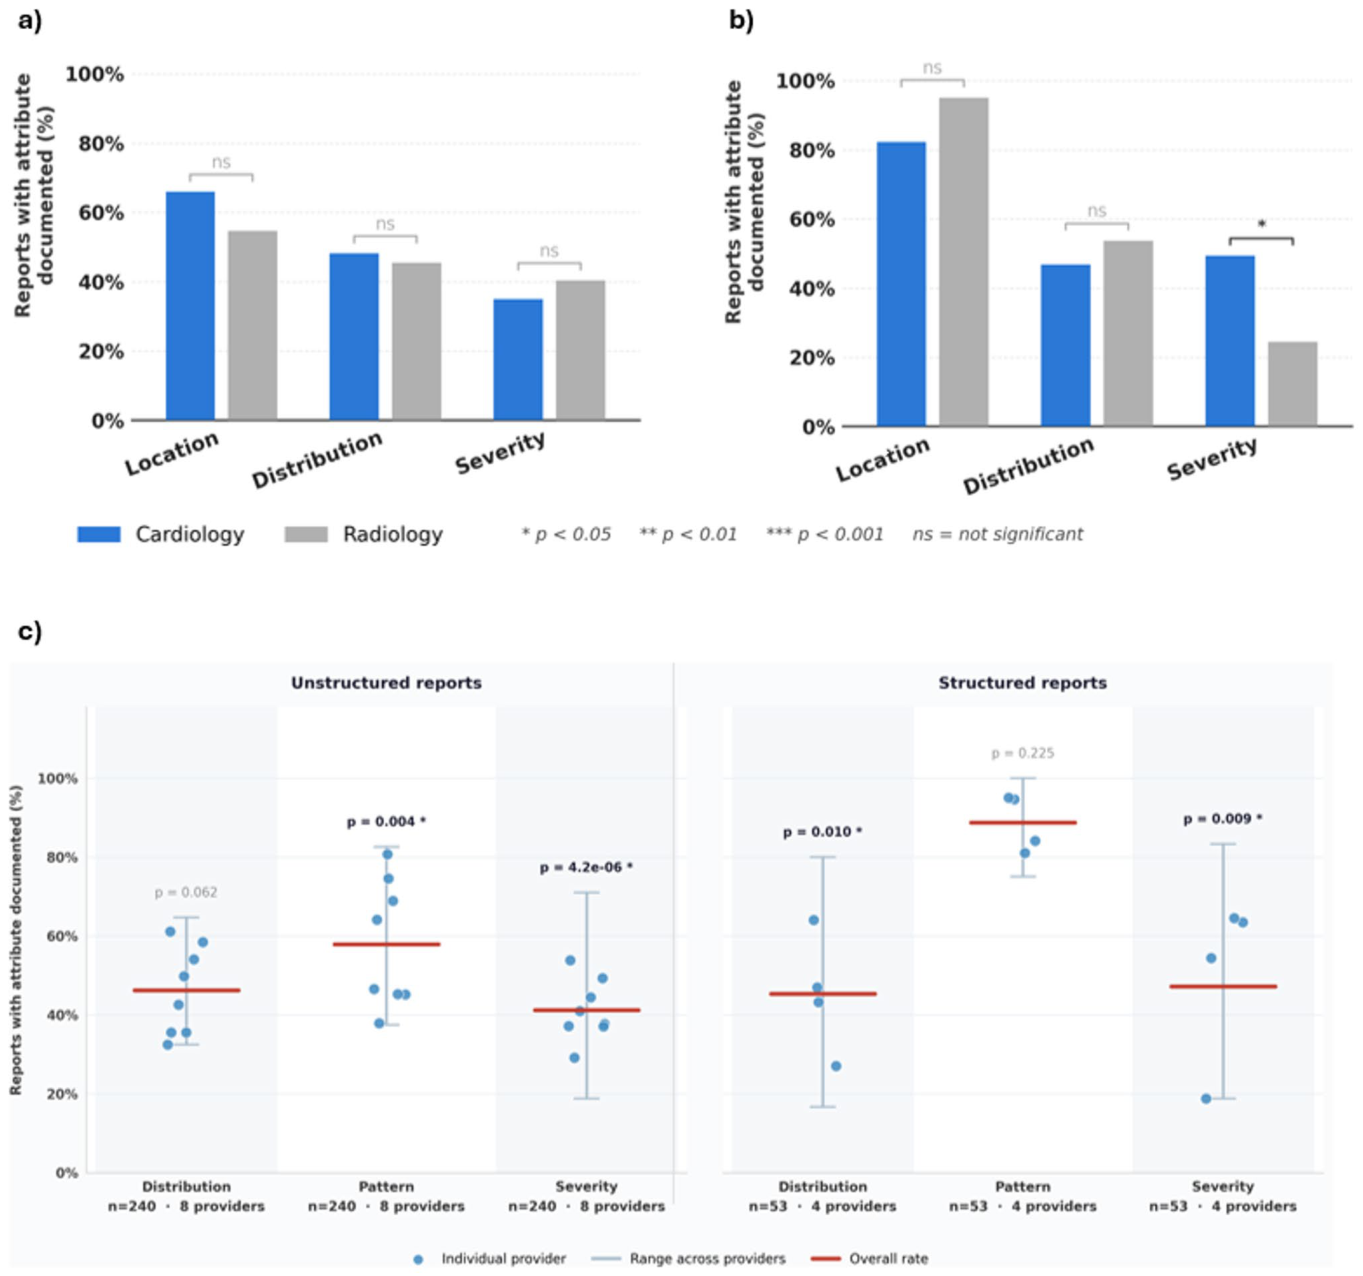
この図は、LGE陽性症例における専門分野間および個々の専門家間でのLGE属性報告のばらつきを示しています。
AIによるLGE報告の進歩
LLMによって生成された所見は、LGEの分布(75.3%)と重症度(70.9%)の報告頻度において、構造化された人間の報告書と非構造化された人間の報告書の両方を統計的に有意に上回りました。LGEパターン報告については、LLM生成所見は構造化された報告書よりは低かったものの(76.5% vs. 85.5%)、非構造化報告書よりは有意に高くなりました(76.5% vs. 61.0%)。これらの改善は特にICMサブグループで顕著でした。
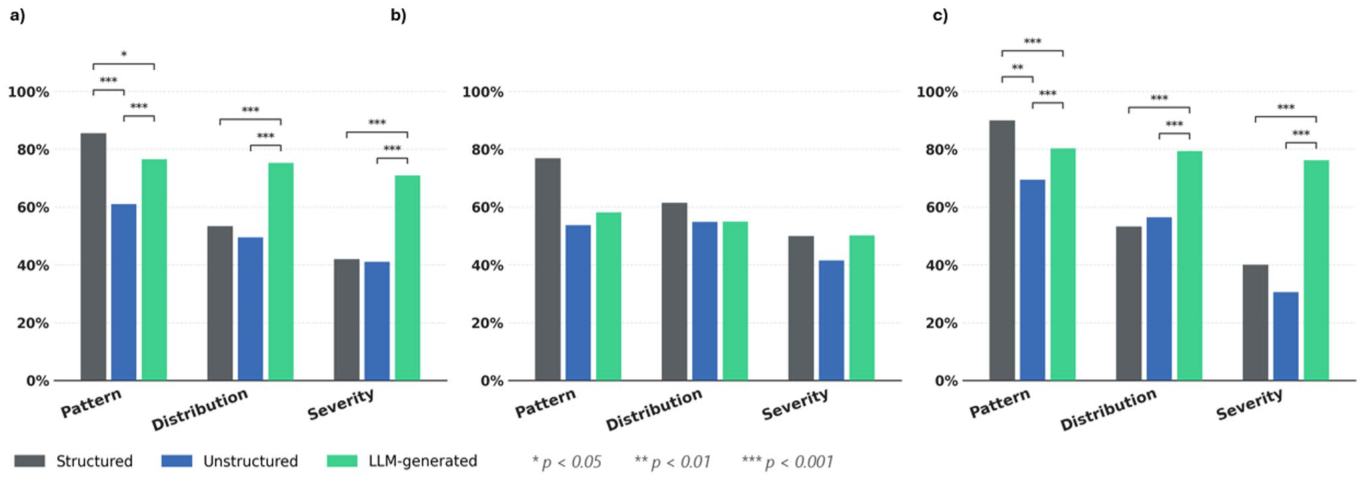
この図は、構造化、非構造化、およびLLM生成CMR所見におけるLGEパターン、分布、重症度の報告率を、全てのLGE陽性症例、NICM症例、およびICM症例について示しています。
さらに、トレーニングデータの質と構造がLLMベースのLGE記載にどのように影響するかを検証しました。その結果、非構造化された所見でファインチューニングされたアダプターが、LGEの重症度、パターン、および分布の全ての報告において、構造化されたアダプターよりも有意に優れた性能を示しました。これは、多様な報告スタイルを反映した異種性のある非構造化データでファインチューニングすることで、モデルがさまざまな記載スタイルからLGE記述子を認識し、抽出する能力が向上することを示唆しています。この非構造化データによるファインチューニングは、特にLGEパターンと分布の報告を改善しましたが、構造化アダプターによるファインチューニングは一貫した改善をもたらさず、いくつかのケースではベースラインモデルと比較して報告の完全性を低下させました。
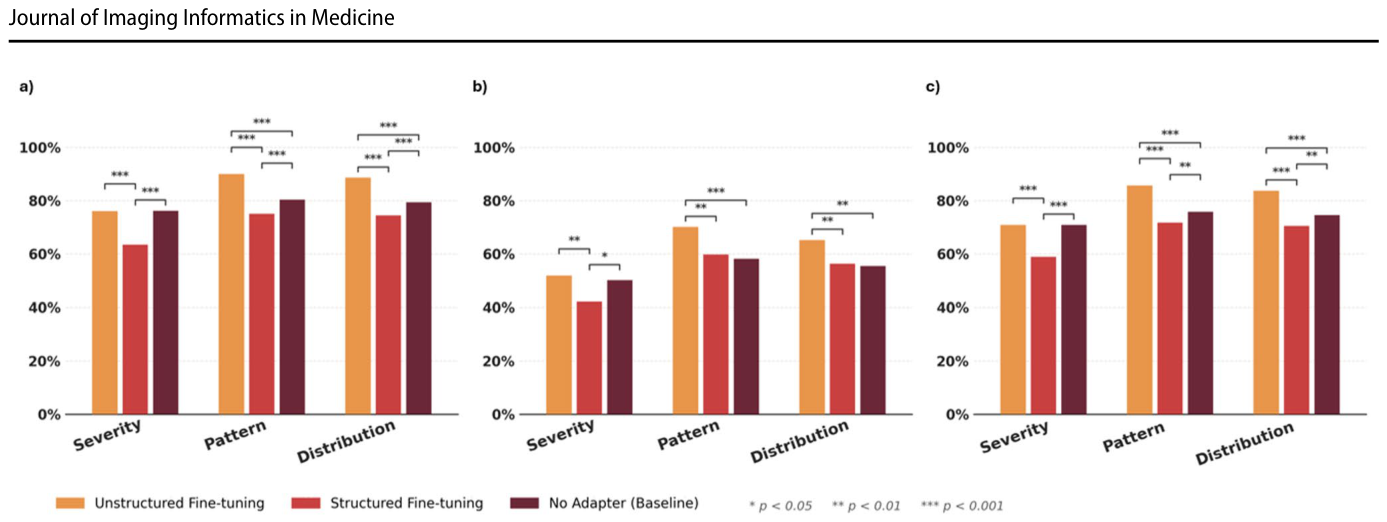
この図は、ファインチューニング戦略別に層別化されたLGEパターン、分布、重症度の報告率を示しています。
考察:AIと構造化報告の相乗効果
この研究から、心臓専門家による診断や予後予測、臨床的意思決定に不可欠なLGE属性の記載に実質的なばらつきがあることが明らかになりました。構造化報告書はLGEパターン記載の改善に有効である一方で、LGE分布や重症度の記載におけるギャップは埋めきれていませんでした。対照的に、LLM支援による所見生成は、特にLGE分布と重症度の記載に関してこれらのギャップを埋める可能性を秘めていることが示されました。特にICMサブグループでは顕著な改善が見られましたが、NICMサブグループではLLM生成所見が人間による報告書を大きく上回ることはなく、AI支援の恩恵が適応症に依存する可能性が示唆されました。
さらに、非構造化CMR所見を用いたファインチューニングは、LGE記述子の報告を改善しました。これは、ファインチューニング時に多様な専門家の異なる報告スタイルに触れることが、モデルの性能向上に寄与することを示しています。単一の標準化された形式に最適化するよりも、実際の臨床における多様な報告スタイルを捉えた異種性のあるトレーニングデータが、LLMベースのツールが実臨床のCMR記載に堅牢に一般化するために重要であることを強調しています。LLMによる所見生成ツールは、専門家の解釈の微妙なニュアンスや文脈的判断を完全に捉えることはできませんが、LGEの重要な所見を伝える上で有望な戦略であり、個々の専門家の行動変容を必要とせず、多様な報告環境でスケールしやすい可能性があります。より完全で一貫性のある構造化された所見は、受診する専門家にとって診断上重要なLGE属性を報告書本文から抽出したり、曖昧な所見を調整したりする手間を減らし、心筋症の臨床意思決定を円滑にする可能性を秘めています。
研究の限界と今後の展望
本研究にはいくつかの限界があります。まず、遡及的な報告書テキストに基づいており、直接的な画像再評価は行われていません。したがって、報告書中の記載の不完全さが、必ずしも所見の不在を意味するものではありません。次に、データセットの期間が長いため、スキャナー技術、臨床診療パターン、LGE予後重要性に関する認識の変化などが、報告のばらつきに寄与した可能性があります。また、単一施設からの知見であるため、報告行動における施設や地域間のばらつきを完全に捉えているとは限らず、一般化可能性が限定される可能性があります。さらに、非構造化報告書と構造化報告書との間の時間的分離があるため、その違いはテンプレートによる標準化とCMR技術開発や報告実践の広範な傾向との複合的な影響を反映していると考えられます。
本研究で使用されたQLoRAアダプターは限られた数の所見で訓練されたため、ファインチューニング効果の大きさが制約され、LGE属性報告におけるアダプター固有の効果に関する知見の一般化可能性も限定される可能性があります。また、人間が生成した所見は手動で注釈付けされたため、アノテーターのエラーや評価者間のばらつきの影響を受ける可能性があり、LLMが生成した所見はMedGemma 27bという自動ジャッジによってスコアリングされたため、コホート間の報告率の直接比較は、この方法論的な非対称性を考慮して解釈する必要があります。今後は、マルチサイトでの前向き研究を通じて、報告形式、読影専門家の訓練、施設文化、AI支援の独立した寄与を解明し、LGE報告行動が臨床的意思決定や対象者の転帰に与える影響を探ることが優先されるべきです。高品質で包括的に注釈付けされたCMRデータセットで訓練されたAIツールの継続的な開発も重要となります。
結論:LGE報告の未来を切り拓くAI
この研究は、構造化および非構造化のCMR報告書において、LGEのパターン、分布、重症度の報告に実質的な不整合があることを明らかにしました。構造化報告書はパターン記載において有意な利点を示したものの、分布と重症度の報告におけるギャップは埋めることができませんでした。一方、LLMによって生成された所見は、LGE分布と重症度の記載を全体的に、特にICMサブグループで改善しました。しかし、NICMデータセットでは依然として意味のあるギャップが残っており、AI支援による生成の恩恵が適応症に依存する可能性を示唆しています。非構造化データでファインチューニングを行うことでLGE属性の報告が改善されたことは、CMRの専門用語へのドメイン適応と、多様な専門家の報告スタイルを反映した異種性トレーニングデータが性能向上を牽引することを示唆しています。これらの結果は、構造化報告書がLGE属性報告の部分的な解決策に過ぎず、LLM支援による所見生成が有望な補完的戦略であることを示しています。CMRの臨床的価値をさらに高めるためには、標準化されたテンプレート、LGEパターン、分布、重症度の特性評価を明示的に促す適応症特異的な報告ガイダンス、そして高品質で包括的に注釈付けされたCMRデータセットで訓練されたAIツールの継続的な開発が必要となるでしょう。LGE記載の改善が、より良い臨床意思決定や対象者の転帰につながるかどうかを判断するためのさらなる研究も求められます。
用語集
- LGE (Late Gadolinium Enhancement): 心臓MRIで心筋の線維化や瘢痕化を検出するための造影技術。
- CMR (Cardiac Magnetic Resonance): 心臓の状態を詳細に評価する磁気共鳴画像法。
- ICM (Ischemic Cardiomyopathy): 虚血性心筋症。心筋への血流不足が原因で心機能が低下する疾患。
- NICM (Nonischemic Cardiomyopathy): 非虚血性心筋症。虚血以外の原因で心機能が低下する疾患。
- 印象 (Impression): 放射線診断報告書の最後に記載される、最も重要な所見や結論。
- 構造化報告書 (Structured Report): 定型化されたフォーマットで情報を記載する報告書。
- LLM (Large Language Model): 大規模言語モデル。人間のようなテキストを生成・理解するAI。
- MedTator: 臨床テキストのアノテーション(注釈付け)を効率的に行うためのウェブベースプラットフォーム。
- QLoRA (Quantized Low-Rank Adaptation): 大規模モデルのファインチューニングを効率化する技術。
- MedGemma 27b: LLMが生成したレポートの品質を評価するために使用された外部のLLMジャッジ。
コメントを残す