
心臓MRIビュー分類の精度を革新:ハイブリッドAI「ConvFormer3D」の挑戦
解説対象論文: ConvFormer3D: A Hybrid 3D-CNN-Transformer Front-End for Cine cMRI View Classification Pipelines
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年11月14日時点)
心臓の形態と機能を詳細に評価する上で不可欠なシネMRI。その解析精度を左右する「ビュー(撮影断面)」の正確な識別は、診断の信頼性を高める上で極めて重要です。スキャナーの多様性や対象者の動きによる課題が残る中、本ブログでは、3D CNNとトランスフォーマーを融合したハイブリッドAI「ConvFormer3D」が、どのように高精度なビュー分類を実現し、心臓画像解析に新たな可能性をもたらすかをご紹介します。
はじめに:心臓MRIビュー分類の重要性
どうも、Beyond the Pixelです。心臓の形態や機能を評価する上で、シネMRI(Cine cMRI)は非侵襲的なゴールデンスタンダードとして広く利用されています。この検査は、心室容積や駆出率、心筋量、組織特性などの定量的な解析を可能にします。しかし、これらの解析を行う上で極めて重要なのが、標準的なシネMRIの「ビュー」(撮影断面)を正確に識別することです。なぜなら、各ビューが心臓のどの解剖学的構造を観察し、定量解析するかを決定するからです。このビューがもし誤って識別された場合、それはその後の容積評価、ストレイン解析、弁評価、ひいては診断全体に誤差が伝播してしまう可能性があります。
既存手法の課題とConvFormer3Dの登場
これまで、シネMRIビューの自動分類には様々な機械学習手法が試みられてきました。初期の機械学習は、手動で抽出された特徴に依存しており、異なるプロトコルや病変への応用が困難でした。その後、ディープラーニング(深層学習)の一種である畳み込みニューラルネットワーク(CNN)が導入され、分類精度が向上しました。しかし、2D CNNでは時間的な一貫性が考慮されず、ビュー間の解剖学的差異がわずかな場合に誤りを生じやすいという課題がありました。一方、完全に3D CNNのモデルは短期的な動きしか捉えられず、中規模の医療データセットでは過学習しやすい傾向があります。さらに、自然な動画データとシネMRIの間にはドメインの違いがあり、転移学習の適用が難しいという側面もありました。このような背景から、スキャナーメーカー間の臨床的変動、取得プロトコルの違い、動きによるアーティファクトといった課題を克服し、正確なビュー分類を実現することは依然として困難でした。本研究で紹介する「ConvFormer3D」は、これらの課題に対応するために開発されたハイブリッドな時空間アーキテクチャです。
ConvFormer3Dのアーキテクチャ
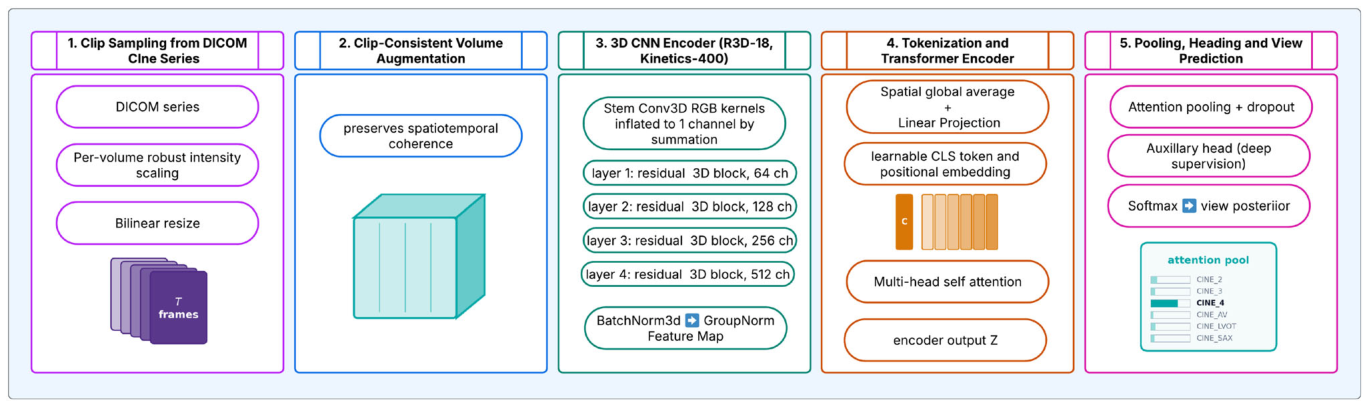
ConvFormer3Dは、強力な局所的時空間事前情報を提供する事前学習済み3D畳み込みエンコーダーと、心拍サイクル全体にわたる長距離依存関係を捉える軽量なテンポラルトランスフォーマーを組み合わせています。モデルは主に4つの部分から構成されています。第一に、Kinetics-400データセットで事前学習された3D残差ネットワーク(R3D-18)エンコーダーを、シングルチャンネルのシネ入力向けに修正しています。具体的には、元のRGB3チャンネル入力を単一チャンネル入力に対応させるため、カーネル重みを統合しています。また、クリップレベルのバッチサイズが小さい場合にバッチ統計がノイズになるのを避けるため、BatchNorm層をGroupNormに置き換えています。これにより、時間的な解像度を維持しつつ空間的なダウンサンプリングのみを行うように設計されています。第二に、このエンコーダーから得られた特徴マップを、空間的グローバル平均プーリングを用いてフレームレベルのトークンシーケンスに変換し、時間的な高解像度を維持します。第三に、学習された位置埋め込みを持つ2層のプレノームトランスフォーマーエンコーダーが、このフレームレベル表現を心拍サイクル全体で文脈化します。ここでは、クラストークンや一様な時間平均に頼るのではなく、学習されたアテンションプーリングクエリがシーケンスを集約し、ビュー識別にとって最も情報量の多い心拍フェーズに重点を置くことができます。例えば、大動脈弁ビュー(CINE_AV)における弁の開口部などです。最後に、分類ヘッドと、訓練時にのみ使用される補助ブランチを備えています。補助ブランチは畳み込み特徴にディープ補助監督を提供し、事前学習済みバックボーンからの特徴が線形分離可能であることを保証し、初期の最適化を安定させるのに役立ちます。このモデル全体で4050万個のパラメータを持ち、8フレームの112×112クリップあたり81.4 GFLOPsの計算コストで、リアルタイムでの利用が可能な効率性を実現しています。
強固なトレーニングと評価プロトコル
この研究では、Northwestern Medicineで収集されたシネcMRIデータを用いています。データセットには、臨床的に標準とされる6つのシネビュー(CINE_2、CINE_3、CINE_4、CINE_AV、CINE_LVOT、CINE_SAX)が含まれており、7702人の異なる対象者からなる10,193シリーズで構成されています。
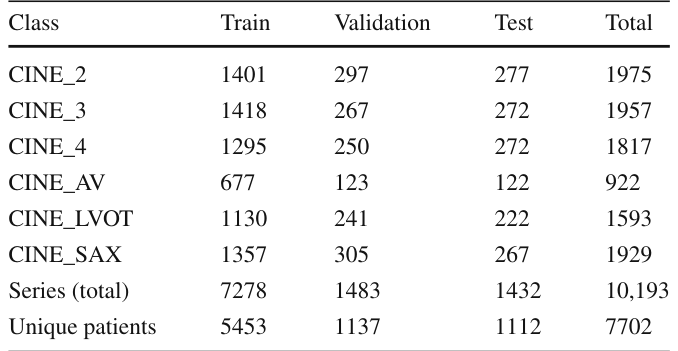
データリーク(情報漏洩)を防ぐため、データ分割は個々の対象者レベルで行われました。これにより、同じ対象者の画像が訓練、検証、テストの複数のパーティションに重複して含まれることを防ぎ、モデルの性能が対象者の特性ではなくビューの識別能力に起因することを保証します。検証データセットはモデル選択とキャリブレーションに、テストデータセットは最終評価のみに使用されました。訓練クリップは各シリーズ内のランダムな時点から選択され、各エポックで異なる心拍サイクルの一部をモデルが学習する「時間的ジッター」が適用されます。さらに、空間的回転、水平反転、空間的ジッター、ガウスノイズ、ランダムな時空間消去などの拡張手法(オーグメンテーション)が用いられ、リアルワールドの画像取得で発生しうる変動に対するモデルの堅牢性が高められています。学習には、ディープ補助監督、ラベルスムージング、パラメータの指数移動平均(EMA)、混合精度最適化といった技術が組み合わされています。また、モデルの予測確率は、温度スケーリング(Temperature scaling)によってキャリブレーション(較正)され、予測された信頼度が実際の誤り率と一致するように調整されています。この綿密な評価プロトコルにより、報告されるすべてのメトリクスは、対象者クラスターブートストラップ(95%信頼区間)で記録され、異なるモデル間の正式なペア統計的有意性検定も実施されています。
ConvFormer3Dの優れた性能
ConvFormer3Dモデルは、独立した対象者レベルのテストパーティションにおいて、0.983(95%信頼区間:0.977-0.989)という高い精度を達成しました。平衡精度(Balanced accuracy)も0.981(95%信頼区間:0.974-0.988)であり、マクロF1スコア(0.983)とコーエンのカッパ係数(0.980)も同様に高い値を示しています。これは、モデルが特定の多数派クラスに偏らず、すべてのクラスに対して堅牢な性能を発揮していることを示しています。
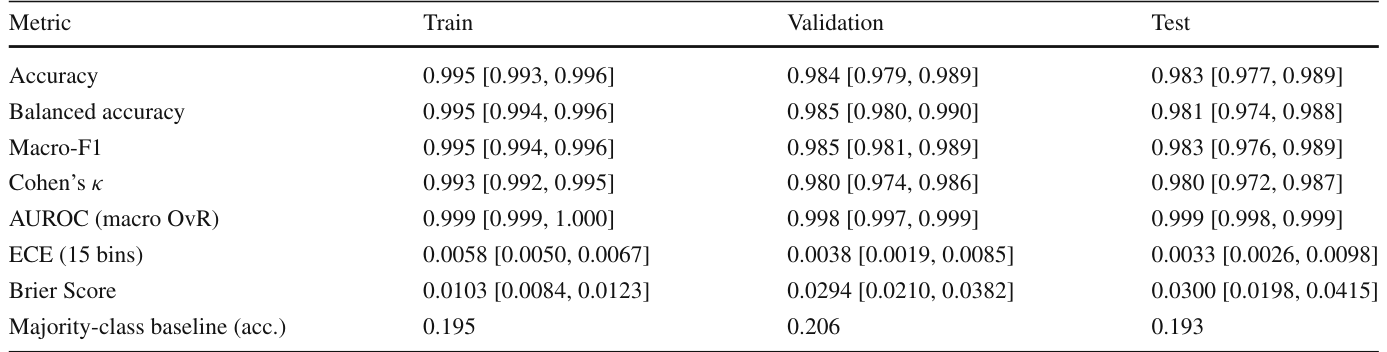
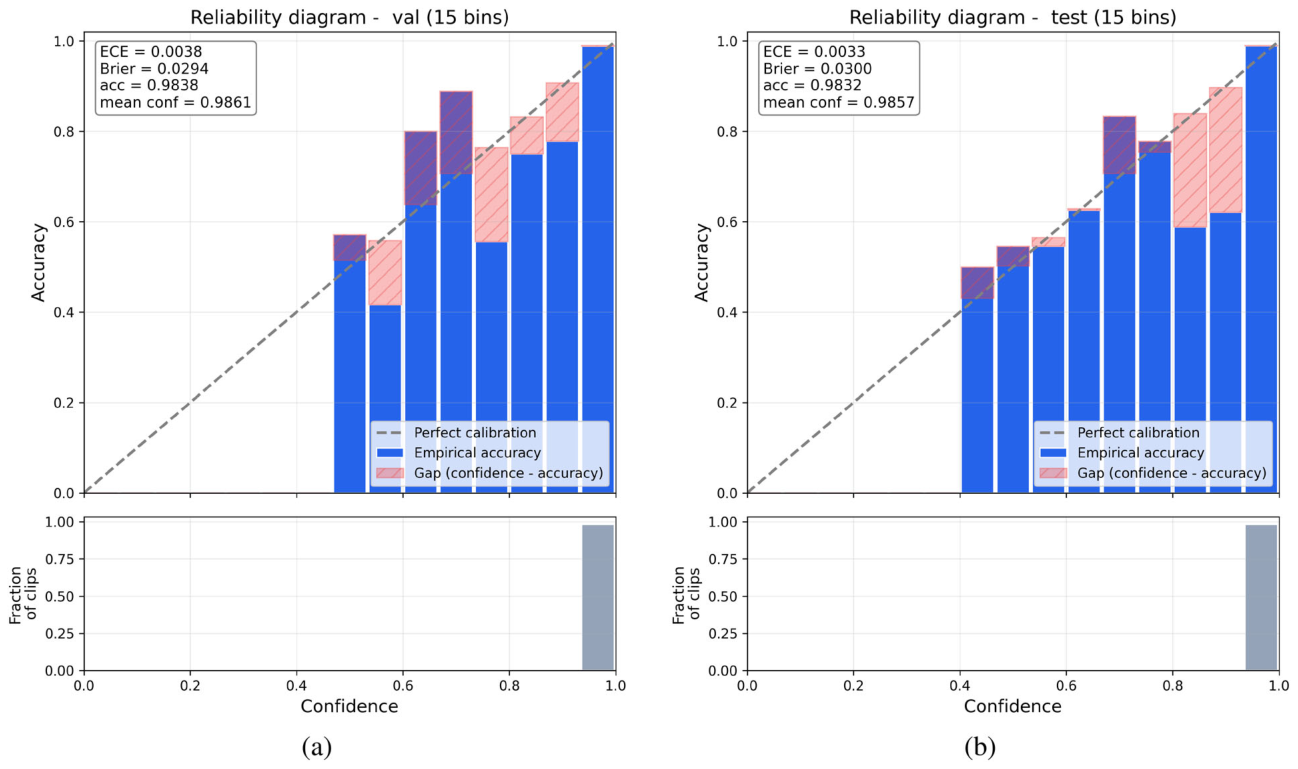
特に、温度スケーリング後の予想キャリブレーションエラー(ECE)は0.0033という低い値であり、予測された信頼度が実際の正答率と密接に一致していることがわかります。これにより、信頼度の低いシーケンスを人手によるレビューに回すなど、下流のパイプラインで予測確率を自信に基づいてルーティング(経路制御)できる可能性を示唆しています。クラスごとのテスト性能を見ると、すべてのクラスで高い精度、再現率、F1スコアが報告されています。
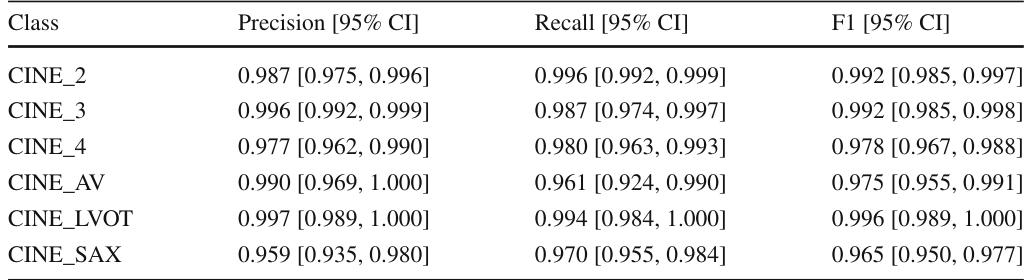
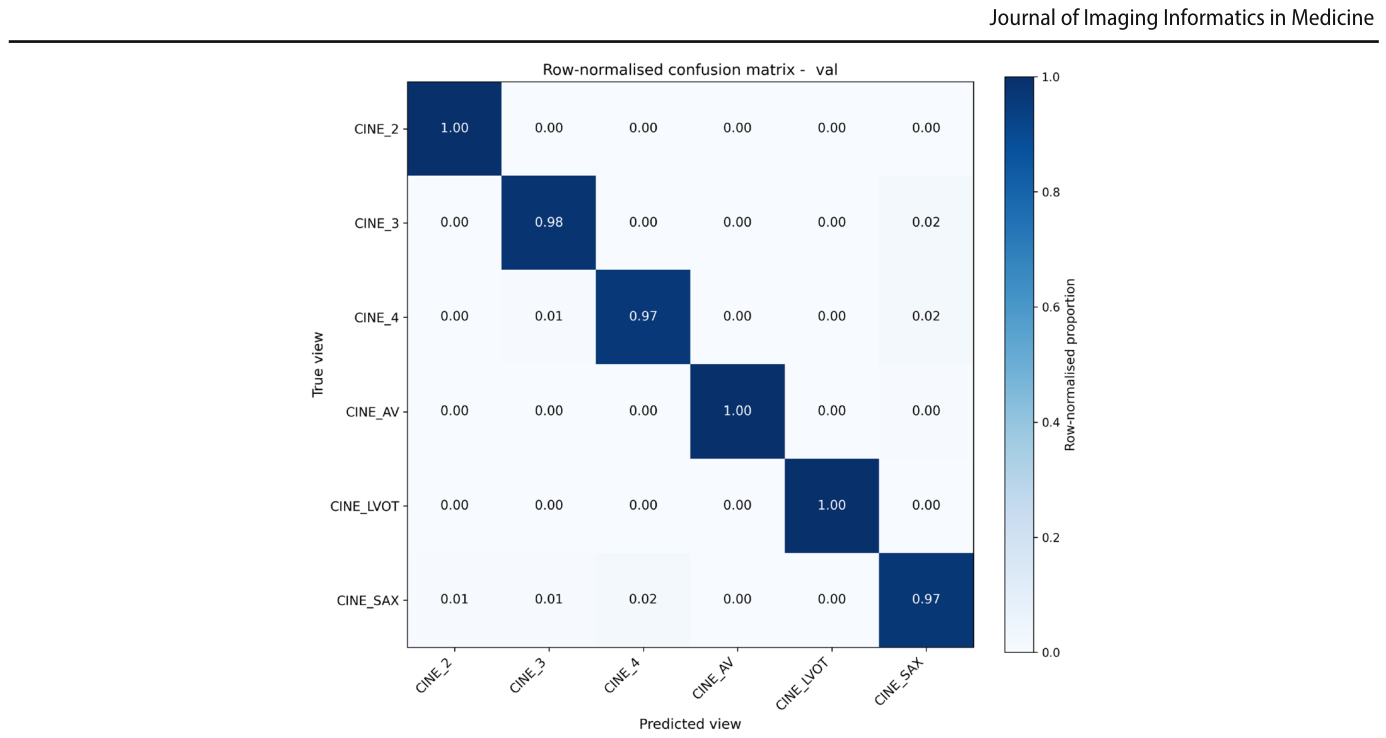
特に、CINE_AVとCINE_LVOTのような解剖学的に隣接し、経験豊富な専門家でも区別が難しいとされるビュー間でも、高い識別能力が示されています。例えば、CINE_AVからCINE_LVOTへの誤分類は全く発生せず、これは先行研究と比較しても顕著な改善点です。検証用データセットにおける混合行列では、予測の分布が示されています。
信頼性ダイアグラムは、温度スケーリングにより検証およびテストパーティションの両方でキャリブレーションが大幅に改善されたことを示しています。これにより、モデルが不確実性を正確に表現できることが裏付けられました。
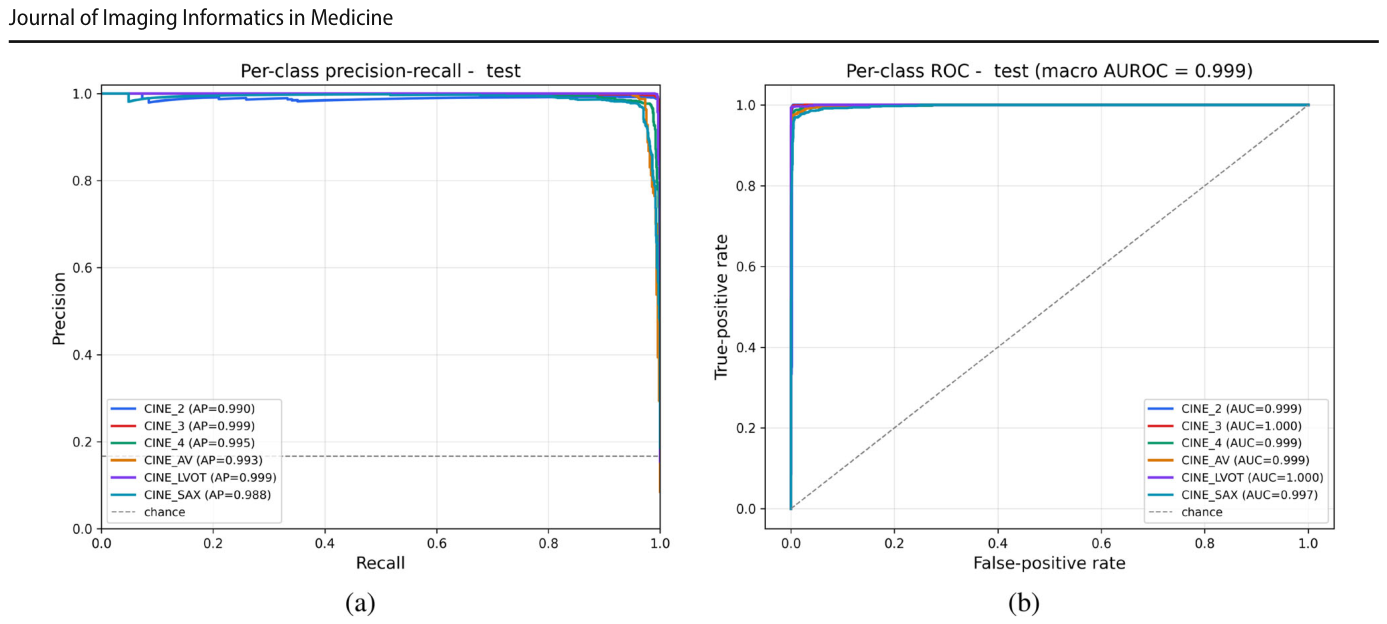
クラスごとの精度-再現率曲線とROC曲線も、希少なクラス(CINE_AV, CINE_LVOT)においても高い性能を示しており、多くの偽陽性を生じることなく高い再現率を達成できることを示唆しています。
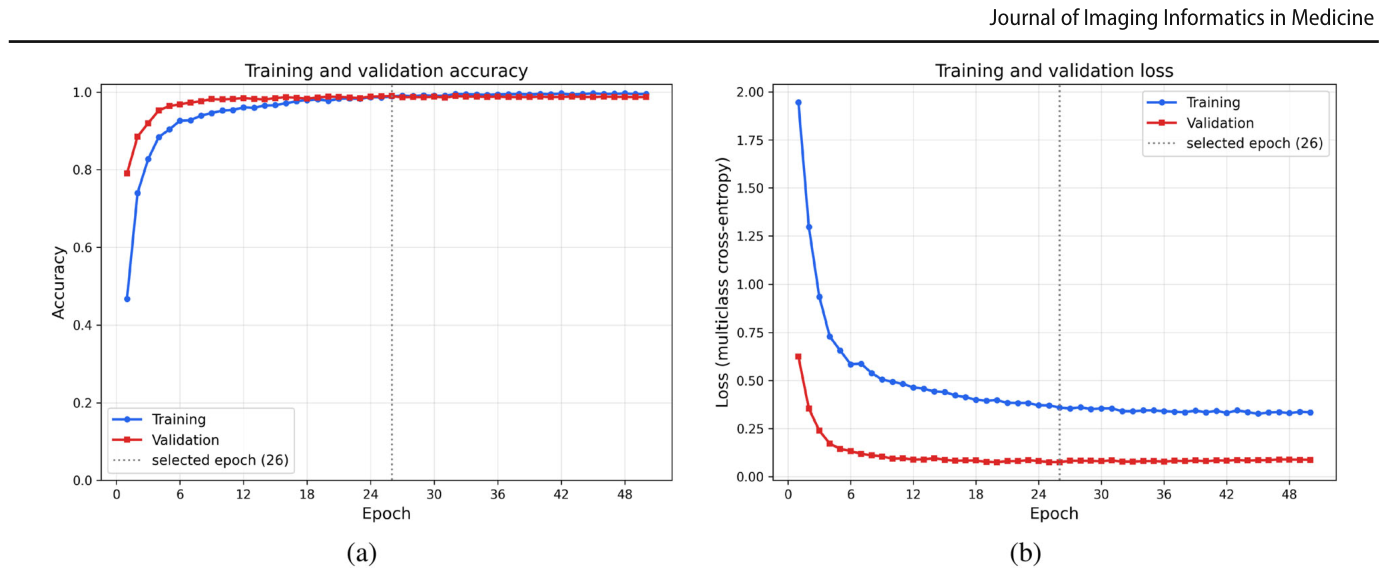
学習曲線を見ると、訓練と検証の両方で早期に急速な改善が見られ、その後安定した収束を示しています。訓練精度と検証精度の間のギャップは0.0107(95%CI 0.0058, 0.0156)であり、モデルが過学習に苦しんでいないことが示されています。
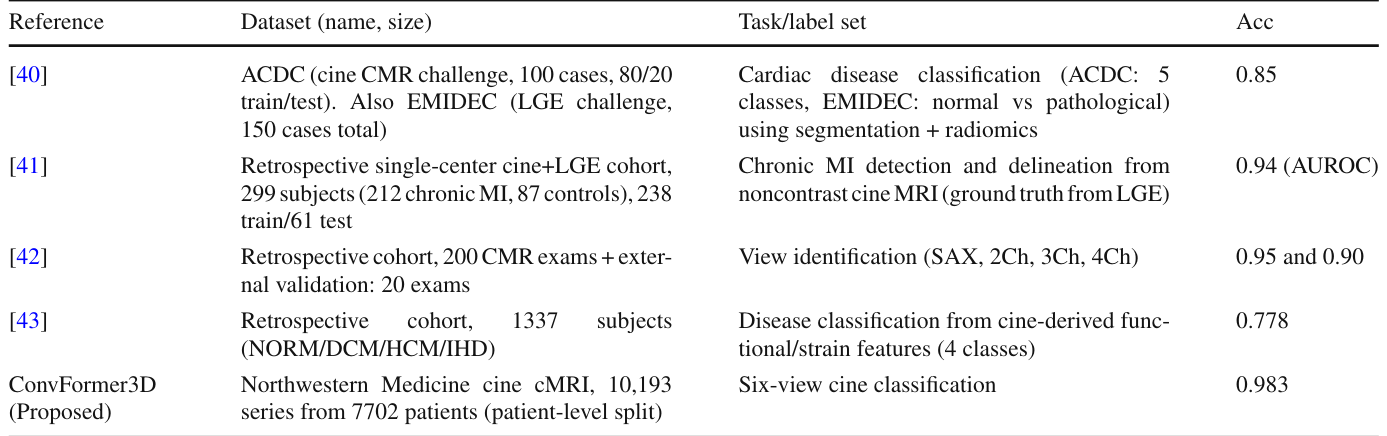
他の心臓MRI分類手法との比較では、ConvFormer3Dは0.983という高い精度を達成しており、これは先行研究で報告されている数値(0.85, 0.90, 0.95など)と比較しても非常に優れています。
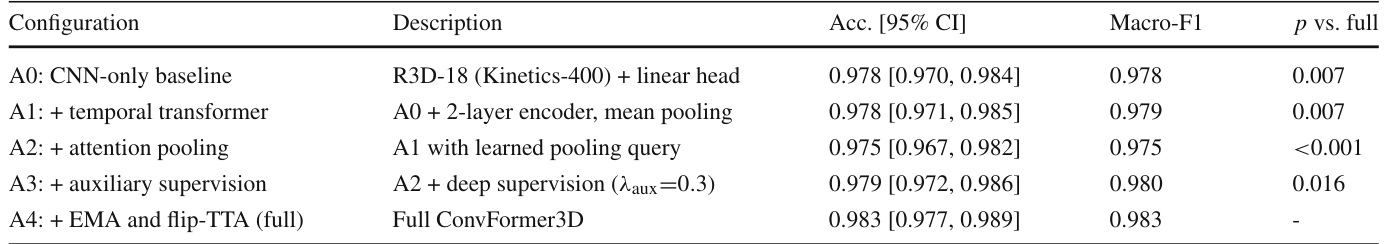
また、アブレーションスタディ(特定のコンポーネントを取り除いた実験)により、各設計要素の寄与が定量化されました。ベースラインのCNNモデルの精度は0.978でしたが、補助深層監督の追加が+0.004、EMAと水平反転テスト時オーグメンテーションの組み合わせが+0.004の改善をもたらし、最終的にフルモデルの0.983へと到達しました。これは、各コンポーネントが単独ではなく、組み合わさることでエラー率を大幅に削減していることを示しています。
研究の限界と今後の展望
本研究にはいくつかの限界があります。第一に、データは単一施設から得られたものです。多様なスキャナーやプロトコル、長年にわたる臨床実践から収集されたものですが、独立した外部コホートでの検証は行われていません。多施設での外部検証は、モデルの実運用における主張にとって不可欠であり、今後の重要なステップとされています。第二に、ベースライン比較は内部で行われたものと既存の文献に基づくものです。同等の計算コストがかかるため、MViTv2やVideo Swinのような最新のビデオブトランスフォーマーとの直接的な比較は、今後の課題として挙げられています。第三に、モデルは固定長の8フレームクリップで動作します。推論時にはスライディングウィンドウ集計法が全サイクルをカバーするために使用されますが、重度の不整脈や非標準的な取得を行う対象者の場合、訓練データで十分に表現されていない時間パターンを示す可能性があります。第四に、ビューラベルは臨床取得記録に基づいており、独立した専門家による再アノテーションではないため、残存するラベルノイズの可能性は否定できません。最後に、示されたレイテンシ(処理遅延時間)は単一のハードウェア設定に関するものであり、完全な臨床ワークフロー(DICOMルーティング、キューイング、バッチ処理などを含む)に統合された場合の実際の影響はまだ特性評価されていません。今後の研究では、外部の多施設・マルチベンダーデータによる検証、同じ対象者レベルプロトコルを用いた大規模ビデオブトランスフォーマーとの直接比較、そしてラベルなしシネデータセットでの自己教師あり事前学習によるドメイン汎化能力のさらなる向上を目指しています。ConvFormer3Dを完全なcMRI解析ワークフローに組み込むことで、セグメンテーション精度、容積およびストレインバイオマーカー、ワークフロー効率への影響を前向きに評価することが可能になるでしょう。
まとめ
この研究では、シネcMRI解析と分類の自動化に対処するため、ConvFormer3Dというハイブリッドな時空間フレームワークを導入しました。このモデルは、Kinetics-400で事前学習された3D残差エンコーダーをシネ入力向けに適合させ、軽量なテンポラルトランスフォーマーとアテンションプーリングを組み合わせています。補助的な深層監督を用いて訓練され、温度スケーリングによってキャリブレーションされています。7702人の異なる対象者からなる10,193シリーズ、および6つの標準ビューから構成されるデータセットで厳密な対象者レベルの分割を用いてテストされた結果、提案された手法は0.983という高いテスト精度(95%信頼区間:0.977-0.989)を達成し、各クラスで堅牢な性能と良好なキャリブレーション(ECE = 0.0033)を示しました。ConvFormer3Dは、統計的に制御された段階的アブレーションスタディにおいて、その3D-CNN畳み込みベースラインを上回り、心臓MRI分類のベンチマークと比較しても優れた性能を発揮します。コンパクトな設計(4050万パラメータ、クリップあたり81.4 GFLOPs)により、自動化されたcMRI解析パイプラインにおいてビュールーティングのフロントエンドとして直接使用できる可能性を秘めています。この技術は、心臓の診断において、より迅速かつ正確な情報を提供し、専門家の負担軽減と医療ワークフローの効率化に大きく貢献することが期待されます。
用語集
- Cine cMRI (シネMRI): 心臓の動きを時系列で撮影し、心機能の評価に用いられる心臓磁気共鳴画像法。
- ビュー分類: 心臓MRI画像の撮影断面(ビュー)を、AIが自動的に識別するタスク。
- 3D CNN: 3次元データ(空間と時間)を直接処理し、特徴を学習する深層学習モデル。
- Transformer (トランスフォーマー): 自己アテンションメカニズムを基盤とし、長距離の依存関係を捉えるのに優れたAIモデル。元は自然言語処理で開発された。
- Kinetics-400: 大規模な動画行動認識データセットの一つ。多くの異なる人間の行動がカテゴリ分けされている。
- 転移学習: あるタスクで学習済みのモデルの知識を、別の関連タスクに応用して学習効率を高める手法。
- アテンションメカニズム: AIモデルが入力データのどの部分に注目すべきかを動的に学習し、その重要度を重み付けする仕組み。
- 温度スケーリング: AIモデルの予測確率分布を調整し、実際の信頼度と一致するように較正する手法。
- データリーク: 機械学習モデルの訓練データと評価データ間で情報が意図せず漏洩し、モデル性能が過大に評価される現象。
- ECE (Expected Calibration Error): AIモデルの予測信頼度と、その予測が実際に正しい確率との乖離度合いを示す指標。
- ゴールデンスタンダード: 診断や評価において、最も信頼性が高く、比較基準として確立されている方法や基準。
- オーグメンテーション: 既存の訓練データを変形・加工することで、データの多様性を人工的に増やし、モデルの汎化能力を高める手法。
- EMA (Exponential Moving Average): 過去のデータポイントに指数的に減衰する重みを与えて移動平均を計算し、学習を安定させる手法。
- F1スコア: 分類タスクの性能指標の一つで、精度(Precision)と再現率(Recall)の調和平均。
- アブレーションスタディ: AIモデルの特定のコンポーネントを意図的に除去し、そのコンポーネントが全体の性能にどの程度貢献しているかを評価する実験。
コメントを残す