
強化学習で生存時間解析のデータ前処理を自動化:CleanSurvivalの革新
解説対象論文: CleanSurvival: automated data preprocessing for time-to-event models using reinforcement learning
BMC Medical Informatics and Decision Making|被引用数: 0(2026年9月26日時点)
機械学習モデルの構築において、データの「前処理」はモデルの性能を左右する重要なステップです。特に、医療画像データなどで発生する「イベント発生までの時間」(time-to-event)を予測する生存時間解析では、データに「打ち切り」があるため、その前処理はさらに複雑になります。これまで、この特殊なデータ前処理を自動化するソリューションは限られていましたが、今回ご紹介する「CleanSurvival」は、強化学習を用いて生存時間解析に特化した前処理パイプラインを最適化し、モデルの堅牢性と予測性能を大幅に向上させる革新的なフレームワークです。データサイエンティストや研究者の負担を軽減し、より迅速で信頼性の高い分析を可能にするCleanSurvivalについて、詳しく見ていきましょう。
はじめに:機械学習の隠れた課題「データ前処理」
どうも、Beyond the Pixelです。今日のブログでは、機械学習モデルの性能に大きく影響するにもかかわらず、しばしば見過ごされがちな「データ前処理」に焦点を当てます。特に、医療分野などで重要な「生存時間解析」におけるデータ前処理の自動化について、画期的な解決策を提案する「CleanSurvival」というフレームワークをご紹介します。生存時間解析は、イベント(病気の再発、機器の故障、対象者の死亡など)が発生するまでの時間を予測する統計手法で、途中でイベントが観察されない「打ち切りデータ」(Censored data)を扱うため、データ前処理に特有の課題があります。CleanSurvivalは、この課題に対し強化学習(Reinforcement Learning, RL)を用いることで、前処理パイプラインを自動で最適化し、より信頼性の高い生存時間モデル構築を可能にします。これまで分類や回帰タスク向けの自動化された前処理ツールは存在しましたが、生存時間解析に特化した自動化ソリューションは不足していました。本稿では、CleanSurvivalがどのようにそのギャップを埋め、データサイエンティストの作業をより迅速かつ容易にし、より堅牢な結果をもたらすのかを詳しく見ていきましょう。
CleanSurvivalとは?生存時間解析のためのQ学習ベースの自動化
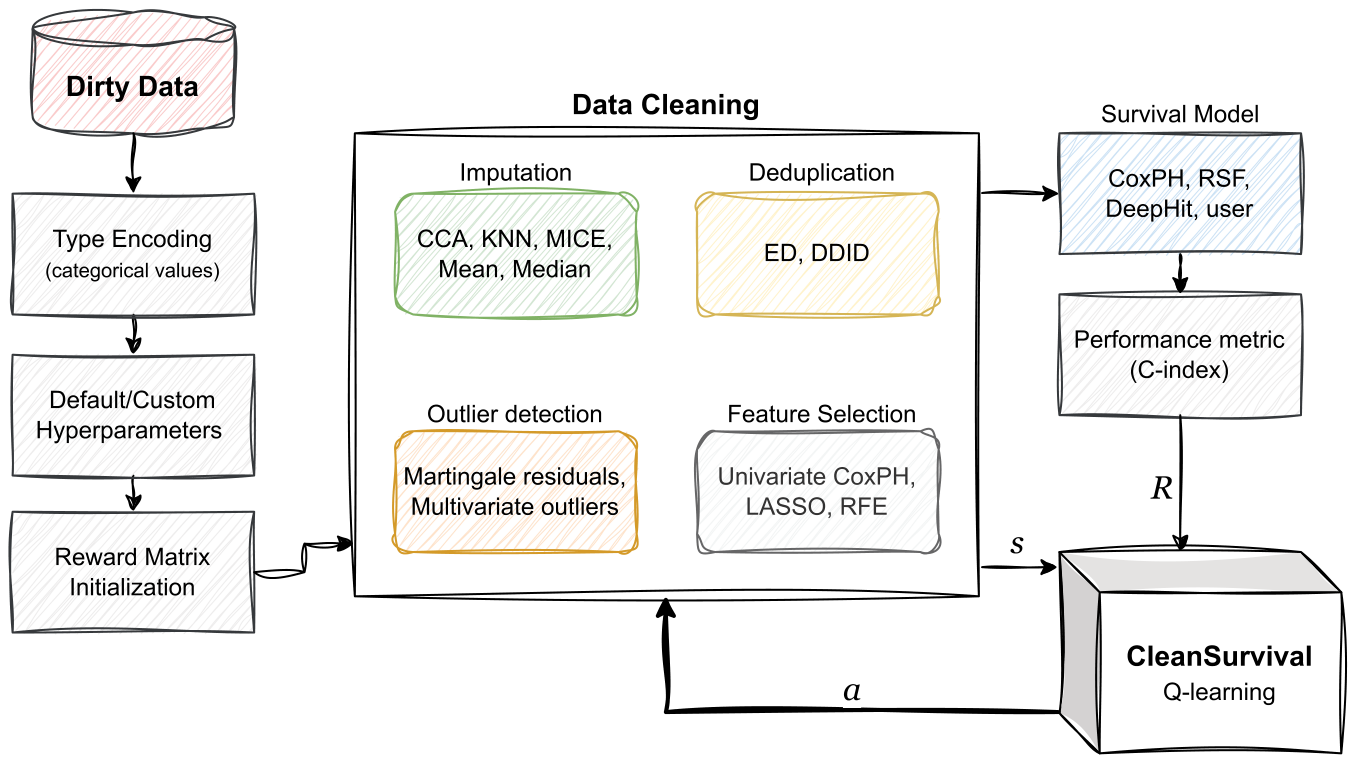
CleanSurvivalは、強化学習の一種であるQ学習(Q-learning)に基づいて、データ前処理パイプラインを最適化するソリューションです。これは、既存のデータクリーニングツール「Learn2Clean」を生存時間解析に特化して拡張したもので、連続変数とカテゴリカル変数の両方を処理できます。具体的には、データ中の「欠損値補完」(Data imputation)、異常な値を特定して処理する「外れ値検出」(Outlier detection)、そして予測に最も関連性の高い変数を選択・変換する「特徴量抽出」(Feature extraction)といった様々なデータ前処理手法の組み合わせの中から、最も性能の高いパイプラインを自動で選択します。対象とする生存時間モデルは、Cox比例ハザードモデル(Cox proportional hazards model)、ランダム生存フォレスト(Random survival forest)、ニューラルネットワーク(DeepHit neural network)など、多岐にわたります。このフレームワークは、オープンソースのPythonパッケージとしてGitHubで公開されています。
生存時間解析におけるデータ前処理の重要性
ビッグデータと機械学習の時代において、複雑なデータセットから意味のある洞察を引き出す能力は極めて重要です。この過程で不可欠なステップがデータ前処理であり、生データを分析に適した形式にクリーニング、変換、準備します。データ前処理の質は、機械学習モデルの性能と信頼性に大きく影響する可能性があります。特に、対象者の死亡や機器の故障など、イベントが発生するまでの時間を予測する生存時間解析の分野では、イベントがまだ観察されていない「打ち切りデータ」が存在するため、特有の課題が生じます。従来の機械学習では、生存時間解析を単純な回帰や分類問題として扱うことがありますが、これは重要な情報損失につながります。例えば、打ち切りデータを無視するとサンプルサイズが大幅に減少し、偏りが生じる可能性があります。
既存のAutoMLフレームワークとの比較
自動機械学習(AutoML)は、アルゴリズム選択、ハイパーパラメータチューニング、モデル評価などのステップを自動化し、機械学習開発プロセスを効率化することを目指しています。しかし、データ前処理は通常、AutoMLパイプラインの範囲外にある重要な分析ステップとして残されています。既存のAutoMLツールは、分類や回帰モデル向けには前処理を統合し始めていますが、生存時間解析のような特殊なタスクでは、その統合が不足しています。多くの汎用AutoMLフレームワーク(Auto-WEKA、TPOT、auto-sklearnなど)は、生存時間モデルや生存時間特有の評価指標をサポートしていません。また、欠損値補完などの基本的なデータ処理はサポートするものの、生存時間解析に特化した柔軟な前処理カスタマイズ機能が欠けているものも多く見られます。
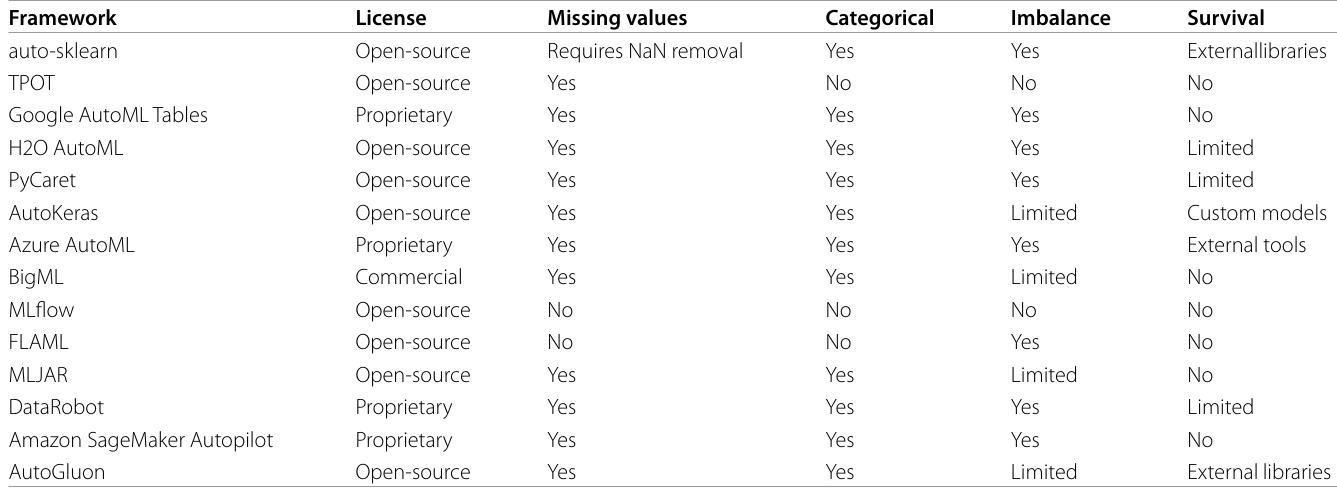
表1は、様々なAutoMLソリューションのデータ前処理と生存時間解析の対応状況を比較しています。CleanSurvivalは、このギャップに対処し、生存時間解析に特化した自動データ前処理を提供する点でユニークな位置を占めています。
CleanSurvivalの核心:強化学習とデータ前処理手法
CleanSurvivalは、強化学習のQ学習アルゴリズムを核として、データ前処理の意思決定プロセスを最適化します。Q学習は、環境と相互作用するエージェント(この場合、前処理パイプラインを決定するシステム)が最適な行動選択ポリシーを見つけることを目指すモデルフリーのオフポリシー強化学習アルゴリズムです。モデルの性能に直結する報酬関数(生存時間モデルの予測性能指標)を最大化するようにパイプラインステップを動的に最適化することで、データクリーニングの決定が生存予測への影響に基づいて導かれます。これにより、データセットと機械学習モデルに最適な前処理の組み合わせを動的に選択できるようになります。
採用されているデータ前処理手法
CleanSurvivalは、多様なデータ特性と分析目標に対応するため、さまざまなデータ前処理手法を提供します。(図1) に示されているように、主な前処理タスクには以下が含まれます。
欠損値補完:
* 完全ケース解析(CCA): 欠損値を含む行を単純に除去します。欠損が少ない場合に適用されます。
* 単純な平均/中央値補完: 欠損値を、その変数の観測値の平均または中央値で置き換えます。
* 多重代入法(MICE): 各欠損値に対して複数の適切な置き換えを生成し、いくつかの完全なデータセットを作成して分析する、より堅牢なアプローチです。これは反復的なプロセスで推定値を洗練させます。
* k近傍法(KNN)補完: 欠損値を持つ観測値に最も類似するk個の観測値を特定し、その値を使用して欠損データを補完します。
外れ値検出:
* 楕円エンベロープアルゴリズム: データ中心からのマハラノビス距離(Mahalanobis distance)に基づいて外れ値を特定・除去します。データの全体的な相関構造から逸脱する外れ値の検出に特に有用です。
* マルチンゲール残差法: 各対象者の観測されたイベント数と期待されるイベント数(単純なKaplan–Meier推定器に基づく)の差を計算し、生存時間がどれだけ異常であるかの尺度を提供します。
変数選択と特徴量抽出:
* 単変量Cox比例ハザード選択(UC): 各特徴が生存に与える個別の影響をCox比例ハザードモデルで評価し、その係数の有意性に基づいて特徴を選択します。
* LASSO回帰: 重要性の低い特徴量の係数をゼロに収縮させ、特徴量選択を効果的に行います。
* 再帰的特徴量除去(RFE): モデル性能への貢献度に基づいて最も重要度の低い特徴量を再帰的に除去します。
* 情報量ゲイン選択(IG): 対象変数(生存アウトカム)に関する情報量を測定し、最も関連性の高い変数を特定します。
サポートされる生存時間モデルと報酬構造
CleanSurvivalには、様々な生存時間分析シナリオに対応するため、以下の3つの生存時間分析モデルが統合されています。
* Cox比例ハザードモデル: 解釈性が高く、ハザード率(イベント発生率)に対する要因の影響を定量化できる広く使われているモデルです。
* ランダム生存フォレスト(RSF): 決定木に基づくアンサンブル手法で、データの非線形性や相互作用に対して堅牢性を提供します。データの根底にある関係が不明瞭な場合に柔軟な選択肢となります。
* DeepHitニューラルネットワーク: ニューラルネットワークの能力を活用して、生存データ内の複雑なパターンと相互作用を捉える深層学習モデルです。
Q学習エージェントを効果的に誘導するため、報酬構造には「C-index」(Concordance index)が使用されます。C-indexは、イベント発生リスクに基づいて対象者を正しくランク付けするモデルの能力を評価するもので、値が高いほど識別能力が優れていることを示します。この報酬は、下流の生存時間モデルの予測に基づいて直接評価されるため、CleanSurvivalは選択されたモデルクラスに最適化された前処理パイプラインを特定します。
4つの動作モード
CleanSurvivalは、ユーザーに幅広いオプションを提供するため、4つの異なる動作モードを実装しています。
* メインアルゴリズムモード: コアのQ学習アルゴリズムを使用して、選択された生存時間分析モデルの性能を最大化する最適な前処理ステップのシーケンスを特定します。
* ランダムクリーニングモード: ユーザーが指定した数のランダムな実験を実行し、ランダムな前処理パイプラインを生成してその性能を評価します。
* カスタムパイプラインモード: シンプルなテキスト設定ファイルを使用して、ユーザーが独自の固定前処理パイプラインを定義できます。
* 前処理なしモード: すべての前処理ステップをバイパスし、生のデータセットを選択された生存時間分析モデルに直接渡します。
これらのモードにより、最適化されたパイプラインの効果を評価するためのベースラインが提供されます。
CleanSurvivalの実験結果:性能向上と堅牢性
著者らは、CleanSurvivalの有効性を評価するために、Rotterdam、Flchain、GBSG(German Breast Cancer Study Group)という実世界のデータセットを使用しました。
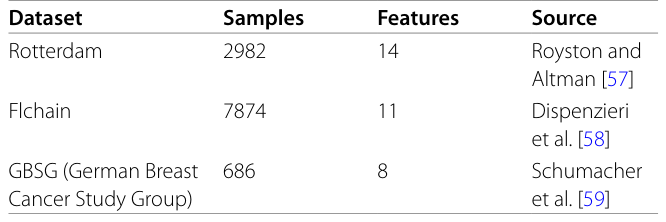
これらのデータセットには、元々欠損値が含まれるものと、シミュレートされた欠損値(欠損が完全にランダム: MCAR、欠損がランダム: MAR、欠損が非ランダム: MNAR)が導入されたものが使用されました。CleanSurvivalの性能は、完全ケース解析(CCA)、欠損値補完のランダム選択、平均値補完といった単純なベースラインと比較されました。評価指標には、C-indexと統合Brierスコア(Integrated Brier Score, IBS)が用いられました。
実験の結果、CleanSurvivalは単純なベースライン(CCAや平均値補完)と比較して予測性能を向上させることが示されました。特に、Rotterdamデータセットの50%欠損設定やFlchainデータセットにおいて、C-indexが改善されました。
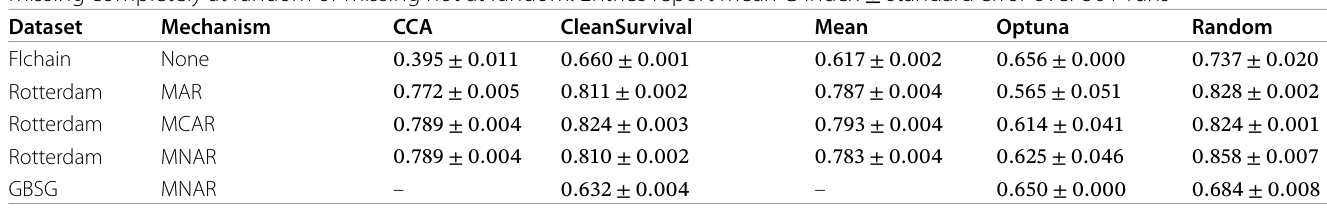
また、Q学習ポリシーによって特徴量選択オペレーター(特にLASSOとRFE)が頻繁に選択されており、CleanSurvivalがノイズの多い特徴を除外することで下流の生存時間モデルを安定させ、性能向上を達成していることが示唆されました。
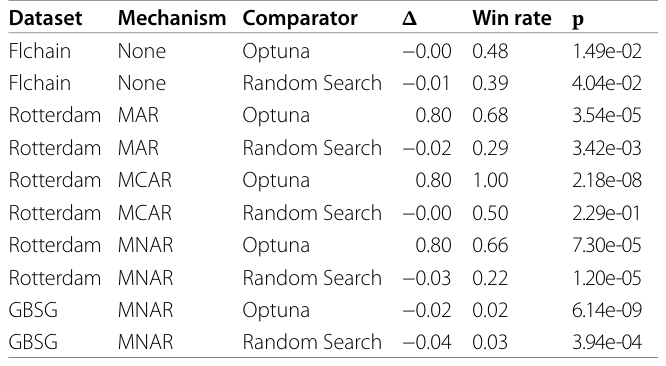
計算時間に関しては、CleanSurvivalはランダム探索と比較してランタイムが大幅に短縮されるケースが多く見られました。
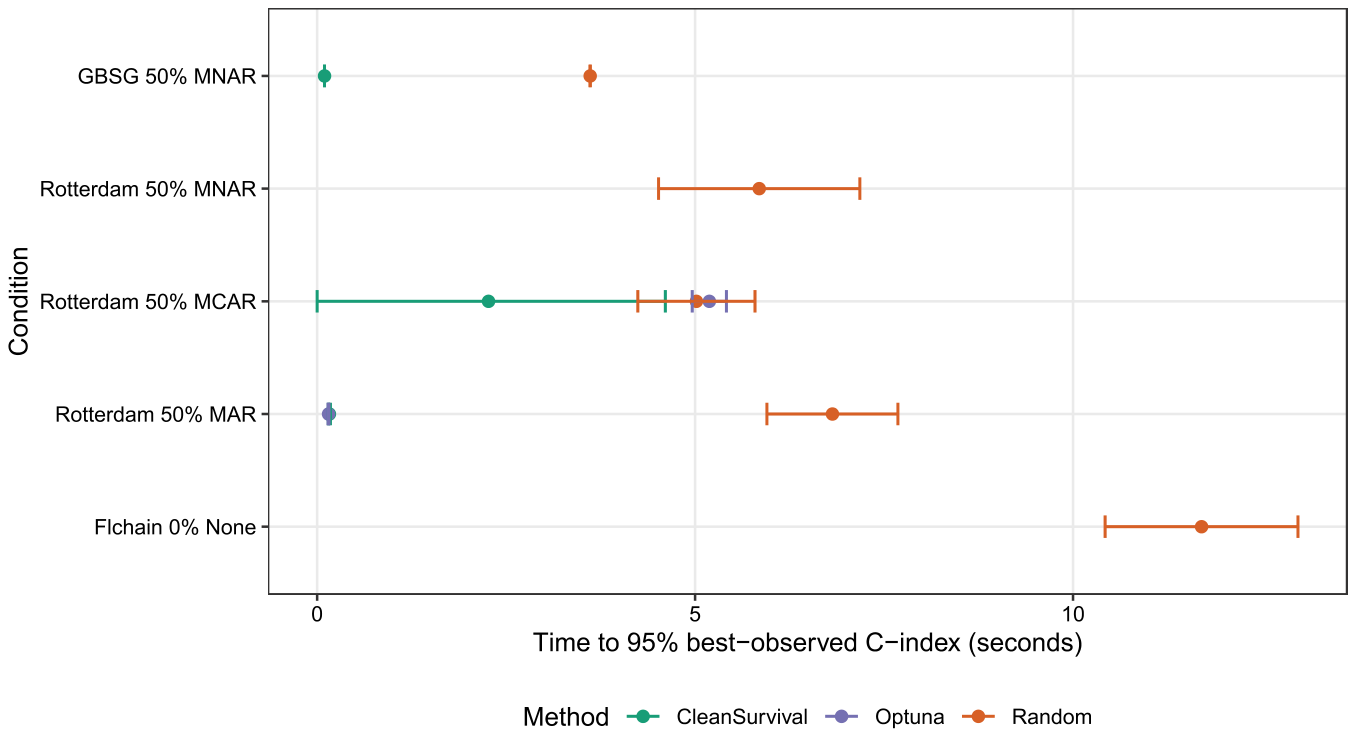
図2は、ベストなC-indexの95%に達するまでの実行時間を示しています。CleanSurvivalは、統合Brierスコアにおいても高い安定性と低い分散を示すことが確認されました。
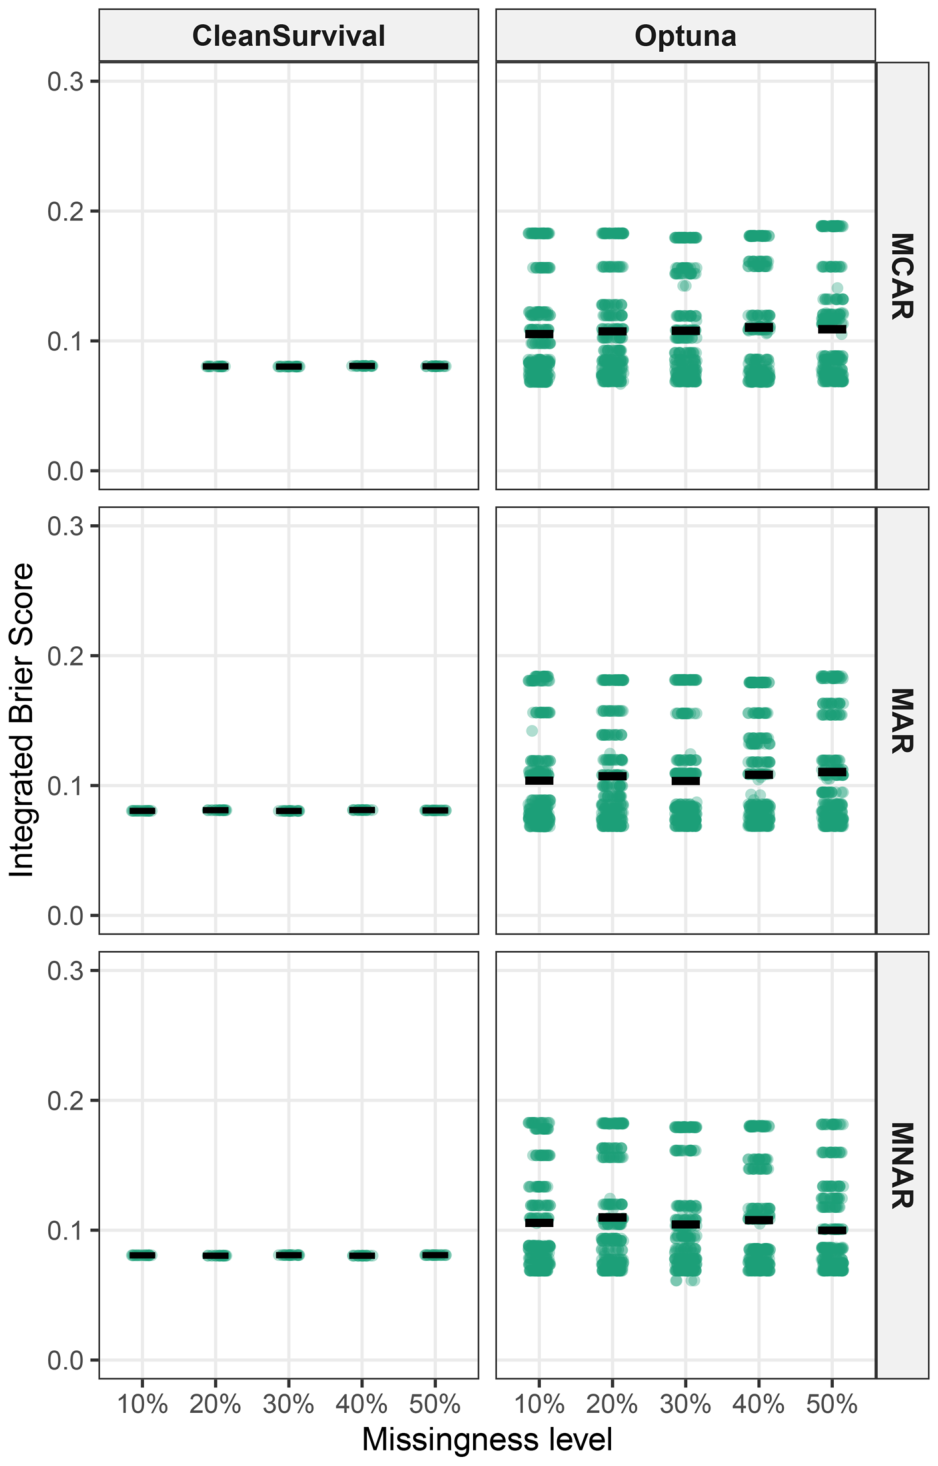
これは、CleanSurvivalが様々な欠損構造において一貫して優れたキャリブレーション(予測が実際のイベント発生確率と一致する度合い)を維持していることを意味します。
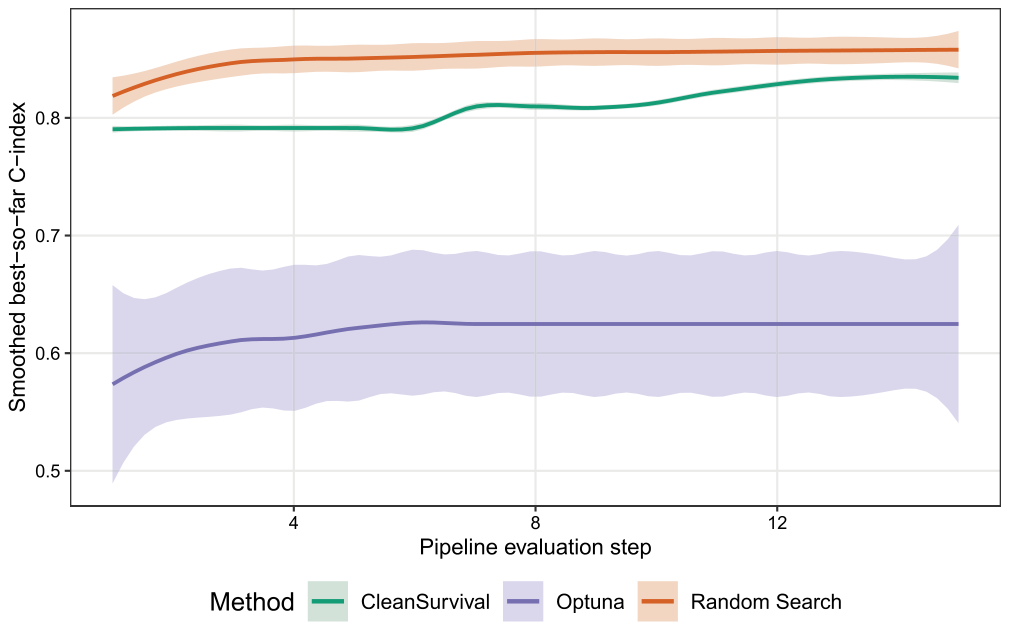
図4は、最適化プロセス中のC-indexの学習軌跡を示しており、CleanSurvivalが効果的に収束している様子が伺えます。
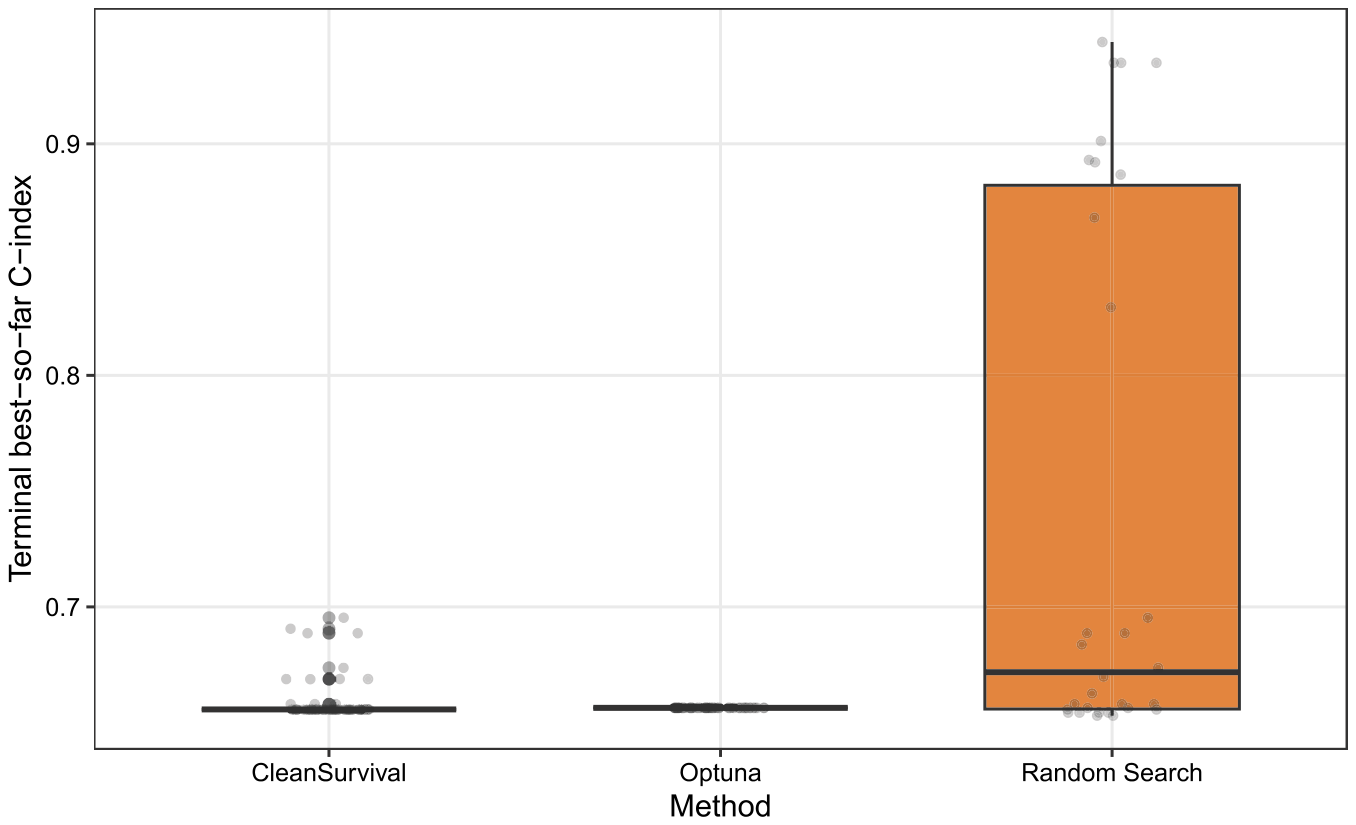
図5は、Flchainデータセットにおける各アルゴリズムの最終的なC-indexの分布をまとめたものです。
さらに、CleanSurvivalの臨床的有用性も示されました。モデルが導き出すリスク層(低、中、高リスクグループ)に基づいて対象者を効果的に層別化することで、自動化された前処理が基盤となる生存シグナルを保持していることが示されました。
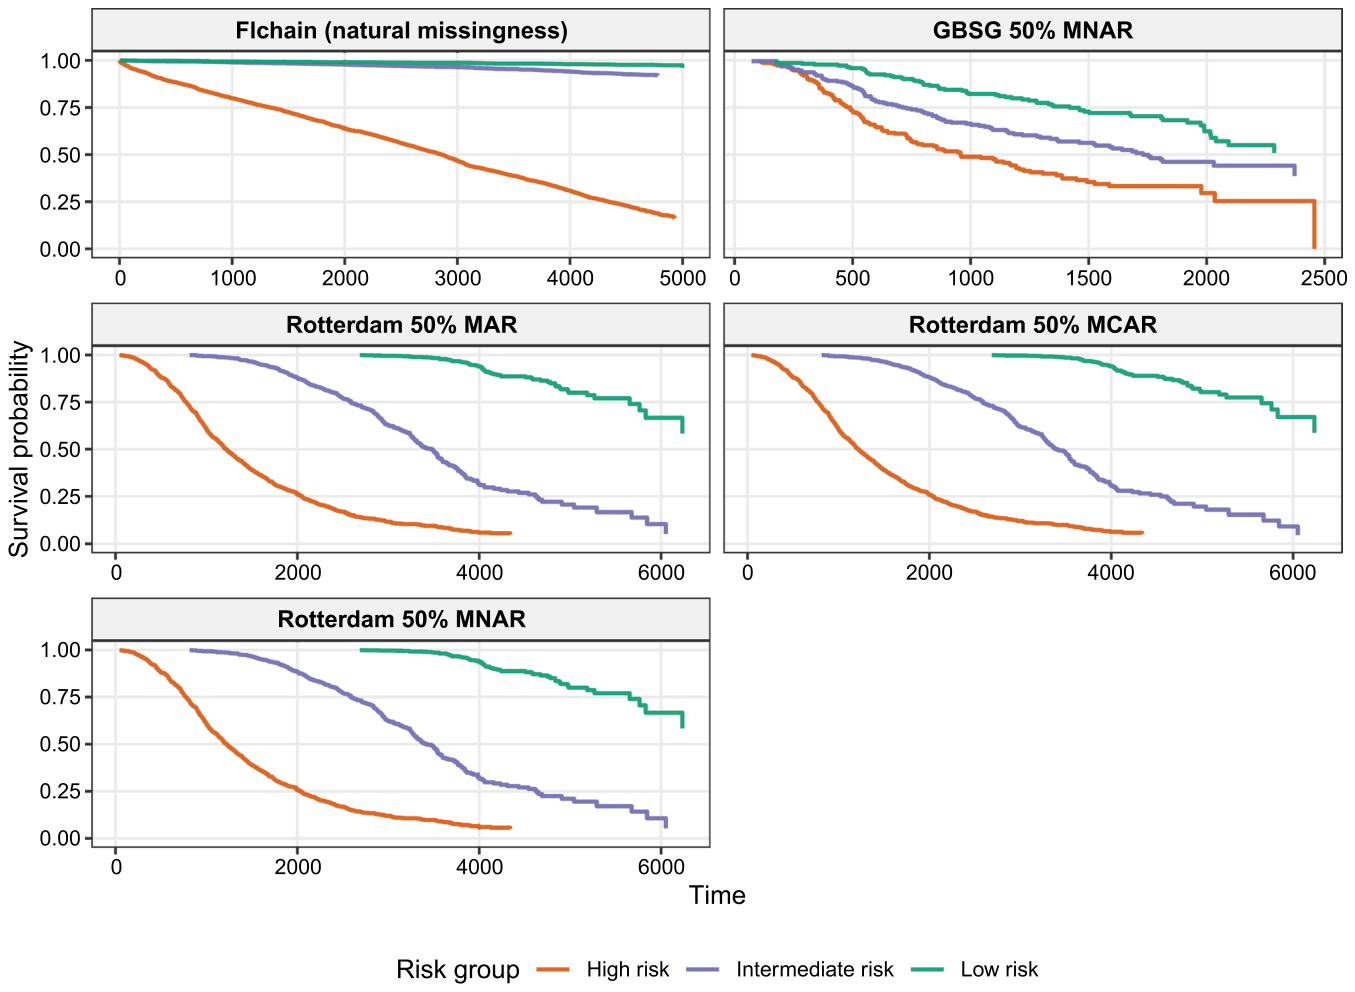
図6は、各リスク層におけるKaplan–Meier生存曲線を示しています。
CleanSurvivalがもたらす未来と今後の展望
CleanSurvivalは、これまでAutoMLの前処理ツールが分類や回帰モデルに集中しがちであった中で、生存時間解析のためのデータ前処理をQ学習ベースのフレームワークと報酬構造を用いて自動化するという点で、重要な進歩を示しました。がん研究などの分野で生存時間解析の重要性が高まる中、打ち切りデータという特有の課題を扱う自動化アプローチの開発は不可欠です。本研究の結果は、データクリーニングを最適化ループに直接統合し、生存時間特有の予測性能指標によってガイドすることで、下流モデルに適応したパイプラインが生成されることを実証しています。
CleanSurvivalは、多様な生存時間モデルをサポートし、ユーザーカスタマイズも可能であるため、機械学習と前処理パイプラインの自動化という新興分野において貴重で柔軟なツールとなります。高次元の電子カルテなどの分析において、臨床データサイエンティストは、欠損値補完や変数選択戦略の最適なシーケンスを選択するのに苦労することがよくあります。CleanSurvivalは、このような場合に、選択された分析手法とデータセットで構成するだけで、ハイパーパラメータの組み合わせやステップ順序の決定を自動化できます。
ただし、いくつかの限界も認識されています。まず、分析に含まれるデータセットは3つに限定されており、より高次元または多モーダルの臨床データセットへの性能向上の一般化は検証されていません。次に、現在の実装では計算上のオーバーヘッドがあり、特にk近傍法補完や複雑な深層学習生存時間モデルをQ学習の反復と組み合わせて繰り返し使用する場合に顕著です。
今後の研究では、フレームワークを拡張して追加の前処理タスクを処理すること、より高度な強化学習戦略を組み込むこと、そして大規模なデータセットや複雑なパイプラインに対するスケーラビリティを向上させることに焦点が当てられます。また、異なるクリーニングされたデータセットと生データをアンサンブル(組み合わせ)することで、予測性能が向上するか、あるいはデータ処理の偏りが増大するかは、今後の研究における未解決の課題です。
用語集
- 機械学習(Machine Learning, ML): データからパターンを学習し、予測や意思決定を行うための技術です。
- 生存時間解析(Survival Analysis): イベント(死亡、病気の再発など)が発生するまでの時間を分析する統計手法です。
- イベント発生までの時間モデル(Time-to-event models): イベントが起こるまでの期間を予測する統計モデルや機械学習モデルを指します。
- データ前処理(Data preprocessing): 生データを機械学習モデルが扱えるように、クリーニング、変換、整理する工程です。
- 打ち切りデータ(Censored data): 生存時間解析において、イベントが観察されずに研究が終了したり、対象者が追跡不能になったりするデータです。
- AutoML(Automated Machine Learning): 機械学習モデルの開発プロセス(アルゴリズム選択、ハイパーパラメータ調整など)を自動化する技術です。
- 強化学習(Reinforcement Learning, RL): エージェントが環境と相互作用し、試行錯誤を通じて最適な行動ポリシーを学習する機械学習の一分野です。
- Q学習(Q-learning): 強化学習のアルゴリズムの一つで、各状態と行動の組み合わせに対する「価値(Q値)」を学習することで最適な行動を決定します。
- 欠損値補完(Data imputation): データセット中の欠損している値(NaNなど)を統計的または機械学習的な手法で埋めることです。
- 外れ値検出(Outlier detection): データセット中で他のデータと大きく異なる異常なパターンや値を特定するプロセスです。
- 特徴量抽出(Feature extraction): 生データから機械学習モデルの学習に有用な新しい変数(特徴量)を生成するプロセスです。
- 変数選択(Variable selection): データセット中の多くの変数の中から、モデルの予測性能に最も貢献する、または最も関連性の高い変数を特定し、選択することです。
- Cox比例ハザードモデル(Cox proportional hazards model): 生存時間解析で広く用いられるモデルで、共変量がハザード率(イベント発生率)に与える影響を評価します。
- ランダム生存フォレスト(Random survival forest, RSF): 決定木を複数組み合わせるアンサンブル学習を生存時間解析に応用したモデルです。
- DeepHitニューラルネットワーク(DeepHit neural network): 深層学習を用いて生存データを分析し、イベント発生時間に関する複雑なパターンを捉えるモデルです。
- C-index(Concordance index): 生存時間モデルの予測性能を評価する指標の一つで、リスクが高い対象者ほどイベントが早く発生すると正しく予測されているかを示します。
- 統合Brierスコア(Integrated Brier Score, IBS): 生存時間モデルの予測精度とキャリブレーション(予測が現実とどれだけ一致するか)を評価する指標で、低い値ほどモデル性能が良いことを示します。
- 完全ケース解析(Complete Case Analysis, CCA): 欠損値を含むすべての対象者を分析から除外する欠損値処理方法です。
- 多重代入法(Multiple Imputation using Chained Equations, MICE): 複数の代入データセットを作成し、それぞれで分析を行った後に結果を統合することで、欠損値の不確実性を考慮する統計手法です。
- k近傍法(k-Nearest Neighbors, KNN): データポイントがk個の最も近い隣接点の多数決または平均に基づいて分類・補完されるアルゴリズムです。
- Mahalanobis距離(Mahalanobis distance): 多変量データにおいて、データ点と分布の中心との距離を、変数の相関関係を考慮して測定する尺度です。
- マルチンゲール残差(Martingale residuals): 生存時間モデルにおいて、観測されたイベント数と予測されたイベント数との差を測る残差の一種で、外れ値検出に用いられます。
- LASSO(Least Absolute Shrinkage and Selection Operator): 回帰分析手法の一つで、重要性の低い特徴量の係数をゼロに近づけることで、変数選択と過学習の抑制を同時に行います。
- 再帰的特徴量除去(Recursive Feature Elimination, RFE): モデルの性能に基づいて最も重要度の低い特徴量を繰り返し除去し、最適な特徴量セットを見つけ出す変数選択手法です。
- 情報量ゲイン選択(Information Gain Selection, IG): 特徴量が目的変数(ここでは生存アウトカム)についてどれだけの情報量を提供するかを測定し、最も関連性の高い特徴量を選択する手法です。
- 比例ハザード仮定(Proportional hazards assumption): Cox比例ハザードモデルの基本的な仮定で、ある2つの対象者のハザード率の比率が時間を通じて一定であるというものです。
- Kaplan–Meier曲線(Kaplan–Meier survival curves): イベントが発生するまでの時間の確率を視覚的に表現するグラフで、対象者集団の生存率の推移を示します。
- 欠損が完全にランダム(Missing Completely At Random, MCAR): データ欠損が、観測されたデータや欠損データそのものとは無関係に発生している状態です。
- 欠損がランダム(Missing At Random, MAR): データ欠損が、観測されている他の変数に依存して発生しているが、欠損データそのものには依存しない状態です。
- 欠損が非ランダム(Missing Not At Random, MNAR): データ欠損が、欠損しているデータそのものの値に依存して発生している状態です。
コメントを残す