
大規模言語モデルの医療画像診断支援:信頼性と説明可能性を追求するRADARプロトタイプ
解説対象論文: RADAR: A Prototype for Grounding Large Language Model Consult Support in an ACR-Structured Appropriateness Knowledge Base with Citation Validation and Abstention
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月28日時点)
大規模言語モデル(LLM)は医療分野でその可能性を示していますが、情報生成の流暢さの裏には、事実の捏造や誤った引用という課題が潜んでいます。この問題を解決し、専門家が安心してLLMを医療現場で活用できるよう、アメリカ放射線医学会(ACR)のガイドライン構造に準拠した知識ベースを活用し、引用の検証と不適切な情報に対する辞退機能を備えたプロトタイプシステム「RADAR」が開発されました。本記事では、このRADARがどのようにLLMの信頼性を高め、臨床における意思決定支援に貢献しようとしているのかを詳しく解説します。
はじめに:医療現場でのLLM活用と課題
どうも、Beyond the Pixelです。医療画像インフォマティクスの分野では、大規模言語モデル(LLM)の進化が目覚ましく、その流暢な対話能力や豊富な知識は、専門家の診断支援ツールとしての大きな可能性を秘めています。特に、画像診断のオーダー時に専門家が適切な検査を選択する上で、アメリカ放射線医学会(ACR)が定める「ACR適切性基準(ACR-AC)」は極めて重要な指針となります。しかし、このACR-ACは200以上の臨床トピックと詳細な検査推奨から成り立っており、多忙な医療現場で常に参照するのは時間的制約から難しいのが現状です。LLMはこのような課題を解決する強力なインターフェースとなりえますが、その一方で大きな問題も抱えています。それは、あたかも事実であるかのように情報を捏造したり、存在しない引用を提示したりする「ハルシネーション(幻覚)」と呼ばれる現象です。この信頼性の欠如が、LLMを医療現場で単独で使用する際の大きな障壁となっています。この研究では、この「検証不可能な引用」と「明示的な情報提供の拒否(辞退)機能の欠如」という2つのギャップを解決するためのプロトタイプシステム「RADAR(Radiology Appropriateness Decision and Advisory Resource)」について解説します。
RADARの仕組み:LLMを「根拠」で固める
RADARは、「検索拡張生成(Retrieval-Augmented Generation, RAG)」という手法を用いたコンサルテーション支援パイプラインです。その核となる考え方は、LLMが自ら推奨事項を生成するのではなく、ACR-ACに似た構造の知識ベースから「適切な情報」を選択し、整形して提示する役割に徹することにあります。これにより、情報の捏造を防ぎ、提示される情報の根拠を明確にすることを狙っています。
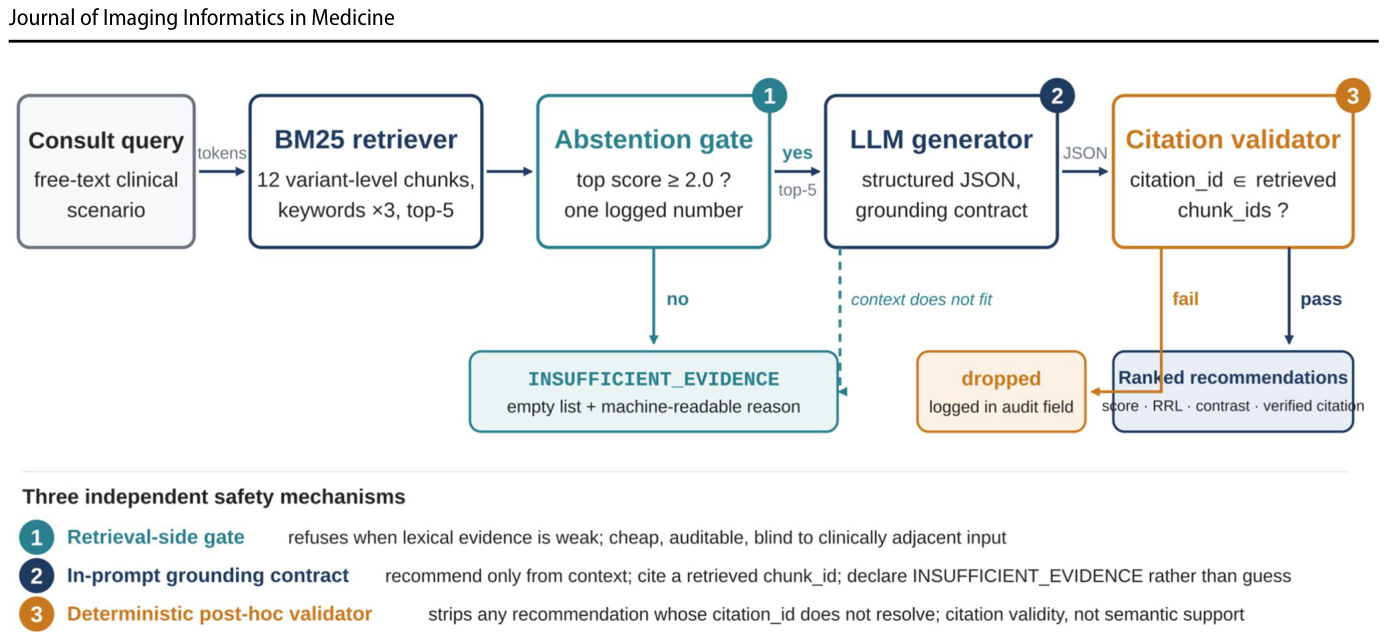
RADARの設計は非常に保守的で、以下の主要な構成要素から成り立っています。1. BM25リトリーバー: 専門家からの自由形式の臨床シナリオ(クエリ)を受け取り、知識ベース内の関連する臨床的バリアント(個々の臨床状況に合わせた基準)を検索・スコアリングします。公式のACR-ACは著作権があるため、この研究では5つのトピックにわたる12の合成バリアントが知識ベースとして用いられました。各バリアントのシナリオキーワードは、検索品質向上のため、索引付けされたテキスト内で3回繰り返して記述されています。2. 絶対スコア辞退ゲート: リトリーバーによるトップスコアが設定されたしきい値(2.0)を下回る場合、システムは「情報不十分(INSUFFICIENT_EVIDENCE)」として明確にクエリを拒否します。これにより、知識ベース外のクエリに対する不適切な応答を防ぎます。3. 構造化出力ジェネレーター: ゲートを通過した上位5つの関連チャンク(情報の断片)がLLMに渡されます。LLMはプロンプト内で「根拠提示契約(grounding contract)」と呼ばれる厳格なルールに拘束され、取得されたチャンクから正確に情報を抽出し、構造化されたJSON形式で出力します。この契約には、引用されたコンテキストに記載されている検査のみを推奨すること、各推奨に取得されたチャンクのIDと等しい引用IDを付与することなどが含まれます。4. 決定論的バリデーター: ジェネレーターが生成した推奨事項について、その引用IDが実際に取得されたチャンクのIDと一致するかを機械的に検証します。一致しない推奨事項は最終的な出力から削除され、検証可能な引用のみが専門家に提示される仕組みです。
評価と結果:LLMの信頼性と限界
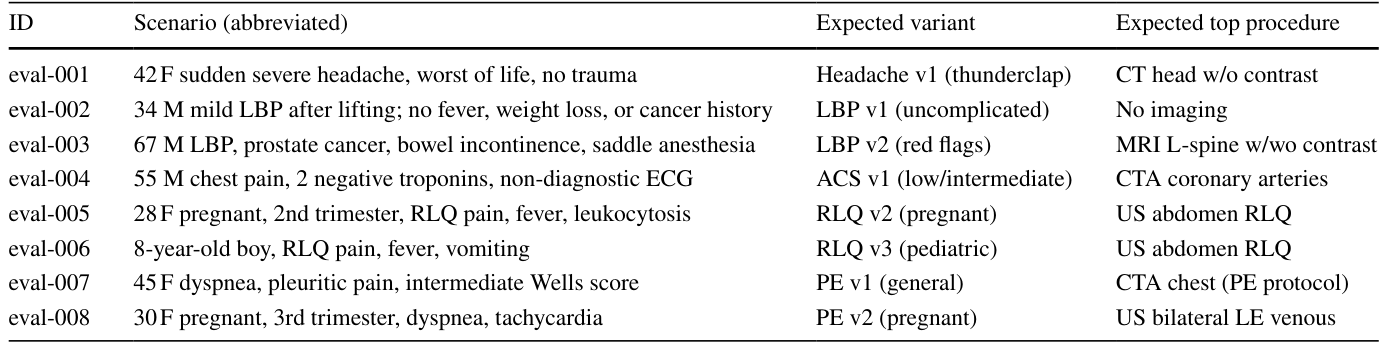
この研究では、システムの性能を評価するために、開発セットと、すべてのパラメーターを固定した後に作成された「ホールドアウトセット」という独立したデータセットが使用されました。開発セットは、パラメータ選択のために使用された8つのコンサルテーションシナリオと7つの領域外プローブで構成されています。例えば、開発セットのシナリオには、激しい頭痛の対象者や、癌の病歴がない軽度な腰痛の対象者などが含まれていました。
検索のみモードでの性能と辞退ゲートの限界
36のホールドアウトシナリオに対する検索(リトリーバー)単体での評価では、34のシナリオで正しいトピック(94.4%)にルーティングできましたが、正しいバリアントを1位にランク付けできたのは25(69.4%)に留まりました。ただし、正しいバリアントは常に上位5つの候補内に含まれていました。検索ランキングが失敗した11のケースは、主に単語の極性(例:「熱なし」を「熱あり」と誤認)や、特定のバリアントを示すキーワードが少ない、あるいは短すぎるクエリによるものでした。
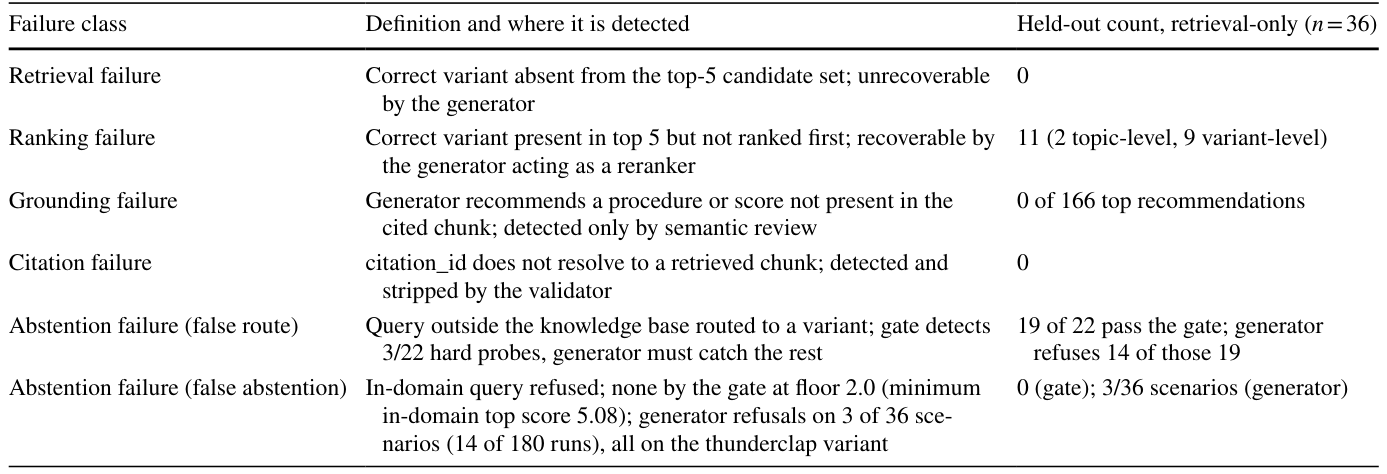
また、辞退ゲートは、システムが応答すべきでない22の「臨床的に隣接するプローブ」(知識ベースにはないが医療に関連するクエリ)のうち、わずか3つしか拒否できませんでした。これは、BM25検索が語彙的な一致に依存するため、ストローク(脳卒中)のクエリが激しい頭痛のバリアントに6.8という比較的高いスコアでルーティングされるなど、知識ベース外の医療関連クエリと知識ベース内のクエリをスコアだけで区別するのが難しいことを示しています。
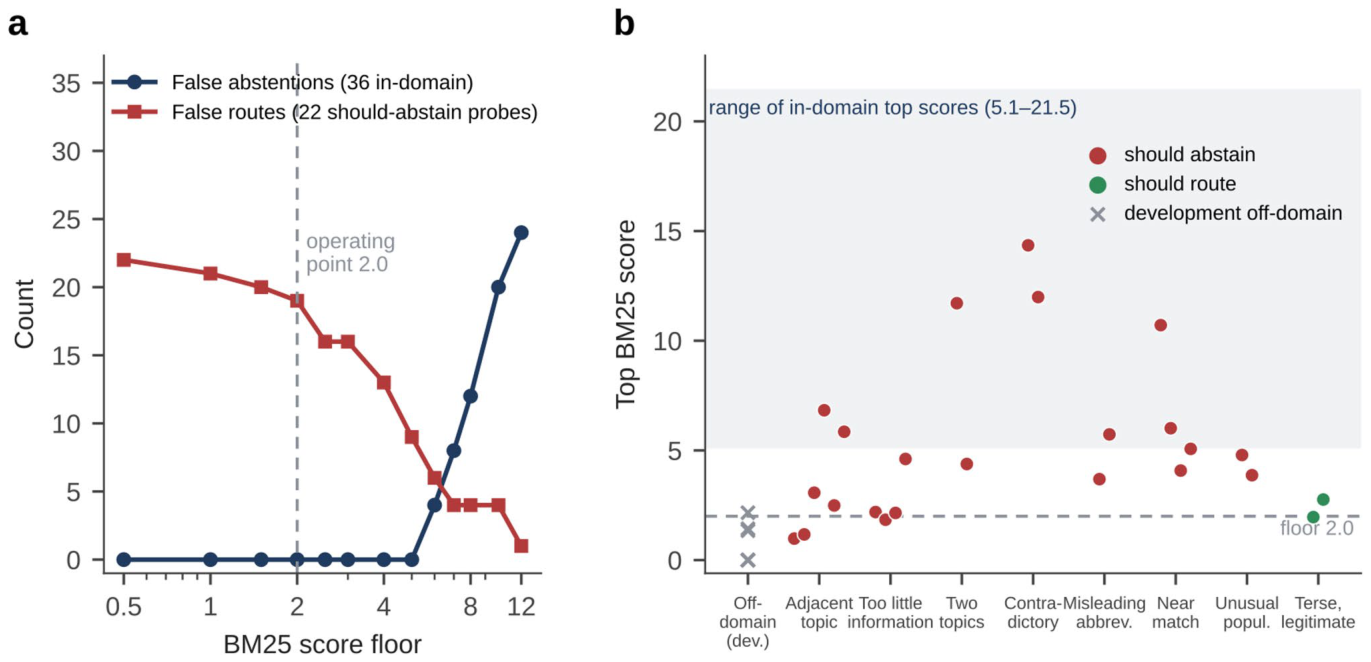
この結果は、単一のスコアしきい値では、不適切なルートを防ぎつつ、適切なクエリを拒否しないようにすることは困難であることを示しています。
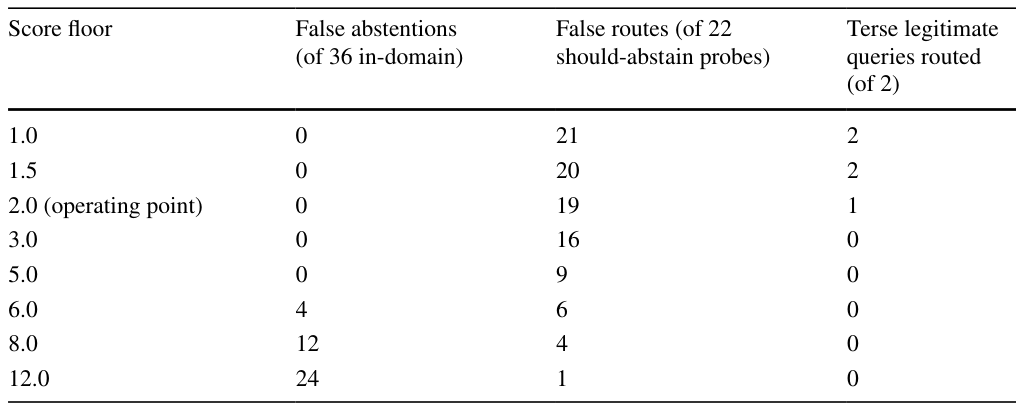
語彙的スコアは、領域外の入力の検出には有効ですが、臨床的に隣接する入力の検出には不十分です。
フルパイプライン(LLMを含む)の成果と信頼性
Claude-sonnet-4-6モデルを用いたフルパイプラインは、ホールドアウトセットの36シナリオのうち33(91.7%)で、5回の試行すべてにおいて正しいバリアントと最適な検査を正確に選択しました。個々の試行で見ると、36シナリオ中33回または34回が正解でした。注目すべきは、フルパイプラインが「誤ったバリアント」を推奨することは決してなく、失敗したケースはすべて「不適切な情報不十分の宣言(false abstention)」、つまりシステムが正しい情報を提示できるにもかかわらず拒否したケースでした。これらの拒否はすべて「雷鳴頭痛(thunderclap-headache)」のバリアントに関するものでした。これは、専門家が誤った情報に基づいて意思決定するリスクを回避するための、システムの保守的な設計の有効性を示しています。
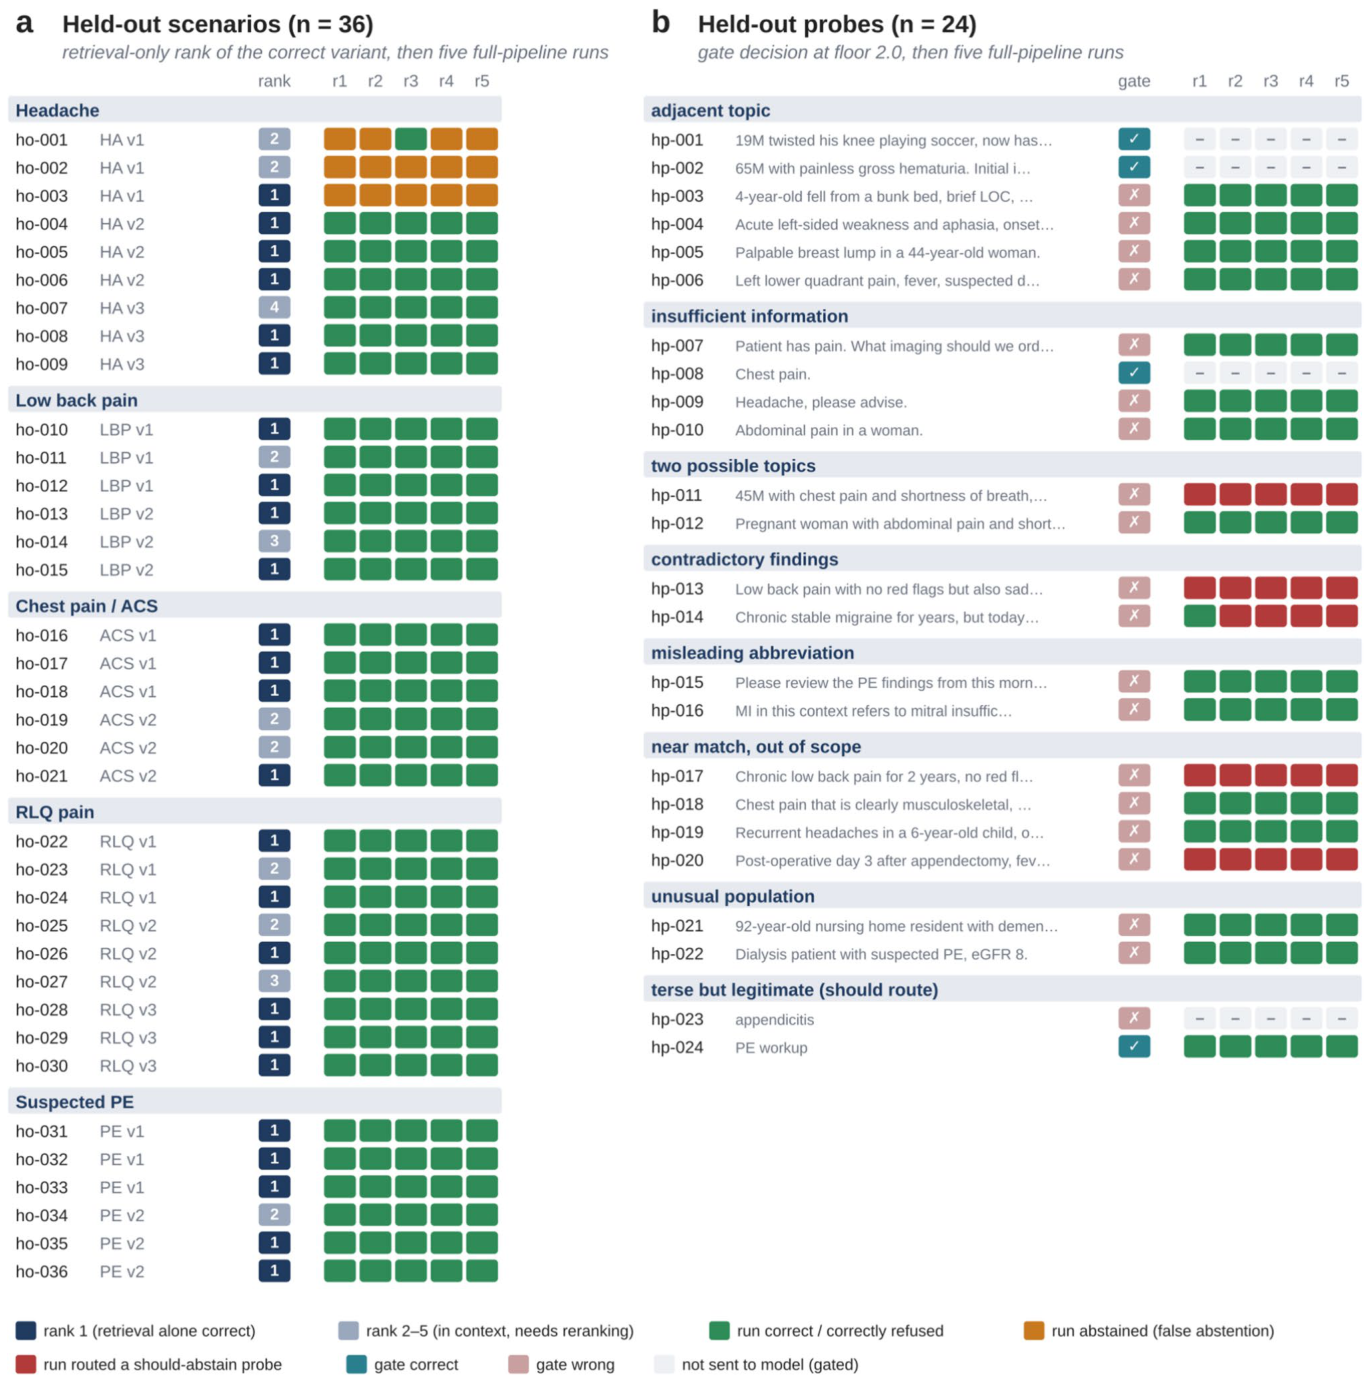
さらに、フルパイプラインは22の臨床的に隣接するプローブのうち17(77.3%)を拒否しました。これは、語彙的なマッチングに頼るゲートだけでは識別できなかった、知識ベース外の医療関連クエリに対して、LLMが「根拠提示契約」に基づいて適切に「情報不十分」を宣言したことを意味します。この研究で出力された591件すべての引用は、取得されたチャンクに解決され、引用の妥当性が完全に検証されました。
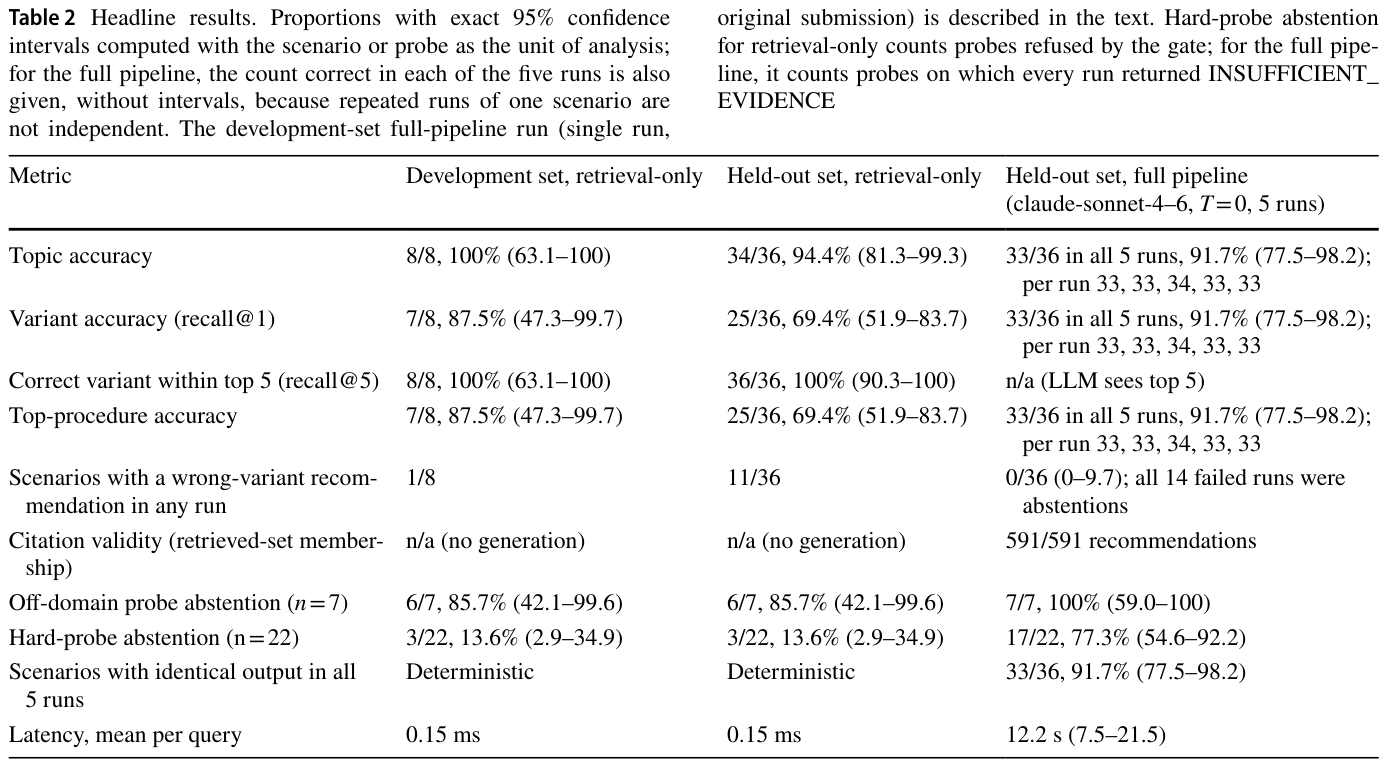
レイテンシー(応答時間)に関しては、LLM以外の処理(検索、ゲート、バリデーター)は0.15ミリ秒と非常に高速でしたが、LLMによる処理は平均12.2秒かかり、同期的なオーダー入力システムには課題が残る可能性があります。
RADARの意義と今後の展望
この研究の成果は、大規模言語モデルが医療画像診断支援において、信頼できる情報を提供するための「概念実証(proof of concept)」として非常に重要です。語彙的な検索(BM25)がトピックのルーティングと引用の追跡可能性を保証する一方で、生成器(LLM)がセマンティックな再ランキング機能として機能し、正確なバリアント選択と現実的な辞退機能を実現しています。RADARは、LLMの流暢さと医療知識を、その信頼性に関する懸念を払拭しつつ活用するための有望なアプローチを示しました。明確な失敗モードと明示的な辞退機能は、専門家がより安全にLLMを活用するための基盤を築くものです。
研究の限界と今後の課題
RADARは研究プロトタイプであり、臨床デバイスではありません。現在の知識ベースは合成された12のバリアントと小規模であり、実際のACR-AC(200以上のトピックと多数のバリアント、多様な表現)での性能は未検証です。臨床導入には、著作権をクリアしたACRの公式コンテンツを組み込むことが不可欠であり、新しい知識ベースに合わせてスコアのしきい値なども再調整する必要があります。評価においても、ホールドアウトセットは著者らによって作成・ラベリングされており、独立した複数名の専門家によるゴールデンスタンダードを用いた評価が求められます。引用の「妥当性(取得されたチャンクからの引用であること)」は確認されましたが、引用されたチャンクが推奨内容を「意味的に支持しているか」の完全な検証は行われていません(トップ推奨については検証済み)。これは今後の課題として挙げられています。また、この研究はシステムの回答の正確性を測定しましたが、それが専門家の行動を実際に変化させるかどうかは測定していません。実際の臨床現場での前向き評価と、既存の意思決定支援システムや専門家との比較研究が必要です。LLMモデルの変更は辞退行動に影響を与える可能性があり、モデルを変更する際には再度ホールドアウトセットでの評価が必要であることを示唆しています。このような限界があるものの、本研究はLLMの医療応用における信頼性向上に向けた重要な一歩であり、今後の研究と発展に期待が寄せられます。
用語集
- 大規模言語モデル (LLM): 大量のテキストデータから学習し、人間のような文章を生成・理解できるAIモデル。
- ハルシネーション: 大規模言語モデルが、事実に基づかない、あたかも真実であるかのような情報を生成してしまう現象。
- 検索拡張生成 (RAG): 大規模言語モデルが外部の知識ベースから情報を検索し、その情報を基に回答を生成する手法。ハルシネーション低減に寄与する。
- ACR適切性基準 (ACR-AC): アメリカ放射線医学会が発行する、様々な臨床状況において最適な画像診断検査を推奨するガイドライン。
- BM25リトリーバー: テキスト検索で用いられるアルゴリズムで、キーワードの出現頻度などを考慮し関連性をスコアリングする。
- 辞退機能 (Abstention): システムが与えられたクエリに対し、情報不十分等の理由で回答を拒否する機能。
- 概念実証 (Proof of Concept): 新しいアイデアや理論が実現可能であることを、単純な形や小規模な実験で示すこと。
- ゴールデンスタンダード: 特定の診断や評価において、最も信頼性が高く、比較の基準となる方法やデータのこと。
コメントを残す