
大規模言語モデルで放射線レポート作成は変わるか?効率と品質向上への可能性
解説対象論文: From Dictation to Structured Report: A Multicenter Evaluation of a Large Language Model–Assisted Dictation and Report Structuring Workflow in Radiological Reporting
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年11月12日時点)
医療現場における放射線レポートの作成は、診断の正確性と迅速な情報共有に不可欠です。しかし、従来の「口述-転写」ワークフローは、レポート作成の遅延や、テンプレートからの記述の偶発的な削除といった運用上の課題を抱えていました。本研究は、大規模言語モデル(LLM)を活用した新しいワークフローが、これらの課題をどのように改善できるか、多施設での評価を通じて検証しました。
はじめに:従来のレポート作成の課題
どうも、Beyond the Pixelです。医療現場における放射線レポートの作成は、診断の正確性と迅速な情報共有に不可欠です。しかし、従来の「口述-転写」ワークフローは、専門家が音声で所見を口述し、転写担当者がそれを文字に起こして標準テンプレートに配置し、専門家が最終承認するという流れです。このプロセスは、レポート作成の遅延や、テンプレートに記載されている正常な基準値を示す記述を誤って削除してしまうなど、運用上の課題を抱えていました。これらの課題は、臨床における意味合いに影響を及ぼす可能性のある、不完全な情報伝達、用語の誤り、テキストエラーとして報告されています。特に、「正常所見の偶発的な削除」とは、標準レポートテンプレートに病的な所見が追加される際に、関連性のない正常な基準値を示す記述が不適切に削除されることを指します。このような省略は、レポートの範囲と明確さを損ない、経時的な比較を複雑にし、臨床コミュニケーションに曖昧さを生じさせる可能性があります。近年、Transformerベースの大規模言語モデル(LLM)は、自然言語処理、文脈情報の合成、構造化されたテキスト生成能力を通じて、放射線レポート作成ワークフローを支援する新たな可能性を提示しています。本研究は、LLMを活用した新しいワークフローが、これらの課題をどのように改善できるか、多施設での評価を通じて検証しました。この研究の目的は、LLMの音声からテキストへの変換およびレポート構造化機能に基づくワークフローを、従来の口述-転写ワークフローと比較することでした。トルコ語の造影胸部CT検査を対象とし、同一の専門家による口述と同一の標準テンプレートを使用することで、口述内容やテンプレート特性に依存しないワークフロー間の違いを評価することを目指しました。
研究デザイン:LLMと従来のワークフローを比較
この研究は、レトロスペクティブな多施設ペアード研究として、3つの大規模医療施設(センターA、B、C)で実施されました。各センターから1名の放射線専門家と1名の医療転写担当者が協力し、2026年1月から6月にかけて実施された450件の造影胸部CT検査が対象となりました。倫理委員会の承認を得た後、選択された検査はルーチンワークフロー外で再口述されました。各検査について、所見とインプレッション/推奨事項のセクションを含む1つの音声記録が作成され、オーディオファイルとして保存されました。この同一のオーディオファイルと同一の標準胸部CTレポートテンプレートが、2つの並行したレポート作成ワークフローで用いられました。これにより、合計900件のペアードレポート下書きが作成されました。
従来のワークフロー
保存されたオーディオファイルは、各センターのルーチン転写キューに提出され、最低5年の経験を持つ医療転写担当者によって転写されました。転写担当者は、専門家が口述した所見とインプレッション/推奨事項の記述を、標準レポートテンプレートの関連するセクションに配置して、生レポート下書きを作成しました。レポートの準備にかかる時間は、オーディオファイルがシステムに提出されてから、転写担当者が生レポート下書きを保存し、「作成済み」ステータスになった時点までの間隔として記録されました。
LLM支援ワークフロー
ChatGPTプラットフォーム(OpenAI製)上にプロジェクトが作成されました。このプロジェクトには、研究固有の指示、詳細なルール文書、および従来のワークフローで使用される標準トルコ語造影胸部CTレポートテンプレートが含まれていました。モデルはGPT-5.6 Solと表示されていました。全ての直接的な対象者識別情報が削除され、データが匿名化された後、同一のオーディオファイル(所見とインプレッション/推奨事項)がプロジェクト内のメッセージ添付ファイルとしてモデルに提出されました。CT画像やその他の臨床データは転送されていません。モデルは、プラットフォームに組み込まれた音声テキスト変換(STT)機能を使用して録音を転写し、指示に従って標準テンプレートの関連セクションに内容を配置しました。中間的な文字起こしは専門家によって作成、読取り、編集されませんでした。レポート下書きの生成にかかる時間は、オーディオファイルを含むメッセージが送信されてから、完成したレポートがユーザーインターフェースに完全に表示されるまでの間隔として記録されました。
モデルに与えられた主な指示は以下の通りです。
* テンプレート: アップロードされた標準テンプレートを唯一の承認された必須の骨格とすること。
* 構造の保持: テンプレートの見出し、セクション、段落、解剖学的順序を固定し、口述された各所見を正しい解剖学的段落に配置すること。
* 矛盾しない正常所見の保持: 口述された所見が直接矛盾する正常な情報コンポーネントのみを置き換えること。テンプレート内の他の全ての正常所見は保持すること。
* 情報の捏造禁止: モデルは、対象者固有の画像所見、測定値、単位、左右、局在、数、否定、確実性、比較、臨床情報、技術的詳細を捏造または変更することを禁止されている。
* エラー修正: 明らかな音声認識、スペル、句読点、文法、および曖シャな用語のエラーは、臨床内容を変更せずに自動的に修正すること。
LLMはいかなる段階でもCT画像にアクセスしたり、画像を解釈したり、独立した診断決定を行ったりしませんでした。専門家によって口述された内容を音声からテキストに変換し、標準テンプレートに配置しただけである点に留意することが重要です。この評価では、口述した専門家が各センターで作成されたレポートのみを評価しました。評価者は、各レポートが従来の転写によって生成されたか、LLM支援ワークフローによって生成されたかを知らされていませんでした。各レポートは、5点リッカート尺度(1が「不十分」、5が「優れている」)でスコアリングされました。
大規模言語モデルがもたらす品質と効率の向上
この研究の結果は、LLM支援ワークフローが、従来のワークフローと比較して、レポート作成の品質と効率において顕著な改善をもたらす可能性を示しています。
レポート品質の評価
LLM支援ワークフローは、評価された4つの品質項目すべてにおいて、従来の転写よりも高い評価を受けました (Table 1)。
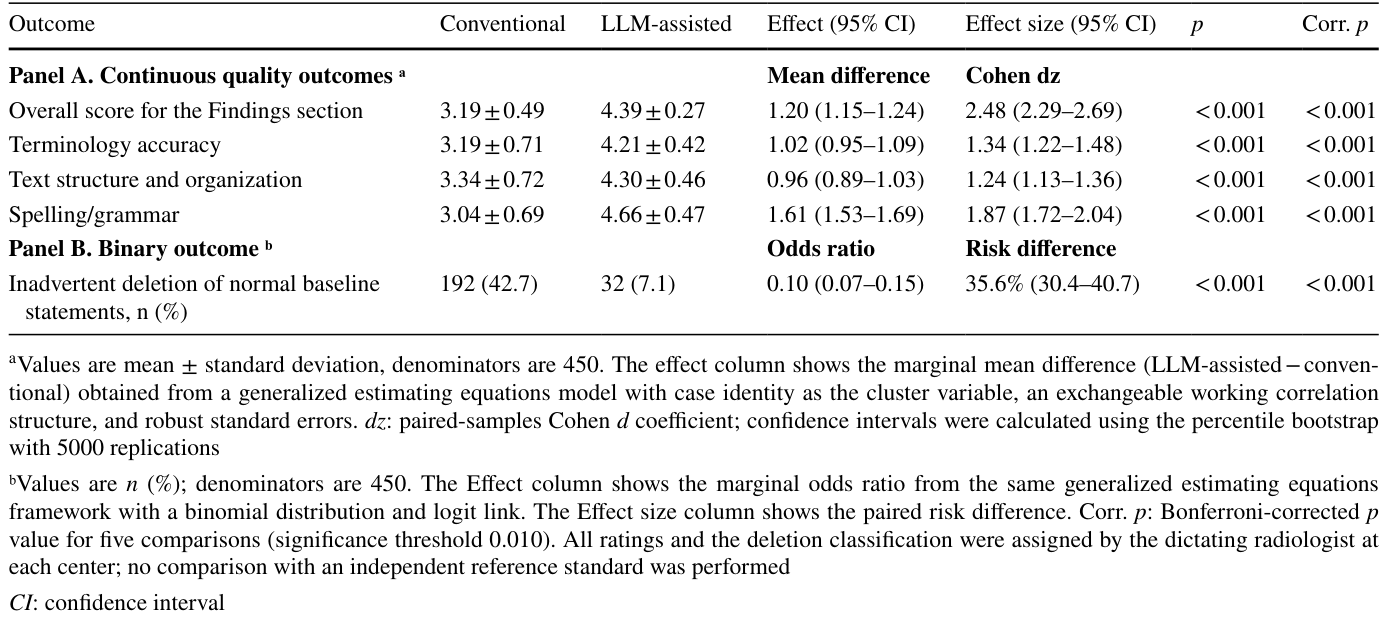
「所見」セクションの総合スコアでは、従来のワークフローが3.19 ± 0.49であったのに対し、LLM支援ワークフローは4.39 ± 0.27と、統計的に有意な差(差1.20;95%信頼区間1.15–1.24;p < 0.001)が認められました。この差は特に、スペル/文法において最も大きく、従来のワークフローが3.04 ± 0.69であったのに対し、LLM支援ワークフローは4.66 ± 0.47でした。用語の正確性(従来の3.19 ± 0.71に対しLLMは4.21 ± 0.42)およびテキストの構造と構成(従来の3.34 ± 0.72に対しLLMは4.30 ± 0.46)も、LLM支援ワークフローの方が有意に高い評価を得ました。個々の症例レベルで見ると、450症例中442症例(98.2%)でLLM支援ワークフローの総合スコアが上回っていました (Figure 2)。
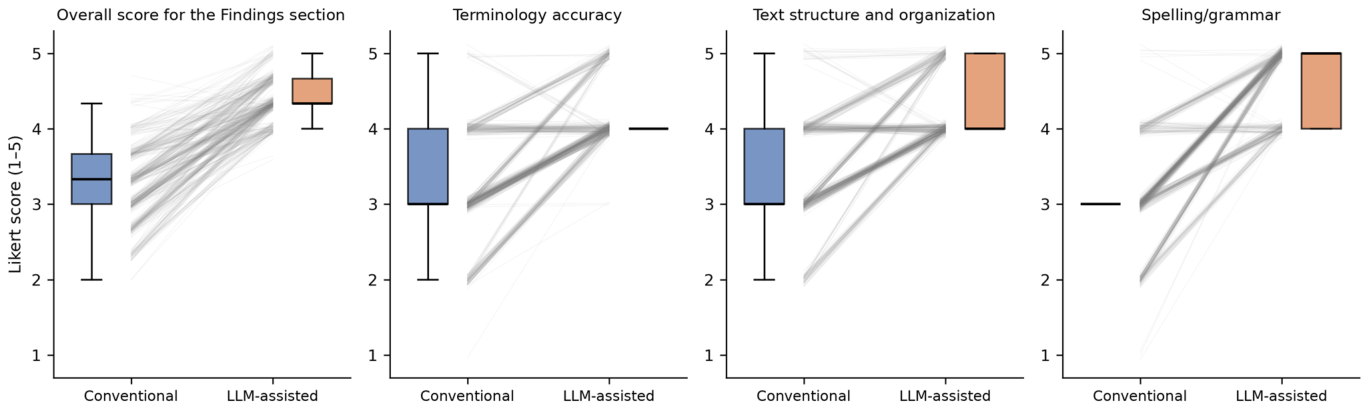
この結果は、LLMが言語処理において人間による転写よりも構造的な優位性を持つことを示唆しています。ただし、モデルにはスペル、句読点、用語の誤りを修正するよう明示的に指示されていたのに対し、転写担当者はルーチン作業の指示に従っていたため、この差の一部は指示の違いを反映している可能性があります。
正常所見の偶発的な削除の減少
研究で定義された運用上のエラーである「正常所見の偶発的な削除」は、従来のワークフローでは450件中192件(42.7%)のレポートで検出されましたが、LLM支援ワークフローでは32件(7.1%)に減少しました (Table 1)。ペアードリスク差は35.6%(95%信頼区間30.4–40.7%;p < 0.001)であり、これは約3件の検査につき1件の割合で、このエラーのある下書きが減少することに相当します。後から行われた分析では、どちらのワークフローにおいても削除された正常な情報はレポートの他の箇所に保持されていなかったため、これらの削除はテンプレート情報の損失を表していると確認されました。LLM支援ワークフローのみで削除が発生した19件の症例の特性評価では、口述された所見の配置時に過剰な削除(例えば、口述された所見が文の一部のみを矛盾しているにもかかわらず、複数要素の正常文全体を削除)が主なパターンとして特定されました。
探索的サブグループ分析では、このエラーが従来のワークフローにおいて症例の複雑さとともに顕著に増加する(単純症例で20.0%から複雑症例で65.3%へ)一方で、LLM支援ワークフローでは複雑さのレベルに関わらず約7%に維持されるという興味深いパターンが観察されました (Table 3, Figure 4)。
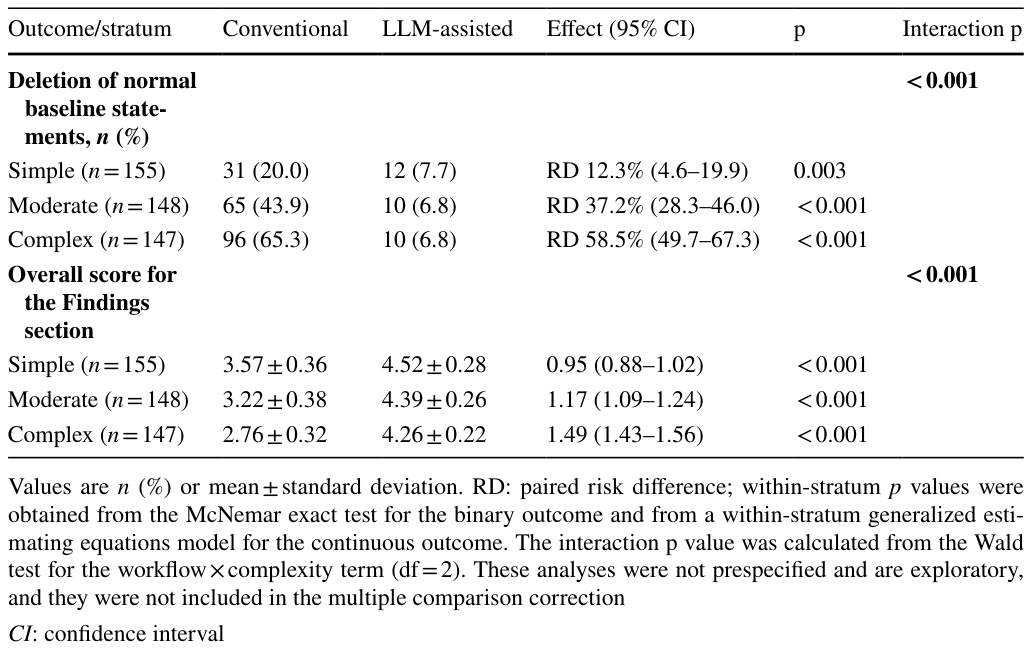
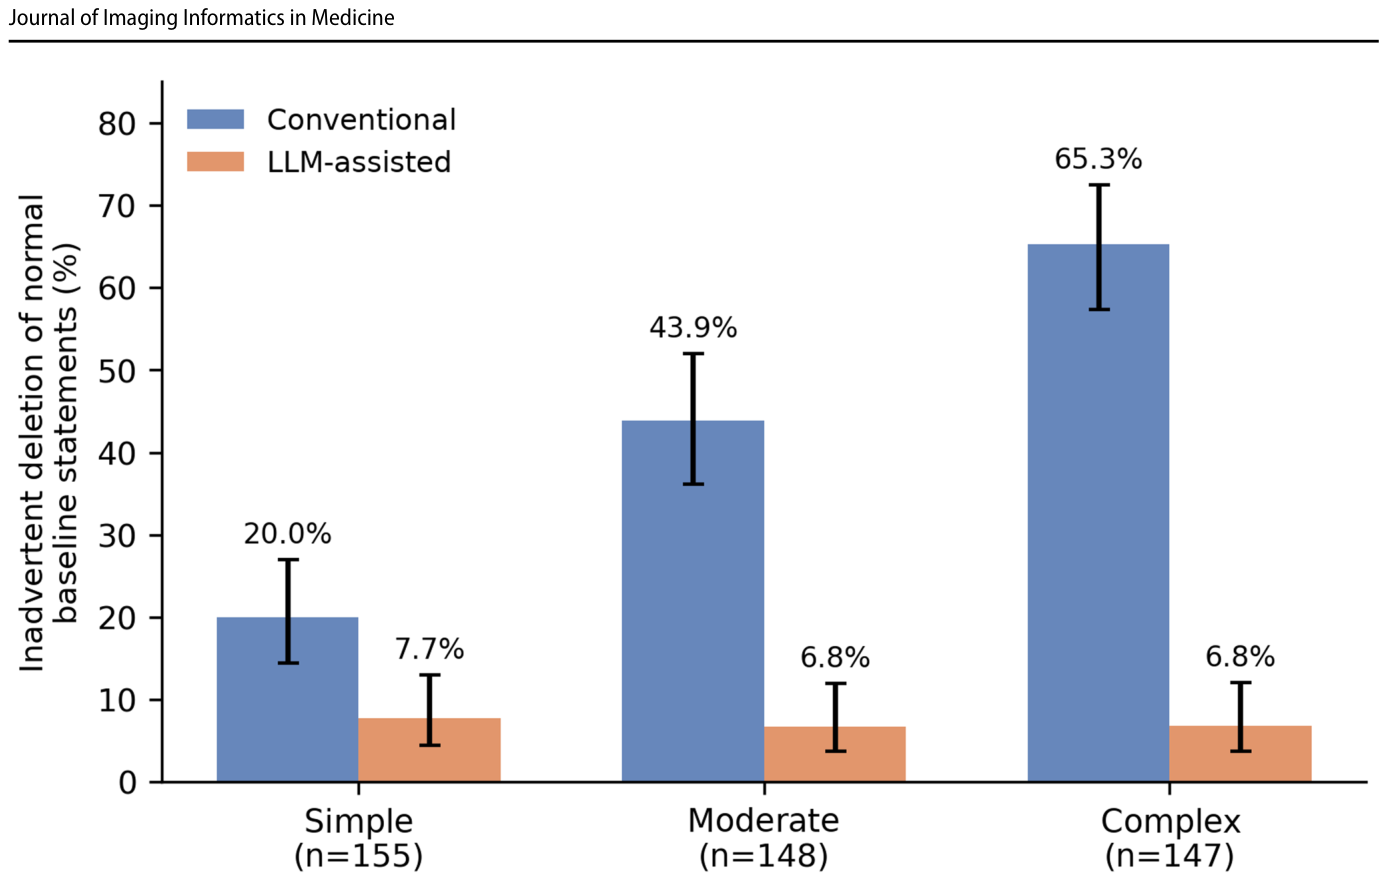
これは、従来のワークフローにおける複雑な症例での手動編集が転写担当者の認知負荷を増加させ、エラー率を高める可能性を示唆しています。LLMは入力の複雑さに対して削除率が安定しているため、その優位性がより発揮されると考えられます。
レポート下書き準備時間の短縮
レポート下書きがレビュー可能になるまでの時間は、従来のワークフローでは中央値34.5分であったのに対し、LLM支援ワークフローではわずか1.00分でした (Table 2)。
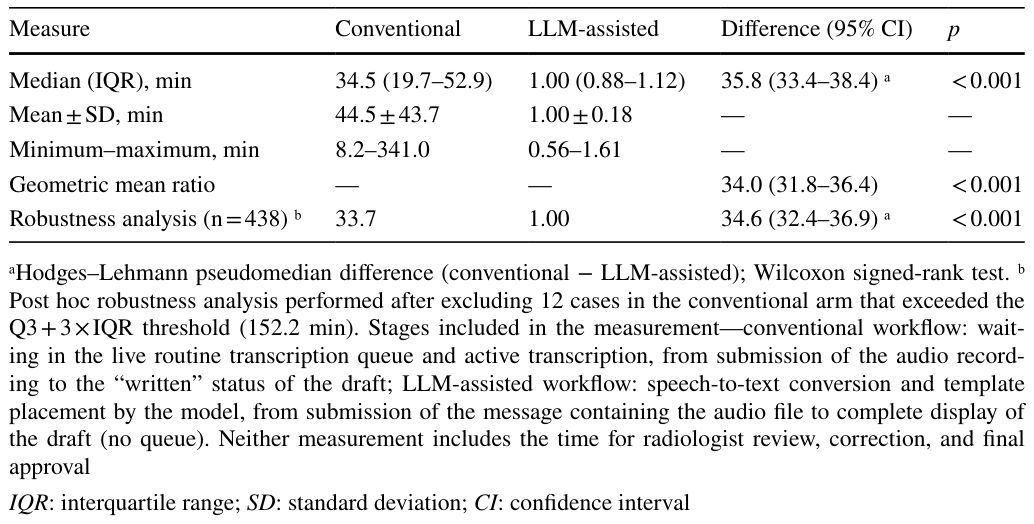
Hodges–Lehmann擬似中央値差は35.8分(95%信頼区間33.4–38.4;p < 0.001)であり、すべての450症例において従来のワークフローの方が時間がかかりました (Figure 3)。
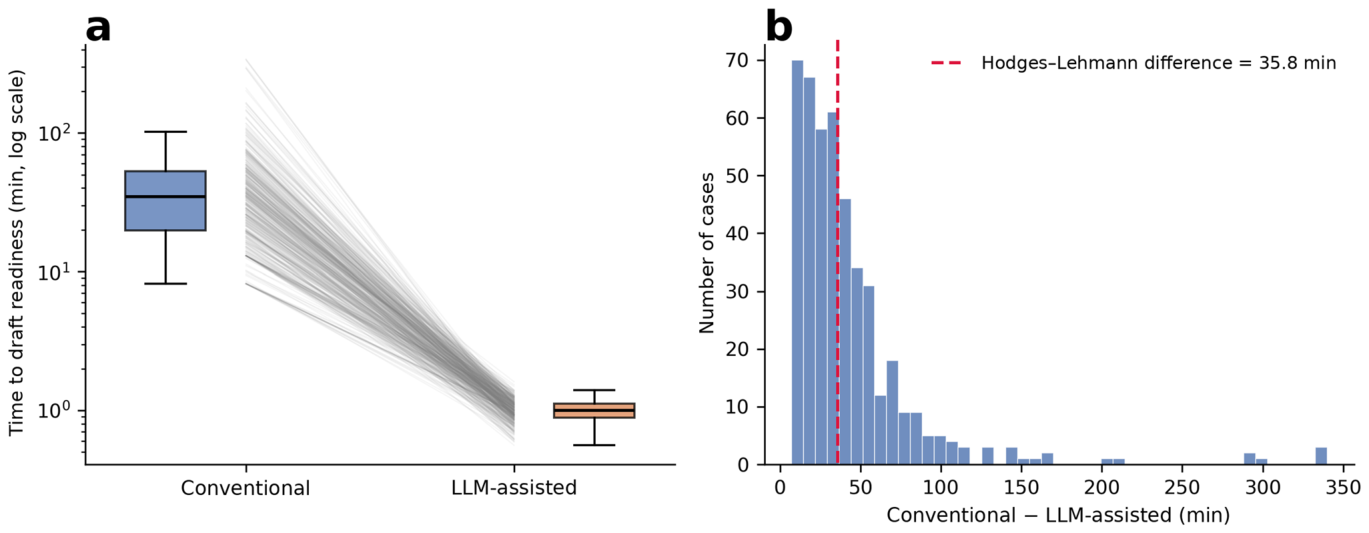
従来のワークフローの測定時間には、ライブのルーチン転写キューでの待ち時間とアクティブな転写時間が含まれるため、この大幅な時間短縮は、キュー待ち時間の削減が主要な要因であると考えられます。LLM支援ワークフローではキューがないため、この待ち時間がなく、実質的な処理時間のみが測定されます。この結果は、LLM支援ワークフローがレポート下書きを迅速に提供する能力を示しています。ただし、この測定には専門家によるレビュー、修正、最終承認の時間は含まれていません。
専門家の満足度と今後の展望
この研究で報告した3名の放射線専門家は、LLM支援ワークフローについて、全体的な品質認識、快適さと知覚されるワークロード、システムへの信頼、時間の節約、将来的なシステム使用の意欲の全てにおいて、従来のワークフローよりも高い満足度を記述的に報告しました。特に、時間節約、快適さと知覚されるワークロードにおいては、3名全員が5点満点を与えています。
研究の限界と考慮事項
本研究は、LLMの放射線レポート作成への応用における重要な知見を提供しますが、いくつかの限界も存在します。最も重要な点は、モデルがいかなる段階でも画像にアクセスしたり、独立した診断決定を行ったりしなかったことです。したがって、観察された違いはモデルの診断能力に関するものではありません。また、LLM支援ワークフローが口述された臨床内容をより正確に転送したことを証明するものでもありません。評価されたのは、口述した専門家が判断した言語的および構造的な品質であり、異常所見の見落とし、測定値の変更、口述されていない内容の挿入、内部矛盾などは、独立したゴールデンスタンダードと比較して系統的に評価されていません。流暢さやテンプレートへの適合性が向上したからといって、必ずしも臨床的正確性が向上したとは断定できないのです。
また、今回の測定には、専門家による下書きのレビュー、修正、最終承認にかかる時間が含まれていません。LLMにおけるエラー率が低いとしても、上で述べた過剰削除のような、まれに発生するLLM特有のエラーを検出するには、かなりの注意と時間が必要となる可能性があります。真に効率的なワークフロー比較を行うには、口述、転写または音声認識、構造化、専門家による修正、最終承認の全ての段階を含める必要があります。
データガバナンスも重要な考慮事項です。本研究では、直接的な対象者識別情報を全て削除し、データが匿名化された上で音声記録のみがプラットフォームに提出されました。一般目的の商用プラットフォームをルーチン臨床で使用する際には、施設内のデータセキュリティ、保持ポリシー、および地域の規制に関して別途評価する必要があります。さらに、商用LLMのバージョンアップがモデルの動作を変更する可能性があるため、臨床現場ではモデルバージョンの管理と定期的な性能モニタリングが不可欠です。
結論と今後の展望
本研究は、LLM支援ワークフローが放射線レポート作成において、下書きの品質向上、特定の運用上のエラー(正常所見の偶発的な削除)の減少、および下書きの準備時間の短縮に貢献する可能性を示唆しています。特に、転写担当者のリソースが限られている環境や、レポートの遅延が臨床ワークフローに影響を与えるような状況において、LLM支援ワークフローはさらなる評価に値します。最終的な放射線専門家による承認は、引き続き不可欠な安全ステップであり、LLMを導入したとしても、ヒューマンレビューの重要性は変わりません。将来的には、独立した評価者による臨床的正確性の検証や、修正時間の測定を含むプロスペクティブ(前向き)研究を通じて、LLM支援ワークフローの真のエンドツーエンドの効率と精度を評価することが求められます。
用語集
- 大規模言語モデル (LLM): 大量のテキストデータを学習し、人間のようなテキスト生成や理解ができる人工知能モデル。
- 口述-転写ワークフロー: 専門家が音声で所見を口述し、転写担当者がそれを文字に起こして文書を作成する従来の作業工程。
- 正常所見の偶発的な削除: レポートテンプレートに病的な所見が追加される際に、関連性のない正常な基準値の記述が意図せず削除されるエラー。
- 音声テキスト変換 (STT): 音声入力された言葉を自動的にテキストデータに変換する技術。
- 放射線情報システム (RIS): 放射線部門の検査予約、結果管理、画像管理などを統合的に行う情報システム。
- ゴールデンスタンダード: 評価の比較対象となる、最も信頼性が高く確立された基準。
コメントを残す