大腸がん迅速診断パスウェイを最適化する機械学習モデル:スウェーデンの挑戦

· 論文解説

🎧 この記事を音声で聴く(AI生成Podcast)

解説対象論文: Development and external validation of a machine-learning risk model for colorectal cancer triage in Sweden’s fast-track pathway
BMC Medical Informatics and Decision Making|被引用数: 0(2026年9月9日時点)

大腸がんの早期発見は治療成績の向上に不可欠であり、疑わしい症状を持つ対象者を迅速に精密検査(大腸内視鏡検査)へ導く「迅速診断パスウェイ」が世界中で導入されています。しかし、この迅速パスウェイは内視鏡検査のキャパシティに大きな負担をかけ、待機時間の延長につながる課題も抱えています。このような背景の中、スウェーデンで行われた研究では、便潜血検査(FIT)と臨床データを組み合わせた機械学習モデルを開発し、迅速診断パスウェイにおける大腸がんトリアージの支援を目指しました。本記事では、この興味深い研究について詳しく掘り下げていきます。

研究サマリー(FINER & PICO)
Feasible実施可能性 日常的に収集される臨床データ(年齢、性別、症状、FIT、ヘモグロビン、画像所見)を利用しており、実装可能性が高い。
Ethical倫理面 後向き研究のため、対象者のプライバシーを保護し、倫理的承認を得て実施された。
Interesting面白さ 内視鏡キャパシティのひっ迫という現実的な課題に対し、機械学習によるトリアージ支援を試みている。
Novel新規性 既存研究のギャップである、迅速診断パスウェイに特化した多変量機械学習モデルの外部検証を行った。
Relevant切実さ 大腸がんの早期発見と医療資源の効率的な利用という、公衆衛生上重要な課題に取り組んでいる。
Measurable測定可能性 AUC、キャリブレーション、決定曲線分析を用いてモデル性能を客観的に評価している。
Modifiable派生・改善 便潜血検査(FIT)の定量的データ利用や他因子追加でモデル改善の余地がある。
Structured文章構造 レトロスペクティブコホート研究として、開発コホートと独立した外部検証コホートを用いた堅牢な研究デザイン。
PICO / PECO対象・介入・比較・結果 P: 大腸がん迅速診断パスウェイで紹介された対象者, I: 機械学習リスクモデルによるトリアージ, C: 既存のパスウェイの入り口ルール, O: 大腸がん検出の最適化

迅速診断パスウェイの課題と機械学習の可能性

どうも、Beyond the Pixelです。大腸がんは、欧州でがんによる疾病負荷の主要な原因の一つであり、診断の遅れを減らすために多くの医療システムで迅速診断パスウェイが採用されています。例えば、スウェーデンの結腸直腸がん標準ケアコース(SCC-CRC)もその一つです。しかし、これらのパスウェイは内視鏡検査のキャパシティに大きな負担をかけ、待機時間の目標が達成されないケースも少なくありません。この状況は、がん発見率を高く維持しつつ、迅速診断パスウェイ内での優先順位付けを支援するツールの必要性を示唆しています。

現在の課題とこれまでの取り組み

症状のみによる評価は診断的価値が限定的です。直腸出血、鉄欠乏性貧血、直腸診察異常などの警戒徴候を持つ対象者に対して、目標とする大腸内視鏡検査までの期間が設定されていますが、個々の症状は陽性的中率が低く、複数の症状を組み合わせてもリスクの増加はわずかであることが示されています。このため、年齢、性別、臨床的特徴を組み合わせた多変量リスクツールが開発されてきました。例えば、英国のプライマリケアで開発されたQCancer-Colorectalは、人口統計学的情報、特定の症状、家族歴などを含みますが、便潜血検査(FIT)は含まれておらず、迅速診断パスウェイでの有用性は確立されていません。便潜血検査(FIT)は、症状のある対象者の大腸がんリスクと強く関連する客観的な指標です。定量的なFIT値を臨床データと組み合わせたCOLONPREDICTやFASTスコアは、その開発環境において高い識別能力を示しています。また、血液検査のパターンに基づく機械学習モデルであるColonFlagも評価されています。しかし、これらのデジタルリスクツールには、迅速診断パスウェイに特化した利用における重要なギャップが存在します。多くのツールは、より低い大腸がん有病率のプライマリケアやスクリーニングコホートで開発されており、異なる集団に適用した場合の性能変化、経時的な絶対リスク推定値の変化、そしてFITが普遍的に利用できない、あるいは定量的ではなく二値の結果(陽性または陰性)のみが報告される健康システムにおける予測情報の減少などが課題でした。

研究の目的と方法

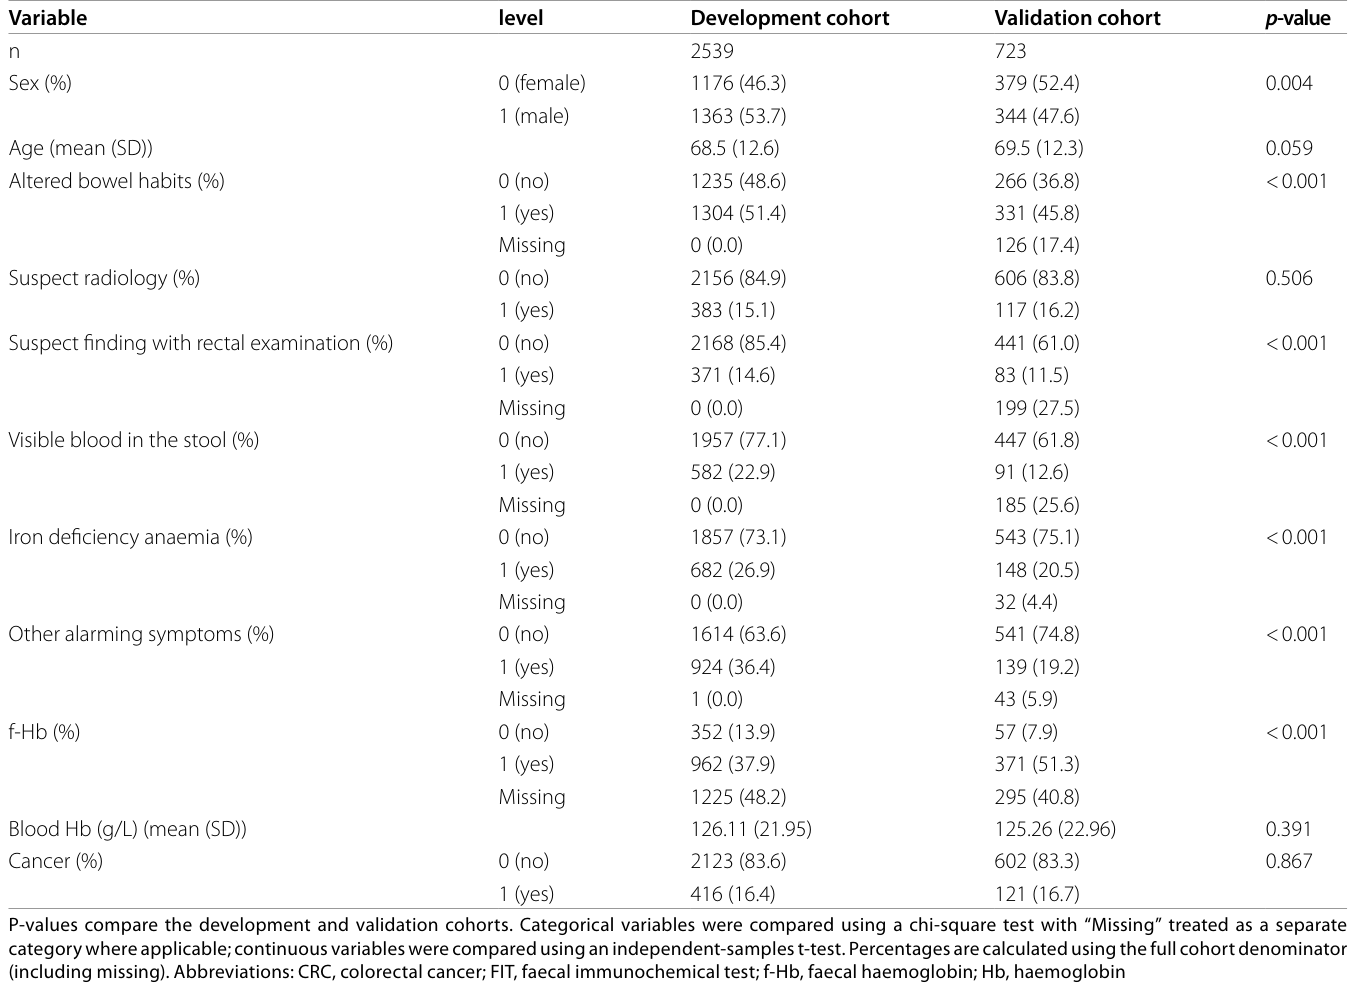
本研究の目的は、スウェーデンのSCC-CRCパスウェイを通じて紹介される対象者に対し、日常的に記録される紹介情報、利用可能なFITステータス、ヘモグロビン値、および放射線学的疑いを用いて、多変量大腸がんリスクモデルを開発し、外部検証することでした。研究はレトロスペクティブコホート研究として実施されました。開発コホートは2016年9月から2020年12月までにSCC-CRCパスウェイで大腸内視鏡検査を受けた2,539名の対象者、外部検証コホートは2021年2月から2022年2月までに同様のパスウェイで紹介された723名の対象者で構成されました。

Table 1
Table 1. Table 1 Characteristics of the development and validation cohorts Variable level Development cohort Validation cohort p-value n 2539 723 Sex (%) 0 (female) 1176 (46.3) 379 (52.4) 0.004 1 (male) 1363 (53.7) 344 (47.6) Age (mean (SD)) 68.5 (12.6) 69.5 (12.3) 0.059 Altered bowel habits (%) 0 (no) 1235 (48.6) 266 (36.8) < 0.001 1 (yes) 1304 (51.4) 331 (45.8) Missing 0 (0.0) 126 (17.4) Suspect radiology (%) 0 (no) 2156 (84.9) 606 (83.8) 0.506 1 (yes) 383 (15.1) 117 (16.2) Suspect finding with rectal examination (%) 0 (no) 2168 (85.4) 441 (61.0) < 0.001 1 (yes) 371 (14.6) 83 (11.5) Missing 0 (0.0) 199 (27.5) Visible blood in the stool (%) 0 (no) 1957 (77.1) 447 (61.8) < 0.001 1 (yes) 582 (22.9) 91 (12.6) Missing 0 (0.0) 185 (25.6) Iron deficiency anaemia (%) 0 (no) 1857 (73.1) 543 (75.1) < 0.001 1 (yes) 682 (26.9) 148 (20.5) Missing 0 (0.0) 32 (4.4) Other alarming symptoms (%) 0 (no) 1614 (63.6) 541 (74.8) < 0.001 1 (yes) 924 (36.4) 139 (19.2) Missing 1 (0.0) 43 (5.9) f-Hb (%) 0 (no) 352 (13.9) 57 (7.9) < 0.001 1 (yes) 962 (37.9) 371 (51.3) Missing 1225 (48.2) 295 (40.8) Blood Hb (g/L) (mean (SD)) 126.11 (21.95) 125.26 (22.96) 0.391 Cancer (%) 0 (no) 2123 (83.6) 602 (83.3) 0.867 1 (yes) 416 (16.4) 121 (16.7)解説: 開発コホートと検証コホートのベースライン特性を比較した表です。対象者の数、性別、年齢、症状、検査値、大腸がん有病率などが示されています。

は、開発コホートと検証コホートのベースライン特性をまとめたものです。両コホート間で多くのベースライン特徴が異なりますが、大腸がんの有病率はほぼ同じ(約16%)でした。年齢、性別、8つの症状、二値のFIT結果、ヘモグロビン、疑わしい画像所見が予測因子として使用されました。欠損値は開発段階で補完され、クラス不均衡はオーバーサンプリングで対処されました。ロジスティック回帰(LR)モデルと勾配ブースティングモデルであるCatBoostモデルが構築されました。モデルの性能は、AUC(曲線下面積)、キャリブレーション(予測リスクと観測リスクの一致度)、および決定曲線分析(DCA)によって評価されました。外部検証では、情報漏洩を避けるためSMOTEや欠損値補完は行わず、完全なケースのみが解析に用いられました。このため、モデルによって検証サンプルサイズが異なりました(モデルA: n=428; モデルB: n=661; モデルC: n=271; CatBoost: n=271)。

研究結果

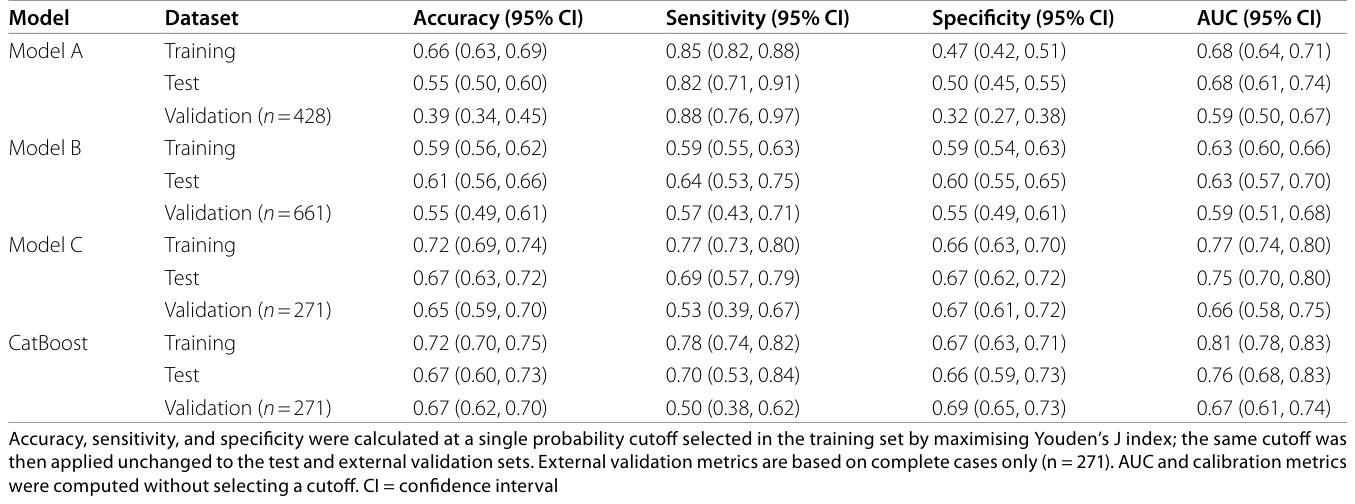
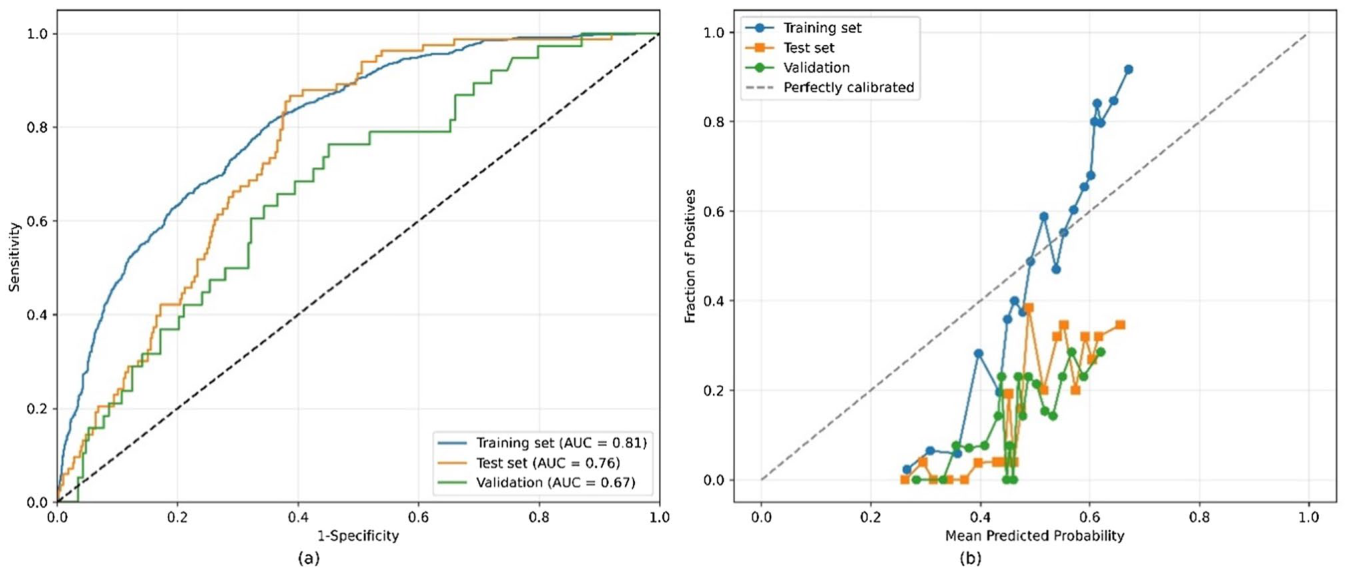
開発コホートにおけるAUCは、CatBoostで0.81(95% CI 0.78-0.83)、ロジスティック回帰で0.77(0.74-0.80)でした。外部検証では、それぞれ0.67(0.61-0.74)と0.66(0.58-0.75)と、識別能力は中程度でした。

Table 2
Table 2. Table 2 Performance metrics of the prediction models Model Dataset Accuracy (95% CI) Sensitivity (95% CI) Specificity (95% CI) AUC (95% CI) Model A Training 0.66 (0.63, 0.69) 0.85 (0.82, 0.88) 0.47 (0.42, 0.51) 0.68 (0.64, 0.71) Test 0.55 (0.50, 0.60) 0.82 (0.71, 0.91) 0.50 (0.45, 0.55) 0.68 (0.61, 0.74) Validation (n = 428) 0.39 (0.34, 0.45) 0.88 (0.76, 0.97) 0.32 (0.27, 0.38) 0.59 (0.50, 0.67) Model B Training 0.59 (0.56, 0.62) 0.59 (0.55, 0.63) 0.59 (0.54, 0.63) 0.63 (0.60, 0.66) Test 0.61 (0.56, 0.66) 0.64 (0.53, 0.75) 0.60 (0.55, 0.65) 0.63 (0.57, 0.70) Validation (n = 661) 0.55 (0.49, 0.61) 0.57 (0.43, 0.71) 0.55 (0.49, 0.61) 0.59 (0.51, 0.68) Model C Training 0.72 (0.69, 0.74) 0.77 (0.73, 0.80) 0.66 (0.63, 0.70) 0.77 (0.74, 0.80) Test 0.67 (0.63, 0.72) 0.69 (0.57, 0.79) 0.67 (0.62, 0.72) 0.75 (0.70, 0.80) Validation (n = 271) 0.65 (0.59, 0.70) 0.53 (0.39, 0.67) 0.67 (0.61, 0.72) 0.66 (0.58, 0.75) CatBoost Training 0.72 (0.70, 0.75) 0.78 (0.74, 0.82) 0.67 (0.63, 0.71) 0.81 (0.78, 0.83) Test 0.67 (0.60, 0.73) 0.70 (0.53, 0.84) 0.66 (0.59, 0.73) 0.76 (0.68, 0.83) Validation (n = 271) 0.67 (0.62, 0.70) 0.50 (0.38, 0.62) 0.69 (0.65, 0.73) 0.67 (0.61, 0.74)解説: 予測モデル(モデルA、B、C、CatBoost)の性能指標(精度、感度、特異度、AUC)を、トレーニング、テスト、外部検証の各データセットで示した表です。95%信頼区間も併記されています。

は、各予測モデルの精度、感度、特異度、AUCを示しています。CatBoostは内部評価でLRを上回りましたが、外部検証では最高のLRモデル(モデルC)と同等のAUCでした。

Figure 1
Figure 1. Fig. 1 Discrimination and calibration of the final CatBoost CRC risk model. (a) ROC curves. Performance is shown for the training set (n = 2 031), the inter­ nal test set (n = 508), and complete-case external validation in 2021-2022 (n = 271 out of 723, after excluding participants with missing predictor values). The dashed 45°-line marks chance discrimination (AUC = 0.5). (b) Calibration plot. For the same three datasets, each symbol represents the observed proportion of CRC within a decile of predicted risk (colours match panel a). The dashed 45° reference denotes perfect calibration; points below the line indicate risk over-estimation, points above indicate under-estimation. Overall, the model tends to overpredict lower risk and underpredict higher risks in training set and consistently overpredict risk in test and validation sets, with calibration slopes of 0.57, 0.55, and 0.48, respectively解説: (a)はROC曲線で、モデルの識別能力を示し、CatBoostモデルのトレーニングセット、テストセット、外部検証におけるAUC値が示されています。(b)はキャリブレーションプロットで、予測リスクと観測リスクの一致度を示しており、モデルが低リスクを過大に予測する傾向があることを表しています。

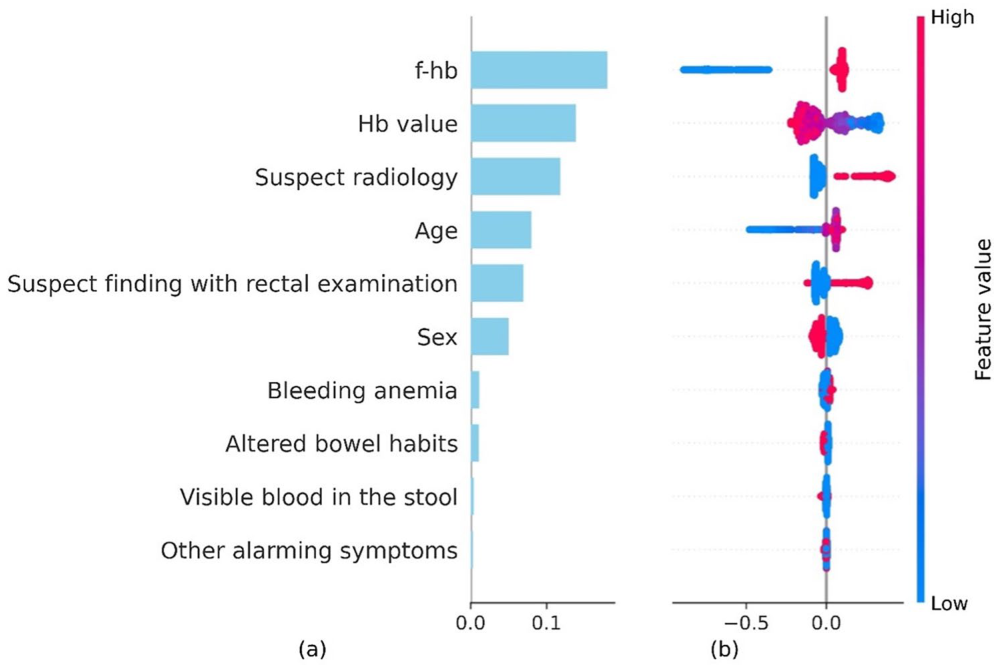
FITステータス、疑わしい画像所見、および年齢が主要な予測因子でした。

Figure 2
Figure 2. Fig. 2 SHAP summary plot illustrating the contribution of each feature to predictions of the final CatBoost model: (a) Mean absolute SHAP value for each feature, representing its overall importance in the model; (b) Distribution of SHAP values for individual instances: each point represents a single observa­ tion, with colour indicating the feature value (red = high, blue = low). SHAP values represent contributions on the model’s log-odds scale. Positive SHAP values correspond to an increased model prediction toward the positive class (e.g., CRC), while negative values correspond to a decreased prediction. The most influential features in the model are f-Hb, blood Hb (Hb-value), suspect radiology findings, and age解説: CatBoostモデルの予測に対する各特徴の寄与度をSHAP値で示したサマリープロットです。(a)は各特徴の平均絶対SHAP値で全体的な重要度を、(b)は個々の観測値に対するSHAP値の分布を示しており、色(赤は高値、青は低値)で特徴量の値を示しています。便ヘモグロビン(f-Hb)が最も影響力の高い特徴であることがわかります。

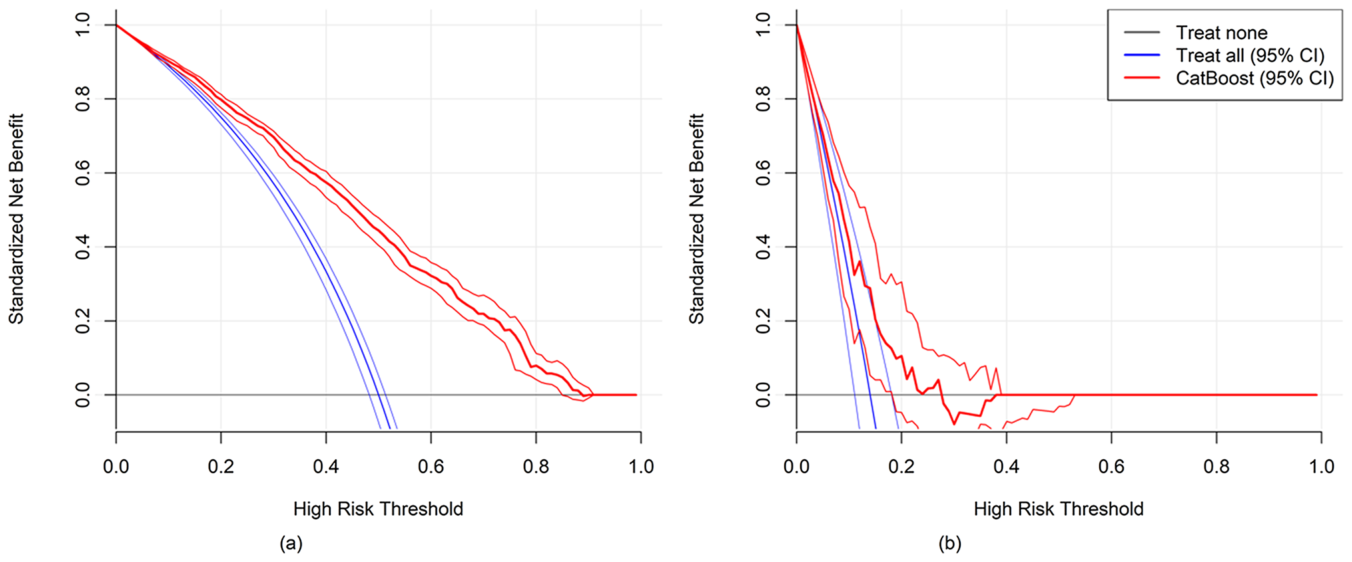
は、各特徴がCatBoostモデルの予測に与える影響をSHAP値で示しています。f-Hb(便ヘモグロビン)が最も寄与度が大きく、次いで低い血液ヘモグロビン値、疑わしい放射線学的所見、年齢が重要でした。予測リスクと観測リスクの一致度を示すキャリブレーションでは、キャリブレーションドリフト(系統的な過大予測)が観察されました。決定曲線分析(DCA)では、開発コホートにおいてCatBoostモデルは「全対象者を検査する」戦略よりも高い正味の利益を示しましたが、外部検証コホートでは95%信頼区間が「全対象者を検査する」ラインと重なり、明確な優位性は確認されませんでした。

Figure 3
Figure 3. Fig. 3 Decision curve analysis (DCA) of the final CatBoost CRC risk model in the (a) development and (b) external validation cohorts. Net benefit is shown across threshold probabilities for CatBoost, “Treat all” (refer all fast-track patients), and “Treat none”. Shaded bands show 95% confidence intervals from bootstrap resampling. Development cohort uses the internal test split from the 2016–2020 dataset; external validation cohort uses complete cases between 2021 and 2022 (n = 271)解説: CatBoostモデルの決定曲線分析(DCA)の結果です。(a)は開発コホート、(b)は外部検証コホートにおける正味の利益を示しており、CatBoostモデルと「全対象者を検査する」戦略、および「全対象者を検査しない」戦略を比較しています。

考察と今後の展望

便潜血検査(FIT)ステータス、単純な検査データ、および臨床的所見を組み合わせた多変量アプローチは、迅速診断パスウェイにおけるトリアージを支援しうることが示されました。しかし、外部検証における識別能力は中程度であり、全ての紹介対象者が大腸内視鏡検査を受けているため、現在のパスウェイの入り口ルール(全対象者を検査する戦略として機能)に対する優位性は示せませんでした。このモデルを臨床で実装する前には、地域を越えた外部検証、定量的なFIT値の記録、および定期的な再キャリブレーションが必要です。特に、スウェーデンのスクリーニングプログラムでは性別に応じたFITカットオフ値を使用しており、英国の症状のある対象者向けガイドラインで一般的な10 µg/gとは異なり、低い定量範囲の情報が失われることがモデルの性能を低下させる可能性が指摘されています。本研究の強みは、5年間にわたる全てのSCC-CRC大腸内視鏡検査データを分析し、外部検証を実施した点、および日常診療から抽出された予測因子を用いた点です。しかし、FITが全ての対象者にオーダーされていなかったこと、症状の記録が不十分であった可能性、およびCatBoostモデルの外部検証サンプルサイズが小さかったことが限界として挙げられます。全てのデータが一つのスウェーデン地域からのものであり、他の地域や医療システムでの汎用性についてはさらなる検証が必要です。スウェーデンの迅速診断パスウェイにおける多変量モデルは、より高リスクの対象者を特定できるものの、外部検証での性能は中程度でした。臨床で使用する前に、他の地域でのテスト、そして理想的には二値の結果ではなく定量的なFIT値へのアクセスが必要です。将来的には、予測因子の体系的な記録と十分な大腸がんイベント数を持つ、より大規模な前向きコホートでの外部検証が求められています。

用語集

  • 便潜血検査(FIT): 糞便中の血液の有無を調べる検査で、大腸がんのスクリーニングや診断に用いられる客観的な指標。
  • 迅速診断パスウェイ: 特定の警戒症状を持つ対象者を大腸内視鏡検査などの精密検査に迅速に誘導するための医療プロセス。
  • トリアージ: 医療資源の限られた状況において、対象者の重症度や緊急性に基づいて治療の優先順位を決定すること。
  • CatBoost: 決定木に基づく勾配ブースティング機械学習アルゴリズムの一つで、特に混合型のデータやカテゴリ変数に強い。
  • AUC(曲線下面積): 予測モデルの識別能力(正例と負例をどれだけうまく区別できるか)を示す指標。値が高いほど性能が良い。
  • キャリブレーション: 予測モデルが出力する確率(予測リスク)と、実際に観測されるイベントの頻度(観測リスク)がどれだけ一致しているかを示す指標。
  • 決定曲線分析(DCA): 予測モデルの臨床的有用性を評価するための手法で、異なる介入閾値での正味の利益を比較する。
  • 特異度: 疾患のない対象者を正しく疾患がないと判断する割合。偽陽性を避ける能力。
  • 陽性的中率: 検査で陽性となった対象者の中で、実際に疾患がある対象者の割合。
powered by visionary imaging services, inc.
免責事項

発行 Beyond the Pixel 編集部(Visionary Imaging Services, Inc.)

編集責任者 小林 達明(診療放射線技師/博士(情報学)) ORCID

本記事は生成 AI を用いて作成しています。公開後に気づいた誤りは編集部が随時修正します。

論文の引用・解釈の方針は免責事項をご覧ください。

コメントを残す

メールアドレスが公開されることはありません。 ※ が付いている欄は必須項目です