
医療音声認識AIの精度と安全性:外科症例報告における詳細分析
解説対象論文: A Controlled Single-Speaker Evaluation of Ambient Voice Technologies’ Speech-to-Text Function Using Narrated Surgical Case-Reports
Journal of Medical Systems|被引用数: 0(2026年10月11日時点)
医療現場での文書作成負担は、専門家の疲弊やケアの質の低下につながる深刻な問題です。この負担を軽減し、効率を高めるツールとして、AIを活用したアンビエント音声技術(AVT)が期待されています。しかし、その精度と安全性に関する厳密な評価はまだ十分ではありません。本記事では、最新の研究論文を基に、AVTが外科症例報告の文字起こしにおいてどれほど正確であり、潜在的な臨床的エラーがどの程度発生するのかを詳細に解説します。
医療現場を変革する音声認識AIの可能性と課題
どうも、Beyond the Pixelです。医療現場における文書作成の負担は、専門家の燃え尽き症候群や質の高いケアの低下につながる深刻な問題です。この負担を軽減し、効率を高めるツールとして、AIを活用したアンビエント音声技術(AVT)が注目されています。AVTは、自動音声認識(ASR)と生成AIを組み合わせることで、話された言葉をテキストに変換し、臨床文書を作成するものです。しかし、その精度と安全性のエビデンスはまだ限られており、特に外科領域でのデータは不足していました。本日の記事では、Journal of Medical Systemsに掲載されたオープンアクセス論文「A Controlled Single-Speaker Evaluation of Ambient Voice Technologies’ Speech-to-Text Function Using Narrated Surgical Case-Reports」を基に、AVTの音声からテキストへの変換機能の精度と、それに伴う潜在的なリスクについて深く掘り下げていきます。この研究では、対象者安全を最優先事項として、外科症例報告をナレーションとして使用した制御された単一話者評価が行われました。
研究の背景と評価システム
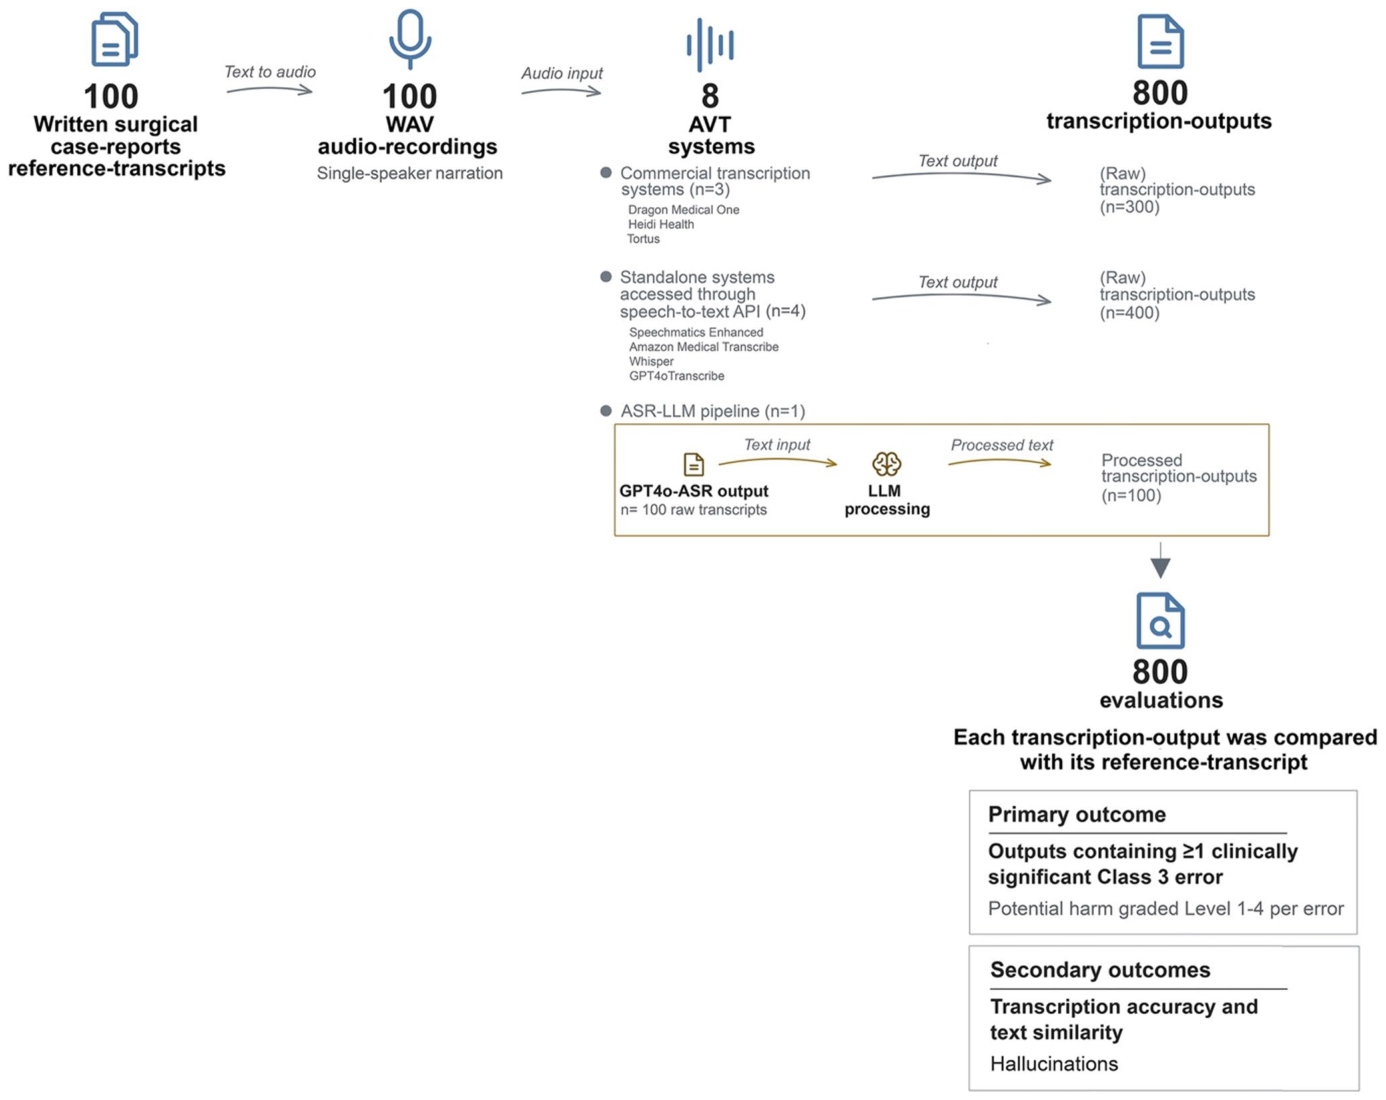
この研究は、AVTの音声テキスト変換機能の評価を目的としています。特に、臨床的に重大なエラーの発生割合を主要評価項目とし、潜在的な危害の程度を評価しました。研究チームは、以下の8種類のAVTシステムを調査しました。
- 商用文字起こしシステム(3種類): Dragon Medical One、Heidi Health、Tortus
- ASR音声テキスト変換API(4種類): Speechmatics Enhanced、Amazon Medical Transcribe、Whisper、GPT4o Transcribe
- 実験的な2段階ASR-LLMパイプライン(1種類): GPT4o Transcribeの出力をGPT-5大規模言語モデル(LLM)で生成的にエラー修正する「GPT4o Transcribe-Corrected-5」
評価には、オープンアクセス外科ジャーナルから抽出された100件の外科症例報告書が参照テキストとして使用されました(合計32,897語、1件あたり平均329語)。これらの報告書は単一の話者によって読み上げられ、WAV形式の音声記録としてAVTシステムに入力され、テキスト出力が生成されました。生成された800件のテキスト出力が分析の対象となりました。
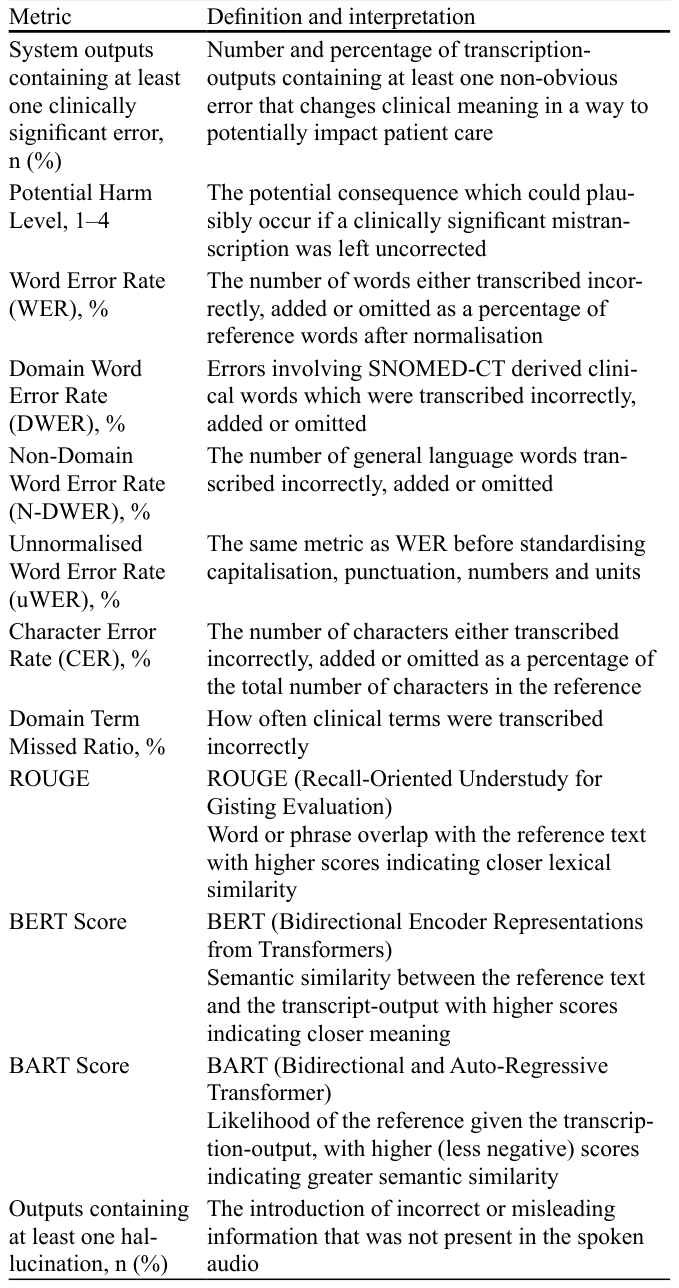
評価指標は多岐にわたりました。主要評価項目は、少なくとも1つの臨床的に重大なClass 3エラー(意味を微妙に変化させ、直ちに気づきにくいエラー)を含むテキスト出力の割合でした。副次評価項目としては、転写精度(SNOMED-CTに基づくDomain-Word-Error-Rate (DWER)、語彙的精度(ROUGEスコア)、意味的類似性(BERT、BARTスコア)などが含まれます。これらの評価指標は、AVTシステムが医療文書においてどれだけ正確であるかを多角的に測るために重要です。
重大な臨床エラーの実態:システム間の性能差
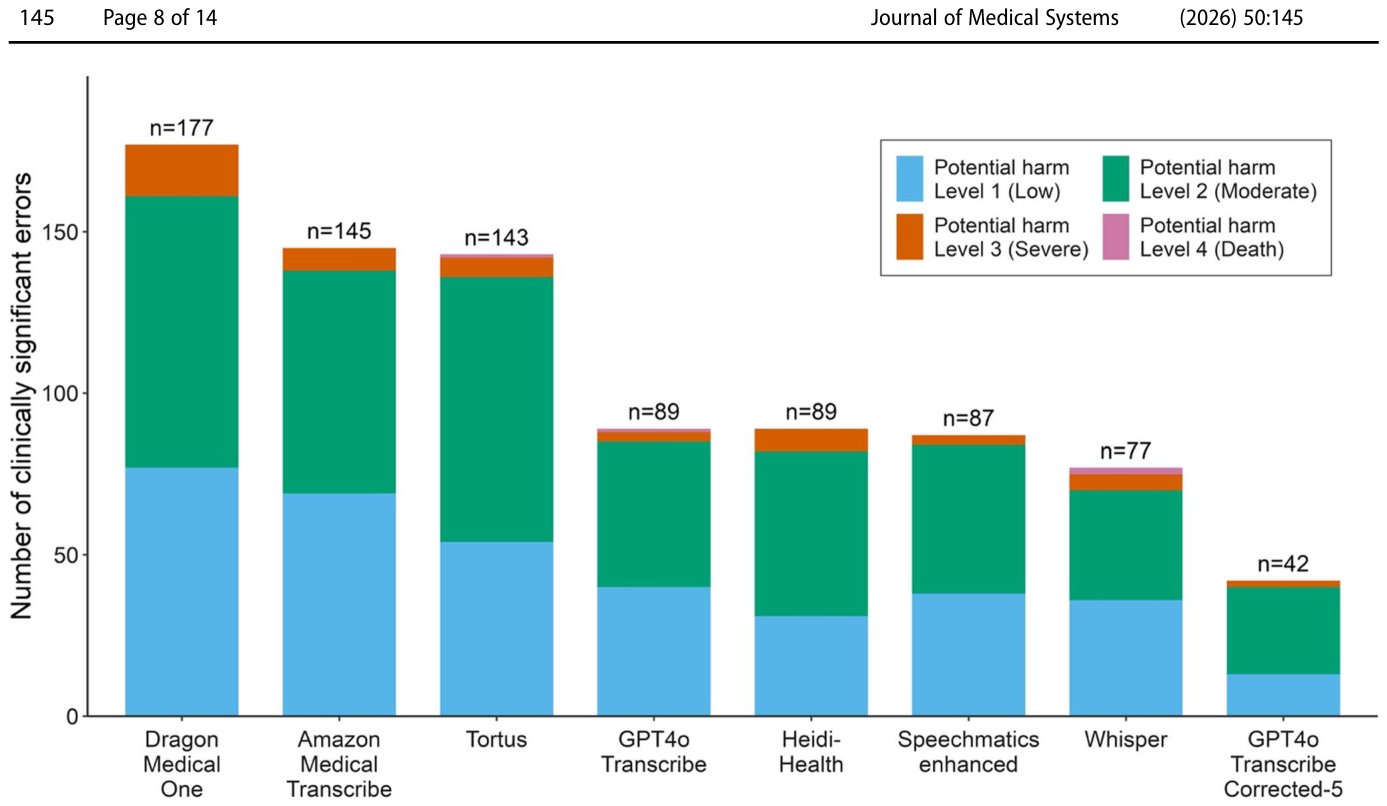
この研究の結果は、AVTシステムの臨床的に重大なエラーに関して驚くべき洞察を提供しています。800件のテキスト出力全体で、少なくとも1つの臨床的に重大なClass 3エラーを含む割合は、システム間で30%から68%と大きく変動しました。最も少なかったのは実験的な「GPT4o Transcribe-Corrected-5」の30%で、最も多かったのは「Amazon Medical Transcribe」と「Dragon Medical One」の68%でした。
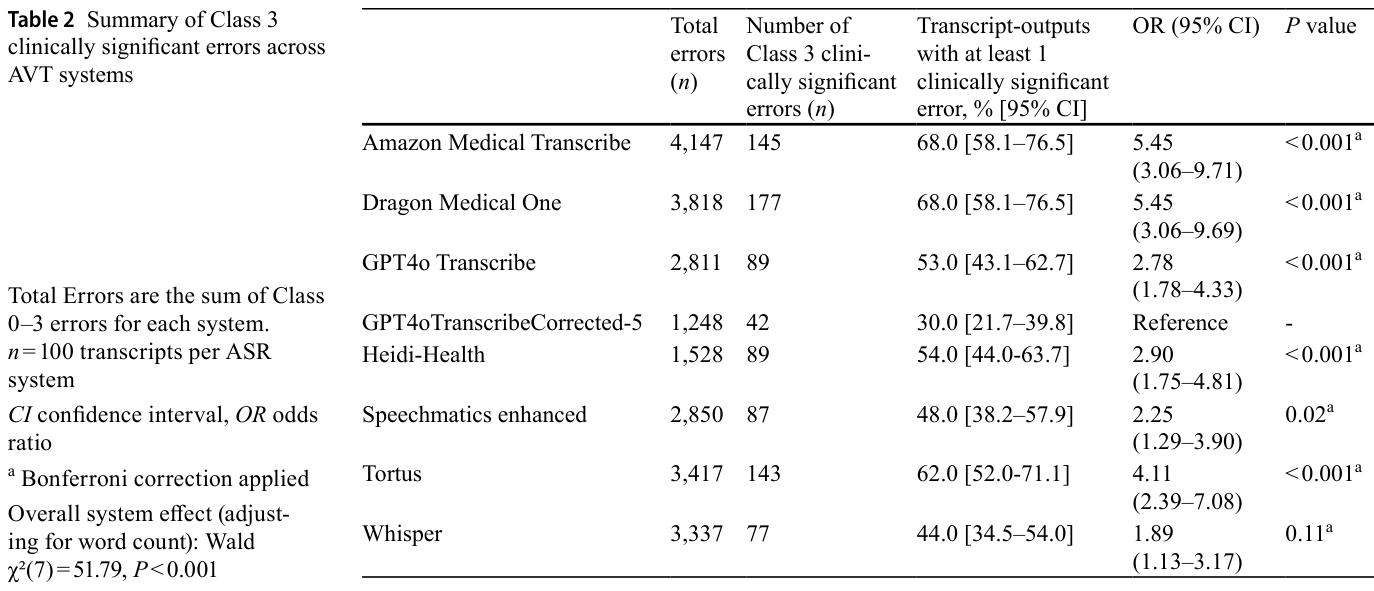
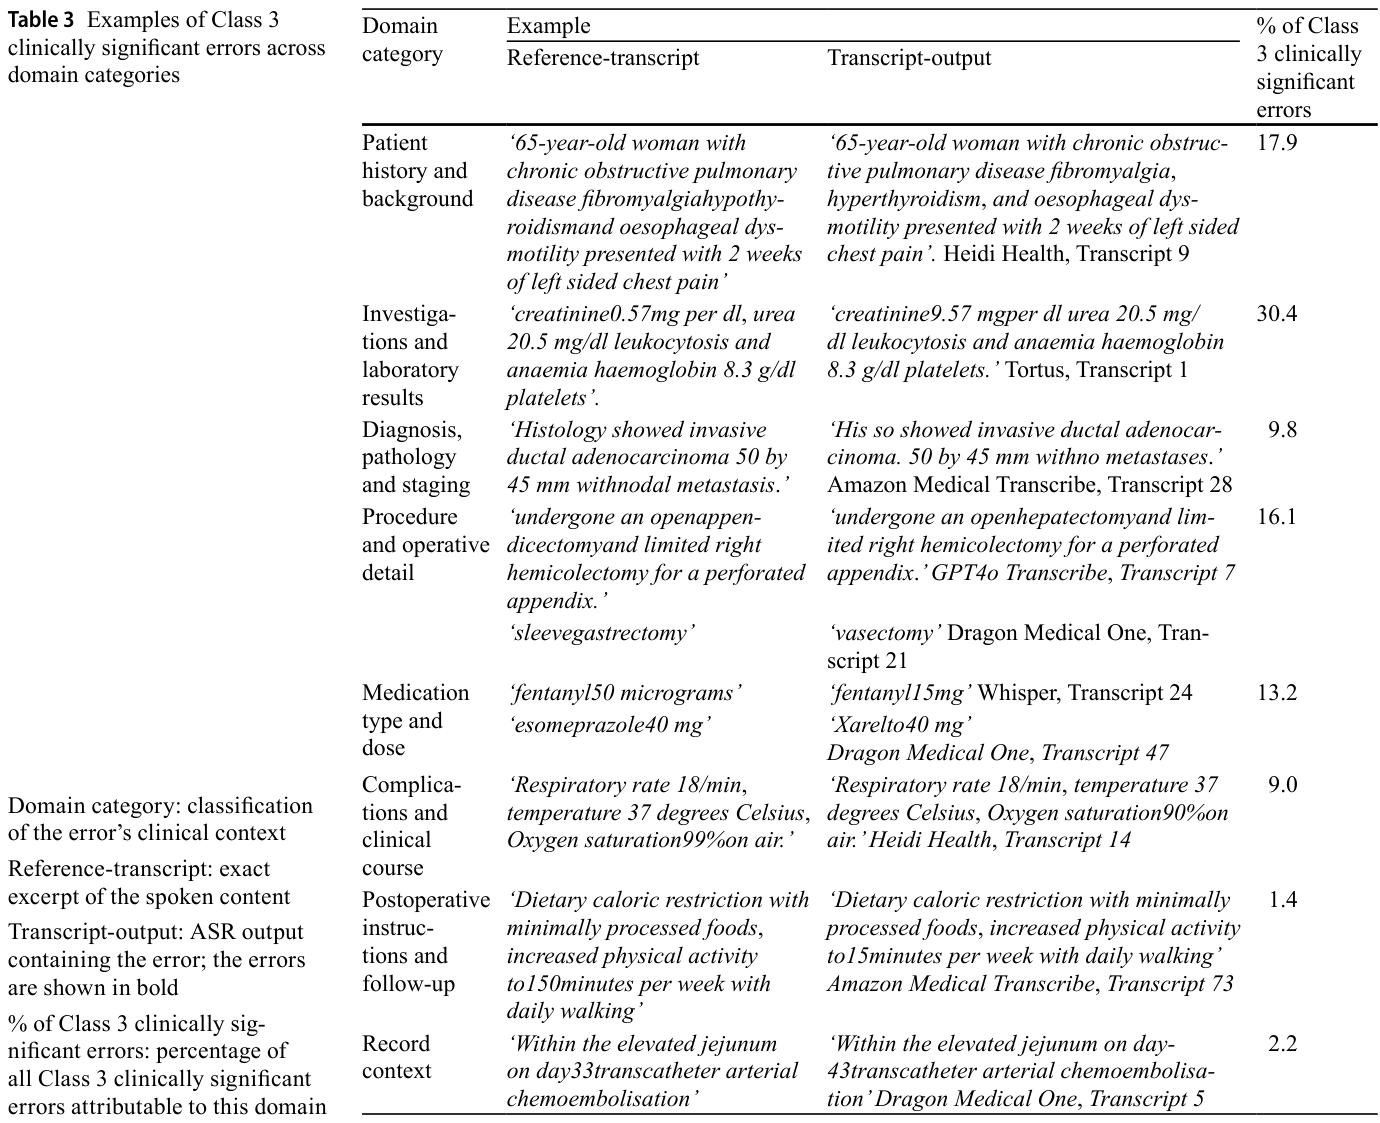
特筆すべきは、LLM処理の効果です。生のASR出力(GPT4o Transcribe)では53%のテキスト出力に臨床的に重大なエラーが含まれていましたが、LLM処理(GPT4o Transcribe-Corrected-5)によってこの割合は30%に減少しました。生のASR出力における89件の臨床的に重大なエラーのうち、51件(57.3%)はLLM処理によって解消されました。しかし、38件(42.7%)は依然として臨床的に重大なエラーとして残り、さらに4件の新たな臨床的に重大なエラーがLLM処理によって導入されたことも明らかになりました。例えば、「malformation(奇形)」が「malignant(悪性)」に置き換わるなどの事例が報告されています。これは、AIによる修正が必ずしも完璧ではなく、新たなリスクを生む可能性を示唆しています。エラーの例としては、薬の種類や用量、検査結果などの数値に関するものが多く見られました。
危害の潜在性とエラーの種類
この研究では、エラーが対象者に与える潜在的な危害の程度も評価されています。 severe(重度)またはdeath(死)につながる可能性のあるエラー(NHSイングランドレベル3-4)は、全システム合計で53件に上りました。これらのエラーは、薬の種類/用量(39.6%)と検査/臨床検査結果(30.2%)の領域に集中していました。これは、特にこれらの情報が正確に記録されることの重要性を浮き彫りにしています。
転写精度と語彙的・意味的類似性
転写精度に関する指標(WER、DWER、N-DWER、uWER、CER)では、システム間で有意な差が見られました。実験的な「GPT4o Transcribe-Corrected-5」パイプラインは一貫して最も低い中央値エラー率を達成し、次いでHeidi Healthが良好な成績を示しました。対照的に、「Amazon Medical Transcribe」は全体的に最も悪い結果となりました。特に、DWER(医療専門用語のエラー率)では、「GPT4o Transcribe-Corrected-5」が3.60%、「Heidi Health」が5.67%と優れた性能を示したのに対し、「Amazon Medical Transcribe」は24.03%と著しく高いエラー率でした。
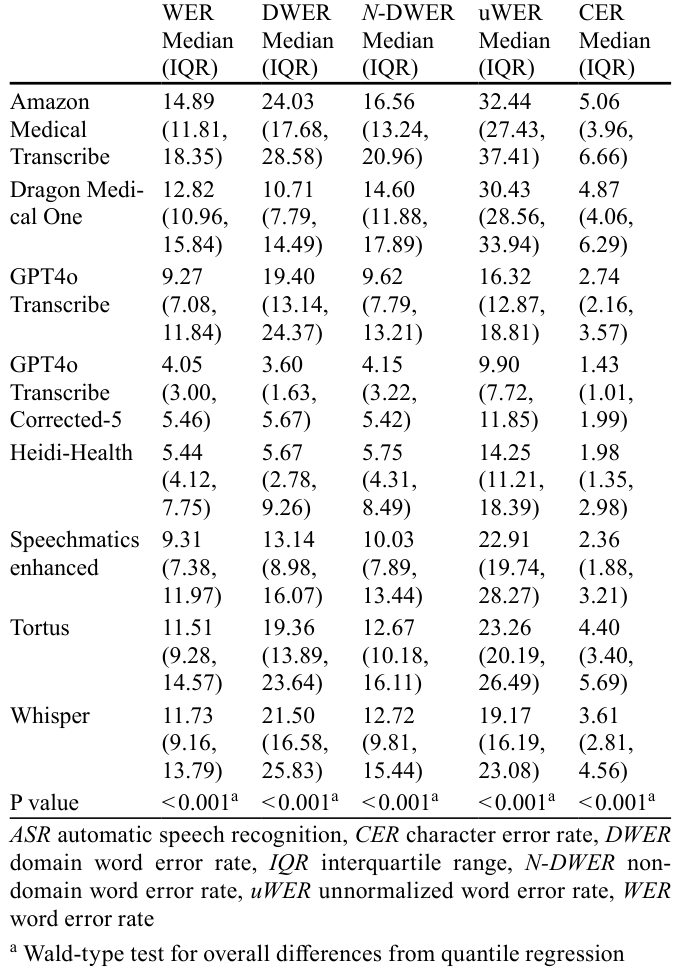
多くのシステムで、DWERがN-DWER(一般言語のエラー率)よりも有意に高かったことは、AVTが専門用語の文字起こしにより大きな困難を抱えていることを示しています。しかし、「Dragon Medical One」は反対のパターンを示し、一般言語と比較して医療専門用語の転写でより強い性能を発揮しました。これは、医療辞書に特化してトレーニングされた製品であることと一致しています。「GPT4o Transcribe-Corrected-5」と「Heidi Health」では、DWERとN-DWERの間に有意な差は見られませんでした。
語彙的類似性(ROUGEスコア)と意味的類似性(BERT、BARTスコア)に関しても、「GPT4o Transcribe-Corrected-5」が最も高い類似性を示し、次いで「Heidi Health」が良好な結果を出しました。
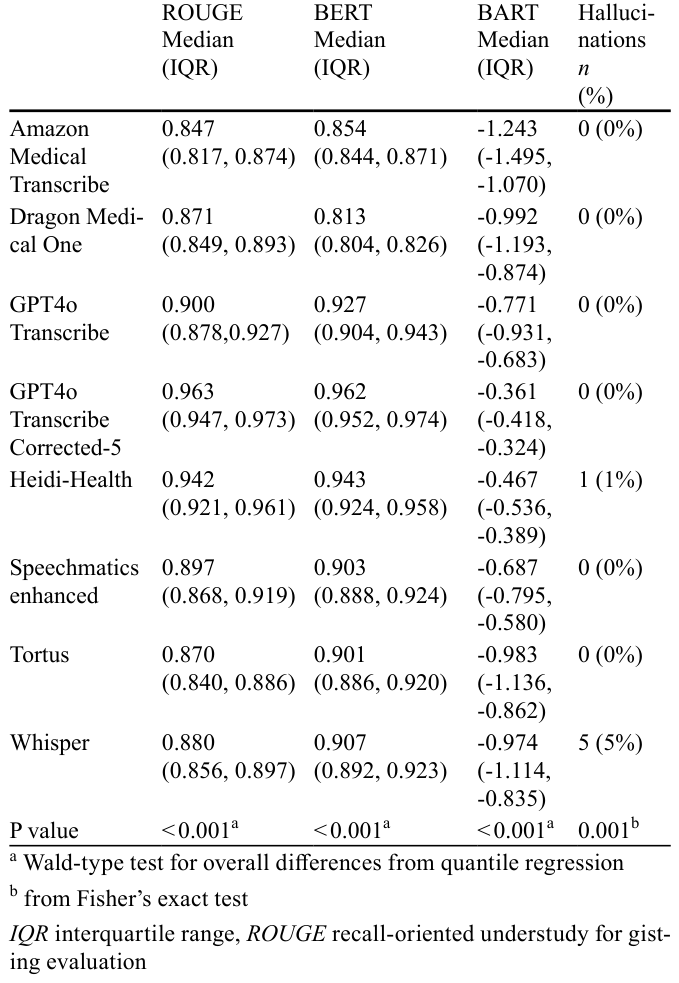
これは、単語レベルの正確性だけでなく、テキスト全体の意味の正確性においても、これらのシステムが優れていることを示しています。
また、幻覚(Hallucinations:音声にはない内容の誤った情報が生成されること)は、「Whisper」で5件、「Heidi Health」で1件発生しましたが、他のシステムでは観察されませんでした。幻覚は、臨床的解釈を大きく歪める可能性があるため、対象者安全にとって重大な問題です。
研究の限界と今後の展望
この研究は、AVTの音声テキスト変換機能の精度と安全性を詳細に評価した重要なものですが、いくつかの限界も存在します。
- 単一話者での評価: 外科症例報告を単一の話者がナレーションしたため、実際の多忙な臨床現場におけるアクセントの多様性、複数の話者、割り込み、バックグラウンドノイズといった要因が反映されていません。これにより、実際の現場でのエラー率は過小評価されている可能性があります。
- 音声テキスト変換に限定: ライブ診察のエンドツーエンドのアンビエント書き起こしではなく、音声からテキストへの変換部分に焦点を当てています。そのため、LLMによる要約機能によって導入される可能性のある追加のエラーモードは捕捉されていません。
- 専門性への限定: 語彙が異なる可能性のあるすべての医療専門分野への一般化は限定的です。これらの知見は、制御された条件下での外科臨床文書のナレーションに特化したものと解釈すべきです。
これらの限界を踏まえ、今後の研究では、外来診療、病棟回診、手術室など、実際の臨床現場での前向き評価や、AVTのエンドツーエンド評価(最終的な記録の質や、専門家による修正時間や臨床的に重大なエラーの修正負担など)に焦点を当てる必要があります。また、薬の用量、検査値、左右の区別、術式などの高リスクな内容に注意を促すユーザーインターフェースの開発など、臨床文書エラーを防ぐための実践的な緩和策にも取り組むべきでしょう。
結論として、AVTの音声テキスト変換機能の精度はシステムによって大きく異なり、テストされたすべてのシステムで臨床的に重大なエラーが確認されました。これらのエラーはテキスト記録の質と安全性に影響を与え、対象者に危害を及ぼす可能性があります。臨床現場でのこれらのシステムの安全性と有効性には、専門家が文字起こし出力を確認する役割を含め、さらなる評価が不可欠です。
用語集
- AVT (Ambient Voice Technologies): 自動音声認識と生成AIを組み合わせ、話された言葉をテキストに変換し、臨床文書を作成する技術。
- ASR (Automatic Speech Recognition): 話された言語を文字に変換するプロセス。AVTの音声テキスト変換コンポーネントを形成する。
- LLM (Large Language Model): 大量のテキストデータで学習された、人間のようなテキストを生成・理解できるAIモデル。生成AIの一種。
- Class 3エラー: 意味を微妙に変化させる転写エラーで、直ちには気づきにくいもの。臨床的に重大な場合は対象者ケアに影響する可能性。
- WER (Word Error Rate): 転写の全体的な正確さを数量化する指標。誤って転写された、追加された、または省略された単語の割合。
- DWER (Domain Word Error Rate): WERを拡張し、医療専門用語(SNOMED-CT由来の単語)に関連するエラーに焦点を当てた指標。
- ROUGE (Recall-Oriented Understudy for Gisting Evaluation): テキストの語彙的類似性を評価するスコア。参照テキストとの単語やフレーズの重複度を測る。
- BERT Score (Bidirectional Encoder Representations from Transformers): 参照テキストと転写出力間の意味的類似性を測定するスコア。高いほど意味が近いことを示す。
- BART Score (Bidirectional and Auto-Regressive Transformer): 参照テキストが転写出力から導き出される可能性を評価するスコア。高いほど意味的類似性が高いことを示す。
- Hallucinations (幻覚): 音声には存在しない、誤った、または誤解を招く情報がテキスト出力に導入される現象。
- SNOMED-CT (Systematized Nomenclature of Medicine Clinical Terms): 電子カルテで利用される臨床用語の体系化された国際標準医療用語集。
コメントを残す