
再現可能な合成臨床レターによるてんかん発作頻度情報抽出の革新
解説対象論文: Reproducible synthetic clinical letters for seizure frequency information extraction
Journal of Biomedical Informatics|被引用数: 0(2026年10月3日時点)
てんかん発作の頻度情報は、研究や臨床意思決定において極めて重要ですが、診療録の自由記述テキストに多岐にわたる形式で記載されており、共有や大規模なアノテーションが困難でした。本研究は、機密性の高い対象者データを用いることなく、再現可能でプライバシー保護に配慮した発作頻度情報抽出フレームワークを開発することを目指しています。完全に合成された臨床レターを教師データとして大規模言語モデル(LLMs)を訓練し、その有効性を実世界の診療録で検証した画期的な取り組みについて解説します。
はじめに:てんかん発作頻度抽出の課題
どうも、Beyond the Pixelです。てんかんは一般的な神経疾患であり、世界的に障害や早期死亡の主要な原因となっています。日常の診療と研究の両方において、発作頻度は疾患のコントロールと治療反応を示す最も頻繁に使用される指標の一つです。しかし、多くの発作は目撃されなかったり、意識障害を伴ったりするため、発作の数を正確に数えることは本質的に困難です。また、現実世界の文書記録は不完全であったり一貫性がなかったりすることが報告されています。現代の医療システムでは、発作頻度に関する情報は、神経内科の診療録のような非構造化された臨床ナーラティブ(自由記述形式の記録)に埋め込まれています。これらの文書には、豊富な文脈的詳細が含まれていますが、発作頻度の情報は非常に多様な言語形式で表現されます。例えば、「週に2回」のような明示的な頻度、「月に4~5回」のような数値範囲、「複数」「時々」といった曖昧な数量詞、「6ヶ月間発作なし」のような発作のない期間、あるいは「月に2回群発、各3回」のような群発性パターンなどがあります。さらに、頻度の記述は「前回診察時以降」といった暗黙的な参照点に基づいていることが多く、正確な解釈のためには文そのものを超えた文脈情報が必要です。このため、手作業による情報抽出は労力を要し、大規模な適用は困難です。これまでの研究では、従来の自然言語処理(NLP)パイプラインや機械学習手法を用いて、電子カルテからてんかんの発作転帰を抽出できることが示されてきました。近年では、大規模言語モデル(LLMs)を用いたてんかん関連変数の抽出も模索されていますが、発作頻度をロバストに抽出することは依然として課題です。これは、時間の正規化、暗黙的な時間窓の推論、および現実世界の臨床文書に頻繁に見られるデータ欠損や曖昧な表現への堅牢性が必要とされるためです。高性能な臨床NLPシステムには、通常、大量の代表的な訓練データと慎重な評価が不可欠です。しかし、臨床テキストの広範な再利用と公開は、プライバシー保護とガバナンスの要件によって制限されています。匿名化の手法は大幅に進歩しましたが、完璧ではなく、依然としてリスクを残す可能性があります。特にLLMの開発では、訓練規模とモデル容量がデータの記憶化と漏洩リスクを増幅させる可能性があるため、これらの制約はより顕著になります。これらの限界に対処するため、機密性の高い対象者テキストを配布せずに再現可能な研究を可能にする補完的な戦略として、合成臨床テキストが登場しました。合成ノートが下流のNLPタスクにおいて測定可能な有用性を持つこと、および実際のノートに転送できる臨床LLMの訓練に利用できることが示されています。しかし、発作頻度抽出のようにフレーズや時間的論理に敏感なタスクでは、合成データが「タスクに忠実」(実際の文書パターンを反映している)であり、「ラベルに忠実」(臨床的に意味のある正規化と整合した信頼できる監視を提供している)であることが不可欠です。本研究は、この課題に取り組んでいます。
合成データフレームワークの詳細
本研究は、現実世界の対象者テキストへの依存を減らしつつ、診療録の記述から発作頻度情報を確実に抽出するという、実践的で臨床的に意味のある目標を掲げています。この目的のため、著者らは完全に合成されたNHS(英国国民保健サービス)スタイルの診療録のコーパスを構築しました。このフレームワークの全体像は
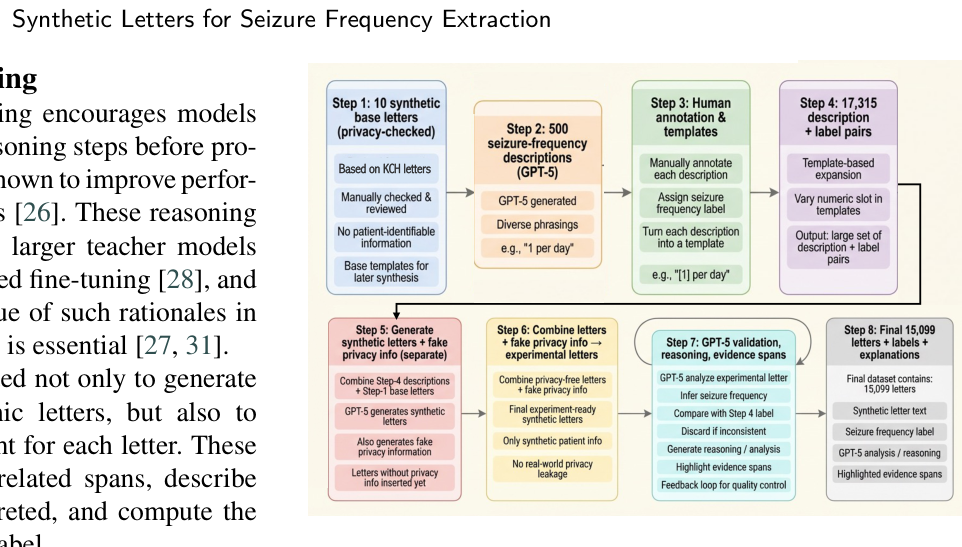
に示されています。このプロジェクトは、英国保健研究局(HRA)ロンドン南東研究倫理委員会からの承認を得て、キングス電子記録研究インターフェース(KERRI)の下で実施されました。本研究では、オープンウェイトの大規模言語モデル(LLMs)に焦点を当てました。これらのモデルは、病院の内部システム内で完全に実行でき、インターネット接続を必要としないため、プライバシー保護と安全な展開が可能です。計算上の実現可能性と強力なモデリング能力のバランスをとるため、4~140億パラメータの範囲にある比較的小規模から中規模のオープンソースモデルが訓練またはファインチューニング(微調整)されました。本研究と以前の研究との大きな違いは、GPT-5を高性能な教師モデルとして組み込んでいる点です。GPT-5は直接展開されず、その強力な推論および生成能力を活用して、現実世界での展開に適した軽量モデルの訓練とドメイン適応をサポートする高品質な合成データやアノテーション(情報付与)を生成するために使用されました。データソースとして、キングス・カレッジ病院(KCH)の25,000件以上の電子カルテにアクセスしました。成人てんかん診療に焦点を当てるため、てんかん診断を受けた18歳以上の対象者の電子カルテのみを含めました。これらの記録から1,781件の診療録が詳細なアノテーションのために選択され、うち300件は二重チェック手順を経てゴールデンスタンダードのテストセットとして確保されました。これに加えて、GPT-5を教師モデルとして使用し、15,099件の合成NHSスタイル神経内科診療録を生成しました。これらの合成レターは、実際の診療録の構造と言語的特徴を模倣していますが、実際の対象者情報は含まれていません。合成データフレームワークの構築は以下のステップで行われました。まず、ステップ1で10件のプライバシーが確認された合成「ベースレター」を作成しました。これらは実際のKCH診療録に基づき、識別可能な情報を手動で編集・削除したものです。次に、ステップ2でGPT-5を用いて500件の多様な発作頻度記述を生成し、専門家が発作負荷を自然に表現する方法を幅広くカバーしました。ステップ3では、人間がこれらの記述を読み、対応する発作頻度ラベルを割り当て、後でランダムにインスタンス化されるスロットを持つパラメトリックテンプレートに書き換えました。ステップ4では、これらのテンプレートを体系的にインスタンス化し、17,315件の最終的な(記述、ラベル)ペアを得ました。ステップ5と6では、これらの記述・ラベルペアを完全な診療録に変換しました。ステップ5で、GPT-5はベースレターと合成記述に基づいて新しいレターをドラフトし、元の発作関連の段落を新しい記述に置き換え、一致する合成の人口統計学的詳細(氏名、住所など)を生成しました。これらのプライバシーに類似するフィールドは、この段階ではレター本体から分離されました。ステップ6では、制御された後処理ステップを実行し、レターテキスト内のプレースホルダー(@NAME@など)を個別に生成された合成詳細で置き換え、最終的な実験準備済みのレターを作成しました。この設計により、生成された識別子が実際の識別子に似ていたとしても、公開データセットには表示されないため、プライバシーリスクを完全に排除できます。最後にステップ7では、完成した合成レターが再度GPT-5に送られ、発作頻度ラベルを推論し、根拠となる証拠スパン(参照箇所)を含む短い自由記述の説明を提供するよう求められました。ステップ4の正解ラベルと推論されたラベルが完全に一致するレターのみが保持され、その他は破棄されました。これにより、15,099件の合成レターの最終データセットが得られました。この反復検証とフィルタリングプロセスにおける破棄されたインスタンスの数は
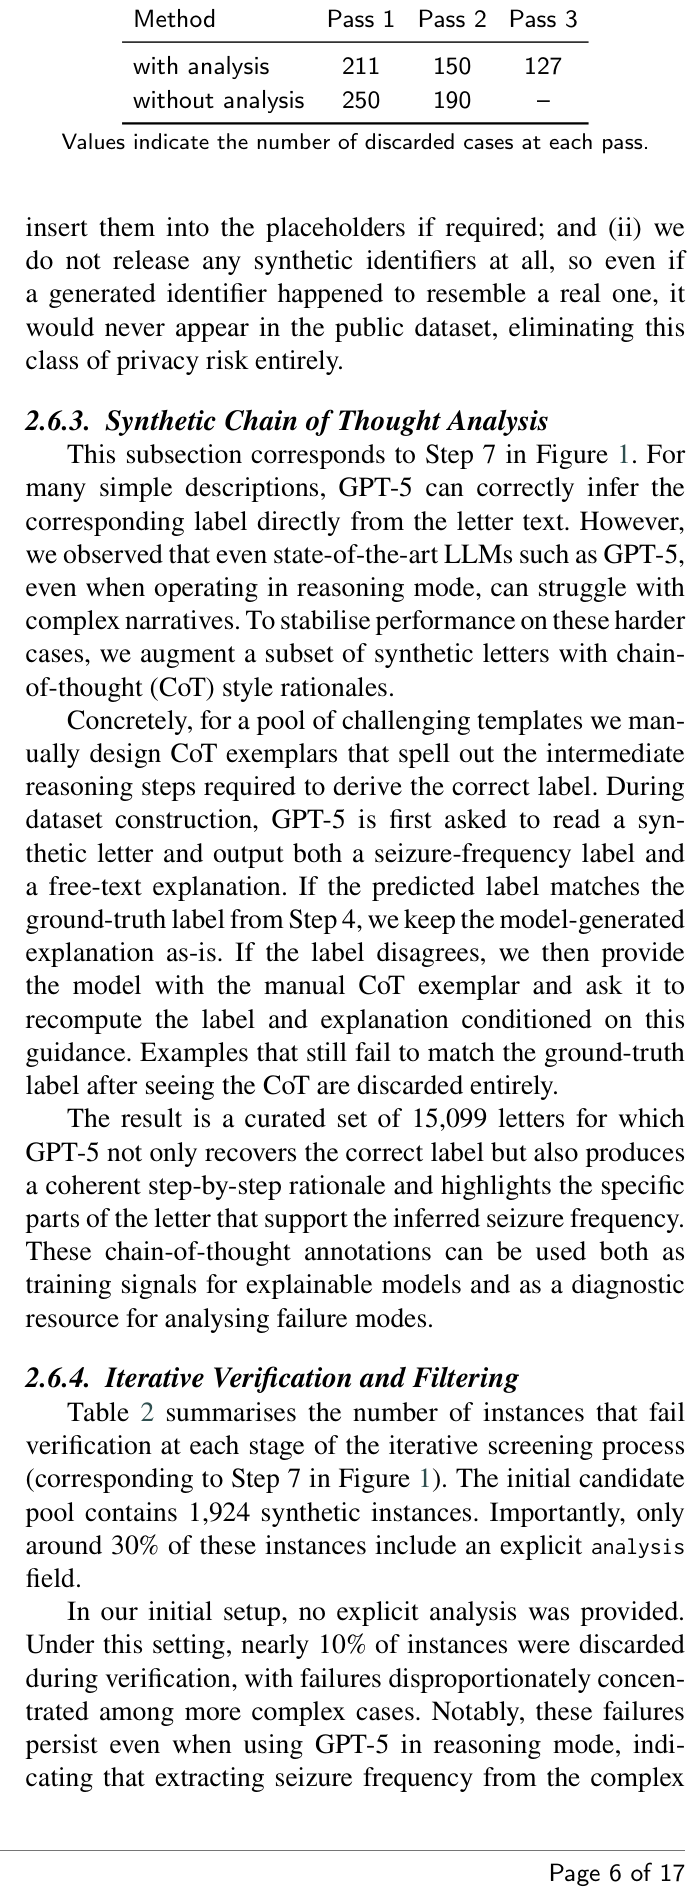
にまとめられています。複雑なインスタンスに対して明示的な分析指導を導入することで、検証段階で破棄されるインスタンスの数を一貫して減らすことができ、より困難な例を最終データセットに保持できるようになりました。また、本研究では、推論ステップを明示的に生成することで、多段階推論タスクの性能を向上させる「思考の連鎖(Chain-of-Thought, CoT)プロンプティング」を活用しました。GPT-5は合成診療録を生成するだけでなく、各レターに対して構造化された思考の連鎖も生成しました。これらのCoTは、発作関連スパンを特定し、時間情報をどのように解釈するかを記述し、最終的な正規化された発作頻度ラベルを計算します。これらのGPT-5が生成したCoTは、オープンウェイトモデルのファインチューニング時の監視シグナルとして使用されました。これにより、小規模なモデルが最終的な予測だけでなく、教師モデルがどのように根拠を臨床テキストに基づかせているかを学習できるようになります。モデルの出力形式は、以下の4種類が比較されました。(1)数値回帰形式(1ヶ月あたりの発作数)、(2)4分類カテゴリ形式(大まかな頻度分類)、(3)構造化ラベル形式(セクション2.6.1で定義されたラベルスキーム)、(4)CoT + ラベル + 根拠形式(構造化ラベルに加えて、思考の連鎖と根拠となるテキストスパン)。この多様な出力形式は、訓練の安定性、評価のしやすさ、臨床的解釈可能性の間のトレードオフを体系的に比較するために設計されました。評価にあたっては、予測された発作頻度出力を、臨床専門家がアノテーションしたゴールデンスタンダードのラベルと比較しました。これは、
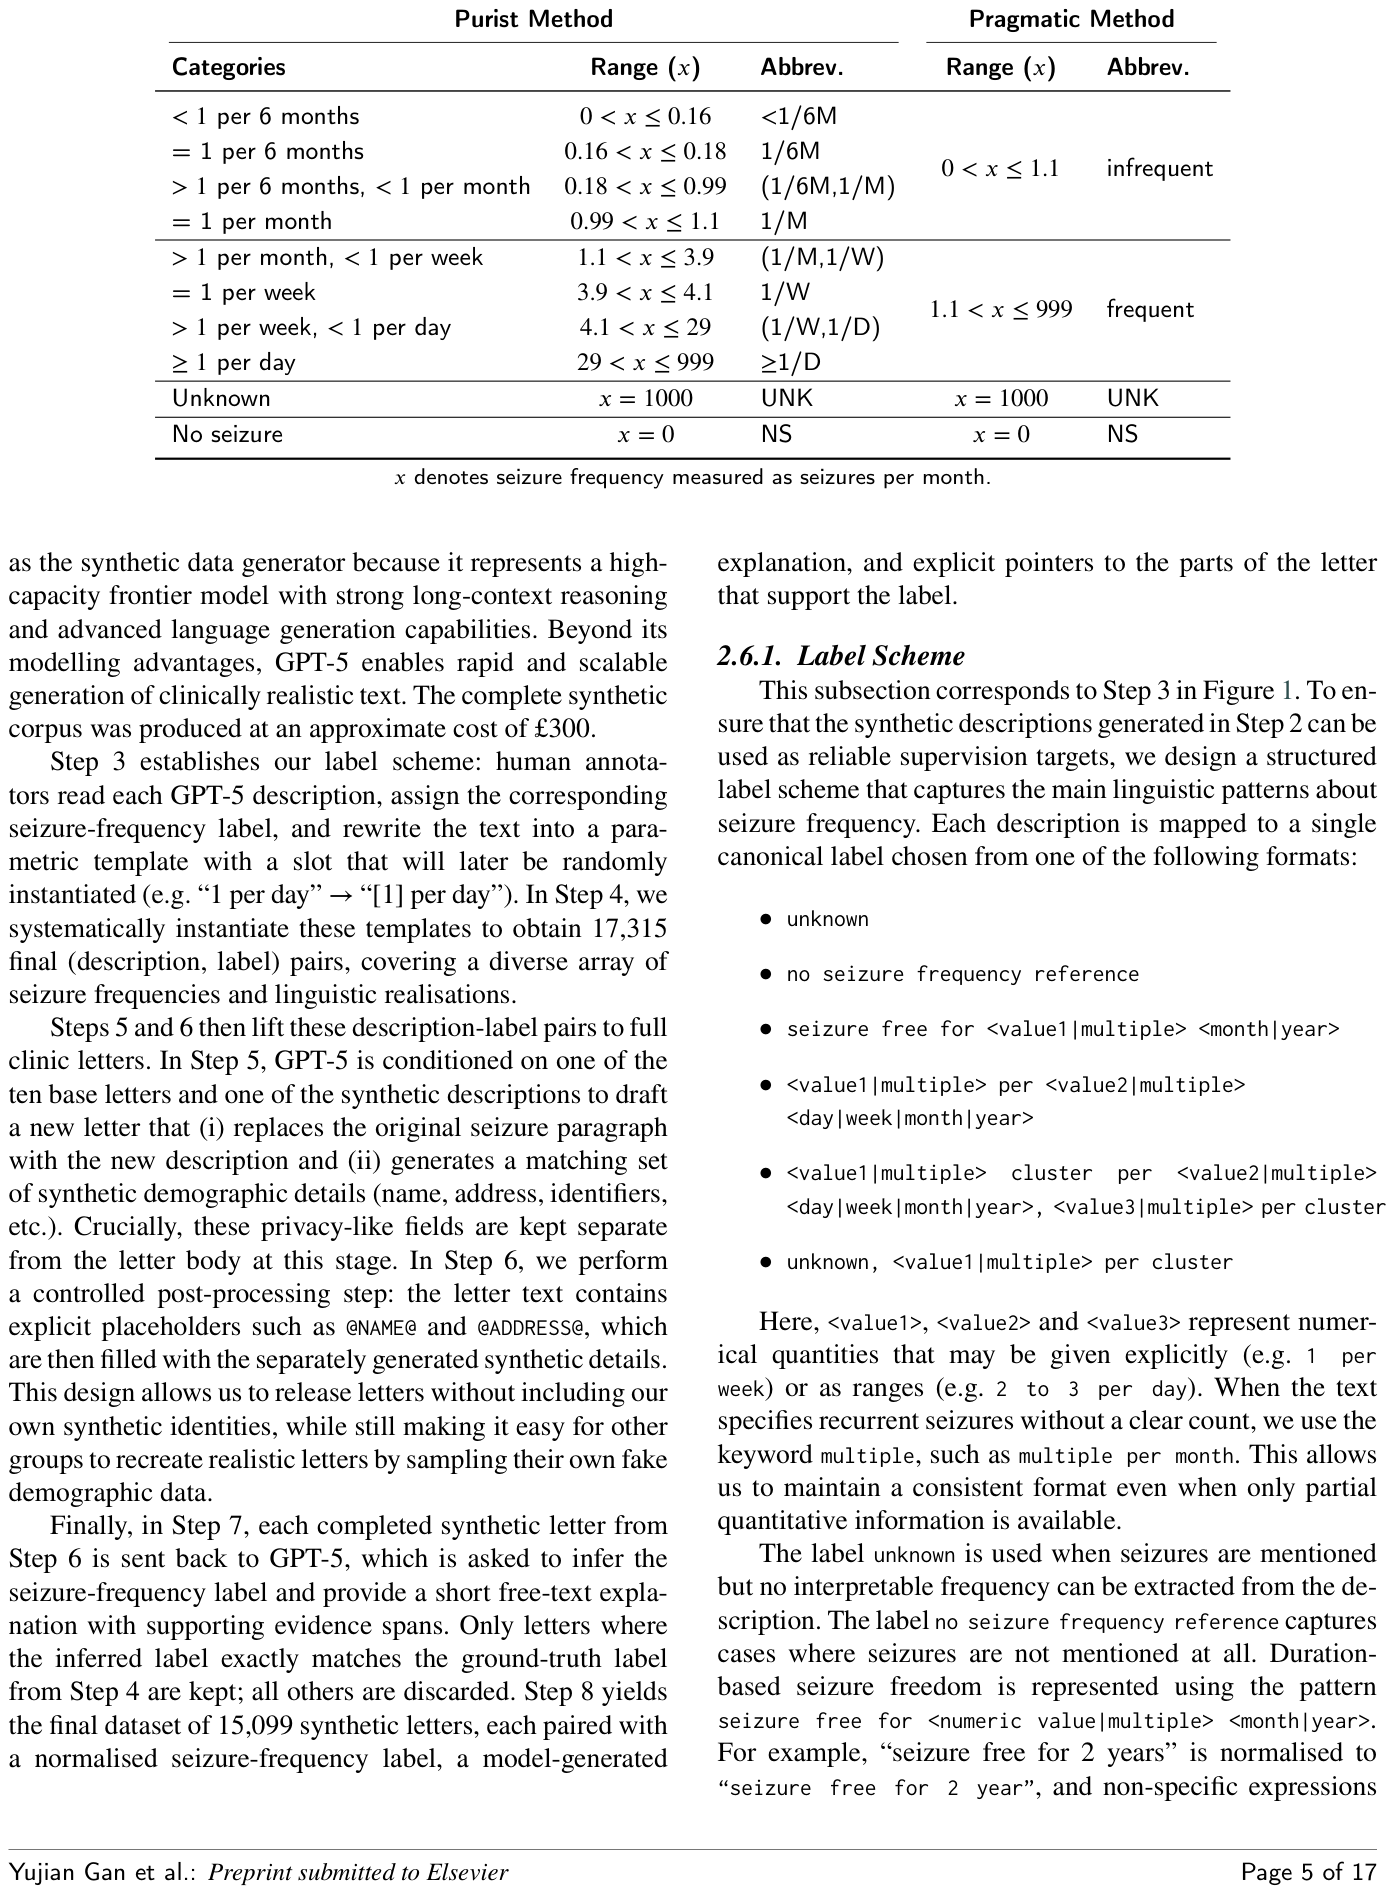
に定義されているPuristとPragmaticという二つの評価スキームの下で行われました。これらの評価スキームは、発作頻度をカテゴリに分類し、モデルの性能を比較するために使用されます。訓練データセットと評価データセットのクラス分布の透明性のために、
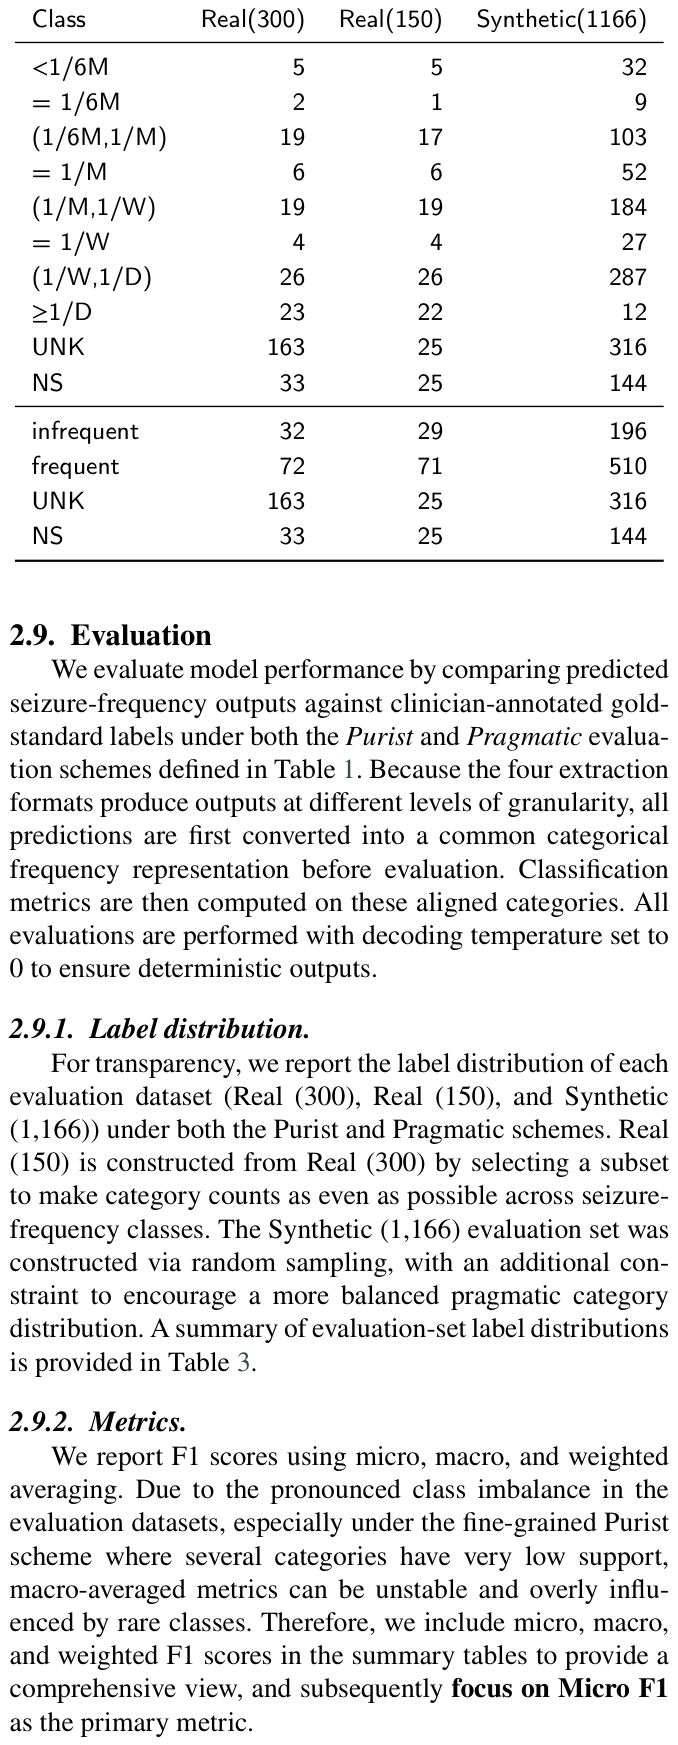
にそれぞれのラベル分布が示されています。本研究では、クラスの不均衡が顕著なため、主要な指標としてマイクロF1スコアに焦点を当てました。
合成データを用いたモデル訓練と評価結果
本研究では、多様な大規模言語モデル(LLMs)を用いて、合成臨床レターによる発作頻度抽出の有効性を検証しました。まず、1,797件の純粋な合成臨床レターのみでファインチューニングされた7つのオープンウェイトLLMの性能を、300件の実際の診療録(Real(300))で評価しました。評価はPurist法とPragmatic法の両方のスキームで行われ、主要な比較指標としてマイクロF1スコアが用いられました。
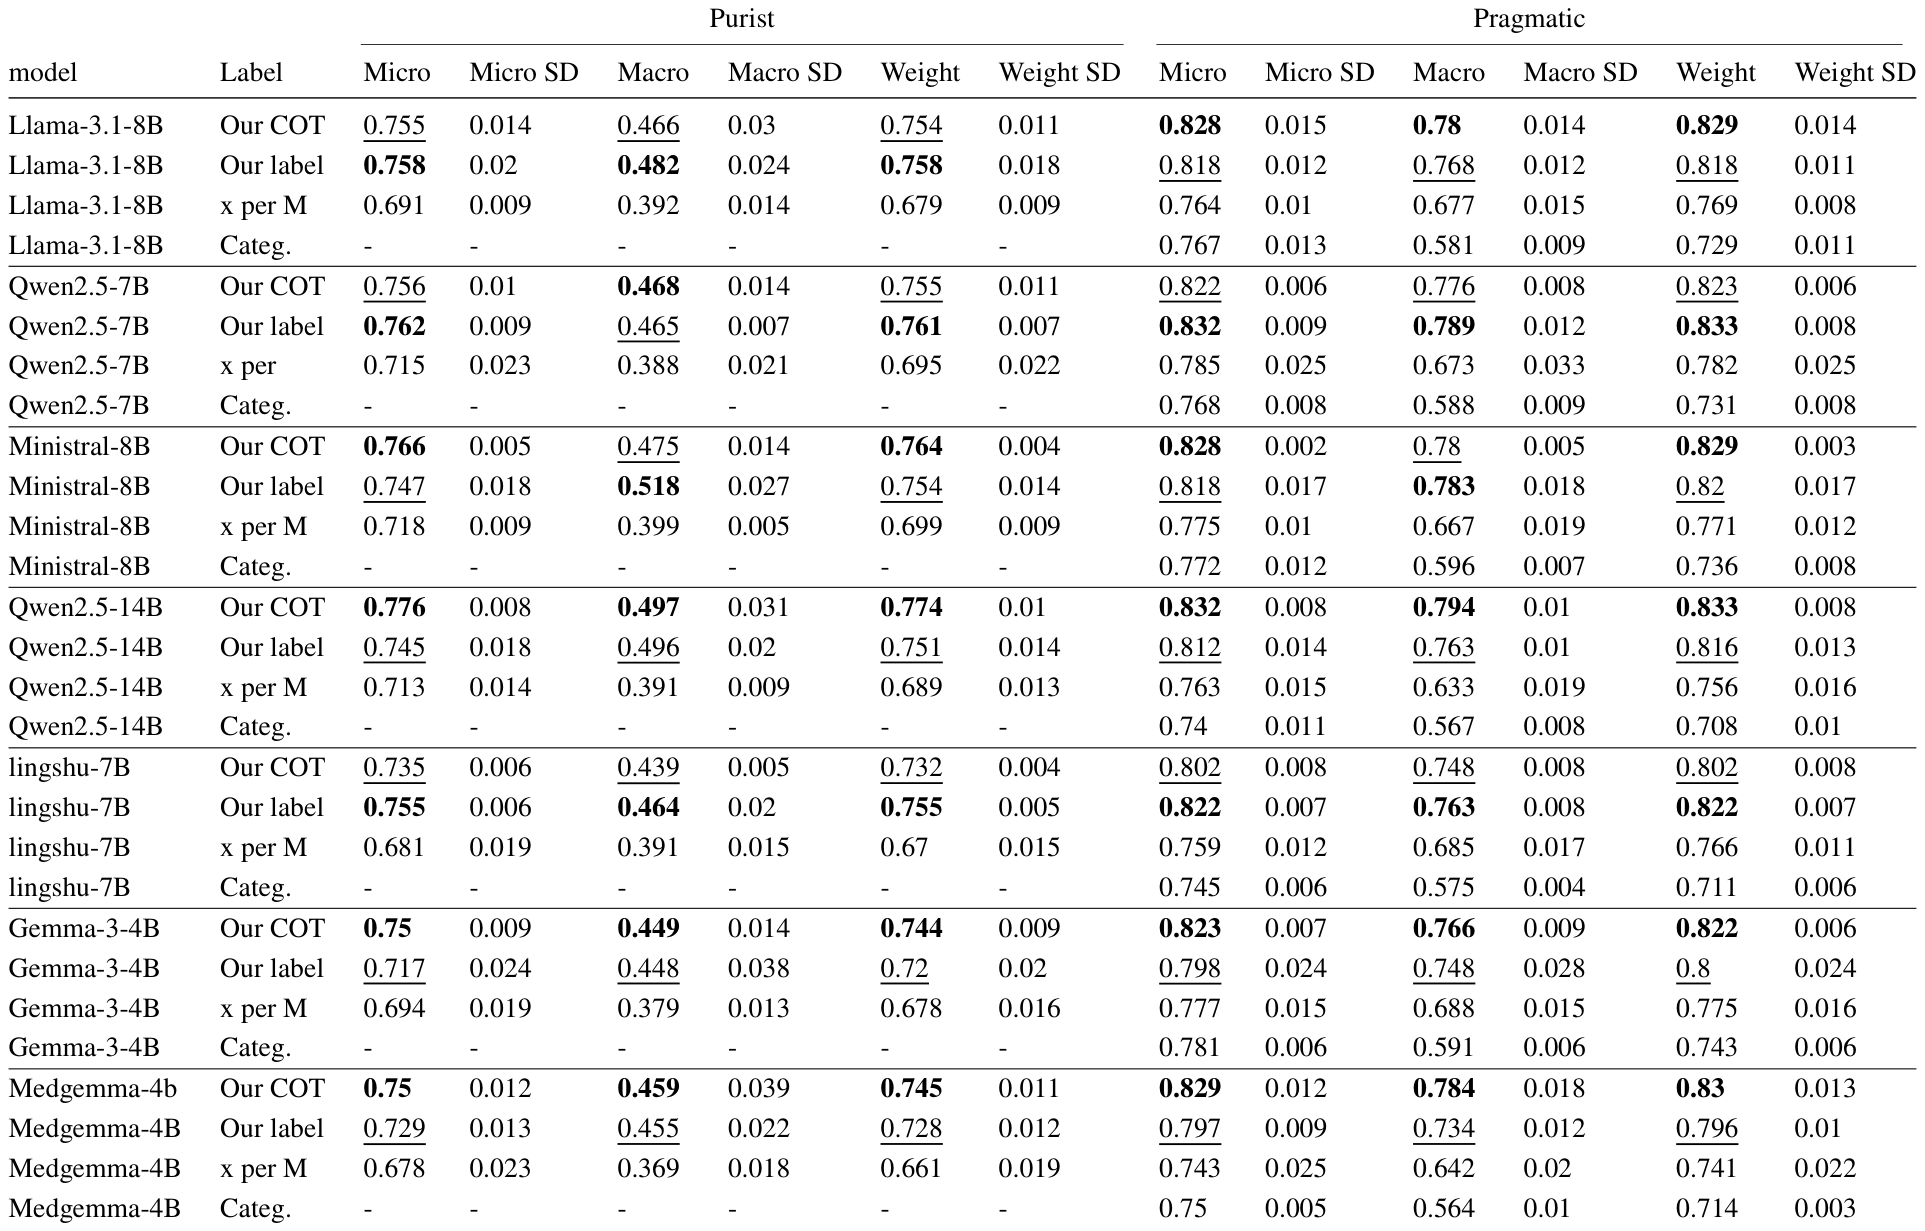
は、その詳細な結果を示しています。この結果から、構造化された出力(「Our label」および「Our CoT」)による監視が、数値回帰形式(「x per M」)や単純なカテゴリ形式(「Categ.」)よりも、実際の診療録に対して一貫して高い性能を達成していることが明らかになりました。特に「Our CoT」形式は、明確な推論過程と証拠スパンを提供するため、モデルの意思決定の質的なレビューを支援します。次に、異なる訓練セットと評価データセットを組み合わせたモデルのマイクロF1スコアが比較されました。
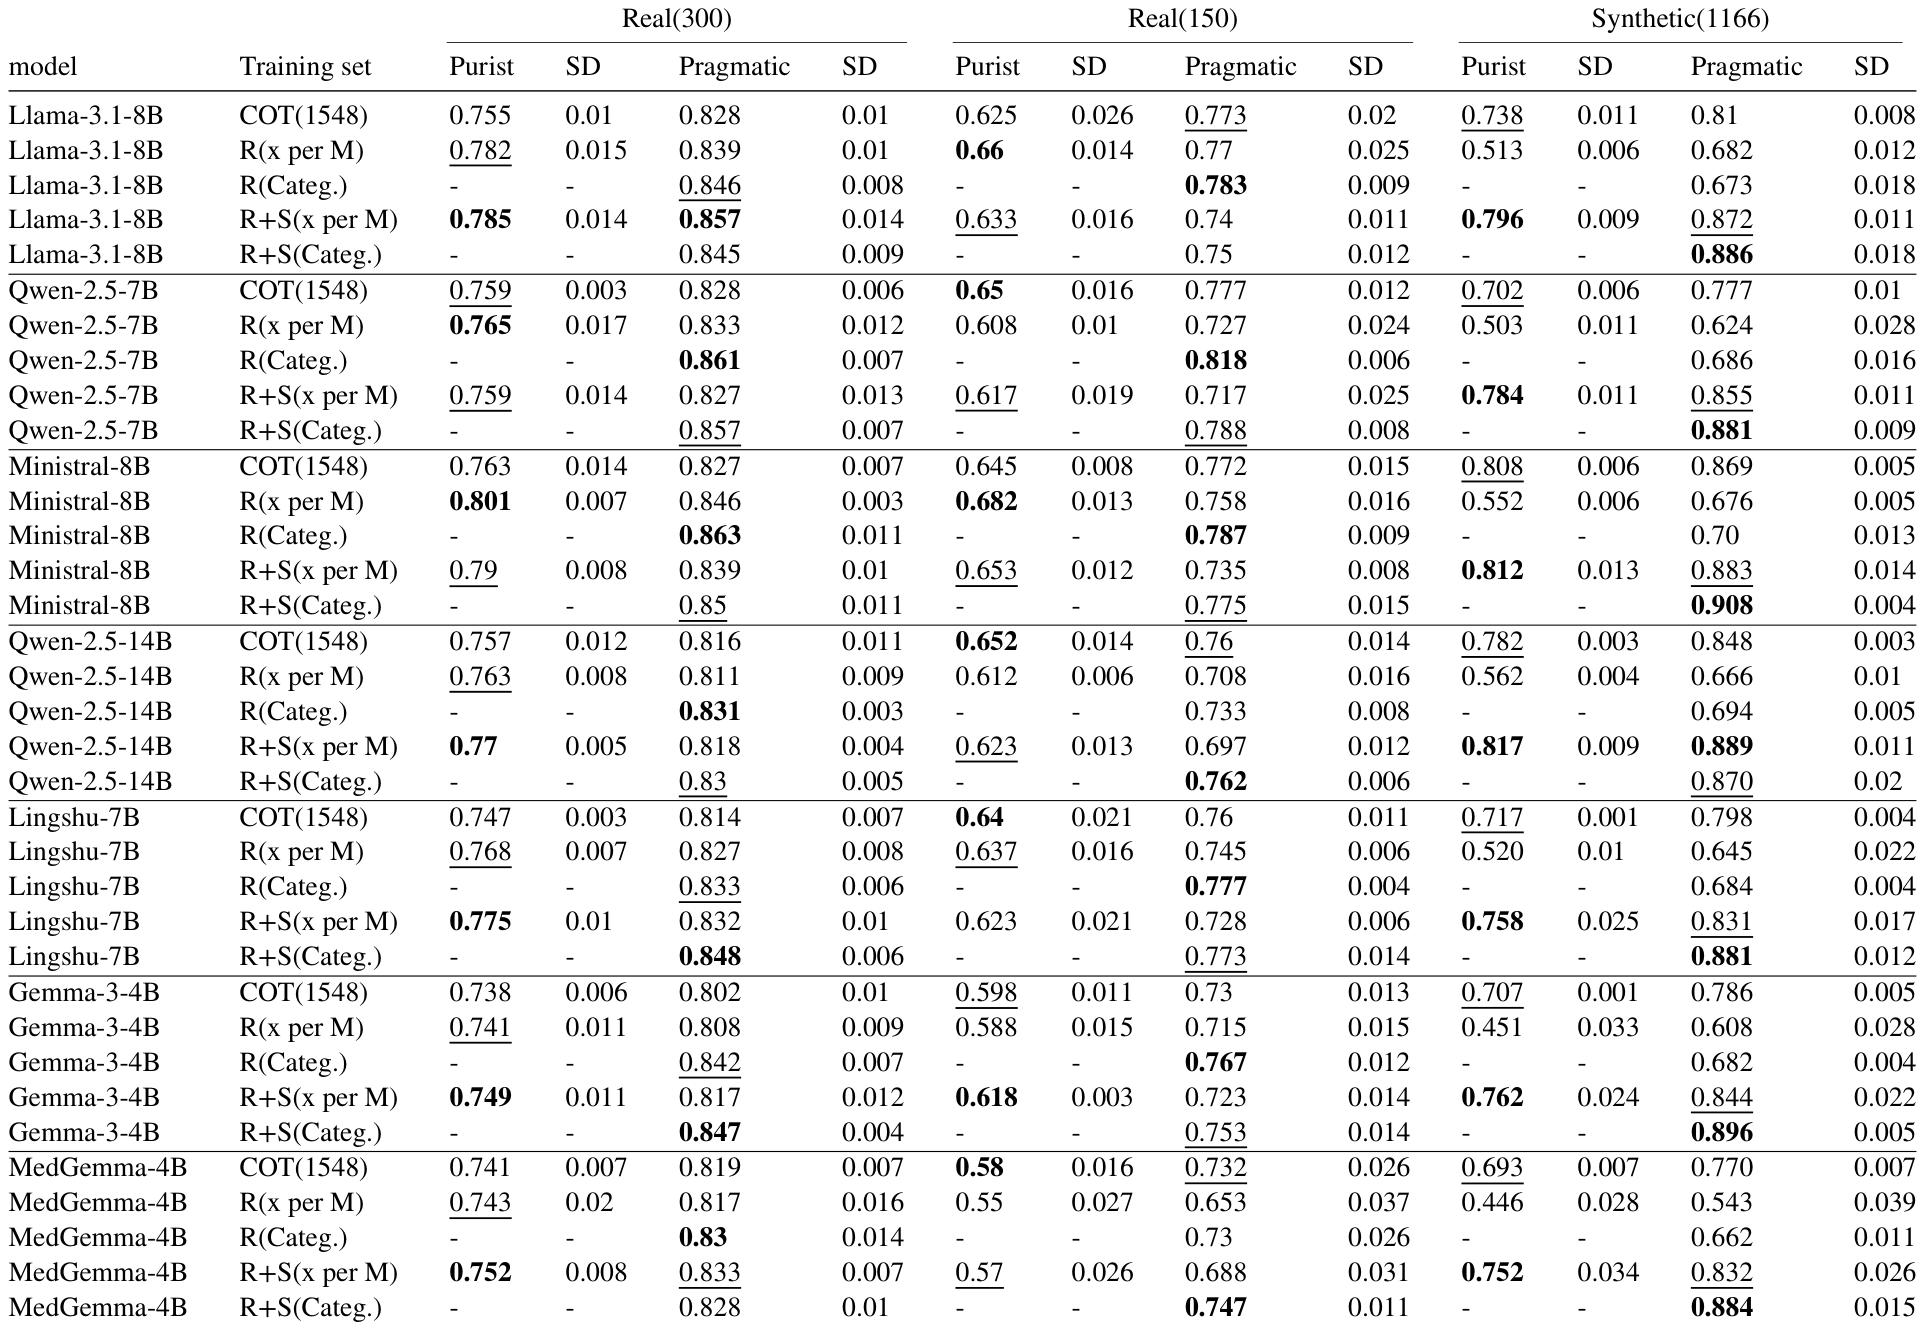
は、Real(300)、Real(150)、Synthetic(1166)という3つの異なる評価データセットにおける、訓練データの構成が汎化性能にどのように影響するかを示しています。結果として、純粋に合成データで訓練されたモデル(CoT(1548))が、実際の診療録のみで訓練されたモデル(R(x per M)またはR(Categ.))に匹敵するか、それを上回る性能を発揮するケースがあることが示されました。特に、合成データを実際のデータと組み合わせた訓練(R+S(x per M)またはR+S(Categ.))は、Synthetic(1166)データセットで非常に高い性能を示し、合成データがモデルの汎化能力を向上させる可能性が示唆されました。さらに、合成訓練データの量が増加するにつれて、発作頻度抽出性能がどのように変化するかを検討しました。Qwen-2.5-14BとMedGemma-4Bという2つの代表的なモデルを用い、合成CoT訓練セットのサイズを500件から15,000件まで増やして評価しました。
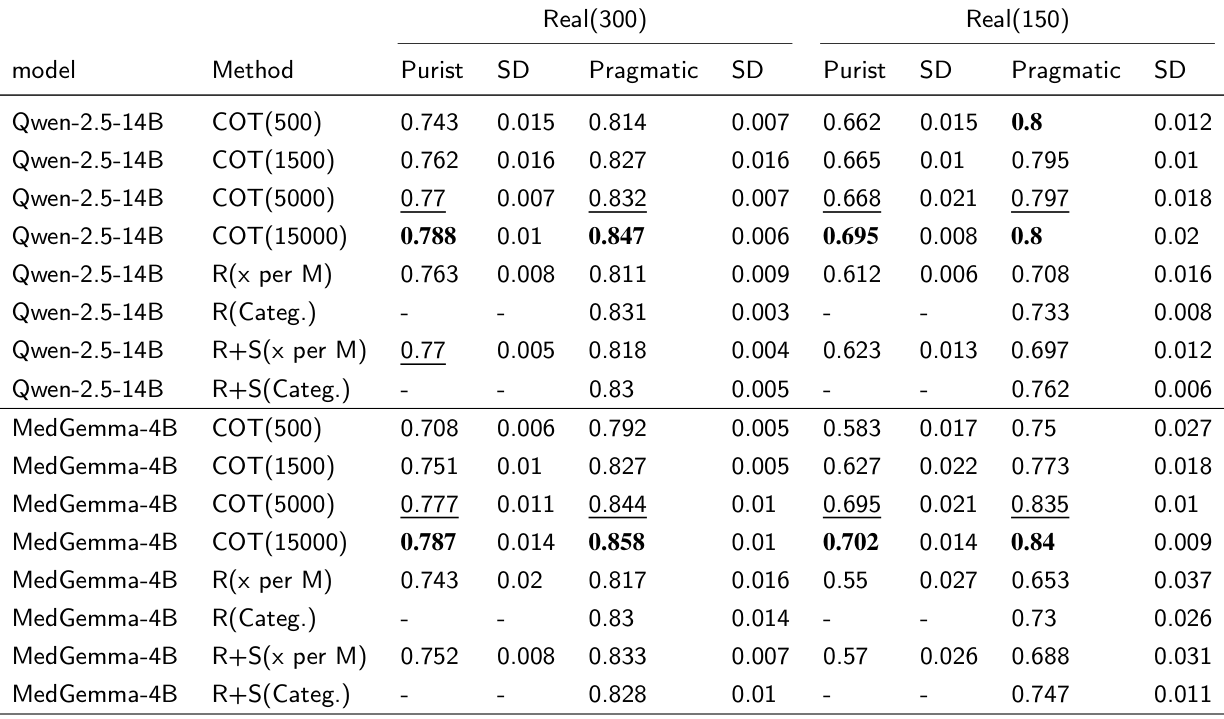
の結果は、合成訓練データの増加が、Real(300)およびReal(150)データセットにおいて一貫して性能向上に繋がることを明確に示しています。例えば、Qwen-2.5-14Bは15,000件の合成データで訓練された際に、Purist法で0.788、Pragmatic法で0.847という最高のマイクロF1スコアを達成しました。これは、合成データの大規模な利用が、実際の臨床現場での強力なモデル性能を実現するための重要な要素であることを示唆しています。最後に、生成された合成レターのリアリズムを評価するため、2人の神経内科専門家が、実際の診療録と合成レターをブラインド形式で評価しました。
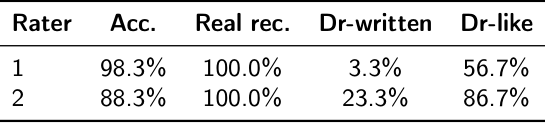
にその結果が示されています。実際のレターは、両方の評価者によって一貫して専門家によって書かれたものであると識別されました(再現率100%)。合成レターについては、神経内科専門家1は56.7%を専門家が書いたもののように(うち3.3%を厳密に専門家が書いたものと)評価し、神経内科専門家2は86.7%を専門家が書いたもののように(うち23.3%を厳密に専門家が書いたものと)評価しました。質的なフィードバックでは、合成レターは臨床的に一貫性があり、概ね説得力があると指摘されました。一方で、専門家らは、過度に包括的な記述スタイル、英国のてんかん診療では一般的でない検査や診察詳細の記載、”per”のようなフレーズの頻繁な使用、不自然に短いフォローアップ間隔、過度に構造化されたナーラティブといった、いくつかの様式的なアーティファクト(人工的な特徴)も指摘しました。これらのフィードバックは、今後の合成データ生成の改善点を示唆しています。
まとめと今後の展望
本研究は、てんかん発作頻度抽出システムを開発するための具体的な道筋を示しており、拡張性、再現性、そして医療におけるプライバシー保護と展開の現実に即した形で実現可能であることを証明しました。著者らが提案したフレームワークは、以下の3つの主要な点で意義深いとされています。第一に、発作頻度抽出に特化した合成データフレームワークとタスク固有のアノテーションスキームを提案したことです。これにより、従来の合成データ生成アプローチとてんかんアウトカムモデリングの要件との間のギャップを直接埋めることができました。第二に、完全に合成データによる監視を通じて、再現可能な訓練とプライバシー保護に配慮した展開を強調している点です。合成データのみで訓練されたモデルが、実際の診療録において、実際のデータのみで訓練されたモデルに匹敵するか、それを上回る性能を達成することを示しました。これにより、プライバシーリスクと、施設固有のデータセットに内在する再現性の問題を回避できます。第三に、推論と根拠を意識した監視を活用し、操作化した点です。モデルが根拠となる説明(ソーステキストに紐づいた証拠スパンなど)を提供できる能力は、監査可能性と人間の検証をサポートし、臨床現場での信頼性を高めます。全体として、本研究は、発作頻度抽出システムのスケーラビリティ、再現性、プライバシー保護の実現に貢献するだけでなく、合成された証拠に基づいた監視を他の臨床的に重要な情報抽出問題に拡張するためのテンプレートとしても機能するものです。このアプローチは、プライバシー上の制約により実際のナーラティブへのアクセスが制限される、他の時間的に複雑な臨床情報抽出問題にも直接適用できる可能性を秘めています。
用語集
- アノテーション: テキストデータに特定の情報(例:発作頻度)を付与する作業。
- 思考の連鎖(Chain-of-Thought, CoT)プロンプティング: 大規模言語モデルに対し、最終回答を出す前に中間的な推論ステップを生成するよう促す手法。
- 教師モデル: より高性能な大規模言語モデルを指し、より小規模なモデルの学習を支援するために、質の高い合成データやアノテーションを生成する目的で使用される。
- F1スコア: 分類モデルの性能を評価する指標の一つで、適合率(Precision)と再現率(Recall)の調和平均。
- マイクロF1: 全てのクラスの真陽性、偽陽性、偽陰性を合計してからF1スコアを計算する方法。クラスの不均衡がある場合に有用。
- ゴールデンスタンダード: 最も信頼できる、または最高の品質を持つ基準データセット。
- 自然言語処理(NLP): 人間が使う言語をコンピュータで処理・分析する技術。
- 大規模言語モデル(LLMs): 膨大なテキストデータで訓練された、人間のようなテキストを生成・理解できるAIモデル。
- オープンウェイトLLM: モデルの重み(パラメーター)が公開されており、研究者や開発者が自由に利用・改変できる大規模言語モデル。
コメントを残す