
レーザー治療の個別化を加速する皮膚・毛髪の自動解析システム
解説対象論文: Hair Segmentation and Skin Characterization on Macroscopic Dermatological Images for Laser Treatment Parameterization
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年10月21日時点)
現在の美容医療や皮膚科治療では、レーザー脱毛をはじめとする光線ベースの治療機器が広く用いられていますが、その効果と安全性は、対象者の皮膚や毛髪の特性に合わせた細かなパラメータ調整に大きく左右されます。しかし、この調整はしばしば専門家の経験と目視に頼る主観的なものであり、治療の質にばらつきが生じる原因となっていました。この課題に対し、最新の研究では、マクロな皮膚科画像を解析することで、毛髪の検出・識別と皮膚の特性評価を自動化し、レーザー治療の個別化と安全性の向上を目指す画期的なシステムが提案されています。
レーザー治療の精度を向上させる客観的パラメータ測定の重要性
どうも、Beyond the Pixelです。美容医療や皮膚科治療において、レーザー脱毛、IPL(インテンスパルスライト)、血管レーザー治療、光線療法などの光線ベースの医療機器は広く利用されています。しかし、これらの治療効果と安全性は、対象者の皮膚フォトタイプ(肌の色調)、毛髪の特性、特定の皮膚状態に応じたレーザーパラメータの正確な調整に大きく依存します。現在の臨床現場では、この調整は専門家による視覚的な検査と経験に基づいて手作業で行われることが多く、主観的で時間がかかり、施術者間のばらつきが生じる可能性があります。これは治療結果だけでなく、対象者の安全性にも影響を及ぼす可能性があります。
例えば、レーザー脱毛では、選択的光熱融解の原理に基づいて毛包に熱エネルギーを照射しますが、そのエネルギー量やパルス持続時間は、火傷や色素沈着のリスクを最小限に抑えつつ効果を最大化するために、対象者の皮膚フォトタイプと毛髪の太さに合わせて調整されなければなりません。しかし、既存の市販機器は、この作業を専門家の判断に大きく依存しており、一部の高度なシステムには基本的なフォトタイプ推定機能が組み込まれているものの、空間的な情報を欠く点ベースのカラーメーターや、照明条件に左右されやすい未校正のRGBカメラに頼っているのが現状です。
マクロ画像で毛髪と皮膚の特性を客観的に評価する統合システム
このような課題を克服するため、この研究では、マクロな皮膚科画像における毛髪のセグメンテーションと皮膚の特性評価のための統合システムを提案しています。多くの既存研究が、厳密に管理された条件下で撮影されたダーモスコピーデータセットに依存しているのに対し、このアプローチは、実際の臨床レーザー治療を模倣したマクロ画像に特化して設計されています。著者らは、YOLOv9という深層学習アーキテクチャのカスタムトレーニングバリアントをインスタンスセグメンテーションに、そして古典的な画像処理を組み合わせることで、皮膚フォトタイプ、毛髪密度、色、太さといった客観的な皮膚・毛髪パラメータを単一のワークフローで抽出するパイプラインを開発しました。さらに、分光測色計による色校正段階を設けることで、照明条件に関わらず正確な特徴推定を保証しています。このパイプラインは、高解像度のマクロ皮膚画像における体毛の検出とセグメンテーションのために、YOLOv9-C-DSEGモデルを採用しています。このモデルは、オブジェクトの位置特定とマスク生成の分離を強化するデュアルヘッドインスタンスセグメンテーションモデルであり、推論速度を損なうことなくエッジ精度とマスクの安定性を向上させます。各毛髪を個別のインスタンスとしてセグメント化することで、その後の定量分析が容易になります。
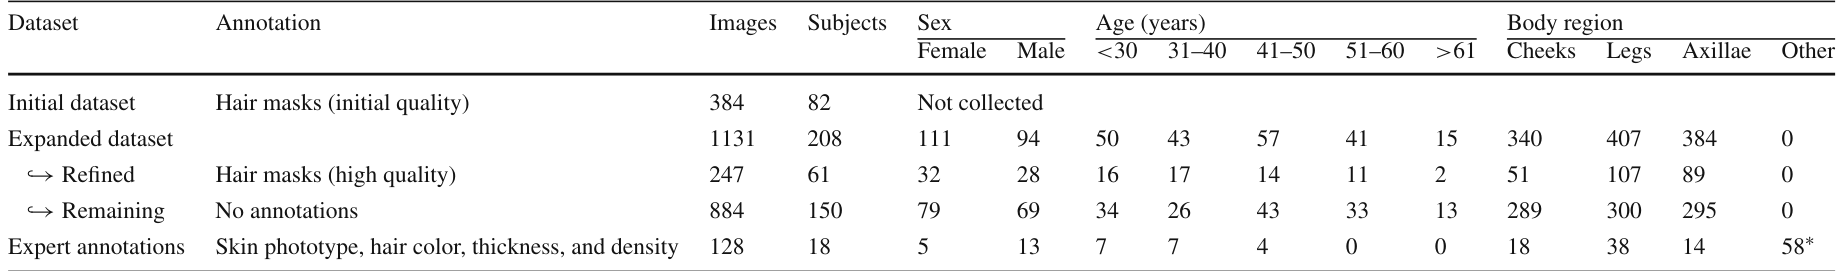
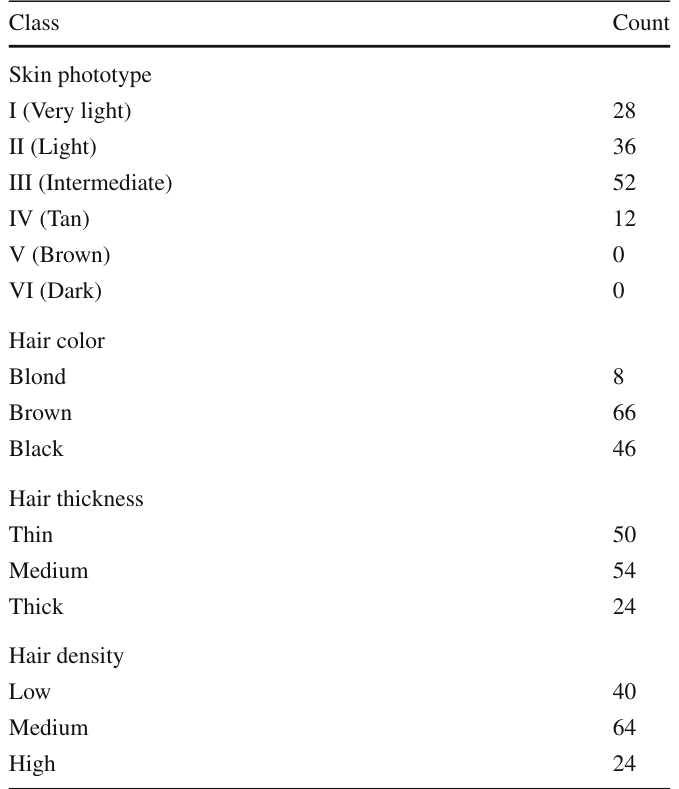
限られたアノテーションデータに対応するため、回転、反転、スケーリング、明るさ、コントラスト、色の調整といったデータ拡張が適用されました。また、専門家の支援を受けて、身体領域、Fitzpatrick分類、ITA値、毛髪の色、太さ、密度といった関連属性がアノテーションされた128枚の追加データセットが収集され、テストと比較評価に使用されました。
すべての画像は、レーザー脱毛治療の前処理状態を再現するため、毛を剃り、清潔で乾燥した状態で取得されました。
皮膚の色調とフォトタイプ推定
皮膚の色分析では、対象者間および画像取得条件全体での一般化と堅牢性を確保するため、客観的で標準化された皮膚の色調測定値であるITA(Individual Typology Angle)が採用されました。ITAは、CIELAB色空間の明度(L)と青黄色の色度成分(b)から計算されます。この値は度数で表され、標準化された閾値(例:55°、41°、28°、10°、–30°)を用いて、皮膚科研究で一般的に使用される6つのフォトタイプクラス(非常に明るい、明るい、中間、日焼け肌、茶色、暗い)に分類できます。
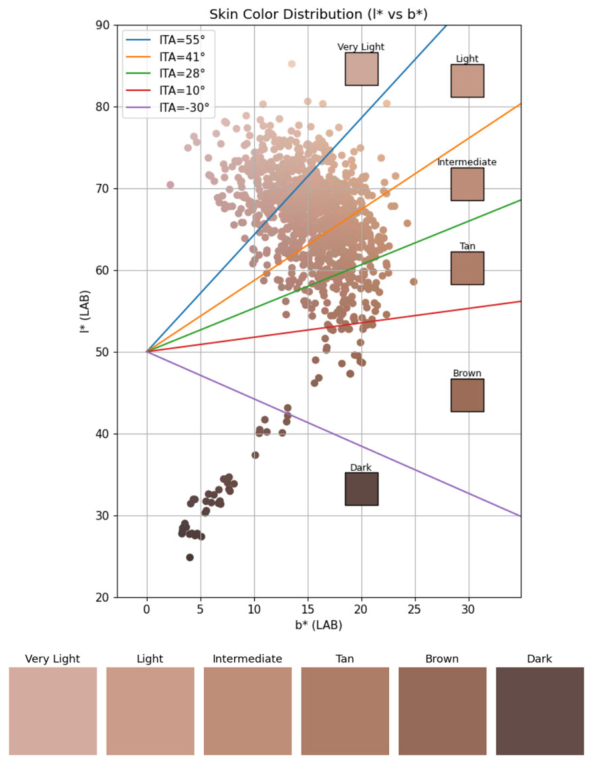
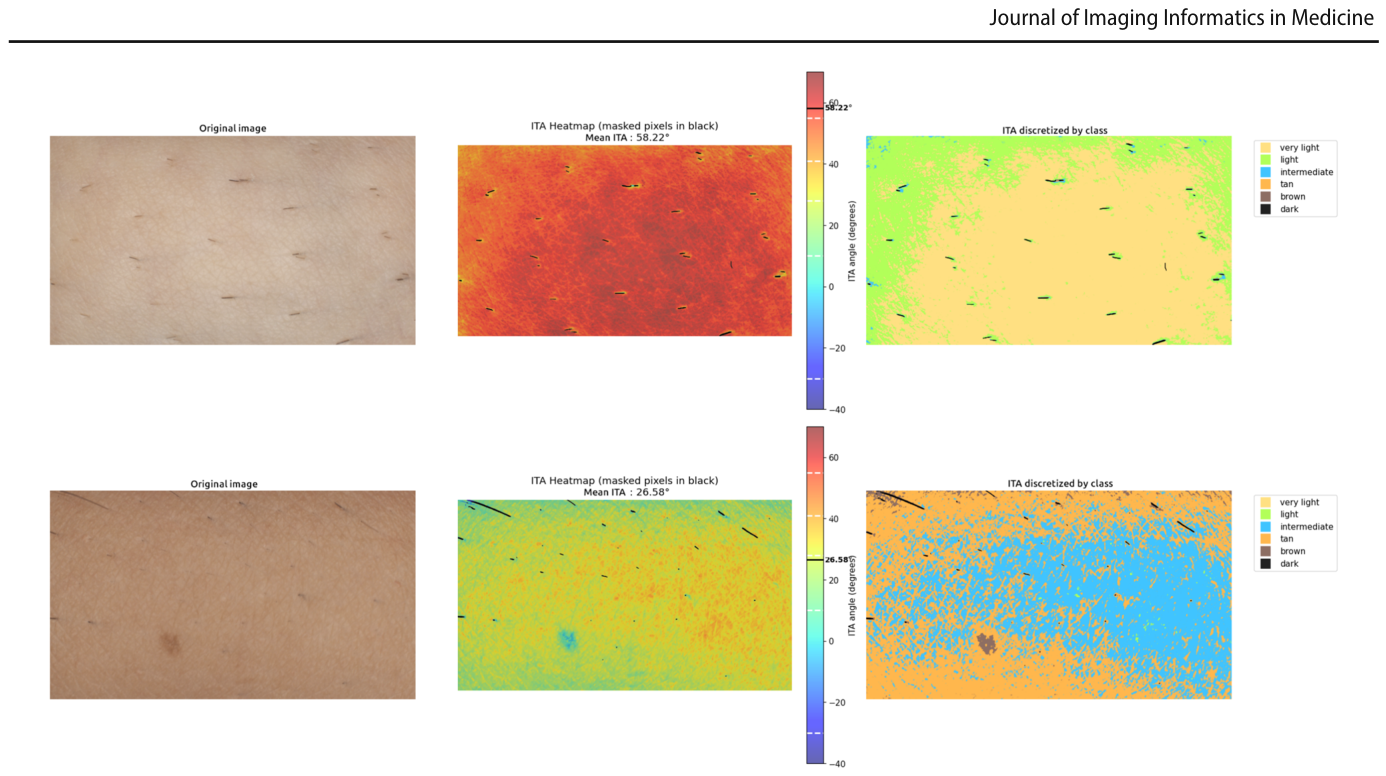
ITAを計算する前に、L=0のピクセルは破棄され、ノイズや局所的なアーティファクトの影響を最小限に抑えるため、Lとb*の両方の平均から1標準偏差内にあるピクセルのみが保持されます。しかし、マクロ画像では、毛穴、細かいしわ、微細な影といった微妙な表面の不規則性が、一見均一に見える領域内でも知覚できる局所的な色変動を引き起こします。また、照明のビネット効果により明るさのグラデーションが生じ、中心領域が明るく、周辺領域が徐々に暗くなる傾向があります。これらの問題を軽減するため、画像の中心にROI(関心領域)が定義され、毛髪セグメンテーションマスクが適用されて毛髪で覆われたピクセルが除外されます。これらのステップ(色校正、中心ROI選択、セグメンテーションに基づくフィルタリング)により、ITA値と対応するフォトタイプクラスが、画像化された領域の真の肌の色を確実に表現し、対象者間および取得セッション間での一貫した再現性のある推定が可能になります。
毛髪の色、数、密度の推定
毛髪の色の推定は、モデルによって生成されたセグメンテーションマスクから直接行われます。各マスクは元のRGB画像に適用され、検出された毛髪に対応するピクセルのみが分離されます。しかし、これらのマスクされた領域には通常、毛髪と皮膚の境界にある混合ピクセルが含まれており、部分的な透明性、焦点ぼけ、色のにじみにより皮膚の色調による汚染が発生します。この問題を軽減するために、2つの異なる戦略が評価されました。一つは、モルフォロジー的エロージョン(収縮処理)を各毛髪マスクに適用し、境界ピクセルを除去して色の汚染が最小限である毛髪の中心領域のみを保持する方法です。もう一つは、毛髪と皮膚のピクセルを組み合わせたセットに対して色クラスタリング(例:k=6のk-means)を実行し、皮膚ピクセルの割合が最も低いクラスタを毛髪に対応するものとして識別する方法です。
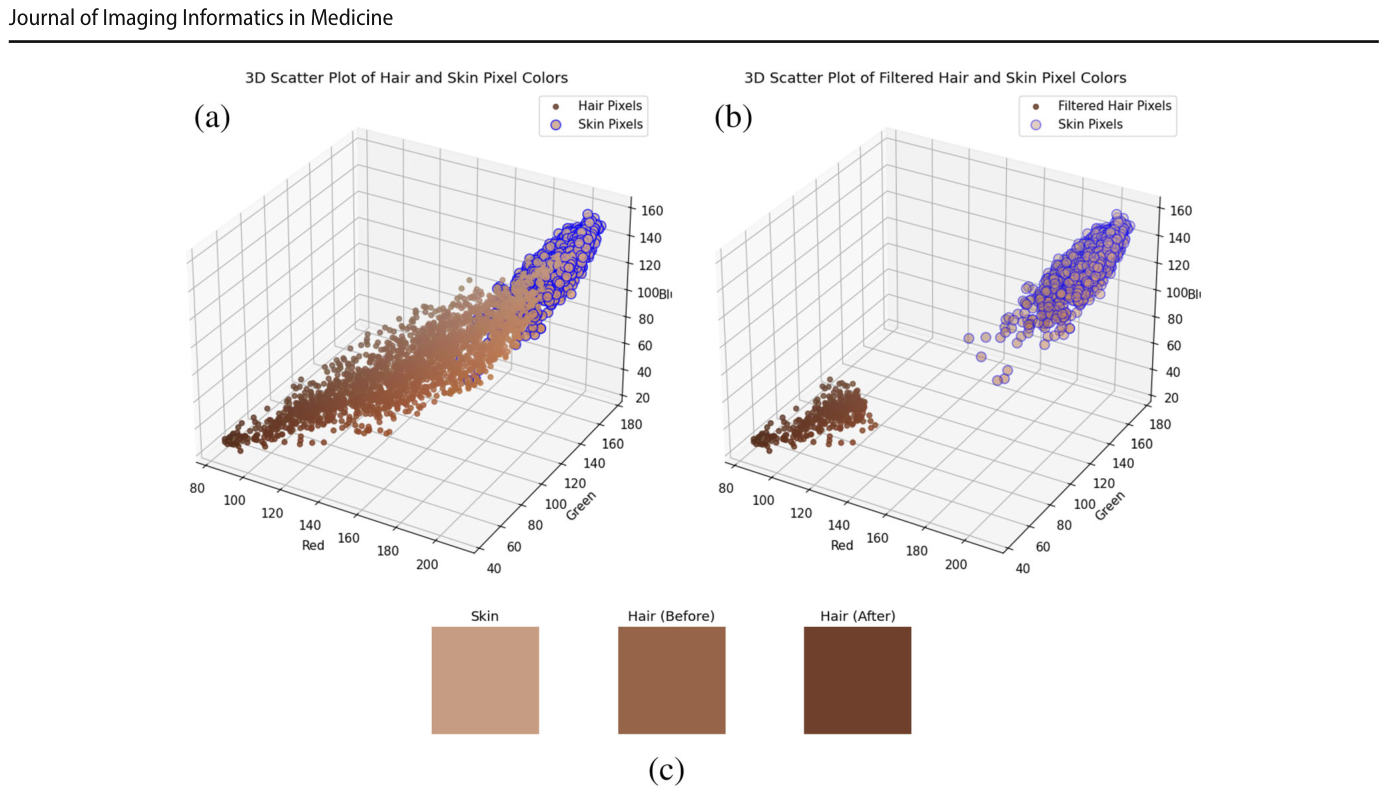
毛髪の色のノイズが除去された後、CIELAB色空間でk=3のk-meansクラスタリングを適用することで、毛髪の色調を金髪、茶色、黒の3つの主要な色グループに分類します。毛髪の数と毛包密度の推定は、インスタンスセグメンテーションアプローチにより直接行われます。検出された各インスタンスが単一の毛髪に対応するため、追加の分析や後処理は必要ありません。毛包密度(通常、平方センチメートルあたりの毛髪数で表される)を計算するためには、正確なピクセルからミリメートルへの変換係数が実験的に決定されました。これにより、検出された毛髪数を物理的に意味のある密度値(毛髪/mm²または毛髪/cm²)に変換できます。毛髪の太さの推定は、セグメンテーションモデルによって生成されたバイナリマスクに古典的な画像処理技術を適用して行われます。各毛髪インスタンスに対応するマスクは、距離変換(distance transform)を用いて処理されます。これは、マスク内の各ピクセルについて、最も近い境界ピクセルまでの距離を計算します。この変換により、毛髪の局所的な半径の空間表現が提供され、最大毛髪の太さと平均毛髪の太さという2つの補完的な厚さの測定値が導き出されます。
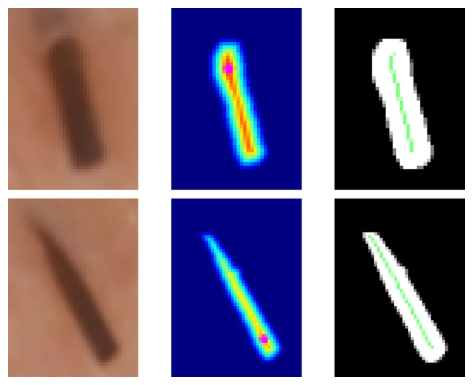
これらの測定値は、先述のピクセルからミリメートルへの変換係数を用いてミリメートル単位に変換されます。
実験結果とシステム評価
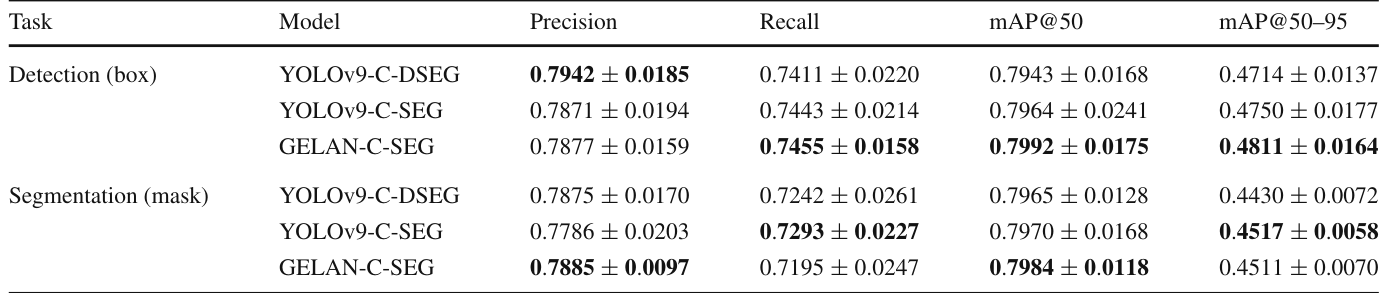
3つの候補モデル(YOLOv9-C-DSEG、YOLOv9-C-SEG、GELAN-C-SEG)の性能は、5分割交差検定戦略を用いて評価されました。その結果、すべてのモデルで類似した高い性能が示され、mAP@50(IoU閾値0.5における平均適合率)は約0.80に達しました。これは堅牢な位置特定を示しています。
より詳細なマスクの境界精度に関する評価では、YOLOv9-C-DSEGがほとんどの領域ベース(Diceスコア、IoU)および境界ベースのメトリクスで他のモデルを上回ることが示され、特に困難な画像に敏感なマクロ平均スコアで優れていました。
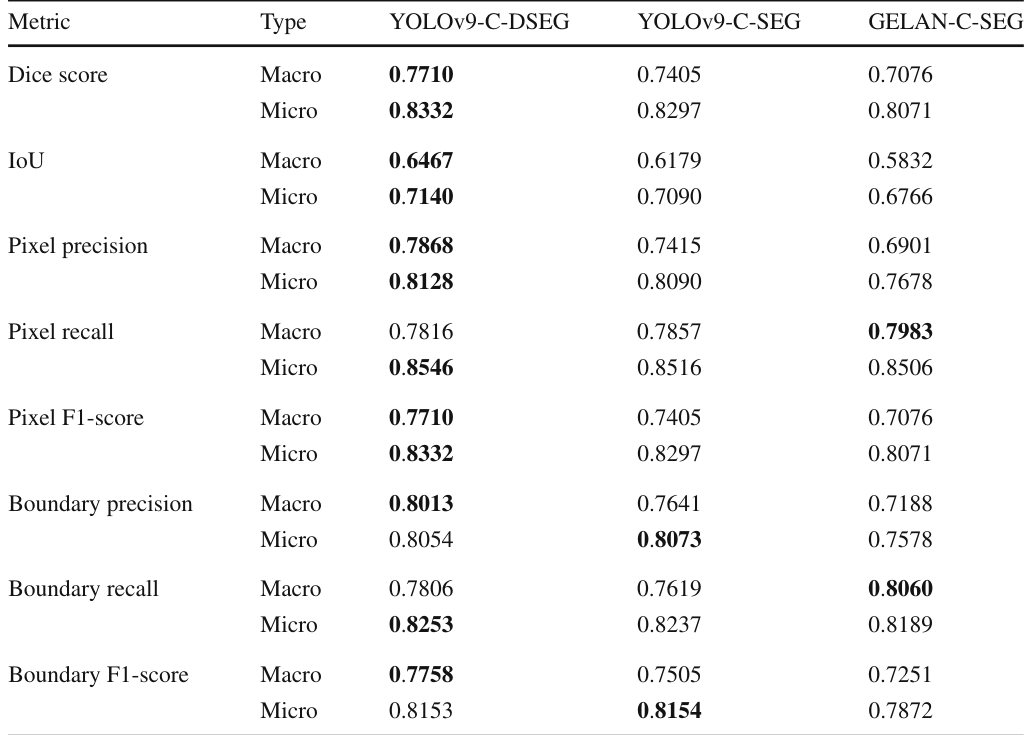
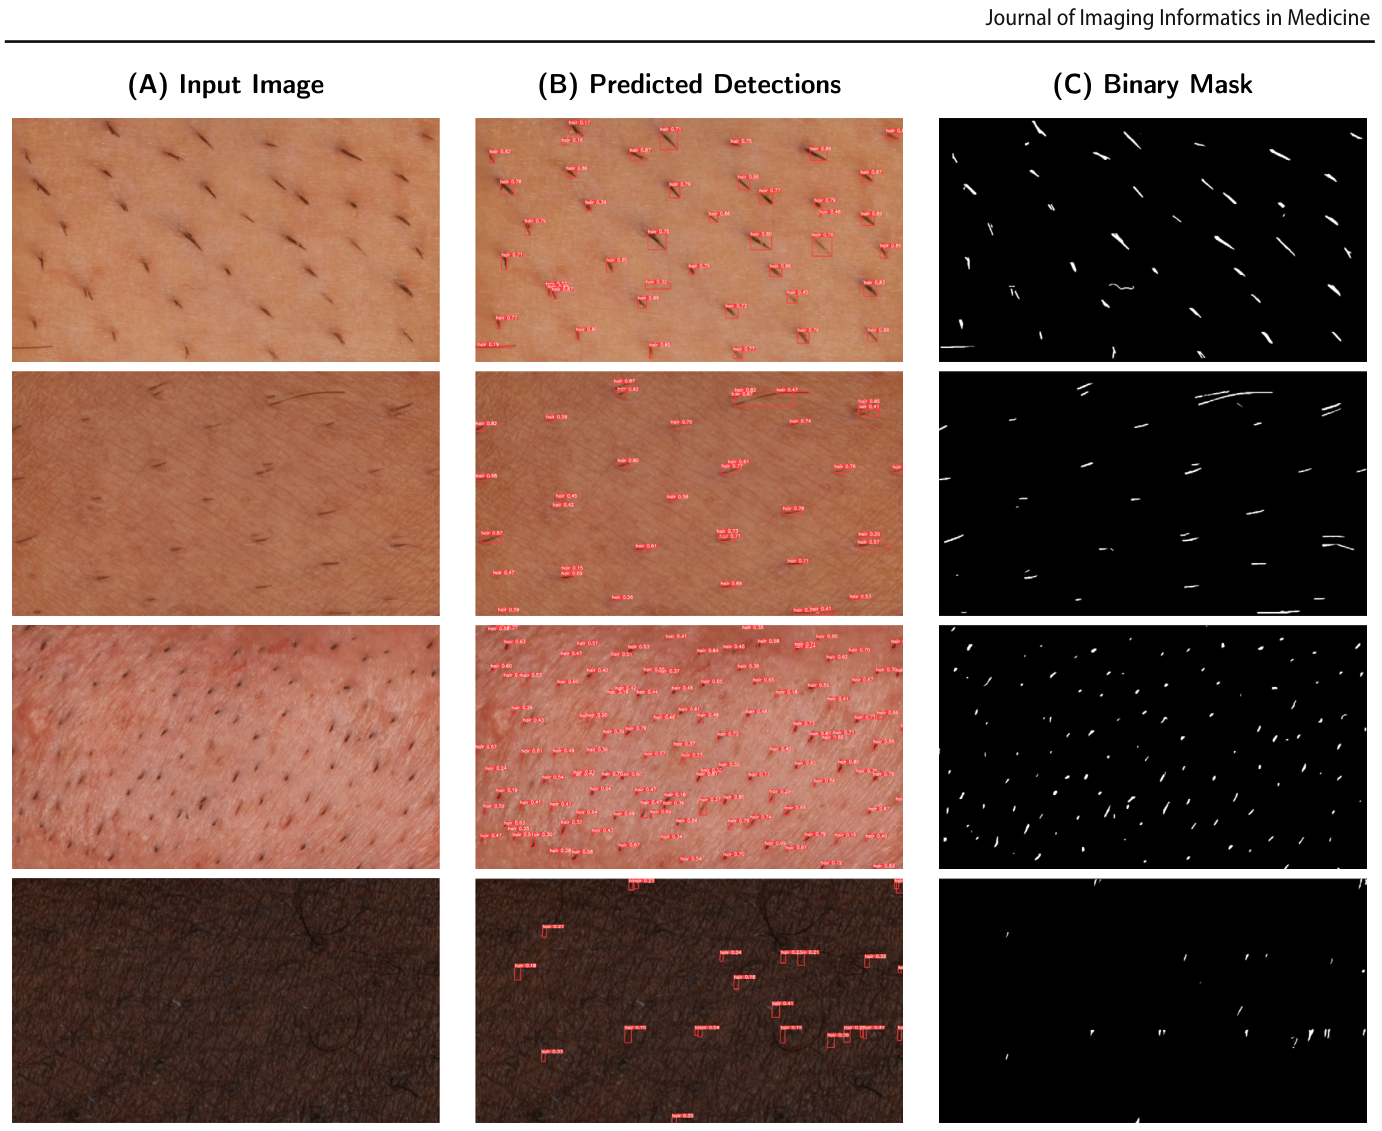
この詳細な分析に基づき、YOLOv9-C-DSEGが最終モデルとして選定されました。推論処理時間は、ミッドレンジGPUでサブ秒を達成し、将来的な臨床機器への統合を強力に支持する結果となりました。
セグメンテーションの不正確さが最終的な臨床パラメータに与える影響を定量化するため、毛髪の太さと密度の推定におけるエラー伝播を分析しました。その結果、モデルの予測マスクから抽出された特徴と、ゴールデンスタンダードマスクから抽出された特徴を比較すると、セグメンテーションのわずかな境界の不完全さが、得られる特徴に与える影響はごくわずかであることが示されました。平均毛髪の太さについて、モデルはわずか4.0 µmという極めて低いマクロ平均絶対誤差を達成しており、これはサブピクセルの偏差に相当します。
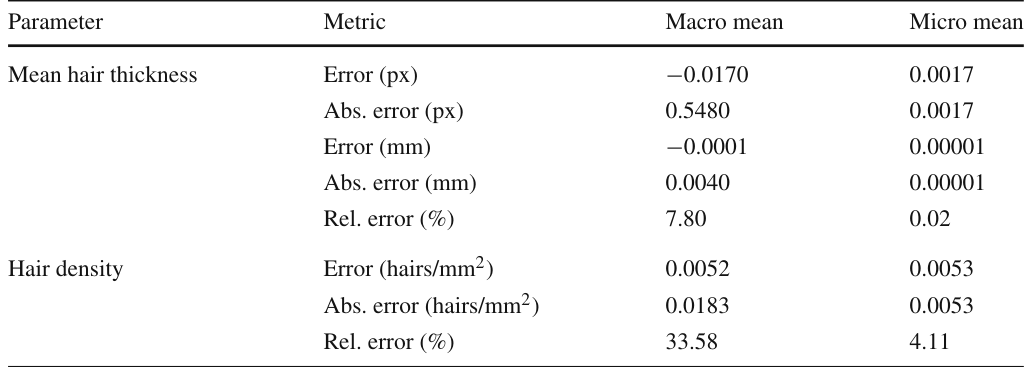
毛髪密度についても、マイクロ平均誤差が4.11%であり、全体的に高い精度を示しています。抽出された特徴の臨床的妥当性を定量的に検証するため、専門家によってアノテーションされた128枚のテスト画像サブセットに対して特徴抽出モジュールの性能を評価しました。毛髪の太さと密度では、バランス精度がそれぞれ80.4%と72.6%に達し、コーエンのカッパ係数は0.676と0.634でした。毛髪の色分類では61.3%のバランス精度(カッパ係数=0.547)、皮膚フォトタイプ分類では73.0%のバランス精度(カッパ係数=0.626)を達成しました。
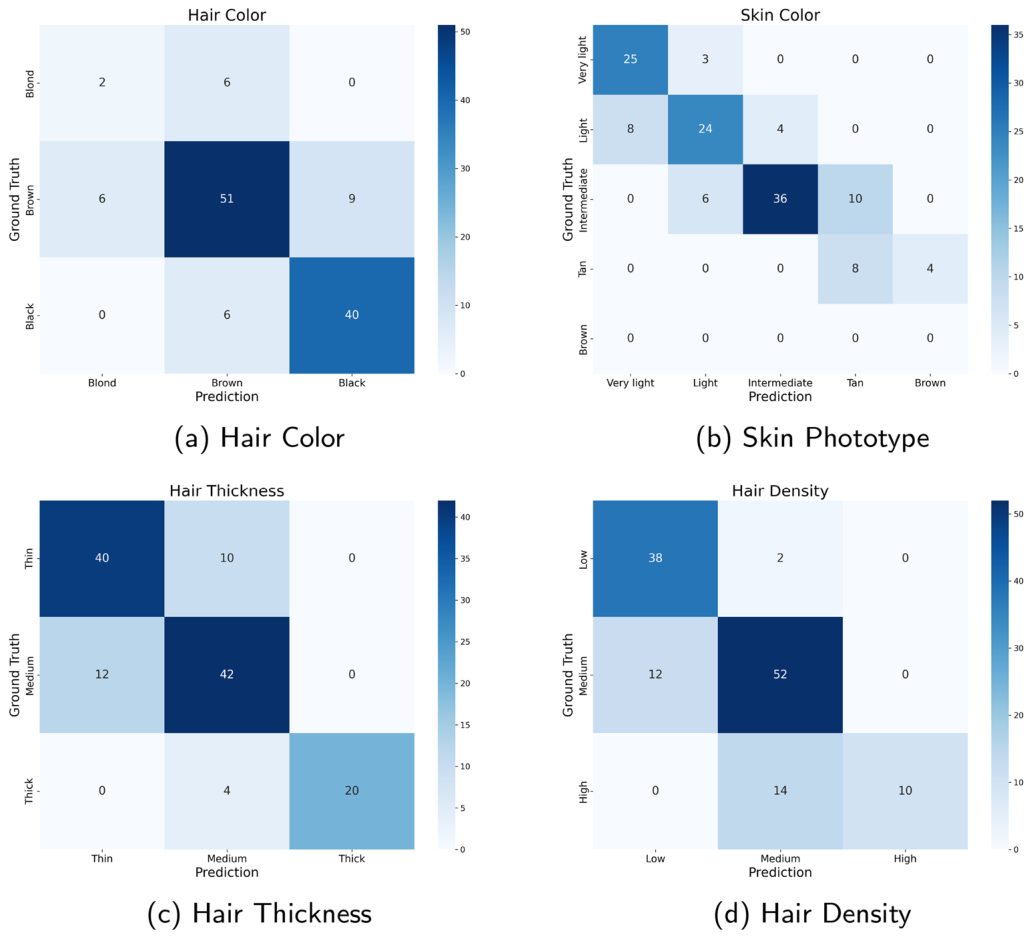
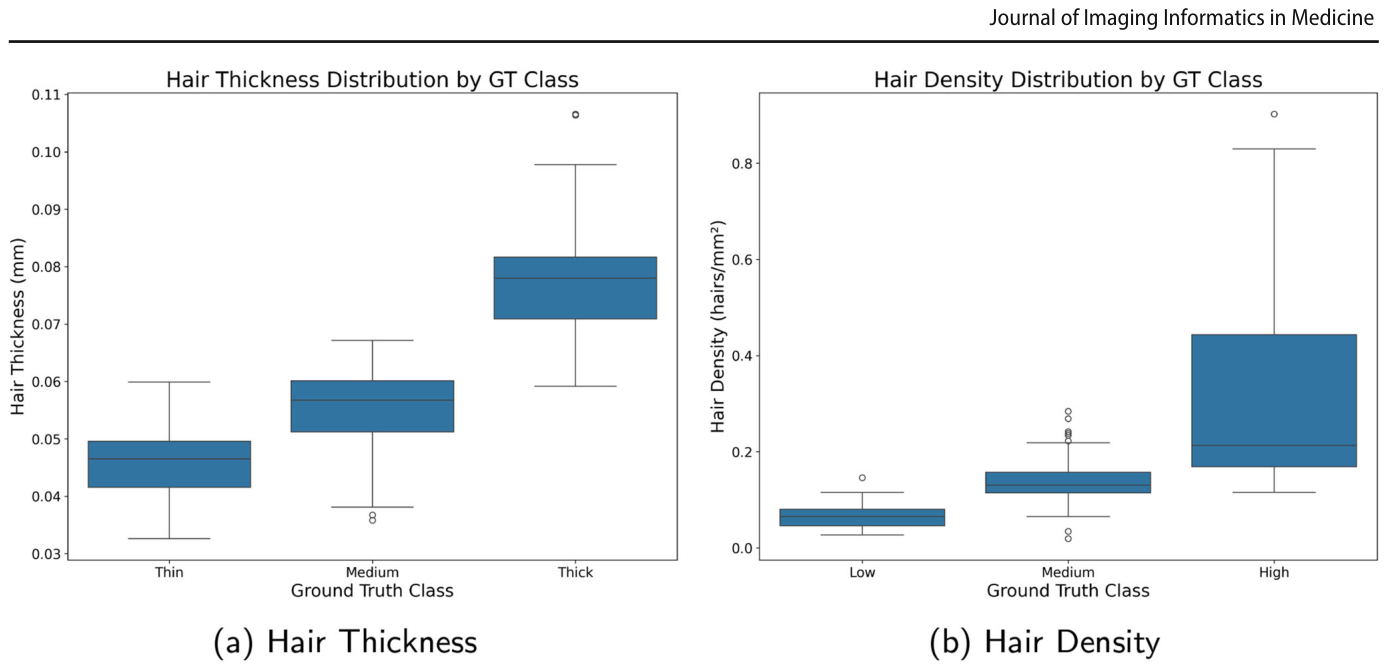
エラー分布を分析する混同行列からは、誤分類が主に隣接するクラス間で発生しており、極端なカテゴリ間の混同はゼロであることが示されました。毛髪の太さと密度の箱ひげ図では、モデルの連続的な測定値の分布が専門家が定義した順序付きカテゴリ全体で単調に増加していることが示され、数値出力がカテゴリと一貫してスケールしていることを示しています。
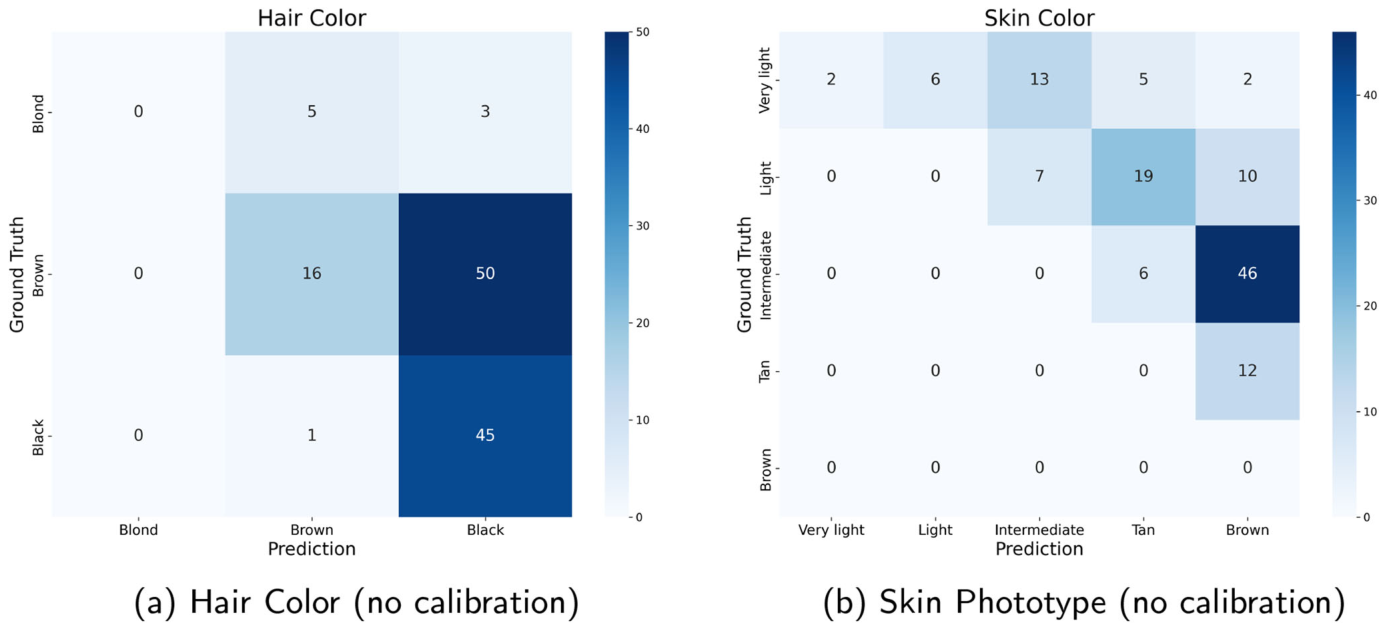
色校正段階の重要性を示すため、色校正を無効にして色依存の特徴を再評価するアブレーションスタディを実施したところ、性能が大幅に低下しました。色校正なしでは、皮膚フォトタイプ分類精度は72.7%からわずか1.6%に急落し、コーエンのカッパ係数は-0.096と、モデルの性能がランダムな機会よりも悪いことを示唆しました。同様に、毛髪の色精度は75.0%から50.8%に低下し、モデルは毛髪の大部分を誤って黒と分類しました。
研究の限界と今後の展望
本研究で提案されたパイプラインは、皮膚と毛髪のインターフェースの完全自動特性評価が技術的に実現可能であることを示しています。YOLOv9-C-DSEGインスタンスセグメンテーションモデルと校正された色処理パイプラインを組み合わせることで、生のマクロ画像と客観的な臨床特徴(皮膚フォトタイプ、毛髪密度、太さなど)との間のギャップをうまく埋めることができました。このシステムは、これらの特性の自動抽出を診断の初期段階として厳密に扱っており、特定の照射パラメータの直接的な推定は本研究の範囲外であり、将来の臨床検証の対象となります。しかし、これらの抽出された特徴は、専門家が安全な線量を計算するために必要とする主要なバイオマーカーであるため、この堅牢な特性評価は、その後の自動パラメータ化ワークフローに不可欠な基盤を提供します。現在の結果は非常に有望ですが、その臨床的適用性を確認するためには、より大規模なデータセットと管理された研究による広範な検証が必要です。今後の研究は、データ収集の規模拡大に焦点を当て、臨床集団の代表的な分布を網羅し、アノテーションの主観性とノイズを軽減するためのマルチ専門家コンセンサスプロトコルを組み込むことを目指します。また、自動特性評価が治療の安全性と個別化に与える実世界での影響を評価するための臨床試験を実施する予定です。現在の技術的限界に対処するため、将来の研究では、Mask R-CNNやアテンションベースのトランスフォーマーなど、代替のインスタンスセグメンテーションアーキテクチャを検討し、極めて微細な構造の境界線がさらに最適化できるかどうかを検証します。また、透明性や焦点ぼけによって引き起こされる非常に明るい毛髪や細い毛髪の誤分類を解決するために、太さに応じた毛髪の色分類フレームワークも検討されます。さらに、暗い肌の色調での検出を改善するために、代替の画像モダリティも評価されるとともに、自己校正型照明または改善された光学均一性の実装も行われます。最終的には、このアプローチは、適応性のある対象者固有のパラメータ化が可能な次世代インテリジェントレーザーシステム開発のための強力な基盤を確立します。
補足図表
Figure 9
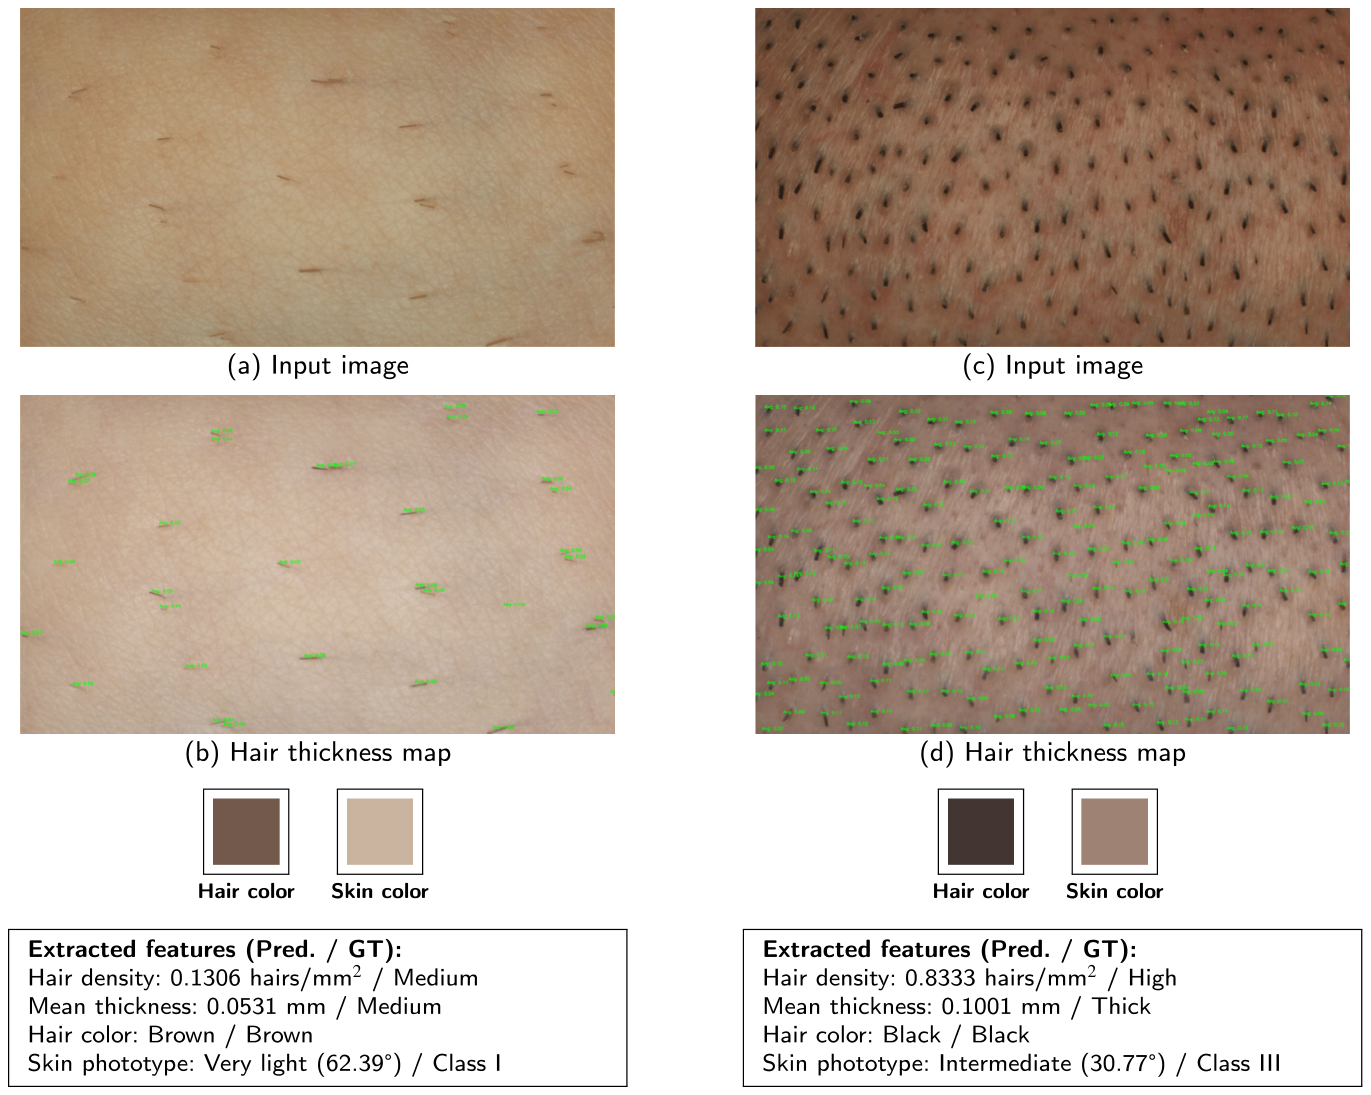
Table 7
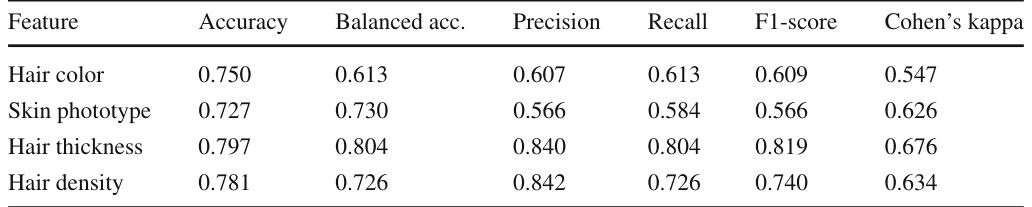
Table 8

用語集
- インスタンスセグメンテーション: 画像内で個々のオブジェクトの境界を特定し、それぞれを異なるインスタンスとして識別する画像処理技術です。
- YOLOv9: 画像内のオブジェクト検出とセグメンテーションを高速かつ高精度に行うための深層学習モデルアーキテクチャの一つです。
- マクロ画像: ダーモスコピー画像よりも広い視野で、肌の表面を拡大して撮影した画像で、実際の臨床治療に近い状態を再現します。
- フォトタイプ: 個人の肌の色調や紫外線への反応性を示す分類で、レーザー治療のパラメータ設定に重要な情報です。
- CIELAB色空間: 人間の視覚に基づいた知覚的に均一な色空間で、色を明度(L)、赤緑(a)、黄青(b*)の3つの軸で表現します。
- ITA (Individual Typology Angle): CIELAB色空間のLとb値から計算される、肌の色調を客観的かつ定量的に示す指標です。
- 分光測色計: 物体の反射率や透過率を波長ごとに測定し、正確な色情報を得るための装置です。
- カラーキャリブレーション: 画像取得装置の色表現を標準的な色空間に合わせることで、照明条件による色のばらつきを補正するプロセスです。
- mAP (mean Average Precision): オブジェクト検出やセグメンテーションモデルの性能を評価するための主要な指標の一つで、検出精度と再現率のバランスを示します。
- Diceスコア: 画像セグメンテーションの性能を評価する指標で、予測された領域と真の領域との重複度を測ります。値が1に近いほど高精度です。
- IoU (Intersection-over-Union): 予測された境界ボックスまたはセグメンテーションマスクと、実際の境界ボックスまたはマスクとの重複領域の割合を示す指標です。
- 距離変換: 二値画像内の各ピクセルについて、最も近い前景(または背景)ピクセルまでの距離を計算する画像処理技術です。
- 骨格化: 二値オブジェクトをその構造の中心線(骨格)に細くする画像処理技術で、オブジェクトの形状解析に用いられます。
コメントを残す