
アルツハイマー病MRI分類AIの公平性と信頼性を高める:バイアス対策と事後較正の最前線
解説対象論文: Improving the fairness and robustness of deep learning classification models through bias mitigation and post hoc calibration
International Journal of Computer Assisted Radiology and Surgery|被引用数: 0(2026年10月19日時点)
この研究は、構造MRIスキャンを用いたアルツハイマー病(AD)の深層学習モデルにおいて、年齢に関連するバイアスと信頼性の低い確率推定という2つの主要な課題を解決し、モデルの公平性と臨床的適用性を向上させることを目的としました。年齢不変の予測を維持しつつ診断精度を保つためのモデル内バイアス軽減戦略と、多様な対象者集団における予測確率の信頼性、解釈可能性、臨床的有用性を改善するための事後較正手法を体系的に評価しました。
はじめに:医療AIの課題とアルツハイマー病診断
どうも、Beyond the Pixelです。医療画像インフォマティクス分野において、人工知能(AI)、特に深層学習(Deep Learning: DL)は、その強力なデータ解析能力により、医療画像診断に革命をもたらす可能性を秘めています。脳の構造と機能を高解像度で捉えることができる磁気共鳴画像法(MRI)は、アルツハイマー病(AD)のような神経変性疾患の早期発見に不可欠なツールです。近年、深層学習モデルはMRI画像解析を通じてADの予測と診断において目覚ましい進歩を遂げ、時には専門家を上回る精度を示すこともあります。しかし、これらのモデルが医療現場に導入されるにつれて、その信頼性と公平性に関する懸念も高まっています。特に、現実世界の医療データで訓練されたモデルは、意図せず人口統計学的交絡因子(Confounders)を学習し、特定の対象者グループ間で偏った予測(Bias)をしてしまう可能性があります。アルツハイマー病の分類においては、年齢が最も重要な危険因子であるため、健康な脳の老化に伴う構造的変化がADの病変と重複することがあり、モデルが疾患特異的な特徴ではなく、正常な老化パターンに依存してしまう危険性があります。また、深層学習モデルが生成する確率推定値の信頼性も課題です。モデルが出力する「病気の可能性」を示すスコアは、しばしば真の統計的確率を反映しておらず、その信頼性を高める「較正(Calibration)」が必要とされています。本研究は、これら二つの主要な課題、すなわち年齢に関連するバイアスと信頼性の低い確率推定に対処し、深層学習モデルの公平性と臨床的適用性を向上させることを目的としています。
研究の目的:深層学習モデルの公平性と信頼性向上
この研究の主要な目的は、構造MRIスキャンからアルツハイマー病(AD)を分類するための深層学習モデルの公平性と臨床応用性を高めることでした。そのために、主に二つの課題に焦点を当てました。一つは「年齢に関連するバイアス」の克服であり、もう一つは「信頼性の低い確率推定」の改善です。具体的には、診断精度を維持しながら、年齢に左右されない予測を達成するための「モデル内バイアス軽減戦略(In-processing debiasing strategies)」を詳細に調査しました。これは、モデルの学習過程においてバイアスを除去するアプローチです。さらに、多様な対象者集団において、予測された確率の「信頼性(Reliability)」、「解釈可能性(Interpretability)」、および「臨床的有用性(Clinical usefulness)」を向上させるための「事後較正(Post hoc calibration)手法」を体系的に評価しました。事後較正とは、モデルが予測を行った後にその確率を調整する手法です。これらの取り組みにより、深層学習モデルが単に高い予測精度を持つだけでなく、臨床現場で真に信頼され、公平に利用されるための基盤を築くことを目指しました。
研究手法:データとモデル開発
本研究では、深層学習モデルの公平性とロバスト性(Robustness: 頑健性)を向上させるために、複数のアプローチが採用されました。
3.1. MRIデータセット
研究では、構造MRIデータが使用されました。このデータは、3つの独立した大規模コホート、すなわち「ADNI(Alzheimer’s Disease Neuroimaging Initiative)」、「AIBL(Australian Imaging, Biomarker & Lifestyle Flagship Study of Ageing)」、および「DELCODE(German Center for Neurodegenerative Diseases Multicenter Observational Study on Longitudinal Cognitive Impairment and Dementia)」から収集されました。すべてのMRIスキャンは、標準化された前処理パイプラインを使用して処理され、一貫性が確保されました。モデルへの入力は、T1強調MRIスキャンから導出された全脳のボクセル単位の灰白質確率マップでした。この研究では、年齢がモデル内で明示的に対処された唯一の交絡変数でした。モデル訓練には軽度認知障害(MCI)の対象者もADグループに含め、その後の評価ではADと組み合わせて性能を評価しました。
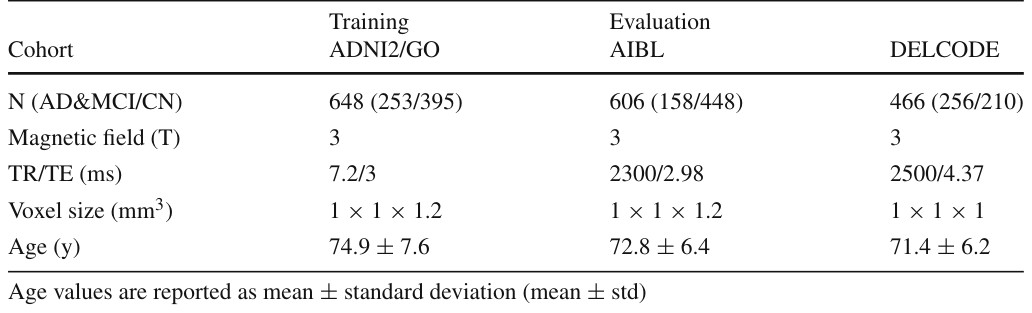
は、参加者の人口統計学的情報とMRI取得の詳細を示しています。
3.2. バイアス軽減戦略
年齢に関連するバイアスに対処するため、共通の3D畳み込みニューラルネットワーク(CNN)フレームワーク内で3つの分類モデルが開発されました。
- ベースラインCNNモデル: これは、4つの畳み込みブロックを持つ3D CNNで構成されており、バッチ正規化(Batch Normalization)、ReLU活性化関数(ReLU activation)、最大プーリング(Max Pooling)が使用されています。バイアス軽減は適用されておらず、他のバイアス軽減戦略との比較のための参照モデルとして機能します。
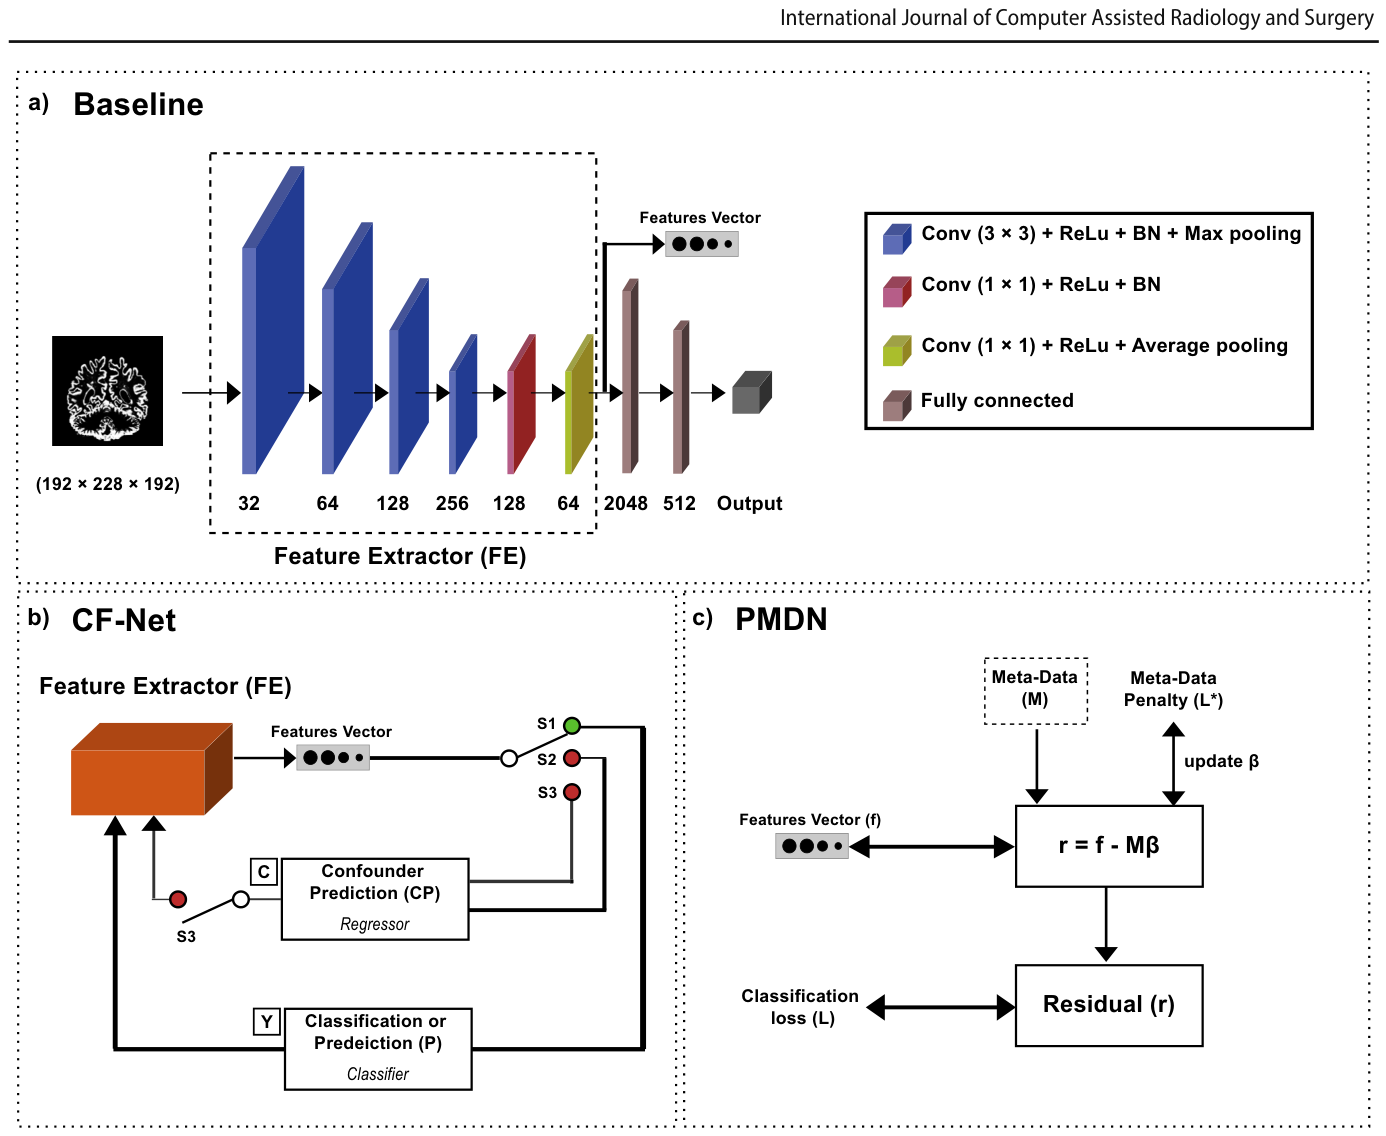
Figure 1. Fig. 1 Overview of model architectures. a Baseline: CNN extracts fea- tures from brain images. b CF-Net: Training occurs in three phases. Phase I is dedicated to prediction module, Phase 2 activates the con-解説: 図1は、モデルのアーキテクチャの概要を示しています。a)はベースラインCNNモデルの構成で、脳画像から特徴を抽出します。b)はCF-Netの訓練フェーズを示しており、予測モジュール、交絡因子予測モジュール、および最終的な共同訓練の相互作用から構成されます。c)はPMDNの概念で、特徴からメタデータが残差化される様子が描かれています。 のa)に示されています。
- CF-Net(Adversarial Confounder-Free Network): このアプローチは、敵対的訓練(Adversarial Training)を通じて、交絡変数(この場合は年齢)に不変な特徴表現を学習するモデル内デバイアス手法です。モデルは、特徴抽出器(FE)、分類器(P)、および交絡因子予測器(CP)の3つのコンポーネントで構成されます。特徴抽出器が生成した特徴ベクトルは、分類器によってターゲットラベル(ADの有無)の予測に使用されると同時に、交絡因子予測器は同じ特徴から交絡因子(年齢)を予測しようとします。訓練はミニマックス目的関数に基づいて行われ、特徴と交絡因子間の統計的独立性を強制します。(図1)のb)にそのアーキテクチャが描かれています。
- PMDN(Penalty-based Metadata Normalization): この戦略もモデル内デバイアス手法であり、ネットワークの特徴空間において交絡因子の影響を直接「残差化(Residualizing)」することで、不変な特徴表現を達成します。PMDNは、交絡効果を一般線形モデル(GLM)として扱い、特徴ベクトルから交絡因子によって説明される部分を差し引いた残差(交絡因子を含まない特徴)を使用します。元の手法の問題点であったバッチごとの不安定性を、微分可能な二段階最適化問題として定式化することで解決し、安定した収束を保証します。(図1)のc)にPMDNの概念が示されています。
3.3. 事後較正手法
較正の目的で、セクション3.2で述べたCNNベースラインモデルの出力に4つの較正手法が適用されました。
- パラメトリック較正: ロジスティック回帰(Logistic Regression)とプロビット回帰(Probit Regression)の2つが使用されました。これらは、生のモデル出力スコアを、真のラベルのよく較正された確率推定値に変換する手法です。
- ノンパラメトリック較正: ベイズビンニング(Bayesian Binning into Quantiles: BBQ)とアイソトニック回帰(Isotonic Regression)の2つが使用されました。これらの手法は特定のパラメトリック形式を仮定せず、データに基づいて較正された確率を推定します。特にアイソトニック回帰は、生スコアを較正された確率にマッピングする単調非減少の区分的定数関数をフィッティングします。
3.4. 評価基準
提案された戦略の性能を評価するために、真陽性(TP)、真陰性(TN)、偽陽性(FP)、偽陰性(FN)の数が計算されました。これらに基づいて、分類性能と確率較正の両方を評価するための複数の評価指標が算出されました。具体的には、感度(Sensitivity)、特異度(Specificity)、精度(Accuracy)、F1スコア(F1-score)、Brierスコア(Brier Score)、予測較正誤差(Expected Calibration Error: ECE)、最大較正誤差(Maximum Calibration Error: MCE)が用いられました。また、受信者操作特性(ROC)曲線と対応する曲線下面積(AUC)も評価されました。Brierスコアは確率予測の正確さを測り、値が低いほど較正が良好であることを示します。ECEとMCEは、予測された確信度と観測された精度との間の平均および最大絶対偏差を測定し、較正の質を評価します。
結果:優れた性能、バイアス軽減、較正効果
本研究では、深層学習モデルのバイアス軽減と事後較正の効果を詳細に評価しました。
4.1. 分類性能
ADNIデータで訓練された3つのモデル(ベースライン、CF-Net、PMDN)は、外部コホート(AIBL + DELCODE)で評価されました。
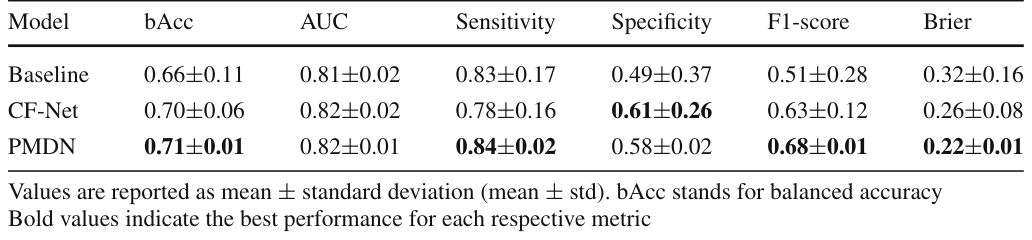
は、テストデータセットにおける各モデルの診断性能(平均±標準偏差)を示しています。PMDNは最も高い均衡精度(Balanced Accuracy)0.71±0.01を達成し、ベースライン(0.66±0.11)およびCF-Net(0.70±0.06)を上回りました。特筆すべきは、PMDNのばらつき(標準偏差<0.02)がベースラインの約10分の1、CF-Netの約5分の1と非常に低かったことです。これは、PMDNがクロスバリデーションフォールド間で一貫した学習挙動を示すことを示唆しています。また、PMDNは最も低いBrierスコア0.22±0.01を達成し、優れた確率較正を示しました。AUC値はすべてのモデルで同程度でした(CF-Netが0.82±0.02、PMDNが0.82±0.01)。
4.2. 年齢バイアス評価
デバイアス(Debiasing: バイアス軽減)が年齢依存の予測を減少させるかどうかを評価するため、年齢と予測されたADロジット(Logit: ロジスティック回帰モデルの出力層での生の出力スコア)との関連性が調査されました。
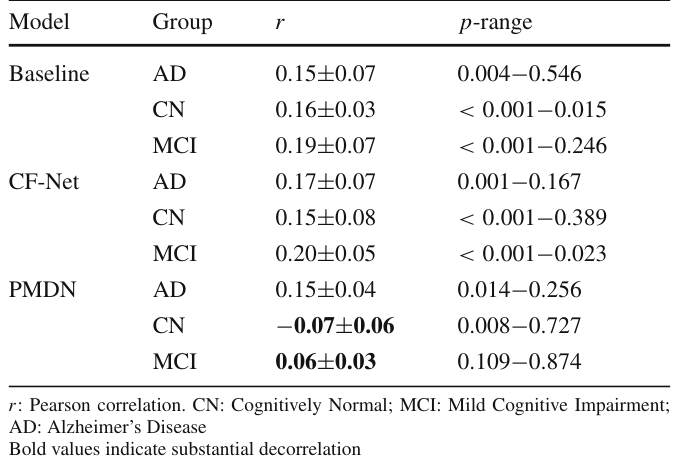
は、外部テストセットにおける年齢とモデル出力の関連性を示しています。ベースラインモデルは、認知正常(CN)群(r = 0.16±0.03)において年齢と予測ロジットの間に一貫した正の相関を示しました。これは、デバイアスがない場合、高齢の認知正常者に体系的に高いADリスクが割り当てられることを意味します。CF-Netもベースラインモデルと同程度の平均相関を示しましたが、ばらつきが大きかったため、敵対的訓練による年齢関連バイアスの軽減は部分的かつ不安定であることが示唆されました。対照的に、PMDNはこの関連性をほぼゼロに減少させました(CN: r = -0.07±0.06)。特に軽度認知障害(MCI)群において、デバイアス戦略間の最も明確な違いが見られました。ベースラインモデル(MCI: r = 0.19±0.07)とCF-Net(MCI: r = 0.20±0.05)は、年齢依存性が強く残存していましたが、PMDNはMCI群においてほぼゼロの相関(MCI: r = 0.06±0.03)を達成し、年齢に起因する交絡因子の効果をうまく除去できたことを示しています。しかし、アルツハイマー病(AD)群では、年齢関連の関連性が3つのモデルすべてで持続しました。
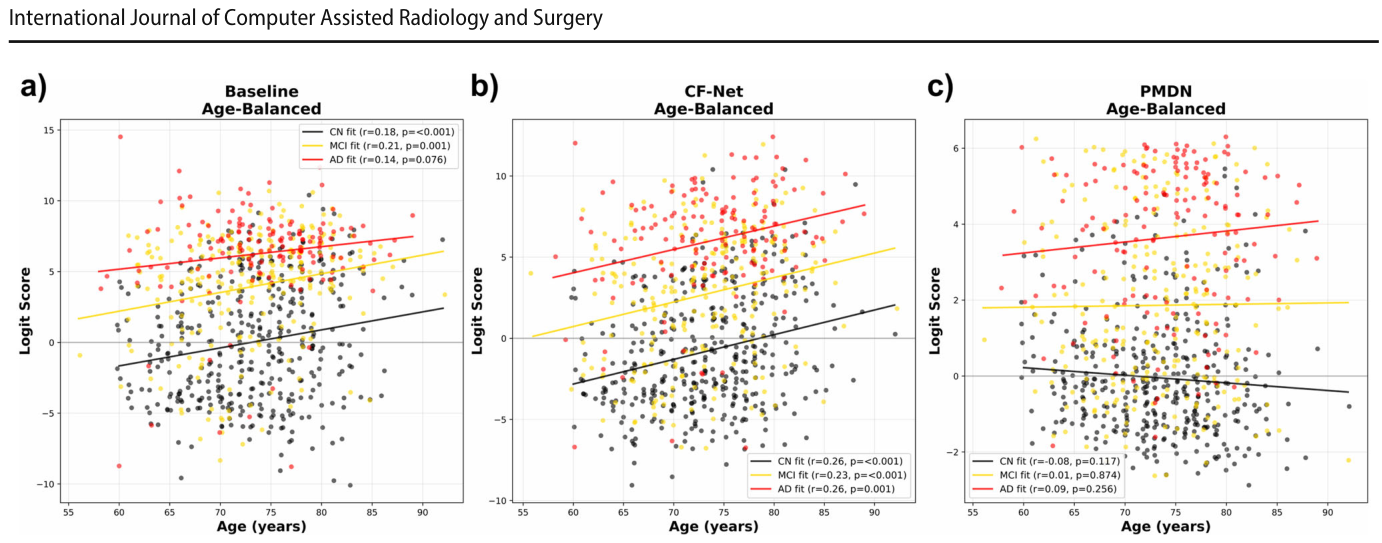
はこれらの関係を図で示しており、PMDNがCN対象者でほぼ水平な回帰直線、MCIで最小限の年齢勾配を示すのに対し、ベースラインとCF-NetではMCI対象者で陽性の勾配が観察され、高齢者には真の診断に関わらず高いADリスクロジットが割り当てられていました。
4.3. 事後較正
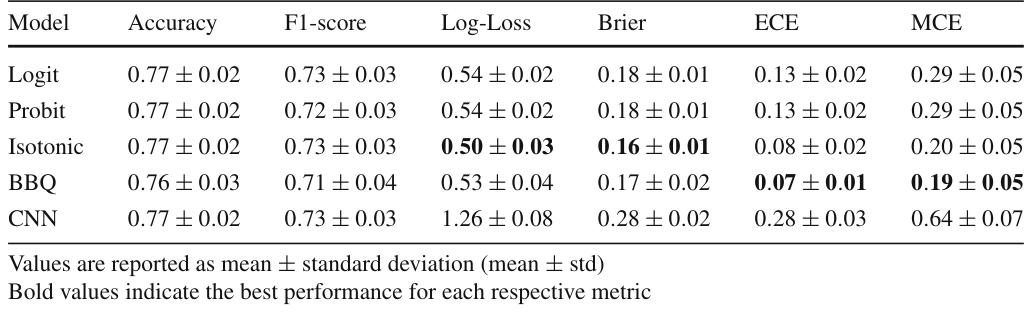
は、4つの較正手法(ロジスティック、プロビット、アイソトニック、BBQ)と未較正のCNN出力の性能比較を示しています。全体の分類性能(精度約0.77、F1スコア約0.73)は、すべての手法でほぼ安定していました。較正特有の指標では、より顕著な違いが見られました。未較正のCNN出力は最大の較正誤差(ECE = 0.28、MCE = 0.64)を示しました。パラメトリック手法(ロジスティック回帰とプロビット回帰)は中程度の改善(ECE約0.13、MCE約0.29)をもたらしました。ノンパラメトリックアプローチ、特にアイソトニック回帰とベイズビンニング(BBQ)は、最も低い較正誤差(ECE約0.07-0.08、MCE約0.19-0.20)を達成し、較正プロット(
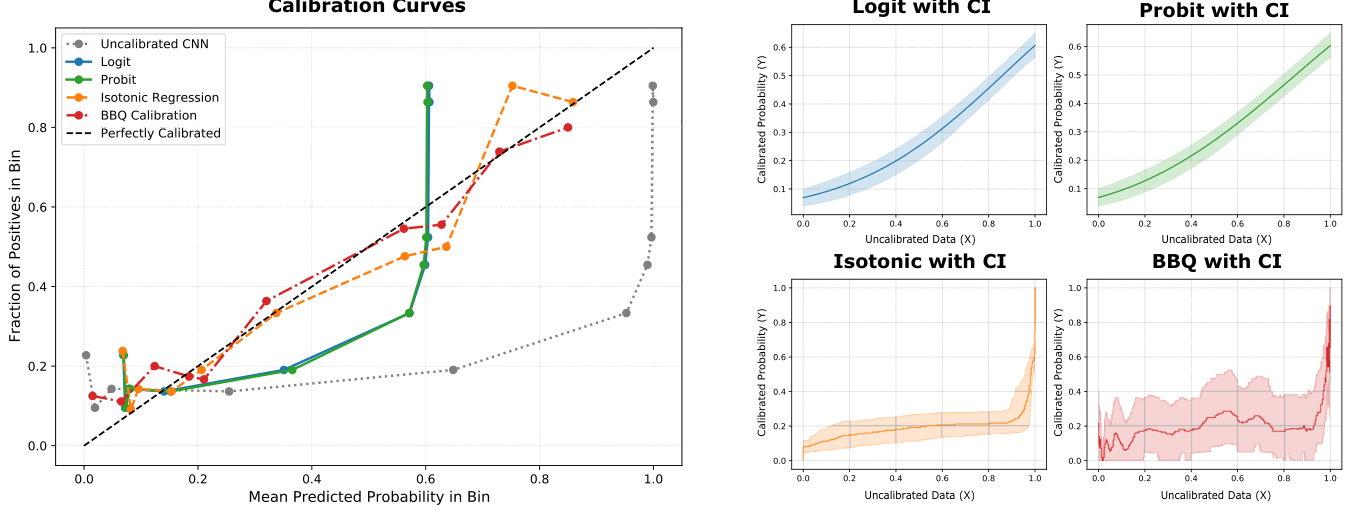
a)参照)で良好な一致を示しました。特にアイソトニック回帰は、最も低いLog-Loss(0.50)とBrierスコア(0.16)を達成し、信頼性の高い確率推定に貢献しました。(図3)b)は、較正された確率推定値とその信頼区間の比較を示しています。
考察:PMDNの有効性と較正の意義
この研究から、深層学習モデルは分類性能が同程度であっても、較正、安定性、公平性の点で大きく異なることが明らかになりました。PMDNは、より高い均衡精度とF1スコア、低いばらつき、そして最も信頼性の高い確率推定値(最も低いBrierスコア)を継続的に達成しました。特にPMDNは、認知正常(CN)および軽度認知障害(MCI)の対象者において、年齢と予測されるADロジットとの関連性を大幅に弱めました。これは、明示的な残差化(Residualization)が交絡因子に関連する分散をより効果的に除去し、モデルが疾患関連の特徴に集中できるようにすることを示唆しています。PMDNとCF-Netの性能差は、それぞれの根底にある最適化戦略に起因すると考えられます。PMDNは、一般線形モデル(GLM)に基づく確定的な補正を適用して、交絡因子によって説明される分散を除去し、安定した一貫性のある特徴表現を生成します。一方、敵対的訓練は競合する目的を持つミニマックス最適化に依存するため、不完全な収束や残存する交絡因子が生じる可能性があります。この不安定性がCF-Netの可変的な性能と効果の低いバイアス軽減を説明しています。臨床的には、これらの知見は、年齢と疾患に関連する構造的変化が重複するMCI集団にとって特に重要です。年齢を代理リスクとして利用するモデルは、高齢の対象者において疾患確率を過大評価する可能性がありますが、PMDNは年齢に不変な予測を強制し、よりよく較正された確率推定を提供します。重要な点は、アルツハイマー病(AD)群では、年齢に関連する予測バイアスが他のグループほど明確には軽減されなかったことです。これは、ADの対象者では年齢に関連する脳の変化と疾患に関連する神経変性が大きく重複しているため、確立された病理の存在下で年齢関連のシグナルと疾患特異的なシグナルを分離することがより困難であることを反映している可能性があります。事後較正は、モデルの識別能力を維持しつつ、予測される確率の信頼性を主に向上させました。単調なアプローチ(ロジット、プロビット、アイソトニック回帰)は滑らかで信頼性の高い較正曲線を生み出しましたが、BBQのような非単調な方法は不規則性を導入しました。パラメトリック手法は安定していますが柔軟性に欠け、ノンパラメトリック手法は局所的な変動を捉えることができますが、ばらつきが増加する可能性があります。
結論と今後の展望
本研究では、アルツハイマー病分類における年齢関連バイアスを軽減するための2つのアプローチ、PMDNとCF-Net、およびモデル予測の信頼性を向上させるための事後較正手法を調査しました。PMDNは、ベースラインモデルやCF-Netと比較して、同等または改善された識別性能を示し、評価全体でより高い安定性を実証しました。特に重要なのは、PMDNが認知正常(CN)および軽度認知障害(MCI)の対象者において年齢関連の関連性を大幅に弱めたことです。ただし、アルツハイマー病(AD)群では年齢関連の関連性が残存しました。対照的に、CF-Netは年齢関連の関連性の軽減において一貫性に欠け、ばらつきが大きかったという結果でした。事後較正は、分類性能を大きく損なうことなく、予測される確率の信頼性をさらに向上させ、特にアイソトニック回帰が最も好ましい較正結果を達成しました。今後の研究では、いくつかの限界に対処する必要があります。第一に、本分析は年齢を単一の交絡因子として扱いましたが、性別、スキャナーの種類、施設効果など、他の因子もモデル予測に影響を与える可能性があります。第二に、神経画像データの高次元性に対してデータセットのサイズが限られており、深層学習ネットワークのロバスト性や汎用性に影響を与える可能性があります。第三に、敵対的訓練はより長い、またはより注意深く調整された最適化から恩恵を受ける可能性があり、本研究での性能がその潜在能力を完全に表しているとは限りません。将来の研究では、これらのアプローチを多交絡因子設定、より大規模で多様なコホート、そして海馬や内側側頭葉の測定値など、疾患に焦点を当てた領域入力に拡張することが重要です。疾患に特化した解剖学的マーカーへの依存を促進し、広範な年齢関連構造変化の影響を軽減できる可能性があります。疾患に焦点を当てた領域表現と明示的な交絡因子モデリングを組み合わせることで、年齢に対する頑健性を向上させつつ、疾患関連情報を維持するための追加戦略となるでしょう。これらの知見が、臨床応用の可能性を評価するために、より大規模で多様なコホートでのさらなる検証が不可欠です。
用語集
- 深層学習(DL): 人間の脳のデータ処理メカニズムにヒントを得た人工知能の一分野。
- 構造MRIスキャン: 脳の形態を高解像度で捉える画像診断技術。
- 交絡因子: モデルの予測に意図せず影響を与える可能性のある変数(例: 年齢)。
- バイアス軽減: モデルの予測における不公平な偏りを減らす手法。
- 事後較正: モデルが出力する確率推定値の信頼性を、予測後に調整する手法。
- 敵対的訓練(CF-Net): モデルが交絡因子に不変な特徴を学習するよう、敵対的なプロセスを用いる訓練方法。
- GLMベースの特徴残差化(PMDN): 一般線形モデル(GLM)を用いて、特徴空間から交絡因子の影響を直接除去する手法。
- 均衡精度(Balanced Accuracy): 各クラスのサンプル数に偏りがある場合でも、分類性能を公平に評価する指標。
- Brierスコア: 確率予測の正確さを測る指標で、値が低いほど予測と実際の観測が一致していることを示す。
- 較正誤差(ECE, MCE): 予測確率と実際の観測頻度との間のずれを定量化する指標。
- ロジット: ロジスティック回帰モデルの出力層で、生の出力スコア。
- アイソトニック回帰: 予測スコアを較正された確率に変換する、単調非減少の区分的定数関数をフィッティングするノンパラメトリック較正手法。
- ベイズビンニング(BBQ): モデルの出力を分位点に基づいてビンに分け、ベイズ的手法で確率を推定するノンパラメトリック較正手法。
- AUC: ROC曲線の下面積で、分類モデルの識別能力を評価する指標。値が高いほど良好。
- 畳み込みニューラルネットワーク(CNN): 画像認識などで用いられる深層学習モデルの一種。
- ReLU活性化関数: ニューラルネットワークで使われる活性化関数の一つで、負の値をゼロにする。
- バッチ正規化: ニューラルネットワークの訓練を安定化・高速化する手法。
- 最大プーリング: 画像などの特徴マップを縮小する操作。
- F1スコア: 精度と再現率の調和平均で、分類性能を評価する指標。
コメントを残す