
脳小血管病マーカーePVSの長期追跡を革新する深層学習Long-PVSUNet
解説対象論文: Long-PVSUNet: A Longitudinal Deep Learning Framework for Count-Oriented Perivascular Space Segmentation in Brain MRI
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月6日時点)
拡大血管周囲腔(ePVS)は、脳の小血管病や脳の老化を示すMRIで可視化される微細なマーカーです。その小ささ、低コントラスト、そして前景と背景の深刻な不均衡により、自動セグメンテーションは非常に困難でした。これまでの手法は主に横断的なものであり、経時的な一貫性をモデル化していなかったため、長期的な変化を追跡する上での有用性が限られていました。今回ご紹介するLong-PVSUNetは、ベースラインとフォローアップのT1強調画像およびFLAIR MRIのペアを用いた、数に基づくePVSセグメンテーションのための2時点フレームワークです。このモデルは、ベースライン情報に基づくアテンション融合と不均衡を考慮した学習を用いることで、この課題を克服します。
拡大血管周囲腔(ePVS)とは?その課題とLong-PVSUNetの登場
どうも、Beyond the Pixelです。今回は、脳の健康状態を評価する上で重要な役割を果たす「拡大血管周囲腔(ePVS)」という微細な構造に着目した最先端の深層学習フレームワーク「Long-PVSUNet」についてご紹介します。ePVSは、脳の小血管病や老化の兆候としてMRIで確認できる小さなマーカーですが、その検出と定量化は非常に難しい課題でした。ePVSはサイズが小さく、周囲とのコントラストが低い上、画像におけるePVSの領域(前景)とそれ以外の領域(背景)の間に深刻な不均衡があるため、従来の自動セグメンテーション(画像中の特定の領域を識別する技術)では困難が伴いました。さらに、既存の多くの手法は単一時点の画像データに焦点を当てた「横断的」な解析に留まり、時間経過に伴うePVSの変化を追跡する「縦断的」な解析には不向きでした。
このような背景から、ePVSのサイズ、低コントラスト、そして前景と背景の不均衡といった課題を克服し、長期的な変化を追跡できる高精度な自動セグメンテーション手法が求められていました。本研究で開発されたLong-PVSUNetは、ベースライン(研究開始時点のデータ)とフォローアップ(追跡調査時のデータ)のMRI画像をペアで解析する2時点フレームワークです。これは、ベースライン情報に基づくアテンション融合(関連性の高い部分に焦点を当てて情報を組み合わせる技術)と、不均衡を考慮した学習を用いることで、この困難な課題に挑みました。
この研究の主な貢献は以下の3点に集約されます。
1. ベースライン誘導型チャネル別アテンション融合を採用し、時間的に一貫性のある縦断的ePVSセグメンテーションを実現する「Long-PVSUNet」フレームワーク。ePVSに特有の極端な画素レベルおよびサンプルレベルのスパース性(データがまばらであること)に対応する、不均衡を考慮した損失関数群(AFDL、ASL)を導入しました。
2. 横断的U-Netベースラインモデルと、既存の縦断的ベンチマークモデルとの比較を含む体系的な評価プロトコル。UK Biobank、ADNI、MASの各コホートで評価を行い、モデルから導出された縦断的ePVS進行と高血圧との関連を検証する探索的解析も実施しました。
3. 再現性のある縦断的ePVSセグメンテーション研究を支援するための、専門家によるアノテーション付きベースライン/フォローアップのBG(基底核)およびCSO(半卵円中心)のePVSデータとソースコードの公開。
Long-PVSUNetの革新的なアーキテクチャと不均衡への対応
Long-PVSUNetは、従来のU-Netアーキテクチャを縦断的解析のために拡張したものです。標準的なU-Netは、マルチスケールの画像特徴を抽出するエンコーダ(特徴抽出器)と、抽出された特徴から画素ごとのセグメンテーションマップを再構築するデコーダ(再構築器)で構成されています。しかし、このU-Netを単独で各スキャンに適用すると、ベースラインとフォローアップ画像間の関係性が明示的にモデル化されず、微妙なePVSの経時的変化の検出が困難になるという課題がありました。
Long-PVSUNetは、この限界を克服するために、ペアになったベースラインとフォローアップのMRI画像に対応するよう設計されています。このモデルは、両方のスキャンから比較可能な特徴表現を抽出するための「共有エンコーダ」と、ベースラインおよびフォローアップのセグメンテーションマスクを個別に生成するための「時点特化型デコーダ」を採用しています。さらに、ベースライン由来の特徴をフォローアップのセグメンテーションに組み込むための「アテンションベースの時系列融合」メカニズムを導入しています。この設計により、U-Netが小さな構造を正確に局所化する能力を維持しつつ、対象者固有のベースライン解剖学的情報がフォローアップのセグメンテーションをガイドし、真の縦断的変化を捉えることを可能にしています。
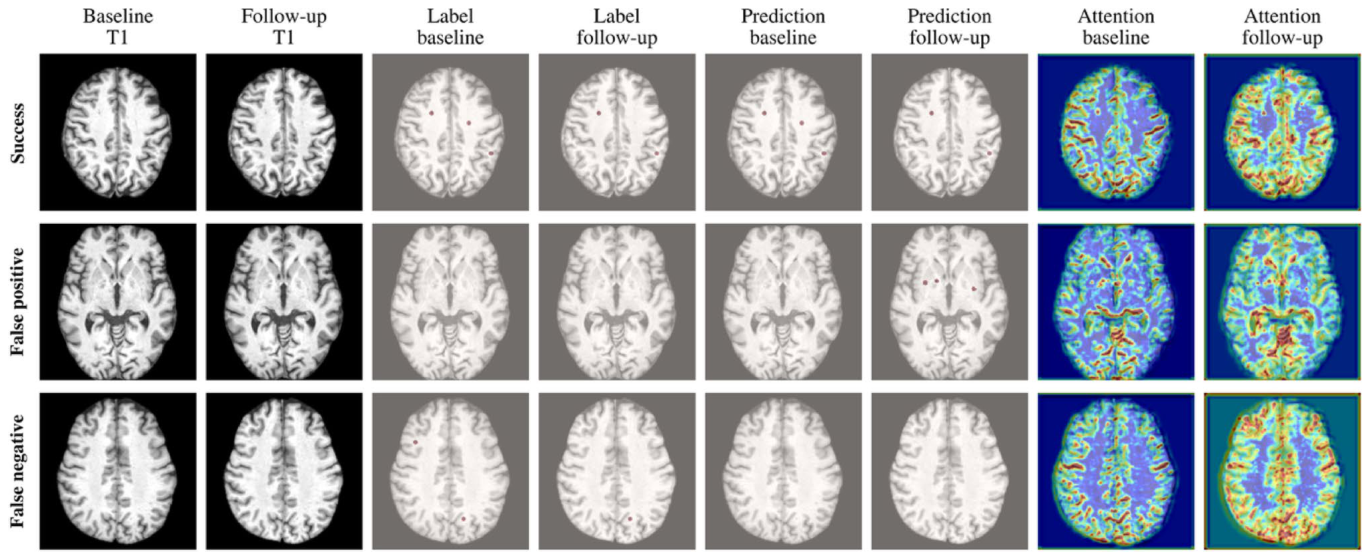
ePVSのセグメンテーションでは、「画素レベルの不均衡」と「サンプルレベルの不均衡」という深刻な課題に直面します。ePVSは脳の画素の1%未満しか占めず、ほとんどのスキャンにはePVSがほとんど、あるいは全く見られないため、標準的な交差エントロピーベースの損失関数では、モデルが圧倒的に多い背景クラスに偏ってしまう傾向があります。このクラス不均衡に対処するため、本研究では以下の不均衡を考慮した損失関数を評価しました。
- DiceCE損失(ベースライン): 画素ごとの交差エントロピー損失とDiceオーバーラップ項を組み合わせた標準的な損失関数です。
- 補助的な前景Dice損失(AFDL): 最適化を病変クラスのみに集中させるために、追加された前景Dice損失項です。
- 非対称損失(ASL): 陽性画素と陰性画素に対して異なる集中パラメータを導入し、背景画素の重みを軽減する損失関数です。
これらの損失関数は、ePVSの極端なクラス不均衡下での最適化を改善し、特に小さなePVS病変に対する感度を高めることを目指しました。
大規模データセットによる検証と前処理の徹底
Long-PVSUNetの性能と汎用性を検証するため、本研究では以下の3つの独立した大規模コホートのデータセットを使用しました。
1. UK Biobank(UKB): 4568名の対象者から、約2.61年±1.02の間隔で取得されたT1強調画像とFLAIR MRIのペアデータを使用しました。画像は3TシーメンスSkyraプロトコルで取得されています。
2. ADNI(Alzheimer’s Disease Neuroimaging Initiative): 277名の対象者から、約3.04年±0.90の間隔で取得されたT1強調画像とFLAIR MRIのペアデータを使用しました。診断グループに関わらず、複数のスキャナーサイトから3Tスキャナーで取得されています。
3. MAS(Sydney Memory and Ageing Study): 403名の対象者から、約2.39年±1.19の間隔で取得されたT1強調画像とFLAIR MRIのペアデータを使用しました。フィリップス3T Achievaスキャナーで取得されています。
これらのコホートの対象者属性は以下の表にまとめられています。
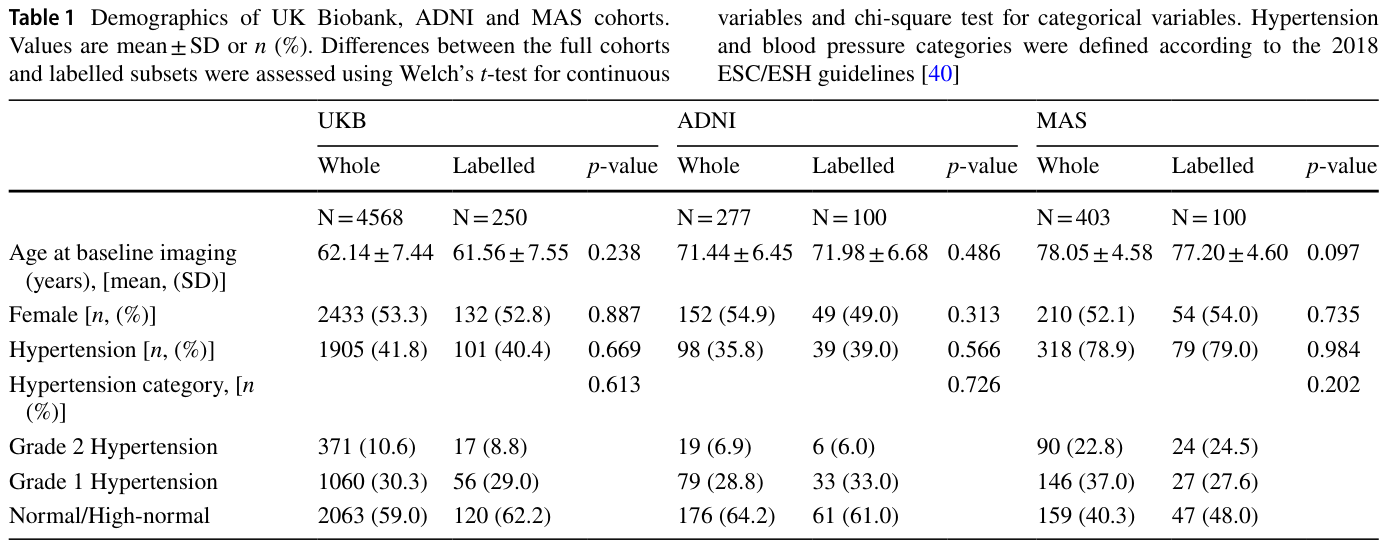
モデル開発と検証のために、UK Biobankから250名、ADNIから100名、MASから100名の対象者のラベル付きサブセットが用意されました。全ての研究は、それぞれの施設の倫理承認を得て実施され、参加者からは書面によるインフォームドコンセントが取得されています。
MRIスキャンデータは、空間的および強度の一貫性を確保するために、以下のような前処理が施されました(
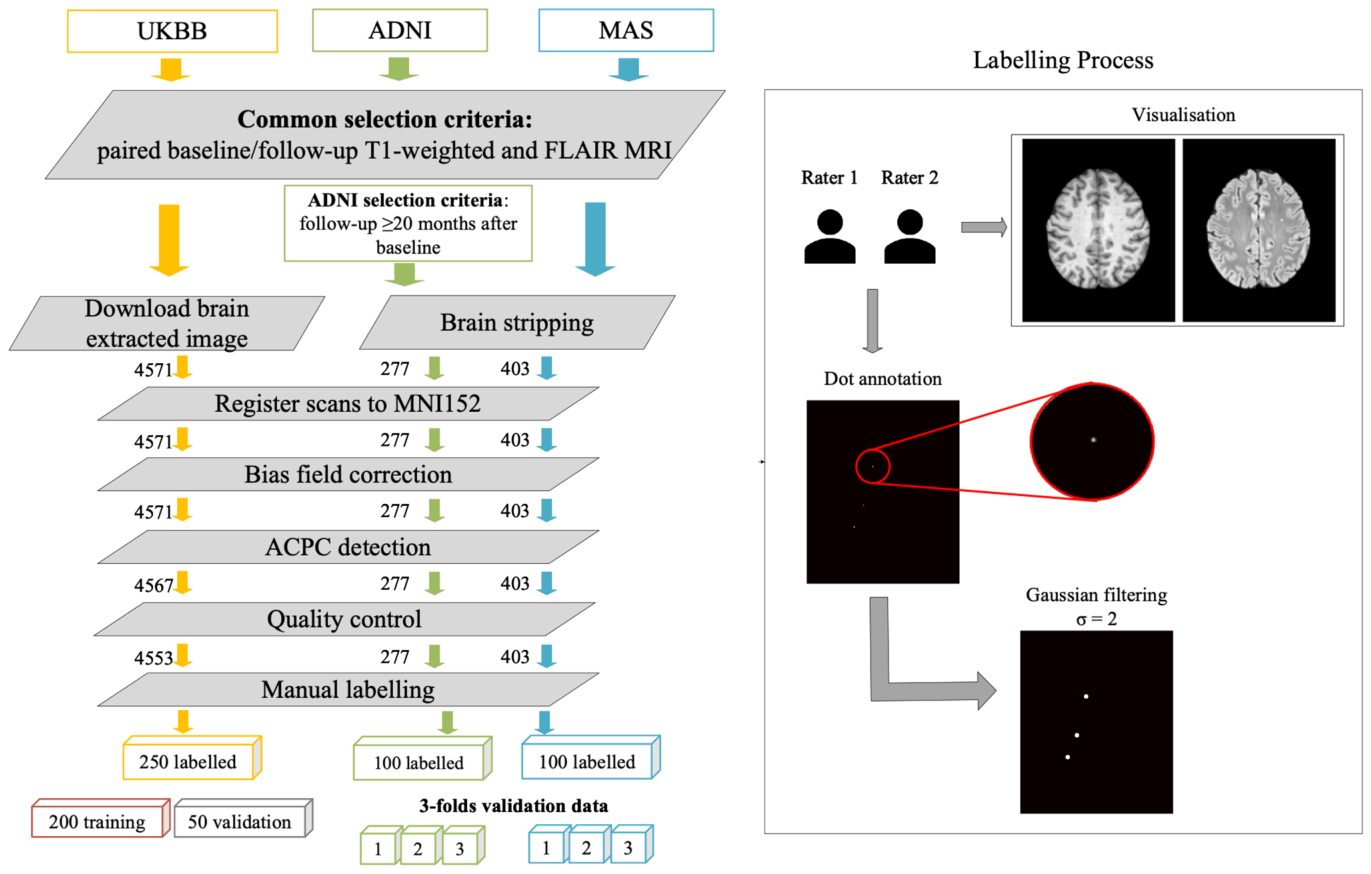
)。
* 脳抽出: 脳領域のみを抽出します。
* FLAIRからT1への剛体位置合わせ: FLAIR画像をT1強調画像に厳密に位置合わせします。
* フォローアップからベースラインへの位置合わせ: フォローアップ画像をベースライン画像に位置合わせします。
* MNI152空間への変換: 異なる対象者の脳画像を共通の標準的な空間に合わせます。
* N4バイアス補正: MRI画像に生じる不均一な輝度分布を補正します。
* AC-PC検出: 前交連-後交連ライン(脳の解剖学的ランドマーク)を自動で検出します。
ePVSのセグメンテーション領域は、先行研究に従い、ACラインから2mm上と37mm上のスライスで基底核(BG)と半卵円中心(CSO)に局所化されました。最終的に前処理された画像は、1×1×1 mm3の解像度を持ちます。
手動アノテーション
本研究では、各ePVS病変の中心付近に単一の点をマークする「ドットアノテーション」という弱教師あり学習戦略を採用しました。2名の訓練されたニューロイメージング専門家によって手動アノテーションが行われ、BGで0.840、CSOで0.832という高い評価者間信頼性(ICC)を示しました。最終的なアノテーションは、両評価者間の合意によって決定されました。
トレーニング設定とデータ拡張
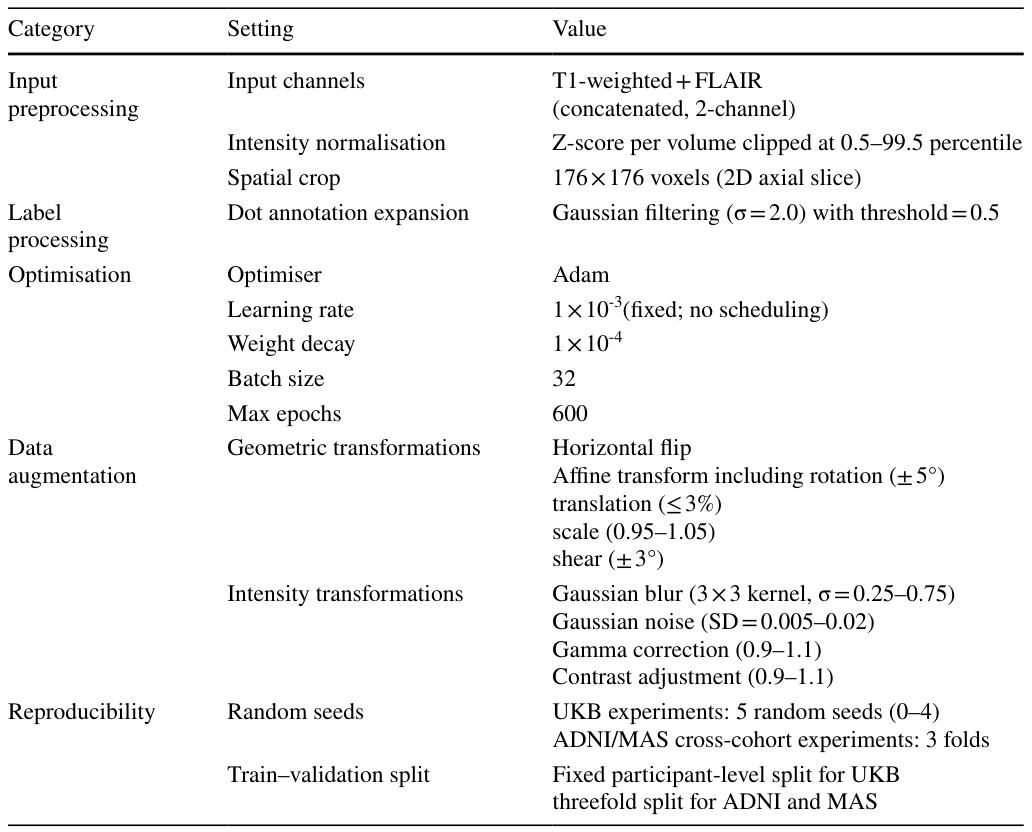
全てのモデルは、強度正規化と空間的クロッピング後のペアになった2D軸位T1強調画像とFLAIR画像を結合したものを入力として使用しました。ドットアノテーションは、Gaussianフィルタリング(σ=2.0、閾値=0.5)を用いて拡張され、画素ごとの弱い教師データとして機能しました。BGとCSOのラベルは、領域に不変な特徴学習を促すため、トレーニング中に結合されました。最適化にはAdamオプティマイザが固定学習率で使用され、データ拡張として水平反転、アフィン変換、ガウスぼかし、ガウスノイズ、ガンマ補正、コントラスト調整などが適用されました。
評価プロトコル
モデルの評価は、以下の方法で行われました。
* データ分割と検証戦略: UK Biobankの200名をトレーニング、50名をバリデーションに使用。ADNIとMASのデータは、クロスコーホート検証のためにそれぞれ3分割されました。
* ベースラインおよびベンチマークモデルとの比較: 標準的な横断的U-Netと、脳腫瘍セグメンテーション用に開発されたsegmentation-through-time (STT)モデルと比較しました。
* アブレーション実験: 2時点入力、損失関数の重み付け、不均衡を考慮した損失関数の効果、特徴融合戦略(アテンション融合、平均融合、結合ベース融合、時間差エンコーディング)、2.5Dモデル、追加の前処理(NLMフィルタリング、CLAHE)の貢献度を評価しました。
* 評価指標: 画素レベルのDice類似度係数(DSC)と、病変レベルのF1局所化スコア(F1)を使用しました。ePVSの経時的変化の方向性の一致率も評価し、モデルが実際の生物学的進行を捉えられているかを確認しました。
Long-PVSUNetの優れた性能と臨床的関連性
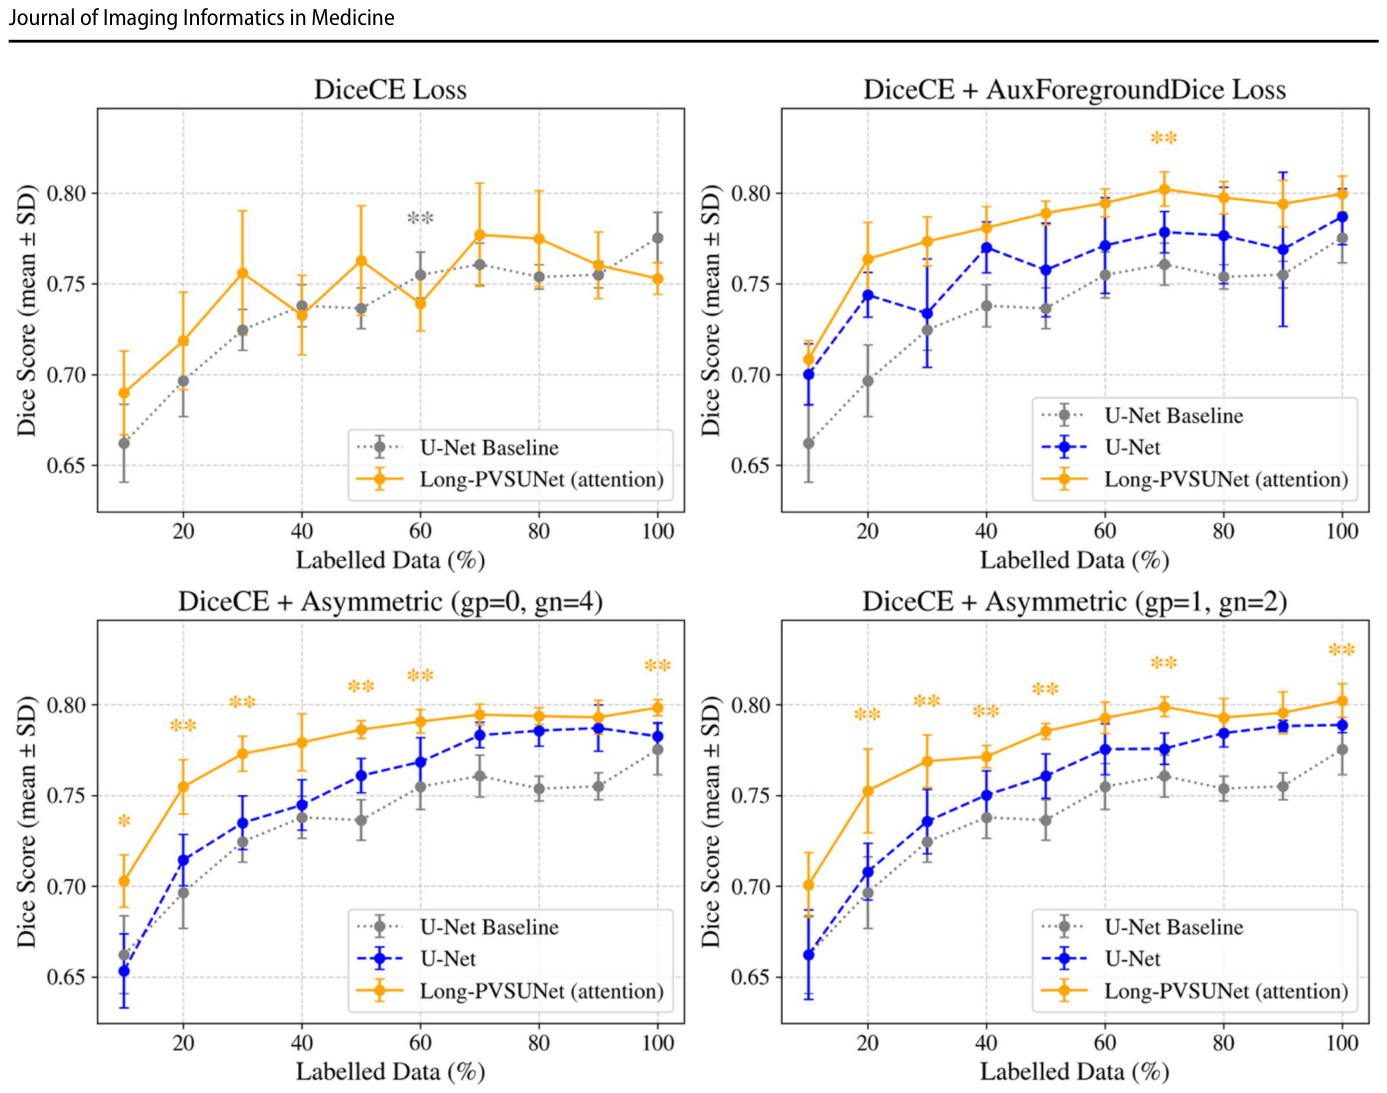
本研究の結果、Long-PVSUNetは、UK Biobankのラベル付きデータの10%から100%の範囲で、従来のU-Netベースラインモデルを上回る優れた性能を示しました。特に、データ効率性にも優れ、比較的少ないラベルデータでも高い性能を維持できることが確認されました。
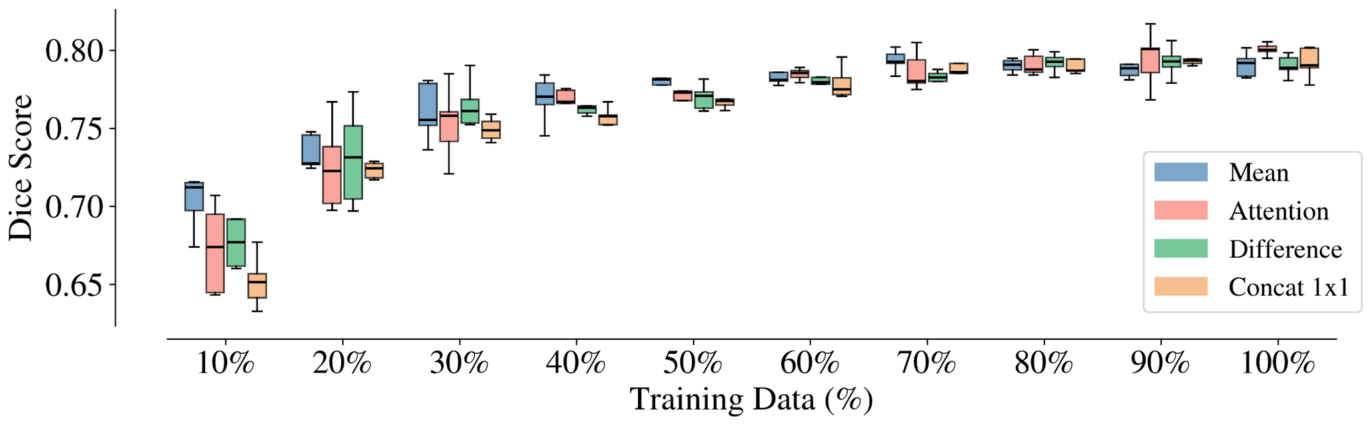
アテンション融合は、他の融合戦略(平均、結合、時間差)と比較して最高のDice類似度係数(0.800 ± 0.004)を達成し、特に平均融合と時間差融合に対して有意な改善を示しました。これは、ePVSのセグメンテーションにおいて、ベースライン情報に基づき関連性の高い特徴に注意を向ける戦略が有効であることを裏付けています。
Long-PVSUNetは、STTベンチマークモデルと比較しても、UK BiobankでのDSCが0.682から0.802に、F1スコアが0.725から0.842に大幅に改善するなど、すべてのコホートでより高いDSCとF1スコアを達成しました。
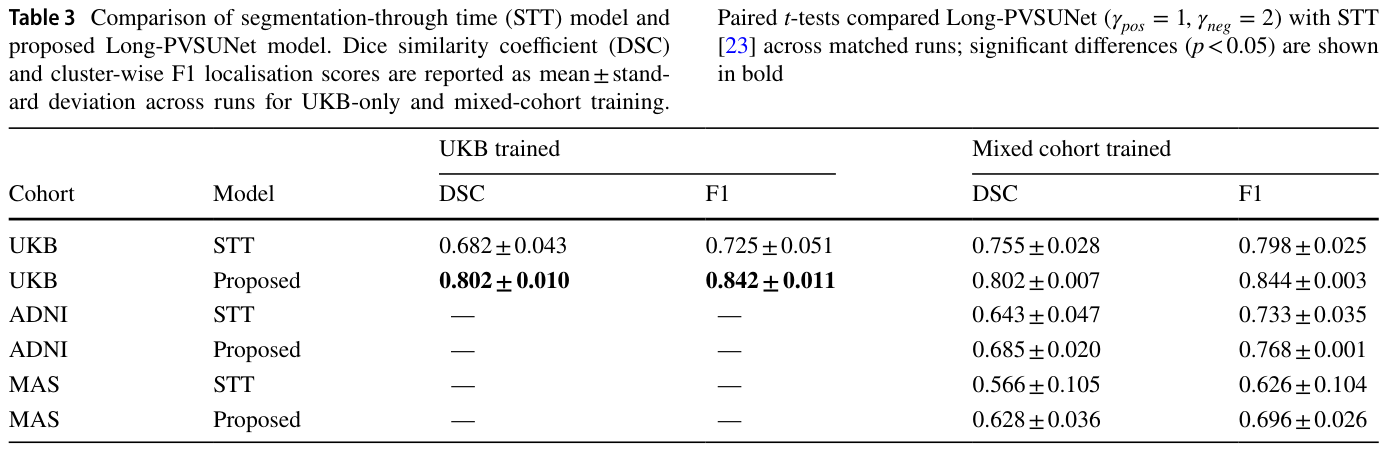
この改善は、Long-PVSUNetが縦断的ePVSセグメンテーションに有効であることを強く示唆しています。
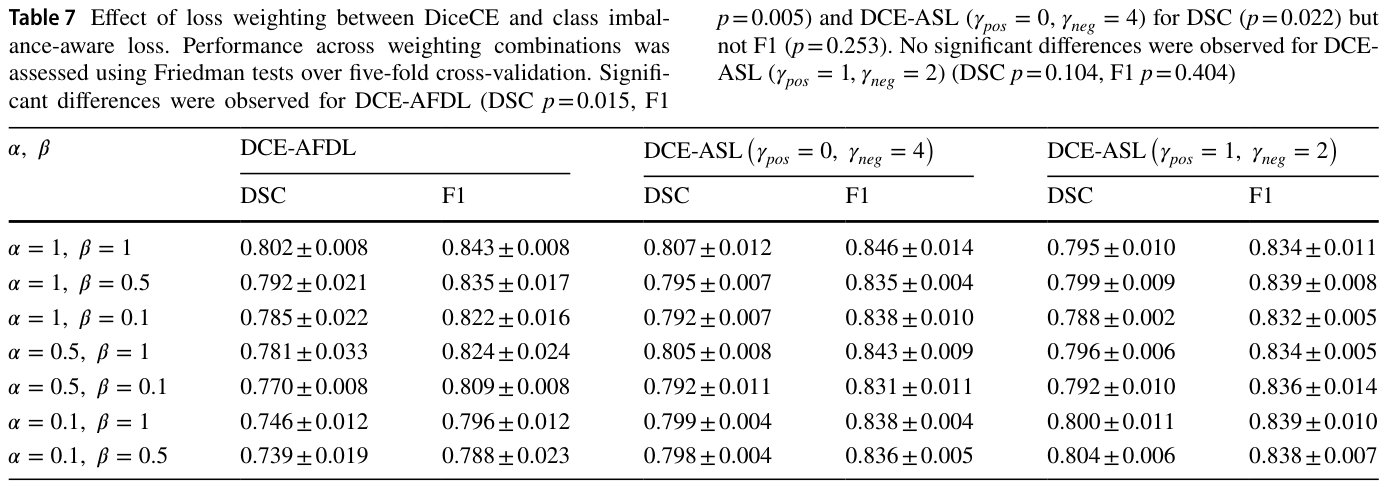
クラス不均衡を考慮した損失関数(DCE-AFDLおよびDCE-ASL)も、DSCとF1スコアをさらに改善し、特にDCE-AFDLはADNIとUK Biobankで最高のDSCを、DCE-ASL(γpos=0, γneg=4)はMASで最高のDSCを達成しました。
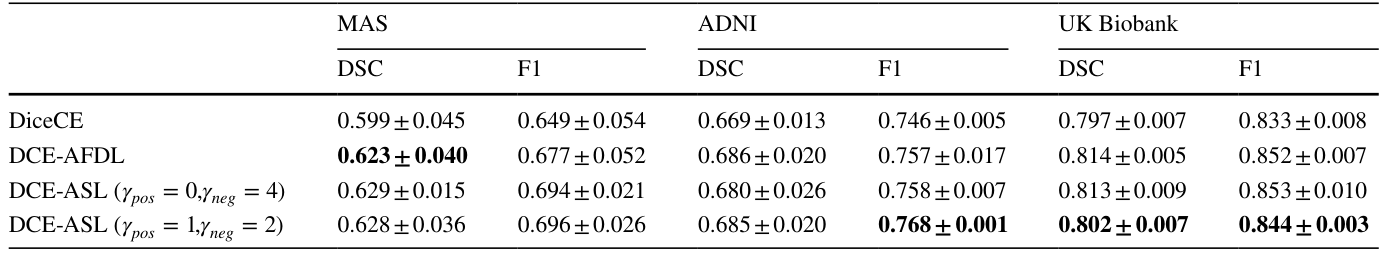
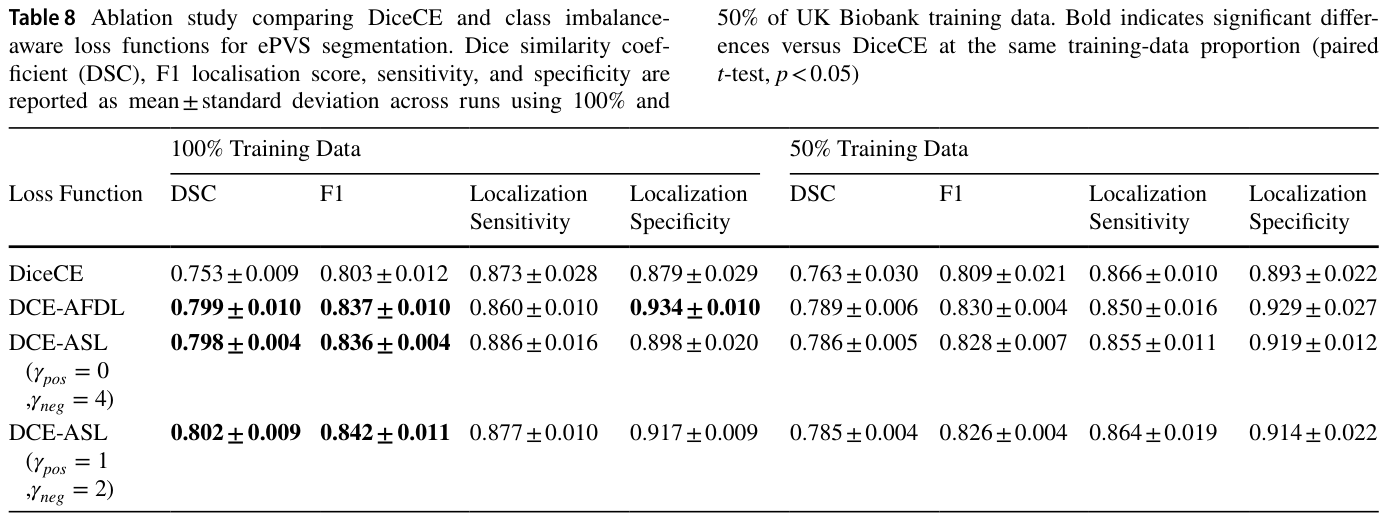
これらの結果は、スパースなePVSのセグメンテーションにおいて、不均衡を考慮した損失関数設計の重要性を示しています。
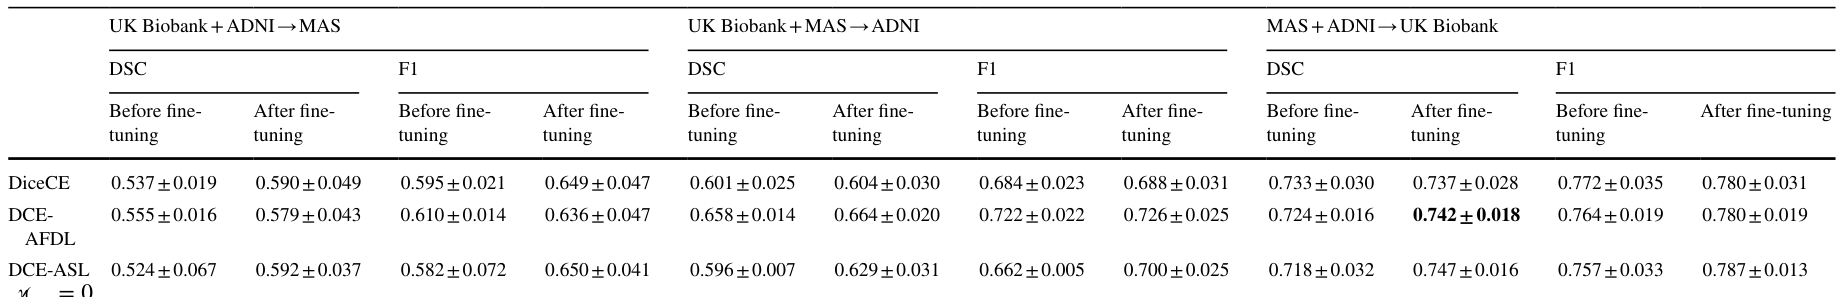
クロスコーホート検証では、Long-PVSUNetが高い汎用性を示し、未見のコホートデータに対しても良好な性能を維持しました。さらに、 held-outコホートからわずか5名の対象者(10スキャン)を用いたファインチューニングで、DSCが改善され、最小限のコホート固有データで効果的な適応が可能であることが実証されました。
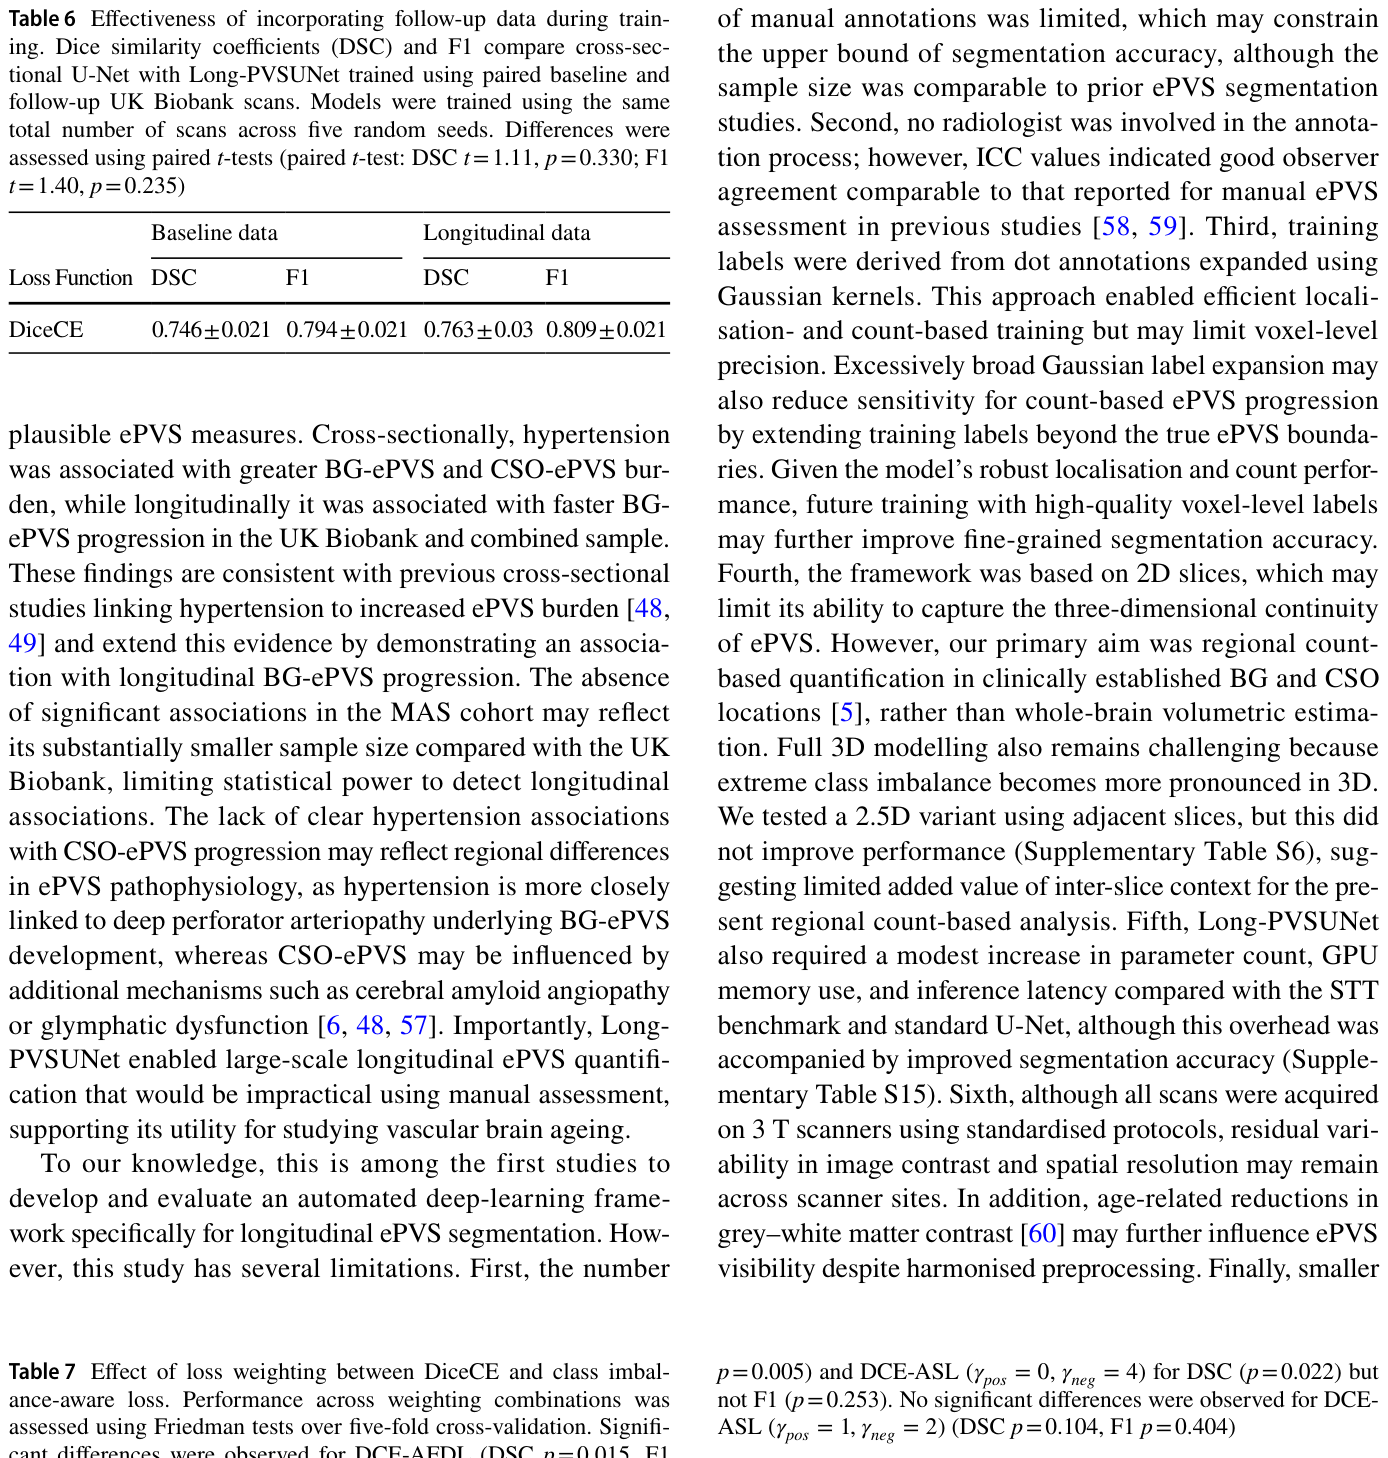
アブレーション研究では、ベースラインとフォローアップの両スキャンを組み込むことで、横断的U-Netベースラインと比較してDSCが改善し、時系列情報の活用が有効であることが示されました。
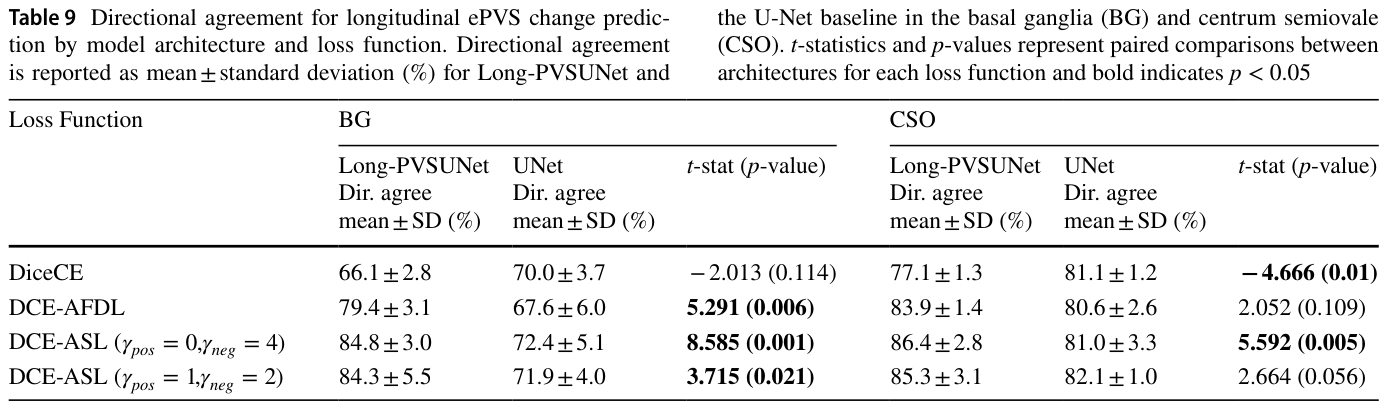
Long-PVSUNetは、ベースラインからフォローアップにかけてBGおよびCSOの両方で予測ePVS数が増加しており、これはePVSの生物学的進行の期待される方向性と一致し、モデル由来の測定値の時間的妥当性を支持しています。また、DCE-AFDLおよびDCE-ASLを用いて学習されたLong-PVSUNetは、U-Netベースラインよりも高いePVS変化方向の一致率を達成しました。特にDCE-ASL(γpos=0, γneg=4)は、BG(84.8% vs 72.4%)とCSO(86.4% vs 81.0%)の両方で有意な改善を示しました。
臨床的関連性解析
臨床的解析では、高血圧とePVS進行との関連が探索されました。横断的には、高血圧はUK Biobankおよび結合されたUK Biobank + MASサンプルにおいて、より高いBG-ePVSおよびCSO-ePVS負担と関連していました。縦断的には、高血圧はUK Biobankおよび結合されたサンプルにおいて、BG-ePVSの進行を加速させることと関連がありました(IRR=1.06、95% CI: 1.02–1.10)。
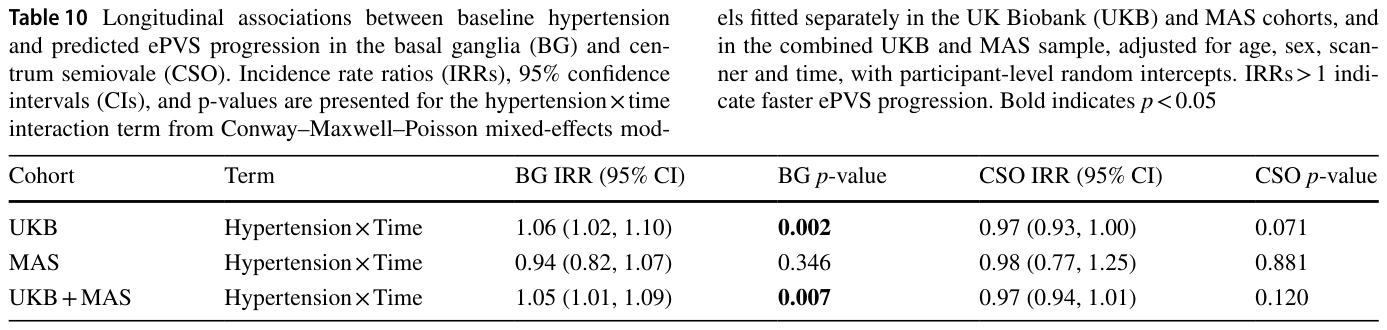
これらの結果は、高血圧がePVSの増加に関連するという先行研究と一致しており、Long-PVSUNetが大規模な縦断的ePVS定量化を可能にし、血管性脳老化の研究に有用であることを示しています。
研究の限界と今後の展望
本研究にはいくつかの限界があります。手動アノテーション数が限られていたこと、放射線科専門家がアノテーションプロセスに関与していなかったこと、ドットアノテーションをGaussianカーネルで拡張したことが画素レベルの精度を制限する可能性が挙げられます。また、フレームワークが2Dスライスベースであるため、ePVSの3次元的な連続性を完全に捉える能力には限界があるかもしれません。Long-PVSUNetは、従来のU-NetやSTTベンチマークモデルと比較して、パラメータ数、GPUメモリ使用量、推論レイテンシが増加しましたが、これはセグメンテーション精度の向上という利点を伴っています。
今後の展望としては、現在のペアワイズアテンション融合を複数時点に対応するマルチ時点アテンションモジュールに拡張することや、より軽量なネットワーク設計の検討が挙げられます。また、中脳や海馬といった他の脳領域への縦断的セグメンテーションの拡張、さらに個々の降圧薬の種類とePVS進行との関連性の解析も重要な研究方向となるでしょう。Long-PVSUNetは、縦断的ePVSの定量化において強力な時間的一貫性、クロスコーホート堅牢性、およびデータ効率性を示しており、多様な集団における縦断的ePVS進行の臨床的価値を確立するためのさらなる研究が期待されます。
用語集
- 拡大血管周囲腔 (ePVS): 脳の小血管病や脳の老化のMRIで可視化される微細なマーカー。
- セグメンテーション: 画像中の特定の領域を識別し、境界線を引く技術。
- 横断的解析: 特定の時点でのデータを一度だけ収集・分析する方法。
- 縦断的解析: 時間の経過とともにデータを複数回収集・分析し、変化を追跡する方法。
- T1強調画像: MRIの一種で、脳の構造を詳しく見るのに適した撮像法。
- FLAIR MRI: MRIの一種で、脳の異常、特に病変と脳脊髄液を区別するのに有用な撮像法。
- 深層学習 (Deep Learning): 人間の脳の神経回路を模倣した多層のニューラルネットワークを用いる機械学習の一種。
- アテンション融合: 深層学習モデルにおいて、異なる情報源から得られた特徴を、関連性の高い部分に焦点を当てて組み合わせる技術。
- クラス不均衡: データセットにおいて、あるクラス(カテゴリ)のサンプル数と別のクラスのサンプル数に大きな差がある状態。
- Dice類似度係数 (DSC): 画像セグメンテーションの評価指標で、予測された領域と実際の領域の重なり具合を示す。0から1の範囲で、1に近いほど精度が高い。
- F1スコア: 検出された病変レベルでの精度を評価する指標。精度と再現率の調和平均。
- ベースライン: 研究開始時点での最初のデータや測定。
- フォローアップ: ベースライン後の追跡調査で収集されるデータや測定。
- U-Net: 医療画像セグメンテーションで広く用いられる深層学習アーキテクチャ。エンコーダとデコーダから構成される。
- エンコーダ: 深層学習モデルの一部で、入力データから重要な特徴を抽出する役割を持つ。
- デコーダ: 深層学習モデルの一部で、エンコーダが抽出した特徴から元の構造(この場合はセグメンテーションマスク)を再構築する役割を持つ。
- 入率比 (IRR): 特定の要因がある群とない群とで、ある事象の発生率が何倍異なるかを示す指標。
コメントを残す