
結腸直腸癌の診断を加速するAI:軽量深層学習モデルと最適化戦略の重要性
解説対象論文: A Hybrid Lightweight Deep Learning Framework for Colorectal Cancer Detection Using an Adaptive Gated Feature Fusion and Grid Search–Based Hyperparameter Optimization
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月24日時点)
結腸直腸癌(CRC)のタイムリーで正確な診断は、対象者の治療成績を向上させる上で極めて重要です。深層学習は病理組織画像解析において大きな可能性を秘めていますが、モデルの精度はネットワークアーキテクチャ、最適化手法、データ不均衡など多くの要因に左右されます。本記事では、CRC-VAL-He-7Kデータセットを用いた結腸直腸癌の分類において、様々な最適化アルゴリズムとハイブリッド軽量モデルがどのように影響するかを探求した最新の研究を紹介します。
はじめに:結腸直腸癌の早期診断と深層学習の可能性
どうも、Beyond the Pixelです。結腸直腸癌(CRC)は、世界中で最も一般的な癌の一つであり、癌関連死の主要な原因となっています。そのタイムリーで正確な診断は、対象者のケアの質を高め、より良い転帰につながる極めて重要な分野です。近年、深層学習(ディープラーニング)は、病理組織画像解析の分野で大きな可能性を示していますが、モデルの精度は、ネットワークアーキテクチャ、最適化手法、データ不均衡など、さまざまな要因に影響されます。本研究では、CRC-VAL-He-7Kデータベースにおける結腸直腸癌の分類に対する様々な最適化アルゴリズムの影響を探求しています。著者らは、ハイブリッド軽量(HYL)モデルを設計し、既存の深層学習モデルと比較評価しました。これらのモデルの概念的なフレームワークを
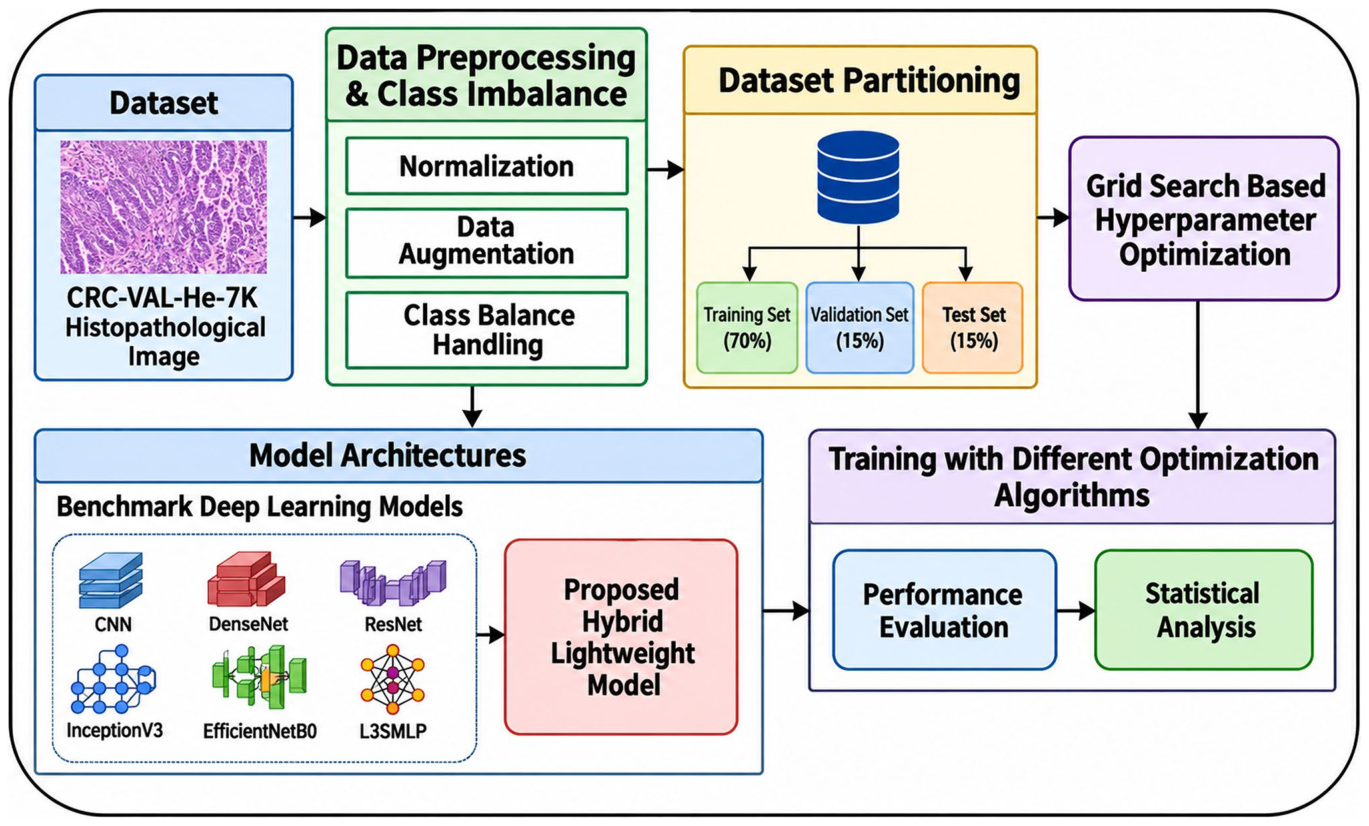
に示します。
研究の課題とアプローチ
従来の診断プロセスは、専門家による医療画像の目視検査に依存しており、時間がかかり、専門家のスキルによって結果が異なるため、一貫性のない結果や専門家への負担増大につながります。深層学習はこれらの課題を克服する可能性を秘めていますが、既存の研究は主にモデルの精度向上に焦点を当てており、最適化手法、ハイパーパラメータの感度、トレーニングの安定性といった側面にはあまり注力していませんでした。また、ほとんどの先行研究は二値分類(癌か否か)を扱っており、結腸直腸組織に存在する多様な変化の複雑性を考慮していません。これらの課題に対処するため、この研究では結腸直腸癌分類のためのハイブリッド軽量モデルを提案し、異なる最適化手法がモデルの性能と安定性に与える影響に焦点を当てています。
データセットと前処理
本研究では、CRC-VAL-He-7Kデータセットを使用しました。これは、脂肪組織(ADI)、背景(BACK)、破片(DEB)、リンパ球(LYM)、粘液(MUC)、平滑筋(MUS)、正常粘膜(NORM)、間質(STR)、腫瘍(TUM)の9つのカテゴリに属する7000枚の病理組織画像で構成されています。画像はすべて128×128ピクセルのグレースケール画像です。データセットの均一性を確保するため、すべての画像を128×128ピクセルにリサイズし、ピクセル値を[0, 1]の範囲にスケーリングしました。過学習(オーバーフィッティング)を防ぎ、モデルの汎化能力を高めるために、ランダムな回転、水平・垂直フリップ、ランダムなトリミングといったデータ増強技術が適用されました。また、クラス不均衡の問題に対処するため、データ増強とクラス重み付け学習手法が用いられました。
提案モデル:ハイブリッド軽量深層学習モデル
著者らが提案するハイブリッド軽量モデルは、病理組織画像解析における分類性能と計算効率のバランスをとるように設計されています。このアーキテクチャは、奥行き方向分離可能畳み込み(デプスワイズセパラブルコンボリューション)に基づくMobileNetに着想を得たパスと、スクイーズ・アンド・エキサイテーション(SE)を持つMBConvブロックに基づくEfficientNetに着想を得たパスという、2つの補完的な軽量特徴抽出パスを組み合わせています。これら2つのパスは、前者が効率的な局所テクスチャ特徴に焦点を当て、後者がより豊かな意味的情報を捉えることで、補完的な表現を抽出します。提案モデルのアーキテクチャは
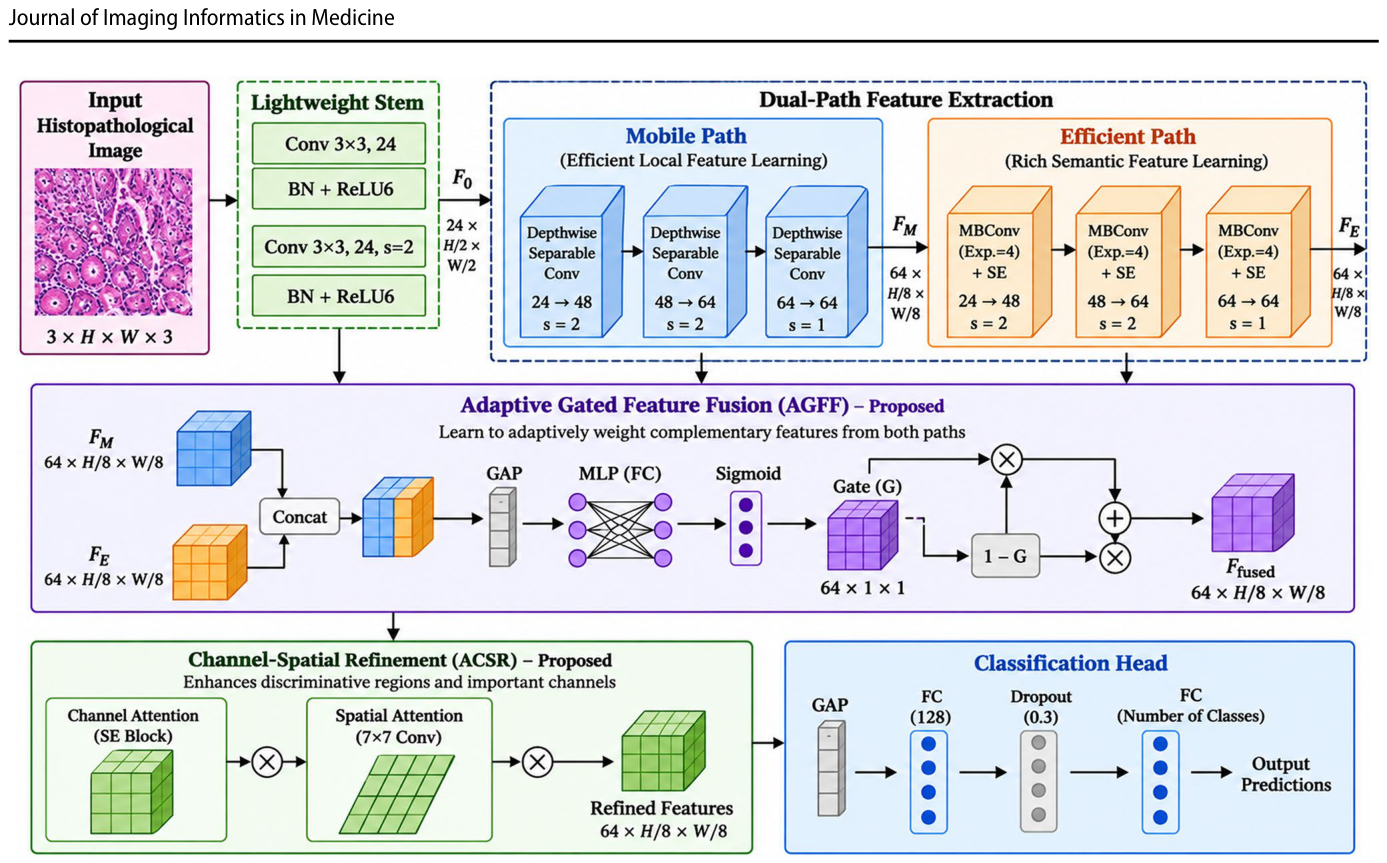
に示されています。また、特徴の直接的な結合ではなく、アダプティブゲート特徴融合(AGFF)メカニズムを用いて、各特徴表現の相対的寄与を学習し、適応的に結合します。融合された特徴は、チャネル空間リファインメント(ACSR)モジュールによって処理され、情報量の多い特徴チャネルと空間領域を強調します。
ハイパーパラメータ最適化と最適化アルゴリズムの評価
モデルの信頼性向上を目的として、ハイパーパラメータの自動調整にはグリッドサーチが採用されました。この研究では、Adam、AdamW、RMSprop、SGD、およびAdadeltaの5つの最適化アルゴリズムが、同一の実験条件下で評価されました。これらの最適化アルゴリズムは、勾配更新や学習率適応に関してそれぞれユニークな特性を持っており、学習プロセスの性能評価を可能にします。学習率(0.001、0.01、0.1)、バッチサイズ(16、32、64)、ドロップアウト率(0.3、0.5、0.7)、隠れユニット数(32、64、128)といったハイパーパラメータが指定され、ReLUが隠れ層に、Softmaxが出力層に適用されました。各モデルは、すべてのハイパーパラメータの組み合わせで50エポックにわたってトレーニングされました。
結果と考察:モデル性能と計算効率
著者らが提案するハイブリッド軽量モデルは、前処理されたCRC-VAL-He-7Kデータセットでトレーニングされ、その性能は様々な深層学習アーキテクチャと異なる最適化設定下で評価されました。性能評価では、精度、適合率、再現率、F1スコア、ROC-AUCといった分類指標が用いられました。
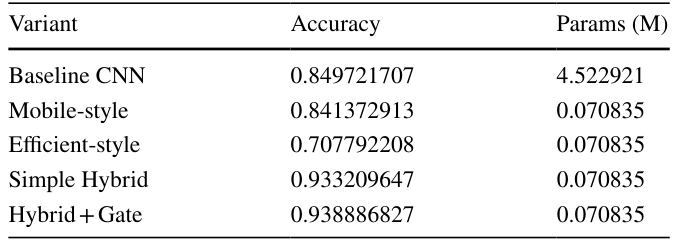
は、CRC-VAL-He-7Kデータセットにおける異なるモデルの比較を示しています。結果は、最適化アルゴリズムの選択がモデルの性能に影響を与えることを示しています。Adadeltaアルゴリズムはすべてのモデルで低い結果を示しましたが、Adam、AdamW、そして一部のケースではSGDが満足のいく安定した結果をもたらしました。CNNの性能は、より複雑なアーキテクチャになるにつれて向上しています。EfficientNetB0とDenseNet121が全体的に最も優れた性能を示しました。特に、EfficientNetB0はRMSpropでトレーニングされた場合に0.98%の精度を達成し、低い変動性を示しました。提案されたハイブリッド軽量モデルは、AdamWオプティマイザを使用した場合に0.93%の精度を達成し、競争力のある精度を提供しながらも、より少ない計算資源しか必要としません。
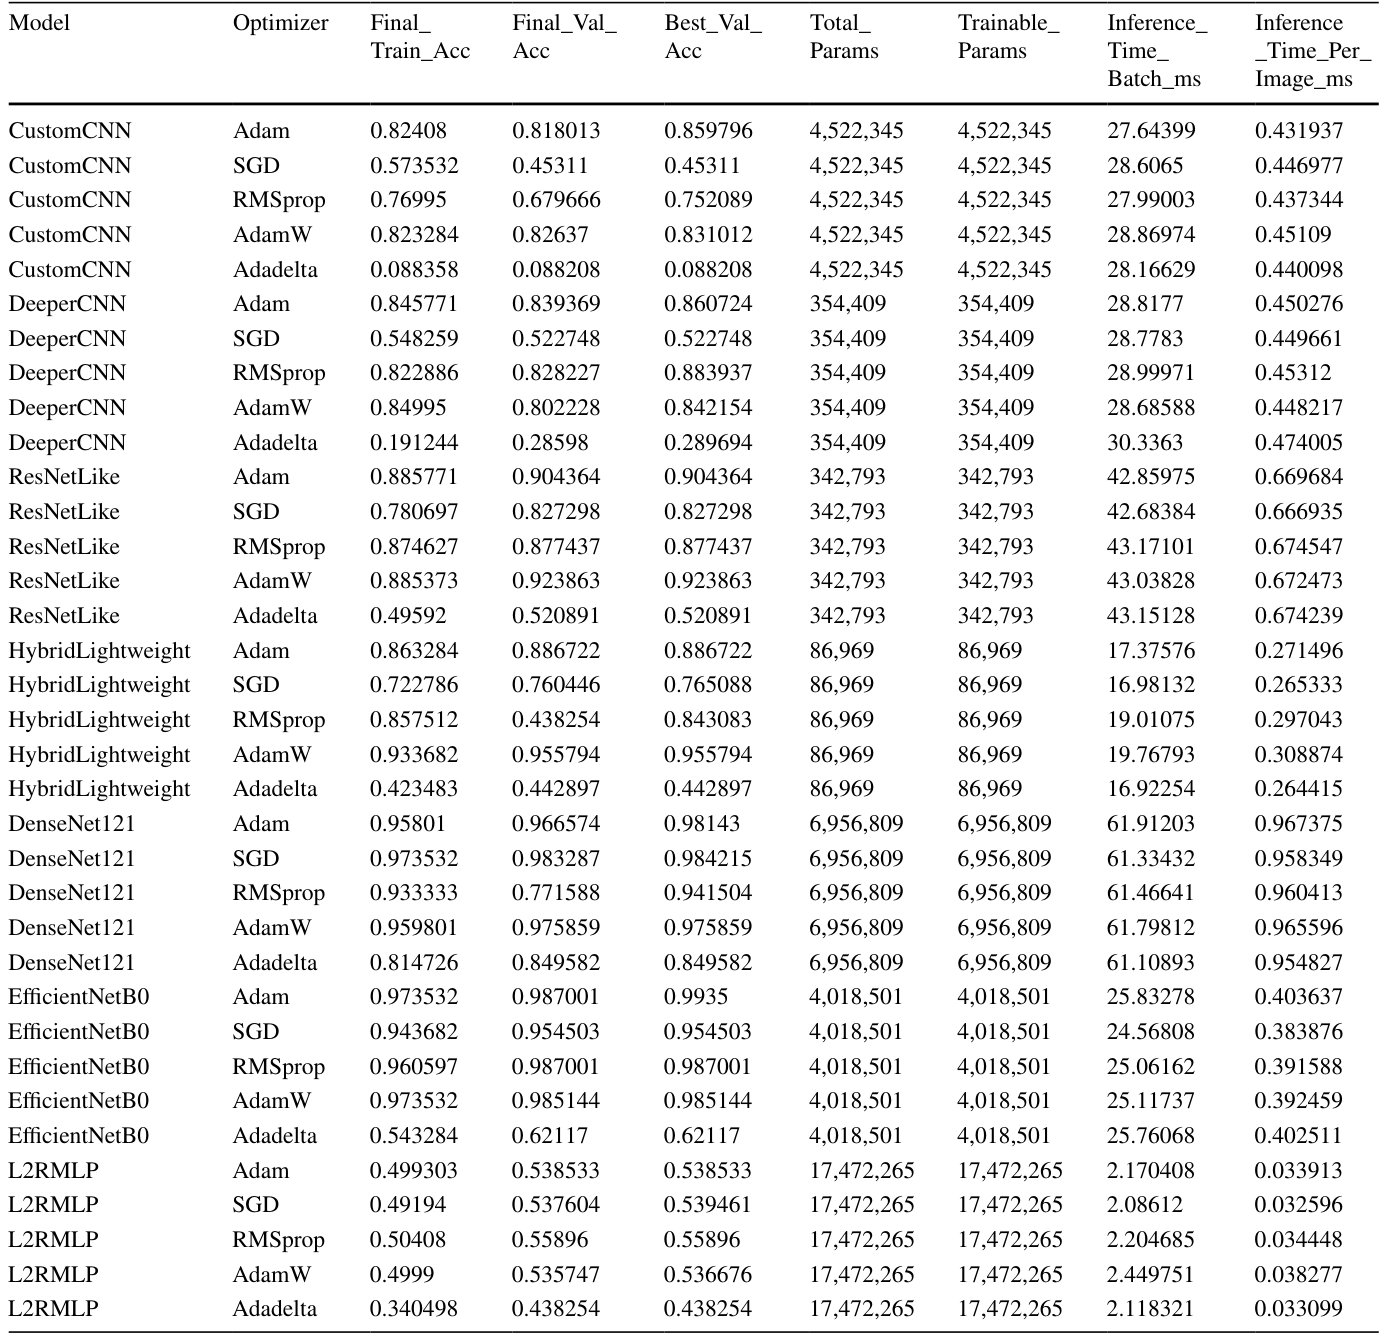
と
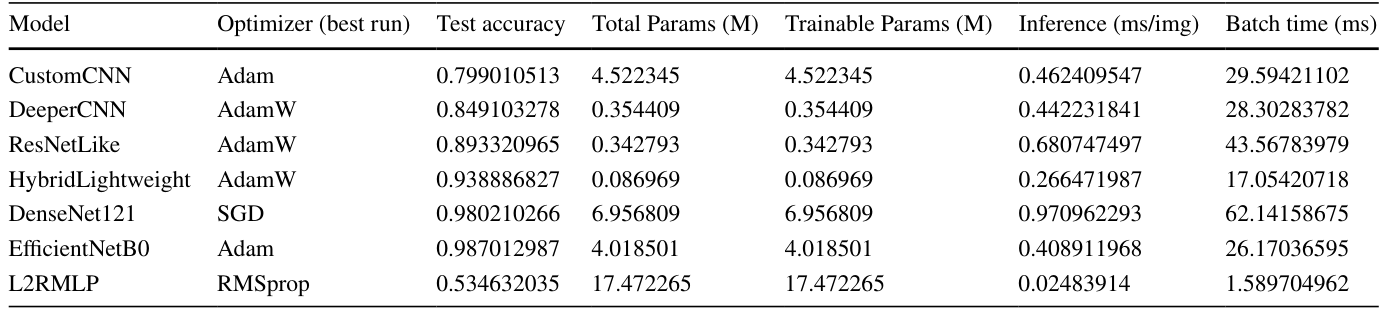
、
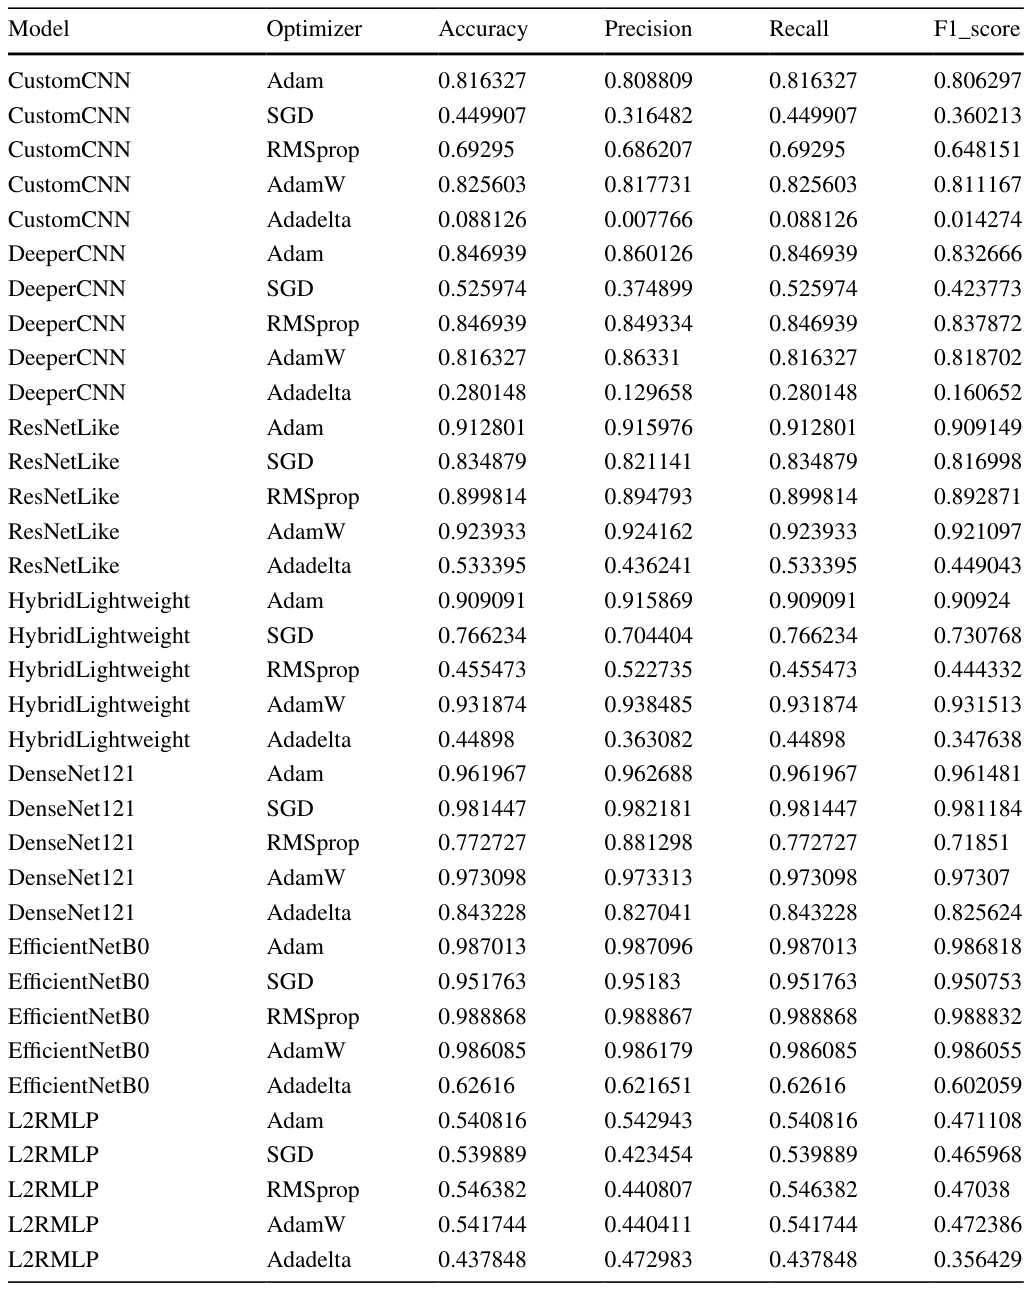
は、CRC-VAL-He-7Kデータセットを用いた計算効率と性能の分析結果を示しています。トレーニングおよび検証損失、精度の動向は
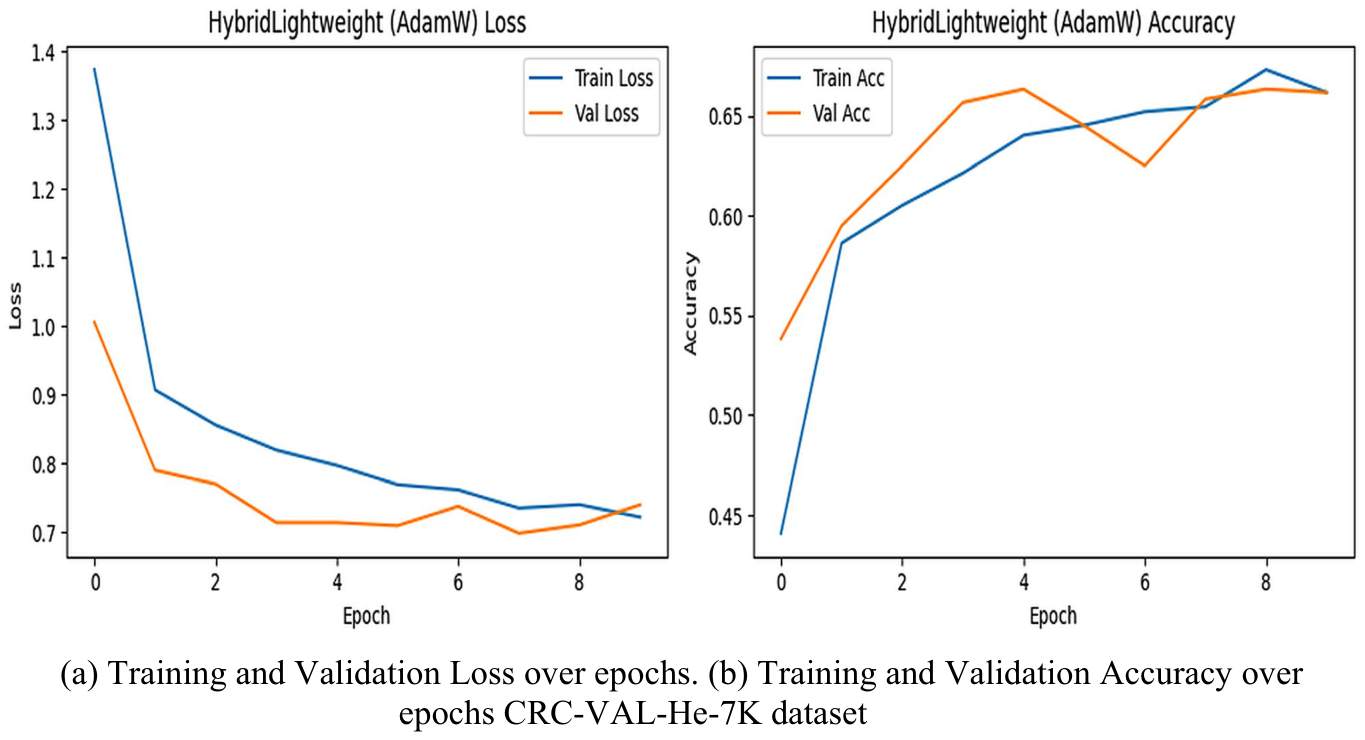
に、混同行列とROC曲線の動向は
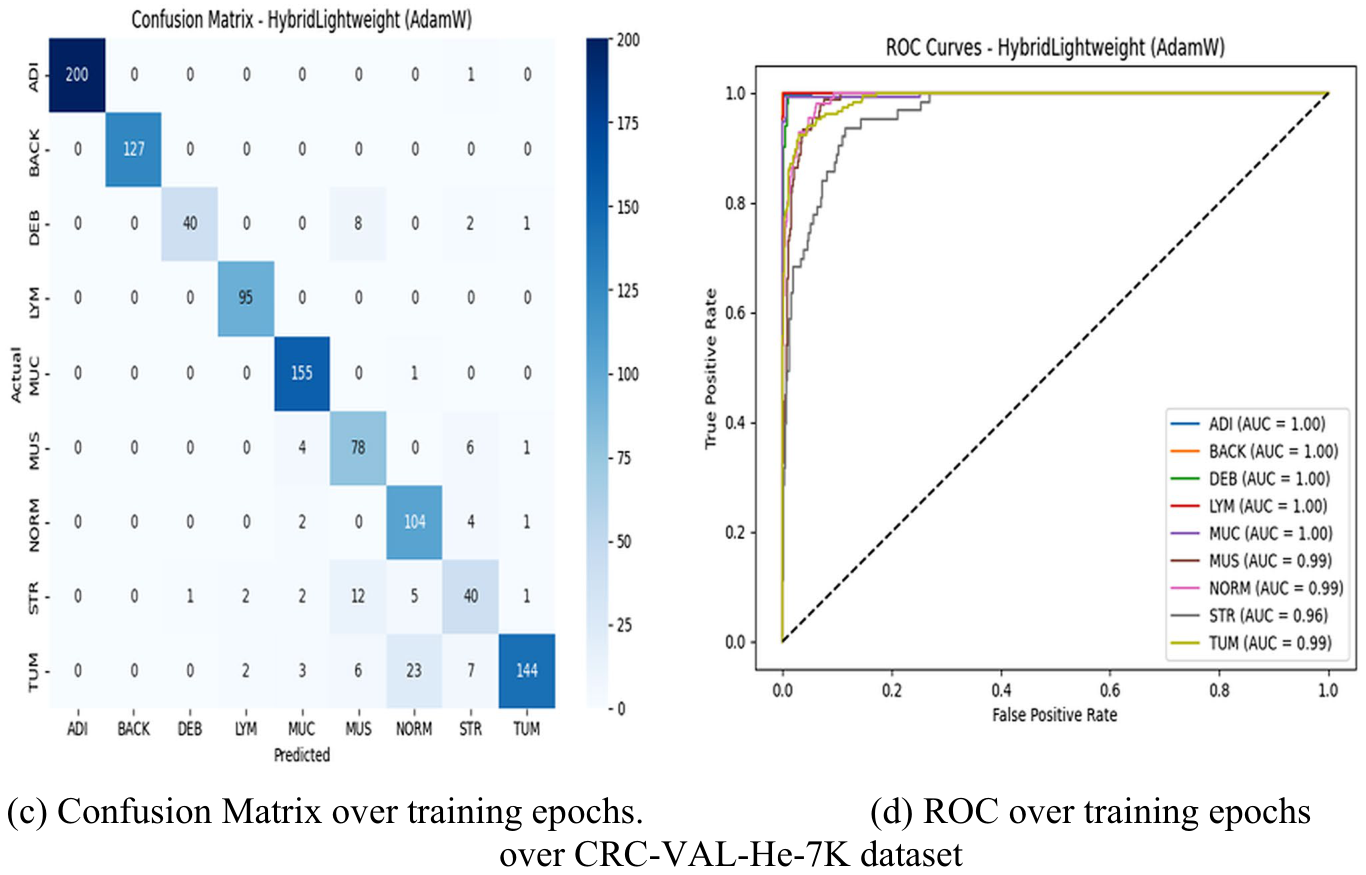
に示されています。トレーニングと検証の損失はエポック数の増加とともに減少し、損失曲線が非常に似ていることから、モデルはデータをうまく分類できており、過学習の兆候は見られません。また、ROC曲線を見ると、すべてのクラスでAUCが1.00に近い値を示しており、良好なクラス識別能力を示しています。これは、提案するニューラルモデルが陽性および陰性の両方のケースを非常にうまく検出できることを示唆しており、分類エラーはほとんどありませんでした。
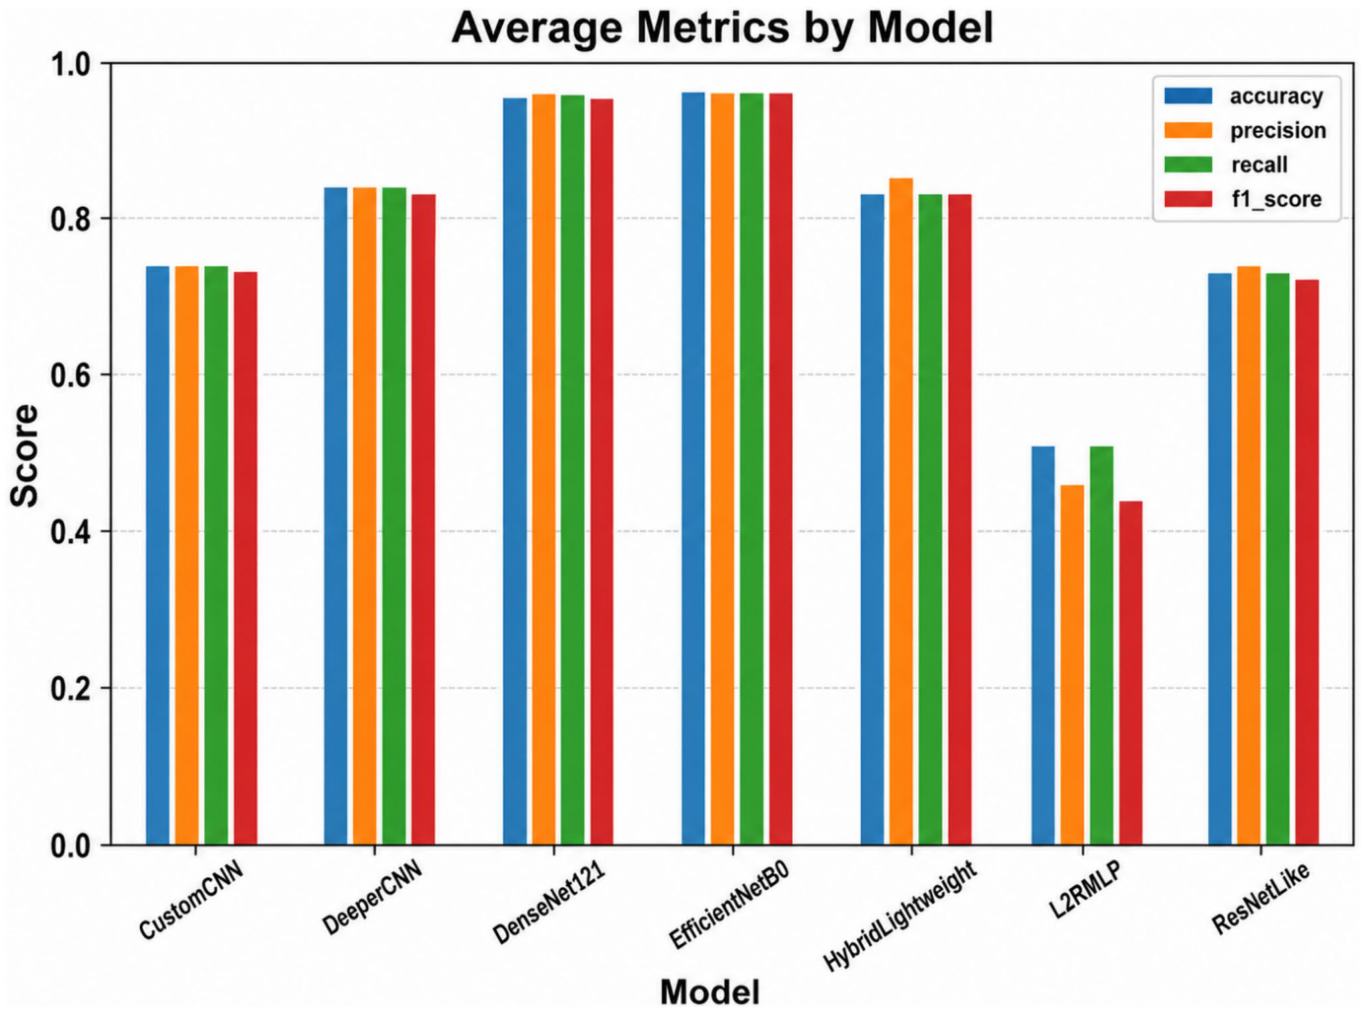
は、様々なモデルと最適化アルゴリズムを組み合わせた平均的な評価指標を示しています。EfficientNetB0とDenseNet121が、4つの指標すべてにおいて優れた性能を発揮しており、誤検出や見逃しに関して正確で効果的であることが証明されました。他のモデルも良好な性能を示しました。
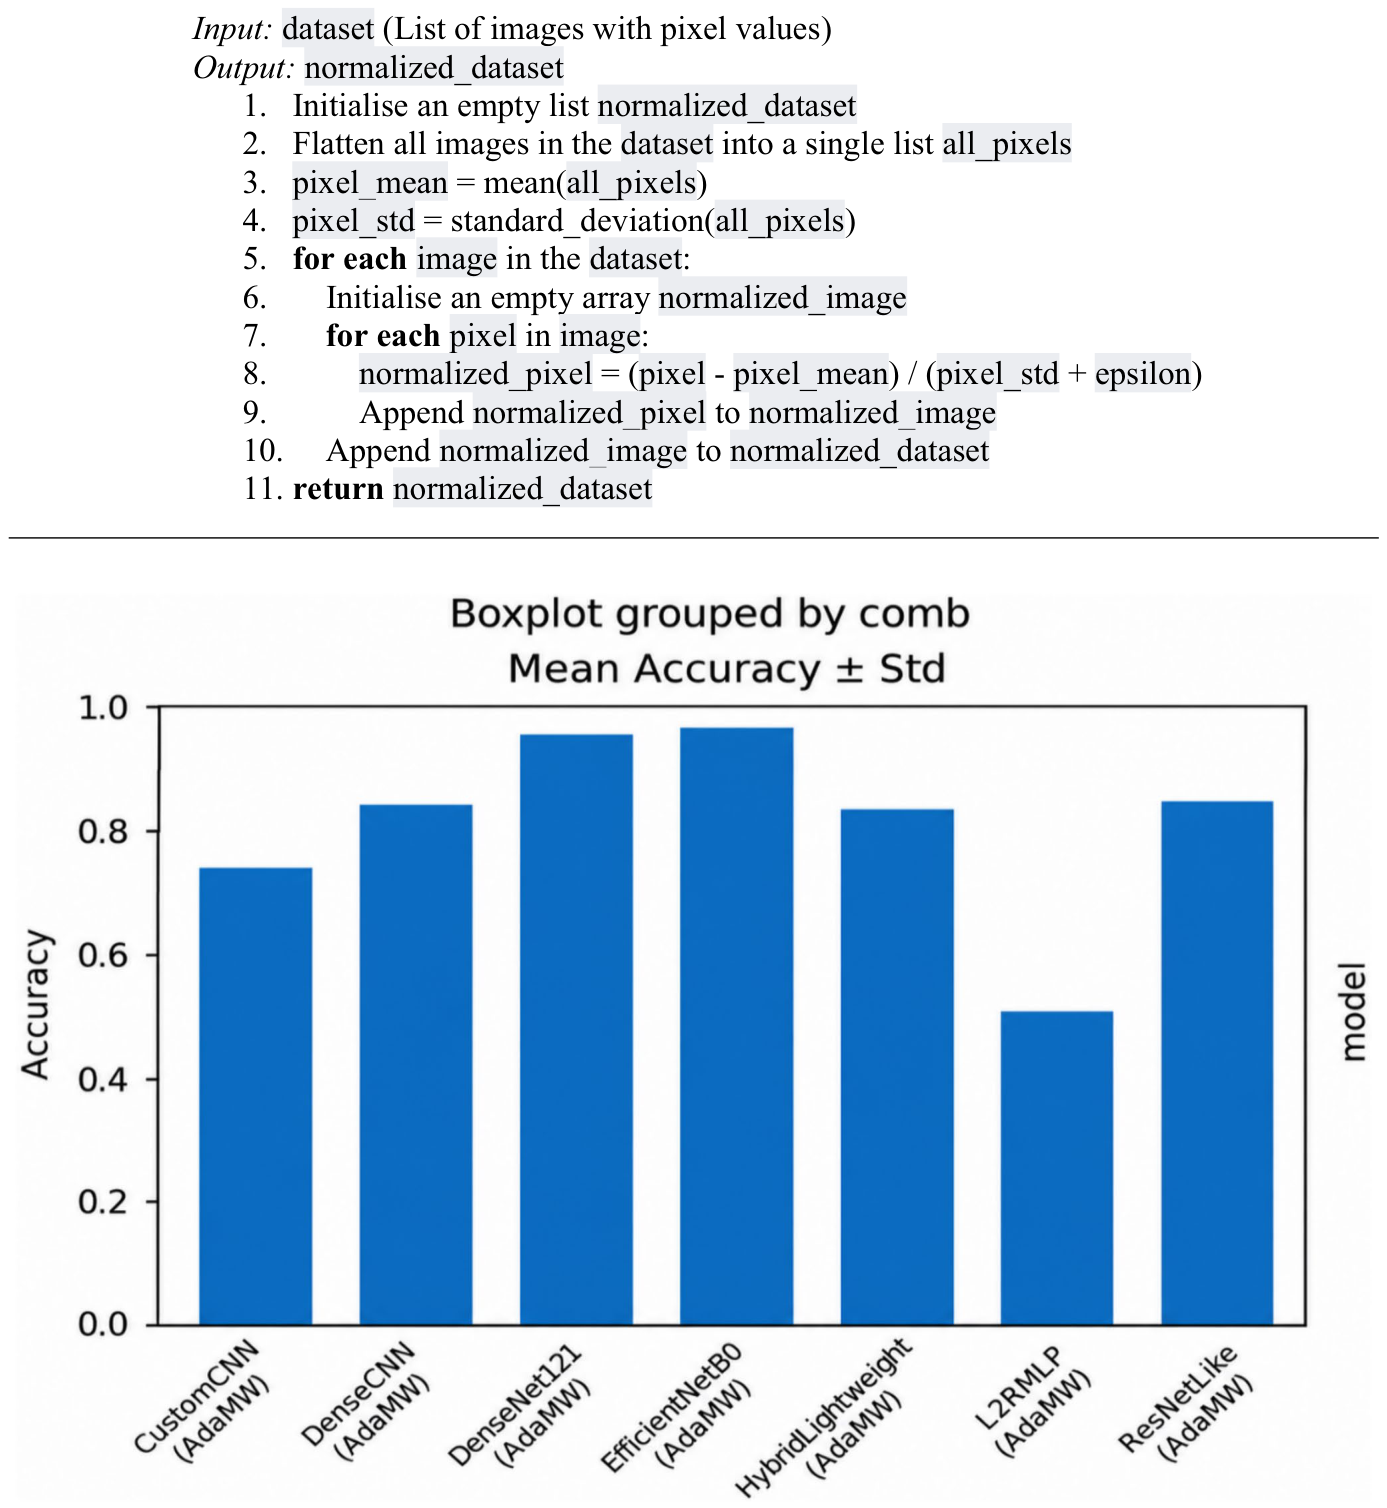
は、モデル全体の平均精度と安定性を示しています。EfficientNetB0とDenseNet121の平均精度が最も高く、汎化能力に優れていることを示しています。これは、より高度な畳み込みアーキテクチャがより良い精度とより一貫した性能を達成することを示唆しています。Kvasirデータセットを用いた追加の計算効率分析結果は
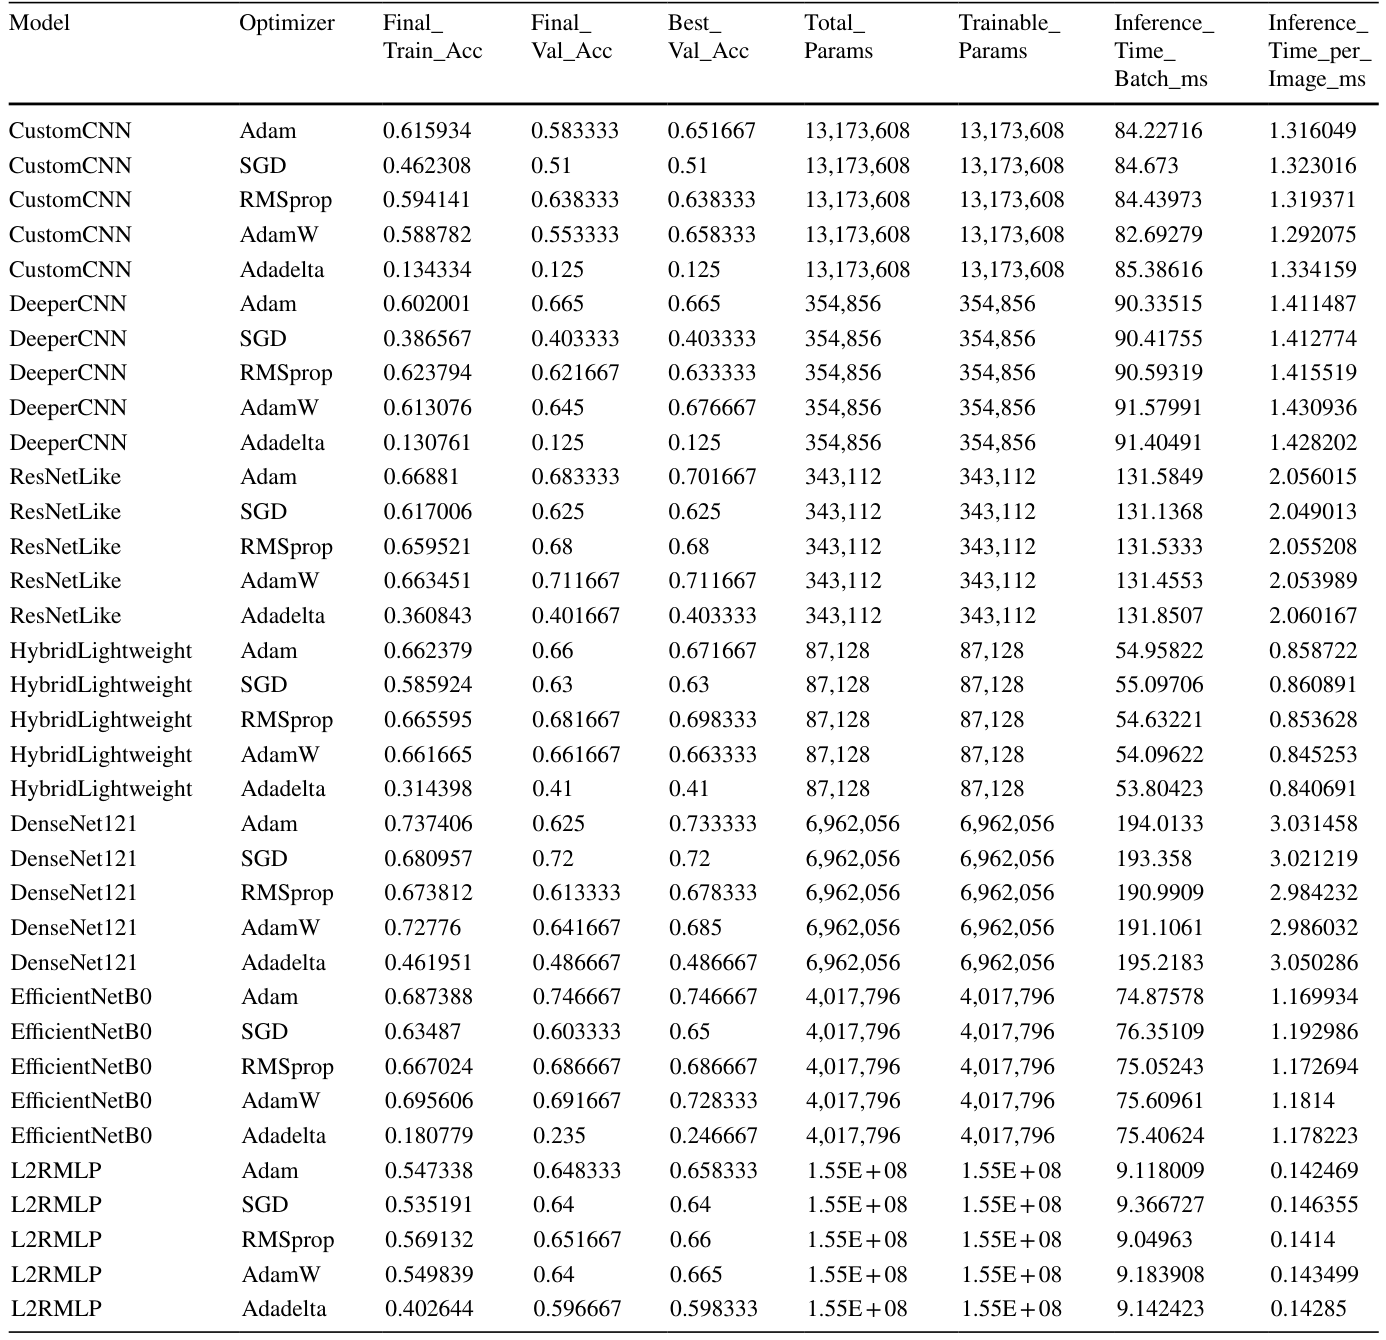
と
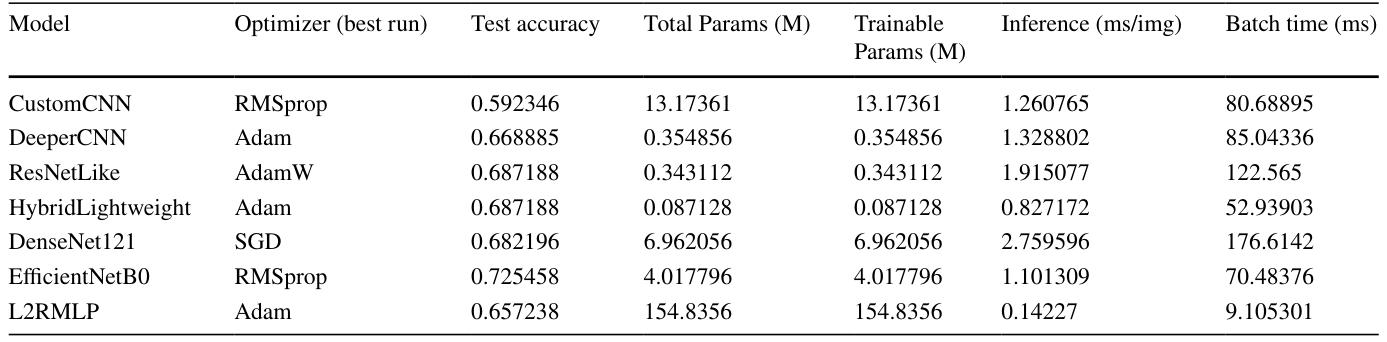
に示されています。
統計解析
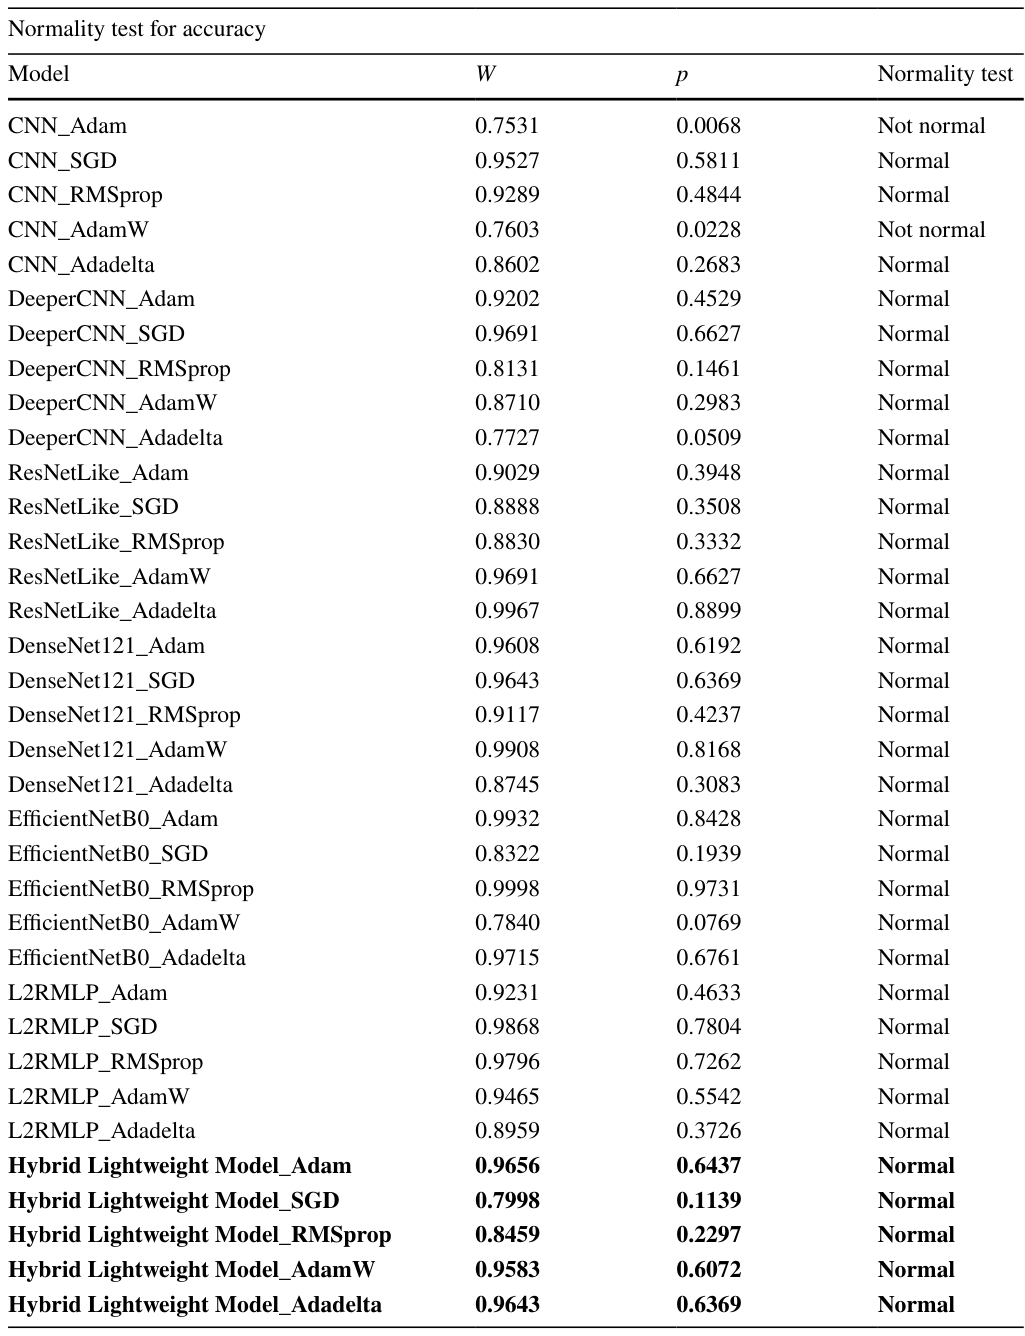
モデルと最適化アルゴリズムの組み合わせにおける性能差の有意性を評価するため、詳細な統計解析が実施されました。二元配置分散分析(two-way ANOVA)の結果は、モデルタイプ、最適化アルゴリズム、およびそれらの相互作用が性能に有意な影響を与えることを示しています。モデル要因(F=72.03、p<0.001)と最適化アルゴリズム要因(F=150.20、p<0.001)はともに統計的に有意であり、モデルアーキテクチャと最適化アルゴリズムの選択が性能の変動に大きく寄与していることを示唆しています。さらに、モデルと最適化アルゴリズムの間には有意な相互作用効果(F=9.07、p<0.001)があり、最適化アルゴリズムの効果が使用するモデルに依存すること、つまり、すべてのモデルに万能な最適化アルゴリズムは存在しないことを示しています。クラスカル・ウォリス検定では、モデルと最適化アルゴリズムの組み合わせ間でモデル性能に有意な差があることが示されました(H=98.77、p<0.001)。
結論と今後の展望
本研究は、結腸直腸癌の病理組織画像分類に用いられる深層学習システムにおいて、異なる最適化戦略がどのように影響するかを評価しました。その結果、ネットワークアーキテクチャと適切な最適化アルゴリズムの選択との相互作用が、モデルの性能に大きく影響することが示されました。著者らが提案したハイブリッド軽量モデルは、分類精度と効率性において満足のいく結果を達成し、EfficientNetB0とDenseNet121が他のテストモデルを上回りました。この研究の利点の一つは、様々な最適化条件下で深層学習アーキテクチャを系統的に比較できたことです。この研究では、グリッドサーチによるハイパーパラメータ最適化だけでなく、適切なデータ増強やクラス重み付け学習手法といったクラス不均衡解消のためのアプローチも追加されました。しかし、本研究にはいくつかの限界点もあります。単一のオープンアクセスデータセットのみを使用しているため、その結果がin vivo条件下での手法の性能を代表するものではない可能性があります。また、研究は限られた典型的な構造と最適化技術に制約されていました。提案された手法は、より大規模で多様なデータセットを用いて、さらなる検討が望まれます。将来の研究では、より高度な最適化プロセス、自動機械学習(AutoML)、Transformerベースのアプローチ、および同様の複雑な手順を用いて、不均衡なクラス問題を解決することが考えられます。また、アノテーション付き病理組織データが限られている場合には、自己教師あり事前学習(Self-supervised pretraining)やパラメータ効率の良い適応(parameter-efficient adaptation)も評価できるでしょう。
補足図表
Figure 8
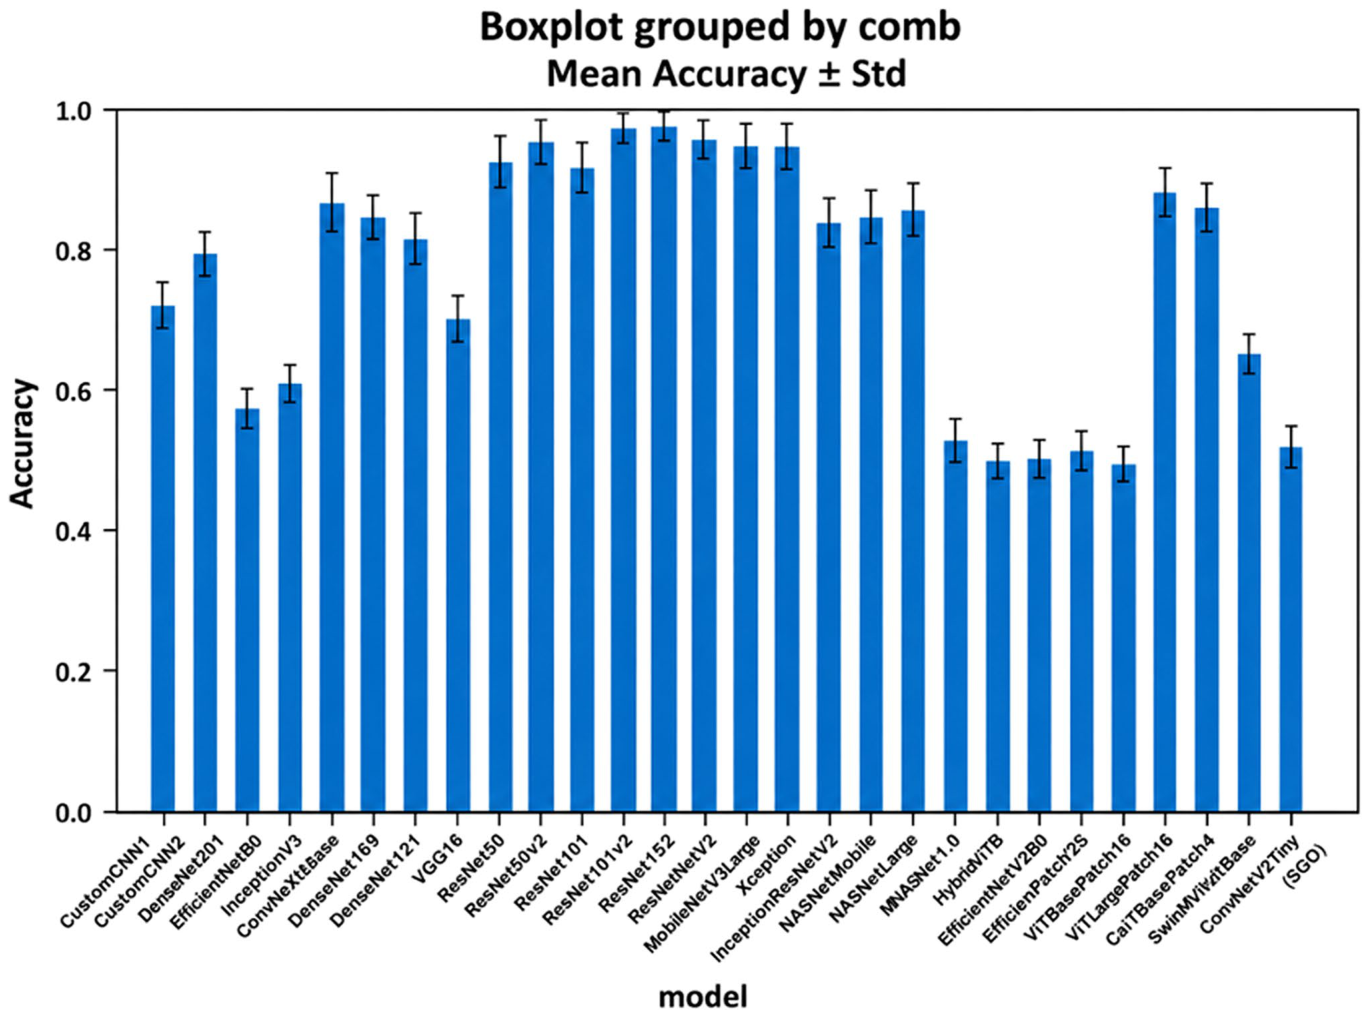
Table 7
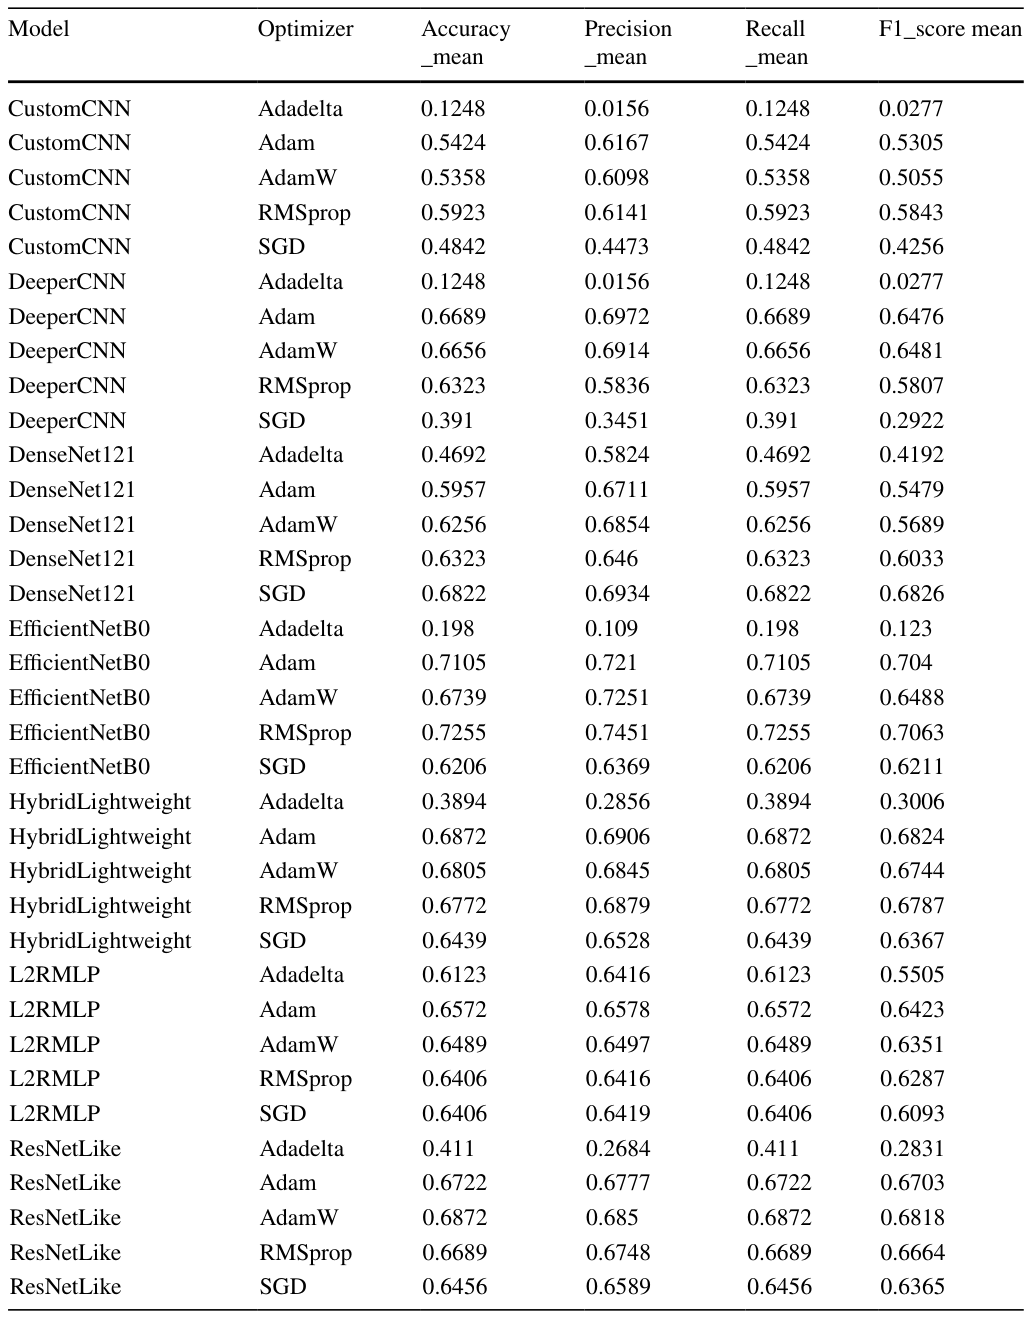
Table 8
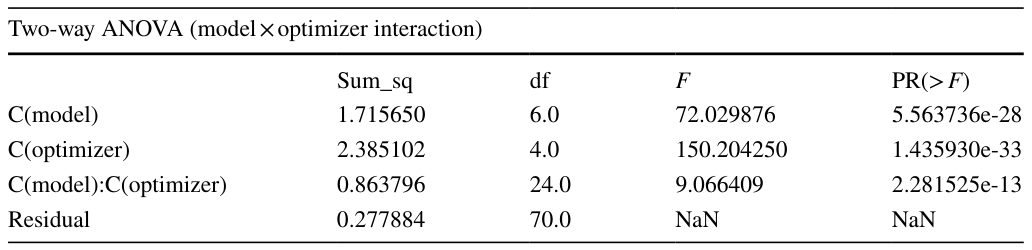
Table 9
用語集
- 深層学習(ディープラーニング): 人間の脳の神経回路を模倣した多層のニューラルネットワークを用いた機械学習の一分野で、画像や音声などの複雑なデータから特徴を自動的に学習します。
- 病理組織画像解析: 生物の組織サンプルから得られた顕微鏡画像を分析し、疾患の有無や種類、進行度などを診断するプロセスです。
- 最適化アルゴリズム: 深層学習モデルが学習中に最適なパラメータ(重みやバイアス)を見つけるための数学的な手法です。損失関数を最小化するようにモデルを調整します。
- ハイパーパラメータ: 深層学習モデルの学習プロセスを制御するために、トレーニング前に手動で設定される値(例:学習率、バッチサイズ、エポック数など)です。
- グリッドサーチ: ハイパーパラメータの最適値を探索するための手法で、事前に定義された複数のハイパーパラメータの組み合わせを網羅的に試行し、最も性能の良い組み合わせを見つけます。
- データ増強(データオーグメンテーション): 既存のデータセットに変換(回転、フリップ、クロップなど)を施すことで、データのバリエーションを増やし、モデルの汎化能力を高め、過学習を防ぐ技術です。
- クラス重み付け学習: データセット内のクラス間でサンプル数に不均衡がある場合に、少数クラスのサンプルに大きな重みを与えることで、モデルが少数クラスをより重視して学習するように調整する手法です。
- 畳み込みニューラルネットワーク(CNN): 画像認識に特化した深層学習モデルの一種で、畳み込み層とプーリング層を複数重ねることで画像の特徴を段階的に抽出します。
- ハイブリッド軽量モデル: 複数の異なる軽量な深層学習アーキテクチャの要素を組み合わせ、高い性能を維持しつつ計算資源の要求を抑えるように設計されたモデルです。
- アダプティブゲート特徴融合(AGFF): 複数の特徴抽出パスから得られた特徴表現の相対的な寄与度を学習し、適応的に結合するメカニズムです。
- チャネル空間リファインメント(ACSR): 深層学習モデルが抽出した特徴マップにおいて、情報量の多いチャネルや空間領域を強調し、関連性の低い情報の影響を低減するモジュールです。
- 精度(Accuracy): モデルの全予測のうち、正しく分類されたサンプルの割合です。
- 適合率(Precision): モデルが陽性と予測したもののうち、実際に陽性であったサンプルの割合です(真陽性 / (真陽性 + 偽陽性))。
- 再現率(Recall): 実際の陽性サンプルのうち、モデルが正しく陽性と予測できたサンプルの割合です(真陽性 / (真陽性 + 偽陰性))。
- F1スコア: 適合率と再現率の調和平均であり、これら二つの指標のバランスを示す評価指標です。
- ROC-AUC: 受信者操作特性(ROC)曲線の下面積(Area Under the Curve)であり、分類モデルの識別能力全体を示す指標です。1.0に近いほど優れた性能を示します。
- エポック(Epoch): 深層学習において、トレーニングデータセット全体がニューラルネットワークに一度だけ順方向および逆方向に渡される学習の反復回数です。
- 過学習(オーバーフィッティング): モデルがトレーニングデータに過度に適応し、未知の新しいデータに対しては性能が著しく低下する現象です。
コメントを残す