
放射線診断AI導入ガイド:エラー率の評価と臨床現場でのリスク管理
解説対象論文: A Detection, Diagnostic, and Triage AI Buyer’s Guide: Questions that Matter
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月5日時点)
人工知能(AI)の医療分野への導入は、放射線診断の効率と精度を向上させる可能性を秘めていますが、その真の臨床的価値を評価することは容易ではありません。本記事では、既存のAI性能評価指標の限界を指摘し、実際の臨床現場でAIがどのように機能するかを予測するための新しい視点と具体的な評価方法について、オープンアクセス論文『A Detection, Diagnostic, and Triage AI Buyer’s Guide: Questions that Matter』に基づき解説します。専門家がAIシステムを導入する際に直面する課題を乗り越え、データに基づいた賢明な意思決定を行うための実践的なガイドラインを提供します。
はじめに:AIの性能を真に理解するための重要な問い
どうも、Beyond the Pixelです。近年、放射線診断における人工知能(AI)モデルの開発と商用リリースが急速に進んでいます。これらのAIモデルは、疾患の検出、診断、トリアージなど多岐にわたる役割を果たすことが期待されています。米国食品医薬品局(FDA)の承認を得るためには、通常、AIシステムの安全性と性能に関するエビデンスを開示する必要があります。しかし、その性能評価には大きな課題があることが指摘されています。一般的に、AIモデルの性能は感度、特異度、ROC曲線下面積(AUC)といった指標に基づいて報告されます。これらの指標はモデルの基本的な識別能力を示すものですが、AIシステムを実際の臨床現場に導入した場合に、どのような種類のエラーがどれくらいの頻度で発生するかを専門家に伝えるには不十分です。
従来の指標だけでは不十分な理由:予測値の重要性
真に重要なのは、陽性反応的中度(PPV)と陰性反応的中度(NPV)、あるいはその逆である偽陽性率(FDR: False Discovery Rate、1-PPV)と偽陰性率(FOR: False Omission Rate、1-NPV)です。これらはAIが陽性と予測した場合に実際に陽性である確率、または陰性と予測した場合に実際に陰性である確率、そして誤った予測の割合を示すものであり、臨床現場でのAIの実際の挙動を予測するために不可欠です。しかし、多くの論文やFDA 510(k)申請ではこれらの予測値が報告されていないか、あるいはターゲット疾患の有病率を人為的に高くした「濃縮データセット」でテストされているため、臨床現場でのPPVを過大評価し、NPVを過小評価する傾向があります。この乖離が、導入後にAIが「頻繁に間違っている」と感じられる原因となることがあります。
事例から学ぶAI性能のギャップ:LVO検出AIの教訓
実際に、Scaringiらのケーススタディでは、大血管閉塞(LVO)検出AIモデルを救急放射線診断に導入した事例が報告されています。ベンダーは感度97%、特異度95.6%、PPV95%、NPV98%と高い性能を報告していましたが、実際に3週間運用した結果、専門家は「頻繁に間違っている」と感じ、システムは撤去されました。サイトでの事後レビューでは、感度100%、特異度91.5%と、ベンダー報告値と同様に高い精度が確認されました。しかし、PPVはわずか33.3%であり、AIが陽性と判定したケースの約3分の2が偽陽性であったことが判明しました。これは、ベンダー報告のFDR 5%を大きく上回る66.7%でした。
この大きな乖離の主な原因は、AIモデルのテストに用いられたデータセットと、実際の臨床現場での対象者コホートにおけるLVOの有病率が大きく異なっていたことにありました。AIシステムはLVO有病率45%の濃縮データセットでテストされていましたが、実際の臨床現場での有病率は4.1%と一桁低かったのです。この有病率の違いが、PPVを実態よりも高く見せかけ、「精度パラドックス」または「偽陽性パラドックス」として知られる現象を引き起こしました。つまり、AI自体の精度は高くても、対象疾患の発生率が低い現実世界では多くの偽陽性を生み出す可能性があるということです。
また、感度と特異度のわずかな違いも乖離の一因でした。ベンダー報告値(感度97%、特異度95.6%)と実際に観察された臨床コホート(感度100%、特異度91.5%)との差は、偽陽性の増加につながります。これらの差異は、AIモデルがトレーニング・テストされたデータと実際の臨床コホートが異なる母集団から来ていることを示唆しています。
FDAの510(k)クリアランス経路は、機器が既存の合法的に市販されている先行機器と実質的に同等であることを示すことで市場への投入を可能にします。放射線診断におけるクリアランスされたAIデバイスは、主にコンピューター支援トリアージ・通知ソフトウェア(CADt)とコンピューター支援検出・診断ソフトウェア(CADe/CADx)の2つのカテゴリーに分類されます。CADtはワークリストの優先順位付けを行いますが、診断解釈には関与しません。一方、CADe/CADxは専門家が最終診断に組み込む所見のマーキングや特徴付けを行います。偽陽性や偽陰性の結果がもたらす影響は、これらのカテゴリー間で異なります。ベンchendorsは安定した推定値を得るために、特に感度について、テストデータセットを臨床実践で期待されるよりもはるかに多くのターゲット陽性症例で濃縮することがあります。その結果、これらのテストセットの有病率は、地域の臨床集団で遭遇する有病率を反映していない可能性があり、臨床有病率自体も様々な理由で臨床実践間で異なることがあります。
さらに、AIモデルの性能の一般化可能性は、トレーニングに使用されたデータによって制限される場合があります。モデルはアクセスしやすいデータ(特定の施設、スキャナー、集団、ワークフローなど)を使用してトレーニングされることが多く、これらのデータはターゲット陽性症例で濃縮されている可能性があります。このような選択バイアスは、モデルの臨床集団への一般化可能性を低下させ、性能の精度を低下させる可能性があります。FDAは、トレーニングおよびテストデータセットの代表性を評価し、一般化可能性の証拠を提供する検証戦略を推奨していますが、モデルやターゲット集団は時間とともに変化する可能性があり、AIモデルが更新されたり、地域の有病率が変動したりすると、FDRやFORも変化することに注意が必要です。例えば、LVOのAIモデルの感度と特異度が更新され、地域の有病率も変化した場合、FDRは大幅に変動する可能性があります。
ソリューション:AIを賢く導入するための3つのステップ
ベンダーが報告する感度、特異度、PPV、NPVといった性能指標にのみ依存することは、AIモデルが特定の臨床現場でどのように機能するかを予測する上で不十分であることが明らかになりました。そこで、本論文ではAIの賢い導入を支援するための3つのステップを提案しています。
ステップ1:ベンダーと自施設に「適切な質問」をする
AIモデルの導入を検討する際、まず自施設がベンダーに尋ねるべき質問と、自施設の臨床状況について考慮すべき質問を明確にすることが重要です。これにより、AIモデルのトレーニングデータとテストデータが自施設の臨床集団と設定にどれだけ近いかを定性的に評価できます。
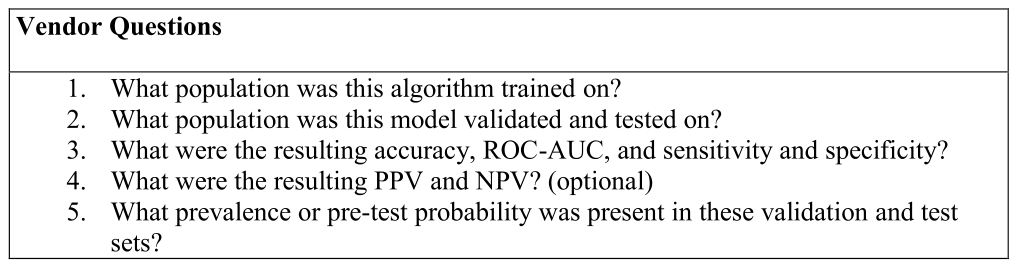
ベンダーに尋ねるべき質問は、アルゴリズムがどの集団でトレーニング・検証・テストされたか、その結果の精度、感度、特異度、PPV、NPVは何か、そしてこれらのデータセットにおける疾患の有病率はどれくらいか、といった点です。これに対し、自施設の状況を評価するためには、自施設の対象者集団の特性(有病率、利用目的、施設の種類など)、症例選択基準、画像取得プロトコル、画像機器、画像品質、ラベリング方法などを検討する必要があります。
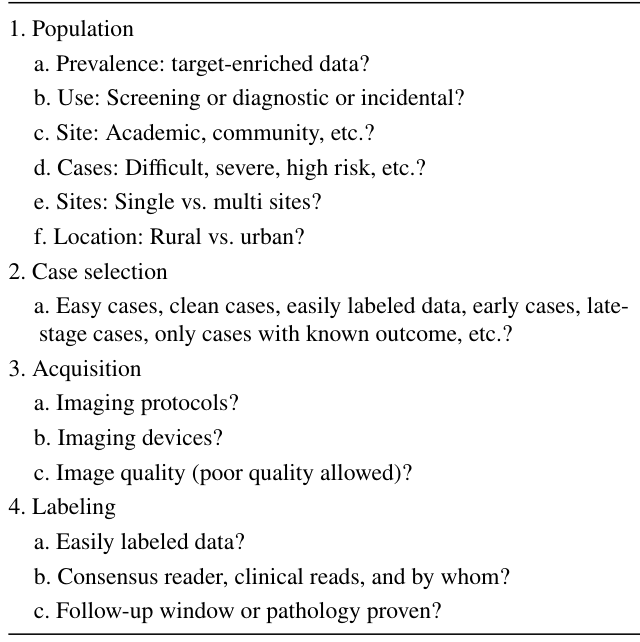
これらの比較を通じて、もしモデルが自施設と同じ集団でトレーニング・テストされていないと判断された場合、ベンダー報告の性能推定値が自施設に一般化されるかは不確かです。この場合、最適な選択肢はベンダーに自施設のデータで「受け入れテスト(パイロットテスト)」を実施させることです。これが不可能な場合は、公表された文献や許容可能な最小値に基づいて、感度や特異度の調整された推定値を使用することを検討します。
ベンダー報告の感度と特異度が自施設の対象者集団で使用した場合でも妥当であると仮定した場合、次に考慮すべきは、ベンダーデータと自施設の対象者コホートにおけるターゲット疾患の有病率の比較です。もし有病率が一致していれば、ベンダー提供のPPV、NPV、FDR、FORの推定値は自施設に一般化される可能性が高いです。しかし、有病率が一致しない場合、専門家はベンダーが提供する感度と特異度(または調整された推定値)と、自施設の地域の有病率を使用して、ベイズの定理に基づいて自施設で予測されるエラー数を計算できます。
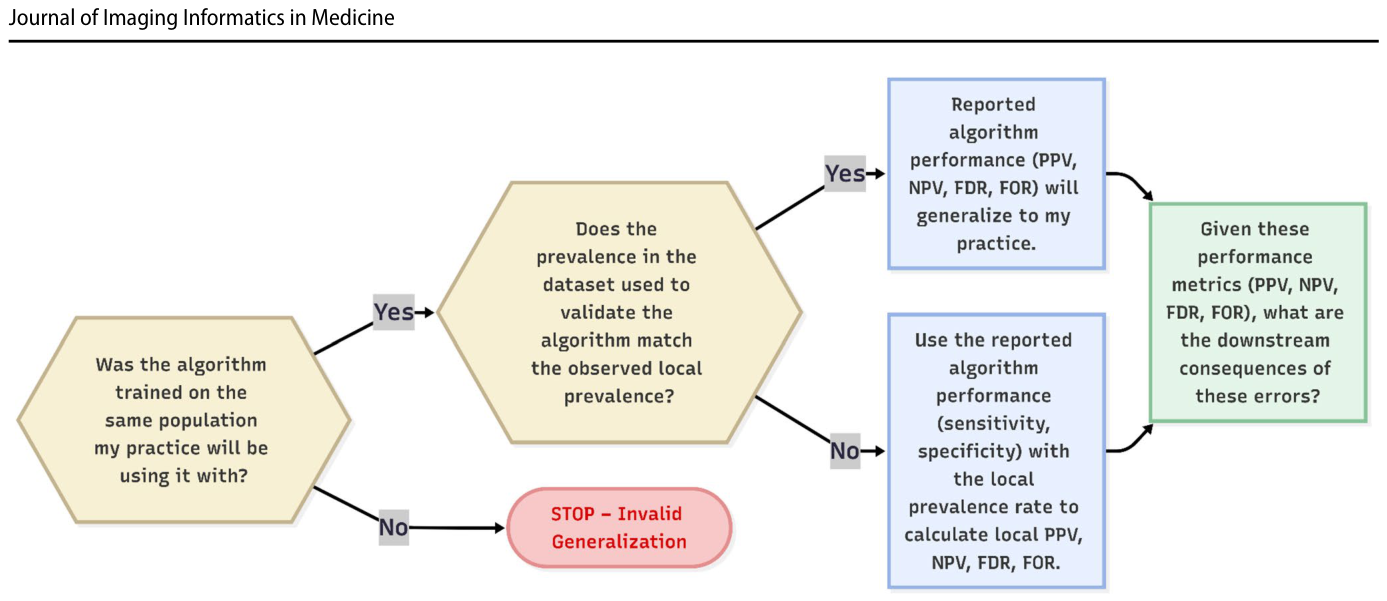
このような計算されたPPV、NPV、FDR、FORは「推定値」であり、これらの推定値が実際の性能にどれだけ近いかは、使用される感度、特異度、有病率の妥当性にかかっています。これらの値が自施設に一般化できない場合、計算された予測値は過大または過小評価される可能性があります。
また、AIモデルの検出閾値(しきい値)も重要です。ベンダーが設定する閾値は、必ずしも自施設のニーズに合致しない場合があります。理想的には、自施設の過去のデータでモデルを実行し、ニーズに最適な閾値を顧客が選択することです。それが不可能な場合でも、ベンダーは感度と特異度の全範囲(またはROC曲線)を提供し、顧客が自身の閾値を選択できるようにすべきです。
これらの情報を得るために、FDA承認済みデバイスは通常、「使用説明書(IFU)」を提供しています。また、米国放射線学会(ACR)データサイエンス研究所(DSI)は、FDA承認済み医療機器としてのソフトウェア(SaMD)製品の公開リポジトリ「ACR AI Central」を維持しており、ベンダーはトレーニング/テストコホートに関する標準的な記述的データ要素と510(k)クリアランス要約書を掲載しています。さらにACRは、AIモデルの実際の性能を監視するためのAIレジストリとデータサービスを提供しており、自施設の疾患有病率を長期的に計算できるほか、専用のレビューツール「ACR Forensics」でフラグが付けられた症例のレビューを支援します。ACR DSIは、PPV、NPV、FDR、FORを計算するオンラインツール「AIエラー率推定計算機」も提供しており、510(k)クリアランスがないAIモデルにも手動入力で利用できます。
ステップ2:AIエラーが意思決定と下流効果に与える影響を考慮する
推定されたエラー率が、専門家の意思決定やその後の臨床アウトカムにどのような影響を与えるかを理解することも不可欠です。AIの出力は、人間による解釈的意思決定に影響を与える可能性があります。これにより、AIがなかった場合には発生しなかったであろう、正確な行為と誤った行為の両方を誘発する可能性があります。
正しいAI分類と人間への影響
AIが真陽性(TP: True Positive、疾患が存在し、AIも正しく検出)または真陰性(TN: True Negative、疾患が存在せず、AIも正しく陰性と判断)を提示する場合、それは正しい分類です。TPの場合、専門家はAIの陽性出力と自身の解釈の一致性を検討し、最終的に受け入れるという労力が発生します。TNの場合、不必要な検査を抑制し、対象者を不必要な不安や労力、費用から解放します。
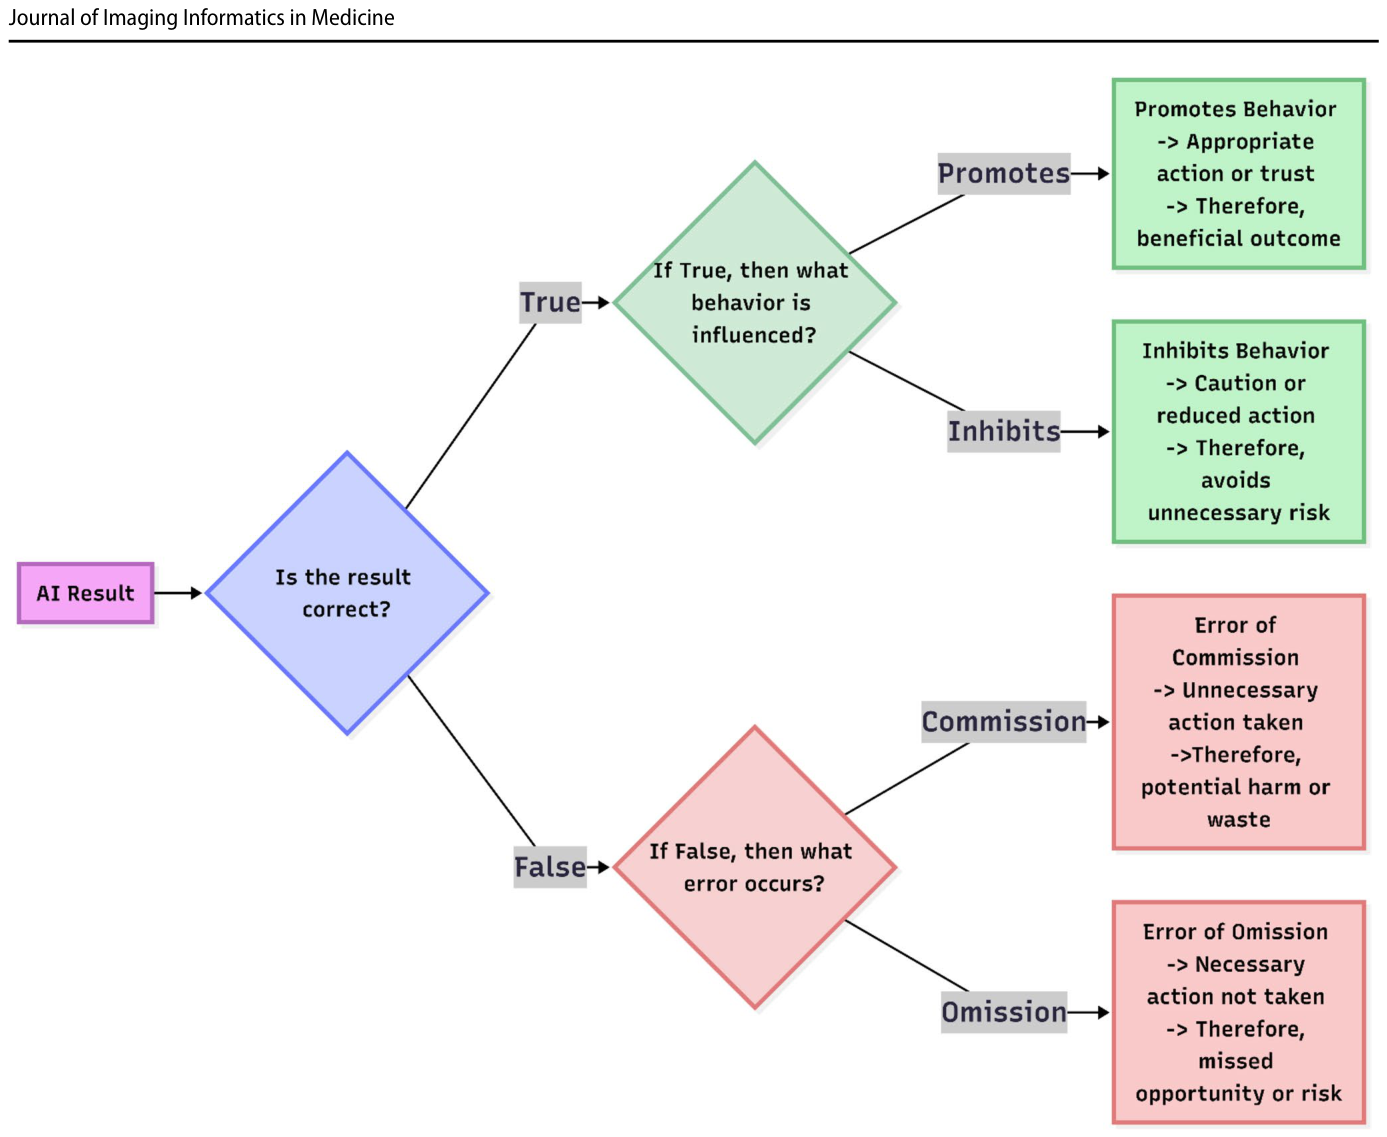
正しいAIの結果は、適切な行動を促進したり、不必要な行動を抑制したりすることで、臨床意思決定を改善し、適切な症例管理とより良い臨床結果につながります。例えば、TPの場合、異常の早期発見につながり、対象者の良好な転帰の可能性を高めます。TNの場合、不必要な検査を避けることで、対象者は不安や労力、費用を節約できます。これらの下流効果には、医療、法的、財政的、心理的、ワークフロー、評判に関するものが含まれ、これらは相互に排他的ではありません。
誤ったAI分類(エラー)と人間への影響
AIの結果は、偽陽性(FP: False Positive、疾患が存在しないのにAIが検出)または偽陰性(FN: False Negative、疾患が存在するのにAIが見落とし)の場合、誤りです。FPは「エラー・オブ・コミッション(行動の過ち)」、すなわち不必要な行動を取る可能性を高めます。FNは「エラー・オブ・オミッション(行動の省略過ち)」、すなわち取るべき行動を取らない可能性を高めます。例えば、不正確なAI出力は、専門家が不正確な臨床行動(エラー・オブ・コミッション)と適切な臨床行動の失敗(エラー・オブ・オミッション)の両方を引き起こす勧告をする可能性があります。
不正確なAIの結果は、より悪いアウトカムにつながるリスクをもたらします。FPの場合、不必要な検査は対象者に不必要な不安、労力、リスク、費用をもたらします。放射線診断施設では、追加の(陰性の)画像を解釈するという非生産的な作業負荷が増加し、ワークフローを阻害します。さらに、AIによるFPが対象者の記録に含まれると、不必要な不安やフォローアップを引き起こし、さらなるワークフローの阻害につながります。FNの場合、必要なフォローアップ検査を見落とすことで、異常の早期発見の機会が失われ、対象者の良好な転帰の可能性が低下します。負の下流効果には、医療、法的、財政的、心理的、ワークフロー、評判に関するものが含まれ、これらは相互に排他的ではありません。
これらのAI結果の確率、意思決定への影響、そして下流効果を文書化するために、本論文では「意思決定と下流効果のリスク評価マトリックス(RADDE)」を提案しています。このマトリックスは、AI結果が臨床意思決定にどのように影響しうるかを専門家が視覚的に理解できるシンプルなツールです。
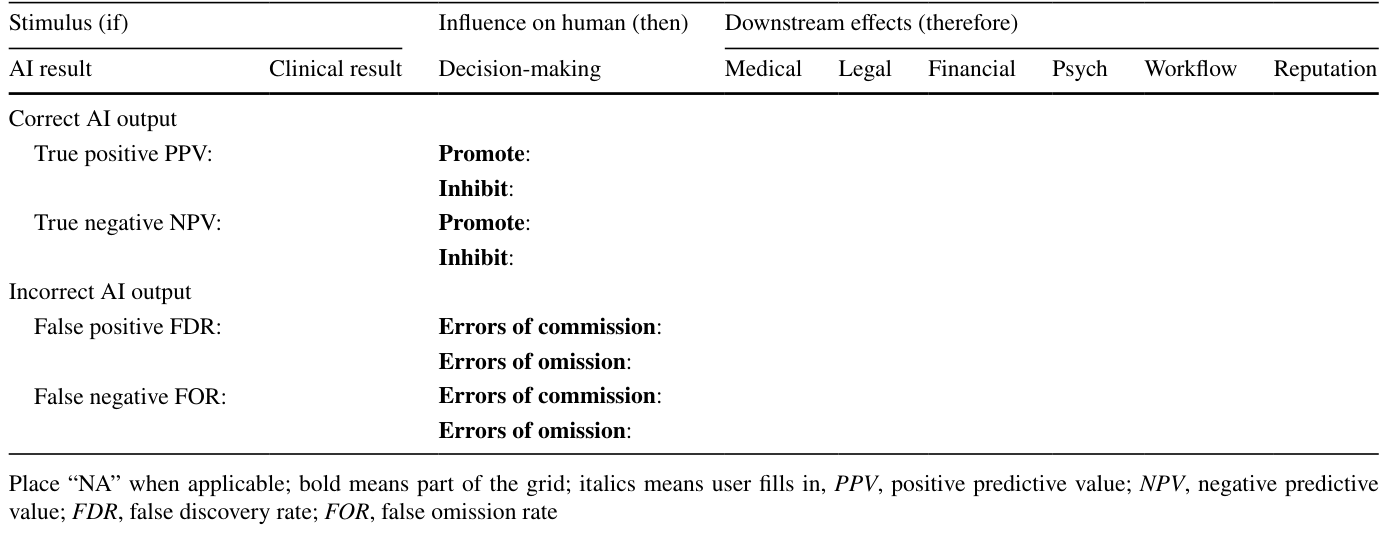
マトリックスは4つの行でTP、TN、FP、FNのAI出力タイプを定義し、各タイプのAI出力の確率(PPV、NPV、FDR、FOR)を定量化し、臨床的定義、意思決定への影響(促進、抑制、エラー・オブ・コミッション、エラー・オブ・オミッション)、および医療、法的、財政的、心理的、ワークフロー、評判といった潜在的な下流効果を記述します。例えば、天気予報AIが雨を予測する例(
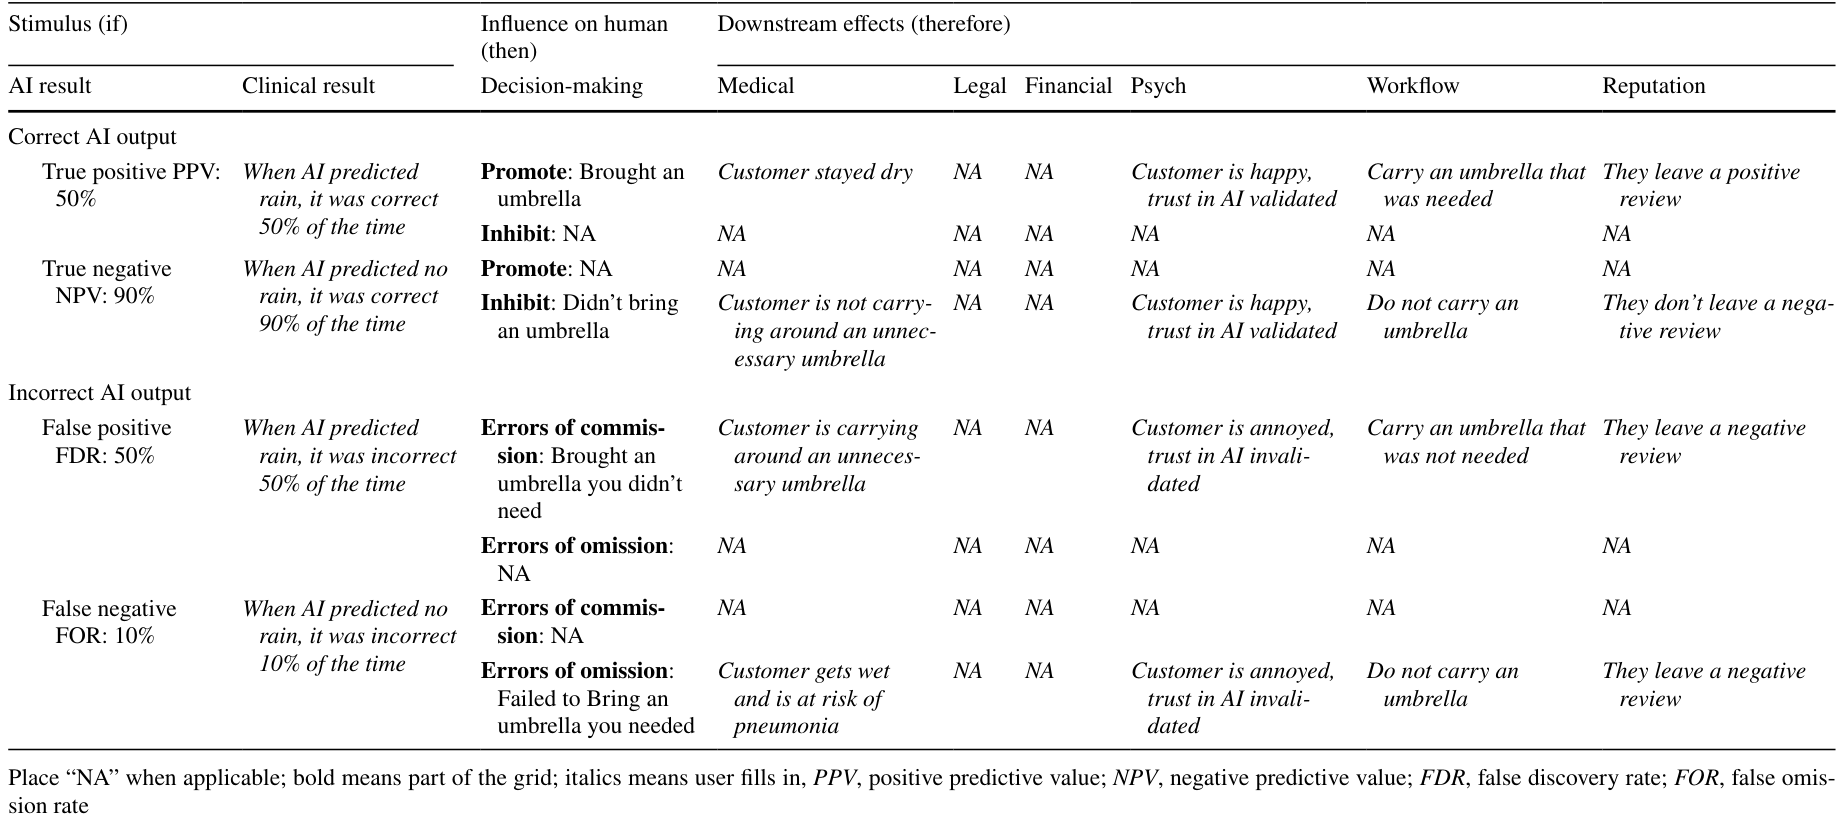
)や、LVO検出AIの例(
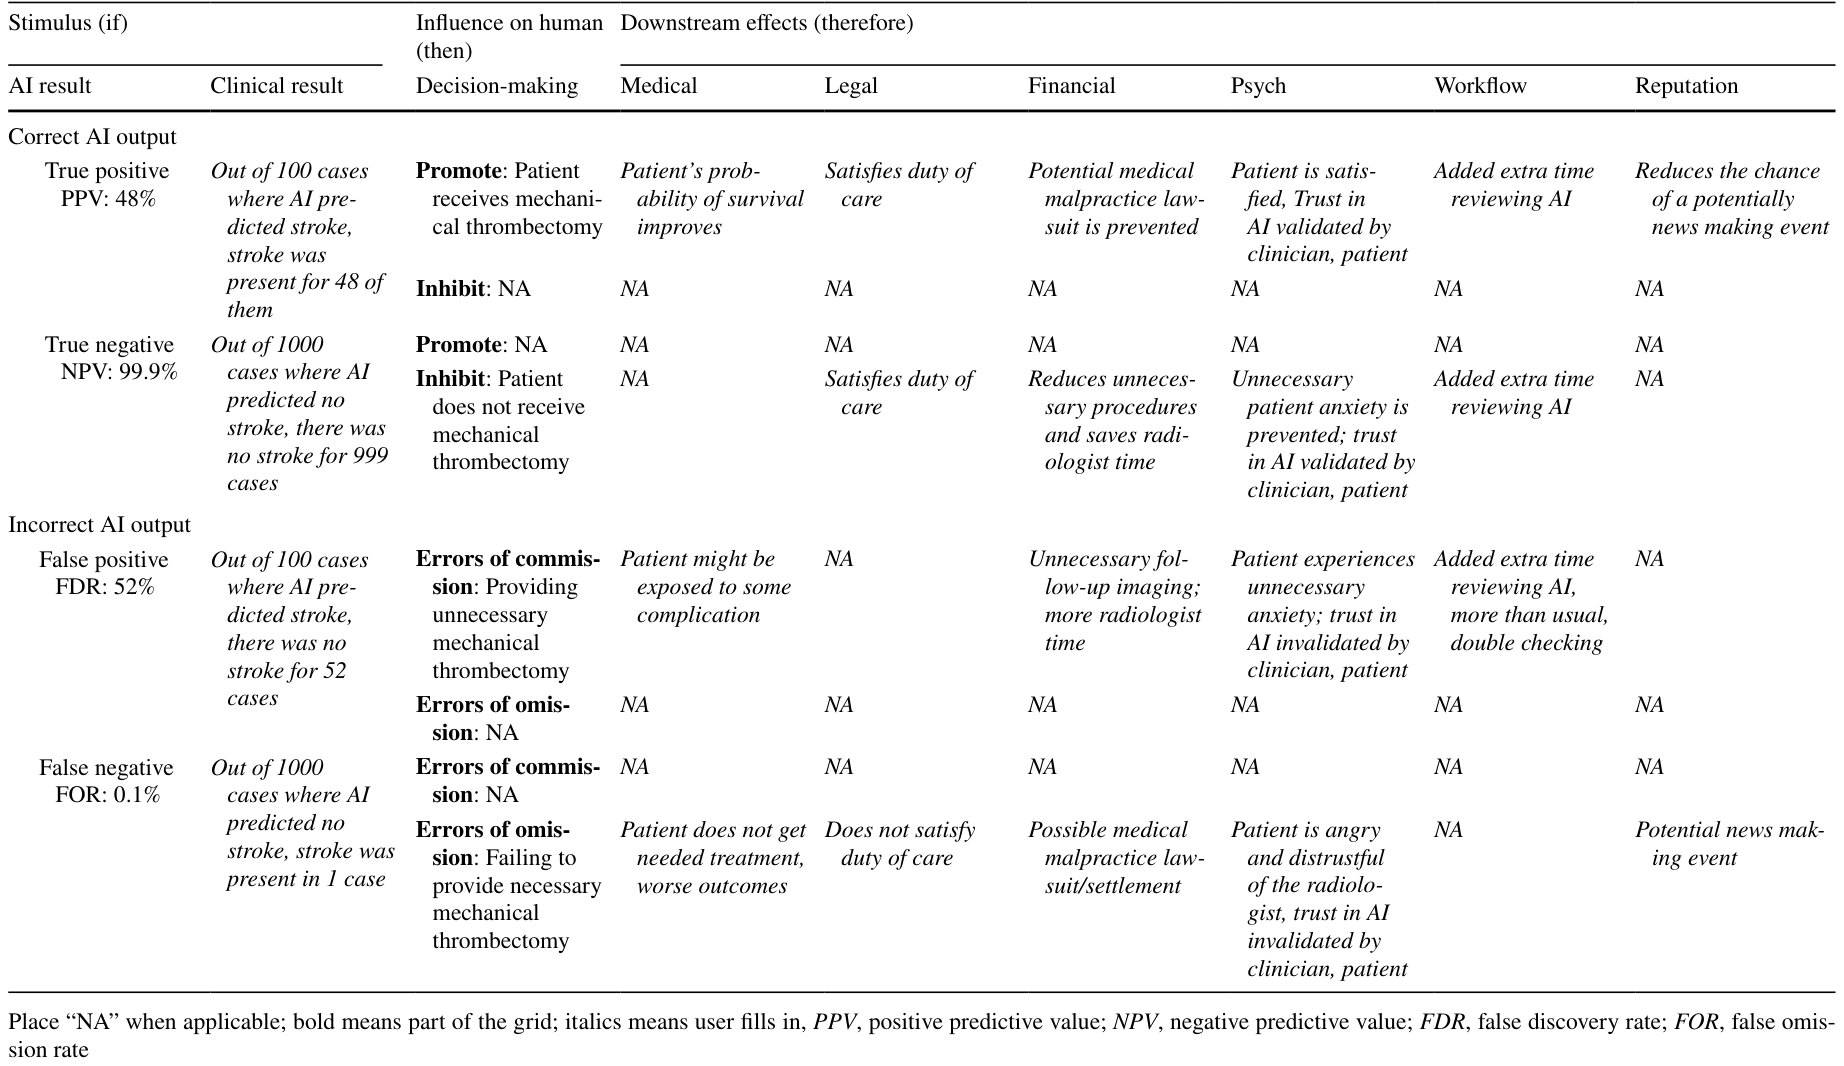
)を通じて、このマトリックスの論理「もし(If)、ならば(then)、ゆえに(therefore)」が示されています。
ステップ3:エラーの頻度とコストを考慮する
AIの誤りがもたらす害を評価する上で、すべてのエラーが同等ではないという重要な事実を考慮する必要があります。例えば、生命を脅かす疾患に対する単一の偽陰性AI出力は、もし専門家が必要なフォローアップ検査を怠る原因となった場合、対象者の死につながる可能性があります。この一つのエラー・オブ・オミッションは、対象者の命に関わるだけでなく、医療訴訟や施設への評判の損失につながる可能性があり、複数の偽陽性AI出力による不必要な検査(エラー・オブ・コミッション)よりもはるかにコストが高い場合があります。専門家は、偽陰性の結果がもたらす深刻な影響を最小限に抑えることに強くインセンティブを感じる傾向があります。したがって、AIシステムのリスク管理は、単にエラー率を特定するだけでなく、各タイプのエラーの「コスト」によってその頻度を重み付けする「適応バイアス」の概念を考慮することが重要です。
さらに、AIモデルのコスト(購入費用、サブスクリプション、ケースごとの料金など)や、導入と維持に必要なインフラ、人員配置を、それが提供する利益(経済的か否かにかかわらず)と比較検討する必要があります。特に、既存の診療報酬コードがないために保険償還されない場合は重要です。AIが正しくても間違っていても、ワークフローに変化をもたらすことは避けられません。ワークフローの効率性への影響(例えば、専門家がレビューすべき新しいデータが追加されるなど)を事前に予測し、評価することが求められます。
このフレームワークは、トリアージ、診断、検出AIシステムに特化しており、偽陽性率と偽陰性率を計算し、これらのエラーの許容度と下流効果を評価することを可能にします。画像取得、画像表示、スケジューリング、適切性、プロトコル、レポート生成に関するAIシステムについては、同様の別のフレームワーク開発が必要です。このフレームワークは、Radiology AI Deployment and Assessment Rubric (RADAR) や、ACR、CAR、ESR、RANZCR、RSNAによる多社会声明のような、包括的なAI評価を意図したものではありません。
結論:データに基づいた賢明なAI導入のために
AIの導入を検討する医療施設は、そのAIモデルが自施設にどのような影響を与えるかを慎重に考慮する必要があります。第一歩は、対象のAIモデルが自施設の集団に対してどのように機能するか、つまりどのようなエラー率を予測できるかを評価することです。これらのエラー率を把握したら、第二ステップとして、それらのエラーが専門家の臨床意思決定、そしてその後の医療、法的、財政的、心理的、ワークフロー、評判に関する下流効果(良い面も悪い面も)にどのように、どれくらいの頻度で影響するかを検討します。これらの問いに対処して初めて、エラーの頻度とコストを比較検討し(ステップ3)、自施設の状況において特定のAIシステムの導入が正当化されるかどうかについて、情報に基づいた意思決定を下すことができます。複数のAIシステムから選択する場合、本論文で提案する3ステップ評価は、データに基づいた比較・選択方法を推進する上で大きな有用性を提供するでしょう。
用語集
- 人工知能 (AI): 人間の知的能力を模倣する技術。
- 感度 (Sensitivity): 真に陽性の対象者を正しく陽性と識別する能力の割合。
- 特異度 (Specificity): 真に陰性の対象者を正しく陰性と識別する能力の割合。
- ROC曲線下面積 (ROC AUC): ROC曲線の下の面積で、AIモデルの識別能力の全体的な指標。
- 陽性反応的中度 (PPV): AIが陽性と予測した中で、実際に陽性であった割合。
- 陰性反応的中度 (NPV): AIが陰性と予測した中で、実際に陰性であった割合。
- 偽陽性率 (FDR): AIが陽性と予測した中で、実際には陰性であった(誤って陽性と判断した)割合。(1-PPV)
- 偽陰性率 (FOR): AIが陰性と予測した中で、実際には陽性であった(見落とした)割合。(1-NPV)
- 有病率 (Prevalence): ある特定の時点または期間において、集団の中で疾患を持つ対象者の割合。
- ベイズの定理 (Bayes’ Theorem): 条件付き確率を求めるための定理で、既存の知識を用いて新しい証拠に基づいて確率を更新する。
- 510(k)クリアランス: 米国FDAによる医療機器の市販前届出制度。既存の認可済み機器と同等性を示すことでクリアランスが得られる。
- CADt (Computer-Assisted Triage and Notification software): ワークリストの優先順位付けを助け、緊急性の高い所見のフラグ付けを行うソフトウェア。診断には関与しない。
- CADe/CADx (Computer-Assisted Detection/Diagnosis software): 専門家の最終診断解釈に組み込まれる所見の検出や特徴付けを行うソフトウェア。
- RADDE (Risk Assessment of Decision-making and Downstream Effects): AIのエラーが意思決定やその後の医療、法的、財政的、心理的、ワークフロー、評判に与える影響を評価するためのリスク評価マトリックス。
- ゴールデンスタンダード: 診断や評価において、最も信頼性が高く、比較の基準となる方法や指標。
- エラー・オブ・コミッション: 誤った行動を取ること(例:不必要な検査)。
- エラー・オブ・オミッション: 取るべき行動を取らないこと(例:必要な検査を見落とす)。
コメントを残す