
医療画像AIの「ブラックボックス」を解き明かす:信頼性と解釈性を両立する品質管理フレームワーク「INFORMER」
解説対象論文: INFORMER—Interpretability-Founded Monitoring of Medical Image Deep Learning Models: Application to Chest X-ray Pathologies
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月18日時点)
深層学習は医療画像診断に革命をもたらしましたが、その「ブラックボックス」的な性質は臨床現場での信頼獲得と安全な導入を阻んでいます。特にマルチラベル分類では、品質管理手法が未発達で、モデルの出力のみに依存しがちでした。この課題に対し、本研究では予測の信頼性と解釈性の両方を高める品質管理フレームワーク「INFORMER」を提案します。これは勾配レベルの情報を活用し、さらに類似症例に基づく説明を提供する「RE-INFORMER」も含まれます。本研究は、胸部X線画像データセットで評価され、既存手法を上回る性能とロバスト性、そして臨床応用における高い可能性を示しました。
医療AIの信頼性向上へ:予測の根拠を明らかにする新フレームワーク
どうも、Beyond the Pixelです。深層学習(ディープラーニング)は医療画像診断において目覚ましい進歩を遂げていますが、その「ブラックボックス」的な性質、つまり予測の根拠が不明瞭である点が、臨床現場での信頼獲得と安全な導入を妨げる大きな課題となっています。特に、一つの画像から複数の病変を同時に検出するマルチラベル分類タスクでは、品質管理の手法がまだ発展途上にあり、一般的にモデルの出力結果のみに依存していました。しかし、予測の信頼性をより深く反映する「勾配レベル情報」を組み込むことで、この課題を解決できる可能性があります。
本研究では、マルチラベル医療画像分類の信頼性と解釈性の両方を向上させる新しい品質管理フレームワーク「INFORMER(Interpretability-Founded Monitoring of Medical Image Deep Learning Models)」が提案されました。このフレームワークは、セイリエンスマップ(ヒートマップ)から得られる情報を分析し、信頼性の低い予測を特定するグラフベースのクラス識別性手法を含んでいます。さらに、その拡張版である「RE-INFORMER(Retrieval-Based INFORMER)」は、フラグ付けされた出力に対して、過去の類似症例に基づいた説明を提供する機能も備えています。
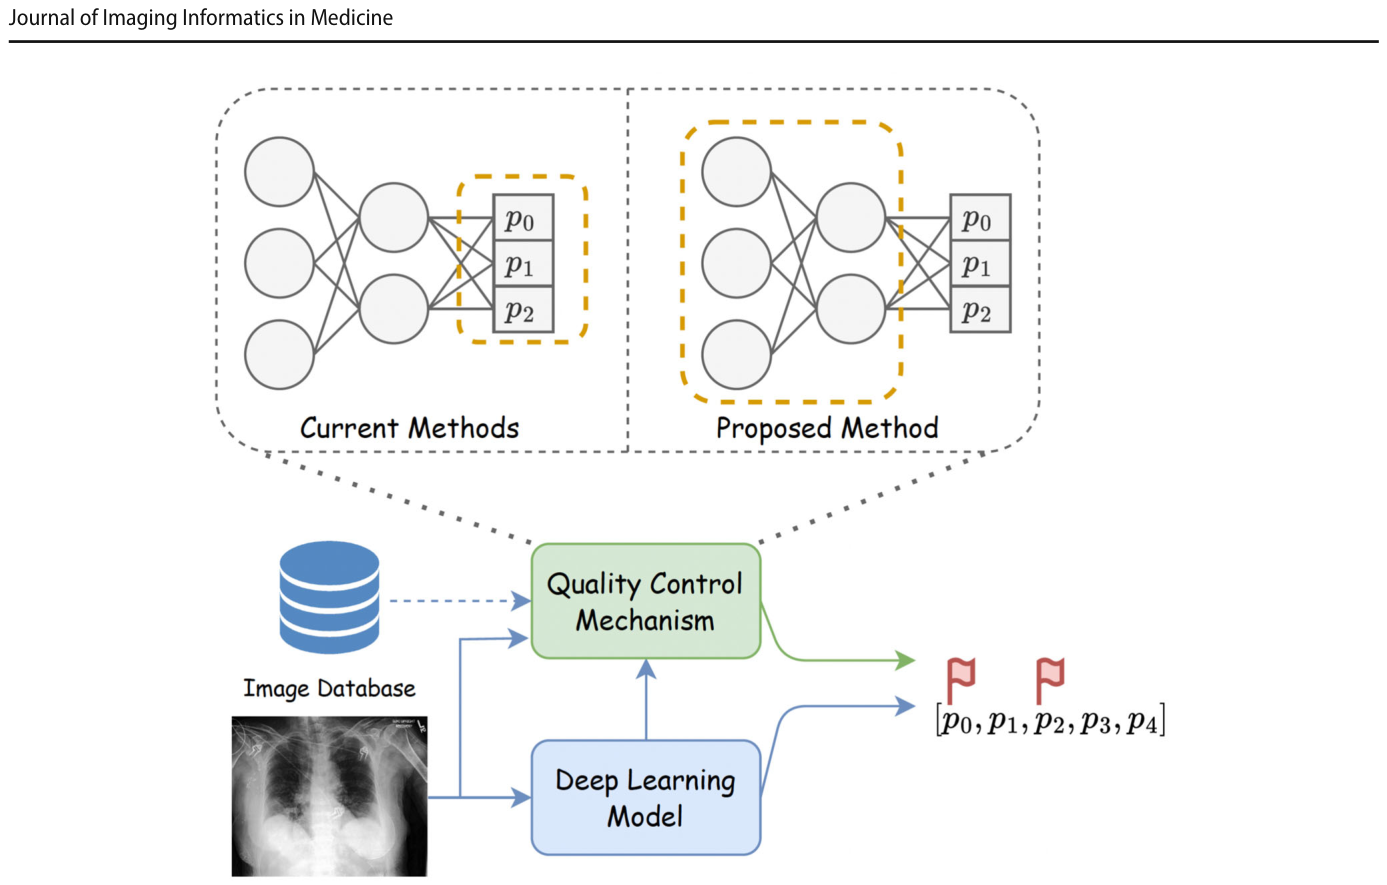
提案された手法は、大規模な胸部X線画像データセットであるCheXpertデータセットで評価され、既存の出力ベースの品質管理アプローチと比較されました。ブートストラップテストセットを用いたロバスト性(頑健性)評価では、INFORMERフレームワークがベースライン手法を上回り、F1スコアと感度において優れた性能を示しました。また、入力画像にノイズを加えた条件下でもその優位性が確認されています。これらの結果は、勾配レベルの情報とグラフベースの分析が、マルチラベル医療画像分類における品質管理の効果、透明性、および臨床適用性を高める可能性を示しています。
INFORMERの核心:勾配情報を活用した品質管理
INFORMERは、医療画像マルチラベル分類における深層学習モデルの予測信頼性を評価するために、クラスレベルの解釈パターンを用いるという新しいコンセプトを導入しています。具体的には、選択されたアトリビューション手法(寄与度分析)を用いて、各クラス(病変)について個々の対象者のセイリエンスマップ(ヒートマップ)を計算します。これらのヒートマップは、モデルが各クラスの予測を行う際に、画像のどの領域が最も寄与したかを視覚的に示します。
各クラスが互いにどれだけ分離可能であるかを定量化するために、セイリエンスマップ間のペアワイズコサイン距離(類似度)を計算し、「解釈性クラス識別性ベクトル(ICDV)」を構成します。このICDVのノルム(大きさ)は、そのクラスの識別性の尺度として機能します。
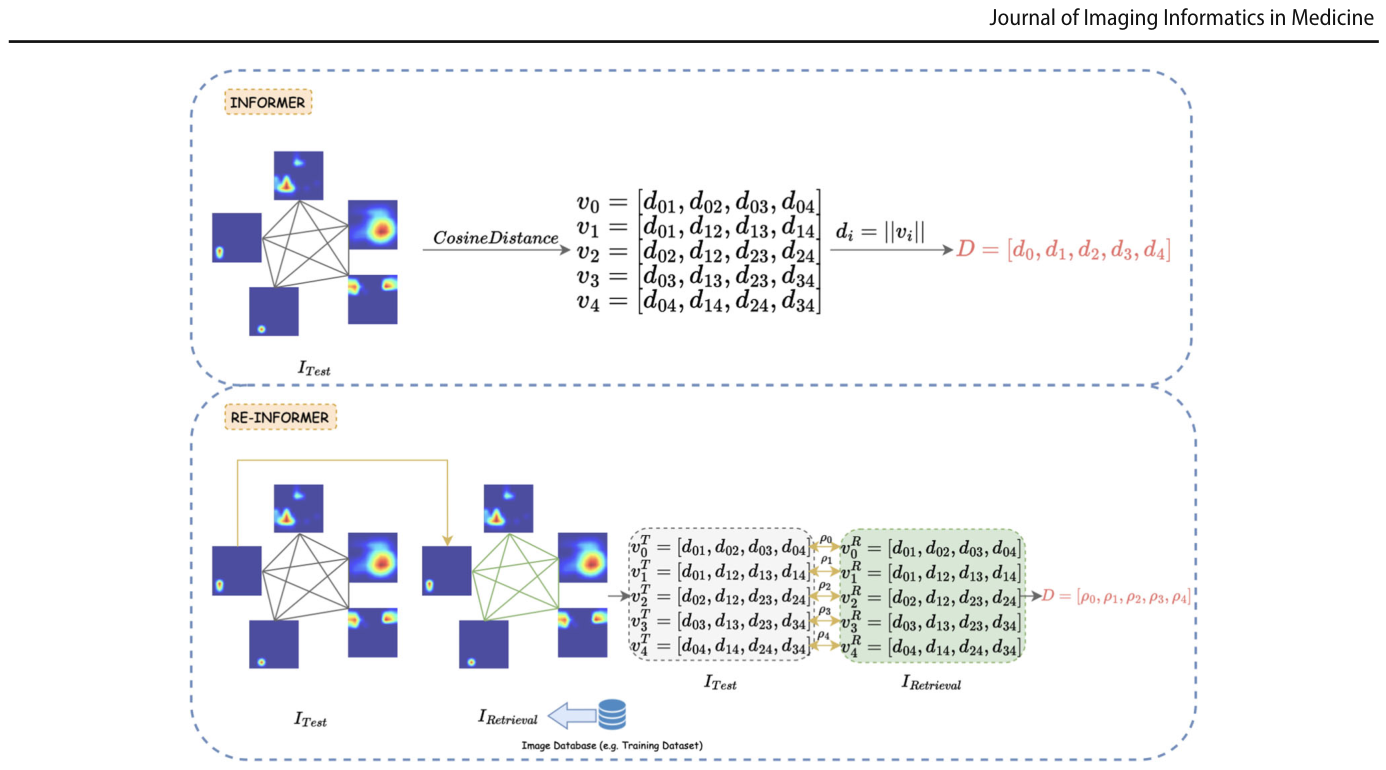
提案手法の根底にある仮説は、「確信度の高いモデルは、異なるクラス間で明確に異なるセイリエンスマップを生成する」というものです。逆に、クラス間の分離性が低い、つまり異なるクラス間で似たような解釈パターンが示される場合、それはモデルの不確実性や予測の曖昧さを反映している可能性があります。この洞察を実用的かつ軽量な品質管理戦略へと落とし込み、医療画像におけるマルチラベル分類タスクに特化させています。
RE-INFORMER:根拠となる類似症例を提示し、解釈性を強化
RE-INFORMERは、INFORMERの中核となるアイデアを拡張し、選択されたデータベース(例: 訓練データセット)から意味的に類似した症例を検索するメカニズムを組み込むことで、解釈性に基づいた不確実性推定を強化します。RE-INFORMERでは、テスト画像と訓練データセットから取得された最も類似した画像の間の解釈パターンを比較します。
この手法の基本的な考え方は、「信頼性の高い予測は、そのテスト画像と参照データベース内の最も類似した症例との間で、クラス間の分離性やクラス固有の特性に関して、強い相関(整合性)を示すはずである」というものです。言い換えれば、テスト画像と類似症例のセイリエンスマップのパターンが似ているほど、モデルの予測は信頼できると判断します。
品質管理システムによってフラグ付けされた予測(不確実な予測)に対して、RE-INFORMERは「予測されたラベル」に対応する類似症例と、「反転された(つまり、モデルが誤っている可能性を示唆する)ラベル」に対応する類似症例を並べて表示します。この比較による視覚化は、モデルの出力に疑問を呈する根拠を人間が理解できる形で提供し、品質管理システムの説明戦略を形成します。専門家は、提示された類似症例を評価することで、フラグ付けされた予測の解釈に対する関連性を判断しました。
評価方法とデータセット:胸部X線画像による検証
本研究の実験は、大規模な公開胸部X線データセットであるCheXpertデータセットを用いて実施されました。
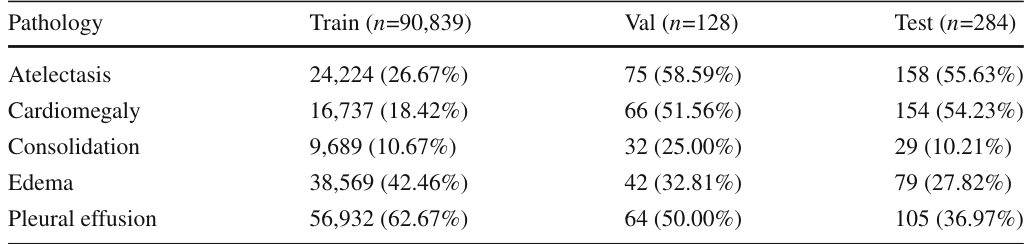
このデータセットは、65,240名の対象者から得られた224,316枚の画像で構成されています。検証セットとテストセットの画像は、各画像が3名の認定された放射線専門家によって独立してアノテーション(注釈付け)されています。CheXpertチャレンジのセットアップに倣い、本研究では臨床的重要性から無気肺、心肥大、浸潤影、浮腫、胸水の5つの主要な病変に焦点を当てました。
データの前処理として、5つの病変のうちいずれかについて「不確実」なラベルを持つ対象者は除外されました。また、「なし」と「記載なし」のラベルは陰性サンプルとしてまとめられました。最終的に、90,839枚の訓練画像、128枚の検証画像、284枚のテスト画像を含むフィルタリングされたデータセットが使用されました。提案手法のロバスト性とバリアンス(ばらつき)を評価するため、テストセットのブートストラップバージョン(元のテストセットから重複を許してサンプリングし、同サイズで再構成したセット)を30種類生成しました。
ベースライン手法として、広く使われている2つの不確実性推定技術、すなわち予測エントロピーとテスト時データ拡張(TTA)が比較対象として用いられました。予測エントロピーは、各クラスの予測確率から不確実性を測定し、TTAは入力画像に複数の変換を適用し、その出力のばらつきから不確実性を推定します。これらのベースラインは、モデルの出力(ロジット)のみを利用して信頼度を推定するアプローチであり、提案手法の解釈性駆動型品質管理フレームワークとの公正な比較を可能にします。
実装には、ImageNetで事前学習済みのDenseNetモデルがCheXpertデータセットで訓練されました。
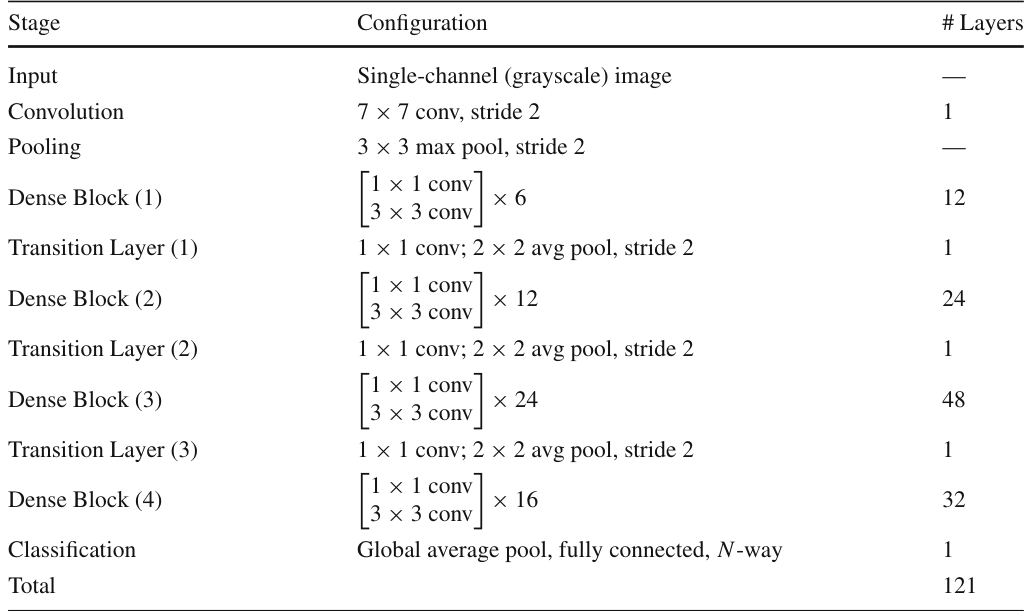
モデルはAdam最適化手法を使用し、3エポック訓練されました。セイリエンスマップの計算にはCaptumライブラリのLRP(層ごとの関連性伝播)とIxG(入力×勾配)の2つの解釈性手法が用いられました。RE-INFORMERの画像エンコーダとしてはRAD-DINOが採用され、訓練セットを参照データベースとして類似画像を検索しました。品質管理の閾値は、各手法と各クラスに対して検証セットで決定されました。
実験結果:精度、感度、ロバスト性における優位性
本研究の実験結果は、提案されたINFORMERおよびRE-INFORMERフレームワークが、深層学習モデルの予測品質管理においてベースライン手法を上回ることを示しています。
F1スコアの比較
元のテストセットでのF1スコアの比較では、INFORMERとRE-INFORMERの両方がベースラインよりも高いスコアを達成しました。特に、INFORMERのLRPバリアントは、5つのクラス全体で平均F1スコア0.574を記録し、ベースライン(0.563)に対して2%高い値を示しました。
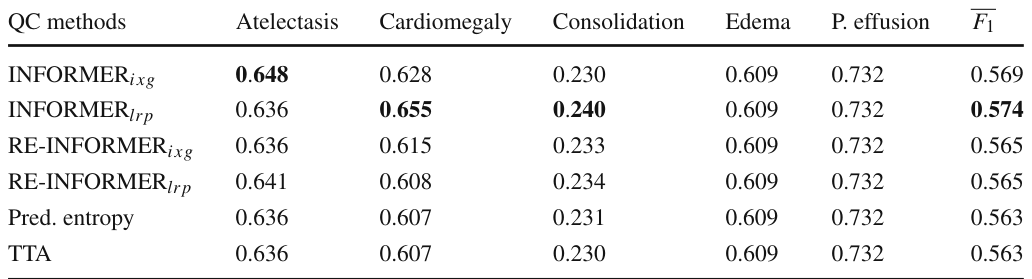
浮腫と胸水では全手法で同様の性能を示しましたが、INFORMERは無気肺、心肥大、浸潤影において特に優れた性能を発揮しました。
感度の比較
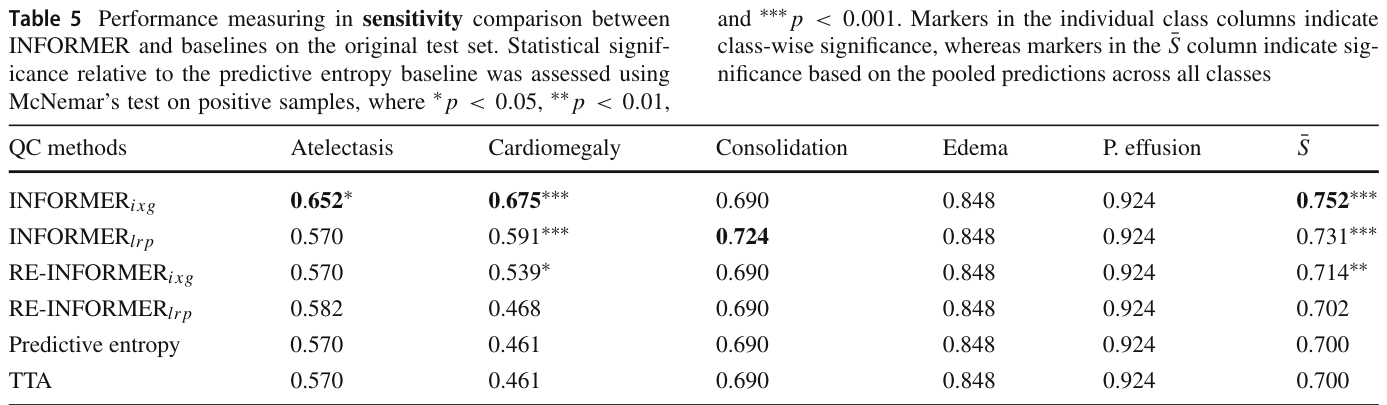
感度(SENS)の測定では、INFORMERのIxGバリアントが無気肺の検出においてベースラインと比較して14%高い感度を達成しました(0.752 vs 0.700)。INFORMERのLRPバリアントも浸潤影で5%の感度向上を示しました。
ブートストラップテストセットでの性能ランキング
30種類のブートストラップテストセットを用いたランキング評価では、INFORMERとRE-INFORMERの両方がベースライン手法を上回る性能を示しました。INFORMERのLRPバリアントは平均ランク1.83 ± 1.05と、低い標準偏差で安定した高い性能を達成しました。
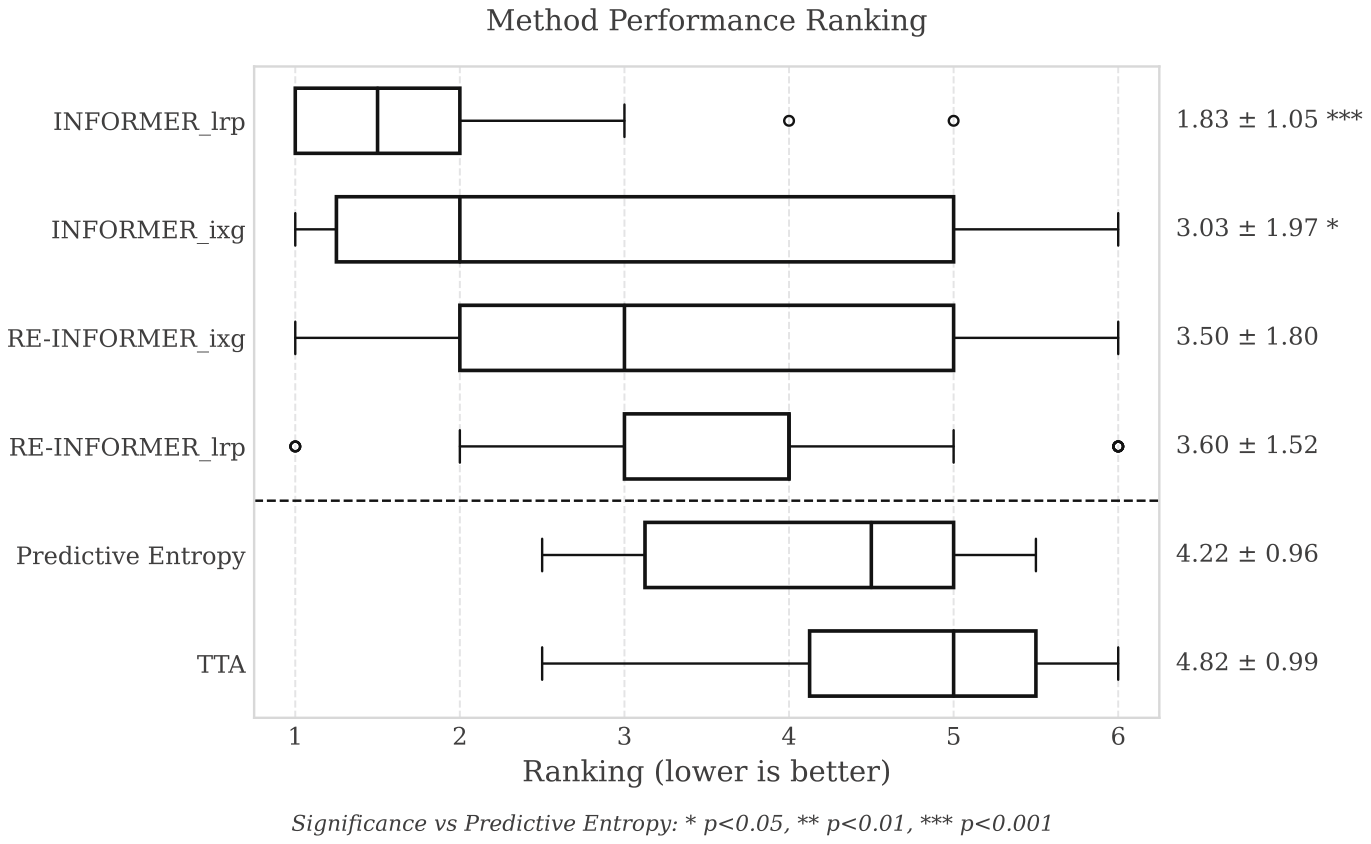
これに対し、ベースラインの予測エントロピーの平均ランクは4.22 ± 0.96でした。この結果は、INFORMERがほとんどのブートストラップテストセットにおいて、常にトップ2のメソッドにランクインしたことを示しています。
閾値変動に対する感度分析
品質管理システムの閾値感度を評価するため、元の閾値を±5%変動させた実験が行われました。結果として、エントロピーベースの品質管理手法が閾値変動に対してより敏感であり、特に閾値が5%減少した際に性能が大きく低下することが示されました。
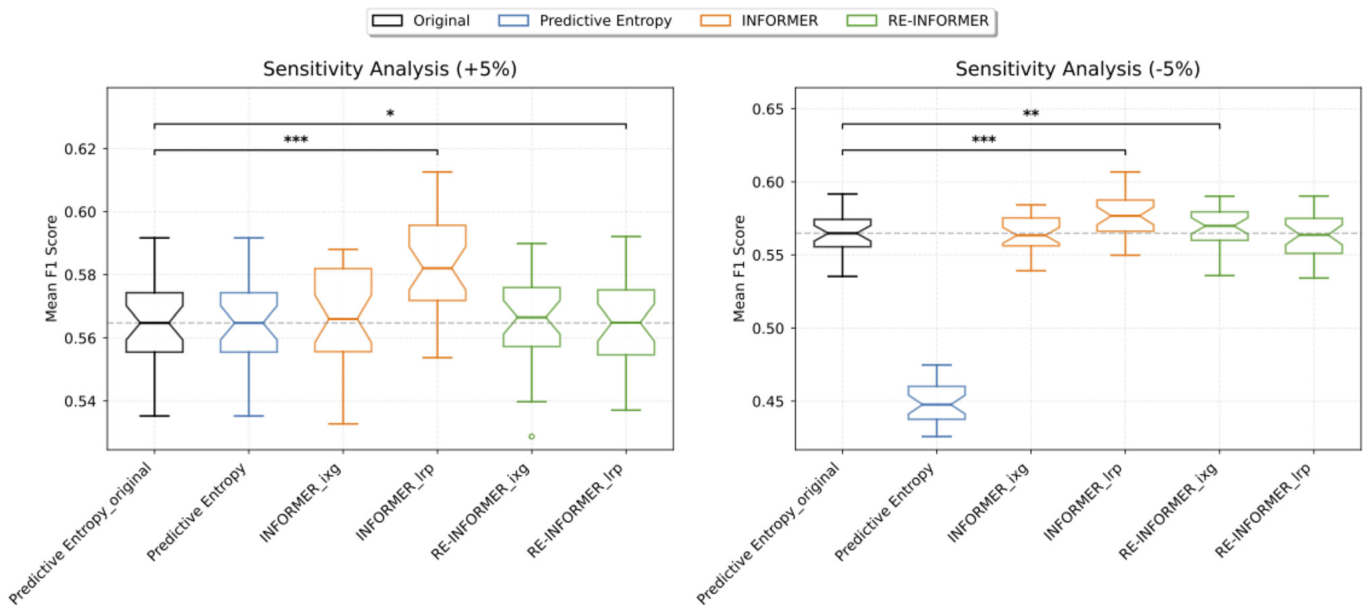
対照的に、INFORMERとRE-INFORMERは閾値のわずかな変化に対してより高いロバスト性を示し、安定した性能を維持しました。
テスト時ノイズ画像に対するロバスト性
入力画像にガウスノイズを加えてロバスト性を評価した実験では、INFORMERが全てのノイズレベルにおいてベースライン手法を一貫して上回り、高いF1スコアを維持しました。
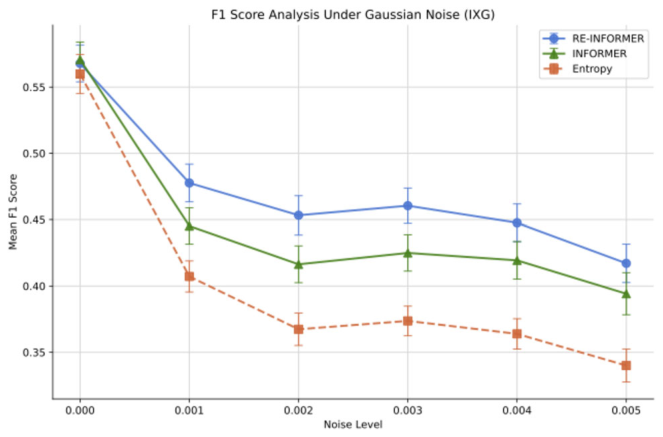
特にRE-INFORMERは、ノイズのあるテスト画像条件下でエントロピーベースの品質管理と比較してより顕著な優位性を示しました。
アラート精度と専門家による評価
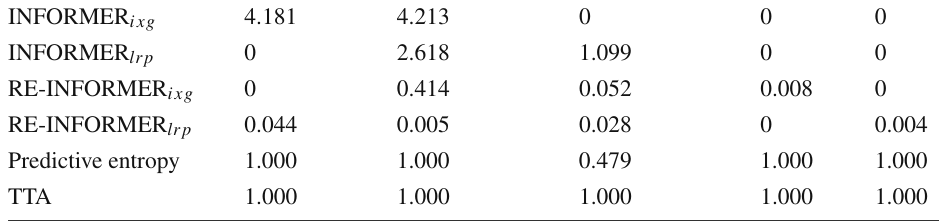
各病変におけるフラグ付けされた予測の精度(正しく修正された割合)とアラート数は、
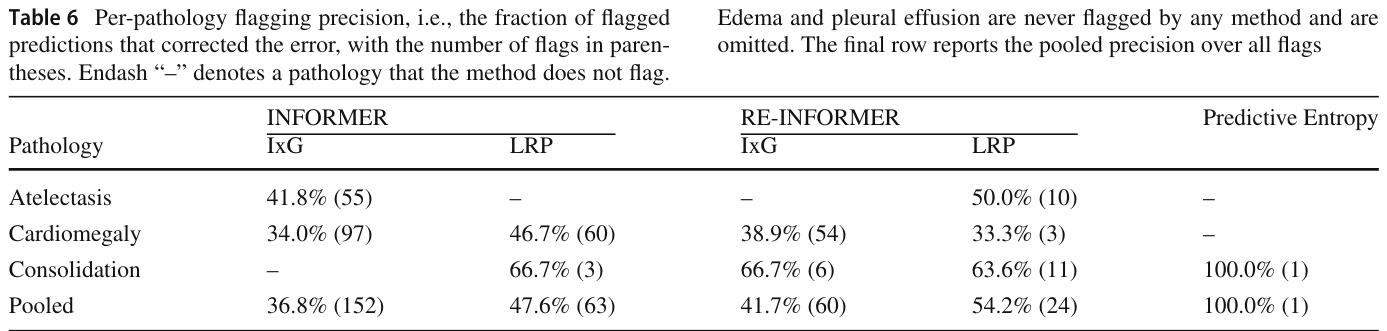
に示されています。INFORMERは全体的に多くのアラートを生成しましたが、RE-INFORMERはアラート数を抑えつつ、より高い精度を達成しました。
さらに、RE-INFORMERの類似症例提示機能の有用性を評価するために、専門家による臨床的関連性の評価が行われました。
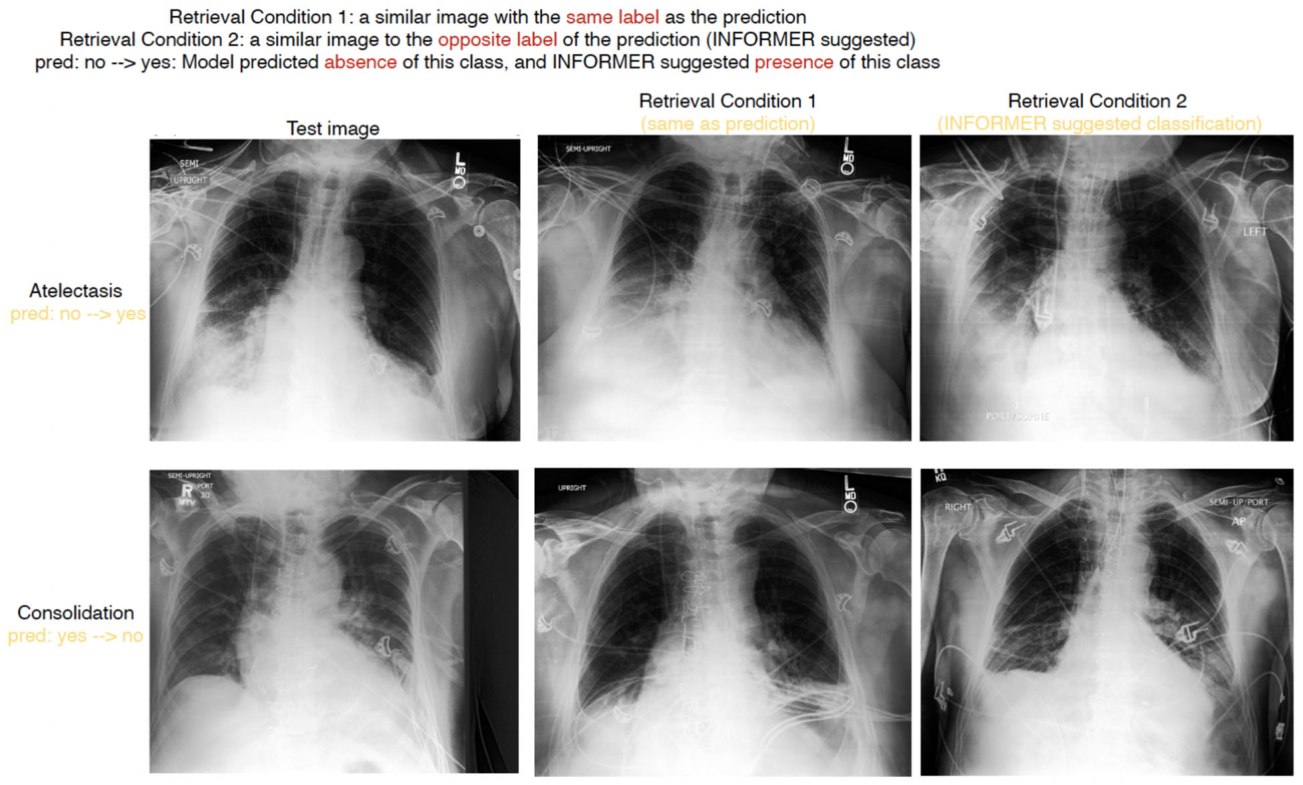
専門家は、フラグ付けされた画像と、モデルの予測に基づく類似症例、および反転された(モデルが誤っている可能性を示唆する)ラベルに基づく類似症例を比較し、フラグ付けされた症例とより整合性のある状態を判断しました。7つの症例セットのうち、専門家は6つの症例でフラグ付けシステムと意見が一致し、示唆されたクラスに関連する病変が予測されたクラスの状態とより一貫していることを示しました。また、専門家は、類似症例に基づく説明が品質管理システムの信頼性と透明性を高めると評価しました。
考察と今後の展望:臨床的意義と課題
本研究の発見は、品質管理システムのモデル予測改善が臨床現場に大きな影響を与える可能性を示唆しています。INFORMERのIxGバリアントとRE-INFORMERのLRPバリアントは、ベースラインモデルと比較して感度が向上しています。例えば、無気肺のケースでは、両手法とも高い感度(SENS)を達成しており、これは特異度(SPEC)のわずかな低下を伴うものの、臨床的には許容され、場合によっては望ましいトレードオフとなり得ます。無気肺は可逆的な原因が多く、呼吸運動や体位変換などの非侵襲的な介入で管理されることが多いため、感度の向上は臨床のベストプラクティスに合致します。
浸潤影の検出においては、INFORMERのLRPバリアントがベースライン手法を感度(SENS: ベースライン0.690、INFORMERlrp 0.724)で上回り、特異度(SPEC: 予測エントロピー0.514、INFORMERlrp 0.510)は同程度でした。
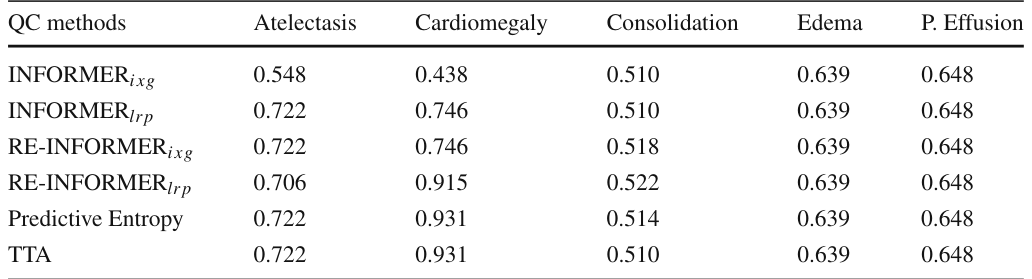
コミュニティ獲得性肺炎(CAP)は浸潤影として現れることが多く、米国だけでも年間150万人もの入院原因となっています。この結果を考慮すると、感度0.690のベースラインが約103万5千件の症例を正しく特定するのに対し、感度0.724のINFORMERlrpは約108万6千件を検出し、追加で5万1千件の対象者を検出できる可能性があります。これらの症例を早期に発見することは、CAPが呼吸不全や敗血症などの重篤な結果に進展するのを防ぐ上で極めて重要です。
本研究で提案された品質管理アプローチは、モデルの勾配情報を活用してマルチラベル分類における予測の不確実性を評価する新しいものです。INFORMERは優れたF1スコアを達成するだけでなく、なぜ特定の予測がフラグ付けされたのかについて勾配ベースの根拠を提供します。さらにRE-INFORMERは、フラグ付けされた症例に対して参照例を提示することで、症例ベースの解釈性を追加します。重要なことに、提案されたフレームワークは特定の疾患に特化しておらず、セイリエンスマップや埋め込み空間から得られる情報に依存しているため、様々な病態への適用可能性を支持しています。RE-INFORMER単体ではINFORMERの品質管理性能を上回ることはありませんが、予測エントロピーのベースラインを上回り、IxG設定ではINFORMERやベースラインよりも入力摂動に対してロバスト性を示しました。
専門家による評価では、類似症例がフラグ付けプロセスの透明性を高め、信頼を醸成すると判断されました。これは、AIモデルが「ブラックボックス」として機能する場合において、臨床的信頼と導入のために透明性と解釈性が重要であるという点において特に意義があります。両手法は、様々な決定閾値においても安定した性能を維持しました。
研究の限界と今後の展望
これらの品質管理手法にはいくつかの限界があります。例えば、複数の所見が画像内で実質的に重複する領域を占める場合、クラス固有のセイリエンスパターンが区別しにくくなり、提案手法の効果が低下する可能性があります。浮腫や胸水に関しては、基礎となる分類器が既に高い感度を達成しており、評価された品質管理設定では追加のアラートが生成されませんでした。また、RE-INFORMERで使用された参照データベースはCheXpert訓練セットであり、そのラベルは放射線レポートから自動抽出されたもので、手動の画像レベルレビューで検証されていません。不確実なラベルは除外したものの、潜在的なラベルの不整合が品質管理シグナルや専門家による参照例の解釈に影響を与える可能性があります。アラートがないからといって予測が正しいと確認できるわけではなく、誤ったアラートは不必要なレビューにつながる可能性があります。すべてのアラートは専門家による解釈を必要とします。
今後の研究の方向性としては、品質管理フレームワークを他の病変や、医療画像とテキストレポートを組み合わせたマルチモーダル設定に拡張し、臨床応用における汎用性とモデルの信頼性をさらに評価する計画です。また、クラス間の関係性をより深く捉えるためにグラフ構造を詳細に分析することを目指しています。さらに、トランスフォーマーベースのモデルへのシステム適応も有望な方向性です。専門家からは、画像に病変の局所的なアノテーション(例: バウンディングボックス)が伴えば、これらの参照が研修医などの判断をさらに支援できる可能性があるとの提案もありました。
まとめ:臨床現場に信頼をもたらすAI品質管理へ
本研究は、勾配ベースの品質管理が、マルチラベル医療画像分類の信頼性と解釈性の両方を改善できることを示しています。出力確率のみに依存するのではなく、勾配レベルの情報を組み込むことで、INFORMERとRE-INFORMERは、改善された性能、摂動や閾値に対するロバストな挙動、そして臨床的に重要な所見に対する高い感度を達成しました。RE-INFORMERの検索ベースの拡張機能は、フラグ付けされた予測に対して症例ベースの説明を提供することで、解釈性をさらに強化し、透明性と人間による監視をサポートします。これらの結果は、勾配情報を活用した品質管理フレームワークが、臨床画像診断における人工知能システムの信頼性、安全性、および実用的な導入を向上させる大きな可能性を秘めていることを示唆しています。
用語集
- 深層学習 (Deep Learning): 複数の層を持つニューラルネットワークを使って、データから特徴を自動的に学習するAI技術です。
- マルチラベル分類 (Multi-label classification): 1つの入力(画像など)に対して、複数の異なるラベル(病変など)を同時に予測するタスクです。
- 解釈性 (Interpretability): AIモデルがどのように予測を行ったかを人間が理解できる度合いです。
- 品質管理 (Quality Control; QC): AIモデルの予測の信頼性を評価し、不確実なケースを特定・対処する仕組みです。
- 勾配レベル情報 (Gradient-level information): モデルの出力が入力データに対してどれだけ敏感に変化するかを示す情報で、予測の信頼性をより深く反映します。
- セイリエンスマップ (Saliency Map) / ヒートマップ (Heatmap): 画像のどの領域がAIモデルの特定の予測に最も寄与したかを示す視覚的な図です。
- クラス識別性 (Class-distinctiveness): 異なるクラス間でのAIモデルの予測パターンやセイリエンスマップがどれだけ明確に区別できるかを示す度合いです。
- F1スコア (F1 score): 予測の精度(適合率)と再現率のバランスを示す評価指標です。
- 感度 (Sensitivity): 真に陽性のものを正しく陽性と予測する割合です。
- 特異度 (Specificity): 真に陰性のものを正しく陰性と予測する割合です。
- ロバスト性 (Robustness): モデルがノイズや変化のある入力に対しても安定した性能を維持する能力です。
- CheXpertデータセット (CheXpert dataset): 胸部X線画像とそれに付随する放射線レポートから抽出されたラベルを含む大規模な公開データセットです。
- 予測エントロピー (Predictive Entropy): モデルの予測における不確実性の度合いを示す指標です。値が高いほど不確実性が高いとされます。
- テスト時データ拡張 (Test-Time Augmentation; TTA): 推論時に複数の異なる方法で画像を変換し、それぞれで予測を行って結果のばらつきから不確実性を推定する手法です。
- 無気肺 (Atelectasis): 肺の一部または全体が虚脱し、空気が入らなくなった状態です。
- 心肥大 (Cardiomegaly): 心臓が通常よりも大きくなった状態です。
- 浸潤影 (Consolidation): 肺炎などで肺胞内に液体が貯留し、X線画像で白く見える領域です。
- 浮腫 (Edema): 体組織に過剰な水分がたまった状態です。
- 胸水 (Pleural effusion): 肺と胸壁の間の空間(胸膜腔)に液体が貯留した状態です。
- RAD-DINO: 医療画像に特化した自己教師あり学習に基づく画像エンコーダの一つです。
コメントを残す