
医療画像分類AIの最前線:CNN、ViT、ハイブリッドモデルの徹底比較と臨床応用への課題
解説対象論文: A Clinically Grounded Review of Medical Image Classification: Quantitative Insights into CNNs, Vision Transformers, and Hybrid CNN-ViT Models
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月8日時点)
医療画像分類は、畳み込みニューラルネットワーク(CNN)、Vision Transformer(ViT)、そしてそれらを組み合わせたハイブリッドモデルの登場により目覚ましい進歩を遂げています。しかし、現実の臨床現場でこれらのAIモデルが広く活用されるまでには、データセットへの依存、評価方法の一貫性の欠如、そして外部検証の不足といった重要な課題が残されています。本レビューは、これらの主要なモデルファミリーを包括的に比較し、医療画像分類における現在の状況と、将来の臨床応用に向けた重要な洞察を提供します。
はじめに:進化する医療画像分類AI
どうも、Beyond the Pixelです。医療画像分類は、コンピューター支援診断において複雑な画像データの自動解釈を支援し、専門家の意思決定をサポートする重要な要素となっています。近年、深層学習、特に畳み込みニューラルネットワーク(CNN)、Vision Transformer(ViT)、そしてこれらを組み合わせたハイブリッドCNN-ViTアーキテクチャの進展により、CT、X線、OCT(光干渉断層計)、超音波、顕微鏡画像など、様々な画像モダリティにおいて画像認識能力が大幅に向上しました。しかし、その目覚ましい進歩にもかかわらず、これらのAIモデルが実際に臨床現場で広く活用されるまでには、データセットへの依存性、評価方法の一貫性の欠如、そして外部検証の不足といった重要な課題が残されています。本レビューは、これらの主要なモデルファミリーを臨床的な観点から比較し、医療画像分類における現在の状況と、将来の臨床応用に向けた重要な洞察を提供します。
研究デザイン:広範な文献レビューで現状を把握
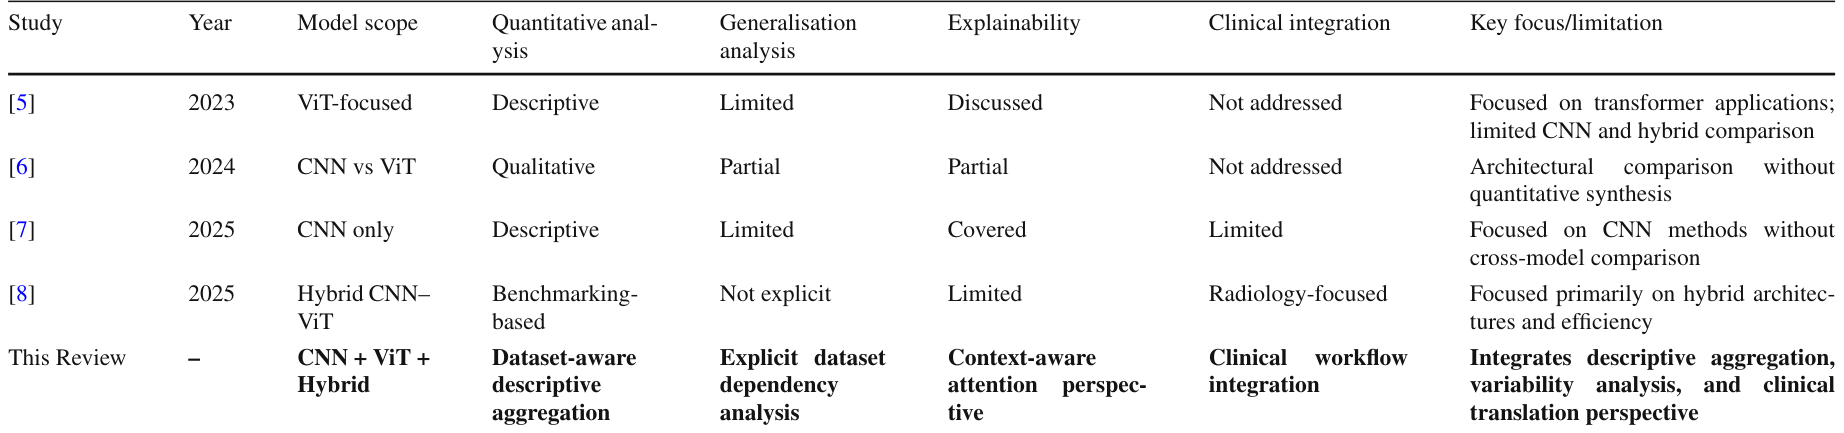
このレビューでは、医療画像分類の分野におけるCNN、ViT、およびハイブリッドCNN-ViTモデルの現状を包括的に把握するため、構造化された文献レビューが実施されました。PubMed、IEEE Xplore、Scopus、Web of Scienceの主要なデータベースを対象に、2016年から2025年までに発表された研究が検索されました。最終的に、事前に定義された適格基準に従って81件の研究が定性レビューに含められ、そのうち74件がデータセットを考慮した記述的定量集計に貢献しました。本レビューは、他の先行研究と比較して、多様なモデル範囲と詳細な分析フレームワークが特徴です。
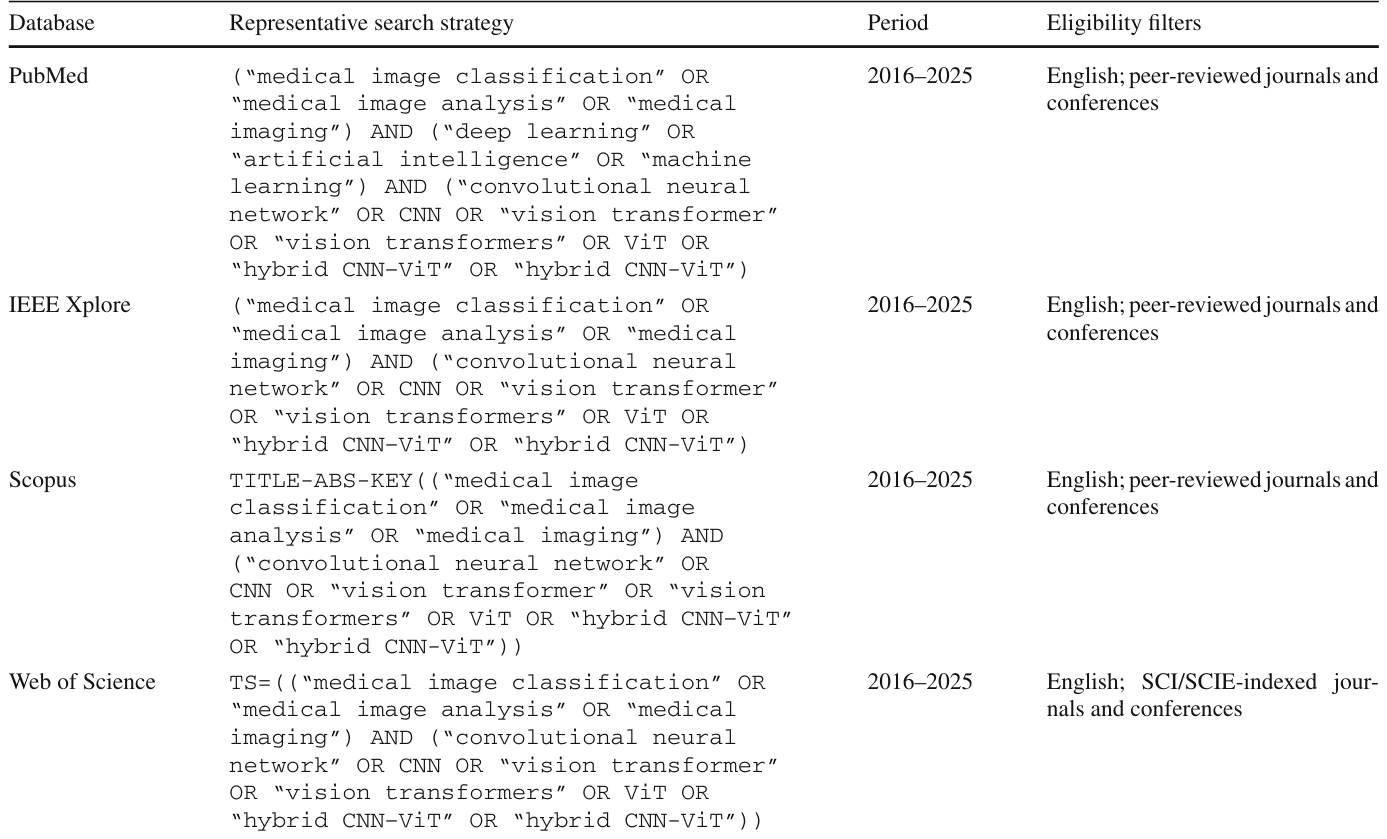
検索戦略には、「medical image classification」「deep learning」「CNN」「ViT」「hybrid CNN–ViT」などの代表的な検索用語がブール演算子と組み合わせて使用され、包括的な文献収集が図られました。
なお、本レビューでは、各研究間に顕著な手法上の異質性があり、研究レベルの分散情報(標準誤差、信頼区間など)の報告が不十分であったため、形式的なメタアナリシスは実施されず、記述的な集計に限定されています。レビューで用いられる「臨床的に根拠のある (clinically grounded)」という用語は、単なる予測性能を超えて、モデルの堅牢性、解釈可能性、外部検証、展開の実現可能性、ワークフローへの統合、および潜在的な規制関連性といった側面を評価することを指します。
主要モデルの性能比較:CNN、ViT、ハイブリッドモデル
本レビューでは、3つの主要な深層学習モデルファミリーであるCNN、ViT、およびハイブリッドCNN-ViTモデルの性能が比較されました。各モデルファミリーは、医療画像分類において異なる強みと課題を持っています。分析は、加重精度と加重再現率を中心に、データセットの規模や画像モダリティごとの性能変動に焦点を当てて行われました。
CNNモデル:安定性と局所的特徴抽出の強み
畳み込みニューラルネットワーク(CNN)は、医療画像分類において最も確立されたアーキテクチャであり、階層的な局所的特徴抽出能力に優れています。レビューされた研究全体で、CNNベースのモデルは白血病、脳疾患、肺疾患、網膜画像、乳がん、肝疾患、皮膚病変の分類など、多様な医療画像タスクで高い性能を示しました。特に、診断に関連する情報が空間的に局所化されている画像タスクにおいて、その有効性が顕著です。
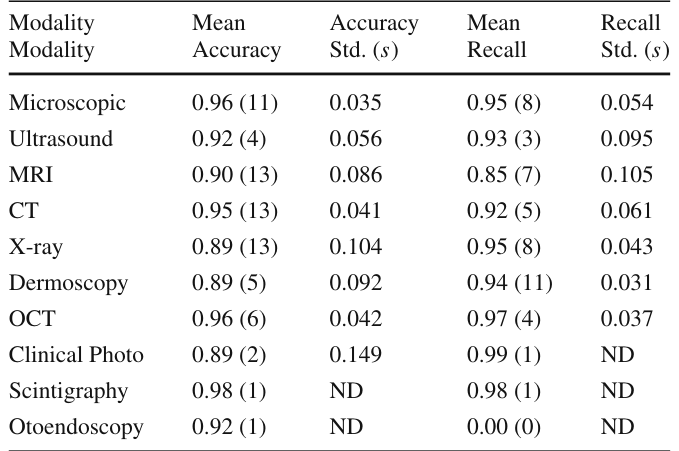
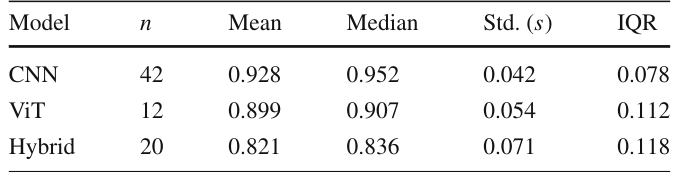
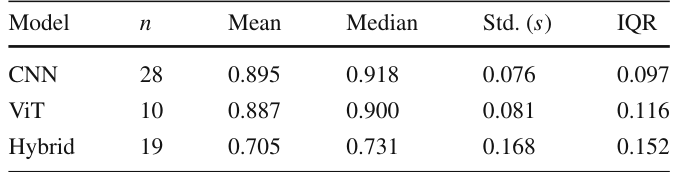
記述的集計によると、CNNベースのモデルは最高の加重精度(0.934)と加重再現率(0.901)を達成し、比較的低い精度変動(s = 0.042)と再現率変動(s = 0.076)を示しました。これは、多様なデータセットや画像モダリティにわたる堅牢性を示唆しています。しかし、その長距離文脈依存性のモデリングには限界があり、多くの研究が精度のみを報告し、感度(再現率)、特異度、適合率、キャリブレーション、不確実性推定などの臨床的に関連する評価指標の包括的な報告が不足しているという課題も指摘されています。また、外部検証が限定的であることも、実世界での一般化能力の評価を妨げています。
Vision Transformer (ViT) モデル:グローバルな文脈理解とデータ依存性
Vision Transformer(ViT)は、畳み込み演算の代わりに自己注意メカニズムを用いて画像をモデリングし、長距離の文脈的関係性をより良く表現できることが特徴です。レビューされた研究では、呼吸器疾患診断、網膜画像、骨折分類、皮膚病変解析などにおいてViTベースのモデルが高い性能を示しています。特にOCT(光干渉断層計)やX線画像など、グローバルな文脈モデリングが有利に働くモダリティで競争力のある性能を達成しました。
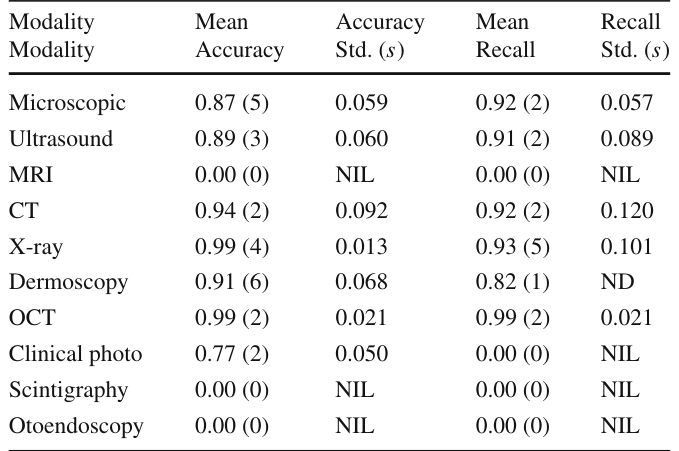
記述的集計では、ViTベースのモデルは競争力のある加重精度(0.906)と加重再現率(0.893)を示しましたが、CNNベースのモデルと比較して、やや高い再現率変動(s = 0.081)を伴いました。これらの結果は、ViTベースのモデルがデータセットの規模や質により敏感である可能性を示唆しています。自己注意アーキテクチャは畳み込みネットワークよりも組み込みの局所性帰納バイアスが弱いため、堅牢な視覚的表現を学習するには、十分に大規模で多様なトレーニングデータセットに依存する傾向があると考えられます。
ハイブリッドCNN-ViTモデル:局所とグローバルの融合、しかし高い変動性
ハイブリッドCNN-ViTアーキテクチャは、畳み込みネットワークの局所性と並進不変性という帰納バイアスと、Transformerベースの自己注意による長距離文脈モデリングを組み合わせることを目指しています。レビューされた研究では、多様な医療画像タスクで強力な性能が報告されていますが、データセットやモダリティ間での性能変動が大きいことが特徴です。
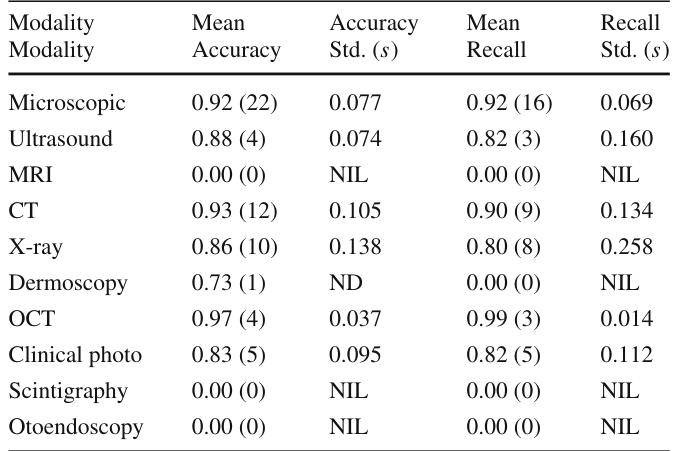
ハイブリッド化の手法には、CNNが最初に局所特徴を抽出し、その後Transformerが処理する「連続的融合」、CNNとTransformerのブランチが同じ画像を並列に処理する「並列融合」、そして独立して生成されたCNNとTransformerの予測を後で組み合わせる「遅延融合」など、様々なアプローチがあります。記述的集計では、ハイブリッドCNN-ViTモデルは加重精度0.814、加重再現率0.698を達成し、3つのモデルファミリーの中で最も高い再現率変動(s = 0.168)を示しました。これらの結果は、ハイブリッドアーキテクチャが特定の条件下で高い性能を発揮する一方で、その有効性がデータセットの特性、アーキテクチャ設計、最適化戦略に、CNNやViTベースのモデルよりも敏感であることを示唆しています。そのため、ハイブリッド化が常に優れた設計選択であるとは限らず、その価値は選択された融合メカニズムが、画像モダリティ、データセット規模、対象の病変、および意図された臨床設定の計算要件に適切に合致しているかどうかにかかっていると考えられます。
全体的な比較とトレンド
このレビューにおける定性的および記述的集計は、3つのモデルファミリーにわたるいくつかの共通パターンを明らかにしました。CNNベースのモデルは、モダリティやデータセットの規模にわたって最も一貫した記述的性能を示しました。一方、ViTベースのモデルは競争力のある性能を示しますが、データセットの規模と質に対してより敏感であるようです。ハイブリッドアーキテクチャは、柔軟な局所-グローバル特徴表現を提供しますが、異質なデータセットにわたってより大きな変動性を示しました。
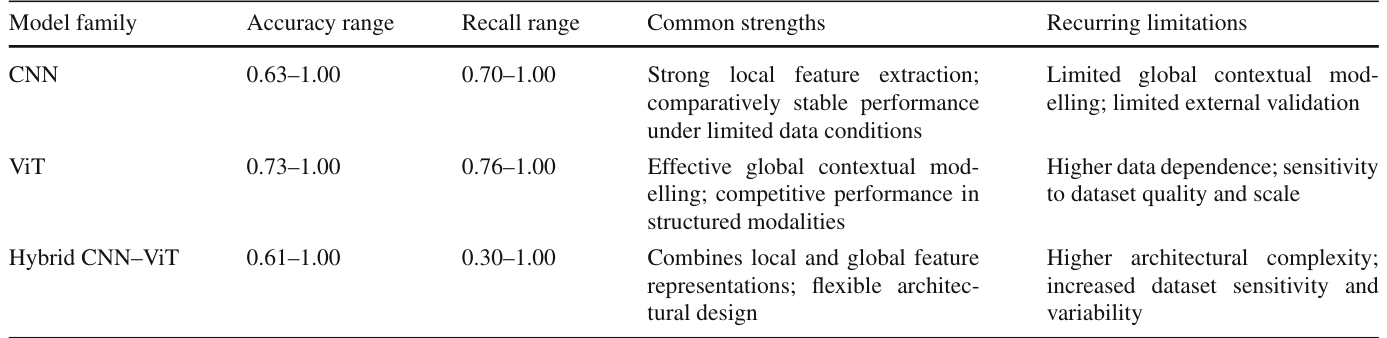
加重性能比較では、CNNが最高の加重精度と再現率、そして比較的低い再現率変動を示し、ViTがそれに続く中程度のデータセット感度、ハイブリッドモデルが最も高い再現率変動とデータセット感度を持つことが明らかになりました。
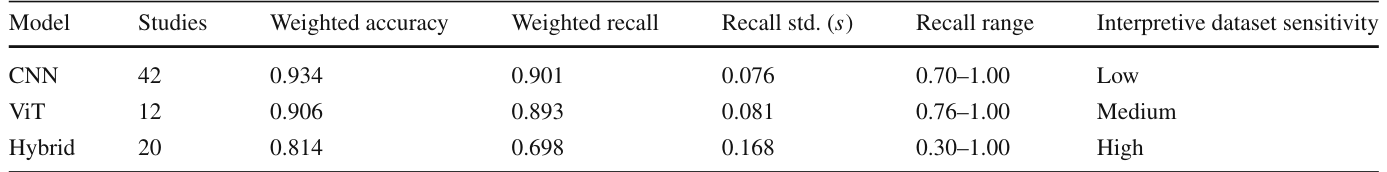
また、これらの数値的な変動性は、平均、中央値、標準偏差、四分位範囲を比較した記述的変動性分析からも確認できます。CNNモデルは精度と再現率の両方で低い標準偏差を示し、ViTは中程度、ハイブリッドは最も高い変動性を示しています。
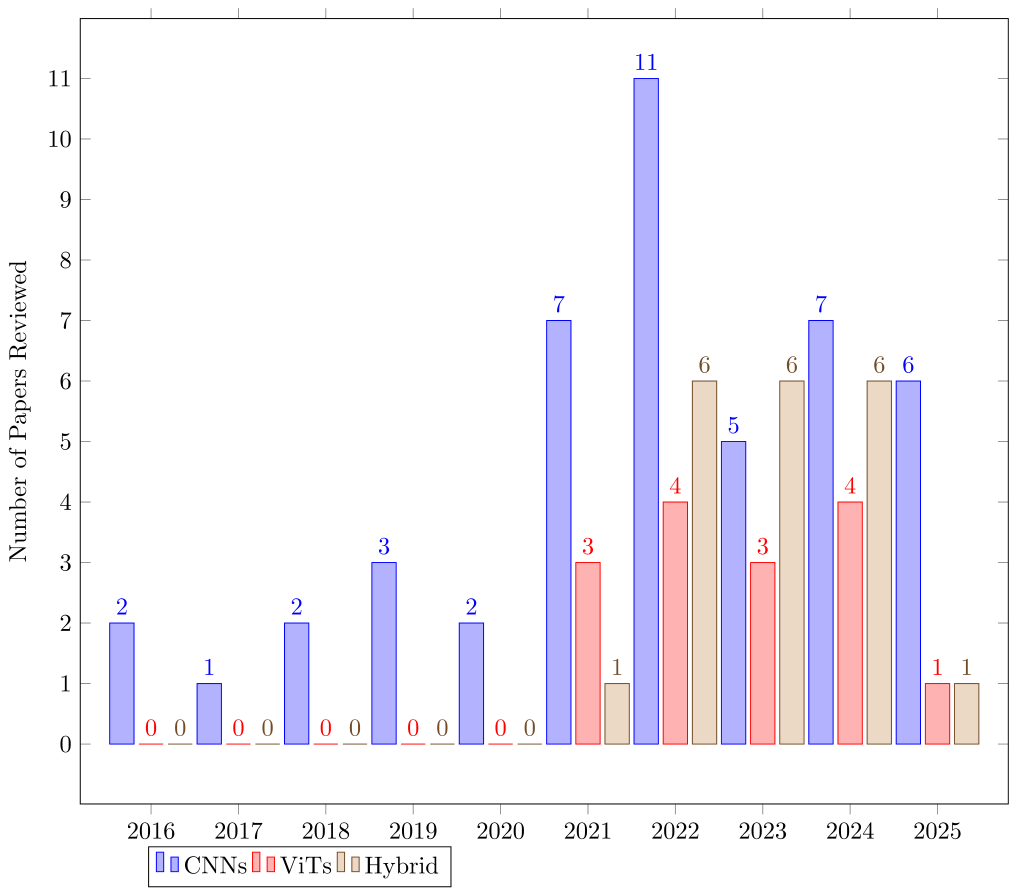
医療画像分類研究の動向としては、初期にはCNNベースのモデルが主流でしたが、近年ViTベースのモデルが出現し、2021年以降はハイブリッドCNN-ViTアーキテクチャが急速に増加していることが示されています。これは、局所的およびグローバルな特徴表現の組み合わせへとシフトしていることを示唆しています。
臨床応用への課題:性能だけでは不十分
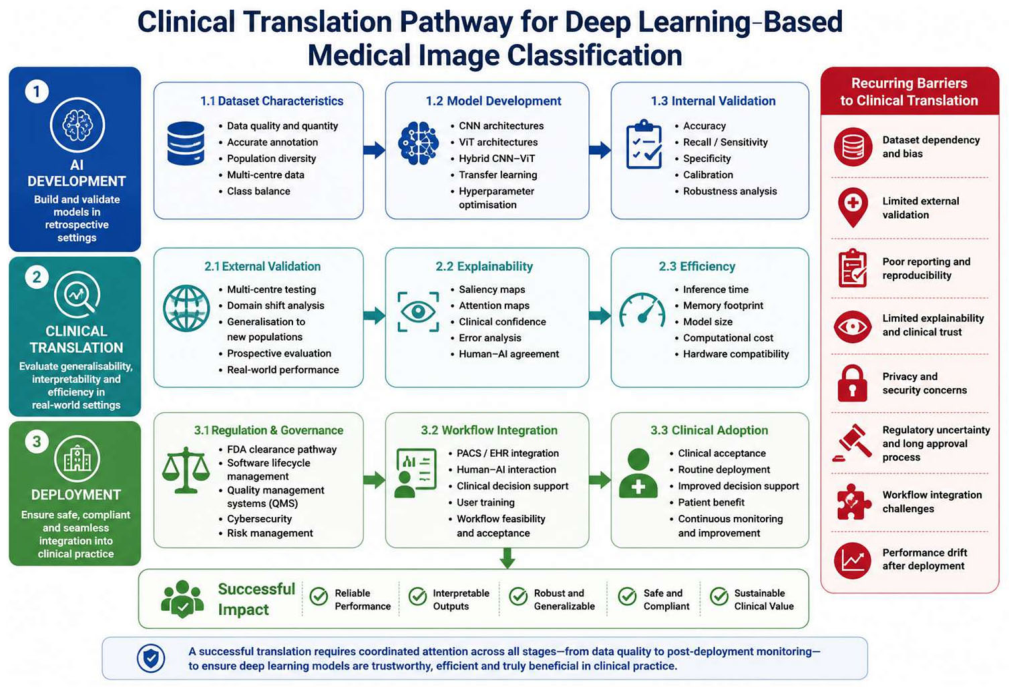
レビューされた文献は、遡及的な分類性能が高いだけでは、AIモデルの臨床的な準備が整っているとは言えないことを示しています。医療画像分類システムが臨床現場で真に価値を発揮するためには、性能以外の多くの要素が考慮される必要があります。
評価指標と外部検証の重要性
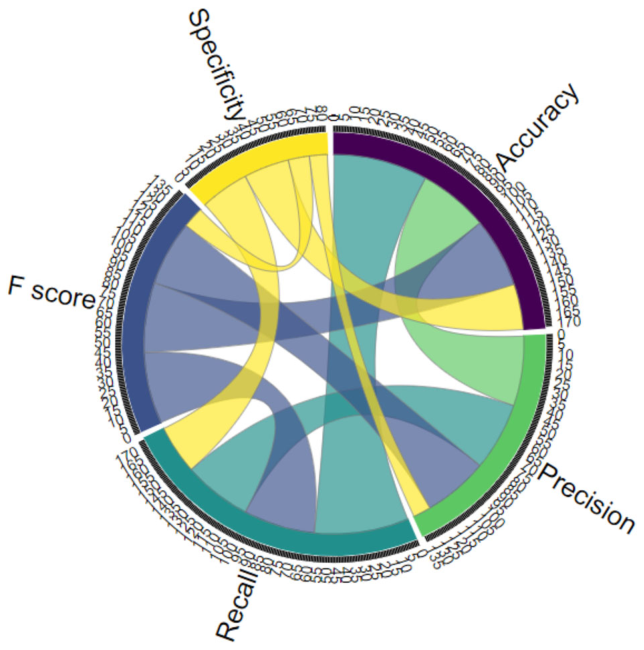
医療画像データが不均衡な場合でも、多くの研究では精度(Accuracy)への依存が続いています。しかし、高い全体精度は、臨床的に重要な少数派(疾患陽性)クラスの検出不良を隠蔽する可能性があります。このような状況では、再現率(Recall/Sensitivity)は陽性症例の検出、特異度(Specificity)は陰性症例での性能、適合率(Precision)は陽性予測の信頼性、F1スコアは適合率と再現率のバランスを反映します。残念ながら、再現率、特異度、適合率などの臨床的に関連する指標は一貫して報告されていません。
さらに重要なのは、81件のレビューされた研究のうち、独立した外部検証を報告しているのはわずか10件(12.3%)に過ぎない点です。これは、発表されたモデルの大部分が内部データセットのみで評価されていることを意味します。このため、完璧に近いとされる性能値も、単一センターのデータセットでの最適化、データセットの多様性の限定、または過学習を反映している可能性があり、慎重に解釈する必要があります。地理的、人口統計学的、施設的に異なる集団での検証がなければ、高い内部テスト性能が臨床的な一般化能力の証拠と解釈されるべきではありません。
データセットと再現性
約70%の研究が公開されているデータセットを利用しており、これはベンチマーク設定と再現性の向上をサポートしています。しかし、データセットの前処理、アノテーションの質、および評価プロトコルには依然として大きなばらつきがあり、研究間の比較可能性や外部検証を制限しています。再現性は、前処理、データ拡張、データ分割、ハイパーパラメータ選択、モデル設定、評価手順など、モデリングパイプライン全体の透明な報告に依存します。これらの違いは、同じデータセットを使用した場合でも報告される性能に影響を与える可能性があるため、これらの手順を十分に詳細に報告し、可能であればコード、モデル設定、乱数シード、明確に定義されたデータセット分割を提供する必要があります。重要なのは、再現性と外部一般化能力は区別されるべきであるということです。あるモデルが元のデータセットで再現可能であっても、独立した施設や対象者集団全体で性能を維持できるとは限りません。
計算効率と推論時間
計算効率は、臨床展開における重要でありながら、一貫して報告されていない側面です。レビューされた研究は一般的に予測性能を強調しており、推論時間、スループット、メモリ消費、モデルサイズ、エネルギー使用量などは、研究間の比較が可能な標準化された形式で報告されることは稀でした。したがって、CNN、ViT、またはハイブリッドCNN-ViTモデルのいずれが臨床運用において一貫して効率的であるかを本レビューで判断することはできません。臨床的に意味のある評価のためには、推論時間はモデルの実行だけでなく、画像取得、前処理、データ転送、モデル推論、後処理、結果通信、および臨床情報システムとの統合を含む「完全な処理経路」を包含すべきです。加速器レベルの推論時間のみを報告することは、専門家が経験する遅延を過小評価する可能性があります。今後の研究では、適切な場合、中央値および上位パーセンタイルの遅延、スループット、モデルサイズ、パラメータ数、メモリ要求、計算操作、ハードウェア仕様、バッチサイズ、および画像寸法を報告すべきです。
臨床ワークフローへの統合
医療画像分類システムは、孤立した予測モデルとしてではなく、確立された臨床プロセス内で機能する必要があります。表11は、CNN、ViT、およびハイブリッドベースのモデルが、画像品質評価や診断支援から疾患モニタリング、治療計画、統合的な臨床意思決定支援に至るまで、臨床ワークフローのさまざまな段階で果たす可能性のある役割を示しています。
効果的な統合には、モデルがいつ活性化されるか、どのようなデータを受け取るか、その出力がどのように提示されるか、誰が結果を確認する責任を負うか、不確実または誤った結果の後にはどのような行動が続くべきか、といった明確な定義が必要です。AIツールの導入は、臨床プロセスの変更、人間とAIのインタラクションのデザイン、専門家へのトレーニング、信頼と受容の構築を伴うため、単なる技術的導入以上のものです。これらはすべて、対象者への安全で効果的なケアを提供するために不可欠な要素となります。
今後の展望:堅牢で解釈可能、そして臨床で使えるAIへ
医療画像分類AIの分野は急速に進歩していますが、臨床応用への道筋には依然として重要な課題が存在します。本レビューの結果は、現在の研究が遡及的な性能に焦点を当てがちであり、実世界の臨床環境における一般化能力や堅牢性、解釈可能性、計算効率といった側面が十分に評価されていないことを示唆しています。今後の研究は、外部検証済みで、解釈可能で、臨床的に展開可能なAIシステムの開発を優先すべきです。これには、標準化された評価方法を採用し、データ効率、解釈可能性、ロバスト性の改善に焦点を当てることが不可欠です。また、性能指標の報告を改善し、精度だけでなく再現率、特異度、キャリブレーション、不確実性推定など、臨床的に意味のある複数の指標を包括的に報告することが求められます。最終的に、医療画像分類AIの真の成功は、高い予測性能だけでなく、そのモデルが臨床ワークフローにシームレスに統合され、専門家の意思決定を効果的に支援し、対象者ケアの質の向上に貢献できるかどうかにかかっています。
補足図表
Table 10
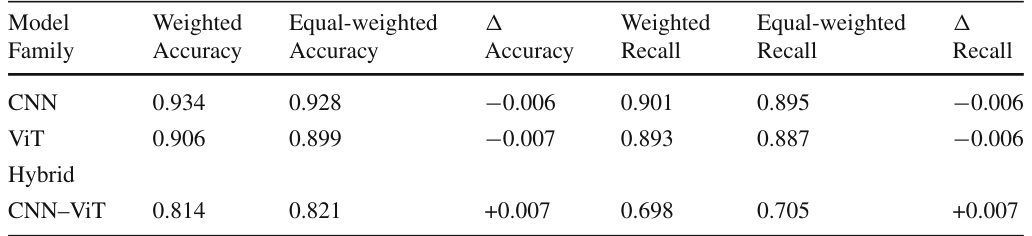
Table 11
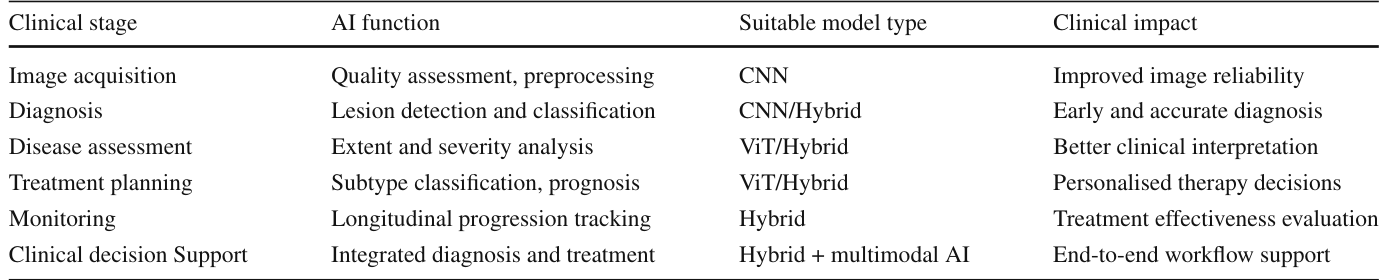
Table 12
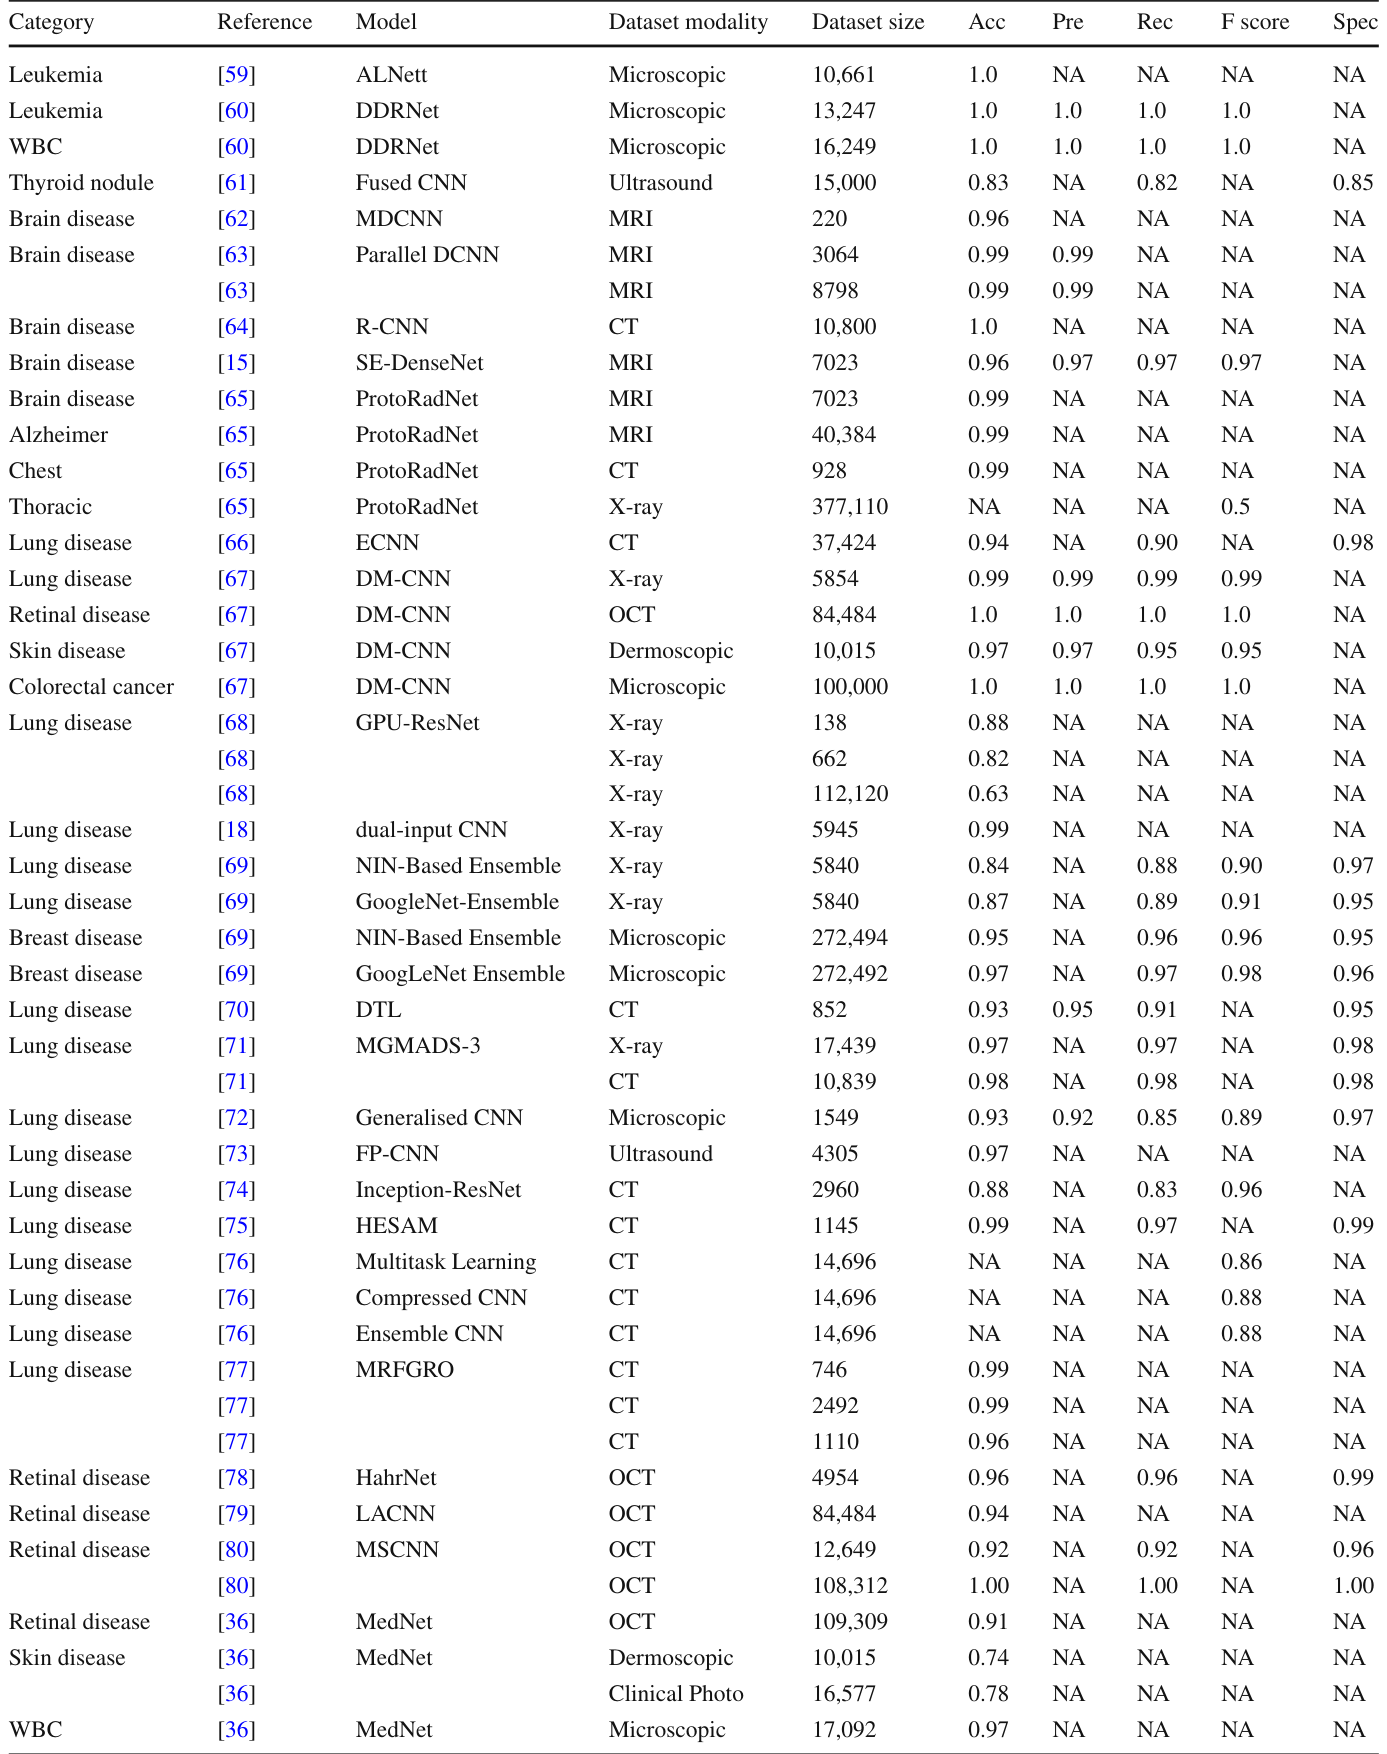
Table 13
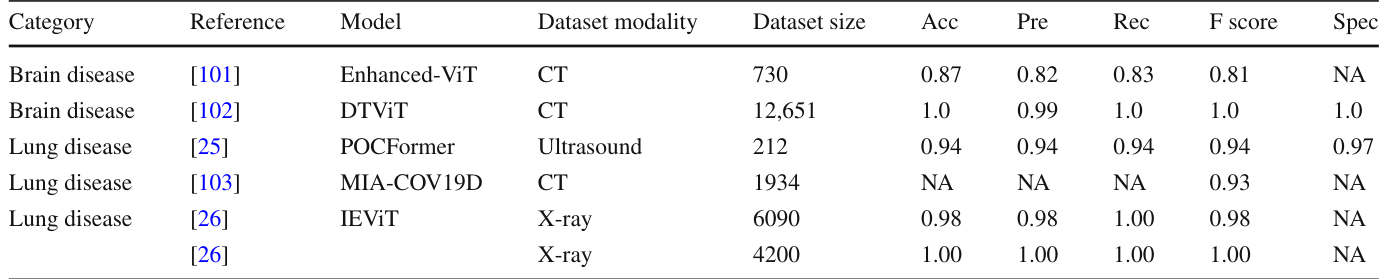
Table 14
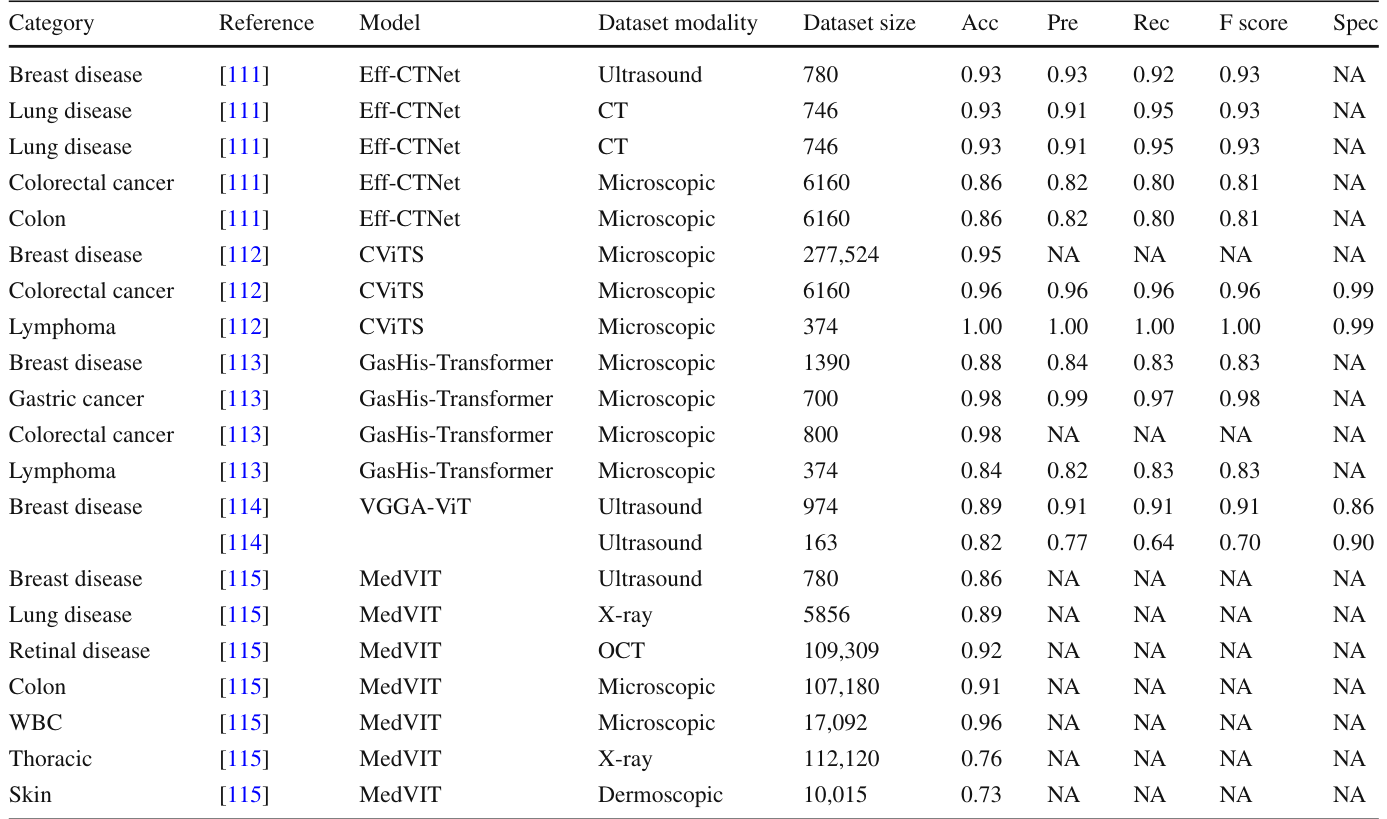
Table 15
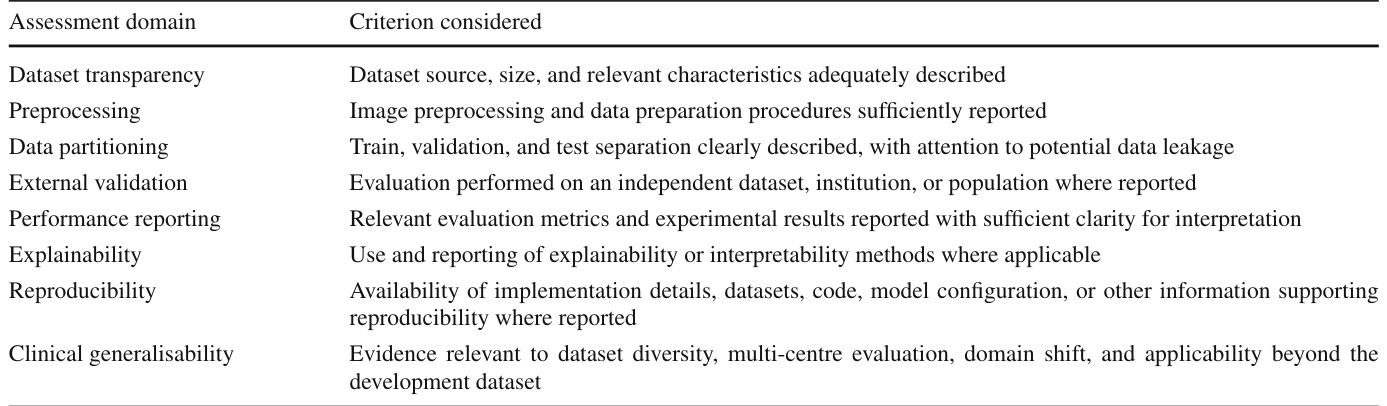
Table 16
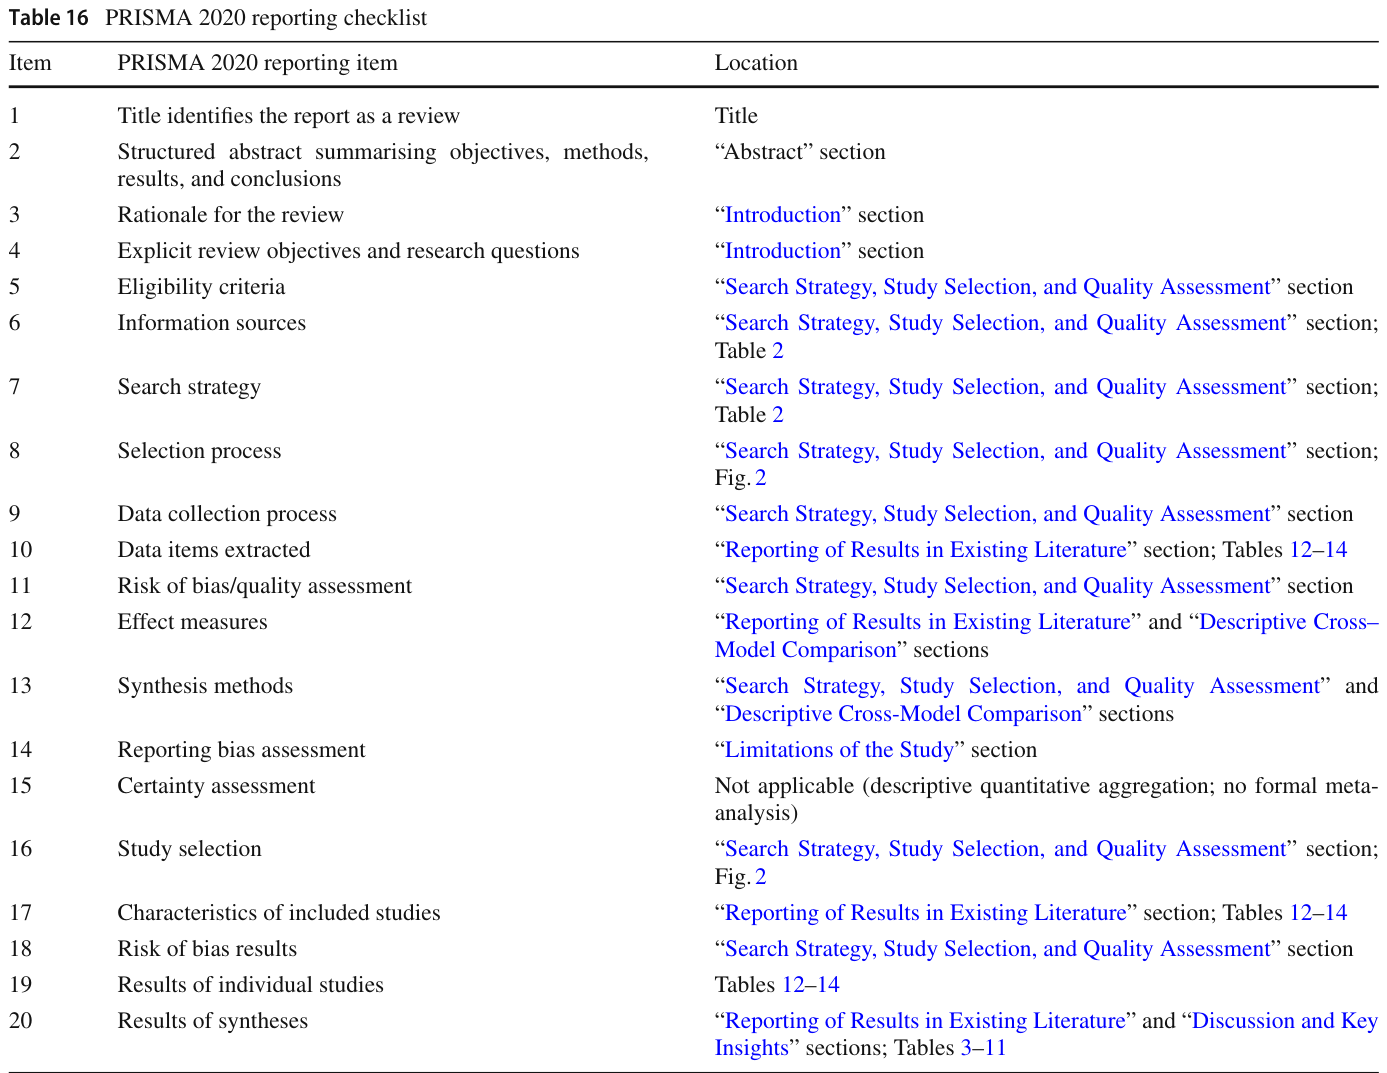
用語集
- 畳み込みニューラルネットワーク (CNN): 画像の局所的な特徴を効率的に学習する深層学習モデル。
- Vision Transformer (ViT): 自己注意メカニズムを用いて画像全体の関係性を捉える深層学習モデル。
- ハイブリッドCNN-ViTモデル: CNNとViTの長所を組み合わせ、局所的・グローバルな特徴を学習するモデル。
- 加重精度 (Weighted Accuracy): データセットサイズを考慮して算出された精度。
- 加重再現率 (Weighted Recall): データセットサイズを考慮して算出された再現率。
- 外部検証 (External Validation): モデルが開発時とは異なる独立したデータセットで性能を維持するか評価すること。
- 再現率 (Recall / Sensitivity): 疾患のある対象者を正しく陽性と判定できた割合。
- 特異度 (Specificity): 疾患のない対象者を正しく陰性と判定できた割合。
- 適合率 (Precision): 陽性と判定されたもののうち、実際に疾患があった割合。
- F1スコア (F1-score): 適合率と再現率のバランスを示す指標。
- キャリブレーション (Calibration): モデルの予測確率が実際の事象の確率とどれだけ一致するかを示す指標。
- データセット感度 (Dataset Sensitivity): モデルの性能がデータセットの規模や質によってどの程度変動するか。
コメントを残す