
YOLO-PEFT:リアルタイム物体検出器の賢いファインチューニング戦略
解説対象論文: YOLO-PEFT: Parameter-Efficient Fine-Tuning on YOLO Family
arXiv (Cornell University)|被引用数: 0(2026年10月28日時点)
PEFT (Parameter-Efficient Fine-Tuning) は、大規模な事前学習済みモデルを効率的に適応させるための強力な手法です。しかし、言語モデル用に開発された既存のPEFT手法を、YOLOのようなリアルタイム物体検出器にそのまま適用すると、予期せぬ性能低下や学習の失敗を招くことが課題でした。本記事では、この課題を解決するために提案されたYOLO-PEFTという新しいフレームワークについて、その仕組みとYOLOシリーズにもたらすメリットを専門的な視点から解説します。
導入 – なぜYOLOに専用PEFTが必要なのか
どうも、Beyond the Pixelです。近年、AIモデルの規模は拡大の一途を辿り、特に自然言語処理分野では「ファインチューニング」と呼ばれるモデルの再調整が頻繁に行われています。このファインチューニングを、より少ない計算資源と時間で行うための技術が「Parameter-Efficient Fine-Tuning(PEFT)」、つまり「パラメータ効率の良いファインチューニング」です。しかし、このPEFTをYOLO(You Only Look Once)のようなリアルタイム物体検出器に適用しようとすると、問題が発生します。言語モデルが比較的均質な「Transformer」という構造をベースにしているのに対し、YOLOを含む多くの検出器は、多様な演算子や検出に特化したコンポーネントを複雑に組み合わせた「異質なグラフ構造」を持っています。現代の検出器は、密な畳み込み、グループ化された畳み込み、DFL(Distribution Focal Loss)投影、変形可能注意、テキスト・画像融合、MoE(Mixture-of-Experts)ルーティングなどを組み合わせているため、言語モデル向けのPEFT手法を無差別に適用すると、最適化の失敗や、物体検出性能を示すmAP(mean Average Precision)の大幅な低下を引き起こす可能性がありました。著者らは、この課題を解決するため、YOLOファミリーに特化した構造認識型のPEFTフレームワーク「YOLO-PEFT」を提案しました。これは、アダプター(PEFTで追加される小さなモジュール)をどこに配置すべきかを、監査可能な制約計画問題として定式化するものです。これにより、手作業での試行錯誤を、明確で検査可能な計画に置き換えることを目指します。
YOLO-PEFTの全体像:検出器の理解から計画まで
YOLO-PEFTは、パラメータ効率の良いファインチューニングをリアルタイム物体検出器に安全かつ効果的に適用するための、構造認識型フレームワークです。そのパイプラインは主に4つの段階で構成されます。
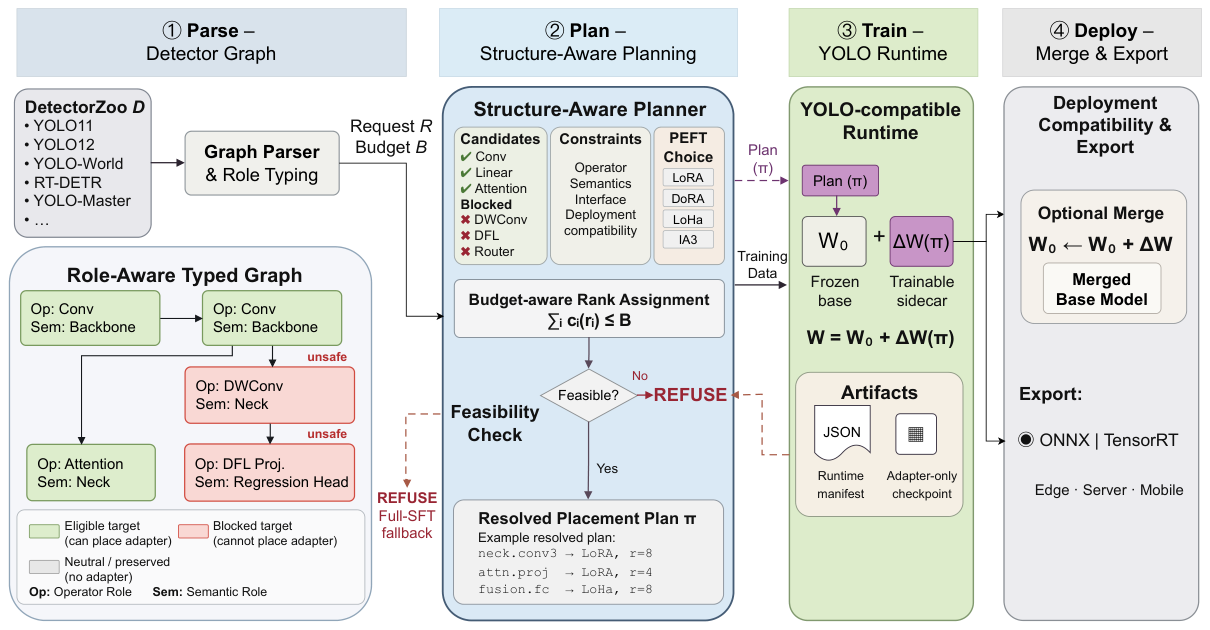
まず「①検出器グラフの解析(Parse)」では、サポートされている検出器ファミリーから、その構造を役割認識型グラフとして解析します。この解析により、各モジュールに「演算子役割」と「意味役割」が割り当てられます。次に「②構造認識型プランニング(Plan)」として、アダプター配置を監査可能な制約計画問題として定式化します。与えられた検出器グラフ、PEFTの要求、およびリソース予算に基づき、候補となるモジュール群の中からアダプターを配置する最適な計画を立てます。もし信頼できる計画が存在しない場合は、「Refuse(拒否)」という結果を返して、訓練前にフルファインチューニングへのフォールバックを推奨します。計画が受け入れられた場合、「③YOLOランタイムでの訓練(Train)」に進み、ベースの重みを凍結したままアダプターを訓練します。最後に「④結合とエクスポート(Deploy)」として、アダプターを元のモデルに結合し、ONNXやTensorRT形式でエッジデバイスやサーバー、モバイル環境へ展開できるようエクスポートします。このように、YOLO-PEFTは検出器の構造を深く理解することで、汎用PEFT手法の限界を克服し、安全で効果的なファインチューニングを実現します。
アダプター配置の多角的制約:なぜ「拒否」が重要なのか
YOLO-PEFTのプランニング段階では、アダプターの配置が単なるモジュールの選択にとどまらず、以下の多角的な制約をクリアする必要があります。1. 演算子有効性(Operator validity): アダプターを挿入するモジュールの演算子タイプが、選択されたPEFT手法と互換性があるかを検証します。例えば、Depthwise Convolution(深層方向の畳み込み)、正規化層、活性化層、未知の演算子などは、チャネルを混合するようなアダプターの更新を受け入れられないため、除外されます。グループ化された畳み込みでは、アダプターのランクはグループ数で割り切れる必要があります。2. 検出器のセマンティック(Detector-semantic): DFL(Distribution Focal Loss)の固定された投影、MoE(Mixture-of-Experts)のルーター、幾何学的に敏感な回帰パスなど、検出性能に影響を与える部分は、無差別なアダプター挿入から保護されます。ユーザーが明示的にアダプターの配置を要求しても、これらの必須フィルターをバイパスすることはできません。3. グラフインターフェース(Graph-interface): アダプター挿入後も、モデルの入出力形状、テンソルの数と順序、残差接続などが破壊されずに、グラフの整合性が保たれることを確認します。4. 展開互換性(Deployment compatibility): 訓練、アダプターのみのチェックポイント保存、重み結合、そしてONNX/TensorRTのような展開ツールへのエクスポートといった一連のライフサイクルが問題なく機能することを保証します。これらの制約に加え、RT-DETR-Lではデコーダーのサンプリングオフセットや注意重みは凍結されるなど、アーキテクチャ固有のポリシーも適用されます。もし、これらの制約条件を満たす信頼性の高い計画が存在しない場合、YOLO-PEFTは訓練前に「Refuse(拒否)」という結果を返します。これは、コストのかかる訓練を未然に防ぎ、潜在的な性能低下から保護するための重要な安全性モデルであり、単なるエラーではなく「計画された拒否」として機能します。
実証結果:性能向上と効率性、そして「拒否」の意義
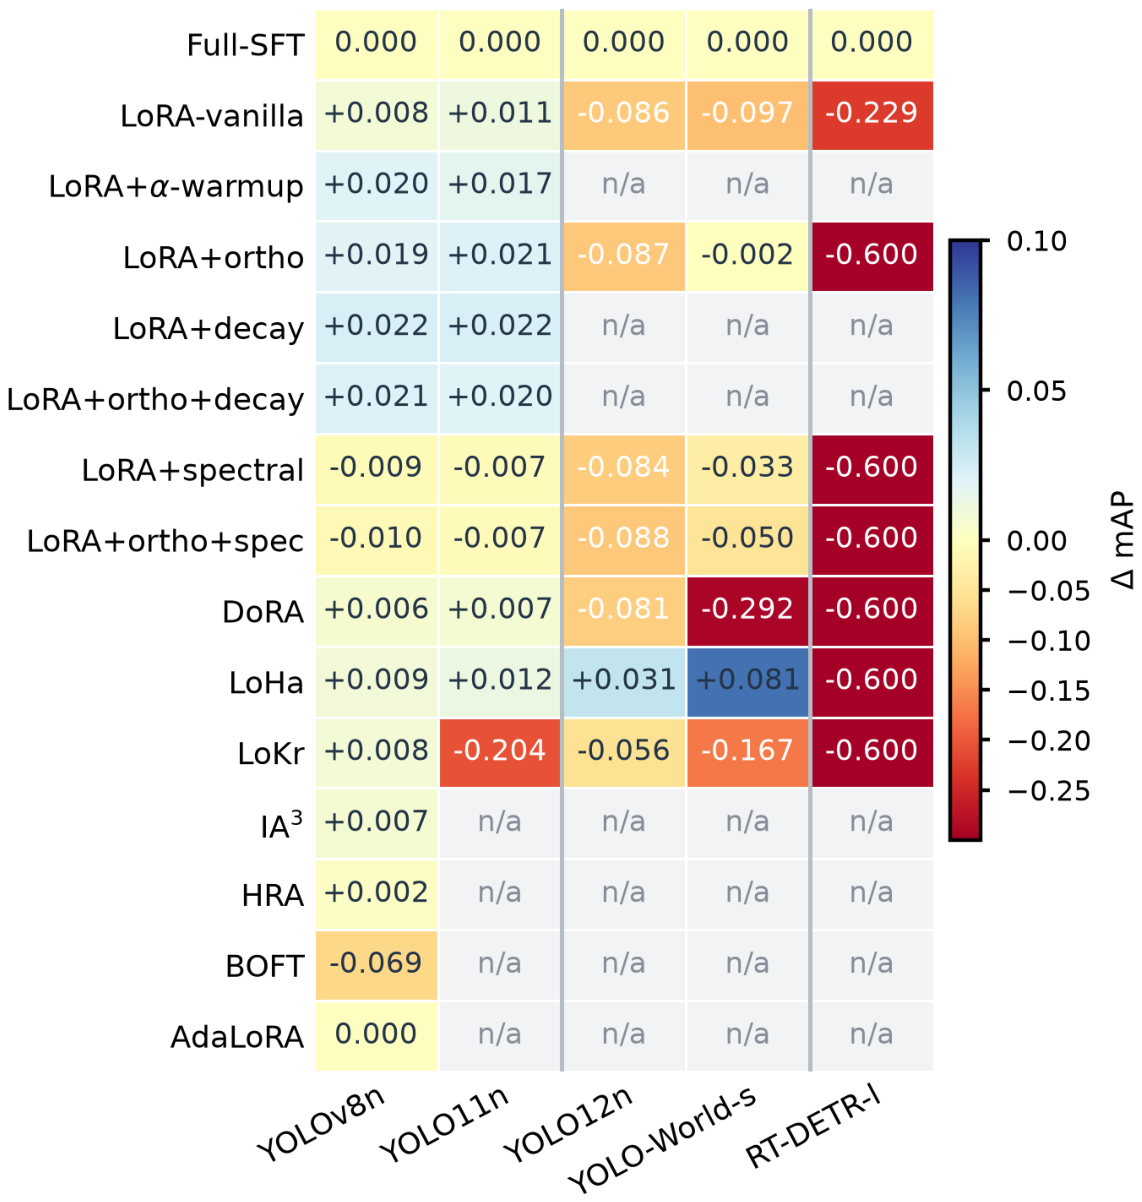
著者らは、YOLO-PEFTの有効性をYOLO11s、YOLO12s、RT-DETR-Lといった多様な検出器アーキテクチャで検証しました。YOLO-PEFTによって選定されたRS-LoRAは、公開されているVOC07+12データセットを用いたテストプロトコルにおいて、YOLO11sでmAP50-95が0.7138(フルファインチューニング比で+7.1ポイント)、YOLO12sでmAP50-95が0.7307(フルファインチューニング比で+6.5ポイント)に達し、フルファインチューニングの性能を上回る結果を示しました。これは、YOLO-PEFTが検出器の特性を考慮した上で、効果的なアダプター配置計画を策定できることを明確に示しています。一方、RT-DETR-Lでは、評価された7つのLoRA系設定全てが事前定義された「壊滅的な閾値(mAPが-0.05を下回る)」を下回る結果となりました。YOLO-PEFTは、この状況で適切な「Refuse」判断を下し、無駄な訓練を回避しました。これは、PEFT手法が無差別に適用された場合に発生しうる「サイレントフェイル(黙って失敗する)」を未然に防ぐ重要な機能です。この拒否は、コストのかかる7回の訓練試行(約23.8分の訓練時間)を回避したことになります。
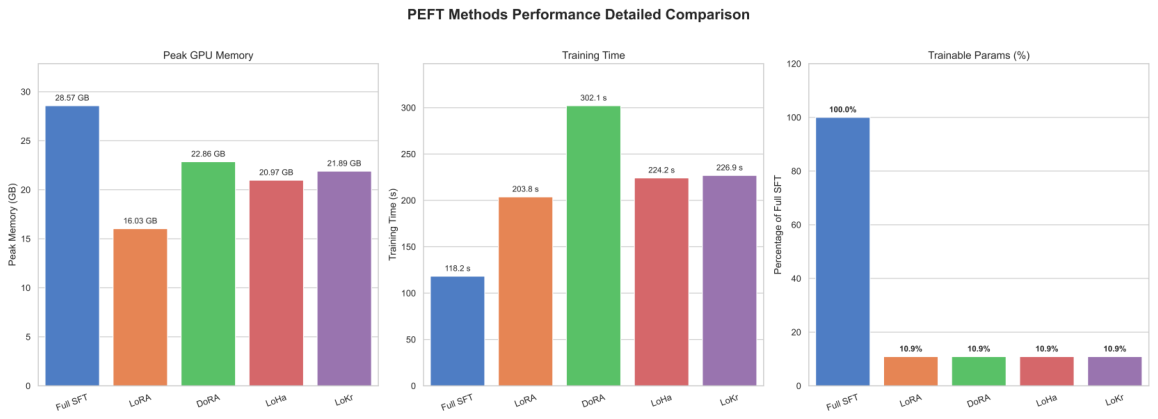
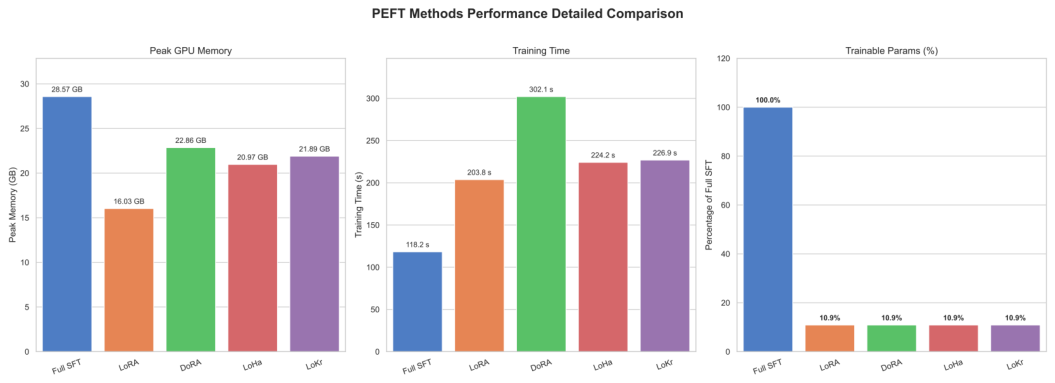
さらに、YOLO11における詳細な監査結果では、LoRAを使用することでピーク訓練メモリ(VRAM)が43.9%削減されることが示されました。ただし、訓練時間は1.72倍長くなるというトレードオフも確認されており、メモリ使用量と訓練時間のバランスを考慮する必要があることを示唆しています。
YOLO-PEFTは、訓練、アダプターのみの永続化、リロード、重み結合、そしてONNX/TensorRTへのエクスポートといった、展開に必要不可欠なライフサイクル全体をYOLO互換のランタイム契約として提供します。これにより、アダプターが導入された後でも、通常のYOLOモデルと同様に展開パイプラインが機能することが保証されます。特に、アダプターを元のモデルの重みに結合する「マージ」操作は、浮動小数点精度で元の畳み込み出力と等価性を維持することが検証されており、アダプターを削除した後のモデルが元の性能を損なわないことを保証します。ナイーブな手法ではONNX/TensorRTエクスポートが失敗することが示されており、この契約層の必要性が強調されています。
研究の限界と今後の展望
YOLO-PEFTは、リアルタイム物体検出器におけるPEFTの適用を大きく前進させるものですが、いくつかの限界も存在します。現在の研究では、評価された検出器ファミリーとキャリブレーション範囲内でのみ、その有効性が検証されています。未知の検出器アーキテクチャに対する「拒否」判断の妥当性については、今後の検証課題として残されています。また、COCOのようなより大規模なデータセットや、ドメインシフト(異なるドメインへの適用)に対する汎化性能、特定の専門家を意識したMoE(Mixture-of-Experts)の計画についても、さらなる評価が必要です。将来的には、クロスモーダル注意(異なる種類のデータ間の注意機構)や語彙ヘッドを持つVLM(Vision-Language Model)検出器、共有ブロックや専門家ごとのアダプターを持つMoT/MoE(Mixture-of-Transformers / Mixture-of-Experts)検出器への拡張が展望されています。これらの拡張は、未知のアーキテクチャやクロスドメインのベンチマークにおいて、結合および未結合のエクスポートチェックを含めて検証される予定です。
用語集
- PEFT (Parameter-Efficient Fine-Tuning): 事前学習済みモデルをファインチューニングする際に、学習するパラメータの数を大幅に削減する手法。
- YOLO (You Only Look Once): リアルタイム物体検出器の代表的なシリーズ。高速な検出が特徴。
- mAP (mean Average Precision): 物体検出モデルの性能を評価するための主要な指標。検出精度と再現率を組み合わせたもの。
- Transformer: 大規模言語モデルなどで広く使われるニューラルネットワークのアーキテクチャ。
- アダプター: PEFT手法で既存モデルに新しく追加・学習される小さなモジュール。
- VRAM (Video RAM): GPUに搭載されているメモリ。特に大規模モデルの学習で重要となる。
- Full Fine-Tuning (フルファインチューニング): モデルの全てのパラメータを再学習させる伝統的なファインチューニング手法。
- ONNX / TensorRT: AIモデルを異なるプラットフォームやデバイスで効率的に実行するためのフォーマットやランタイム。
- DFL (Distribution Focal Loss): 物体検出の回帰ヘッドで用いられる、分布ベースの損失関数。
- MoE (Mixture-of-Experts): モデルの一部が特定の入力に対して専門家(エキスパート)のように振る舞う構造を持つアーキテクチャ。
- LoRA: PEFT手法の一つで、低ランク分解(Low-Rank Adaptation)を利用してパラメータを効率的に更新する。
- RS-LoRA: LoRAにスケーリングを導入したバリアント。
- VOCデータセット: 物体検出のベンチマークとして広く利用されるPascal VOC Challengeデータセット。
コメントを残す