
CTトポグラムを活用した解剖学的ラベリング:深層学習による効率的な医療画像処理
解説対象論文: Topogram-based anatomical labelling of CT series: anatomy-aware CT data processing using deep learning
European Radiology|被引用数: 0(2026年9月5日時点)
CTスキャンにおいて、その解剖学的範囲の正確な識別は、臨床ワークフローやAIによる高度な画像解析にとって不可欠です。しかし、従来のCTシリーズの分類は、不整合で不完全なDICOM(Digital Imaging and Communications in Medicine)メタデータに依存しており、手作業によるレビューが必要で、スケーラビリティに限界がありました。この課題に対し、本研究では、深層学習を用いてCTトポグラム(CTスキャン前に撮影される広範囲のX線平面画像)を分析し、DICOM空間幾何学と組み合わせることで、信頼性の高い解剖学的ラベリングを可能にする「Rapid Analysis and Processing of Image Data (RAPID)」フレームワークを提案しています。
はじめに:なぜCTシリーズの正確な解剖学的ラベリングが必要なのか?
どうも、Beyond the Pixelです。
近年、人工知能(AI)は医療分野、特に放射線医学において急速な進歩を遂げており、深層学習(Deep Learning)を用いた手法が臨床ワークフローに組み込まれつつあります。体積定量化や体組成分析、解剖学的ランドマーク検出など、様々なタスクに応用され、大規模な医療画像解析におけるAIの役割は増大しています。
しかし、これらのAI駆動型画像アプリケーションの多くは、前提条件として「CTシリーズの正確な解剖学的範囲の識別と選択」に依存しています。従来のCTシリーズの解剖学的分類は、DICOM(Digital Imaging and Communications in Medicine)メタデータに大きく依拠していましたが、これらの情報はしばしば一貫性がなく、不完全にしか入力されていないため、スケーラブルで再現性のある画像分析には不十分でした。例えば、複数の体領域にまたがる癌のCTスキャンでは、「腹部CT」のような単一のラベルでは、取得されたシリーズの真の解剖学的範囲を正確に反映できない場合があります。
このような課題から、正確な解剖学的分類とシリーズ選択には、手作業によるCTデータのレビューが必要となり、これは時間と労力がかかり、大規模な運用には限界がありました。本研究では、この問題に対処するため、CTトポグラムの深層学習ベースの分析とDICOM空間幾何学を組み合わせた「Rapid Analysis and Processing of Image Data (RAPID)」フレームワークを提案しています。このフレームワークは、不整合なテキストメタデータに依存することなく、CTシリーズの信頼性の高い解剖学的ラベリングを可能にします。
RAPIDフレームワークの概要:CTトポグラムをAIで解析
RAPIDフレームワークは、深層学習モデルを用いてCTトポグラム(CTスキャン前に撮影される広範囲のX線平面画像)を分析し、CTシリーズの解剖学的ラベリングを可能にします。このアプローチでは、予測された解剖学的領域とランドマーク(特定の解剖学的構造)をDICOMの幾何学的取得パラメータを用いて個々のCTシリーズに空間的にマッピングすることで、シリーズの解剖学的範囲を決定します。これにより、手動や不整合なDICOMメタデータに頼ることなく、正確で再現性の高い、ピクセルベースのCTシリーズ解剖学的分類が可能となります。
この研究では、RAPIDフレームワークを構成する3つのYOLOv8(You Only Look Once, version 8)ベースのモデルが訓練されました。YOLOv8は物体検出に特化した深層学習モデルの一種です。これらのモデルは以下のタスクを実行しました。
- RAPID分類(RAPID Classification): 画像を「下肢」「上肢」「頭部」「体幹部」の4つのグローバルな解剖学的カテゴリに分類します。
- RAPID体領域検出(RAPID Body Regions): 体幹部と分類されたトポグラム内で「頭部」「胸部領域」「心膜」「腹部領域」などの体領域を識別します。
- RAPIDランドマーク検出(RAPID Landmarks): さらには、「脳」「脊椎」「肺」「心臓」「肝臓」「脾臓」「胃」「膵臓」「腎臓」「結腸」「股関節」といった具体的な解剖学的ランドマークを検出します。
これらのモデルは、83,207枚のトポグラム(うち20,802枚がテスト用)を分類に、2,000枚(うち500枚がテスト用)と1,926枚(うち481枚がテスト用)のトポグラムをそれぞれランドマークと体領域の検出に用いて訓練されました。データは2003年から2022年の間に収集されたものです。
研究の方法と評価
本研究は、2003年から2022年の期間で単一の医療施設から無作為に選択された内部データと、2005年から2023年の期間で外部機関から取得された外部データを用いた単一施設の後ろ向き研究として実施されました。対象となったのは合計65,250人の対象者でした。対象者の年齢中央値は62歳、女性の割合は44%でした。
解剖学的ラベルのゴールデンスタンダードは、自動生成戦略によって作成されました。具体的には、BOAモデル(CTボリュームから解剖学的セグメンテーションを抽出する3Dセグメンテーションアルゴリズム)とTotalSegmentator(CT画像中の104の解剖学的構造をセグメンテーションするモデル)を用いてCTボリュームから解剖学的セグメンテーションを抽出し、これらのラベルをDICOMヘッダーの幾何学的情報を使用して対応するトポグラムに投影しました。この自動ラベリング生成は、大規模なデータセットにおいても一貫性のある再現可能なアノテーションを保証し、モデル訓練と評価のための信頼できる参照標準を提供します。
モデルの性能評価には、F1スコア(精度と再現率の調和平均)とmAP50(平均精度、Intersection over Unionの閾値が0.50の場合)が用いられました。さらに、臨床での適用可能性を評価するため、3人の放射線専門家がランダムに選択された150件の予測結果を、5段階のLikert尺度(5: 非常に良い、1: 悪い)で独立してレビューし、専門家間の合意度をGwetの合意係数2(AC2)で測定しました。
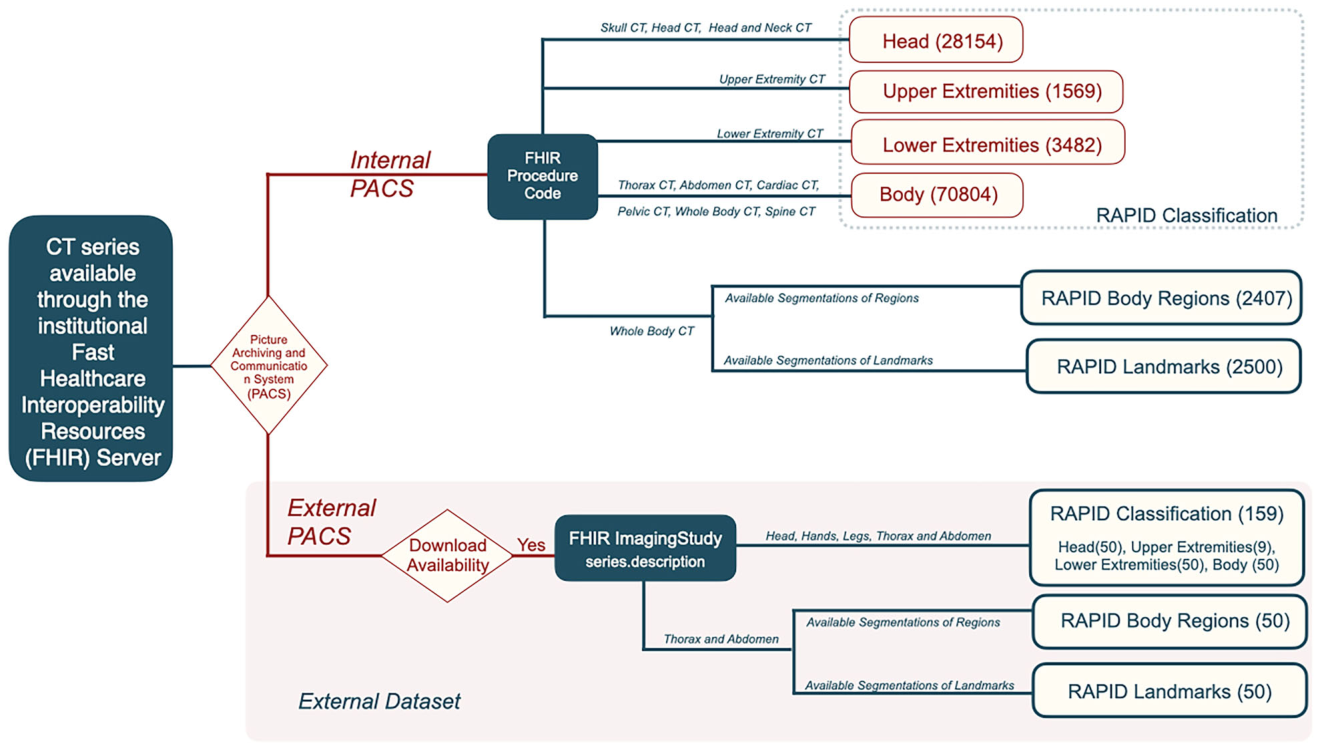
は、研究コホートの生成プロセスを示しており、内部データと外部データがどのように各モデルの訓練とテストに用いられたかを概説しています。
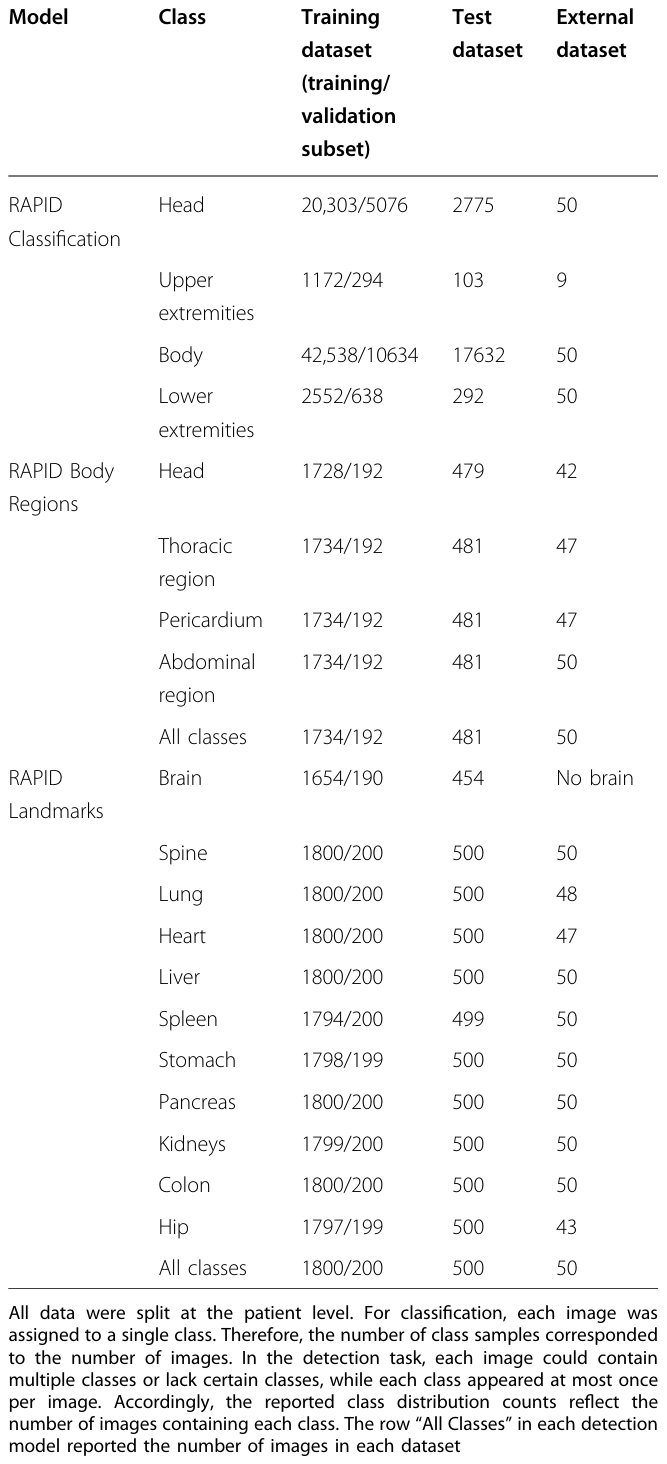
は、分類モデル、体領域検出モデル、ランドマーク検出モデルのそれぞれで使用されたデータセットの特性、訓練データとテストデータのサンプル数、および外部データセットのクラス分布を詳細に示しています。
驚くべき結果:高い精度で解剖学的ラベリングを実現
RAPIDフレームワークの3つのモデルは、CTシリーズの解剖学的ラベリングにおいて高い性能を示しました。
1. RAPID分類モデルの性能
内部データセットでは、全体のF1スコアは0.920(95%信頼区間: 0.905, 0.933)を達成しました。外部データセットでは、F1スコアは0.970(95%信頼区間: 0.945, 0.990)と、さらに高い性能を示しました。特に体幹部と上肢の分類では、外部データセットでF1スコアが1.000に達するなど、非常に堅牢な結果が得られました。
2. RAPID体領域検出モデルの性能
内部データセットにおいて、mAP50は0.993、F1スコアは0.996(95%信頼区間: 0.994, 0.998)と非常に高い検出精度を達成しました。外部データセットでは、mAP50が0.952、F1スコアが0.929(95%信頼区間: 0.900, 0.958)とわずかに低下しましたが、それでも優れた性能を維持しています。
3. RAPIDランドマーク検出モデルの性能
内部データセットでは、mAP50は0.958、F1スコアは0.957(95%信頼区間: 0.952, 0.961)でした。脊椎、肺、心臓、股関節などのランドマークは非常に高い検出性能を示しました。脾臓のような小さなランドマークではやや性能が劣るものの、全体的に良好な結果が得られています。外部データセットでは、mAP50が0.926、F1スコアが0.905(95%信頼区間: 0.880, 0.930)でした。
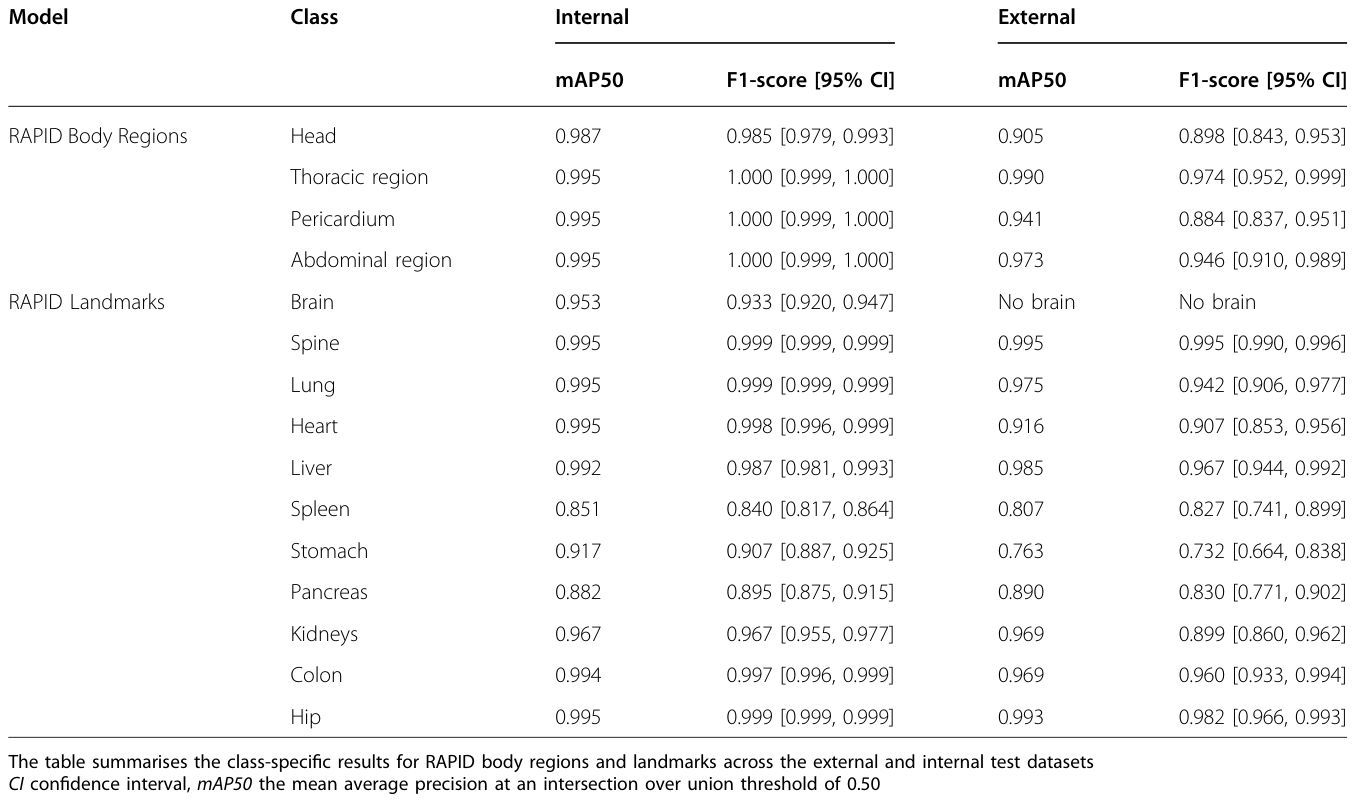
は、RAPID体領域検出モデルとランドマーク検出モデルの内部および外部テストデータセットにおけるクラスごとの性能結果をまとめたものです。
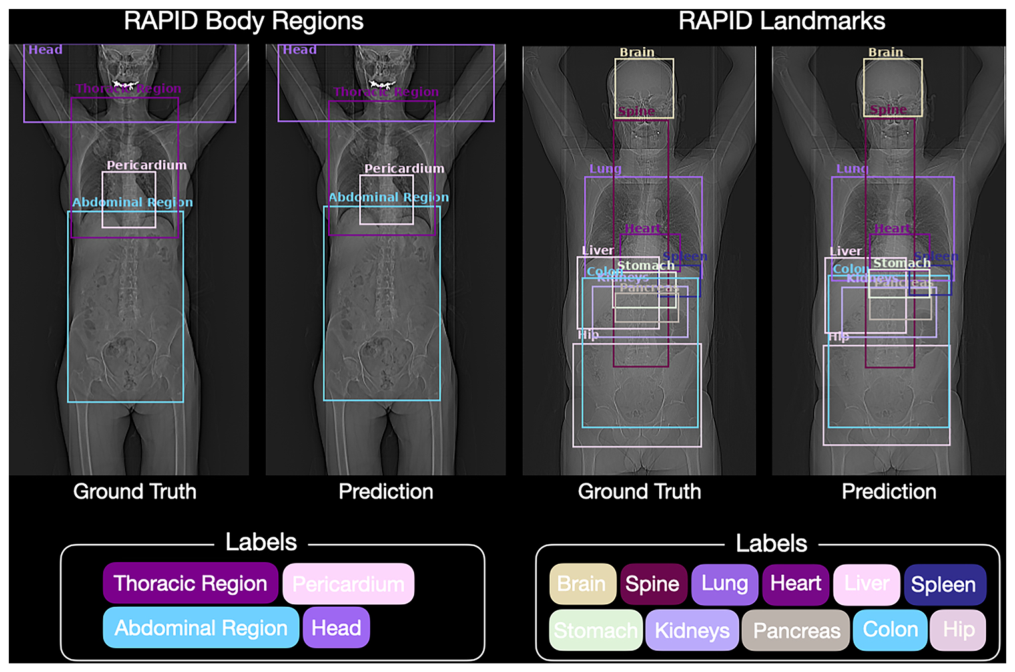
は、ランダムに選択された2名の対象者のRAPID体領域検出モデルおよびランドマーク検出モデルの出力例を示しており、モデルがどのように解剖学的領域とランドマークを検出しているかが視覚的に確認できます。
専門家による質的評価も、技術的評価と概ね一致していました。
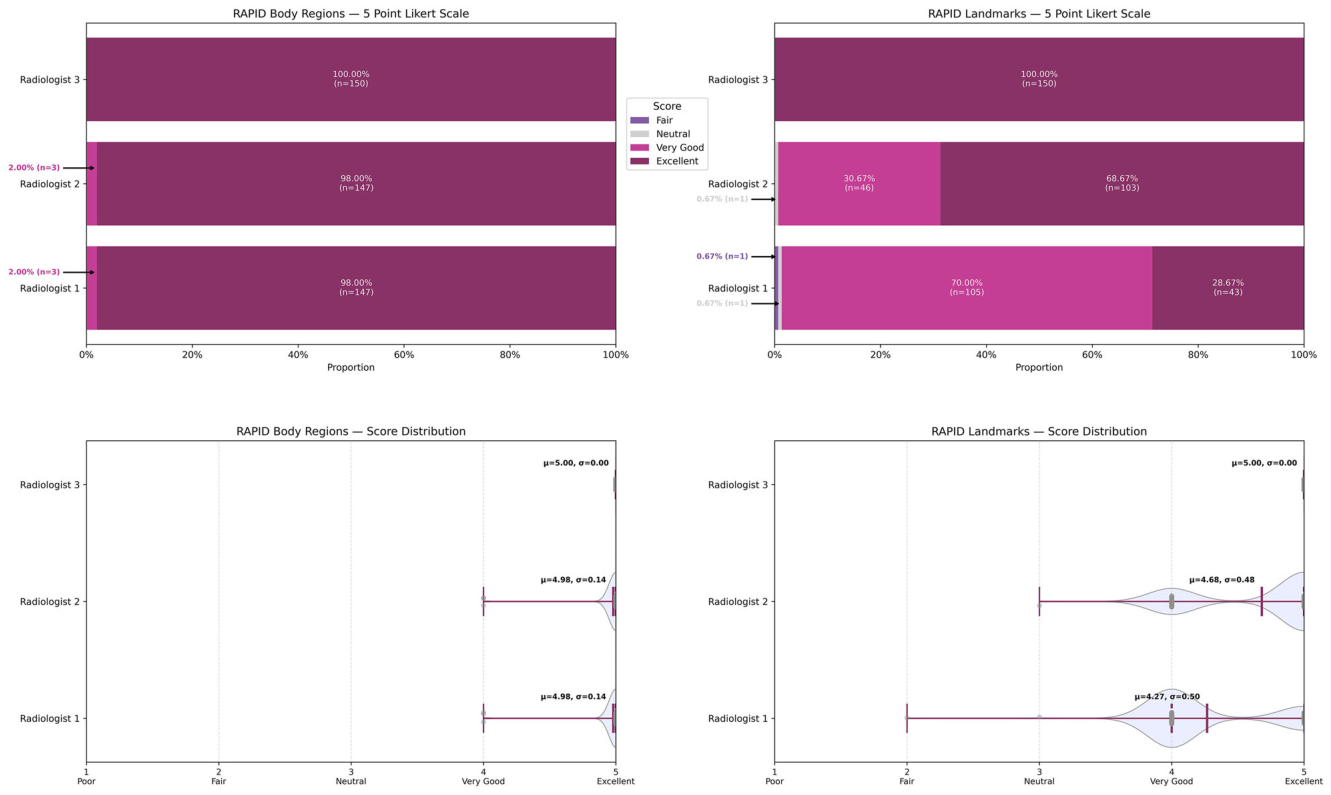
に示すように、3人の専門家によるレビューでは、ほとんどの予測が5段階評価で「4」または「5」と評価され、専門家間の高い合意度(GwetのAC2で体領域モデルは0.999、ランドマークモデルは0.915)が示されました。
臨床での応用例:一貫性のない情報からの脱却
このRAPIDアプローチは、医療現場におけるCTシリーズの解剖学的ラベリングの信頼性を大幅に向上させることが期待されます。たとえば、肝臓をターゲットとしたCTシリーズでも、実際の撮影範囲は様々で、テキストメタデータだけでは必ずしも正確な情報が得られない場合があります。
RAPIDはCTシリーズのカバー範囲をトポグラムに直接マッピングし、画像から解剖学的情報を抽出します。これにより、特定のCTシリーズが、例えば肝臓だけでなく胃のような隣接するランドマークも含まれているかどうかを、専門的な解剖学的知識を持たない使用者でも判断できるようになります。これは、迅速な研究ナビゲーションを促進し、ワークフローの効率を改善し、コホート選択や画像ルーティングといった自動化された臨床アプリケーションをサポートします。
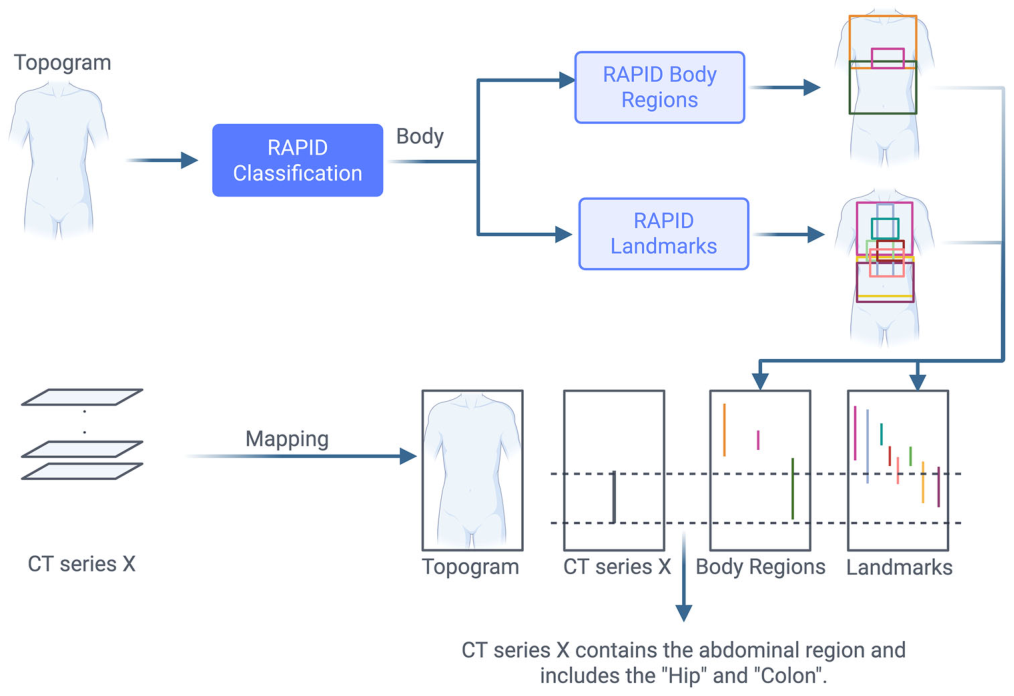
はRAPIDのワークフローの模式図を示しており、CTシリーズがどのようにトポグラムにマッピングされ、予測された体領域やランドマークと空間的に比較されるかがわかります。
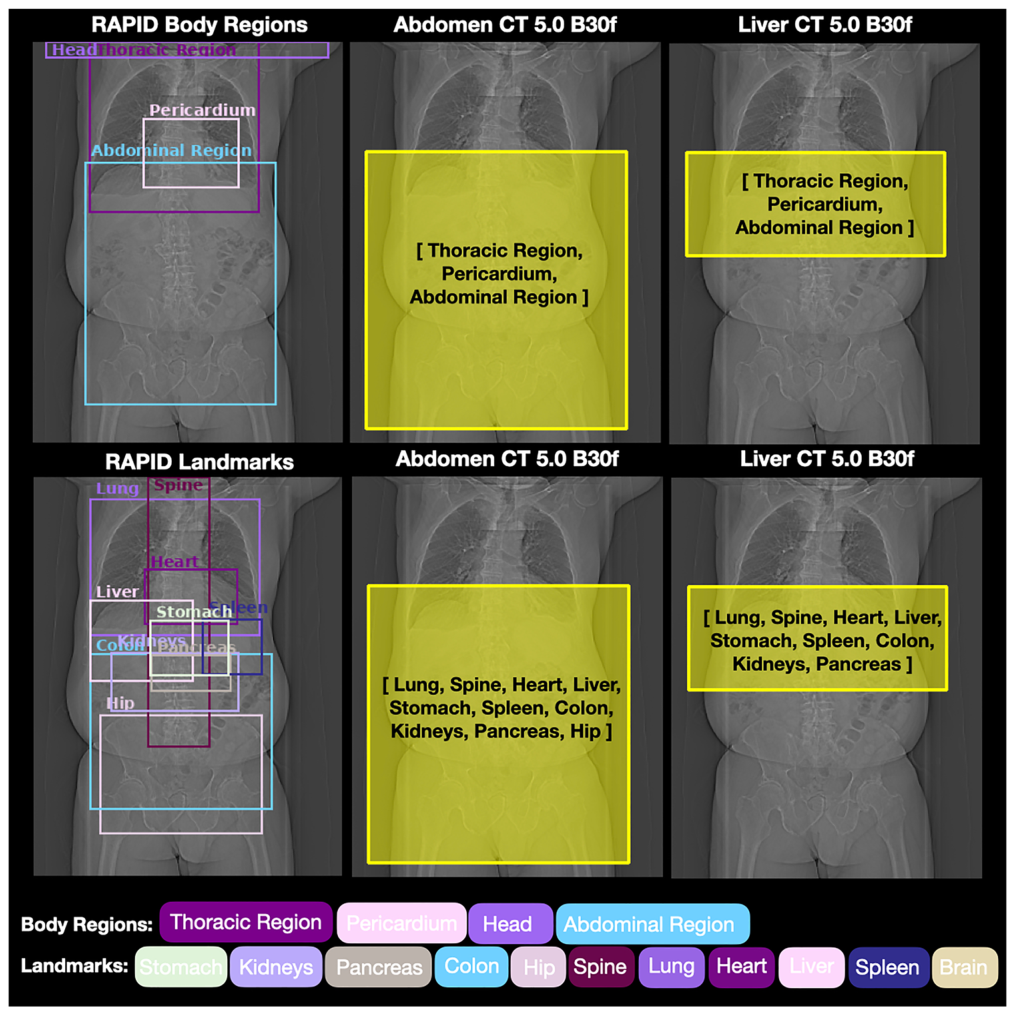
では、ラベリングされたトポグラムとCTシリーズのカバー範囲が示されており、肝臓および腹部のCTスキャンにおける体領域とランドマークの検出が視覚的に説明されています。
本研究の強みと限界、そして今後の展望
この研究の重要な強みは、大規模なデータセットにわたる解剖学的参照アノテーションを生成するために、自動ラベリング戦略を採用した点です。従来の多くの研究が手動でのラベル付けに依存していたのに対し、本研究ではBOAモデルを用いてCTボリュームから解剖学的セグメンテーションを抽出し、これらをトポグラムに転送することで、時間とコストのかかる手動プロセスを排除し、一貫性のある再現可能なアノテーションを大規模に実現しています。
また、RAPIDは従来のメタデータのみに依存するアプローチと比較して、単一画像内の複数の解剖学的領域の存在をより効果的に捉えることができます。さらに、スライスレベルで分類を行う既存のアプローチとは異なり、RAPIDはトポグラムレベルで直接動作するため、よりシンプルで軽量なエンドツーエンドのパイプラインを実現します。これにより、複数のラベルが共存する重複する解剖学的領域も自然にサポートされます。
一方で、いくつかの限界も認識されています。第一に、対象者の体位によって体領域が重なり合う場合など、解剖学的な曖昧さが依然として課題となります。これは純粋な解剖学的ラベリングと臨床的に意図されたスキャン領域との違いを反映するものです。今後は、複数のラベルやハイブリッドモデリングアプローチを検討し、重複する解剖学的貢献を明示的に表現する必要があります。第二に、脾臓のような小さな解剖学的構造の検出は依然として困難です。これはYOLOベースのモデルを含む物体検出アーキテクチャの既知の限界と一致しています。小さな構造はトポグラム上での空間的範囲とコントラストが限られており、局所化エラーの影響を受けやすいため、超解像モデルや適応型信頼度閾値の使用が今後の検討課題となります。
さらに、本研究の検出モデルは全身のトポグラムに限定されており、地域CT研究におけるトポグラムへの適用可能性を評価する必要があります。使用されたトポグラムの約99%がシーメンス社製のスキャナで取得されたものであり、検出器の形状や再構成パイプラインの違いにより、他社製スキャナへの汎用性には限界がある可能性があります。将来的には、複数ベンダーのデータセットでの性能評価が求められます。最後に、現在の方法は解剖学的ラベリングのみに焦点を当てており、造影剤のフェーズなどの追加の取得関連特性は組み込まれていません。完全に自動化された、意味的にリッチなCTシリーズの特性評価を達成するには、このような追加次元に対応する補完的なモデル(例: 造影剤フェーズ識別モデル)との統合が必要です。
まとめ
本研究は、深層学習ベースのCTトポグラム分析が、DICOM空間幾何学と組み合わせることで、CTシリーズの正確で再現性の高い解剖学的ラベリングを可能にすることを実証しました。このアプローチは、画像データから直接解剖学的情報を導き出すことで、不整合なDICOMメタデータへの依存を減らし、データの整合性とスケーラビリティを向上させ、臨床応用における効率を高めます。
完全に自動化された包括的なCTシリーズ特性評価には、さらなる補完的なモデルが必要ですが、提案されたRAPIDアプローチは、解剖学的情報を意識したCTデータ分析の強力な基盤を確立します。実用的な放射線専門家の視点から見ると、CTシリーズを解剖学的にラベル付けされたトポグラムにリンクさせることは、各スキャンの解剖学的カバー範囲を透明で再現可能な記録として提供します。これにより、テキスト情報が一貫性がなかったり不完全であったりする場合でも、より効率的なシリーズ識別をサポートできます。
重要なのは、このアプローチが既存のDICOMベースのシステムを補完し、テキストメタデータにピクセルベースの解剖学的情報を加えることで、手動での確認への依存を減らし、臨床および研究設定でのCTデータの一貫した使用を支援する点です。
用語集
- 深層学習 (Deep Learning): 多数の層を持つニューラルネットワークを用いた機械学習手法で、画像や音声などの複雑なデータから特徴を自動的に学習します。
- DICOM (Digital Imaging and Communications in Medicine): 医療画像を保存、伝送、表示するための国際標準規格で、画像データとメタデータ(撮影情報、対象者情報など)を含みます。
- トポグラム (Topogram): CTスキャンを行う前に撮影される、広範囲のX線平面画像(スカウト画像やスキャングラムとも呼ばれます)。CTスキャンの計画や範囲決定に用いられます。
- YOLOv8 (You Only Look Once, version 8): 物体検出(画像内のオブジェクトを識別し、その位置を特定する)に特化した、高速かつ高精度な深層学習モデルの一種です。
- F1スコア (F1 score): 分類モデルの性能を評価する指標の一つで、精度(Precision)と再現率(Recall)の調和平均を取ったものです。値が高いほど良好な性能を示します。
- mAP50 (mean Average Precision at an Intersection over Union threshold of 0.50): 物体検出モデルの性能を評価する主要な指標。検出されたオブジェクトと実際のオブジェクトとの重なり(IoU)が50%以上である場合に、平均精度を算出します。
- Likert尺度 (Likert scale): アンケートなどで、回答者の同意度や評価を「非常に良い」から「非常に悪い」のような複数の段階で示すための心理学的評価尺度です。
- FHIR-Pyrate (Fast Healthcare Interoperability Resources – Python Package): FHIRサーバーから医療データをプログラム的に照会し、取得するために設計されたPythonパッケージです。
- BOAモデル (Body and Organ Analysis model): CTボリュームから身体領域や臓器の解剖学的セグメンテーション(領域分割)を抽出するために開発された3Dセグメンテーションアルゴリズムです。
- TotalSegmentator: CT画像から104もの解剖学的構造を堅牢にセグメンテーション(領域分割)できる深層学習モデルです。
- Gwetの合意係数2 (Gwet’s Agreement Coefficient 2; AC2): 複数の評価者(ラベラー)の間での合意度を測定するための統計的指標で、偶然の一致による影響を調整して算出されます。
コメントを残す