
説明可能なAIで側頭骨CT診断を向上:左右対称性とアテンションの力
解説対象論文: Symmetry-Consistent Attention Supervision for Explainable Multi-label Temporal-Bone CT Assessment
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年11月12日時点)
側頭骨CT画像は、内耳や中耳の微細な骨構造や両側性解剖を詳細に可視化しますが、関連構造が小さく、異常が微妙であること、そして左右比較が必要となるため、その解釈は専門家にとって非常に困難な場合があります。この課題に対し、深層学習を用いた自動診断支援ツールの開発が期待されています。本研究は、深層学習モデルがどのように診断に至ったかを専門家が理解できる「説明可能なAI(Explainable AI)」を構築し、側頭骨CTにおける内耳および中耳の状態を領域ごとに、複数のラベルで評価する新しいフレームワークを提案しています。特に、左右対称性の解剖学的特徴を学習プロセスに組み込むことで、より信頼性が高く、解釈しやすい診断支援を目指しました。
側頭骨CT診断の難しさとAIへの期待
どうも、Beyond the Pixelです。側頭骨CT画像は、内耳や中耳の微細な骨構造や左右対称性解剖を詳細に可視化できますが、関連構造が小さく、異常が微妙であること、そして左右比較がしばしば必要となるため、その解釈は専門家にとって非常に困難な場合があります。この複雑さから、臨床現場での画像レビューや診断には経験豊富な耳鼻咽喉科専門家や放射線科専門家が求められます。深層学習(Deep Learning)は、慢性中耳炎や真珠腫の評価、耳硬化症の検出、乳突蜂巣や中耳の分析、解剖学的セグメンテーション(領域分割)といった側頭骨CT関連タスクにおいて有望な結果を示しています。しかし、その臨床応用には二つの重要な課題が残されていました。一つは、画像全体を認識する分類器が、目的の耳の構造ではなく文脈的または非解剖学的な根拠に依存する可能性があること。もう一つは、同じCT検査から複数の相関する2Dスライス(断面画像)が生成されるため、不適切なスライスレベルのデータ分割が性能評価を過大評価する可能性があることです。本研究は、これらの課題に対処し、側頭骨CTにおける内耳および中耳の状態を領域ごとに、複数のラベルで評価する説明可能な深層学習(Explainable AI, XAI)フレームワークの開発を目的としています。このフレームワークは、左右の耳の正常状態および先天性奇形状態を表す8つのラベルを予測するために、ResNet-18エンコーダとクラス固有アテンションプーリング(クラス固有アテンションプーリング)を使用しました。
左右対称性とアテンションによる「説明可能」な診断支援
この研究で提案されたフレームワークは、左右の耳の構造が解剖学的に左右対称であるという特徴を、深層学習モデルの設計に組み込むことで、より信頼性が高く、解釈しやすい診断支援を目指しています。具体的には、モデルは左内耳、左中耳、右内耳、右中耳という最大4つの領域について、その状態をラベル付けします。ポジティブな所見の一部に対しては、疎なポリゴンアノテーション(限定的な領域を示す注釈)が利用可能であり、これが空間的な教師信号として機能します。
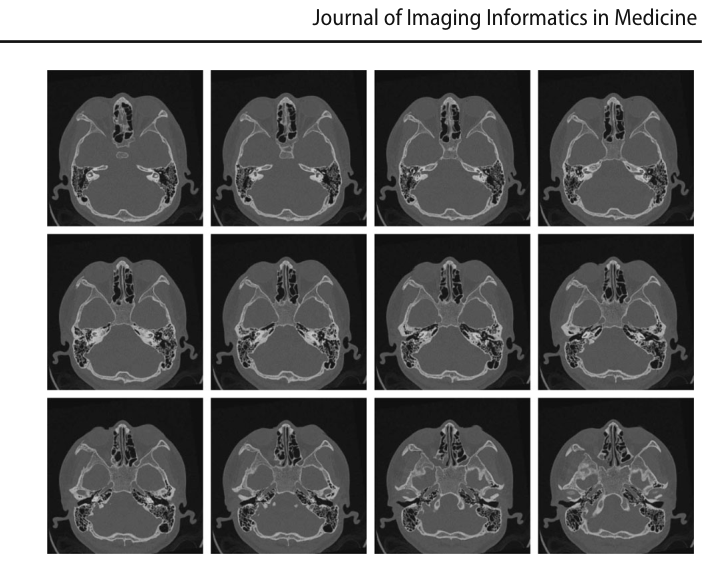
このデータセットには、軸位断と冠状断のCT画像が含まれており、これらの画像は、同じ対象者の複数のスライスを含む可能性があります。
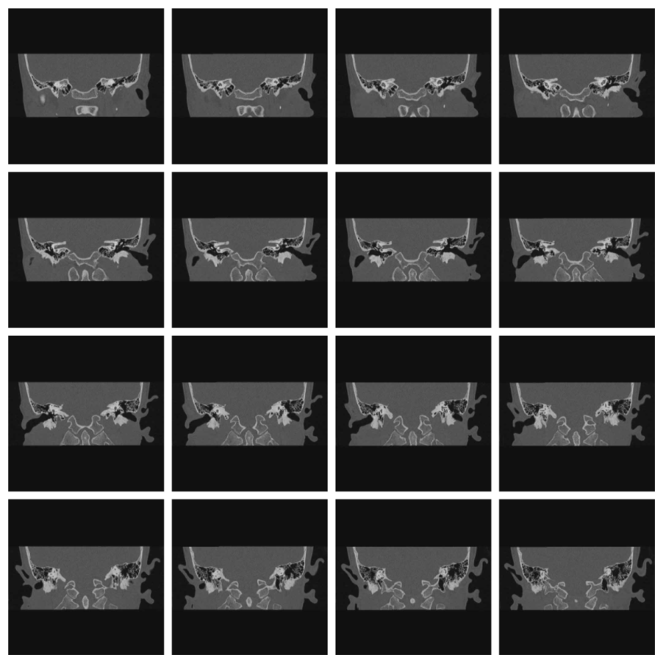
この課題は、左右非対称性、不完全な多ラベル学習(Multi-label Classification)、そして疎な空間的教師信号という、複合的な問題として定式化されました。主要な貢献は以下の通りです。まず、左右の内耳と中耳の正常状態および先天性奇形状態を表す8つのアトミックラベル(最小単位のラベル)を定義し、不完全な領域レベルのアノテーションを明示的に扱いました。次に、ネットワークがラベルごとのアテンションマップを生成し、疎なポリゴンマスクを使って最適化することで、局所化の直接的な教師信号を持つアテンション誘導型分類器を開発しました。これには、マスク付き二値交差エントロピー、Dice-overlap、およびマスク外ペナルティが用いられます。さらに、水平反転とラベルチャネルの順列(入れ替え)を用いて、ログ確率(Logit)とアテンションマップの両方に左右対称性の一貫性(Bilateral Equivariance)正則化を導入しました。最後に、厳格な対象者レベルでのデータ分割により、データリーク(情報漏洩)を考慮した評価プロトコルを確立しました。これにより、内部的な画像レベル評価の限界を明確に議論しています。この研究では、合計87名の対象者から得られた2399枚の軸位断および冠状断CT画像が使用されました。開発フェーズでは35名の対象者(1018枚の画像)に対して四重の対象者レベル交差検証(クロスバリデーション)が行われ、その後、残りの52名の対象者(1381枚の画像)からなる内部テストセットで評価が実施されました。
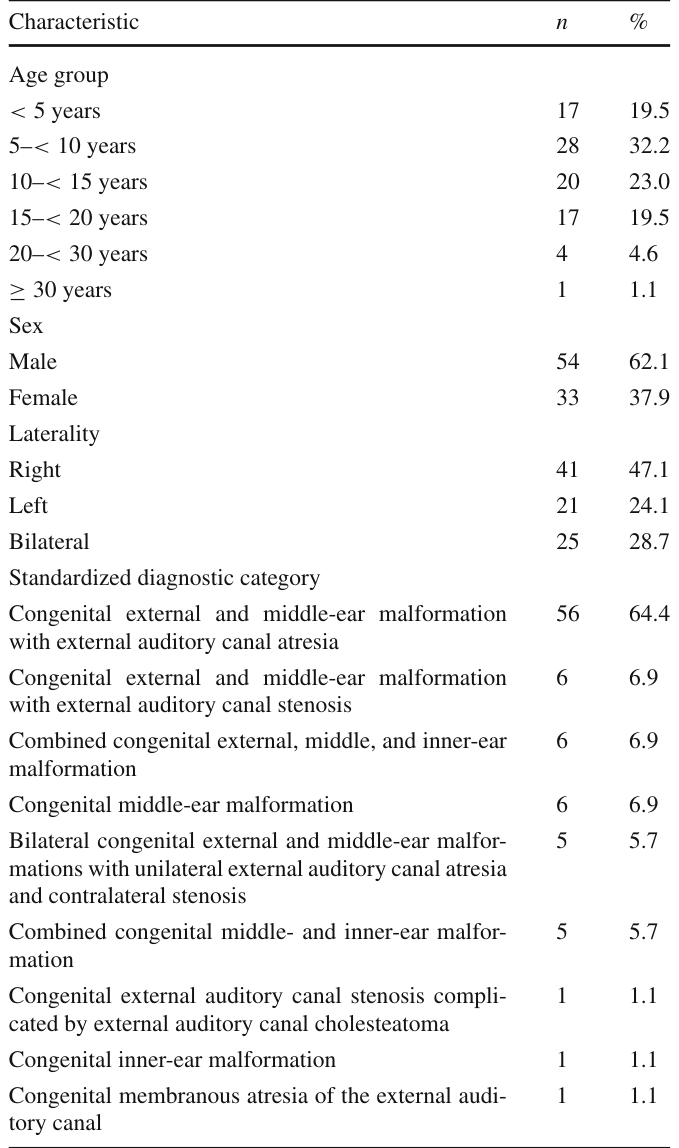
対象者の年齢層や性別、耳の奇形の罹患側などの特徴が示されています。
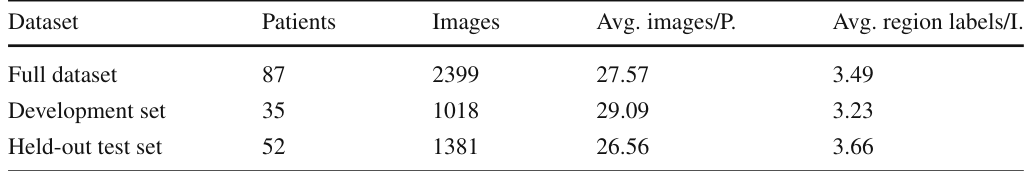
データセット全体の概要と、開発セットおよびテストセットの内訳が示されています。
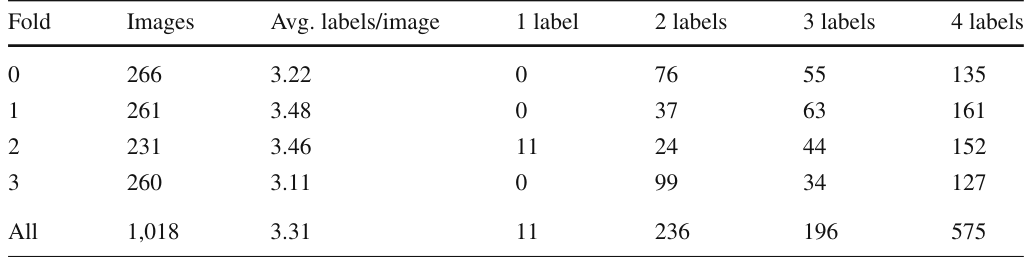
開発セットがどのように4つのフォールド(分割)に分けられ、各フォールドに何枚の画像が含まれ、それぞれの画像にいくつの解剖学的領域ラベルが存在するかが示されています。
開発セットの4つのフォールドにおける、8つのアトミックラベル(左右の内耳・中耳の正常および奇形)ごとの画像数と割合が示されており、すべてのフォールドにすべてのラベルが表現されています。提案されたアーキテクチャは、ResNet-18エンコーダをベースにしており、入力画像から特徴量を抽出し、二つの並行ブランチに供給します。
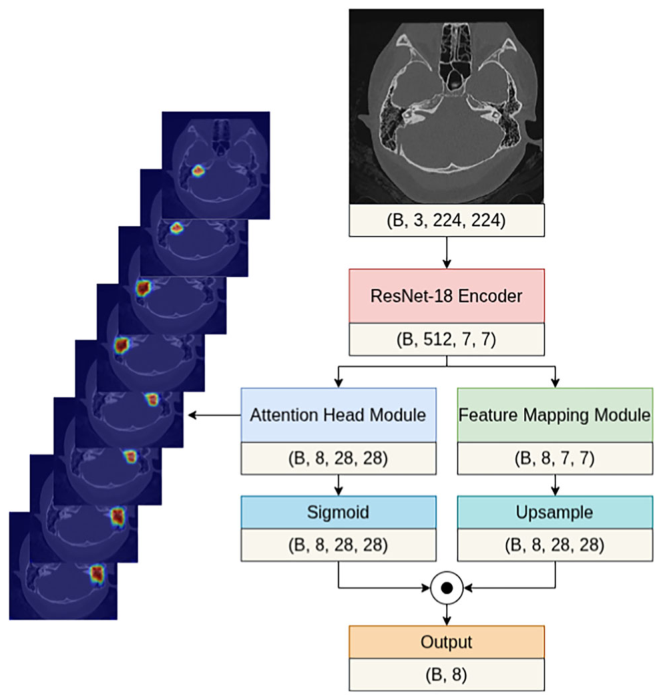
一つは特徴マッピングモジュールで、エンコーダの特徴を目的のラベル空間に投影します。もう一つはアテンションヘッドモジュールで、クラス固有のアテンションログ確率を生成し、シグモイド正規化後にクラス固有の空間重み付けマップとして使用されます。画像レベルのログ確率は、このアテンションマップで空間的に重み付けされた合計によって得られます。これにより、局所化信号が予測メカニズムの一部となり、事後的な可視化に留まらない点が特徴です。トレーニングは、以下の要素を組み合わせた複合的な損失関数を最小化することで行われます。クラス不均衡を考慮した分類のための重み付き多ラベル二値交差エントロピー、有効な局所化マスクを持つラベルのアテンションログ確率を指導するマスク付きアテンション二値交差エントロピー、小さな前景マスクにおける極端な前景-背景の不均衡の影響を軽減するためのDiceアテンションオーバーラップ(Dice係数)、有効なポジティブマスクの外側のアテンションをペナルティするマスク外アテンションペナルティ、そして予測とアテンションマップが期待される左右対称変換に従うように促す左右対称性の一貫性正則化です。水平反転によるデータ拡張と左右対称性の一貫性正則化は、異なる役割を果たします。データ拡張はトレーニングの多様性を高めることを目的としていますが、左右対称性の一貫性正則化は、入力の左右反転に対して予測が一貫して変換されることを明示的に促します。両方のメカニズムはトレーニング中のみ使用され、推論時には追加コストは発生しません。
評価結果と解釈可能性の向上
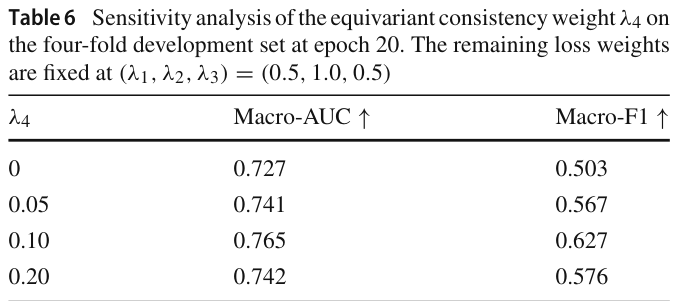
提案モデルの性能は、マクロAUC(Macro-AUC)とマクロF1スコア(Macro-F1 Score)を用いて評価されました。開発フェーズの交差検証において、完全なモデルはマクロAUC 0.765、マクロF1スコア 0.627を達成しました。
補助的な損失項(アテンション二値交差エントロピー、Diceアテンション、マスク外ペナルティ、左右対称性の一貫性)のそれぞれが、モデル性能に貢献していることが示されています。
左右対称性の一貫性重み(λ4)の感度分析の結果が示されており、λ4=0.1のときにマクロAUCとマクロF1の両方で最高の性能を達成しました。残りの損失重みを固定した状態でλ4を0から0.1に増やすと、両方の指標が着実に向上しました。これは、バランスの取れた設定で左右対称性を強制することが、判別性能を維持しつつ有効であることを示唆しています。内部テストセットでの画像レベル評価では、マクロAUC 0.688、マクロF1スコア 0.572を達成し、評価されたCNN、Vision Transformer (ViT)、MedViTのベースラインモデルの中で最高の平均性能を示しました。
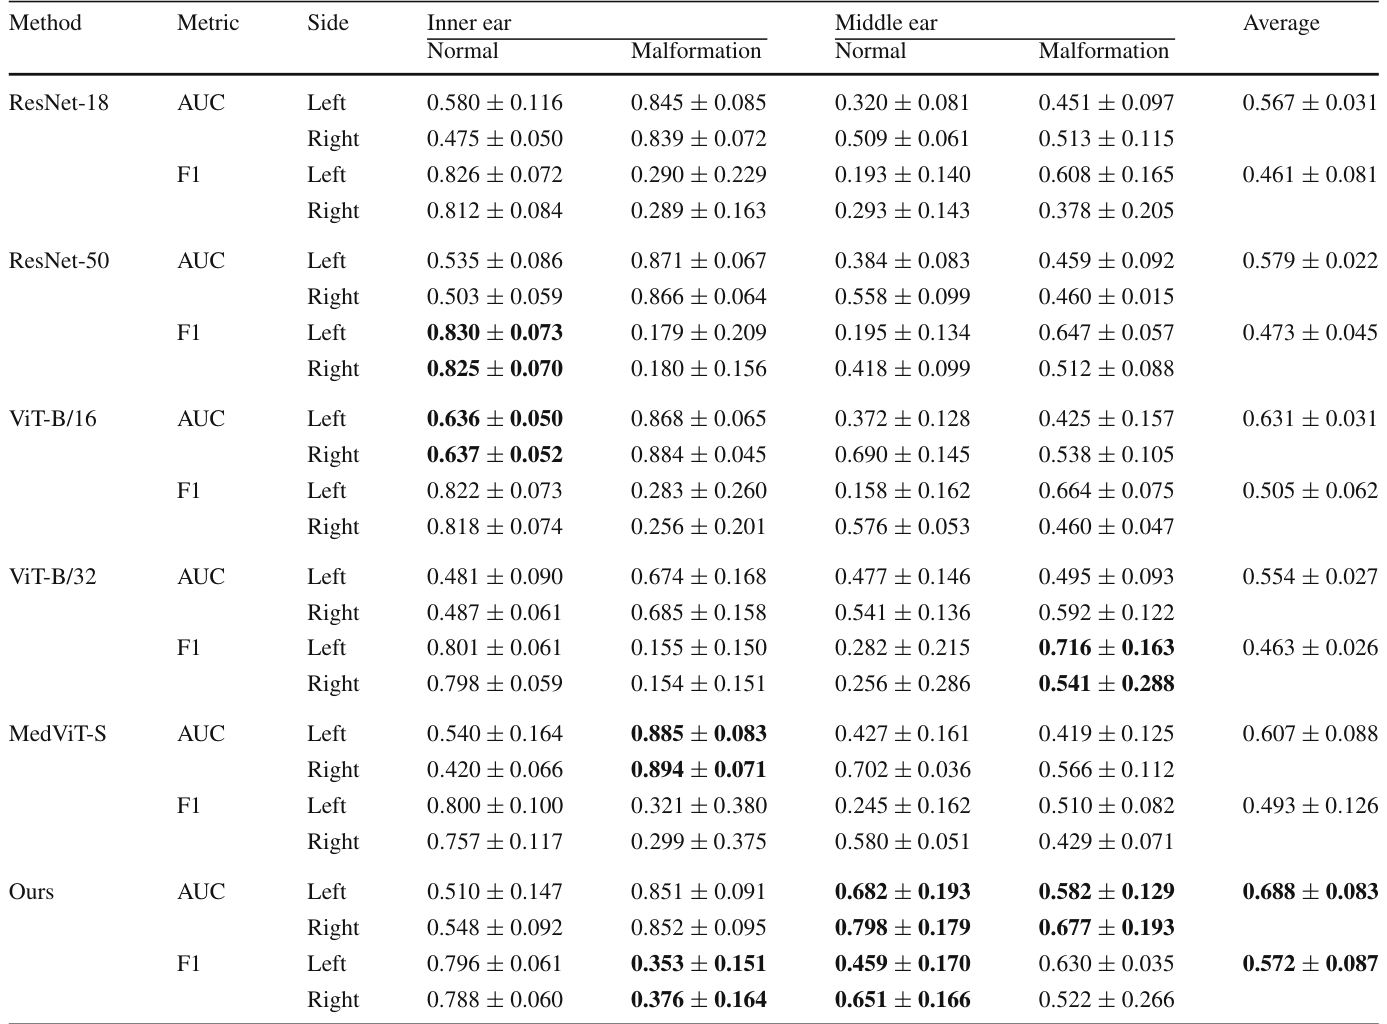
この表は、提案手法と他のベースラインモデル(ResNet-18、ResNet-50、ViT-B/16、ViT-B/32、MedViT-S)の、左右の内耳と中耳の正常および奇形ラベルごとのAUCおよびF1スコアの比較を示しています。提案手法は、中耳のラベルと内耳の疾患状態に関するF1スコアで最も一貫した改善が見られました。これは、不均衡な医療画像データセットにおいて、分類器が一般的な正常ラベルを優先しがちな傾向がある中で、重要なパターンです。さらに、対象者レベルでの集約評価では、マクロAUCが0.716、マクロF1スコアが0.621に向上しました。
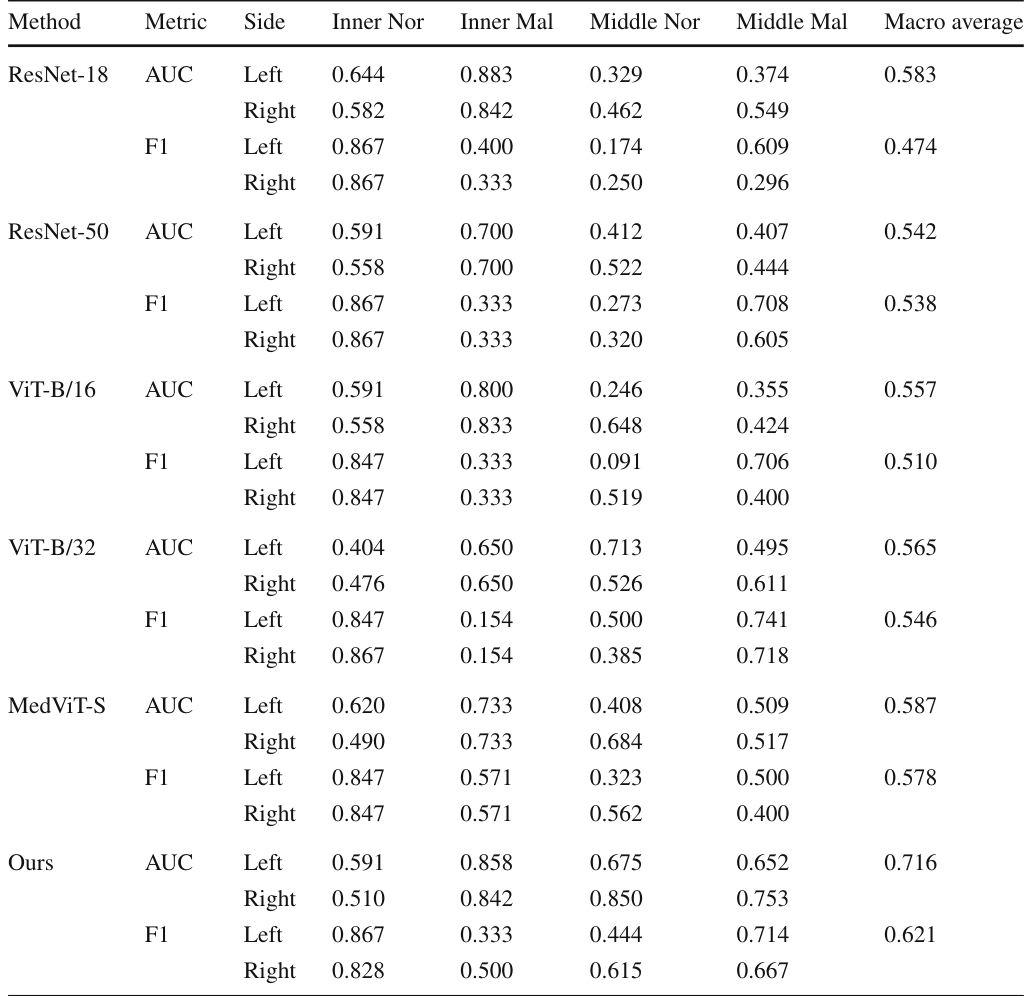
この表は、52名の対象者からなる内部テストコホートにおける対象者レベルの性能を示しており、スライスごとの確率を平均して得られたものです。提案手法は、画像レベルの評価に比べて対象者レベルでも全体の性能優位性を維持し、マクロAUCとマクロF1スコアともに向上しました。この対象者レベルの分析は、側頭骨CTの臨床使用により密接に対応しています。定性的なアテンション解析では、提案モデルが意図された耳の構造の周りにアテンションを集中させる傾向があることが示されました。アテンションマップは左右に特異的であり、左耳のラベルは主に左側の解剖学的構造を活性化し、右耳のラベルは主に右側の解剖学的構造を活性化しました。この図は、提案手法によって生成されたアテンションマップの可視化を示しています。第一列は冠状断、第二列は軸位断の画像で、各列は左内耳、左中耳、右内耳、右中耳に対応しています。暖かい色ほど高い正規化されたアテンションを示し、左右の対象構造周辺に集中していることが視覚的に確認できます。この図は、Fig. 4に対応する拡大表示で、小さな内耳および中耳の解剖学的構造とそれに対応するアテンションパターンがより明確に視覚化されています。この図は、正しく予測されたCT画像に対する提案手法のアテンションマップとベースラインのヒートマップを比較しています。ベースラインの一部のマップが拡散的であったり、対側が活性化されたりするのに対し、提案手法はより頻繁に期待される左右の目標領域を強調しています。推論効率については、提案モデルはモデル単体での推論に画像あたり0.833 ± 0.008ミリ秒、エンドツーエンドでは画像あたり2.887 ± 0.229ミリ秒を要しました。
今後の展望と研究の限界
本研究は、深層学習モデルの分類能力と解釈可能性を、クラス固有アテンションプーリングと左右対称性の一貫性という特徴を介して結びつけることで、側頭骨CTにおける説明可能な多ラベル学習の可能性を探りました。このアプローチは、単一の疾患や解剖学的ターゲットに焦点を当てた従来の深層学習研究のギャップを埋めるものです。特に、先天性耳奇形は左右両側に発生したり非対称であったり、内耳、中耳、または複数の解剖学的区画に同時に影響を及ぼす可能性があります。したがって、耳の画像診断における機械学習の価値は、単に分類精度を向上させるだけでなく、専門性への依存度が低い、標準化された再現性のある画像診断支援ツールを提供する可能性にあります。症例数が限られた医療施設では、このようなシステムが予備的なスクリーニング、異常領域の局所化、左右構造の比較、そして専門家への紹介判断を支援し、さらなる評価を必要とする対象者を特定するのに役立つ可能性があります。しかし、本研究にはいくつかの限界があります。まず、報告された性能は画像レベルで評価されています。同じ対象者から複数の画像が得られるため、将来の研究では対象者レベルの集約と診断評価を取り入れ、臨床展開シナリオをより良く反映させる必要があります。第二に、現在のラベル定義は、内耳および中耳領域の広範な正常状態と先天性奇形状態を捉えるものであり、具体的な診断名(例: ミッシェル奇形、蝸牛無形成など)を区別するものではありません。次のステップとして、より詳細にアノテーションされたデータセットと、これらの臨床的に特定のカテゴリに対する診断ベンチマークの開発が求められます。第三に、現在のモデルはエクスポートされた2D画像で動作しており、標準化された入力表現を提供しますが、3Dの volumetric な文脈を完全に活用しているわけではありません。フレームワークを拡張して3D情報を組み込むことで、解剖学的および先天性奇形の特徴付けをさらに改善できる可能性があります。さらに、解釈可能性の分析は定性的な可視化に限定されており、独立した完全な専門家アノテーションセットに対する定量的な局所化評価や、ブラインドされた放射線科専門家による読影者研究は行われていません。したがって、本結果は局所化の精度、放射線科専門家の好み、解釈時間の短縮、または臨床意思決定の改善を確立するものではありません。今後の研究では、完全な独立した局所化アノテーションと事前定義された定量的指標を用い、解剖学的妥当性、診断性能、信頼性、および解釈時間についてブラインド多読影者評価を実施する必要があります。本研究は、クラス不均衡を考慮した分類、疎なアテンション教師信号、マスク外正則化、および左右対称性の一貫性を組み合わせた、説明可能な多ラベル側頭骨CT評価のための左右対称性一貫性アテンション教師ありフレームワークを提示しました。このアプローチは、耳科領域のCAD(Computer-Aided Diagnosis)において、疎なポリゴンアノテーションをクラス固有アテンション学習に直接組み込み、左右対称性の一貫性を予測とアテンションマップの両方に明示的に強制できることを示しています。ただし、展開には大規模な外部検証、対象者レベルの診断評価、および臨床的に特定の診断エンドポイントが引き続き必要です。
用語集
- 側頭骨CT: 耳の内部構造(内耳、中耳など)を詳細に調べるためのX線断層撮影検査。
- 深層学習(Deep Learning): 人間の脳の神経回路を模倣した多層のニューラルネットワークを用いてデータから特徴を学習する機械学習の一分野。
- 説明可能なAI(Explainable AI, XAI): AIモデルがどのように特定の決定や予測に至ったかを人間が理解できるようにする技術や手法。
- 多ラベル分類(Multi-label Classification): 1つの入力データに対して複数の正解ラベルを同時に予測するタスク。
- ResNet-18エンコーダ: 画像認識に広く使われる畳み込みニューラルネットワーク(CNN)の一種であるResNetの18層バージョン。画像から特徴量を抽出する部分(エンコーダ)として利用される。
- クラス固有アテンションプーリング: 各予測ラベル(クラス)に関連する画像領域に焦点を当てる(アテンションをかける)仕組み。これにより、モデルがどこを見て判断したかを可視化できる。
- 左右対称性の一貫性(Bilateral Equivariance): 左右反転という変換が入力画像に適用された際に、モデルの出力(予測やアテンションマップ)も左右が入れ替わるという予測可能な形で変換されるべきであるという性質。
- マクロAUC(Macro-AUC): 各クラスのAUC(受信者操作特性曲線下面積)を計算し、それらを平均したもの。クラス間の不均衡がある場合に、全体的な性能を公平に評価するために用いられる。
- マクロF1スコア(Macro-F1 Score): 各クラスのF1スコアを計算し、それらを平均したもの。適合率と再現率のバランスを示す指標で、不均衡データセットで有用。
- ログ確率(Logit): 分類モデルの出力層の手前で得られる、まだ活性化関数(シグモイドなど)が適用されていない生の値。
- 二値交差エントロピー(Binary Cross-Entropy, BCE): 二値分類タスクでモデルの予測と実際のラベルとの間の誤差を測る損失関数。
- Dice係数(Dice-overlap): 2つの領域(例えば、モデルの予測と正解マスク)がどれだけ重なっているかを示す指標。特に医療画像分野のセグメンテーション(領域分割)でよく使われる。
- Vision Transformer (ViT): 自然言語処理分野で使われるTransformerモデルを画像処理に応用したもの。
- MedViT: 医療画像に特化したVision Transformerモデル。
- CNN: 畳み込みニューラルネットワークの略。画像認識などによく使われる深層学習モデルの一種。
- CAM (Class Activation Mapping) / Grad-CAM: ディープラーニングモデルが画像のどの部分に注目して予測を行ったかをヒートマップで可視化する手法。
コメントを残す