
健康診断データと低線量CTで冠動脈疾患を予測:データ不足に強いAIモデルの可能性
解説対象論文: Availability-Aware Prediction of CCTA Findings Using Opportunistic Low-Dose CT and Routine Health-Check Data
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年11月11日時点)
冠動脈CT血管造影(CCTA)は、冠動脈疾患の疑いを評価する上で非常に重要な検査です。しかし、健康診断の記録では検査値や病歴データが必ずしも一貫して利用できるわけではありません。今回ご紹介する研究は、これらのデータ不足を考慮した「可用性認識型アンサンブル学習モデル」を提案しています。このモデルは、通常の健康診断データと機会的に撮影された低線量CT(LDCT)の情報を活用し、CCTAの重要な所見であるCAD-RADSカテゴリー3以上の病変を予測します。この革新的なアプローチは、早期のリスク評価を改善し、より適切な医療介入へと繋がる可能性を秘めています。
健康診断とAIが拓く冠動脈疾患リスク予測の新時代
どうも、Beyond the Pixelです。心臓病の一つである冠動脈疾患は、心筋梗塞や狭心症などの重篤な状態を引き起こす可能性があり、早期発見が非常に重要です。この疾患の診断には、冠動脈CT血管造影(CCTA)が非侵襲的ながらも強力なツールとして広く用いられています。しかし、CCTA検査をすべての人に行うわけにはいかず、誰に検査を行うべきかという意思決定は常に課題となります。今回ご紹介する研究は、「Journal of Imaging Informatics in Medicine」に掲載された「Availability-Aware Prediction of CCTA Findings Using Opportunistic Low-Dose CT and Routine Health-Check Data」という論文で、健康診断で得られる情報と、たまたま撮影された低線量CT(LDCT)データから、CCTAの重要な所見である冠動脈疾患報告データシステム(CAD-RADS)カテゴリー3以上の状態を予測する革新的なAIモデルについて報告しています。
データ不足の課題を乗り越えるAIアプローチ
この研究の背景には、健康診断の記録において、検査データや病歴に関する情報が必ずしもすべて揃っているわけではないという現実があります。このような「データの可用性(availability)が一定でない」という課題は、複数の臨床データと画像データを組み合わせて予測を行う上で大きな障壁となります。著者らはこの課題に対し、データの可用性を考慮したアンサンブル学習モデルを開発しました。具体的には、864名の健康診断対象者(うち221名がCAD-RADSカテゴリー3以上)のデータを対象としました。モデルは8つの基本的な臨床情報と31のLDCT由来の入力変数を使用し、さらに必要に応じて検査値と病歴の変数も組み込むことができる設計でした。この研究デザインの全体像は
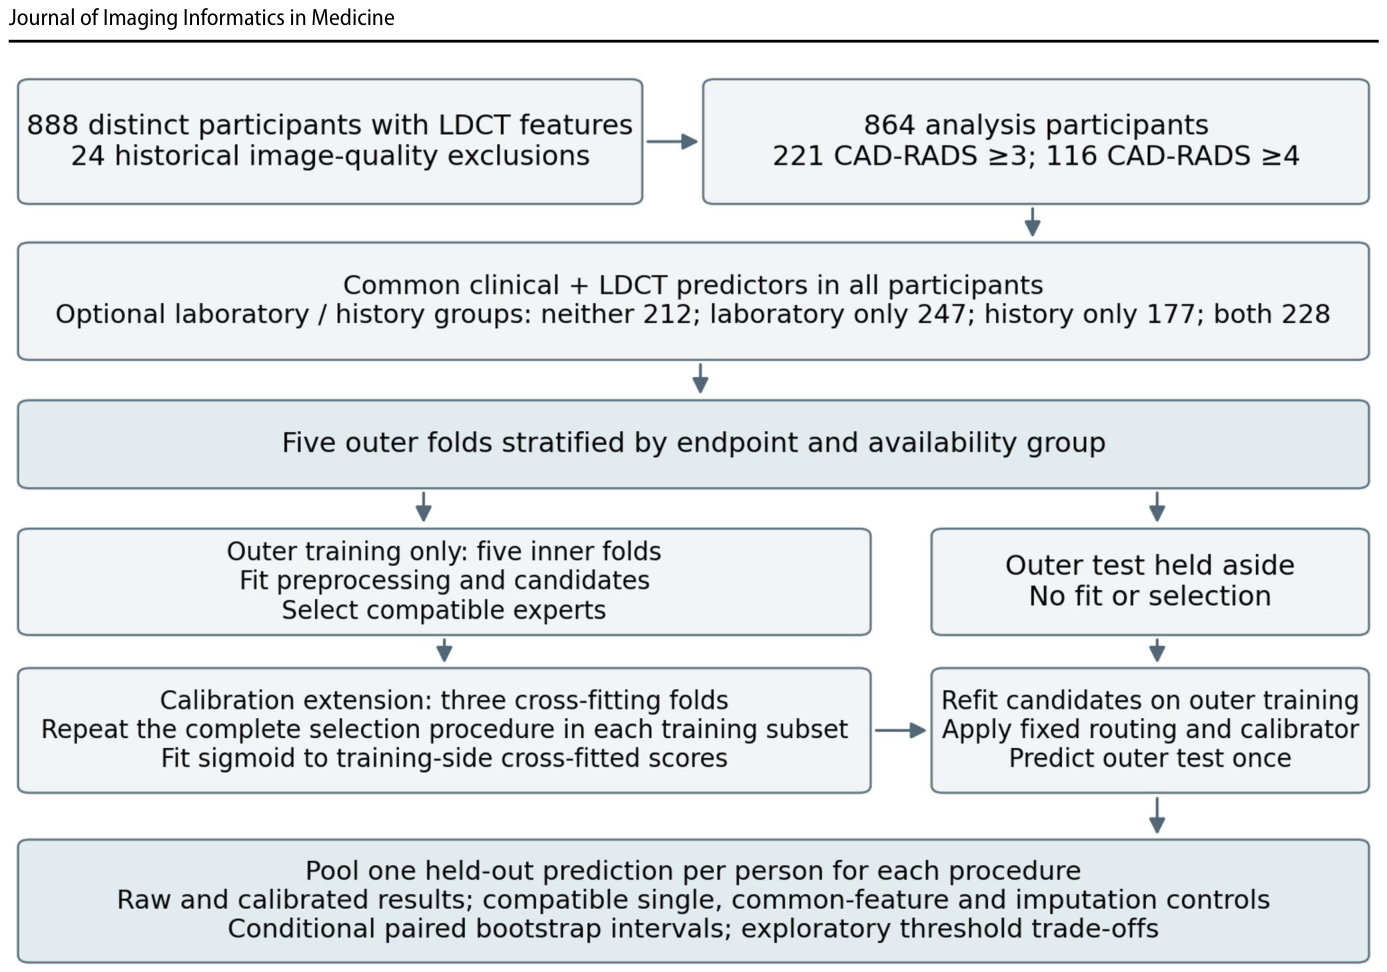
で確認できます。モデルの評価は、5回の外側交差検証と5回の内側交差検証という厳密な方法で行われ、前処理やモデル選択、キャリブレーションといったプロセスは外側のトレーニングデータ内に限定されました。参加者の特性は
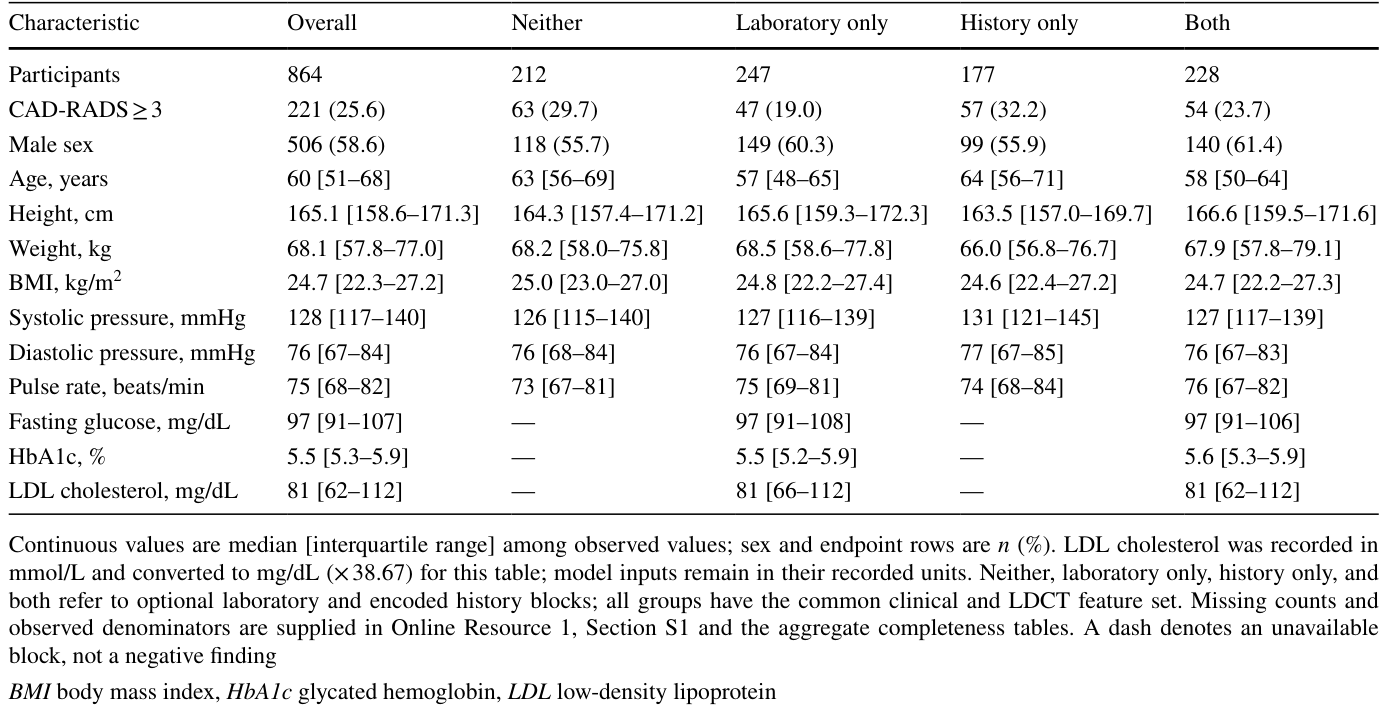
にまとめられています。
予測性能とアンサンブル学習の優位性
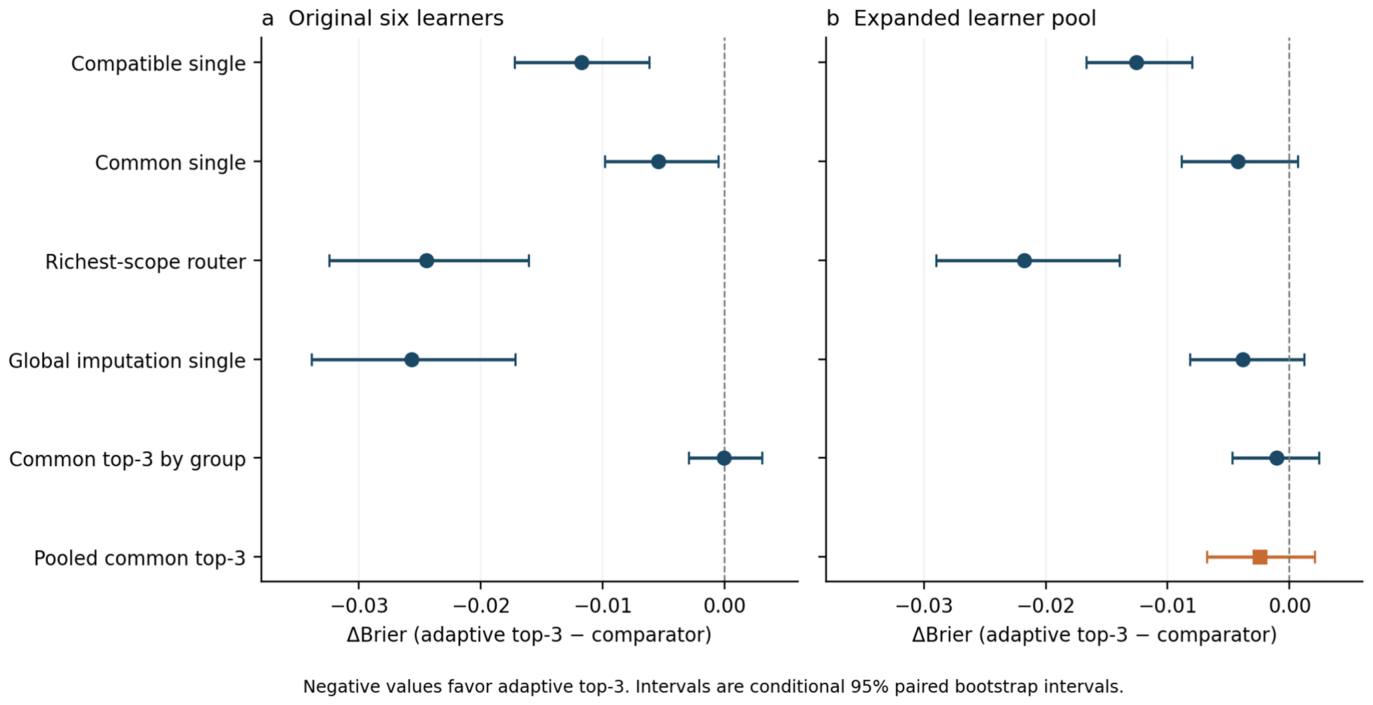
AIモデルの予測性能を評価するために、研究チームは複数の指標を用いました。主要な指標は、受信者動作特性曲線下面積(AUROC)、平均適合率(AUPRC)、そしてBrierスコアです。校正済みの適応型トップ3アンサンブル学習モデルは、AUROC 0.808、平均適合率 0.622、Brierスコア 0.14152という優れた結果を達成しました。この結果は、標準的な単一モデルと比較して、AUROCで+0.0193、Brierスコアで-0.01174の改善を示しており、アンサンブル学習が予測性能を向上させることを示唆しています。
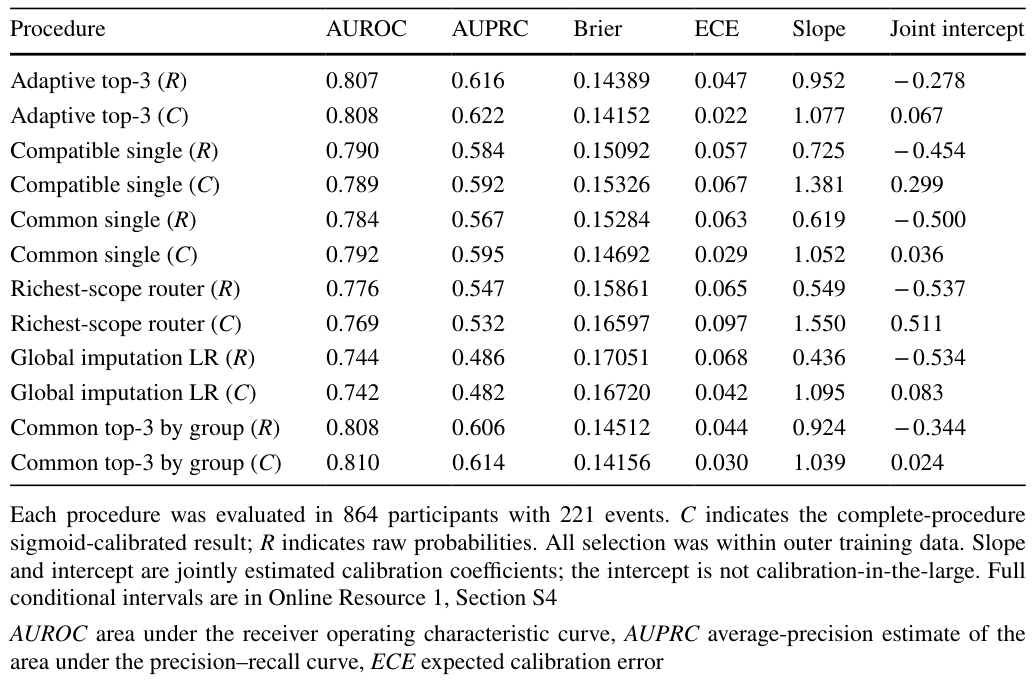
では、生データとキャリブレーション後の性能が詳細に示されています。また、
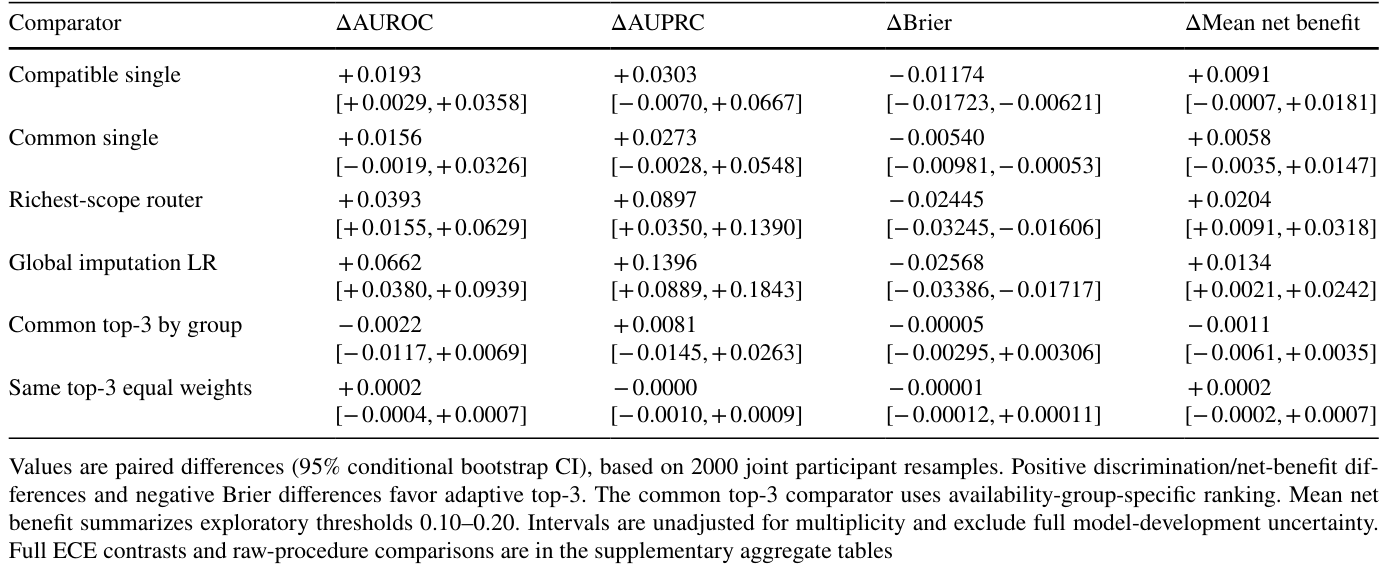
では、キャリブレーション済みの適応型トップ3モデルと他の比較対象モデルとの間の性能差が示されており、特にBrierスコアの差がマイナス(予測誤差が小さい)であることから、このアンサンブルモデルが優位であることがわかります。
検査値データと意思決定のヒント
この研究では、モデルが提示する予測確率の「キャリブレーション」も重要視されました。キャリブレーションとは、予測された確率が実際のイベント発生率とどの程度一致するかを調整することです。優れたキャリブレーションを持つモデルは、例えば「予測確率が15%」と提示された場合に、実際に15%の対象者が疾患を持っているという信頼性を高めます。キャリブレーション曲線と意思決定曲線は
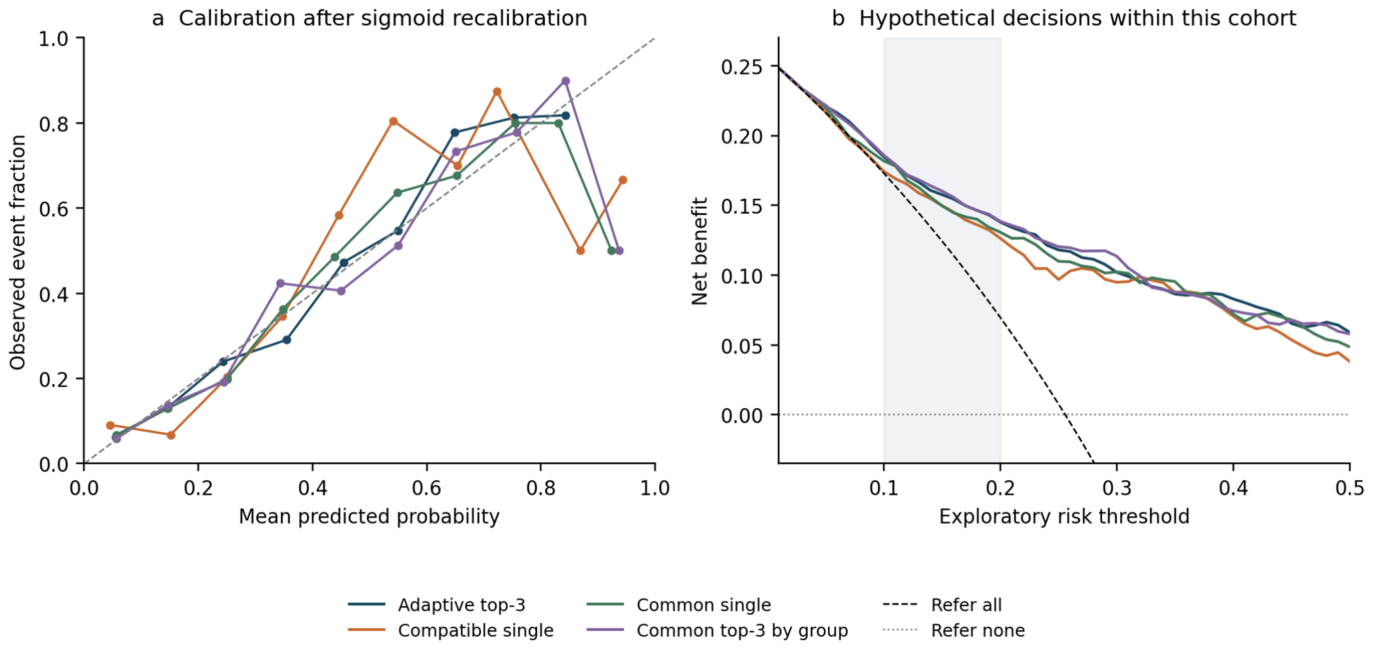
に示されています。特に、キャリブレーション済みの適応型トップ3モデルは、特定の閾値(例: 0.15)において、疾患陽性者の13.1%(29/221例)を見逃す一方で、閾値以下の対象者における陰性予測値は91.9%でした。これは、モデルが陽性の可能性が低いと判断した対象者においては、実際に疾患がない可能性が高いことを意味します。
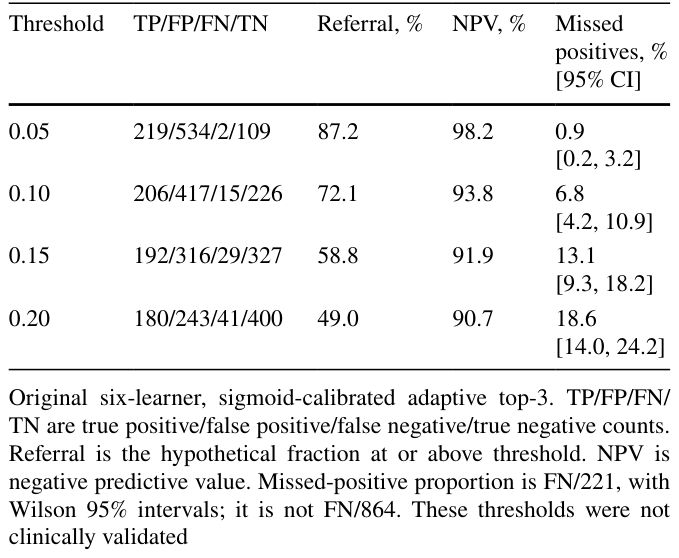
は、様々な閾値での予測結果のトレードオフを示しています。また、一致解析では、単一モデルの選択において検査値(採血データなど)を追加することがAUROCおよびBrierスコアの改善につながることが支持されました。一方、病歴データの追加による改善は不確実でした。
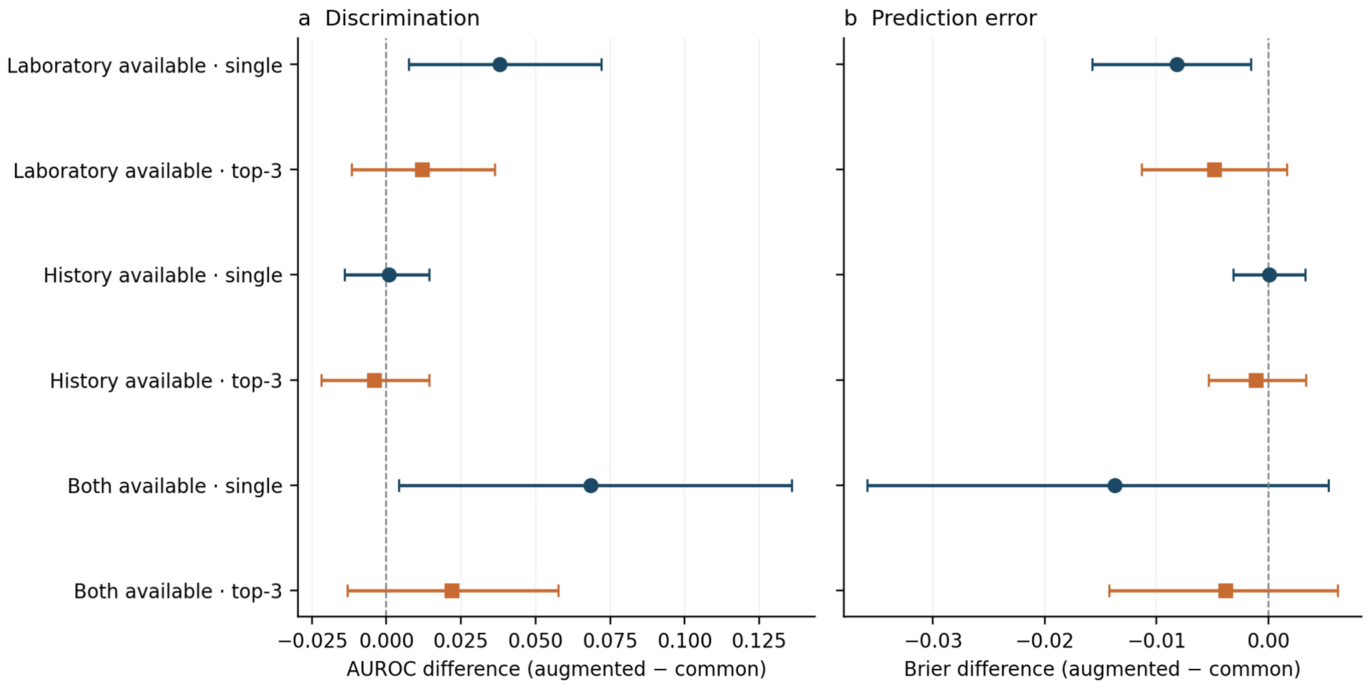
は、検査値および病歴の追加がAUROCとBrierスコアに与える影響を比較したものです。
研究の限界と今後の展望:実臨床導入への道
この有望な結果にもかかわらず、著者らはいくつかの研究の限界も指摘しています。まず、研究は単一施設から得られた健康診断のアーカイブデータに基づいており、対象者の選択に偏りがある可能性があります。また、過去のデータを使用しているため、CCTA検査の指示時における予測因子の可用性を厳密に検証することはできませんでした。これらの限界から、モデルが他の医療施設や異なるプロトコル、データ可用性のパターンにおいても同様の性能を発揮するかどうかは、外部検証が必要です。さらに、この予測モデルを実際に臨床で導入する際には、予測が実際の医療提供にどのような影響を与えるか、例えば、CCTAの依頼件数の変化、専門家による判断の上書き、下流の管理の変化などを前向きに評価する必要があります。著者らは、より単純なアンサンブルモデルやデータ補完モデルとの比較を続けることで、追加の入力データや可用性に応じたルーティングの真の価値を直接評価する必要があると述べています。
まとめ:データ活用でリスク評価をより賢く
健康診断データとたまたま撮影された低線量CT画像を組み合わせ、データの可用性の不均一性を考慮したAIモデルは、冠動脈疾患の重要な所見(CAD-RADSカテゴリー3以上)を予測する上で有効であることが示されました。特に、複数のモデルを組み合わせるアンサンブル学習のアプローチは、単一のモデルを選択する場合と比較して、予測性能(AUROCおよびBrierスコア)を改善する可能性があります。検査値データは一部のモデルの性能向上に貢献する一方で、病歴データの貢献はまだ不明確な点も残ります。この研究は、医療画像のインフォマティクス分野において、既存のデータを最大限に活用し、個々の対象者に合わせたより賢いリスク評価へと繋がる可能性を示唆しています。今後の外部検証と前向き評価を通じて、この技術が実臨床における意思決定支援ツールとして確立されることが期待されます。
補足図表
Figure 2
用語集
- CCTA (冠動脈CT血管造影): 冠動脈の狭窄や病変を非侵襲的に評価するために用いられる画像検査です。
- LDCT (低線量CT): 通常のCT検査よりも少ない放射線量で撮影されるCT検査で、健康診断などで機会的に行われることがあります。
- CAD-RADS (冠動脈疾患報告データシステム): 冠動脈CTの結果を標準化された形式で記述し、重症度を分類するための国際的なシステムです。
- アンサンブル学習: 複数の異なる機械学習モデルの予測を組み合わせることで、単一モデルよりも高い予測性能を目指す手法です。
- AUROC (ROC曲線下面積): 機械学習モデルの識別能力(陽性・陰性を区別する能力)を示す指標で、値が1に近いほど識別能力が高いことを意味します。
- Brierスコア: 予測確率と実際の結果との間の誤差を測る指標で、値が0に近いほど予測が正確であることを示します。
- キャリブレーション: モデルの予測確率が実際のイベント発生率とどの程度一致するかを調整するプロセスです。
- ネステッド交差検証: モデルのハイパーパラメータ選択と性能評価を厳密に行うための、入れ子構造になった交差検証法です。
コメントを残す