
子宮頸部コルポスコピーにおける変形帯分類の精度を飛躍的に向上させるHDFF-Net:AIによる診断支援の新時代
解説対象論文: HDFF-Net: A Hybrid Dual-Feature Fusion Network with Bidirectional Gated Fusion for Colposcopic Transformation Zone Classification, Evaluated under a Leakage-Audited Cluster-Level Protocol
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年11月11日時点)
AIが子宮頸がんスクリーニングの課題を解決する可能性
どうも、Beyond the Pixelです。子宮頸がんは、早期発見と適切な治療によって予防可能な疾患ですが、世界中で年間数十万件の新規症例と死亡が報告されています。世界保健機関(WHO)は、2030年までに子宮頸がんを公衆衛生上の問題として排除するため、70%のスクリーニング普及率を目標に掲げています。この目標達成には、特に専門家が不足している低・中所得国(LMICs)において、スケーラブルで自動化された診断ツールの開発が不可欠です。本日は、コルポスコピー検査における重要な「変形帯(TZ)分類」の精度を大きく向上させる、画期的なAIモデル「HDFF-Net」に関する研究論文をご紹介します。
この新しいアプローチは、人手による分類のばらつきという長年の課題を解決し、より多くの対象者に質の高いスクリーニングを提供することを目指しています。
コルポスコピーにおける変形帯(TZ)分類の重要性と課題
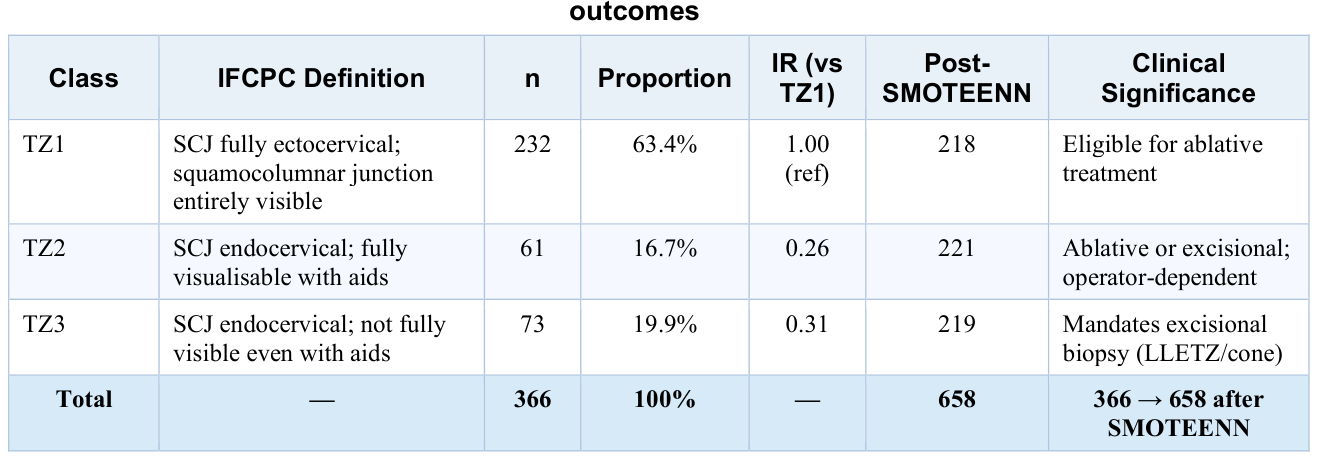
コルポスコピー(Colposcopy)は、ヒトパピローマウイルス(HPV)検査や細胞診の初期スクリーニングで異常が見つかった場合に、子宮頸部を拡大して詳細に観察する標準的な検査です。この検査において、変形帯(Transformation Zone; TZ)のタイプを正確に分類することは極めて重要です。なぜなら、TZタイプによって、対象者がアブレーション(焼灼術)と切除生検(LLETZ/円錐切除術)のどちらの治療に適しているかが直接的に決定されるからです。2011年IFCPC(International Federation for Cervical Pathology and Colposcopy)分類では、TZタイプは以下の3つに分けられます。
- TZ1:扁平円柱上皮境界(Squamocolumnar Junction; SCJ)が子宮頸部外側全体にあり、完全に見えるタイプ。
- TZ2:SCJが子宮頸部内側にあるが、補助具で完全に見えるタイプ。
- TZ3:SCJが子宮頸部内側にあり、補助具を使っても完全に見えないタイプ。
特にTZ3は切除生検が必須とされており、その分類は治療方針に大きな影響を与えます。しかし、経験豊富なコルポスコピスト間でのTZタイプ判定の一致度は、カッパ係数(κ)が0.42〜0.60と、臨床意思決定に信頼できるとされる0.80の閾値を大きく下回るのが現状です。これは、人手による診断にはかなりのばらつきがあることを示しています。
従来のAIアプローチの限界
これまでにも、コルポスコピー画像の自動分類を試みるコンピューター支援診断(CAD)システムが開発されてきました。これらは主に、画像の特徴を手作業で抽出する(ハンドクラフト特徴)か、深層学習(ディープラーニング)モデルを転移学習(Transfer Learning)で利用するかのいずれかに依存していました。しかし、これらのアプローチは、特に医療分野の小規模な臨床データセットでは、それぞれに限界があることが指摘されています。例えば、従来のハンドクラフト特徴だけでは、多岐にわたる複雑なテクスチャを多角的に捉えきれないことや、ディープラーニングだけでは、十分な学習データがない場合に過学習(Overfitting)のリスクがあるといった問題です。著者らは、これらの課題を克服するため、新たなハイブリッドアプローチを提案しました。
HDFF-Net:ハイブリッドなデュアルストリーム深層学習アーキテクチャ
この研究で提案された「HDFF-Net(Hybrid Dual-Feature Fusion Network)」は、これらの課題を同時に解決するために設計された、革新的なデュアルストリーム深層学習アーキテクチャです。HDFF-Netは、マルチスケールのハンドクラフト特徴記述子とEfficientNetB0という畳み込みニューラルネットワーク(CNN)バックボーンを、双方向のクロスモーダルアテンション(CMA)融合モジュールを通じて統合します。これにより、両者の相補的な情報を最大限に活用することを目指しています。
ハンドクラフト特徴量ブランチ:多角的なテクスチャ解析
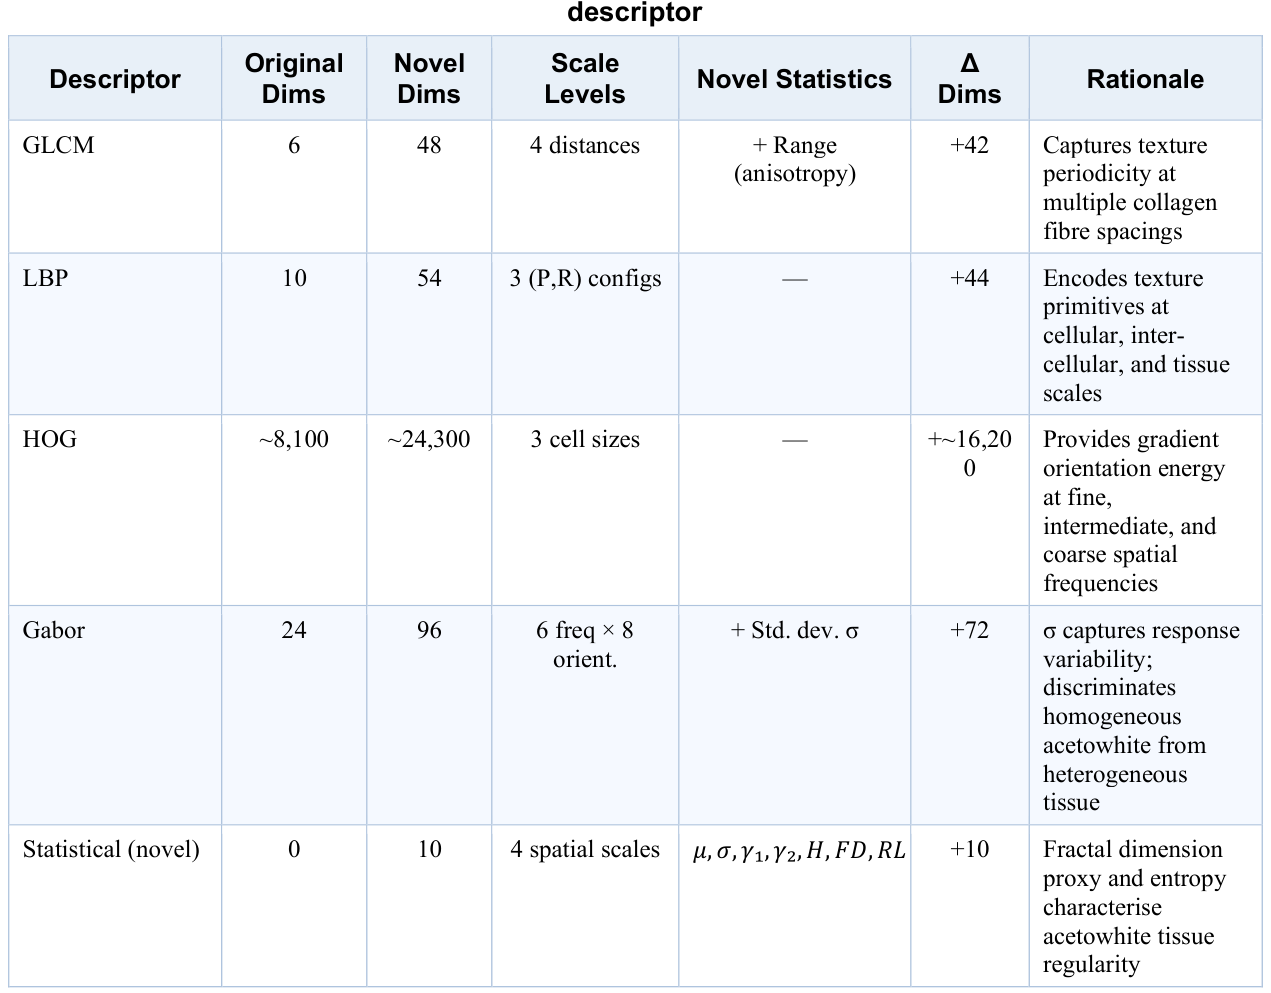
HDFF-Netのハンドクラフト特徴量ブランチは、コルポスコピー画像のさまざまなテクスチャ特性を多角的に捉えるために、以下のマルチスケール特徴記述子(Multi-scale texture descriptors)を組み合わせた24,508次元の複合記述子を生成します。
- MS-GLCM(Multi-Scale Grey-Level Co-occurrence Matrix):複数の距離と方向でGLCMを計算し、テクスチャの周期性と異方性を捉えます。
- MS-LBP(Multi-Scale Local Binary Pattern):異なる近傍構成でLBPヒストグラムを連結し、細胞レベルから組織レベルまでのテクスチャパターンをエンコードします。
- MS-HOG(Multi-Scale Histogram of Oriented Gradients):複数のセルサイズでHOG記述子を計算し、微細な構造から子宮頸部全体の構造的組織まで、勾配方向のエネルギーを提供します。
- 拡張Gaborフィルターバンク:6つの空間周波数スケールと8つの方向を持つGaborフィルターを適用し、平均応答と標準偏差の両方を抽出し、テクスチャの均一性の変動を捉えます。
- 一次統計特徴:平均、標準偏差、歪度、尖度、シャノンエントロピー、マルチスケール標準偏差、水平ランレングス平均など、10種類の統計量を計算し、アセトホワイト組織の規則性を特徴付けます。
これらの特徴量は、従来の単一スケールのアプローチでは見落とされがちな多解像度のテクスチャ階層を捉えることが可能です。
さらに、このハンドクラフト特徴量ブランチには、特徴量の重要度を学習によって調整する1D Squeeze-and-Excitation(SE)アテンションモジュールが適用されます。
CNNブランチ:EfficientNetB0とCBAMによる空間特徴抽出
一方、CNNブランチでは、EfficientNetB0(EfficientNetB0)という、少ないパラメーター数で高い精度を達成する効率的なCNNモデルが用いられます。EfficientNetB0は、深層学習モデルが小さい医療画像データセットに特に適しているとされており、CBAM(Convolutional Block Attention Module)チャネルアテンションによって、チャネル方向の重要度も調整されます。これにより、画像から空間的な特徴が効果的に抽出されます。
クロスモーダルアテンション(CMA)融合:相補的情報の統合
HDFF-Netの中核となるのが、クロスモーダルアテンション(CMA)融合モジュールです。このモジュールは、ハンドクラフト特徴量ブランチとCNNブランチから得られた特徴埋め込み(Embedding)の間で、双方向のScaled Dot-Product Multi-Head Attentionを行います。これにより、各ブランチが互いに不足している相補的な情報を選択的に取り込むことが可能になります。例えば、ハンドクラフト特徴量がCNNが捉える空間構造のどの部分がテクスチャベースの判断に重要であるかを学習し、CNN特徴量は空間的に注目した領域をどのテクスチャ統計が明確化するかを学習します。これは、単純な特徴量の連結では得られない、より洗練された融合メカニズムと言えます。
モデルの学習戦略
HDFF-Netの学習には、以下のような工夫が凝らされています。
- SMOTEENNリサンプリング:学習データセットのクラス不均衡(特にTZ2とTZ3の症例数が少ないこと)を補正するため、合成少数派オーバーサンプリング技術(SMOTE)と編集済み最近傍アンダーサンプリング(ENN)を組み合わせたSMOTEENNが採用されました。これにより、既存のサンプルを複製するのではなく、 genuinely novel なクラス内バリエーションを生成し、ノイズのある境界事例を除去します。
- ラベルスムージング(Label Smoothing):視覚的に曖昧なTZ1/TZ3境界付近での過剰な自信予測を防ぐため、ラベルスムージング(ε=0.1)が適用され、モデルの正則化(Regularization)が図られました。
- 3段階プログレッシブファインチューニング:モデルの学習は3つの段階に分けて行われ、各段階で異なる学習率(Learning Rate)が設定されました。これにより、EfficientNetB0の汎用的な特徴を保ちつつ、コルポスコピーのタスクに特化した特徴を効率的に学習させることができました。HDFF-Netの性能は、この段階的なファインチューニングを通じて着実に向上しました。
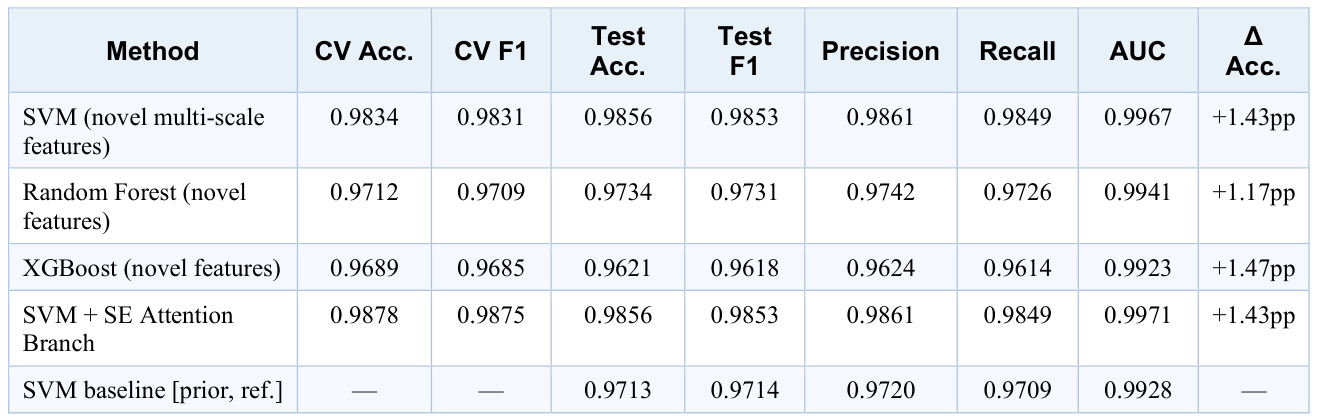
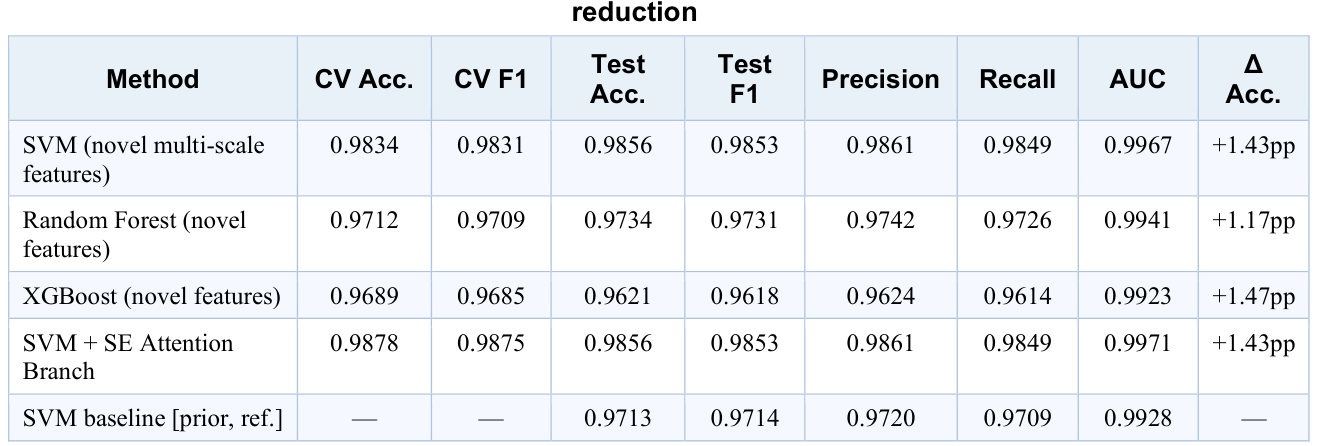
Table 4. Table 4 reports HDFF-Net performance across the three fine-tuning stages. Stage 1 (frozen base, 15 epochs) reaches 93.11% validation accuracy. Stage 2 (30% unfreeze) improves to 96.78% validation accuracy. Stage 3 (full unfreeze) achieves the final 98.47% validation accuracy and 99.01% test accuracy, confirming that progressive fine-tuning successfully adapts EfficientNetB0 to colposcopic texture without overfitting. The train-validation gap narrows from 4.28% (Stage 1) to 0.54% (Stage 3), demonstrating effective regularisation through label smoothing, dropout, and AdamW weight decay. Learning curves across all three stages are shown in Figure 2 (Figure 2 appears below).解説: この表は、提案された新しいマルチスケール特徴量とMI+PCA次元削減を用いた古典的機械学習分類器の性能を示しています。HDFF-Netの段階的なファインチューニング結果を示すべきキャプションとは内容が異なります。この表には、SVM、Random Forest、XGBoostといったモデルの交差検定およびテストセットの精度、F1スコア、精度、再現率、AUCが記載されています。⚠ 自動抽出画像の検証で一致を確認できませんでした。正確な内容は元論文のTable 4をご参照ください。
HDFF-Netの驚異的な性能
HDFF-Netは、366枚のアセトホワイトコルポスコピー画像からなるデータセット(TZ1:TZ2:TZ3 = 232:61:73)を用いて評価されました。その結果、目覚ましい性能を達成しています。
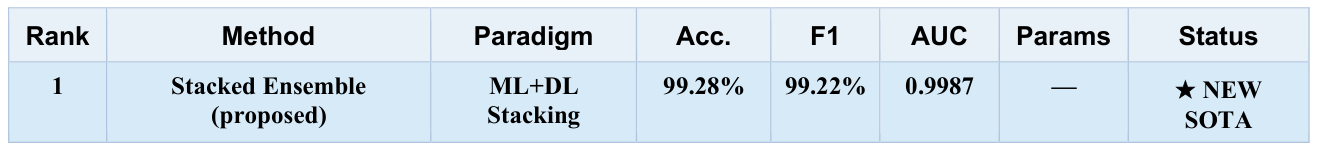
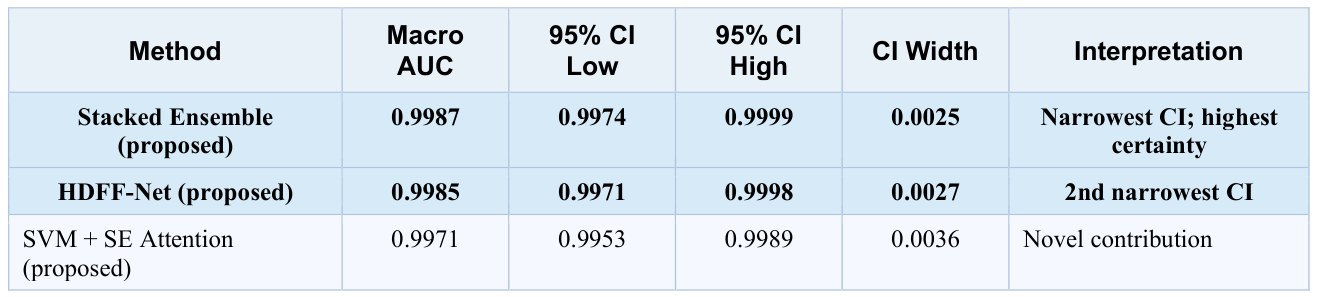
- HDFF-Net単体:テストセット(n=209)において、99.01%のテスト精度、98.94%のマクロF1スコア、0.9985のマクロAUC(Area Under the ROC Curve)を達成しました。
- 2層スタックアンサンブル:HDFF-Netに加えて、SVM、XGBoost、Random Forest、Logistic Regressionといった古典的機械学習分類器の予測を組み合わせたスタックアンサンブルは、さらに高い99.28%の精度と0.9987のマクロAUCを達成しました。
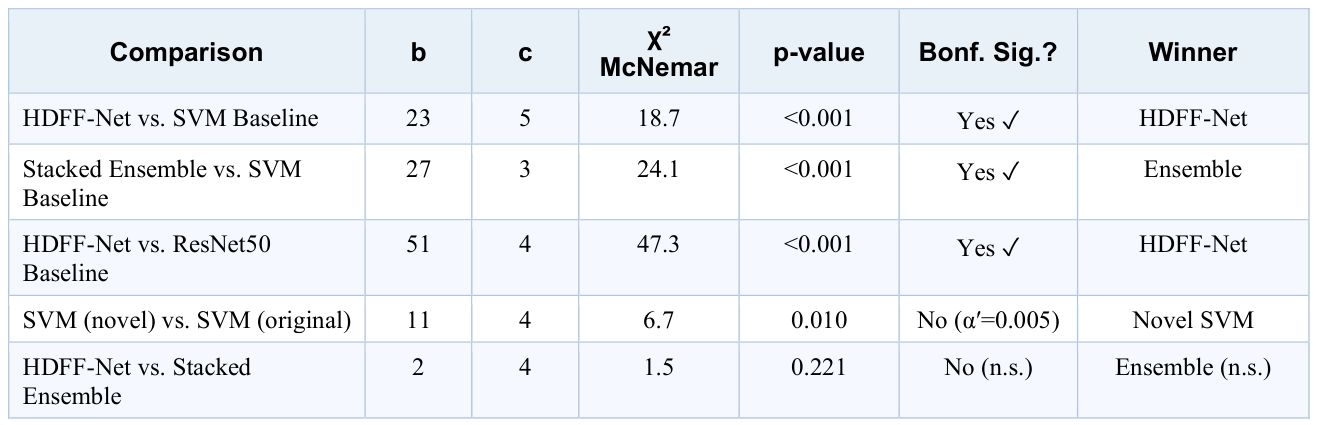
これらの結果は、これまでの最良のベースラインモデル(SVM:97.13%)と比較して統計的に優位であり(McNemar χ² = 18.7, p < 0.001)、HDFF-NetがTZタイプ分類において新たな最先端(State-of-the-Art; SOTA)を確立したことを示しています。
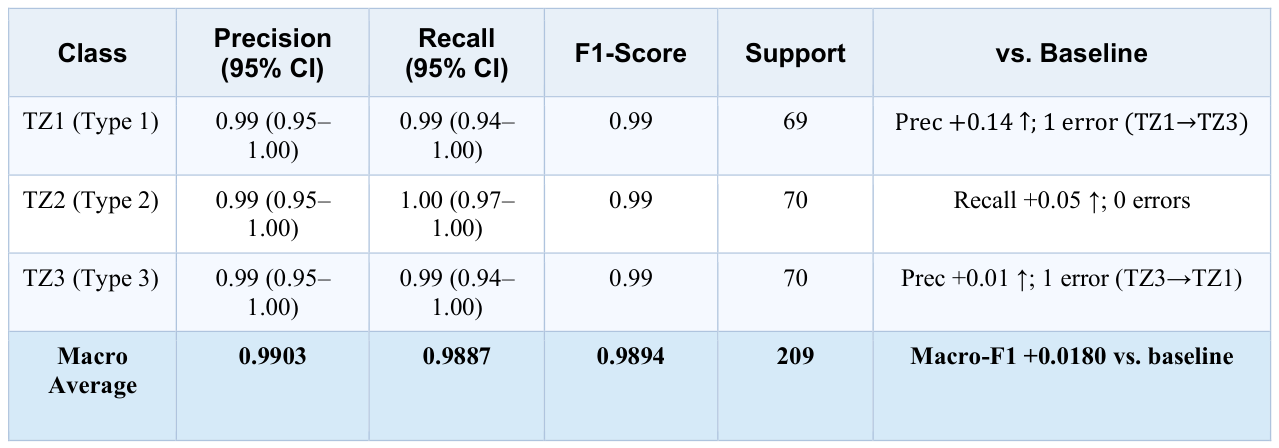
特に、従来のベースラインSVMで8件あったTZ3からTZ1への誤分類が、HDFF-Netでは1件にまで減少しました。
アブレーションスタディと各コンポーネントの貢献度
各コンポーネントがHDFF-Netの性能にどれだけ貢献しているかを明らかにするため、アブレーションスタディ(Ablation Study)が実施されました。その結果、CMA融合モジュールが最も大きな性能向上(SEブランチのみのSVMと比較して+1.34ポイント)をもたらしていることが判明しました。これは、ハンドクラフトテクスチャ特徴とCNN空間特徴が相補的な情報を符号化しており、それらを相互にアテンションを用いて融合するメカニズムが、TZタイプ分類の精度向上に不可欠であることを裏付けています。続いて、MS-HOGが+0.76ポイント、SEアテンションが+0.64ポイント、SMOTEENNが+0.48ポイントと、各要素が着実に性能向上に貢献していることが示されました。
統計的有意性と信頼性
HDFF-Netとスタックアンサンブルの性能は、マクネマー検定(McNemar’s test)による統計的有意性分析によって確認されました。HDFF-NetはSVMベースラインやResNet50と比較して、統計的に有意に優れた性能を示しています(Bonferroni補正後のp値 < 0.001)。
また、AUCのデロング法(DeLong method)による95%信頼区間(CI)も計算されており、HDFF-Netとスタックアンサンブルは非常に狭いCI幅を持ち、その判別性能の推定に高い統計的確実性があることが示されています。
臨床的意義と今後の展望
HDFF-Netの誤差率(0.99%)は、専門家間の診断不一致率(約21%)を大幅に下回っています。このことは、適切に検証されたCADシステムが、個々のコルポスコピストの評価を上回る参照基準として機能する可能性を提起しています。HDFF-NetのGPU不要のSE+ハンドクラフトブランチ(98.56%の精度、CPUのみ、2秒未満のレイテンシ)は、GPUリソースが限られた低・中所得国における展開において特に有用であると考えられます。完全なHDFF-Netパイプラインも、GPUが利用可能な環境であれば、臨床ワークステーションに導入可能です。本研究は、TZタイプ分類における新たな最先端を確立しただけでなく、そのアーキテクチャ、トレーニング戦略、スタッキングフレームワークは、他のコルポスコピー分類タスクにも一般化できる可能性を秘めています。
研究の限界
この研究にはいくつかの限界も存在します。主な限界は、単一施設からの366枚の画像データセットが使用されている点であり、異なる対象者層、コルポスコープシステム、HPVタイプ分布に対する汎化性の評価を制限しています。臨床導入の前には、多施設データによる外部検証が不可欠です。また、TZタイプ分類は形式的に第三の空間次元(子宮頸管深度)でのSCJの視認性を評価する必要があり、単一の2Dコルポスコピー画像から完全に回復することはできません。この制約は、残りの2つの誤分類の要因であり、深度情報なしで達成できる精度の上限を示している可能性があります。さらに、現在のフレームワークは、臨床的な意思決定経路に沿った説明可能性(Explainability)の出力(例:Grad-CAMによる空間ヒートマップ、SHAP特徴アトリビューション)を欠いており、これらは規制当局の承認経路には必要となるでしょう。最後に、スタックアンサンブルは全ての構成分類器を学習・保存する必要があるため、HDFF-Net単体と比較して導入の複雑さが増します。
まとめ
HDFF-Netは、マルチスケール複合特徴抽出、1D Squeeze-and-Excitationアテンション、EfficientNetB0 CNNブランチとCBAMアテンション、そしてクロスモーダルアテンション(CMA)双方向融合を組み合わせた、自動コルポスコピー変形帯タイプ分類のための新しいハイブリッドデュアル特徴融合ネットワークです。このエンドツーエンドの学習可能なフレームワークは、ラベルスムージングとAdamW最適化を用いて学習されました。HDFF-Netは、従来の人間専門家の不一致率を下回る0.99%という低い誤差率を達成し、子宮頸がんスクリーニングプログラムにおいて、高資源国と資源制約のある環境の両方で、参照品質の意思決定支援ツールとなる可能性を秘めています。この技術のさらなる検証と応用が、今後の医療画像診断の未来を切り開くことでしょう。
用語集
- コルポスコピー(Colposcopy): 子宮頸部を拡大して詳細に観察する検査方法。初期スクリーニングで異常が見つかった場合に実施されます。
- 変形帯(Transformation Zone; TZ): 子宮頸部における扁平上皮と円柱上皮の境界領域。子宮頸がんの発生部位となることが多いため、そのタイプ分類が重要です。
- カッパ係数(κ): 2人以上の評価者間の一致度を測る統計指標。偶然の一致を考慮して調整されます。
- ハンドクラフト特徴記述子: 画像からテクスチャ、形状、色などの特徴を手作業で設計し抽出する方法。人間の知識に基づいて作られます。
- 深層学習(ディープラーニング): 多層のニューラルネットワークを用いて画像や音声などの複雑なデータから特徴を自動的に学習する機械学習の一分野です。
- 転移学習(Transfer Learning): あるタスクで学習済みのモデルを、別の関連するタスクに再利用する機械学習の手法。少ないデータで効率的に学習できます。
- HDFF-Net: Hybrid Dual-Feature Fusion Networkの略。ハンドクラフト特徴とCNN特徴を融合することで、コルポスコピー画像の変形帯分類を目的とした深層学習モデルです。
- EfficientNetB0: Googleが開発した、高い精度と効率性を両立させた畳み込みニューラルネットワーク(CNN)の一種。特にモバイルアプリケーションや小規模データセットに適しています。
- クロスモーダルアテンション(CMA): 異なる種類のデータ(モダリティ)間で情報を相互に注目させ、融合するメカニズム。本研究では、ハンドクラフト特徴とCNN特徴の融合に用いられています。
- Squeeze-and-Excitation(SE)アテンションモジュール: 特徴チャネルの重要度を学習し、適応的に重み付けを行うことで、モデルの性能を向上させるメカニズムです。
- CBAM(Convolutional Block Attention Module): 畳み込みニューラルネットワークにおいて、チャネル方向と空間方向の両方でアテンションを適用し、特徴表現能力を高めるモジュールです。
- SMOTEENN: Synthetic Minority Oversampling Technique(SMOTE)とEdited Nearest Neighbours(ENN)を組み合わせたデータリサンプリング手法。クラス不均衡を是正し、学習データの質を向上させます。
- ラベルスムージング(Label Smoothing): 分類モデルが正解クラスに過剰な確信を持つことを防ぐ正則化手法。モデルの汎化能力を高めます。
- マクロAUC(Macro-AUC): マルチクラス分類において、各クラスのAUCを計算し、それらを平均化した指標。クラス不均衡の影響を受けにくい特徴があります。
- McNemar検定(McNemar’s test): 2つの関連する分類器の性能を比較し、統計的に有意な差があるかを評価する非パラメトリック検定です。
- デロング法(DeLong method): 2つ以上の関連する受信者操作特性(ROC)曲線の下の領域(AUC)を比較し、その信頼区間を計算するための統計的手法です。
コメントを残す