
小型言語モデルが拓く胸部X線レポートの未来:RadStructAgentの挑戦
解説対象論文: RadStructAgent: agentic structuring of free-text chest X-ray reports with small language models
International Journal of Computer Assisted Radiology and Surgery|被引用数: 0(2026年11月10日時点)
医療画像診断において、胸部X線レポートの作成は専門家にとって重要な業務です。しかし、その記述形式の多様性が、AIを活用した自動レポート生成の発展を阻む要因となっていました。この課題に対し、構造化されたレポート形式(SRRGスタイル)でのAI学習が有効であることが先行研究で示されています。本記事では、この構造化形式の有効性を大規模な多施設データで再検証し、さらにオープンソースの小型言語モデル(SLM)を用いて、自由記述形式のレポートを高品質な構造化レポートに変換する画期的なエージェントフレームワーク「RadStructAgent」の登場について深掘りします。
胸部X線レポートの課題とAIによる自動化の重要性
どうも、Beyond the Pixelです。医療画像診断において、胸部X線レポートの作成は専門家にとって重要な業務です。しかし、その記述形式の多様性が、AIを活用した自動レポート生成の発展を阻む要因となっていました。放射線レポートは施設によって用語、記述スタイル、文章構造、報告の好み、解剖学的構成が異なり、このばらつきがAIモデルのトレーニングと評価を複雑にしています。特に、自由記述形式でのAI学習は、モデルに無関係な言語的ばらつきを学習させ、解剖学的レベルでの評価を困難にするという問題がありました。この課題に対し、構造化されたレポート形式(SRRGスタイル:放射線レポートの所見を事前に定義された解剖学的領域に整理する手法)でのAI学習が有効であることが先行研究で示されています。SRRGは、所見を「肺と気道」「胸膜」「心血管」などの定義済み解剖学的セクションに整理し、より一貫性のある学習データと解剖学的に意識した評価を可能にします。本研究では、この構造化形式の有効性を大規模な多施設データで再検証し、さらにオープンソースの小型言語モデル(SLM:パラメータ数が比較的少ない言語モデルで、リソース効率の良い運用が可能)を用いて、自由記述形式のレポートを高品質な構造化レポートに変換する画期的なエージェントフレームワーク「RadStructAgent」の登場について深掘りします。
RadStructAgent:小型言語モデルによる胸部X線レポート構造化のエージェントフレームワーク
この研究では、自由記述形式の胸部X線レポートをSRRGスタイルの構造化レポートへ変換するためのエージェントフレームワーク、RadStructAgentを提案しています。これは、LLMベースのオーケストレーション(大規模言語モデルが複数のタスクやAIエージェントの協調を調整・管理すること)、ジャッジフィードバック(AI生成レポートの品質を評価し、改善のための具体的な指摘を行うフィードバック)、およびフィードバックに基づく修正を組み合わせることで、オープンソースのSLMの能力を強化します。
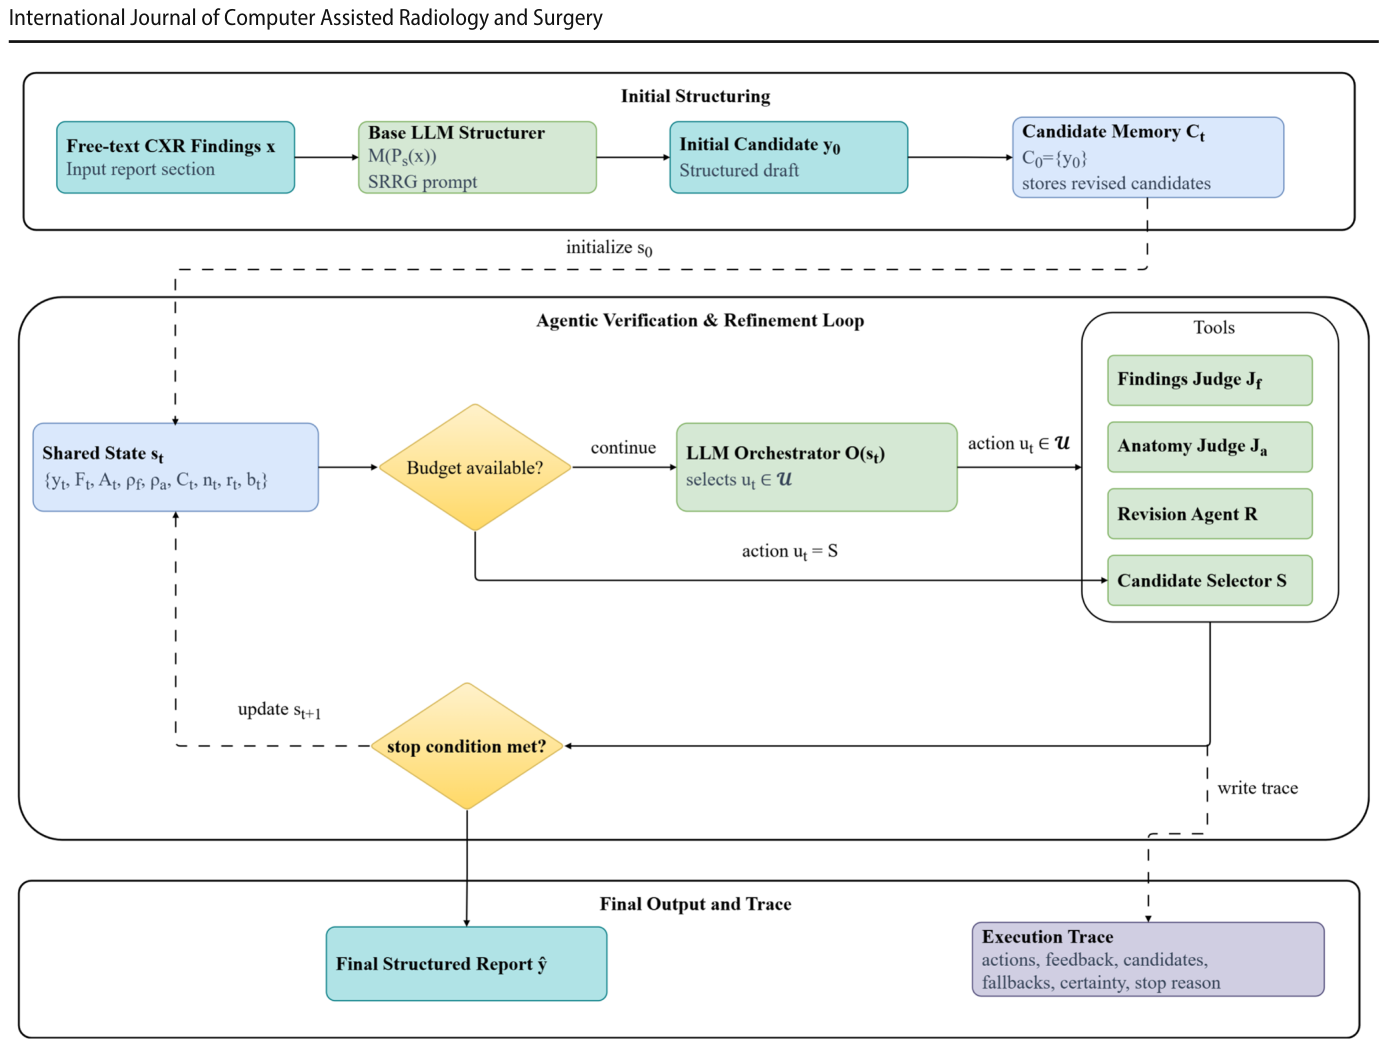
RadStructAgentの処理フローは、まず基盤となるLLM(大規模言語モデル)構造化モデルが入力された自由記述レポートから初期の構造化候補を生成します。この候補は、Lungs and Airways, Pleura, Cardiovascular, Hila and Mediastinum, Tubes, Catheters, and Support Devices, Musculoskeletal and Chest Wall, Abdominal, and Otherといった事前に定義された解剖学的セクションに所見を整理するよう促されます。次に、エージェントループが開始され、共有状態が現在の候補、ジャッジフィードバック、ツール呼び出し数、修正回数、残りの予算などの情報を保持します。LLMオーケストレーターは、この共有状態を読み取り、次に実行すべきアクション(所見ジャッジ、解剖学的ジャッジ、修正、候補選択、最終化など)を選択します。所見ジャッジは、構造化レポートが元の自由記述レポートの臨床内容を保持しているか(欠落した所見や、元のレポートにないにもかかわらず生成されたサポートされていない所見がないか)を評価します。一方、解剖学的ジャッジは、解剖学的配置と重複内容(誤ったセクションへの配置や、複数のセクションに重複して現れる所見がないか)を評価します。ジャッジからのフィードバックがある場合、フレームワークは逐次的に候補を修正します。まず所見レベルのフィードバックがあればそれを基に修正し、次に解剖学的レベルのフィードバックがあればそれを基に修正します。最終的に、候補選択器が記憶された候補の中から、元の自由記述レポートと最もよく一致する最適な構造化レポートを選択します。このループは、オーケストレーターが最終化を選択するか、最大ツール呼び出し数または修正予算に達するか、修正が空または変更のない候補を生成した場合に停止します。この逐次的な検証と洗練のプロセスを通じて、RadStructAgentはリソース効率が高く、オフラインでの処理やプライバシー保護が考慮された構造化レポートの準備に適したアプローチを提供します。この研究チームは、コード、プロンプトテンプレート、設定ファイルを公開しています。
大規模多施設設定での構造化監視の有効性検証
まず、この研究では、SRRGスタイルの構造化監視がVLMベースの胸部X線レポート生成に与える影響を、より大規模な多施設設定で検証しました。Qwen2.5-VL-3Bという視覚言語モデル(VLM:視覚情報とテキスト情報を統合して処理するAIモデル)を、10の異なる施設から収集された合計97,000の胸部X線画像とレポートのペアを用いて、自由記述形式とSRRGスタイルの構造化形式の両方で学習させました。結果として、構造化監視は自由記述監視と比較して、ほとんどの臨床評価指標を改善することが示されました。具体的には、主要な臨床的レポート品質指標であるGREEN(医療レポートの臨床的品質を評価するための主要な評価指標)が0.494から0.539に向上し、F1-SRR-BERTも0.489から0.533に、CRIMSONも0.447から0.457にそれぞれ改善しました。一方、RaTEScoreは0.608で変化がありませんでした。
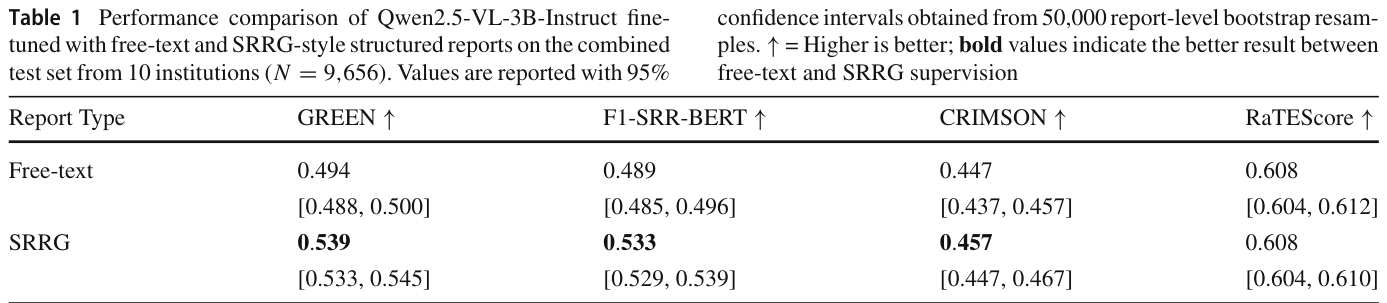
この改善は、
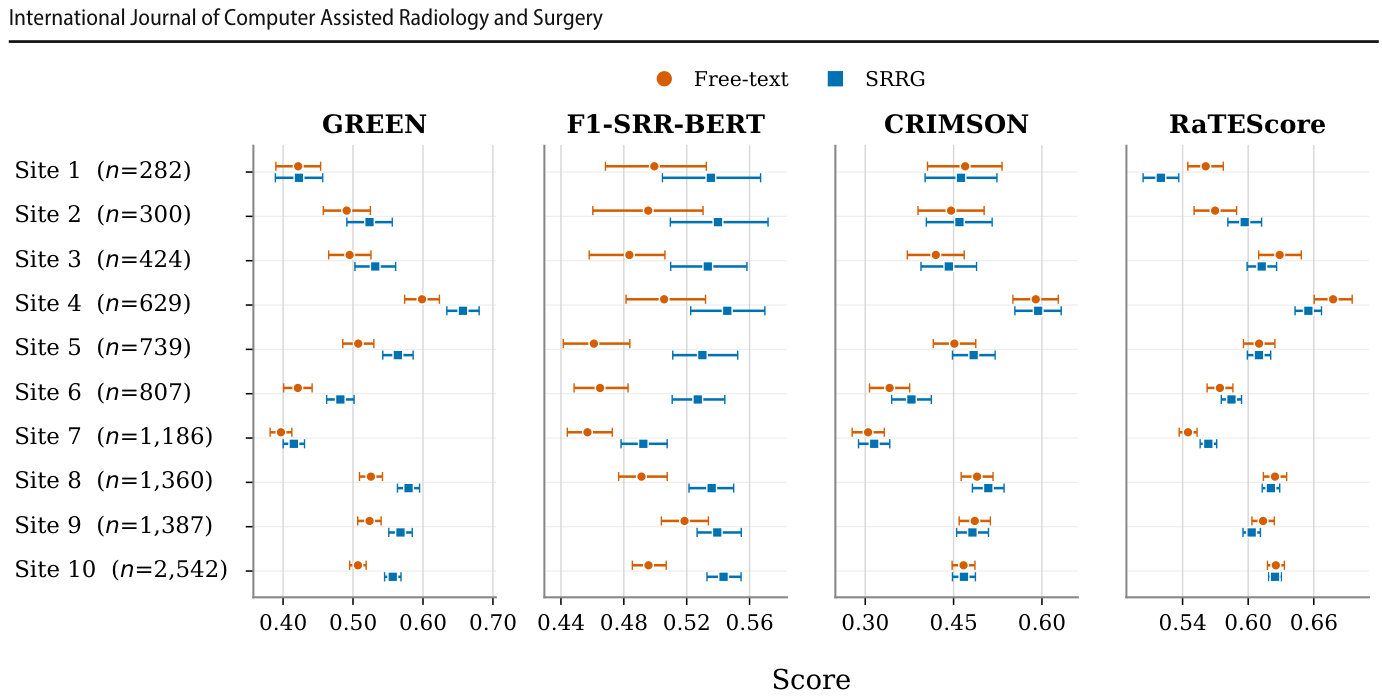
に示すように、GREENスコアにおいて10施設全てで一貫して見られ、SRRGスタイルの監視が、より安定した監視信号を提供することで、臨床レポートの精度を向上させる可能性を示唆しています。この結果は、より大規模な多施設環境においても、SRRGスタイルの構造化監視がVLMベースの胸部X線レポート生成に引き続き有効であることを裏付けています。このことから、スケーラブルな構造化データセット作成のために、自由記述から構造化レポートへの信頼性の高い変換が重要であるという動機付けが強化されました。
RadStructAgentによるレポート構造化性能の向上
次に、RadStructAgentが自由記述から構造化レポートへの変換においてどの程度の性能向上をもたらすかを評価しました。Qwen3-4BとQwen3-8Bという二つの小型言語モデル(SLM)を用いて、1,000件の自由記述胸部X線レポートを対象に、通常のシングルパス推論(単一の生成ステップでレポートを変換)とRadStructAgentを用いたエージェント推論の性能を比較しました。
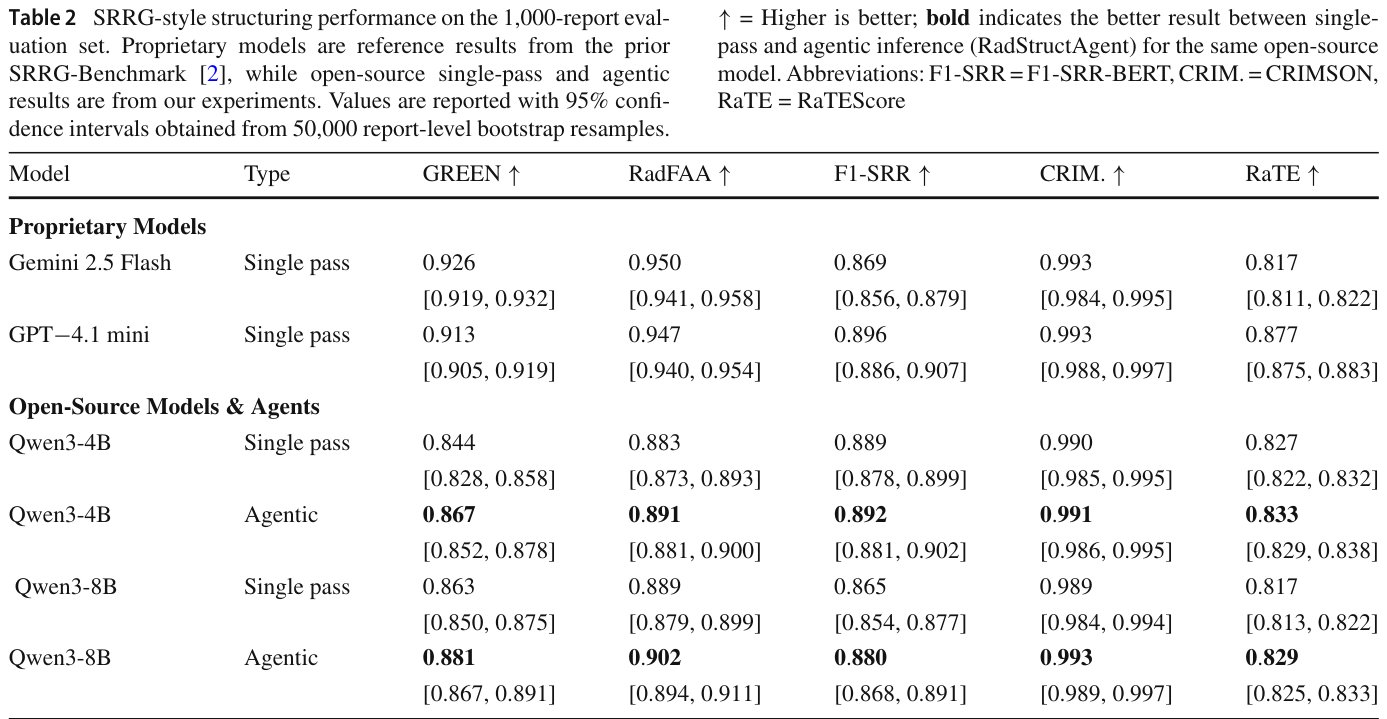
結果は、RadStructAgentがシングルパス推論に比べて、臨床的品質(GREEN)と解剖学的レベルの割り当て(RadFAA:解剖学的レベルでの所見の割り当ての正確さを評価するための指標)の両方で大幅な改善を示すことを明らかにしました。具体的には、Qwen3-4BではGREENが0.844から0.867に、RadFAAが0.883から0.891に向上しました。Qwen3-8Bでは、GREENが0.863から0.881に、RadFAAが0.889から0.902に向上しました。これらの数値は、RadStructAgentがより高い臨床的正確性(GREEN)と、所見が適切な構造化セクションに一貫して配置される能力(RadFAA)をもたらすことを示しています。オープンソースモデルは、一部の強力なプロプライエタリモデル(Gemini 2.5 FlashやGPT-4.1 miniなど)には及ばないものの、RadStructAgentはシングルパス推論の性能を改善し、そのギャップを縮めることに貢献しました。これは、RadStructAgentのエージェント的ワークフローが、欠落した所見、サポートされていない記述、重複した内容、不正確な解剖学的ラベルといったエラーを削減し、より一貫性のある構造化データセットの準備を支援することを示唆しています。
オーケストレーターの動作と実行時間のトレードオフ
RadStructAgentの洗練ループの動作を分析すると、
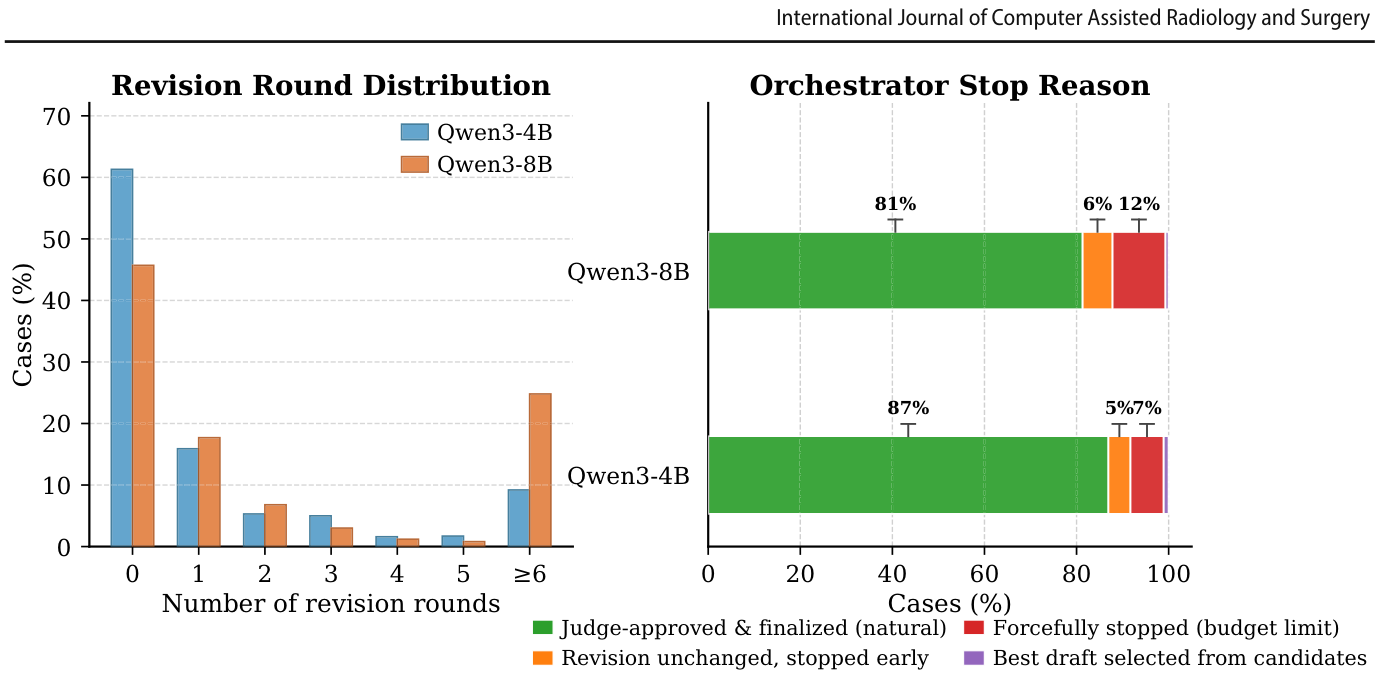
に示すように、ほとんどのレポートが少数の修正ラウンドしか必要としないことが分かります。これは、フレームワークが各ケースに応じて修正量を適応させていることを示しています。Qwen3-4Bのケースの87%、Qwen3-8Bのケースの81%は、ジャッジによって承認され最終化された「自然な」停止理由で終了しています。残りのケースは、修正が変更されなくなった場合、予算制限に達した場合、または候補メモリから最適な候補が選択された場合など、制御されたフォールバック経路を通じて終了します。
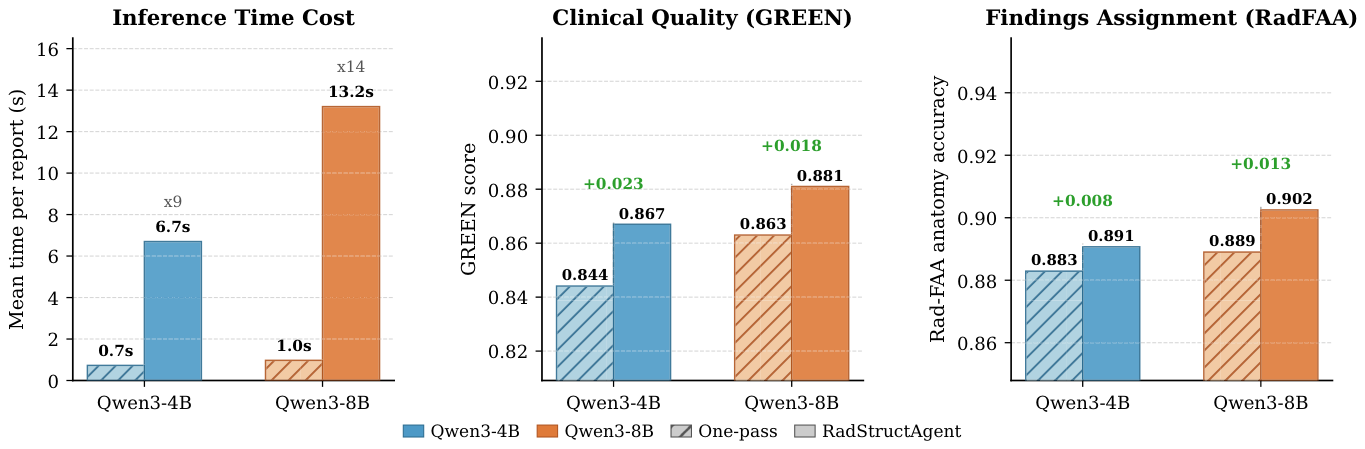
RadStructAgentの推論時間は、複数のLLM呼び出しのため、シングルパス推論に比べて増加します。Qwen3-4Bでは、レポートあたりの平均処理時間が0.7秒から6.7秒に増加し、約9倍になりました。Qwen3-8Bでは、平均処理時間が1.0秒から13.2秒に増加し、約14倍になりました。しかし、構造化レポートの準備は通常、一度限りのオフライン前処理ステップであるため、レポート品質と解剖学的整合性が向上するのであれば、この追加コストは許容できると考えられます。
RadStructAgentの構成要素と汎用性に関するアブレーション分析
RadStructAgentの各コンポーネントが性能にどのように貢献しているかを評価するために、段階的なアブレーション分析が行われました。
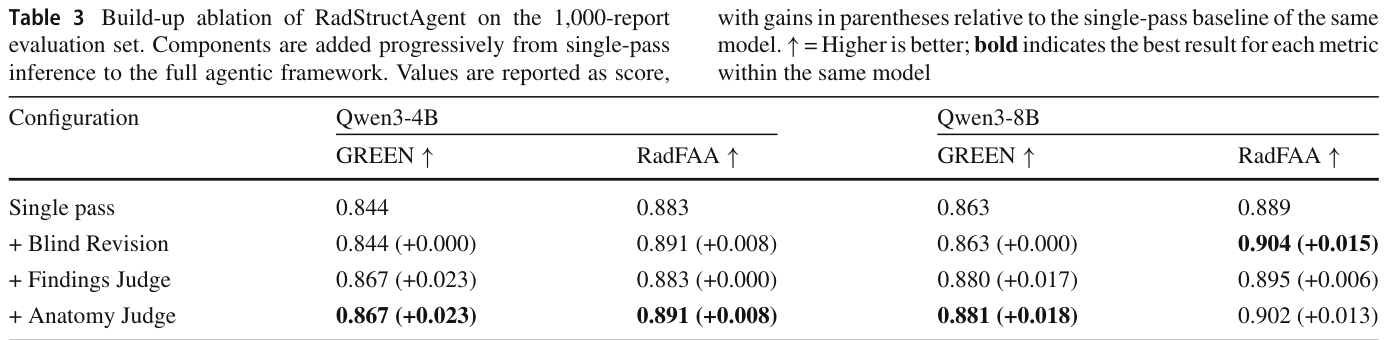
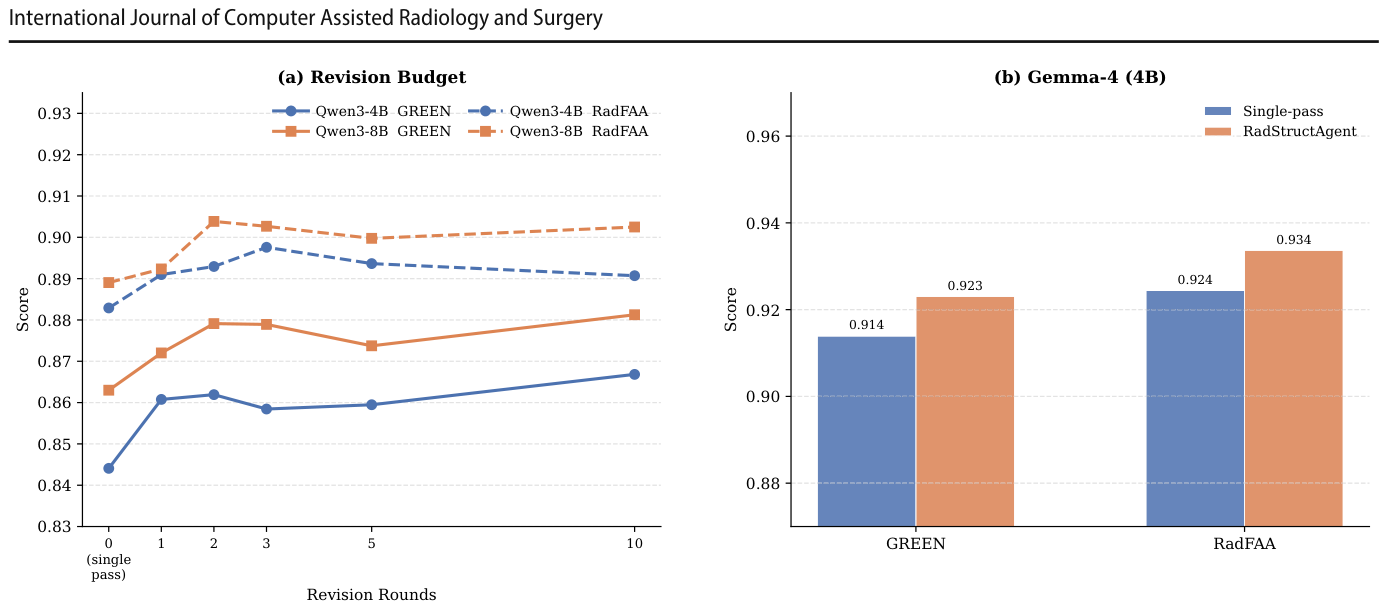
盲目的な修正(ジャッジフィードバックなしで修正ステップを適用)は、Qwen3-4BおよびQwen3-8Bの両モデルでGREENスコアに変化をもたらしませんでしたが、RadFAAスコアをQwen3-4Bで0.008、Qwen3-8Bで0.015向上させました。これに対し、所見ジャッジからのフィードバックを追加すると、主にGREENがQwen3-4Bで0.023、Qwen3-8Bで0.017改善しました。さらに、解剖学的ジャッジからのフィードバックを追加することで、RadFAAのさらなる改善が見られました。この結果は、所見レベルと解剖学的レベルのフィードバックが、反復的なワークフロー内で相補的な利点を提供することを示唆しています。また、{{FIGURE_5a}}に示すように、修正予算が性能に与える影響も分析されました。ほとんどの改善は初期の修正ラウンドで発生し、その後の追加ラウンドでは改善が小さくなる傾向が見られました。これは、性能と推論時間の間のトレードオフを示しており、修正予算によって計算コストを制御する実用的なメカニズムが提供されます。さらに、{{FIGURE_5b}}に示すように、Gemma-4-E4B-itという別のモデルファミリーでも同様の改善が見られました。これは、RadStructAgentのエージェント的洗練戦略がQwenモデルに限定されず、他のモデルファミリーにも汎用性があることを示唆しています。
研究の限界と今後の展望
RadStructAgentはオープンソースのSLMを用いたSRRGスタイルの構造化を改善しましたが、さらなる向上の可能性も残されています。本研究は自動評価指標に依存しており、LLM-as-a-judgeツールが所見を見落としたり、誤ってフラグを立てたりする可能性があります。また、単一の解剖学的ジャッジでは、曖昧な所見に対する正確な解剖学的割り当てを評価するのに限界があるかもしれません。今後の研究では、人間による専門家検証、ジャッジの信頼性分析の改善、プロンプト感度評価、解剖部位ごとのフィードバックジャッジ、適応的なツール呼び出し予算の導入、より広範な多施設での評価、および追加のモデルファミリーとサイズでの実験を含めるべきだと考えられます。さらに、すべてのモジュールで同じモデルを使用するのではなく、異なるSLMを異なるエージェントの役割に割り当てることも重要な方向性です。
まとめ
本研究では、VLMベースの胸部X線レポート生成におけるSRRGスタイルの構造化監視を、より大規模な多施設設定で検証し、その有効性を確認しました。さらに、オープンソースの小型言語モデル(SLM)を用いて、自由記述形式の胸部X線レポートをSRRGスタイルで構造化するエージェントフレームワーク「RadStructAgent」を導入しました。RadStructAgentは、シングルパス推論と比較して、臨床的レポート品質(GREEN)と解剖学的レベルの割り当て(RadFAA)の両方を向上させることが示されました。アブレーション分析は、提案されたフレームワークが相補的なジャッジフィードバックと逐次的な修正から恩恵を受けていることを示唆しており、単一のモデルファミリーに限定されない汎用性も確認されました。これらの発見は、エージェントによる検証と洗練が、オープンソースSLMを用いた自由記述レポート構造化の臨床的正確性を向上させることができることを示しています。RadStructAgentは、効率的かつプライバシーを保護しながら構造化レポートを準備するための、貴重なリソースとなるでしょう。
補足図表
Figure 5
用語集
- Vision-Language Model (VLM): 視覚情報とテキスト情報を統合して処理するAIモデル。
- Small Language Model (SLM): パラメータ数が比較的少ない言語モデルで、リソース効率の良い運用が可能。
- Structured Radiology Report Generation (SRRG): 放射線レポートの所見を事前に定義された解剖学的領域に整理する手法。
- Agentic Framework: LLMを基盤とし、計画、ツール使用、記憶、推論、フィードバックなどの多段階ワークフローを自律的に実行するAIシステム。
- LLMベースのオーケストレーション: 大規模言語モデル(LLM)が複数のタスクやAIエージェントの協調を調整・管理すること。
- ジャッジフィードバック: AI生成レポートの品質を評価し、改善のための具体的な指摘を行うフィードバック。
- GREEN: 医療レポートの臨床的品質を評価するための主要な評価指標。
- RadFAA: 解剖学的レベルでの所見の割り当ての正確さを評価するための指標。
コメントを残す