
脳腫瘍の精密画像診断を革新するEfficientGFormer:高速かつ高精度なAIモデル
解説対象論文: EfficientGFormer: Pruned spatial–semantic graph-transformer learning for multimodal brain tumor segmentation
Biomedical Signal Processing and Control|被引用数: 2(2026年11月5日時点)
脳腫瘍の正確な診断と治療計画には、MRI画像からの腫瘍領域の精密なセグメンテーション(領域分割)が不可欠です。しかし、腫瘍の多様な性質と、複雑な3Dボリュームデータを処理する際の高い計算コストが課題となっていました。今回ご紹介する「EfficientGFormer」は、これらの課題を克服するために開発された新しいAIアーキテクチャです。このモデルは、既存の高性能な基盤モデルとグラフベースの推論、そして効率化技術を組み合わせることで、リアルタイムでの正確な脳腫瘍セグメンテーションを実現します。
はじめに:脳腫瘍セグメンテーションの課題
どうも、Beyond the Pixelです。脳腫瘍の正確な診断と治療計画には、MRI画像からの腫瘍領域の精密なセグメンテーション(領域分割)が不可欠です。しかし、腫瘍の多様な性質(例えば、異なるサブリージョン間の境界の不明瞭さ)と、複雑な3Dボリュームデータを処理する際の高い計算コストが、長らく大きな課題となっていました。従来の深層学習モデル、特にTransformer(変換器)ベースのモデルは、長距離のコンテキストを捉える能力に優れていますが、密なボクセル表現に対するグローバルアテンションの利用は、トレーニングと推論の両方でスケーラビリティのボトルネックを引き起こしていました。さらに、これらのアーキテクチャはボリュームMRIを単なる生のテンソル入力として扱い、トポロジカルな構造的情報を十分に活用できていませんでした。一方で、Graph Neural Network (GNN: グラフニューラルネットワーク) は、医用画像における関係性構造をモデル化する有望な代替手段として浮上しましたが、モダリティの異質性を無視したり、きめ細やかなエッジの意味論を取り込めなかったりすることが、3Dセグメンテーションにおけるスケーラビリティと表現力を制限していました。本論文で提案されている「EfficientGFormer」は、これらの課題を克服するために開発された新しいハイブリッドAIアーキテクチャです。このモデルは、既存の高性能な基盤モデルとグラフベースの推論、そして効率化技術を組み合わせることで、リアルタイムでの正確な脳腫瘍セグメンテーションを実現します。このアプローチは、スケーラビリティ、解釈可能性、および汎化能力を兼ね備えた、臨床的に実行可能なソリューションを提供することを目指しています。
EfficientGFormerの革新的なアプローチ
EfficientGFormerは、マルチモーダルMRIデータを用いた脳腫瘍セグメンテーションを、高精度かつ計算効率良く行うために設計された独自のアーキテクチャです。このフレームワークは、ボリュームベースの基盤モデルとグラフベースの構造的推論を融合させ、さらに構造化された剪定メカニズムを導入することで、臨床現場でのリアルタイム展開を可能にしています。具体的には、以下の5つの主要なコンポーネントで構成されています。
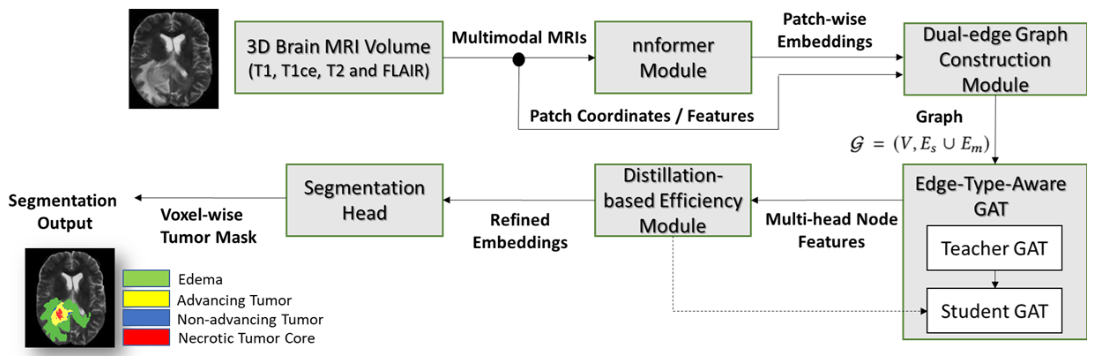
この図は、マルチモーダルMRI入力からボクセルレベルの腫瘍セグメンテーション出力に至るまでの、EfficientGFormerフレームワークの全体像を示しています。
基盤モデルエンコーダー「nnFormer」による特徴抽出
マルチモーダル脳MRIスキャンから高レベルの意味的表現を効果的に捉えるため、著者らは3D医用画像解析に特化して調整された最先端の3D Swin Transformer(変換器)アーキテクチャであるnnFormer(エヌエヌフォーマー)を採用しています。nnFormerは、非局所的でシフト不変なウィンドウ型Transformer設計内で階層的な自己アテンションメカニズムを活用することで、複数のベンチマークで優れた性能を発揮してきました。各対象者のデータセットには、T1強調画像、T1Gd(造影T1強調画像)、T2強調画像、FLAIR画像という4つの相補的なMRIシーケンスが含まれています。これらのモダリティは、浮腫、壊死性コア、増強性腫瘍といった多様な腫瘍サブリージョンを区別するために重要な、異なる組織コントラストプロファイルを提供します。特徴抽出に先立ち、全てのモダリティに対して、空間アライメント(共通の解剖学的空間への位置合わせ)、強度正規化(スキャナーによるばらつきを減らすためのゼロ平均・単位分散スケーリング)、リサンプリング(対象者間での空間的一貫性を確保するための均一なボクセル解像度化)といった標準的な前処理が施されます。その結果得られた3Dボリュームは、8 × 8 × 8 mm3の固定サイズで重複しないパッチ(断片)に細分化されます。各パッチは、事前に学習されたnnFormerエンコーダーを介して個別に処理され、局所的および文脈的な解剖学的情報の両方をカプセル化した密な特徴埋め込み(Embedding: データの特徴を数値で表現したもの)を出力します。これらの埋め込みは、後続のグラフベース推論モジュールで利用される初期ノード特徴となります。
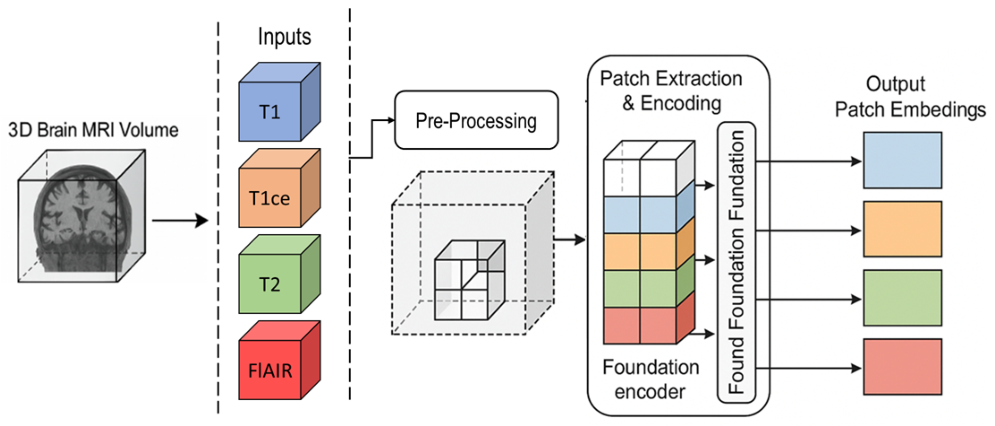
この図は、生のMRIデータから意味のある特徴空間への変換を担う基盤エンコーダーのパイプラインの概要を示しています。
空間的・意味的情報を捉える「デュアルエッジグラフ」
nnFormerエンコーダーによるパッチレベルの特徴抽出後、著者らは空間的および意味的コンテキストの関係性推論を可能にするため、構造化されたグラフG = (V, E) を構築します。形式的には、V = {v_i}^N_{i=1} はN個のノード(節点)の集合を表し、各ノードv_iは特徴埋め込みによって符号化された3D画像パッチに対応します。エッジ(辺)集合はE = E_s ∪ E_mと定義され、空間エッジE_sと意味的エッジE_mの両方を含みます。この段階の目的は、デュアルエッジ(二重エッジ)グラフという定式化を通じて、解剖学的近接性と外観に基づく類似性の両方を明示的にモデル化することで、各ノードの表現を豊かにすることです。空間エッジは、各ノードをユークリッド空間におけるk個の最近傍ノードに接続することで確立され、局所的な組織の連続性を保持します。対照的に、意味的エッジは、コサイン類似度に基づいて埋め込み空間で最も類似する上位k個のノードを特定することで構築され、非局所的でありながら特徴的に一貫した相互作用を可能にします。この異種混合グラフは、エッジタイプ情報で注釈付けされ、後続のエッジタイプ認識型グラフアテンションネットワークの基盤を形成します。
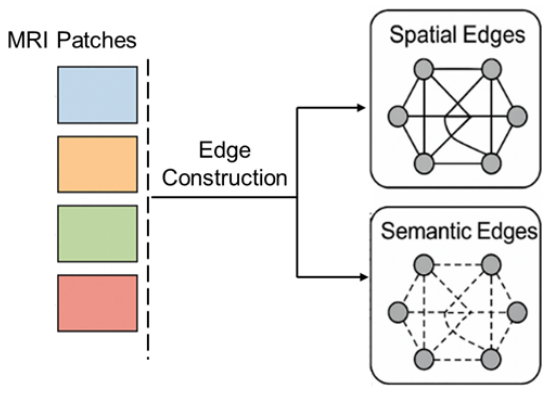
この図は、デュアルエッジの構築方法を示しています。各MRIパッチ(ノード)は、3D空間における近接性に基づく空間エッジと、特徴の類似性に基づく意味的エッジの2種類のエッジを通じて他のノードと接続され、下流の推論で用いられる異種混合グラフを形成します。
効率的な関係性推論を可能にする「剪定型GAT」
ボリュームMRIパッチ間で文脈情報を伝播させるため、著者らはデュアルエッジグラフG = (V, E_s ∪ E_m) 上で動作するGraph Attention Network (GAT: グラフアテンションネットワーク) を採用しています。この設計には、空間的相互作用と意味的相互作用を区別するためのエッジタイプ認識型アテンションが組み込まれており、さらにセグメンテーションの忠実性を保ちつつ計算量を削減するための構造化された剪定メカニズムが導入されています。エッジタイプ認識型アテンションにより、ネットワークはトポロジカルな隣接ノードと外観に基づく隣接ノードに対して異なる方法で注目(アテンション)することができます。多頭アテンション設定では、H個のヘッド(アテンション機構の並列インスタンス)の出力が平均または結合されますが、すべてのヘッドがパフォーマンスに均等に貢献するわけではありません。そこで、計算効率の高い推論を可能にするため、著者らはヘッドレベルの構造化された剪定手法を導入しています。各ヘッドの貢献度は、トレーニングセット全体での活性化エネルギーを通じて定義されます。トレーニング中に、エネルギーの低い下位p%のヘッドが剪定され、残りのヘッドが保持されます。これにより、推論時間とメモリ使用量を大幅に削減しながら、競争力のあるセグメンテーション精度を維持できることが実証されています。
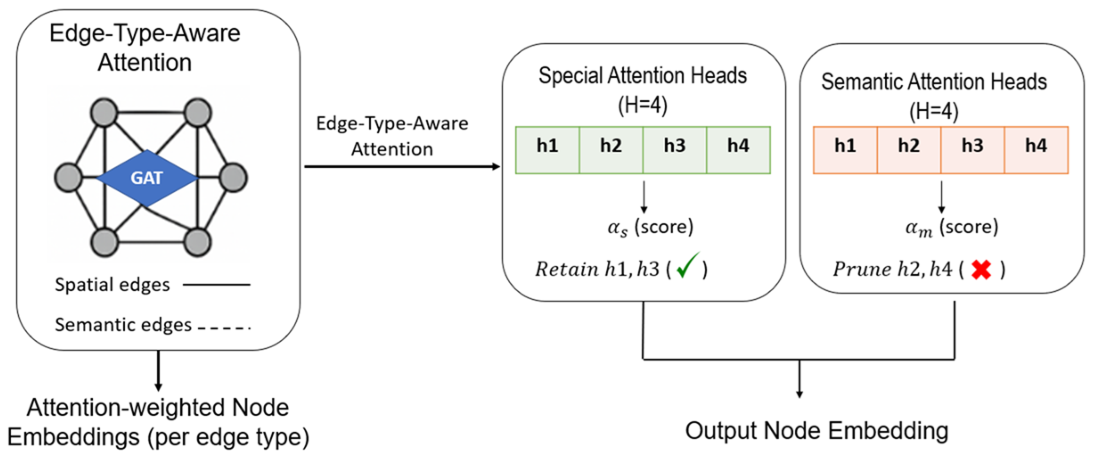
この図は、剪定されたエッジタイプ認識型グラフアテンションメカニズムの概要を簡潔に示しています。
リアルタイム推論を実現する「知識蒸留モジュール」
計算効率と汎化能力をさらに高めるため、著者らは高容量の教師モデルから剪定されたグラフベースの生徒ネットワークに意味的知識を転送する知識蒸留モジュールを導入しています。このプロセスにより、EfficientGFormerはフルモデルの表現力を維持しつつ、計算オーバーヘッドを大幅に削減して動作できるため、リアルタイムの臨床現場での展開が容易になります。教師モデルとして剪定されていないエッジタイプ認識型GATを、生徒ネットワークとして剪定されたGATを指定します。両ネットワークは同じ入力ノード特徴とデュアルエッジグラフ構造を共有しますが、構造化されたヘッド剪定によりアーキテクチャ容量が異なります。目標は、生徒モデルの出力分布を教師モデルの出力分布と一致させ、フル容量モデルが学習した関係性および文脈的情報(キュー)の転送を促進することです。蒸留損失は、ソフト化された出力分布間のカルバック・ライブラーダイバージェンス(KLダイバージェンス)として定義され、温度パラメータを用いて確率分布を平滑化します。高い温度は、生徒モデルが教師モデルによって符号化されたきめ細やかなクラス類似性を捉えることを促します。この手法により、パラメータ数、メモリ使用量、推論時間を大幅に削減しながら、フルモデルのセグメンテーション精度を維持できることが示されています。これにより、生徒モデルはリソースが限られた環境での展開に適したものとなります。
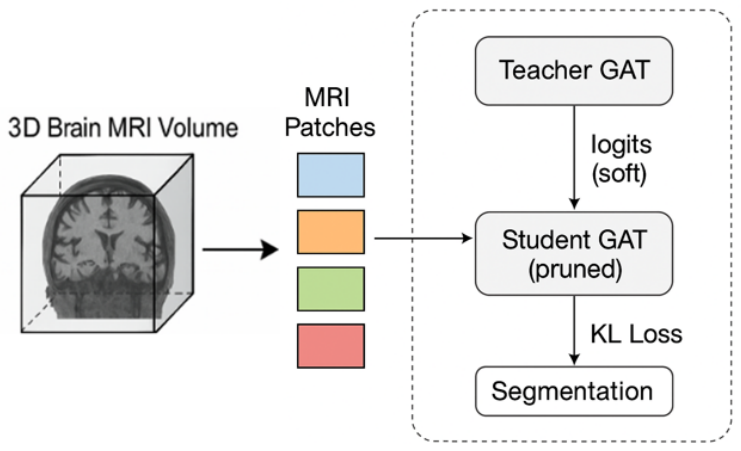
この図は、知識蒸留のプロセスの簡略図です。
精密な領域分割を実現する「セグメンテーションヘッド」
EfficientGFormerアーキテクチャの最終コンポーネントは、洗練されたノード埋め込みを密なボクセルレベルの腫瘍予測にマッピングする、軽量でありながら表現力豊かなセグメンテーションヘッドです。グラフ推論と剪定が実行された後、グラフG = (V, E) の各ノードv_iは、元のMRIボリューム内の3Dパッチを表すコンパクトで意味的に豊かな特徴ベクトルz_i ∈ R^dを持ちます。ボリュームセグメンテーションマップを再構築するため、まずノードレベルの埋め込みを対応する空間位置に再編成します。これは、パッチの逆マッピングを通じて行われ、パッチ単位の特徴を元の解像度空間に復元します。これらの表現はその後、畳み込みデコーダーを介して渡されます。デコーダーは、バッチ正規化とReLU活性化を備えた一連の3D畳み込み層、フル解像度を復元するための段階的なアップサンプリングブロック、およびC個のセグメンテーションクラス(全腫瘍(WT)、腫瘍コア(TC)、増強性腫瘍(ET)、および背景)に対するボクセル単位のソフトマックス確率マップを生成する最終的な1 × 1 × 1畳み込み層で構成されます。予測されたセグメンテーションボリュームˆYは、Dice損失L_Diceと交差エントロピー損失L_CEを組み合わせた複合損失関数を用いて最適化されます。このデュアルロス設定は、領域レベルの精度と境界の鮮明さの両方を保証します。これは、腫瘍サブリージョンを区別するような臨床シナリオで極めて重要です。表現学習とセグメンテーションデコーディングを分離し、効率的な教師付き学習を強制することで、このヘッドモジュールは、計算上軽量でありながら、正確でクラス識別の高い予測を保証します。
驚くべき性能と効率性
EfficientGFormerの性能は、Medical Segmentation Decathlon (MSD) Task01: Brain TumorデータセットとBraTS 2021データセットを用いて評価されました。これらのデータセットは、神経膠腫の対象者からのマルチモーダル3D MRIスキャンを含み、増強性腫瘍 (ET)、腫瘍コア (TC)、全腫瘍 (WT) の3つのサブリージョンについて注釈が付けられています。評価指標として、Dice Similarity Coefficient (DSC: ダイス類似度係数) と95パーセンタイルHausdorff Distance (HD95: 95パーセンタイルハウスドルフ距離) が用いられました。効率性評価では、モデルのパラメータ数、浮動小数点演算数 (FLOPs: フロップス)、およびボリュームあたりの推論時間が報告されています。
既存モデルを凌駕するセグメンテーション精度
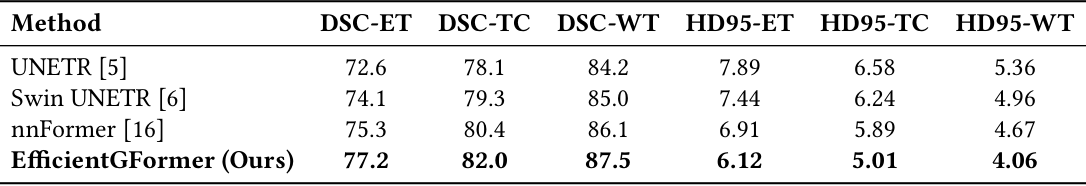
EfficientGFormerは、TransformerベースのUNETRやSwin UNETR、nnFormer、さらにはグラフベースのDGRUnit、MCTSeg、GDacFormerといった最先端のモデル群と比較して評価されました。その結果、EfficientGFormerは、増強性腫瘍(ET)、腫瘍コア(TC)、全腫瘍(WT)の全ての腫瘍サブリージョンにおいて、一貫して最高のDice類似度係数(DSC)と最低の95%ハウスドルフ距離(HD95)を達成しました。
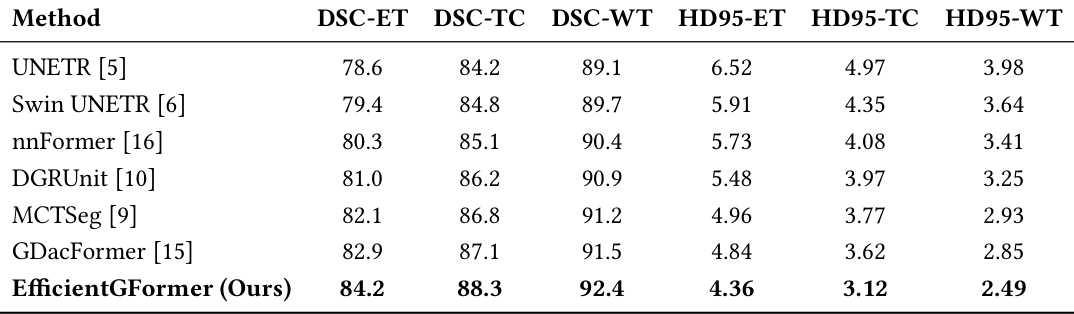
この表は、MSD Task01脳腫瘍データセットにおけるセグメンテーション性能の比較を示しており、EfficientGFormerが既存の手法を上回る結果を達成していることがわかります。特に、提案手法におけるデュアルエッジグラフ推論と、剪定を考慮した知識蒸留モジュールの統合が、複雑な腫瘍境界の正確な識別において優れた性能をもたらしています。
各モジュールの寄与を明らかにするアブレーション研究
EfficientGFormerフレームワークの各コンポーネントの寄与を理解するため、著者らはアブレーション研究(特定の一部を取り除いたり変更したりする実験)を実施しました。これにより、各モジュールが全体のパフォーマンスにどのように貢献しているかを分析しました。具体的には、「デュアルエッジグラフなし」、「エッジタイプ認識なし(バニラGATを使用)」、「知識蒸留モジュールなし(教師モデルのみを使用)」、「浅いCNNエンコーダー(nnFormerバックボーンを置き換え)」の各バリアントが評価されました。
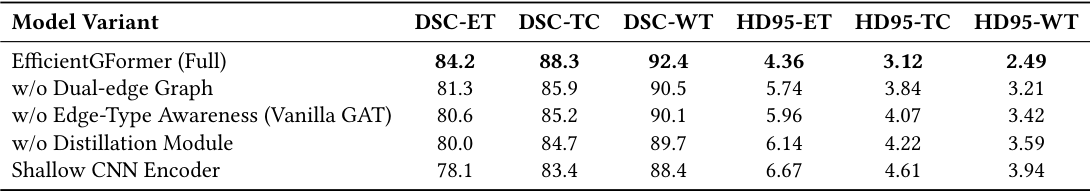
この表は、アブレーション研究の結果をまとめたもので、いずれの主要モジュールを削除してもDSCとHD95の両方で性能が著しく低下することが示されており、それらの必要性が強調されています。特に、デュアルエッジグラフの導入はセグメンテーション精度を大幅に向上させ、エッジタイプ認識アテンションは、増強性腫瘍のような異種サブリージョンのDiceスコアをさらに改善しました。また、知識蒸留と組み合わせた剪定メカニズムは、モデルの複雑さを大幅に削減しつつ高い性能を維持できることを示し、生徒モデルが教師の表現力を効果的に継承していることを証明しています。nnFormerエンコーダーを単純なUNetバックボーンに置き換えると、性能が大幅に低下し、豊富なボリューム理解のための事前学習済み基盤モデルの重要性が浮き彫りになりました。これらの知見は、各コンポーネントがセグメンテーション品質の向上に貢献するだけでなく、フレームワークが正確かつリアルタイムの臨床現場で展開可能であるという目標にも寄与していることを検証しています。
ドメインシフトに強い汎化能力
EfficientGFormerの堅牢性とドメイン汎化能力を評価するため、著者らはBraTS 2021データセットを用いたクロスデータセット転送実験を実施しました。このデータセットは、スキャナー構成と対象者コホートの両方でMSDデータセットとは異なるため、現実世界での適用可能性を評価するための意味のあるテストベッドとなります。MSD Task01脳腫瘍データセットで学習されたモデルを、ファインチューニングなしでBraTS 2021検証セットに直接適用した結果、EfficientGFormerはドメインシフトにもかかわらず、腫瘍サブリージョン全体で高いセグメンテーション精度を維持し、nnFormerやSwin UNETRといった最先端のベースラインモデルを著しく上回る性能を示しました。
この表は、BraTS 2021データセットに対するクロスデータセット汎化結果(ファインチューニングなし)をまとめたものです。この結果は、EfficientGFormerのアーキテクチャ設計、特にモダリティ認識型エンコーディングとグラフ構造化推論の融合が、優れた分布外汎化を可能にすることを示しており、これは複数の施設での臨床展開において極めて重要となります。
臨床現場で求められるリアルタイム処理能力
最先端のセグメンテーション性能を達成することは重要ですが、深層学習モデルの現実世界での展開、特に臨床現場では、計算効率への配慮が不可欠です。そこで、著者らはEfficientGFormerのリソースフットプリント(モデルサイズ、浮動小数点演算数、推論レイテンシ)を分析しました。
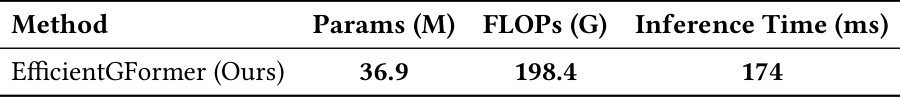
この表は、EfficientGFormerの効率性プロファイルをまとめたものです。EfficientGFormerはわずか36.9百万のパラメータを含み、推論あたり198.4 GFLOPsしか必要とせず、計算コストとセグメンテーション精度との間で好ましいトレードオフを示しています。最も注目すべきは、モデルがリアルタイムに近い推論速度(1ボリュームあたり約174ミリ秒)を達成しており、これは一般的なTransformerベースのセグメンテーションモデルよりも大幅に高速であるということです。EfficientGFormerの設計は、以下の3つのコアメカニズムを通じて計算上の節約を意図的に重視しています。(1) 全ボリュームアテンションをスパースなデュアルエッジグラフ推論に置き換えること、(2) エッジタイプとアテンションヘッドの構造化された剪定、(3) フル容量の教師モデルを軽量な生徒モデルに圧縮する知識蒸留モジュール。これらの結果、EfficientGFormerは精度において先行モデルを上回るだけでなく、リソースが制約された、あるいは時間的制約のある臨床環境での展開に対する準備も整っていることを示しています。
まとめと今後の展望
著者らは、基盤モデルエンコーディング、グラフベースの関係性推論、軽量モデル圧縮を相乗的に統合した、マルチモーダル脳腫瘍セグメンテーションのための統一された効率的なフレームワーク「EfficientGFormer」を導入しました。このアーキテクチャは、3D MRIボリューム全体で空間的および意味的関係性の両方を捉えるためにデュアルエッジグラフ構築を採用し、効率的な文脈的推論のために剪定されたエッジタイプ認識型GATを利用しています。知識蒸留を通じて、EfficientGFormerは最先端の精度を維持しつつリアルタイム推論を達成します。本研究は脳腫瘍データセットにおけるフレームワークの有効性を示していますが、EfficientGFormerのモジュール設計により、神経腫瘍学以外の幅広いボリュームセグメンテーションタスクや画像モダリティにも容易に適応可能です。そのグラフベースの推論とTransformerエンコーディングは、CT、PET、超音波データを用いた腹部、胸部、全身画像における複雑な解剖学的構造にも汎化できる可能性があります。さらに、デュアルエッジグラフの定式化は、多様な組織トポロジーや臓器間の関係性を符号化できる柔軟な事前情報を提供します。今後の研究では、EfficientGFormerを、ドメインシフトやアノテーションの異質性がさらなる課題となる多施設データセットにおける多臓器セグメンテーションタスクに拡張する予定です。また、限られた教師付き学習の下での汎化を強化するために自己教師あり学習戦略を組み込むこと、および対象者固有の解剖学的事前情報に基づいた動的なグラフ構築方法を調査することも目指しています。さらに、携帯型画像診断システムや術中リアルタイムガイダンスプラットフォームなど、リソースの少ない臨床環境でのフレームワークの展開を最適化し、アルゴリズムの革新とベッドサイドでの適用可能性との間のギャップを埋めることを意図しています。
用語集
- セグメンテーション: 画像の中から特定の領域(ここでは脳腫瘍)を画素レベルで正確に区別・分割する処理。
- Transformer(変換器): 自然言語処理分野で成功を収めた、長距離の依存関係を捉えるのに優れた深層学習モデル。
- Graph Neural Network (GNN: グラフニューラルネットワーク): グラフ構造のデータ(ノードとエッジで構成)を直接処理し、ノード間の関係性やグラフ全体の特性を学習する深層学習モデル。
- nnFormer: 3D医用画像解析に特化して設計された、最先端のSwin Transformerベースのアーキテクチャ。
- マルチモーダルMRI: T1、T1ce(造影)、T2、FLAIRなど、異なる撮像シーケンスで取得された複数のMRI画像データ。それぞれ異なる組織特性を強調する。
- パッチ: 3Dボリューム画像データを、処理しやすいように小さなブロック(断片)に分割したもの。
- 埋め込み(Embedding): 高次元のデータを、より低次元のベクトル空間に変換して表現したもの。これにより、類似したデータは空間的に近くに配置される。
- デュアルエッジグラフ(二重エッジグラフ): 空間的な近接性(隣接関係)と、意味的な類似性(特徴の似ている度合い)という2種類の異なるエッジ(辺)を持つグラフ構造。
- Graph Attention Network (GAT: グラフアテンションネットワーク): グラフ上の各ノードが、その隣接ノードからどれだけ情報を「注目」すべきかを学習することで、ノードの特徴表現を更新するGNNの一種。
- 知識蒸留(Knowledge Distillation): 大規模で高性能な「教師モデル」の知識を、よりコンパクトな「生徒モデル」に転送する技術。これにより、生徒モデルは計算コストを抑えつつ高い性能を維持できる。
- Dice Similarity Coefficient (DSC: ダイス類似度係数): 2つの領域(例えばAIの予測とゴールデンスタンダード)がどれだけ重なっているかを示す指標。高いほど正確なセグメンテーションを意味する。
- 95th percentile Hausdorff Distance (HD95: 95パーセンタイルハウスドルフ距離): 2つの領域の境界がどれだけ近いかを示す指標。低いほど境界の精度が高いことを意味する。
- FLOPs (Floating Point Operations: 浮動小数点演算): モデルが計算を行う際に必要な演算回数の合計。計算負荷の指標となる。
コメントを残す