
DINOv3-SAMによる医療画像分類:セマンティックと解剖学的情報の融合
解説対象論文: DINOv3–SAM: Fusing Semantic and Anatomical Foundation Models for Robust Medical Image Classification
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年11月4日時点)
医療画像診断におけるAIの活用は、専門家の業務負担軽減と診断精度の向上に貢献する可能性を秘めています。しかし、多様な画像取得プロトコル、ラベルの不完全性、そして疾患の微妙な差異が、堅牢な画像分類モデルの開発を困難にしてきました。本記事では、最新のオープンアクセス論文「DINOv3–SAM: Fusing Semantic and Anatomical Foundation Models for Robust Medical Image Classification」で提案された新しいフレームワーク「DINOv3-SAM」に焦点を当て、医療画像分類における課題を克服し、どのようにしてより信頼性の高い診断支援システムを構築できるかを探ります。
医療画像分類の現状と課題
どうも、Beyond the Pixelです。医療画像の正確な分類は、診断支援において極めて重要ですが、その実現には多くの課題が伴います。例えば、画像取得プロトコル(撮影方法や機器)の多様性、アノテーション(ラベル付け)におけるノイズ、そして疾患クラス間の微妙な差異などが挙げられます。特に胸部X線撮影においては、解剖学的な構造とは無関係なアーティファクト(ノイズや影など)や、撮影時の体位による投影のばらつきが、モデルの汎化性能(未知のデータへの適応能力)を著しく低下させる原因となります。
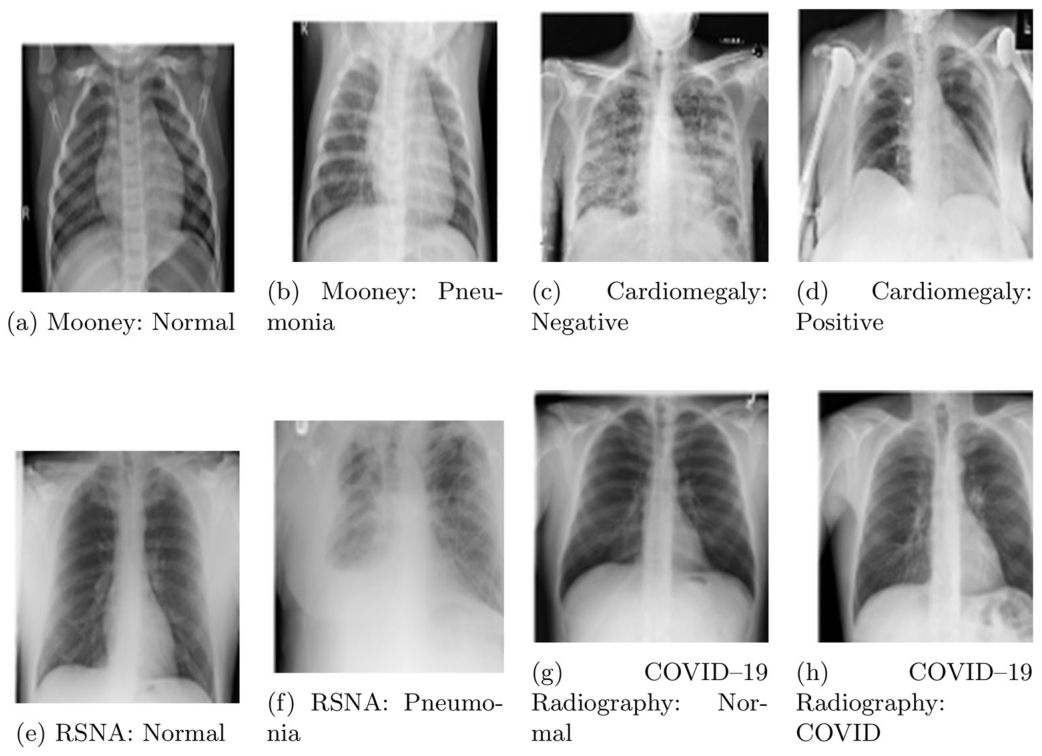
このような状況下で、従来の深層学習モデルである畳み込みニューラルネットワーク(CNN)やビジョントランスフォーマー(ViT)は、それぞれ局所的なパターン抽出や長距離の依存関係のモデリングに強みを持つものの、固有の限界を抱えていました。CNNは局所性バイアスによりグローバルな文脈の把握が苦手であり、ViTは大量の注釈付きデータが必要で、ドメインシフト(学習データと異なる分布のデータ)に敏感であるという課題があります。
基盤モデルの台頭とDINOv3-SAMの提案
近年、基盤モデル(大規模なデータで事前学習され、多様なタスクに応用可能なモデル)の進展は、医療画像解析に新たな可能性をもたらしています。自己教師あり学習に基づくDINOv3のようなビジョントランスフォーマーは、大量のラベルなし医療画像からでも転移可能なセマンティック表現(意味的な情報)を学習し、限定されたアノテーション条件下やクロスドメインの変動に対する堅牢性を向上させます。一方、Segment Anything Model(SAM)のような大規模セグメンテーションモデルは、高解像度の空間構造や解剖学的境界を捉えることができます。しかし、これらのモデル単独では、セマンティック情報と解剖学的空間特徴を統合した、効率的で解釈可能な分類フレームワークの構築は依然として難しい課題でした。このギャップを埋めるため、本研究では、DINOv3とSAMの相補的な視覚的表現を相乗的に統合するデュアルエンコーダフレームワーク「DINOv3–SAM」を提案しています。これは、グローバルなセマンティック文脈を捉えるDINOv3と、解剖学的構造を意識した空間特徴を提供するSAMの画像エンコーダを組み合わせるものです。
DINOv3-SAMアーキテクチャの解説
DINOv3-SAMのアーキテクチャは、主に4つの主要コンポーネントで構成されています。
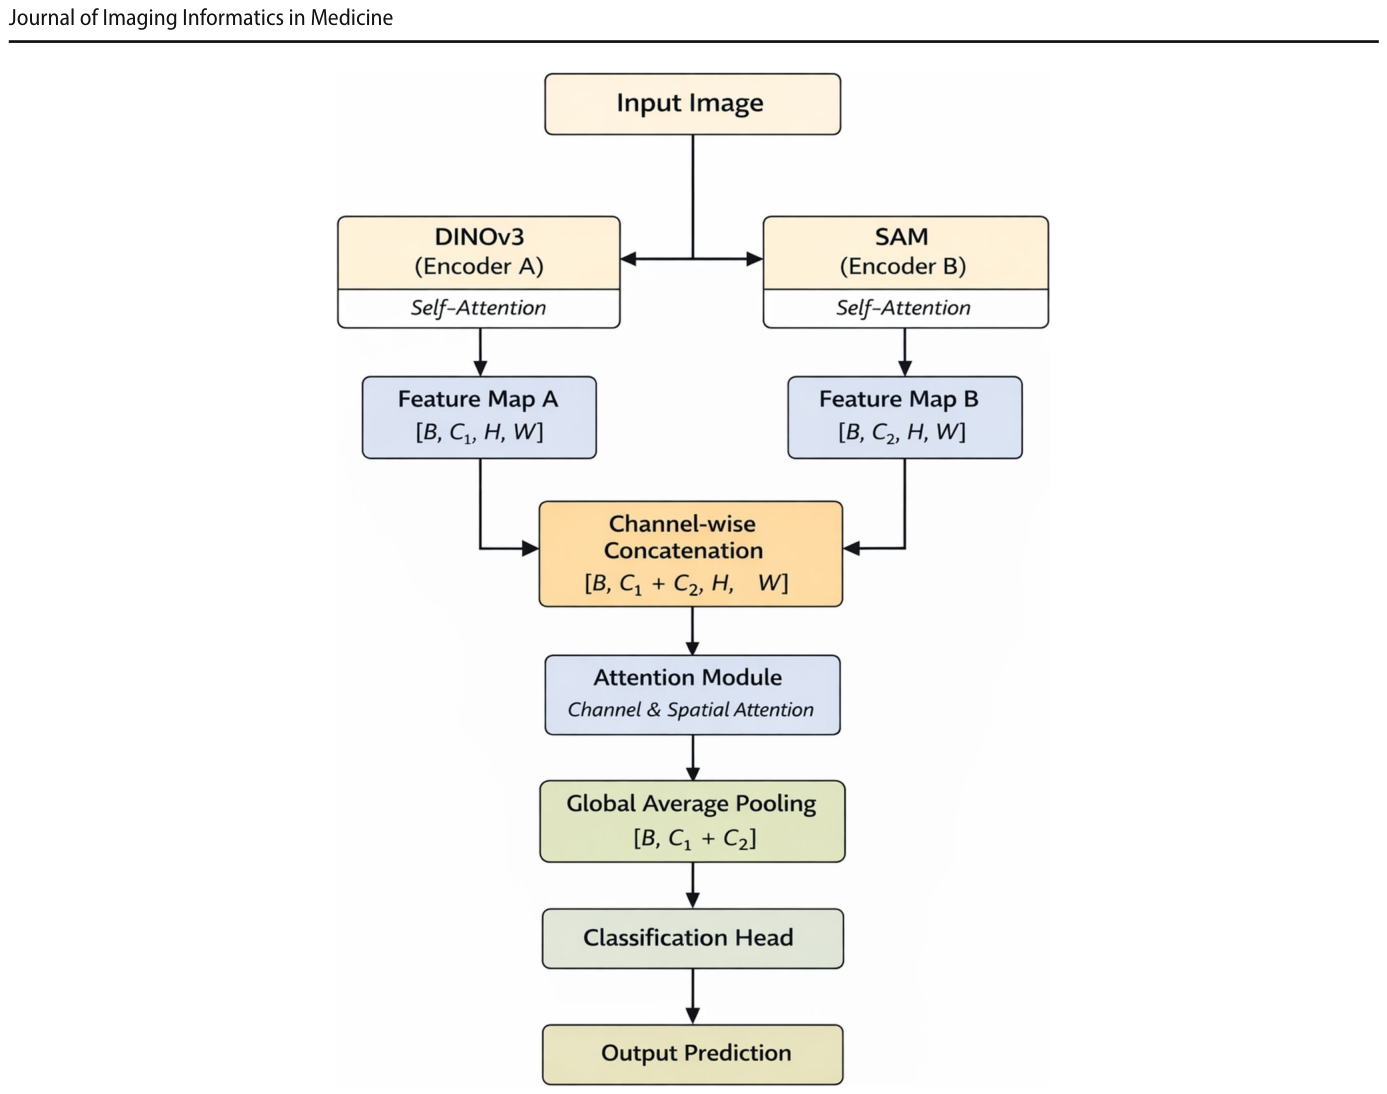
まず、グローバルなセマンティック特徴抽出のためのDINOv3 ViT-Smallエンコーダと、解剖学的構造を意識した空間表現のためのSAM ViT-Base画像エンコーダが並列に機能します。DINOv3は自己教師あり学習によって事前学習されており、画像全体にわたる意味的な内容を、ノイズの変化に不変な方法でエンコードします。一方、SAMの画像エンコーダは、ピクセルレベルの正確なセグメンテーション(画像内の領域分割)をサポートするように訓練されているため、きめ細かな空間情報や境界情報を保持し、肺野や心臓などの解剖学的境界に強く関連する特徴を抽出します。これらの異なる特性を持つ特徴ストリームは、空間的にアラインされ、チャネルごとの連結によって融合されます。その後、この融合された特徴は、畳み込みブロックアテンションモジュール(CBAM)によって適応的に洗練されます。CBAMは、情報量の多いチャネルと診断上関連性の高い領域を強調することで、モデルが臨床的に重要な解剖学的構造に焦点を合わせるように促し、非解剖学的なアーティファクトの影響を低減します。注目すべきは、計算効率を高めるために、DINOv3の最終層のみがファインチューニングされ、SAMエンコーダはフリーズされたままに保たれる点です。これにより、学習可能なパラメータがわずか530万に抑えられ、効率的なフレームワークが実現されています。最後に、各ブランチから得られた特徴ベクトルは、独立した分類ヘッドを通過し、予測結果を出力します。また、一貫性ガイド付きのマルチヘッド設計により、セマンティック特徴と解剖学的特徴の一貫性を保ちながら、単一の特徴源への過度な依存を防ぎ、予測の堅牢性を向上させます。このマルチヘッド分類戦略では、最終的な分類は融合された特徴に基づいて行われますが、個々のDINOv3とSAMの出力間の一貫性を促す正則化項が損失関数に組み込まれています。
多様な医療画像データセットでの評価
DINOv3-SAMフレームワークの性能を包括的に評価するため、研究チームは5つの公開データセットを用いて実験を行いました。これらは、小児肺炎分類、心臓肥大検出、大規模RSNA肺炎検出、COVID-19ラジオグラフィー、皮膚病変分類という多様なモダリティと診断タスクをカバーしています。
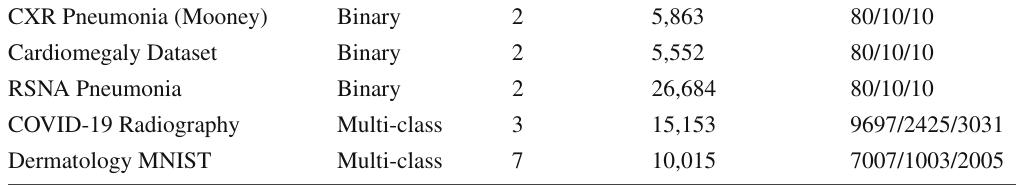
評価プロトコルは、二値分類と多クラス分類の両方の設定で一貫性と公平性を確保するために統一されています。各設定は異なるランダムシードで3回訓練され、統計的有意性検定を伴う詳細な比較が、再現されたCNNベースラインおよび発表済みの最先端手法に対して行われました。この研究では、胸部X線画像だけでなく、皮膚鏡画像も評価対象としています。
これは、フレームワークの汎用性とクロスドメインにおける堅牢性を確認するために重要です。データセットの分割と前処理についても厳格なプロトコルが適用され、各データセットは訓練、検証、テストの各サブセットに分割され、クラス分布が維持されるように層化サンプリングが行われています。これにより、データリーク(テストデータが学習プロセスに漏れ出すこと)が防止され、公平な比較が保証されています。
DINOv3-SAMの性能と優位性
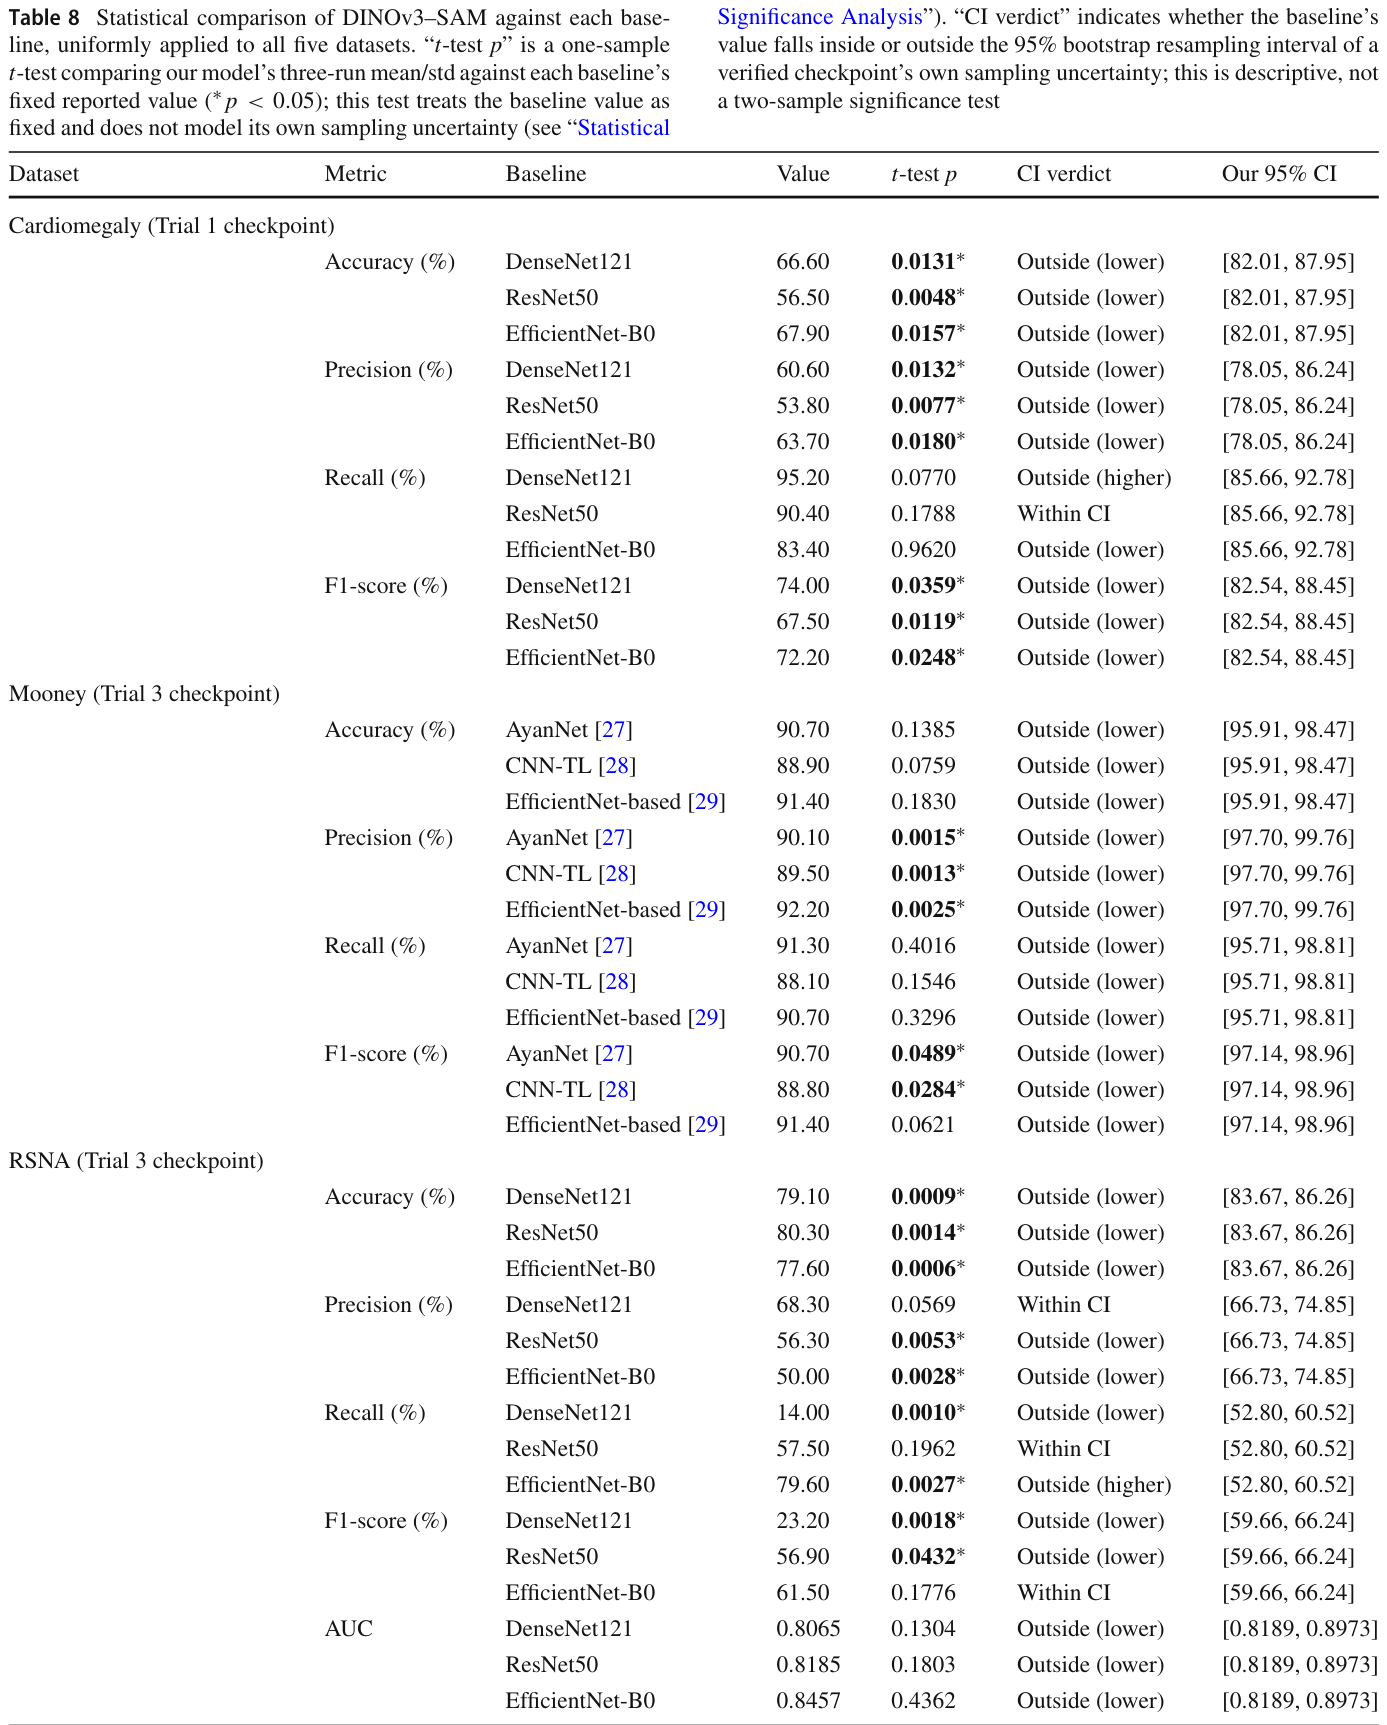
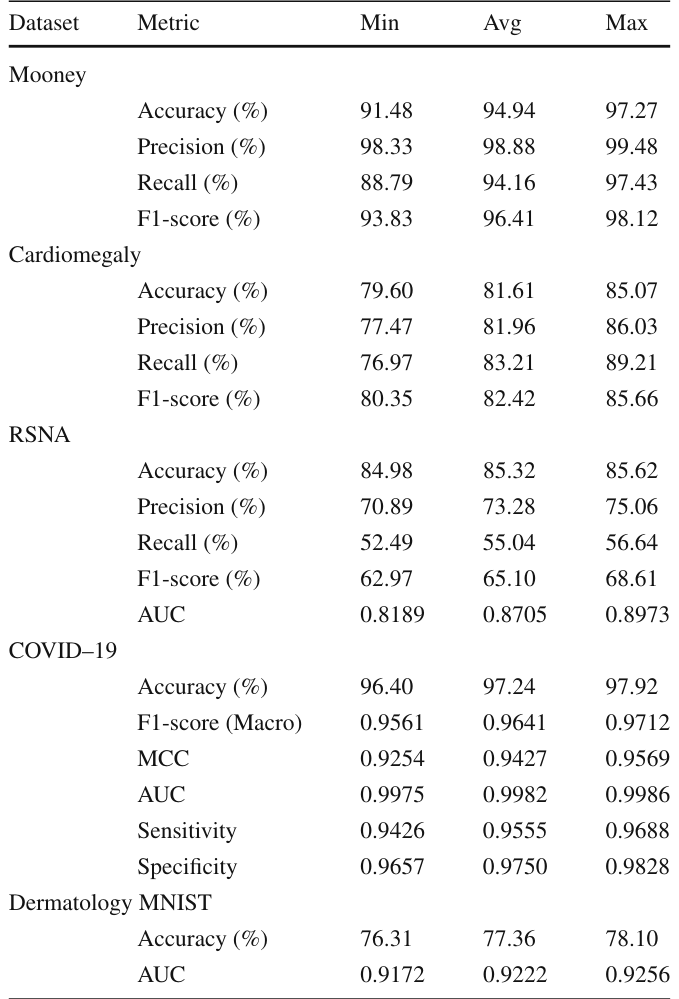
DINOv3-SAMは、ほとんどのデータセットと評価指標において改善を示しました。例えば、小児肺炎分類では平均精度94.94%(±3.06)を達成し、既存のAyanNet(90.7%)やEfficientNetベースのモデル(91.4%)を上回りました。
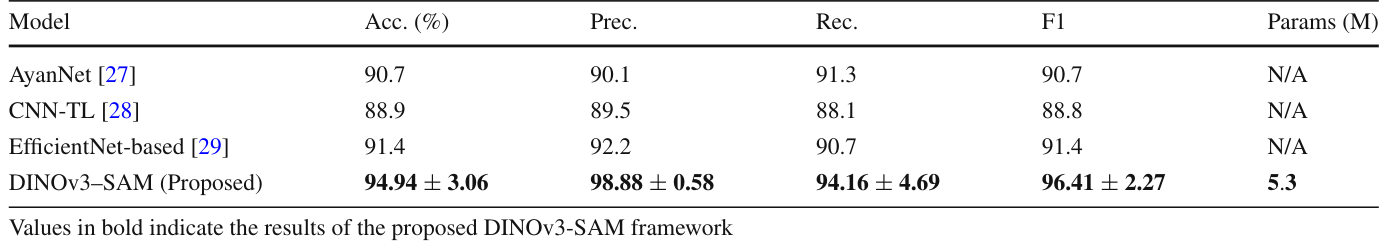
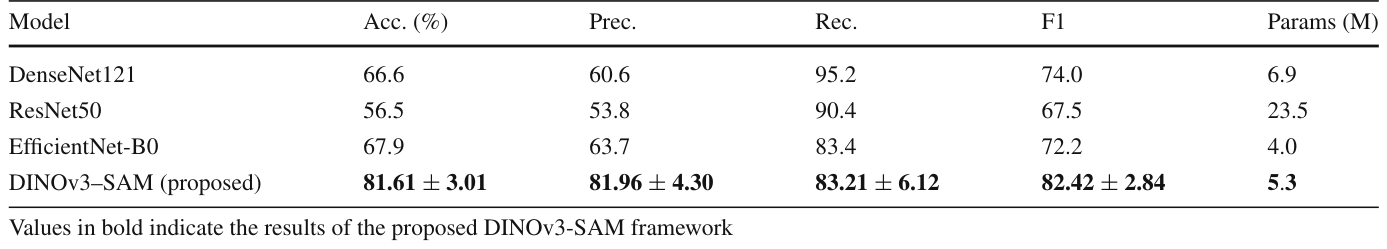
特に適合率が98.88%(±0.58)と高く、セマンティック表現と解剖学的特徴表現の組み合わせが有効であることを示しています。心臓肥大検出タスクでは、平均精度81.61%(±3.01)、平均F1スコア82.42%(±2.84)を達成し、全ての再現されたベースラインモデルを一貫して上回りました。
RSNA肺炎データセットのようなより困難なベンチマークでは、平均AUC0.8705(±0.0445)を達成し、DenseNet121(0.8065)やEfficientNet-B0(0.8457)を上回る傾向を示しています。
COVID-19ラジオグラフィーデータセットでは、平均精度97.24%(±0.77)、F1スコア0.9641(±0.0076)、AUC0.9982(±0.0006)という強力な性能を発揮しました。
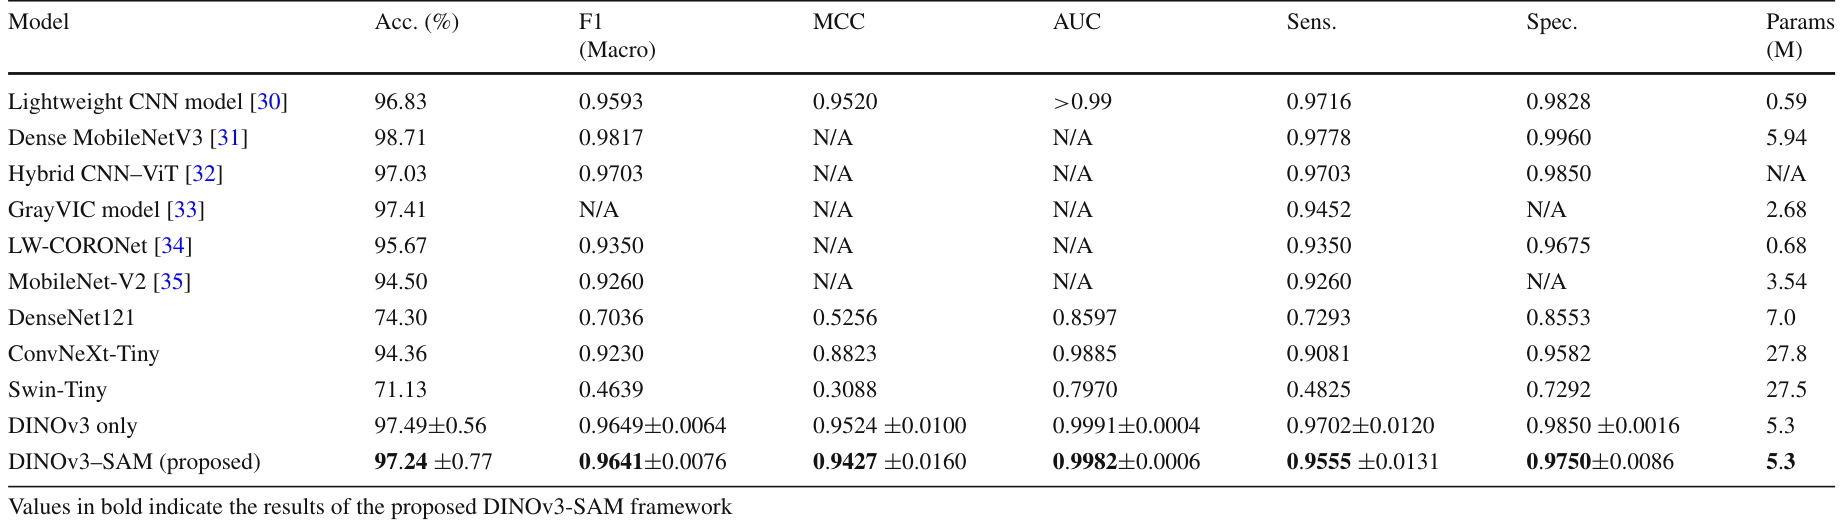
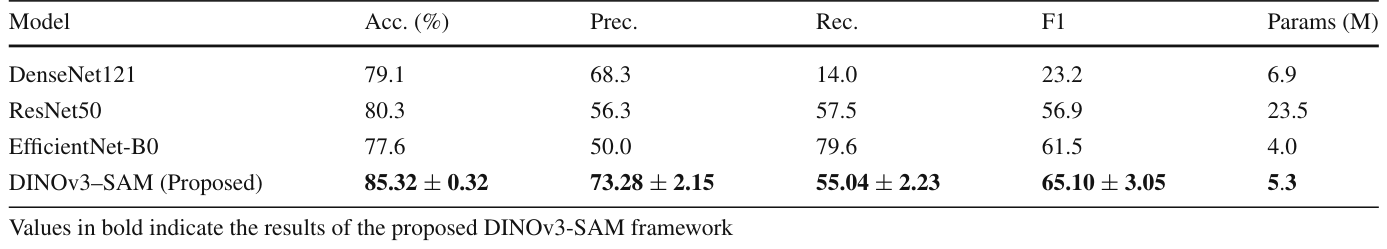
皮膚科MNISTデータセットでも、平均精度77.36%(±0.93)、AUC0.9222(±0.0044)を達成し、従来のCNNやAutoMLベースラインモデルを上回り、最も強力な公開ベースライン(Google AutoML、MedViTなど)と統計的に区別できないレベルの性能を示しました。
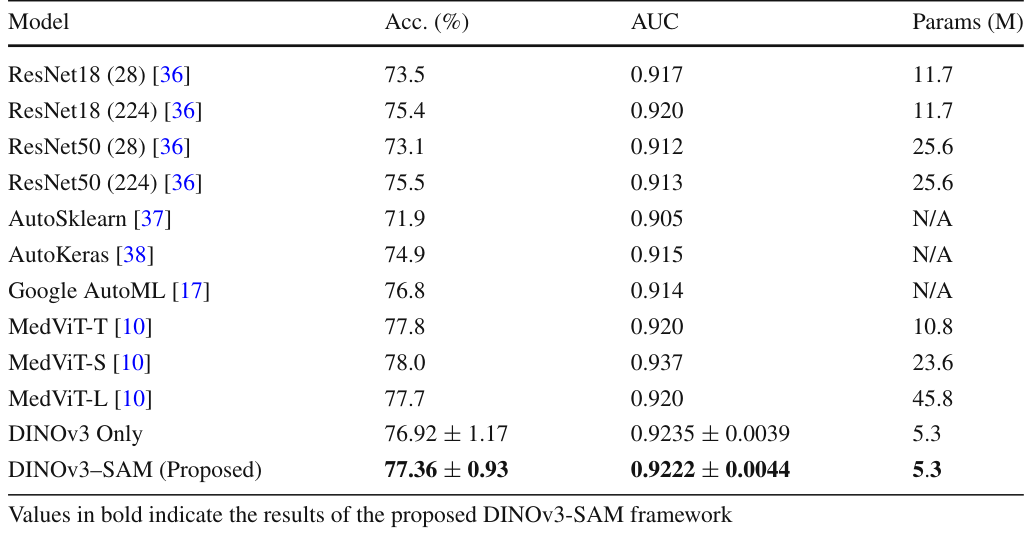
これらの結果は、データセットのバイアス、取得時の変動、クロスドメインシフトに対する堅牢性を高める上で、自己教師ありのセマンティック表現とセグメンテーションから得られる解剖学的情報とを融合することの有効性を強調しています。
アブレーションスタディと統計的有意性
デュアルエンコーダ設計の貢献度を評価するため、DINOv3-SAMフレームワークとDINOv3エンコーダのみを使用するシングルブランチ構成とのアブレーションスタディが行われました。結果として、DINOv3単独モデルもその自己教師ありセマンティック表現により強力な性能を示していますが、COVID-19ラジオグラフィーデータセットと皮膚科MNISTデータセットでは、DINOv3-SAMモデルとDINOv3単独モデルとの間に統計的に有意な差は見られませんでした。これは、これらのデータセットではDINOv3のセマンティック特徴のみで十分に判別信号を捉えていることを示唆しています。一方で、二値分類の胸部X線タスク、特に心臓肥大検出のように強い構造的/解剖学的信号が重要なデータセットでは、DINOv3-SAMの全体モデルがCNNベースラインに対して明確で統計的に有意な改善を示しました。このことは、SAMのセグメンテーション指向の事前学習が、構造的な特徴に依存するタスクで最も有効であることを裏付けています。
また、各メトリックについて3回の独立した訓練実行における最小値、平均値、最大値も報告されており、標準偏差に基づく要約を補完し、ランダムシードによる結果のばらつきの全体像を提供しています。
計算効率性と今後の展望
DINOv3-SAMは、学習可能なパラメータ数を530万に抑えることで、基盤モデル全体のファインチューニングと比較して学習効率が高いことが示されています。しかし、推論時の計算コストについては、SAM ViT-Baseブランチが高解像度(1024×1024)で動作するため、フレームワーク全体の推論FLOPS(浮動小数点演算数)の大部分を占め、単一バックボーンのCNNやTransformerベースラインよりも大幅に高いという特徴があります。
この事実は、リアルタイム処理やバッチ処理が必要な臨床シナリオでの展開において重要であり、厳格な遅延要件を持つアプリケーションでは、SAMブランチをより低解像度または蒸留されたバリアントに置き換えることが将来の課題として挙げられています。DINOv3-SAMは、自己教師ありセマンティックトランスフォーマー、フリーズされた解剖学的認識エンコーダ、CBAMアテンションによる連結ベースの融合、および一貫性ガイド付きマルチヘッド学習を統合することで、多様なデータセットと臨床条件にわたる堅牢な医療画像分類のための統一された解剖学的に情報に基づいたフレームワークを提供します。このアプローチは、研究指向の診断支援システムにおけるマルチデータセットおよびマルチモダリティ医療画像分類のための信頼できる基盤を提供します。
用語集
- 基盤モデル: 大規模なデータで事前学習され、多くの異なるタスクに適用できる柔軟なAIモデル。
- 自己教師あり学習: ラベル付けされていないデータから、データ自身の構造を利用して学習する方法。
- ビジョントランスフォーマー (ViT): 自然言語処理で成功したTransformerモデルを画像認識に応用した深層学習モデル。
- DINOv3: 自己教師あり学習の手法の一つで、Transformerベースのモデルが画像の意味的特徴を学習する。
- Segment Anything Model (SAM): 様々な視覚ドメインでプロンプトに基づいて任意のオブジェクトをセグメンテーションできる大規模モデル。
- デュアルエンコーダフレームワーク: 異なる種類の2つのエンコーダ(特徴抽出器)を組み合わせて入力データを処理するAIの構造。
- チャネルアテンション: 画像の特徴マップにおいて、どの情報チャネルが重要であるかを動的に重み付けするメカニズム。
- 空間アテンション: 画像の特徴マップにおいて、どの空間領域が重要であるかを動的に重み付けするメカニズム。
- 畳み込みブロックアテンションモジュール (CBAM): チャネルアテンションと空間アテンションを連続的に適用し、特徴表現を洗練する軽量なモジュール。
- ファインチューニング: 事前学習済みのモデルを、特定のタスクに合わせて一部の層を再訓練すること。
- グローバルアベレージプーリング (GAP): 画像特徴マップの各チャネルの空間次元全体で平均を取り、単一の数値にまとめる処理。
- 精度 (Accuracy): モデルが正しく分類したサンプルの割合。
- F1スコア (F1-score): 適合率と再現率の調和平均であり、分類性能のバランスを示す指標。
- AUC (Area Under the Curve): 受信者操作特性曲線(ROC曲線)の下の面積で、分類モデルの識別能力を示す指標。
- Matthews相関係数 (MCC): 不均衡なデータセットでも信頼性の高い、二値分類の性能を示すバランスの取れた指標。
- 再現率 (Recall): 実際に陽性である全サンプルの中で、モデルが正しく陽性と予測できた割合(感度とも呼ばれる)。
- 適合率 (Precision): モデルが陽性と予測した全サンプルの中で、実際に陽性であった割合。
- ショートカット学習: モデルが、意図しないデータセット固有のパターンやアーティファクトに依存して予測を行う現象。
- 汎化性能: モデルが学習データとは異なる、未知の新しいデータに対しても、どれだけ正確に予測できるかという能力。
- ドメインシフト: 学習データの分布と、推論時に遭遇するデータの分布が異なることによって生じる性能低下の現象。
- 特徴マップ: 深層学習モデルの途中の層で抽出された、入力画像の特徴を表す多次元のデータ。
コメントを残す