
直腸がん放射線治療におけるGTV輪郭描出:SAMを用いた対話型ワークフローが臨床効率を革新
解説対象論文: Segment anything model (SAM)‐driven prompt‐guided interactive delineation of gross tumor volume for rectal cancer neoadjuvant radiotherapy
Medical Physics|被引用数: 0(2026年10月27日時点)
直腸がんの放射線治療において、腫瘍の位置を正確に特定し輪郭を描出することは、治療の成否を分ける重要な要素です。しかし、この作業は専門家にとって時間と労力がかかる上に、手作業による誤差も避けられませんでした。近年、AIモデルの進化は医療画像分野にも大きな変革をもたらしていますが、特に画像中のあらゆる物体を認識しセグメンテーションできるSegment Anything Model(SAM)は、その可能性に注目が集まっています。本記事では、Medical Physicsに掲載された最新の研究論文を基に、直腸がんの肉眼的腫瘍体積(GTV)の輪郭描出において、SAMがどのように画期的な精度と効率をもたらすのかを深掘りします。少ない操作で高精度な輪郭描出を実現する、SAM駆動型ワークフローの全貌に迫りましょう。
はじめに:直腸がん治療における精密なGTV輪郭描出の重要性
どうも、Beyond the Pixelです。直腸がんは世界中で罹患率および死亡率が上位にある悪性腫瘍の一つであり、特に中国では結腸直腸がんの中で最大の割合を占めています。局所進行直腸がんの対象者には、術前補助放射線治療が推奨されており、これにより術後の局所再発が大幅に減少し、病理学的完全奏効率が向上することが示されています。放射線治療において、標的体積(TVs)の正確な輪郭描出は、良好な治療成績を達成するために極めて重要です。直腸がん術前補助放射線治療におけるTVsの輪郭描出には、肉眼的腫瘍体積(GTV)と臨床的標的体積(CTV)の2つの要素が含まれます。GTVとは、目視可能な原発腫瘍と転移性リンパ節を指し、CTVにはGTV、微小病変、および高リスクのリンパドレナージ領域が含まれます。しかし、CT画像を用いたTVsの従来の手動による輪郭描出(手作業で境界線を引くこと)は、時間と労力がかかり、専門家による誤差が生じやすいという課題があります。臨床効率を向上させるため、TVsの自動輪郭描出に向けて多くの研究が進められてきました。特に近年、深層学習(ディープラーニング:機械学習の一種で、多層のニューラルネットワークを用いてデータから特徴を自動的に学習し、高精度な予測や判断を行う技術)に基づく手法が主流となっています。しかし、CT画像での腫瘍コントラストが低いため、直腸がんのGTV自動輪郭描出は依然として特に困難な課題とされています。
SAMの登場と医療画像分野への応用
近年、ユーザーが定義するプロンプト(モデルに与える指示や情報のこと)を活用することで、事前知識(事前に持っている情報)を組み込み、セグメンテーション(画像内で特定の物体や領域を画素単位で識別・分離すること)性能を向上させるプロンプト誘導モデルが有望な解決策として登場しました。最も注目すべきプロンプト誘導モデルの一つが、Meta AIによって提案されたオープンソースの大規模視覚モデルであるSegment Anything Model(SAM)です。SAMは、膨大なデータセットで事前学習されており、点、バウンディングボックス(対象を囲む四角い枠)、マスクプロンプトなど、さまざまなインタラクション(人間がモデルに情報を与える操作)を介して、対象領域(ROI)に注釈を付けることができます。複数の研究でSAMが医療画像セグメンテーションに適用され、CT、MRI、超音波、X線などの多様なイメージングモダリティ(検査手法や画像の種類)において、特に境界が明確な臓器や病変で満足のいくセグメンテーション性能を達成できることが示されています。しかし、放射線治療におけるSAMの応用はまだ限定的で、ほとんどが頭頸部がんのリスク臓器(OAR)の輪郭描出に限られています。現在のところ、標的の輪郭描出に関する文献検索では、MRIベースの骨盤内腫瘍セグメンテーションに関する研究が1件見つかるのみです。これらの研究はSAMが標的輪郭描出に大きな可能性を秘めていることを示唆していますが、主にモデル性能のベンチマークに焦点を当てており、SAMを臨床的な標的輪郭描出のワークフロー(一連の作業手順)に効果的に統合する方法はまだ不明確です。このような背景から、本研究では、最適化されたSAMを活用した、実現可能なプロンプト誘導型の対話型輪郭描出ワークフローを提案しています。
研究方法:最適化されたSAMワークフローの構築
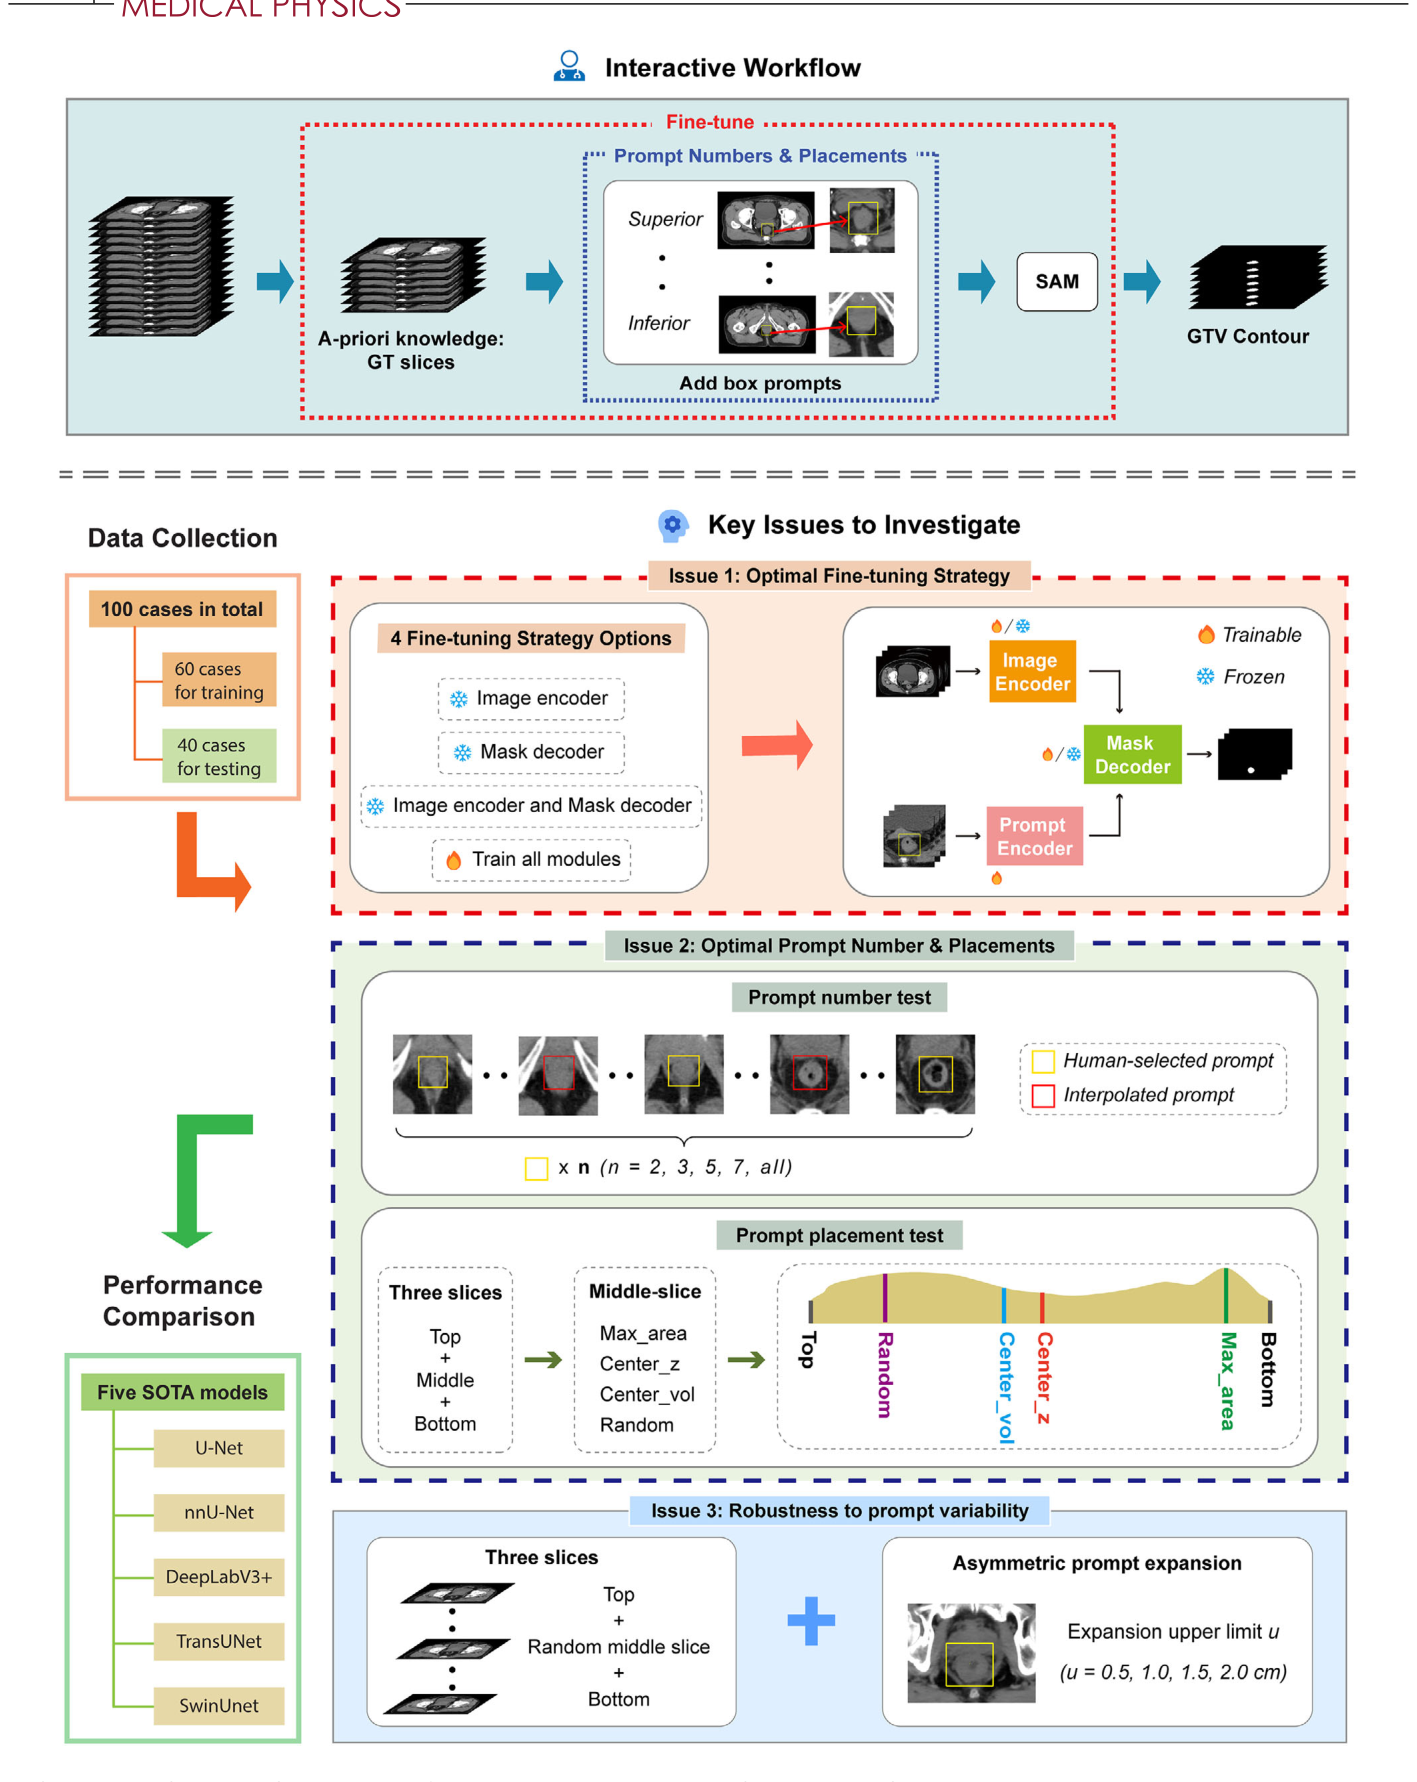
この研究では、直腸がんの術前補助放射線治療を目的としたGTVセグメンテーションのために、最適化されたSAMによる実現可能なプロンプト誘導型の対話型輪郭描出ワークフローを提案しています。合計100件の直腸がん症例が収集され、60件がトレーニング(モデルに学習させること)に、40件がテスト(学習済みモデルの性能を評価すること)に用いられました。この研究では、バウンディングボックスプロンプト(対象を囲む四角い枠の指示)を使用してSAMをGTVセグメンテーションに誘導しました。ワークフローは大きく4つのステップで構成されます。まず、専門家は医療記録(診察記録や診断画像など)から一般的な腫瘍情報を事前知識として把握します。次に、計画CT画像でGTVの一般的な標的体積を特定し、少なくとも最上部と最下部のスライスにGTVのバウンディングボックスを手動で注釈付けします。その後、中間スライスで手動で注釈が付けられていないバウンディングボックスプロンプトは、補間戦略(既知のデータ点から未知のデータ点を推定する方法)を用いて自動的に生成されます。最後に、注釈が付けられたCT画像と関連するボックスプロンプトがSAMに順次入力され、目的のGTV輪郭(対象領域の境界線)が生成されます。
本研究では、SAMのトレーニングのための4つのファインチューニング戦略(事前学習済みのモデルを特定のタスクに合わせて再調整すること)が評価されました。これには、画像エンコーダー(画像を特徴表現に変換するSAMの構成要素)を固定する、マスクデコーダー(特徴表現からセグメンテーションマスクを生成するSAMの構成要素)を固定する、両方を固定する、全てのパラメータをトレーニングする、の4つです。また、プロンプトの数と配置の影響も評価されました。最終的に最適化されたSAMワークフローの性能は、5つの最先端(SOTA)モデル(その時点での最高性能を持つモデル)と比較され、中間スライスの選択やバウンディングボックスプロンプトのマージン(境界からのゆとり)におけるプロンプトの変動に対するロバスト性(変化やノイズに対して安定した性能を保つ能力)も分析されました。
最適なファインチューニング戦略とプロンプトの影響
4つのファインチューニング方法(画像エンコーダーの固定、マスクデコーダーの固定、画像エンコーダーとマスクデコーダーの両方の固定、全モジュールのトレーニング)の性能は、異なるバウンディングボックスの拡張値(ボックスのサイズをどれだけ広げるか)で評価されました。その結果、他のファインチューニング方法と比較して、画像エンコーダーを固定する方法が最も安定した性能を示しました。これは、バウンディングボックスプロンプトのマージンに対する高い耐性(許容度)を示唆しています。バウンディングボックスのマージンが1cmを超えて拡大すると、セグメンテーション性能が徐々に低下しました。これは、過度に緩いバウンディングボックスプロンプトが不要な背景情報(対象以外の情報)を誘導し、結果としてセグメンテーション精度を損なう可能性があることを示唆しています。
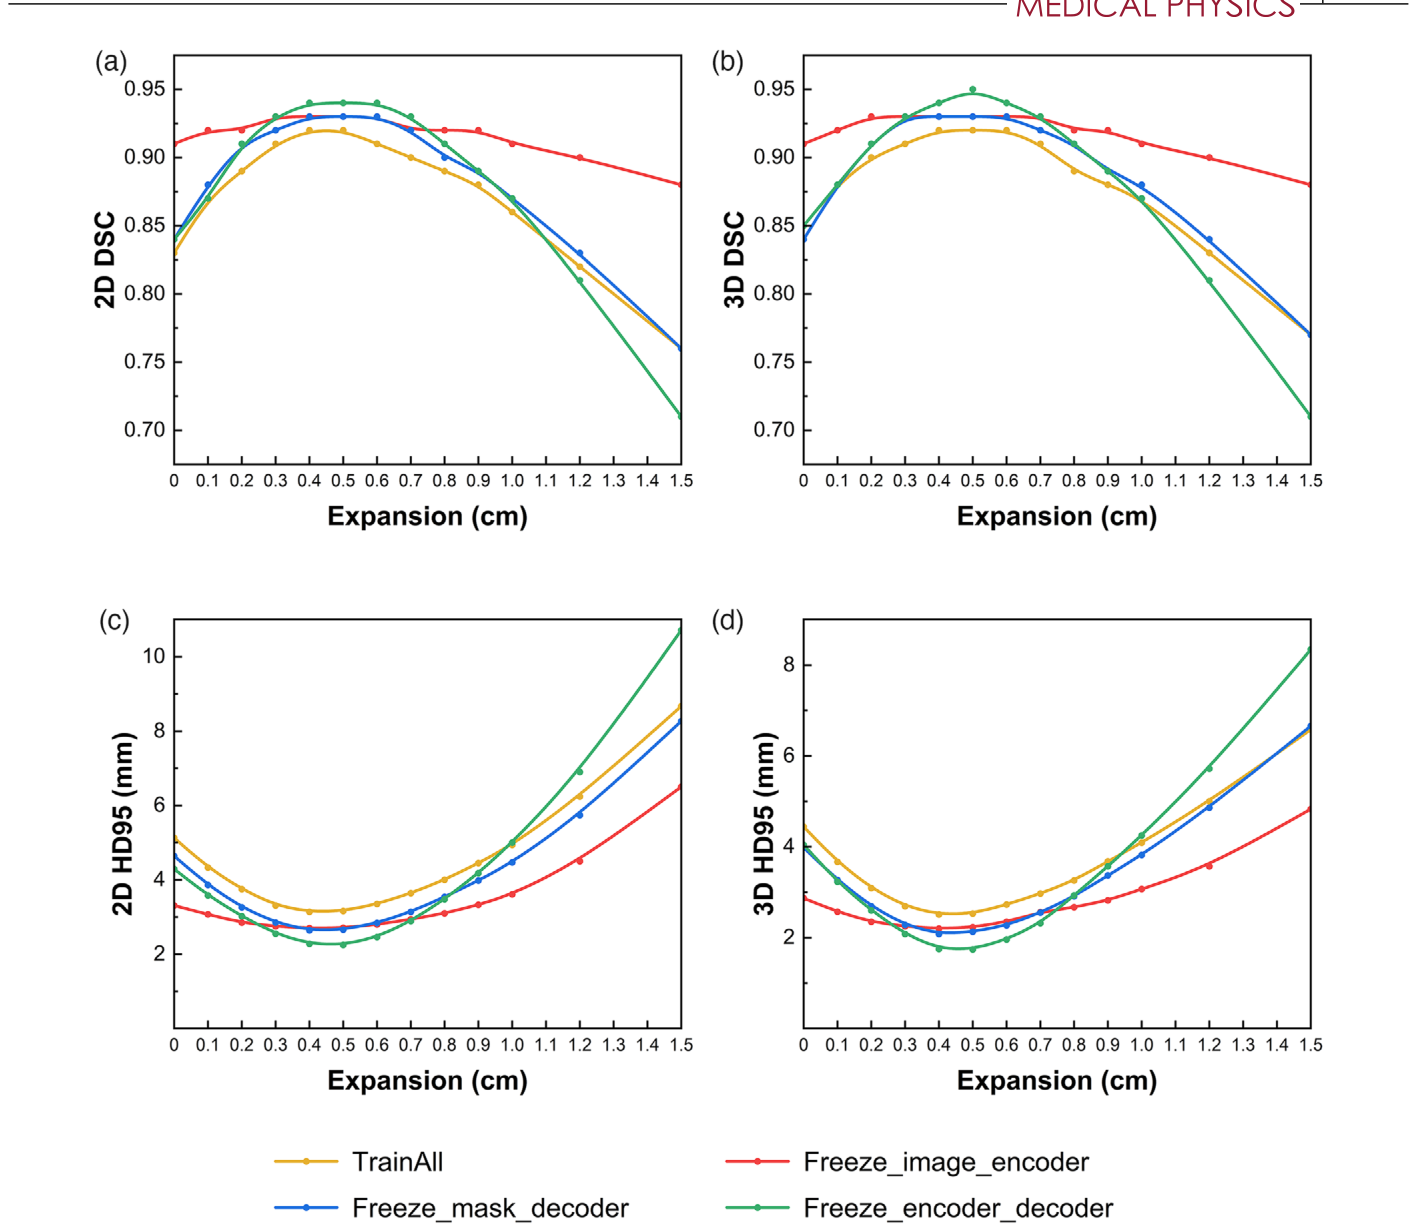
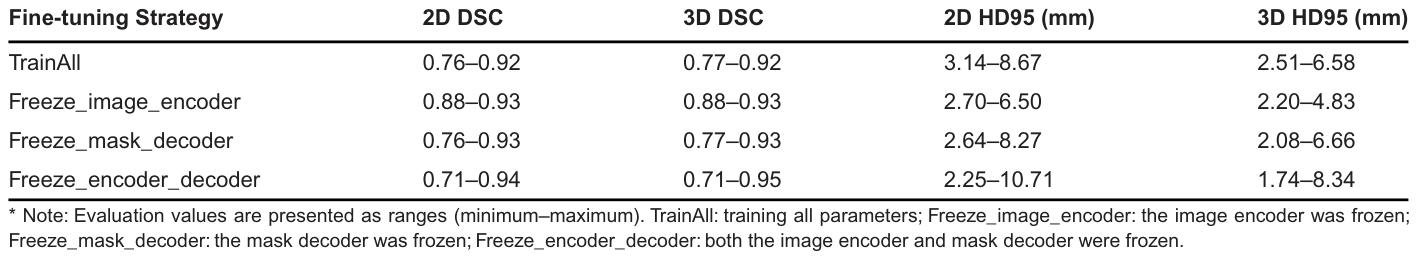
また、LoRA(Low-Rank Adaptation:大規模モデルの効率的なファインチューニング手法の一つ)モジュールを導入した追加実験も行われ、LoRAベースのSAMファインチューニングは全トレーニング戦略を上回り、0-1cmのボックス拡張範囲内で画像エンコーダーを固定する戦略に匹敵する性能を達成しました。この結果は、限られたデータセットでのSAM適応において、完全なパラメータファインチューニングが常に最適ではない可能性を示唆しており、特定の事前学習済みモジュールを固定することで過学習(モデルがトレーニングデータに過度に適応し、未知のデータに対する性能が低下すること)のリスクを軽減し、モデル性能を向上できることが示唆されます。
本研究の主要な新規性の一つとして、提案されたワークフローは、最上部のスライス、最下部のスライス、および1つの中間スライスのわずか3つのスライスに手動でバウンディングボックスプロンプトを提供するだけで、ほぼ最適な性能でGTVセグメンテーションを実行できることが分かりました。これは、セグメンテーションタスクにおけるSAMの能力の効率的な活用を可能にし、専門家の操作負担を大幅に軽減するものです。
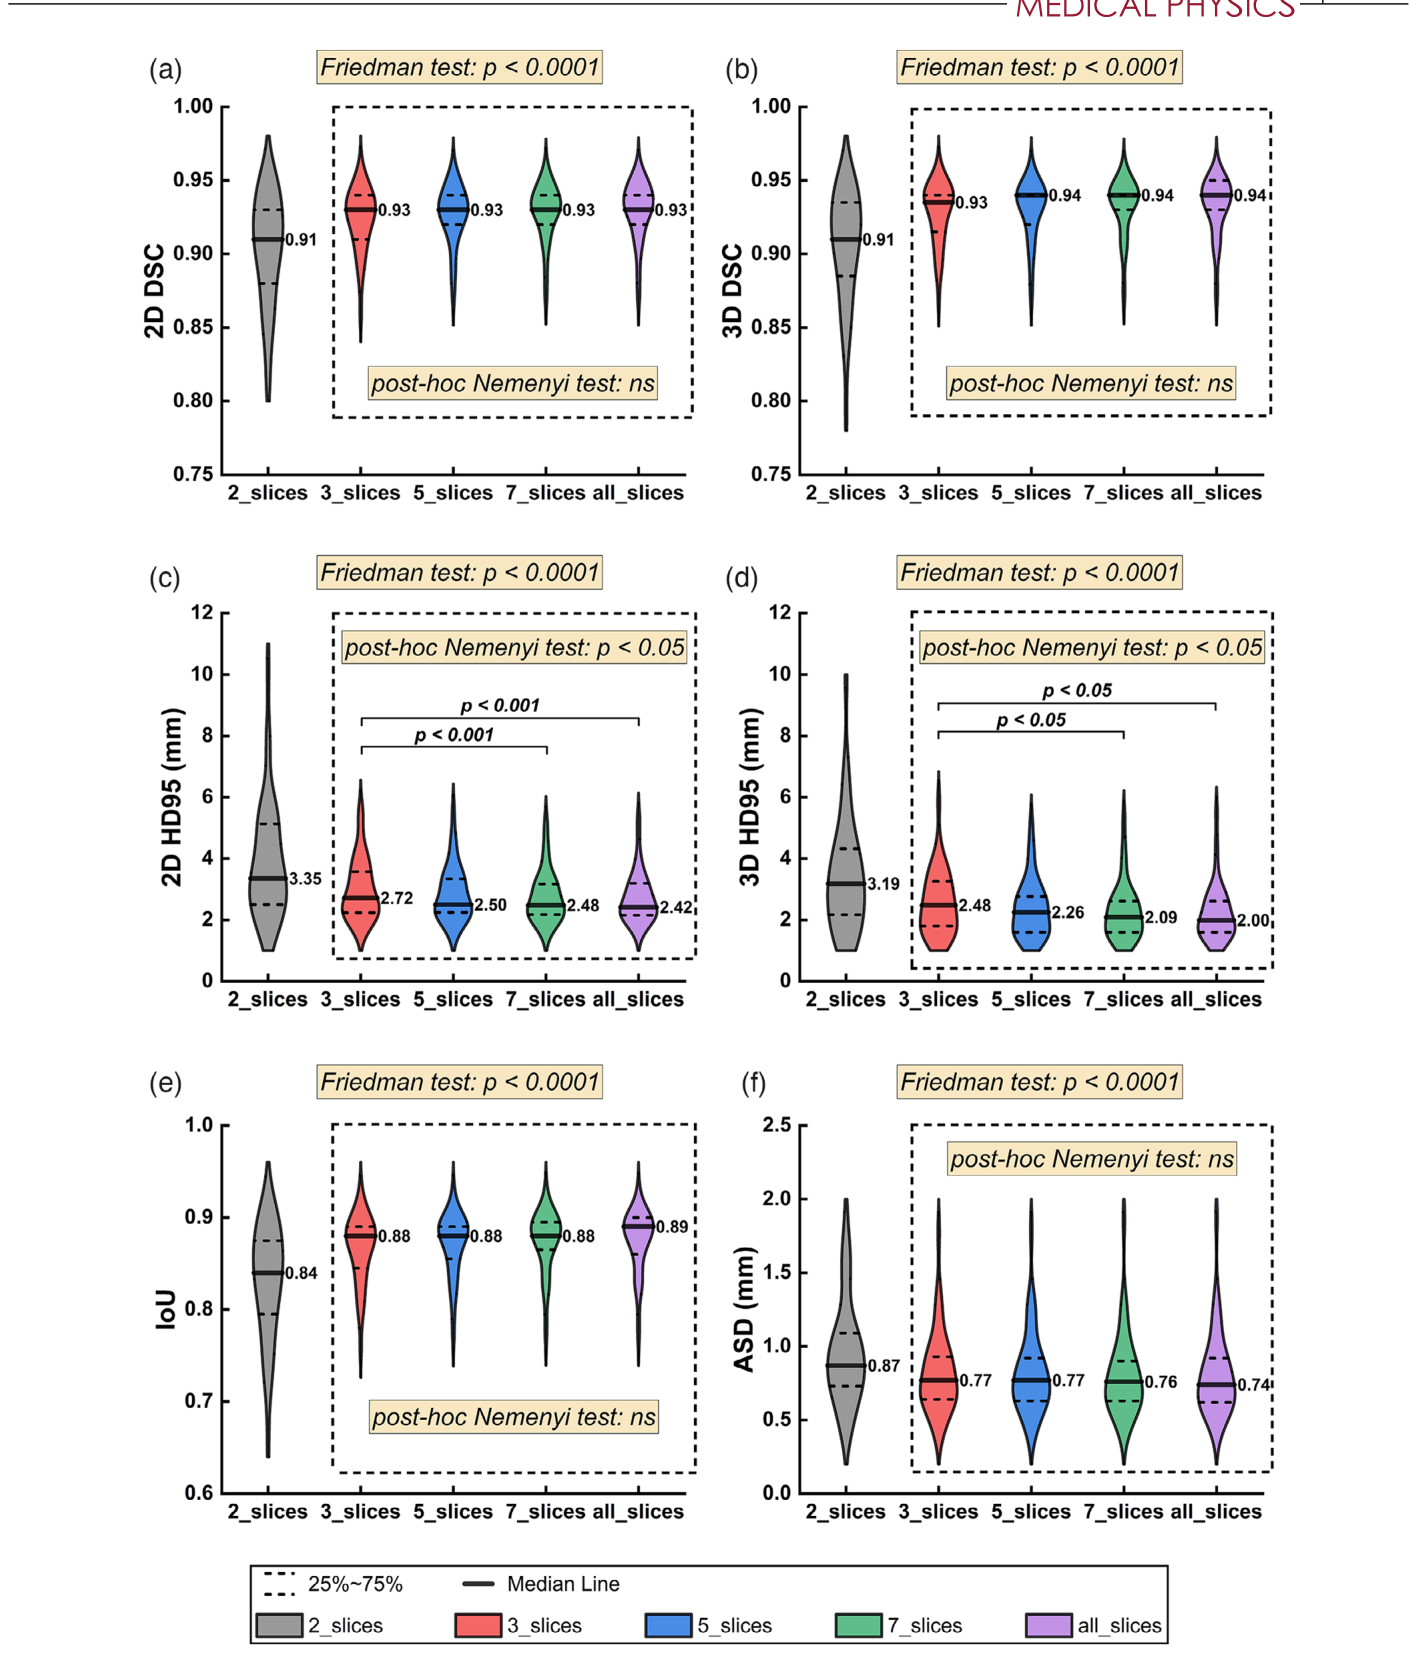
中間スライスのプロンプトの配置については、その影響はごくわずかであることが判明しました。これは、専門家が特定の中間スライスを正確に特定する必要なく、望ましい輪郭描出結果を得られることを示唆しています。
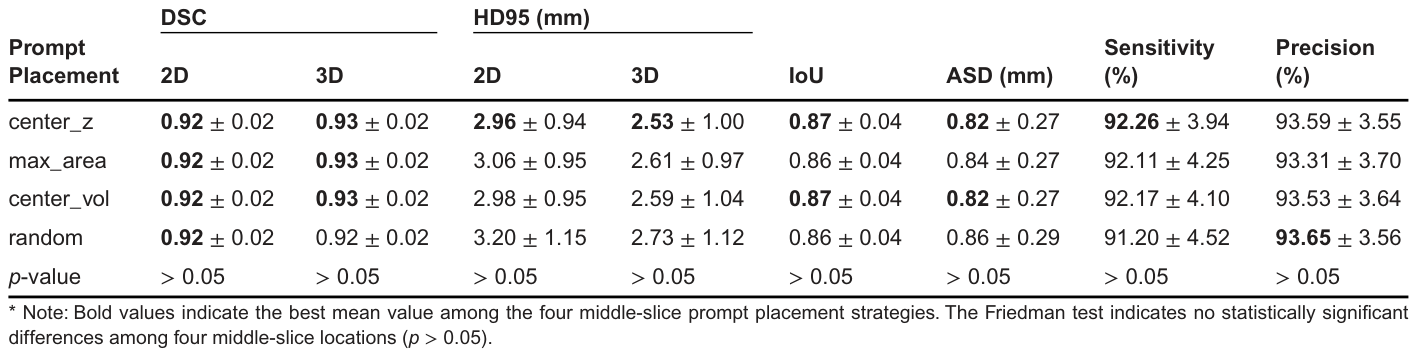
この3スライスプロンプトの補間戦略の効果は、直腸GTVがCT画像上で直腸壁に沿って連続的に広がる特徴を持つことと、SAMのボックスプロンプトが厳密な境界制約ではなく空間的な手掛かり(ヒント)として機能するためと考えられます。SAMはプロンプト領域を超えて推論し、プロンプトと全体的な画像情報の両方を統合して正確なセグメンテーションを達成します。
SAMワークフローの性能とロバスト性
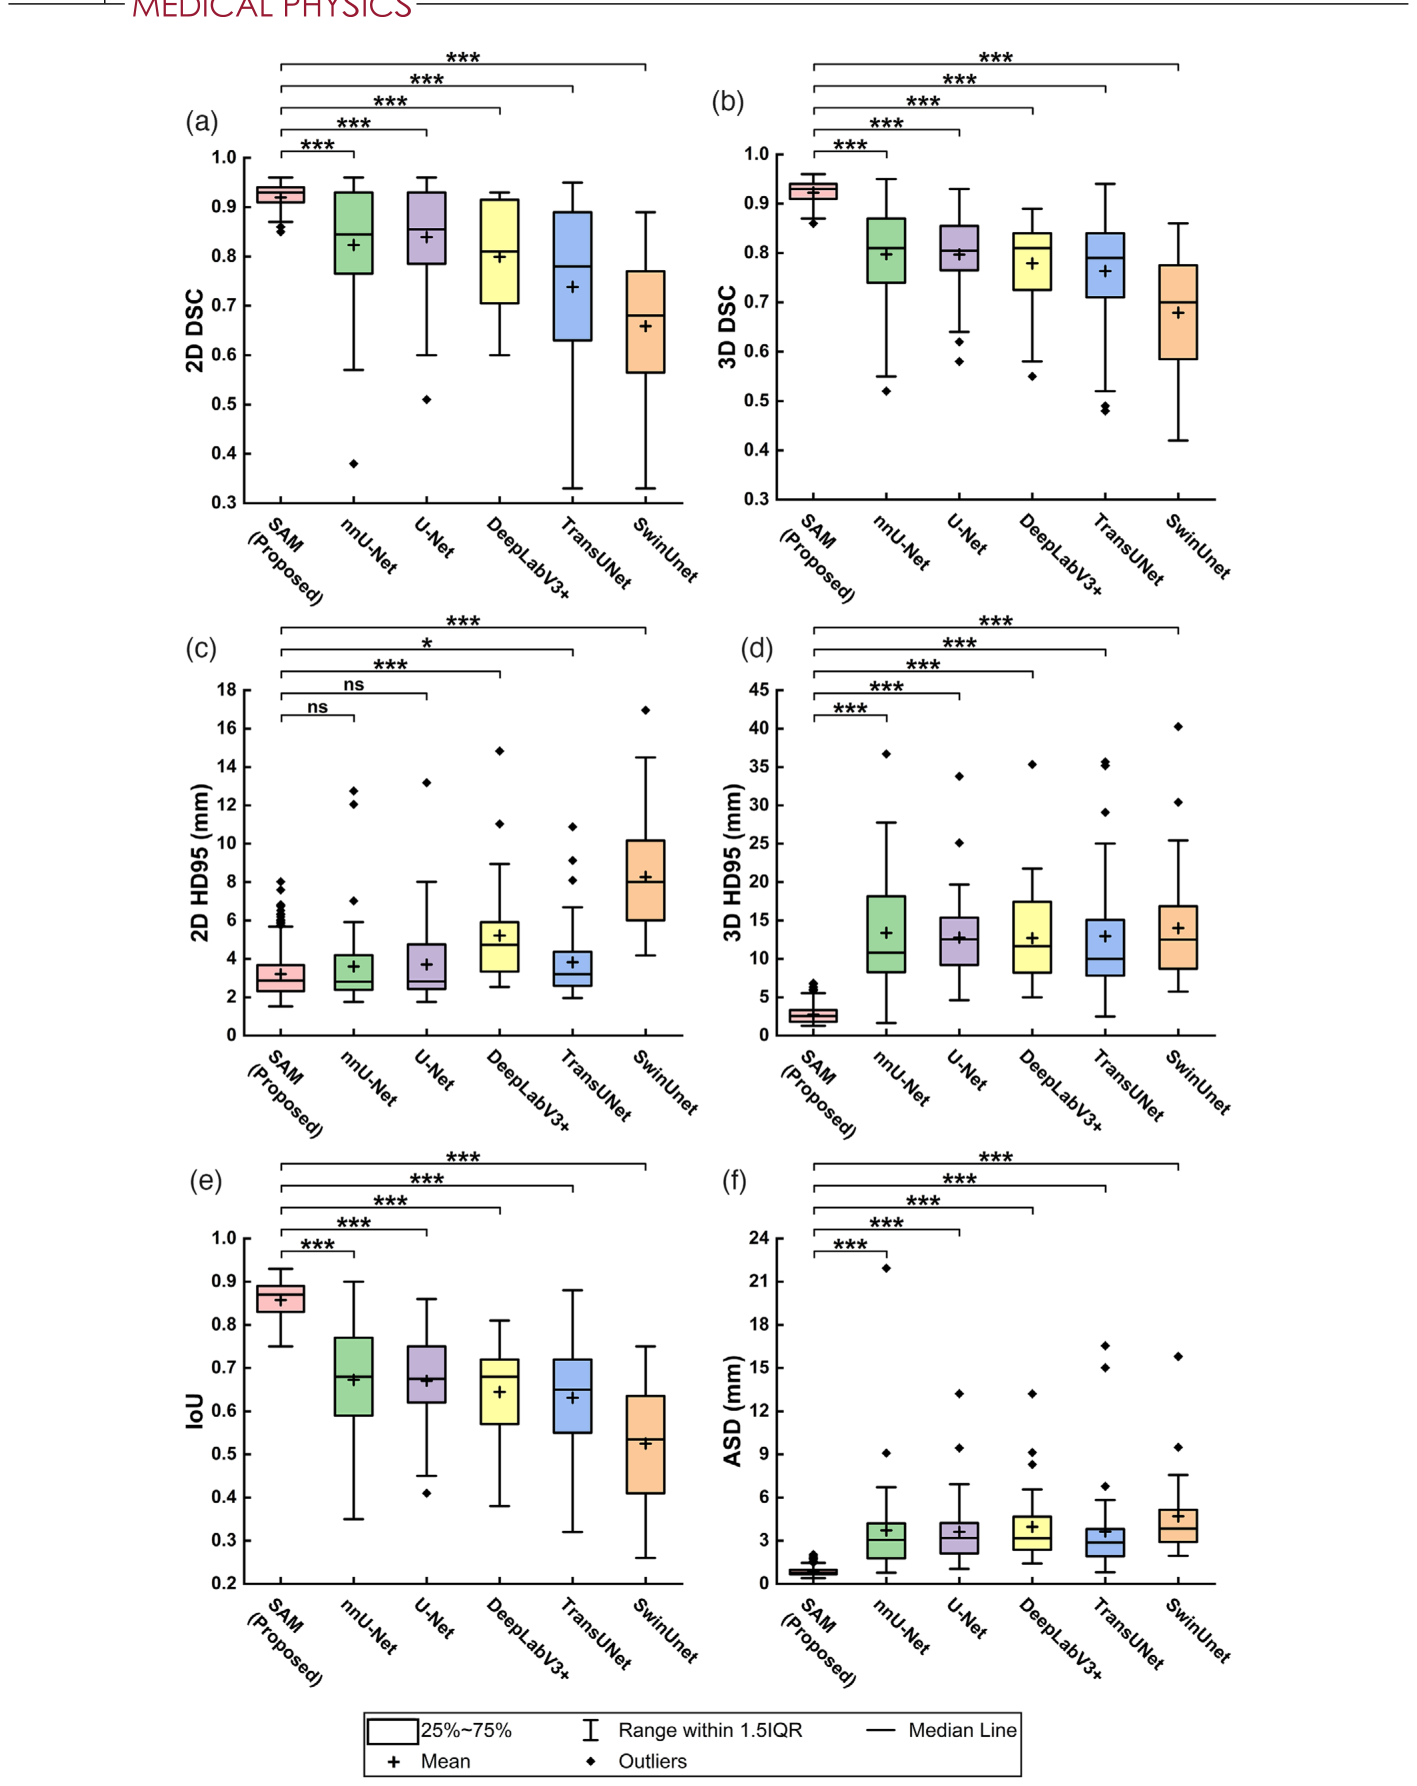
最終的なSAM駆動型ワークフローの性能は、U-Net、DeepLabV3+、nnU-Net、TransUNet、SwinUnetの5つの最先端(SOTA)モデルと比較されました。提案されたSAMワークフローは、全ての評価指標において最も優れた性能を達成しました。最高のベースライン(比較対象の標準的な性能)値と比較して、提案されたSAMは3D DSC(Dice類似度係数:予測と実際の重なりを評価する指標)を0.80から0.92へ、3D HD95(95パーセンタイル Hausdorff距離:予測と実際の境界間の最大距離の95パーセンタイル値)を12.70mmから2.73mmへ、IoU(Intersection over Union:予測と実際の領域の重なりを評価する指標)を0.67から0.86へ、感度(Sensitivity:真の陽性をどれだけ検出できたかを示す指標)を85.98%から91.20%へ、適合率(Precision:陽性と予測されたもののうち、どれだけが実際に陽性であったかを示す指標)を79.23%から93.65%へと改善しました。
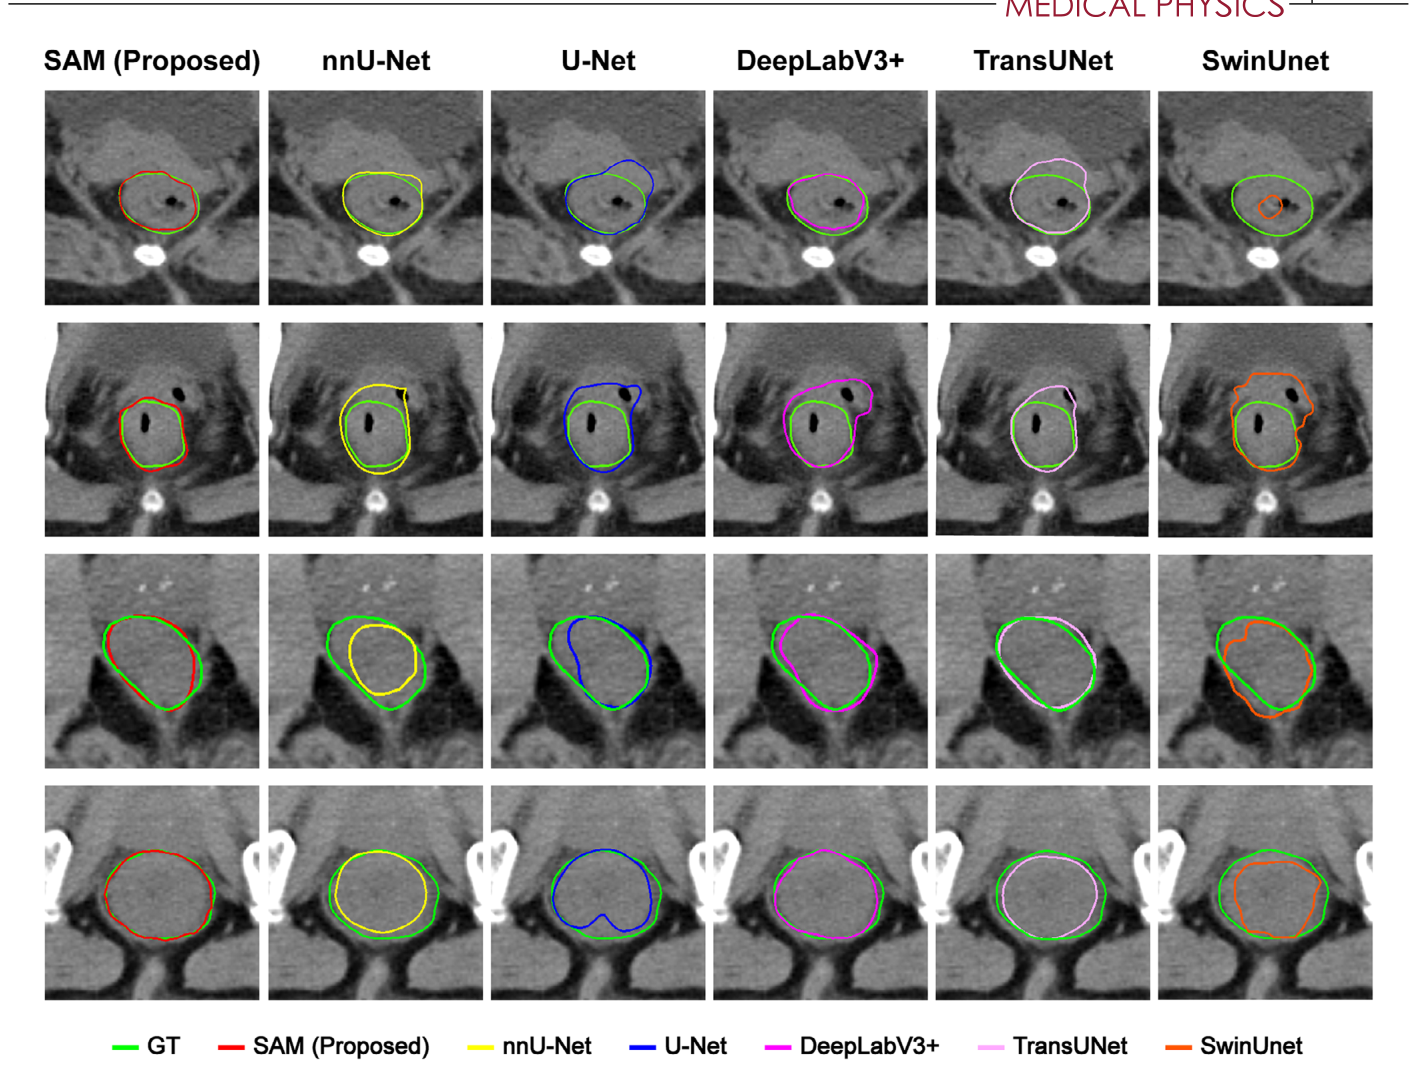
視覚的な比較でも、SAMによって生成された輪郭はゴールデンスタンダード(最も信頼できる基準)と優れた一致を示した一方、比較モデルには明らかな不一致が見られました。特に、境界が不明瞭な症例や、標的領域が不規則な形をしている症例、あるいは一般的な症例よりも標的領域が大きい症例では、ベースラインモデルは過剰セグメンテーション(実際の領域よりも大きくセグメンテーションしてしまうこと)や過小セグメンテーション(実際の領域よりも小さくセグメンテーションしてしまうこと)の誤差を示しました。
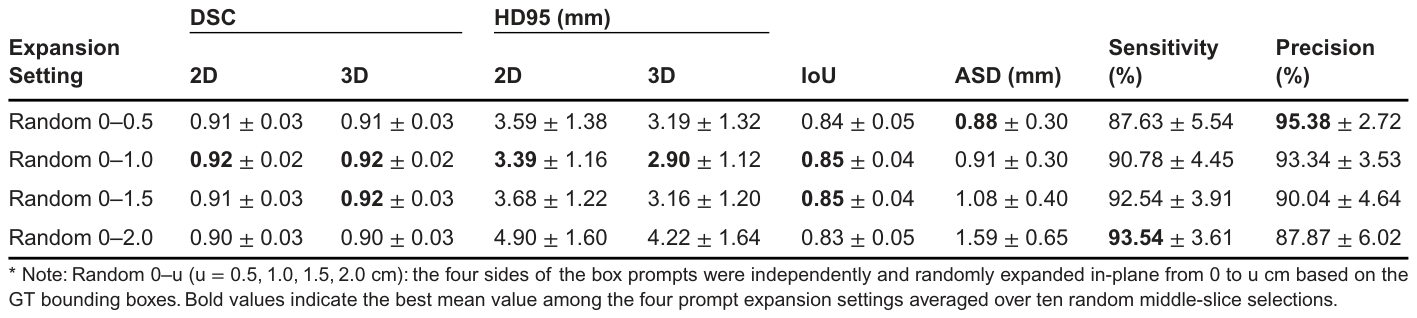
提案されたワークフローのプロンプトの変動に対するロバスト性を評価するため、中間スライスの選択と関連するボックスプロンプトの変動をシミュレートするランダム化テスト(無作為に条件を変化させる試験)を実施しました。ランダム0-1.0cmの設定では、DSCとIoUが最も高く、HD95が最も低いという、指標全体でバランスの取れた性能が示されました。これは、ワークフローがプロンプトの変動に対してロバストであり、高度に標準化されたプロンプトを必要とせずに臨床応用を促進する可能性を示唆しています。
研究の限界と今後の展望
本研究は単一施設での検討であり、サンプルサイズが限られているといういくつかの制限があります。今後の研究では、研究コホート(共通の特性を持つ集団)を拡大し、外部バリデーション(妥当性検証)を実施して、提案されたワークフローの汎化可能性(未知のデータに対する適用能力)をより良く評価する必要があります。また、後方視的データ収集の制約により、本研究のCT画像は2種類の異なるスキャナー(画像診断装置)から取得されました。スキャナーのベンダー(製造元)や取得プロトコル(画像撮影の手順)の違いが画像テクスチャやモデル性能に影響を与える可能性があります。より標準化された画像取得プロトコルは、このような変動を低減するのに役立つでしょう。さらに、ベースラインSAMは2Dセグメンテーションモデルです。本研究では、スライス間補間戦略を採用し、良好な体積評価結果を達成しましたが、一部の症例ではスライス間の連続性が不十分であったり、輪郭の滑らかさが劣るという問題が依然として存在する可能性があります。最近では、SAM2やMedSAMなどの新しいバリアント(派生モデル)も登場しています。今後の研究では、これらの新しいバリアントを調査し、3Dインタラクティブセグメンテーションフレームワークを探求することが考えられます。最後に、プロンプトの変動はシミュレートされましたが、プロンプトの各辺の拡張距離が専門家間変動(異なる専門家間での作業結果のばらつき)と一致するかどうかは、さらに評価されるべきです。また、すぐに利用できるインタラクティブなインターフェース(操作画面)がないため、全てのテストはコードレベルで実施されました。今後の研究では、インタラクティブなインターフェースを開発し、複数の専門家間の変動と実際のインタラクション効率を評価することが期待されます。
結論
提案されたSAM駆動型のプロンプト誘導対話型ワークフローは、最小限の専門家の操作で、直腸がんのGTV輪郭描出を正確かつロバストに実行可能であることを示しました。わずか3つのバウンディングボックスプロンプトで、このワークフローは従来の深層学習モデルと比較して優れた精度を達成し、放射線治療における標的輪郭描出の実用的な応用への可能性と実現可能性を実証しました。
用語集
- 手動による輪郭描出: 医療画像上で対象物の境界線を専門家が手作業で引くこと。
- 深層学習: 機械学習の一種で、多層のニューラルネットワークを用いてデータから特徴を自動的に学習し、高精度な予測や判断を行う技術。
- プロンプト: AIモデルに与える指示や情報のこと。
- 事前知識: モデルが学習や推論を行う前に、あらかじめ持っている情報や傾向のこと。
- セグメンテーション: 画像内で特定の物体や領域を画素単位で識別・分離すること。
- Segment Anything Model(SAM): Meta AIによって開発された、プロンプトに基づいて画像内のあらゆるオブジェクトをセグメンテーションできる大規模視覚モデル。
- 点: プロンプトとして使用される、画像上の特定の座標。
- バウンディングボックス: 画像内の対象物を囲む四角い枠。
- マスクプロンプト: セグメンテーションしたい領域の輪郭の一部や、大まかな形状を示すプロンプト。
- インタラクション: 人間がモデルに情報を与える操作や、モデルからの応答。
- モダリティ: 医療画像診断における検査手法や画像の種類(例: CT、MRI)。
- リスク臓器: 放射線治療において、放射線の影響を受けやすく、保護する必要がある正常な臓器(OARと略される)。
- ワークフロー: 一連の作業手順や業務の流れ。
- 対話型輪郭描出ワークフロー: 専門家とAIモデルが対話(情報のやり取り)しながら、対象物の輪郭を描出する一連の作業手順。
- 医療記録: 対象者の診察記録、診断画像、検査結果などの医療に関するあらゆる情報。
- トレーニング: AIモデルにデータを与えて学習させるプロセス。
- テスト: 学習済みのAIモデルが、未知のデータに対してどれだけ正確な予測や判断ができるかを評価すること。
- バウンディングボックスプロンプト: セグメンテーションモデルに、対象物の大まかな位置や範囲を四角い枠で指示すること。
- 補間戦略: 既知のデータ点(この場合は手動で描画されたプロンプト)の間に位置する未知のデータ点(中間スライスのプロンプト)を推定する方法。
- 輪郭: 画像内で対象となる領域の境界線。
- ファインチューニング戦略: 大規模なデータセットで事前学習されたAIモデルを、特定のタスクや小規模なデータセットに合わせて再調整(微調整)する方法。
- 画像エンコーダー: SAMの構成要素の一つで、入力画像を数値的な特徴表現に変換する部分。
- マスクデコーダー: SAMの構成要素の一つで、画像エンコーダーから得られた特徴表現とプロンプト情報から、最終的なセグメンテーションマスク(輪郭)を生成する部分。
- 最先端(SOTA)モデル: 特定のタスクにおいて、その時点で公表されている中で最高の性能を持つとされているAIモデル。
- マージン: バウンディングボックスが対象領域の境界からどれだけ離れて設定されているかという、ゆとりの度合い。
- ロバスト性: AIモデルが、入力データの変動やノイズ、未知の状況に対して、安定して良い性能を保つ能力。
- 拡張値: バウンディングボックスの各辺を、元のサイズからどれだけ広げるかを示す数値。
- 耐性: AIモデルが特定の変化や誤差に対してどれだけ許容できるかという度合い。
- 背景情報: 画像内で、セグメンテーションの対象となる物体や領域以外の部分の情報。
- LoRA: Low-Rank Adaptationの略で、大規模なAIモデルを効率的にファインチューニング(微調整)する手法の一つ。
- 過学習: AIモデルがトレーニングデータに過度に適応しすぎてしまい、未知の新しいデータに対しては性能が低下してしまう現象。
- 手掛かり: AIモデルがセグメンテーションを行う際に、判断の参考となる情報やヒント。
- U-Net: 生物医学画像セグメンテーションのために設計された、畳み込みニューラルネットワーク(CNN)ベースのAIモデル。
- DeepLabV3+: Googleが開発したセマンティックセグメンテーション(画像内の各ピクセルを特定のカテゴリに分類するタスク)のための深層学習モデル。
- nnU-Net: 自己設定型の深層学習ベース医療画像セグメンテーション手法で、さまざまな医療画像セグメンテーションタスクで高い性能を示す。
- TransUNet: U-NetアーキテクチャにTransformerを組み合わせ、医療画像セグメンテーションの性能向上を目指したモデル。
- SwinUnet: Swin TransformerをベースにしたU-Net型のモデルで、医療画像セグメンテーションに用いられる。
- ベースライン: 比較の基準となる、標準的または基本的な性能や手法。
- 3D DSC: 3次元Dice類似度係数。予測されたGTVと実際のGTVの3次元的な重なりを評価する指標で、1に近いほど精度が高い。
- 3D HD95: 3次元95パーセンタイル Hausdorff距離。予測されたGTVと実際のGTVの境界間の距離の95パーセンタイル値で、小さいほど境界が正確。
- IoU: Intersection over Union。予測領域と実際の領域の重なり具合を評価する指標で、1に近いほど精度が高い。
- 感度: 真の陽性(実際に腫瘍である部分)のうち、モデルが正しく腫瘍と識別できた割合を示す指標。
- 適合率: モデルが陽性(腫瘍)と予測した部分のうち、実際に腫瘍であった割合を示す指標。
- ゴールデンスタンダード: 最も信頼できる、あるいは基準となるデータや測定値。この研究では、専門家が手動で描出したGTVの輪郭がこれに相当します。
- 過剰セグメンテーション: AIモデルが、実際の対象領域よりも大きくセグメンテーションしてしまい、背景の一部を誤って含んでしまう現象。
- 過小セグメンテーション: AIモデルが、実際の対象領域よりも小さくセグメンテーションしてしまい、対象の一部を検出できない現象。
- ランダム化テスト: 複数の条件を無作為に(ランダムに)設定して、それぞれの効果を評価する試験方法。
- コホート: 共通の特性を持つ集団。
- バリデーション: AIモデルや手法の妥当性(有効性や正確性)を検証すること。
- 汎化可能性: AIモデルが、トレーニングで使われなかった新しいデータや異なる状況に対しても、どれだけ正確な性能を発揮できるかという能力。
- スキャナー: 医療画像診断に使用される装置(例: CTスキャナー)。
- ベンダー: 製品やサービスを提供する企業や製造元。
- 取得プロトコル: 医療画像を撮影する際の手順や設定の標準化されたガイドライン。
- バリアント: 既存のモデルを基に、改良や変更を加えて開発された派生モデル。
- 3Dインタラクティブセグメンテーションフレームワーク: 専門家が操作しながら、3次元の医療画像データに対してセグメンテーションを行うためのAIシステム。
- 専門家間変動: 複数の専門家が同じタスク(例: 輪郭描出)を行った際に生じる、結果のばらつきや不一致のこと。
- インターフェース: ユーザーがAIシステムを操作するための画面や操作環境。
コメントを残す