
糖尿病合併敗血症における院内死亡を機械学習で予測:SOFAスコアを上回る精度
解説対象論文: Application of machine learning prediction models for in-hospital mortality in diabetic sepsis patients: a study based on the MIMIC IV database
BMC Medical Informatics and Decision Making|被引用数: 0(2026年10月23日時点)
重症集中治療室(ICU)における糖尿病合併敗血症は、罹患率と死亡率が高い深刻な病態です。この複雑な対象者集団において院内死亡を正確に予測することは、最適な意思決定、資源配分、対象者管理戦略のために極めて重要です。本研究では、機械学習モデルが従来のスコアリングシステムであるSOFAスコアよりも高い精度で院内死亡を予測できる可能性を示しました。
はじめに:糖尿病合併敗血症という深刻な課題
どうも、Beyond the Pixelです。集中治療室(ICU)において、糖尿病を合併した敗血症は、罹患率と死亡率が非常に高く、臨床現場で大きな課題となっています。この複雑な病態は、二つの主要な健康問題が絡み合うことで、対象者の予後を予測することを難しくしています。最近の世界的な推定では、敗血症は毎年約4890万人に影響を与え、1100万人もの死亡につながっているとされています。敗血症の対象者のうち、糖尿病の有病率は17%から30%に及び、これらの疾患が頻繁に併存していることが、この特定の対象者集団への対応が重要であることを示しています。糖尿病は免疫機能を変え、感染症や敗血症への生体反応を変化させる可能性があり、診断、治療、予後予測において独自の課題をもたらします。糖尿病に特徴的な血糖調節異常は、敗血症で見られる代謝異常を悪化させ、より重篤な臓器機能不全につながる可能性があります。このような背景から、糖尿病合併敗血症の対象者における院内死亡を正確に予測することは、専門家による意思決定の最適化、資源配分、そして対象者管理戦略の改善に不可欠です。従来のスコアリングシステムであるSOFAスコア(Sequential Organ Failure Assessment score:集中治療室における臓器機能不全の程度を評価するためのスコア)は、敗血症のリスク層別化に広く用いられてきましたが、限られた変数に依存しているため、敗血症と糖尿病の複雑な相互作用を十分に捉えきれない可能性があります。近年、機械学習(データからパターンを学習し、予測や意思決定を行う人工知能の一分野)アプローチは、様々な臨床シナリオにおいて予後予測を改善する可能性を示しています。本研究チームは、MIMIC-IVデータベース(Medical Information Mart for Intensive Care IV database:米国のICU入院対象者の匿名化された詳細な臨床データ集)を用いて、この課題に取り組むため、糖尿病合併敗血症のICU対象者における院内死亡を予測する機械学習モデルを開発し、その有用性を検証しました。
研究方法:MIMIC-IVデータによる詳細な分析
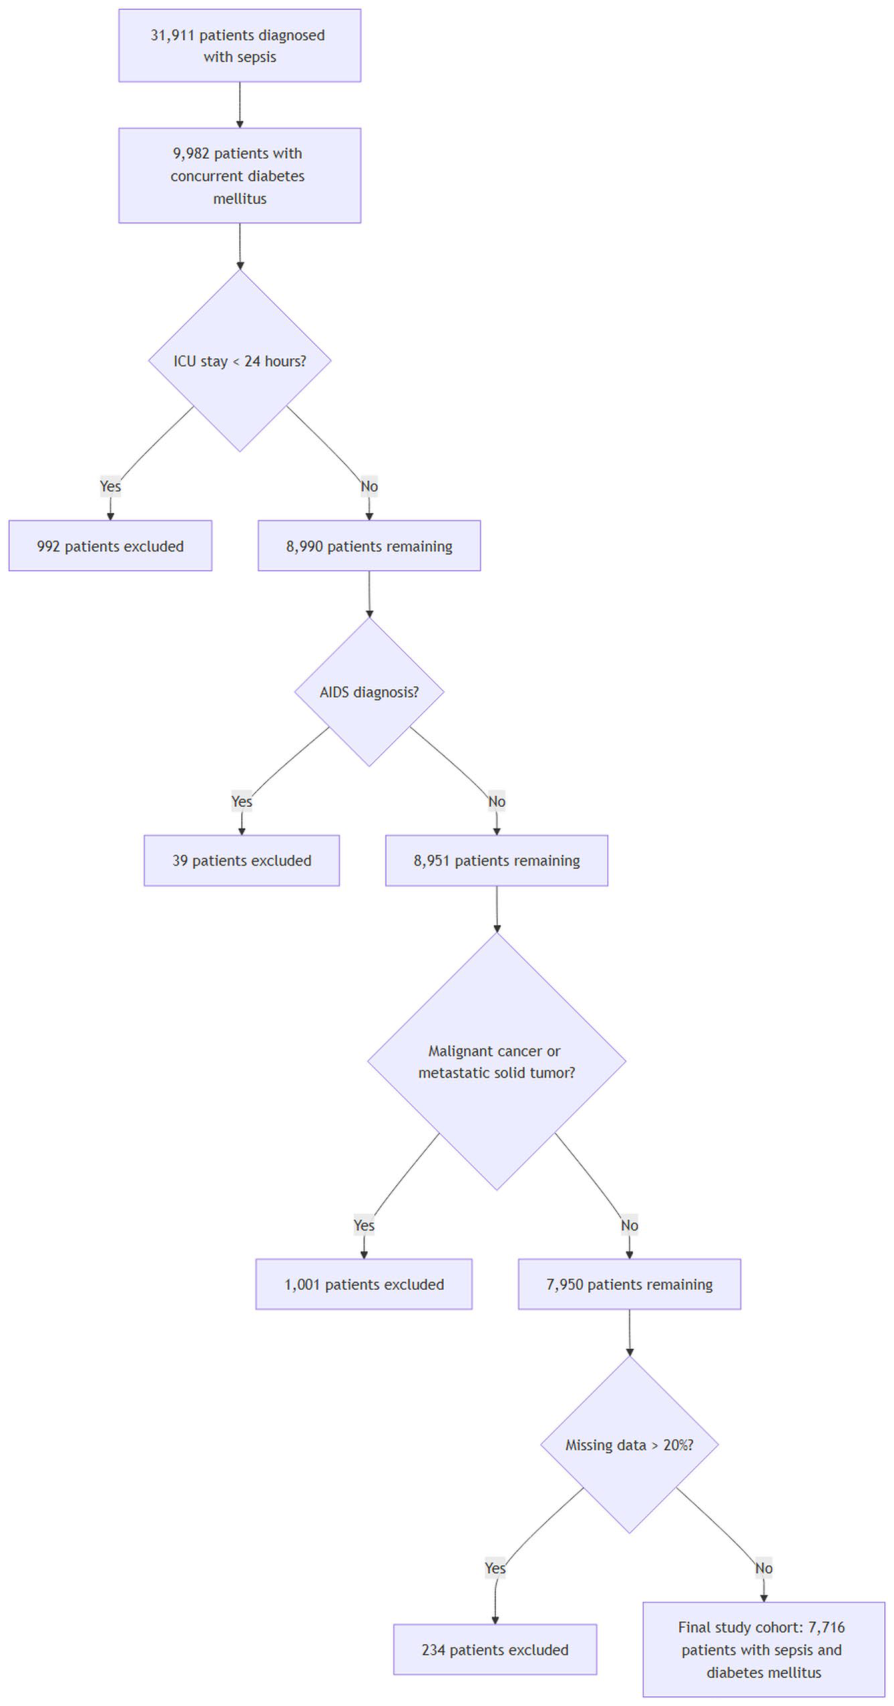
この研究は、MIMIC-IVデータベースを利用したレトロスペクティブコホート研究(Retrospective Cohort Study:過去のデータを用いて特定の要因と結果の関係を調べる研究デザイン)として実施されました。対象者は、敗血症(Sepsis:感染症に対する生体反応が過剰になり、自身の臓器や組織を損傷する状態)と糖尿病(Diabetes Mellitus:血糖値が高い状態が慢性的に続く疾患)の両方の診断を受けた成人ICU対象者でした。ICU滞在が24時間未満の対象者、18歳未満の対象者、妊娠中の女性、AIDS、悪性腫瘍、または転移性固形腫瘍の診断を受けた対象者は除外されました。また、分析対象の変数に20%を超える欠損データがある対象者も除外されました。最終的に、7716人の対象者が研究コホートに含まれました。
このデータは、ICU入室後の最初の24時間以内に収集された包括的な臨床データで構成されています。これには、年齢、性別、ボディマス指数(BMI)などの人口統計学的変数、心不全や高血圧などの併存疾患、クレアチニン、電解質、乳酸などの検査結果、そしてSOFAスコアなどの疾患重症度指標が含まれます。データセットは、訓練コホート(70%)と検証コホート(30%)にランダムに分割され、欠損値はランダムフォレストアルゴリズムに基づく多重補完技術を用いて処理されました。著者らは、以下の6つの機械学習アルゴリズムを評価しました:Logistic Regression (LR:ロジスティック回帰、二値分類問題に用いられる統計モデル)、K-Nearest Neighbors (KNN:K近傍法、データ間の距離に基づいて分類する非線形モデル)、Random Forest (RF:ランダムフォレスト、複数の決定木を組み合わせて予測するアンサンブル学習モデル)、Gradient Boosting Decision Tree (GBDT:勾配ブースティング決定木、弱い予測器を順次学習して精度を高めるアンサンブル学習モデル)、XGBoost (eXtreme Gradient Boosting:GBDTを高速化・高精度化したアルゴリズム)、そしてLightGBM (Light Gradient Boosting Machine:XGBoostをさらに高速化・大規模データに対応させたアルゴリズム)。これらのモデルの予測性能は、従来のSOFAスコアと比較されました。モデルの識別能力は、AUC-ROC(Area Under the Receiver Operating Characteristic Curve:モデルの識別能力を示す評価指標で、値が高いほど性能が良い)を用いて定量化され、モデルの解釈可能性を高めるために、SHAP値(SHapley Additive exPlanations values:機械学習モデルの予測において、各特徴量がどの程度寄与しているか、その影響度を説明するための値)が用いられました。
主要な研究結果:機械学習モデルの優れた予測性能
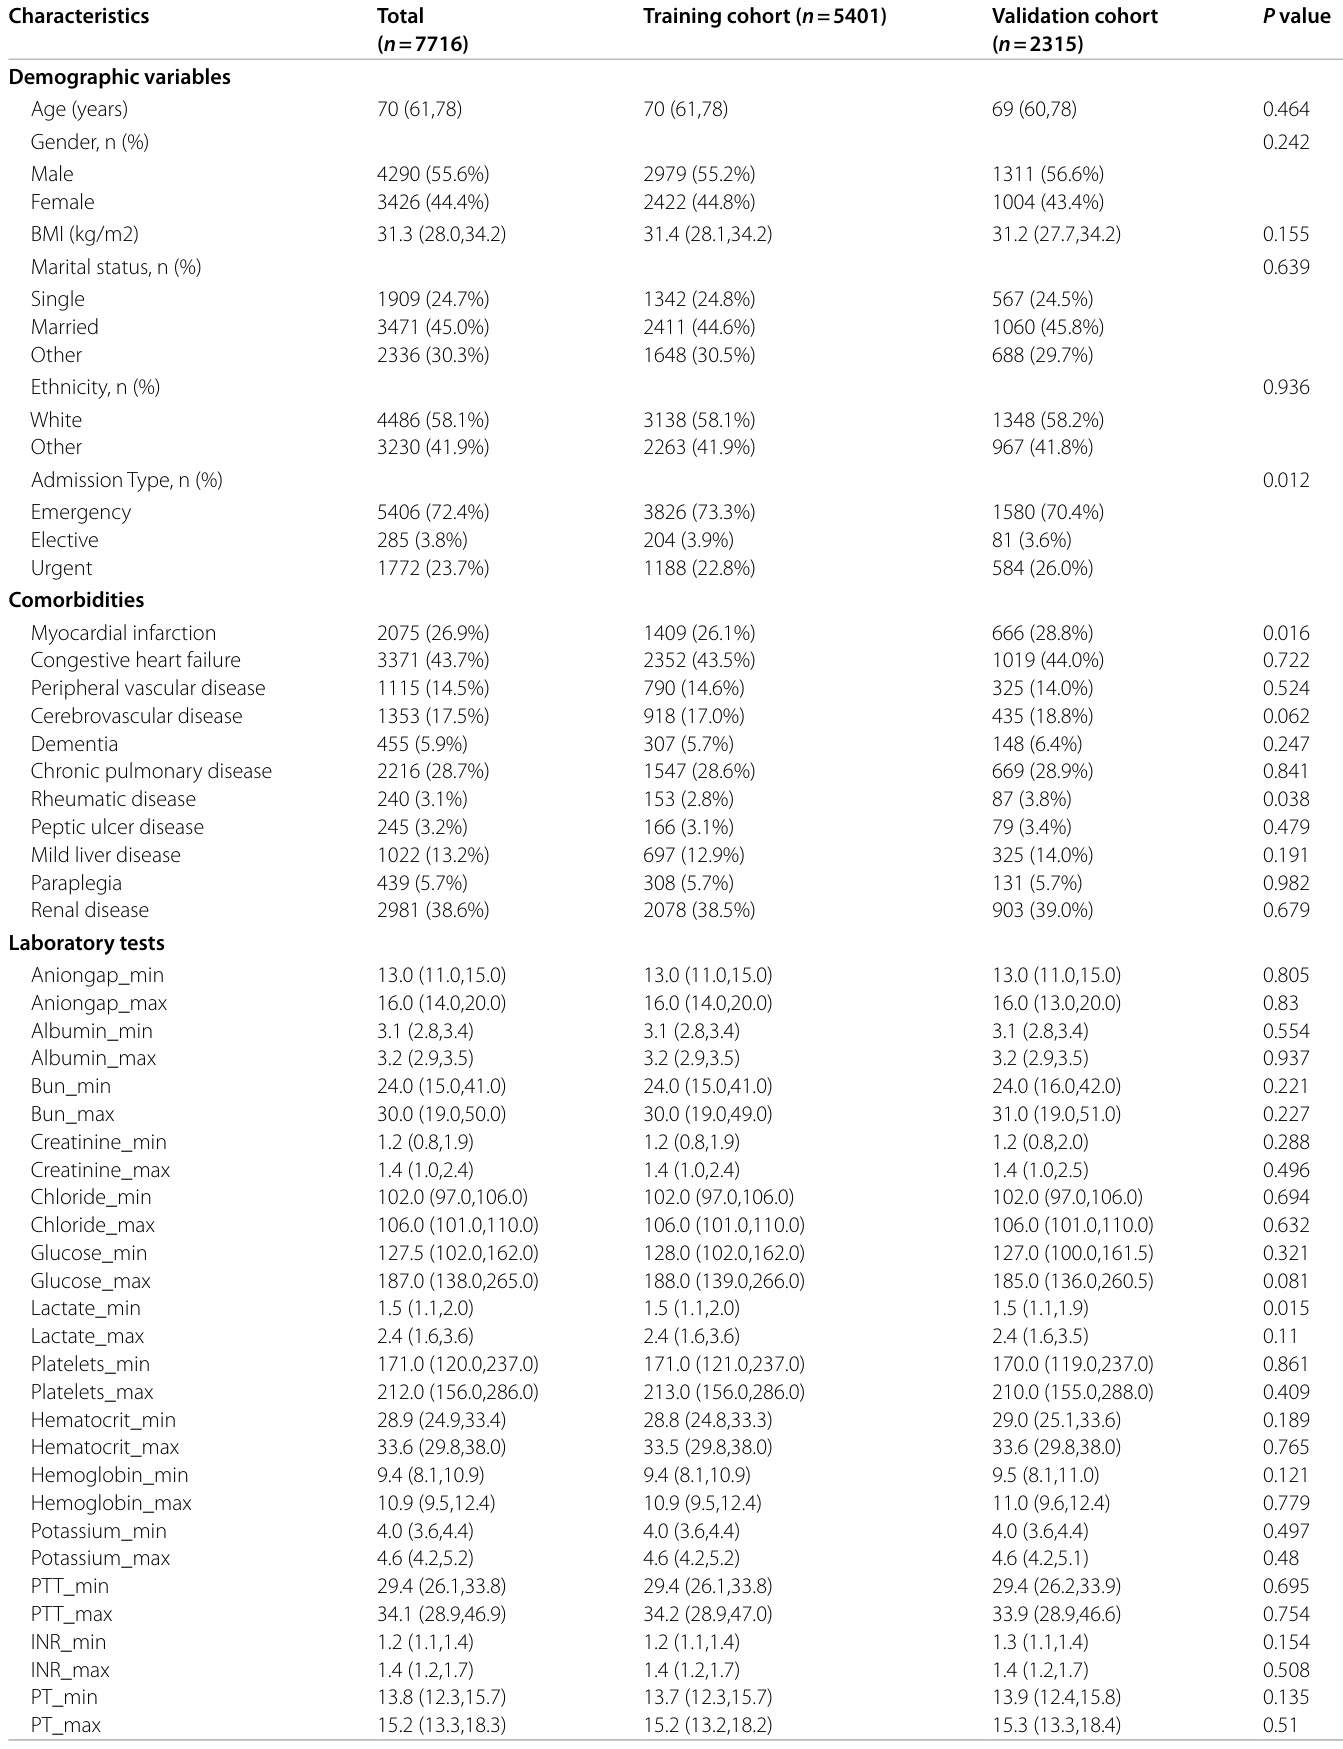
研究コホートの7716人の対象者のうち、1357人(17.6%)が院内死亡を経験しました。訓練コホートと検証コホートの間で、人口統計、併存疾患、検査値などのベースライン特性は類似しており、ランダム化が成功したことを示しています。
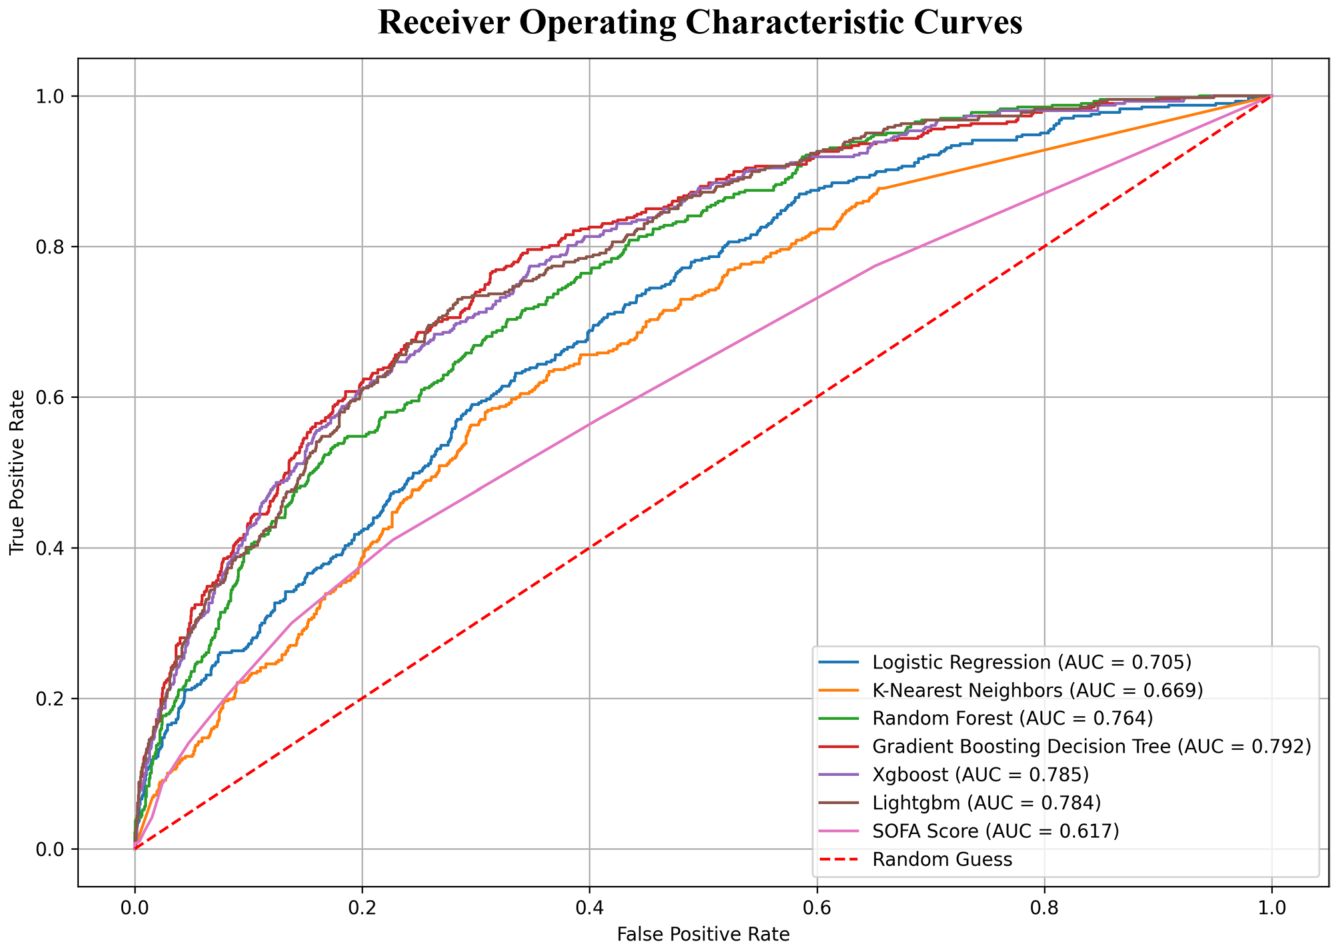
評価された機械学習モデルの中で、GBDTモデルが最も優れた予測性能を示し、AUC値は0.792(95%信頼区間:0.769–0.814)を達成しました。この性能は、他の機械学習アルゴリズムと従来のSOFAスコア(AUC 0.617、95%信頼区間:0.587–0.647)を上回るものでした。
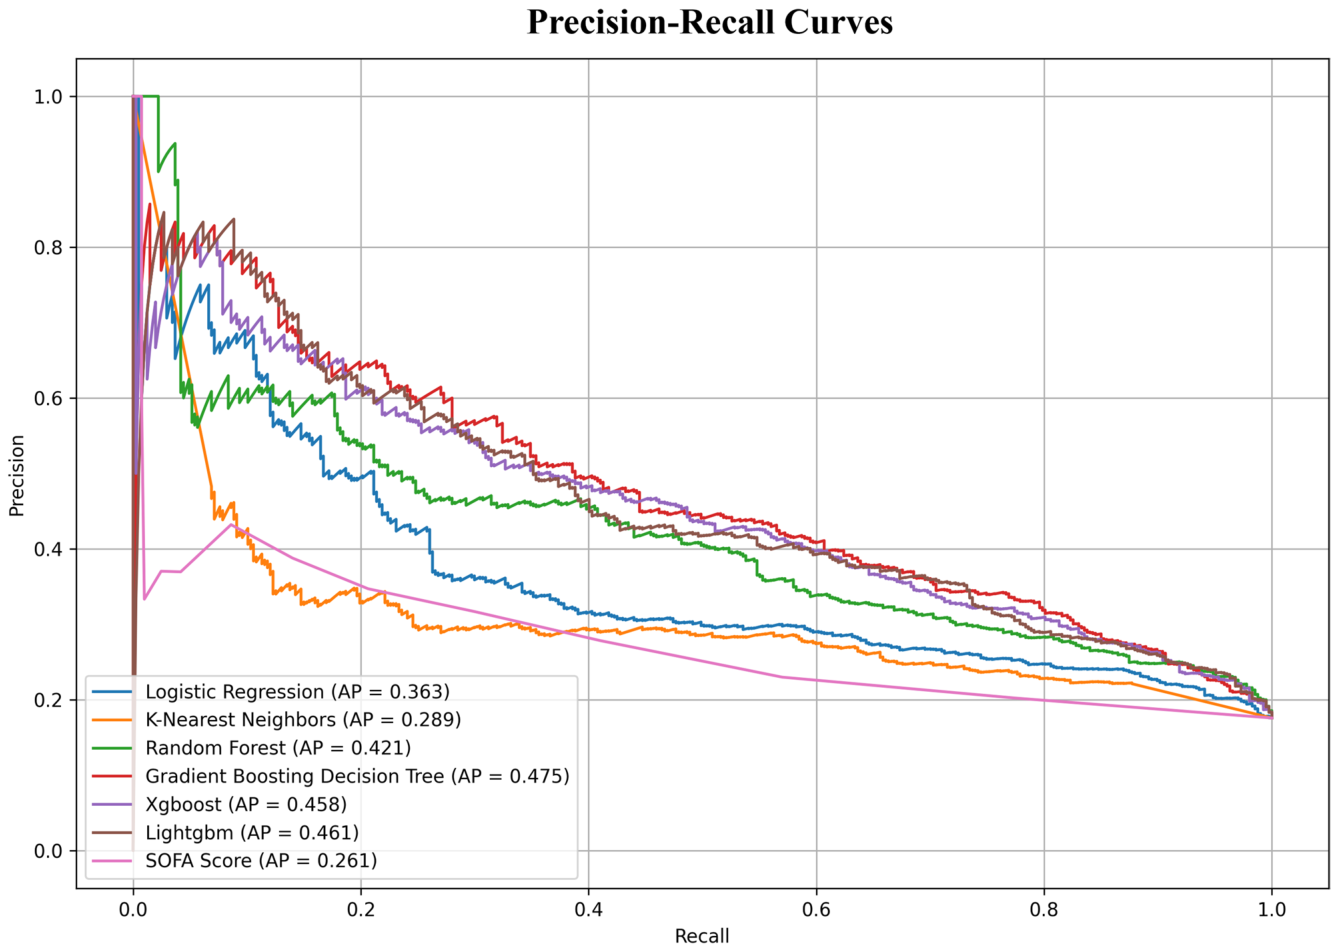
また、Precision-Recall曲線でもGBDTモデルは優れた性能(AP=0.475)を示し、XGBoost(AP=0.458)、LightGBM(AP=0.461)がそれに続きました。
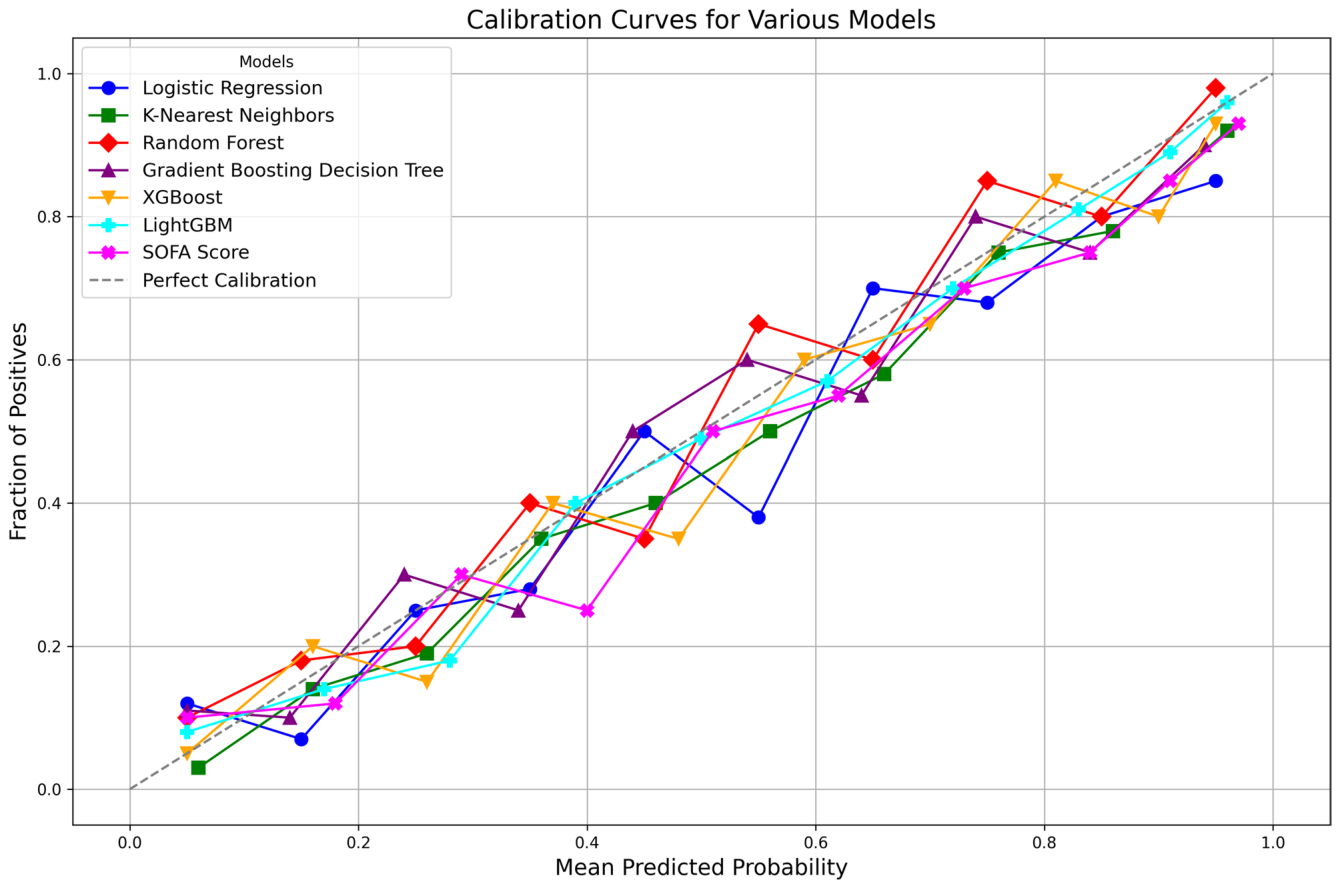
モデルのキャリブレーション曲線(Calibration Curve:予測確率と実際の結果の一致度を示すグラフ)は、機械学習モデルによって導き出された院内死亡の予測確率と実際のアウトカムとの間に良好な一致があることを示しており、特にGBDT、XGBoost、LightGBMモデルは理想的なキャリブレーションラインに密接に追従していました。
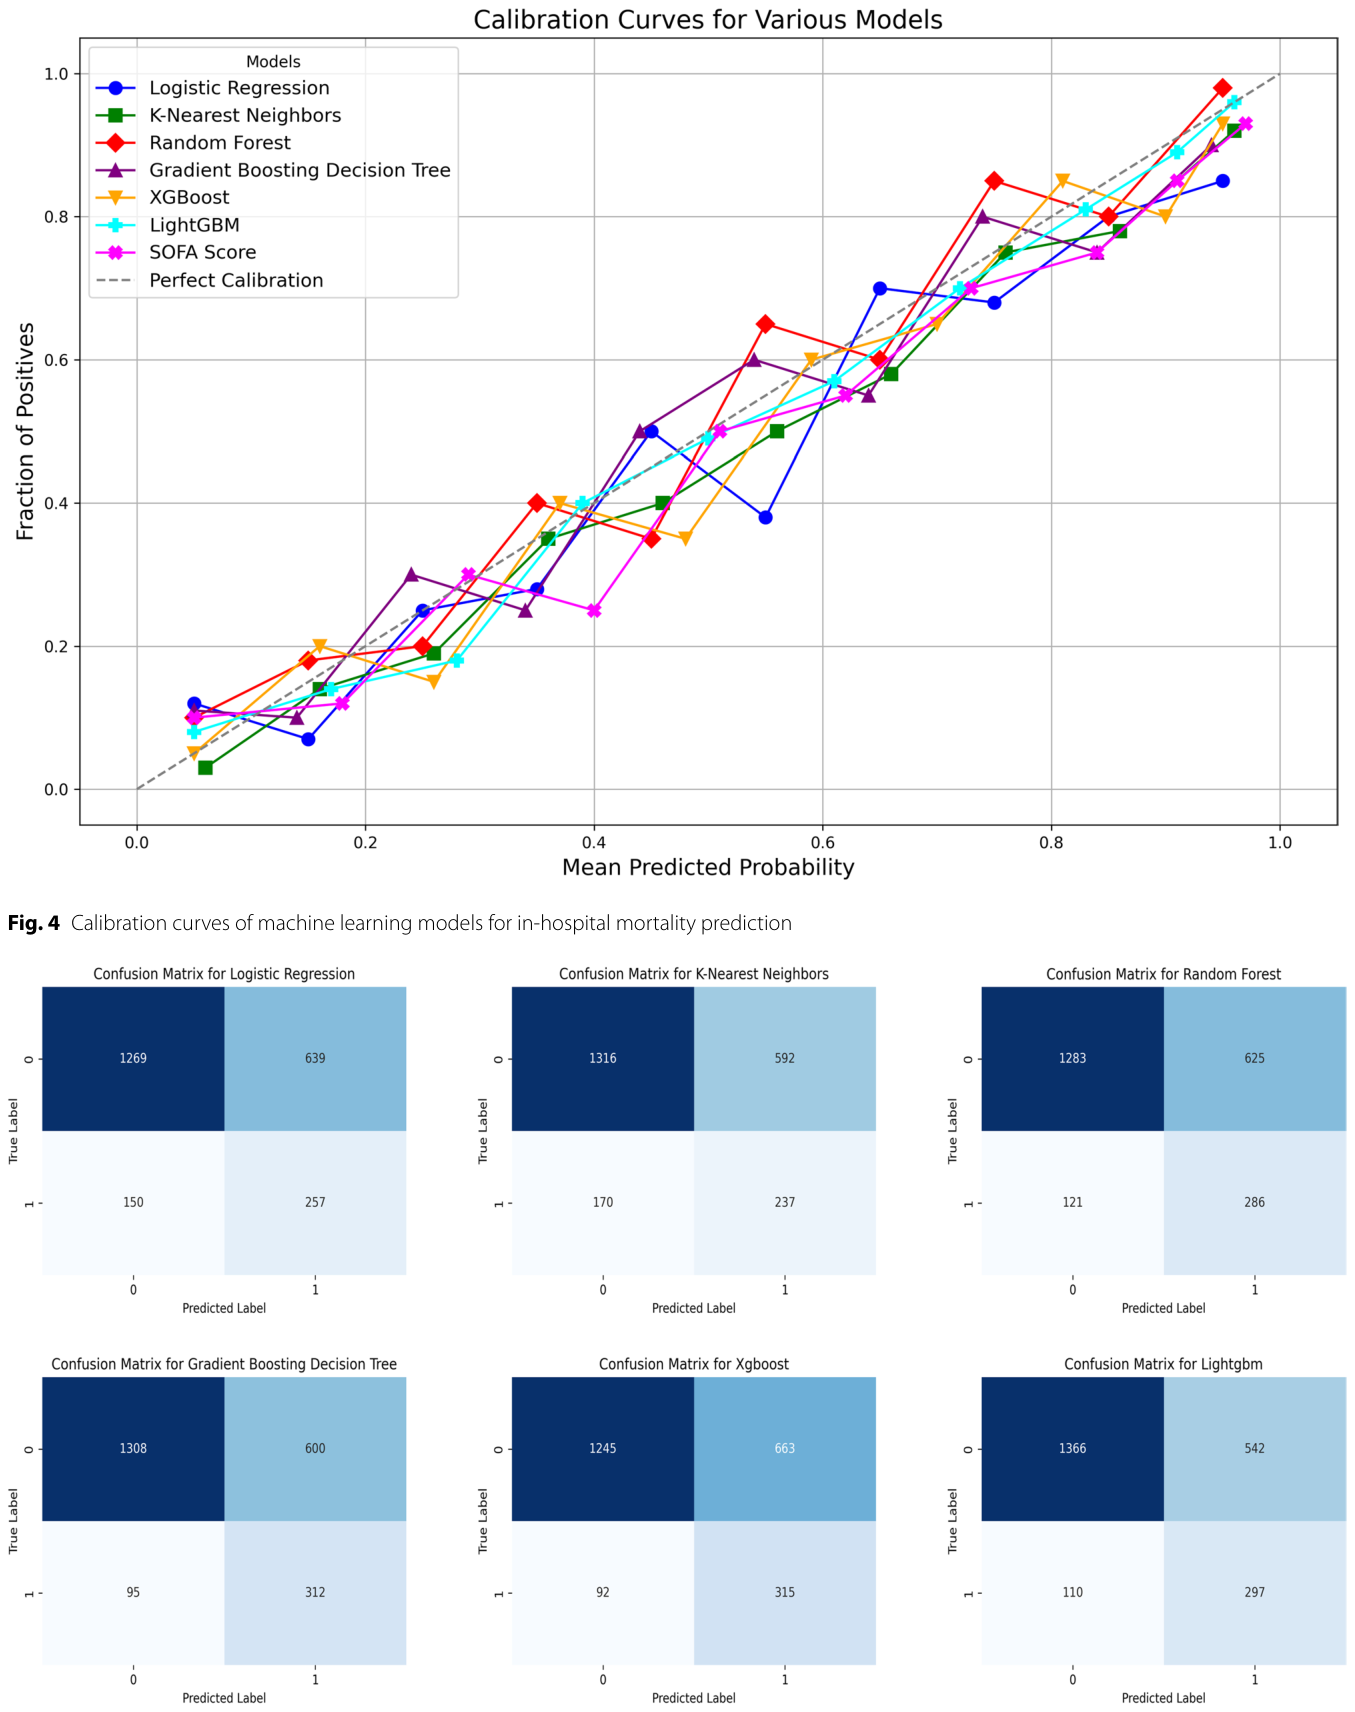
各機械学習モデルの混同行列も提示され、真陽性、真陰性、偽陽性、偽陰性の観点から分類性能が詳細に示されています。
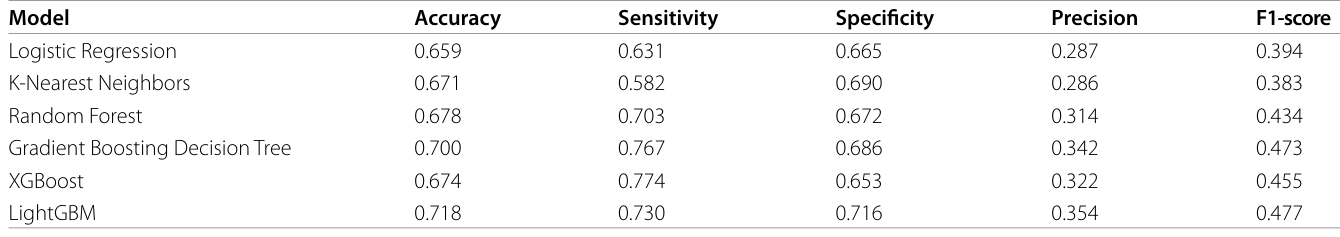
検証コホートにおけるモデルの閾値依存性評価指標(感度、特異度、適合率、F1スコア)も報告され、LightGBMが最も高いF1スコア(0.477)を示しました。
SHAP分析(
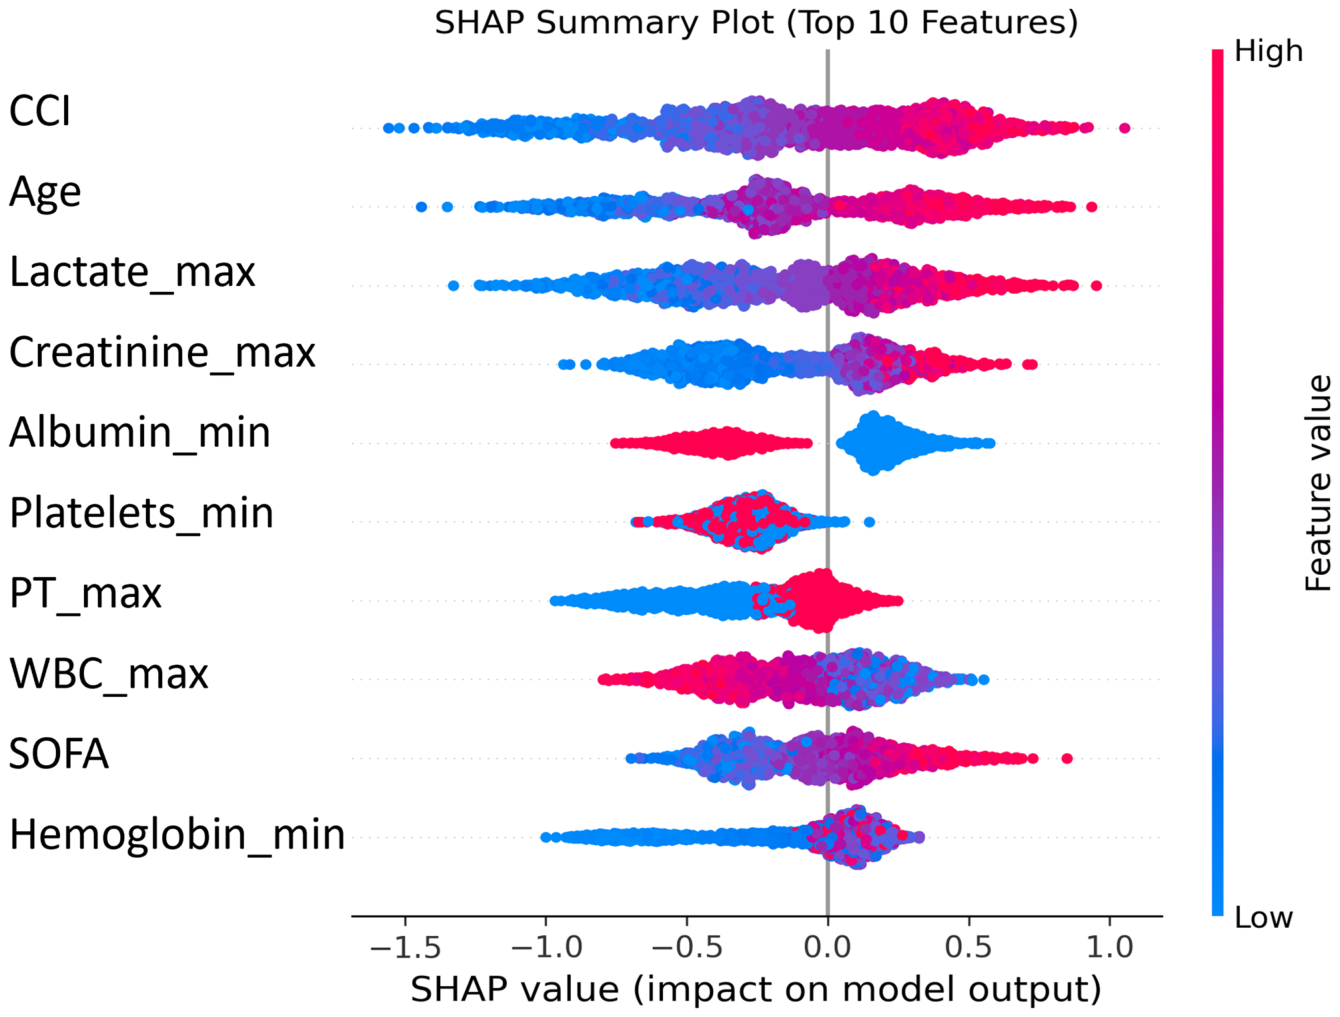
)は、GBDTモデルの予測に寄与する臨床的および人口統計学的特徴の相対的な重要性について貴重な洞察を提供しました。最も影響力のある予測因子として特定されたのは、Charlson Comorbidity Index (CCI:チャールソン併存疾患指数、対象者の持つ併存疾患の数を重み付けして、10年生存率を予測するスコア) であり、スコアが高いほど死亡リスクが増加することを示しました。年齢も重要な因子として挙げられ、高齢の対象者ほど死亡の可能性が高いことが示されました。SOFAスコアの上昇、最大乳酸値、最大クレアチニン値の上昇、最大プロトロンビン時間(PTT)の延長も重要な予測因子であり、これら全てが院内死亡リスクの増加と関連していました。SHAP分析では、最小アルブミン値の低下、最小血小板数(Platelets_min)の減少も高い死亡率と関連する有意な因子として強調されました。最大白血球数(WBC_max)と死亡率の関係は複雑で、非常に高い値と非常に低い値の両方が死亡リスクの増加と関連する可能性が示されました。さらに、最小ヘモグロビン値(Hemoglobin_min)も死亡リスクに微妙な影響を示すことが明らかになりました。これらのSHAP値は、GBDTモデルの予測に寄与する臨床的特徴の階層的意義を深く理解することを可能にしました。
考察と今後の展望:臨床応用への期待と課題
この研究は、機械学習モデル、特にGBDTモデルが、糖尿病合併敗血症の対象者における院内死亡予測において優れた性能を示すことを明らかにしました。これらの先進的な分析技術は、従来のSOFAスコアを大きく上回り、この複雑な対象者集団における予後予測を強化し、臨床意思決定と資源配分を改善する可能性を強調しています。SHAP分析は、CCI、年齢、最大乳酸、最大クレアチニン、最小アルブミン、最小血小板数、最大プロトロンビン時間、最大白血球数、SOFAスコア、最小ヘモグロビンといった、院内死亡の最も影響力のある予測因子について重要な洞察を提供しました。これらの因子は、併存疾患の負担、年齢、組織の低灌流、腎機能障害、栄養状態、血液凝固異常、炎症反応、貧血といった、クリティカルな対象者における死亡率を決定する主要な要因を反映しています。著者らは、ルーチンで収集される変数をモデルに使用しているため、既存の電子医療記録システムへの統合が容易であると述べています。実世界の状況では、モデルはICUデータが利用可能になった24時間後に個別の院内死亡リスク推定値を生成し、日々の回診中にこの情報を表示することで、早期のリスク層別化とモニタリングおよび臓器サポートの強化を支援する自動意思決定支援ツールとして機能する可能性があります。しかし、この研究にはいくつかの重要な課題とバイアスの源があることも認識されています。GBDTのような複雑なモデルの解釈可能性は主要な課題であり、SHAP値が特徴量の寄与に関する洞察を提供するものの、これらのモデルを専門家にとって十分に透過的で受け入れられるものにするためには、さらなる研究が必要です。また、MIMIC-IVデータベースが単一施設のものであるため、結果の一般化可能性に限界があります。ケースミックス、診療パターン、データ収集プロセスは、他の医療施設やシステムで大幅に異なる可能性があります。モデルは内部検証のみで評価されており、外部集団に適用された場合の性能とキャリブレーションは変化する可能性があります。したがって、現在の結果は仮説生成的なものと見なされるべきであり、MIMIC-IVコホートと同様の環境に主に適用可能であると考える必要があります。今後の研究では、多施設共同の外部検証と、実際のワークフローに組み込まれた場合の臨床プロセスおよびアウトカムへの影響の正式な評価、そしてエンドユーザーのための解釈可能性を高めるさらなる取り組みが優先されるべきです。リアルタイムでのベッドサイド使用を評価する前向き研究も必要とされています。
用語集
- 敗血症: 感染症に対する生体反応が過剰になり、自身の臓器や組織を損傷する状態
- 糖尿病: 血糖値が高い状態が慢性的に続く疾患
- MIMIC-IVデータベース: 米国のICU入院対象者の匿名化された詳細な臨床データ集
- SOFAスコア: 集中治療室における臓器機能不全の程度を評価するためのスコア
- AUC: モデルの識別能力(正しく判別する能力)を示す評価指標で、値が高いほど性能が良い
- SHAP値: 機械学習モデルの予測において、各特徴量がどの程度寄与しているか、その影響度を説明するための値
- レトロスペクティブコホート研究: 過去のデータを用いて特定の要因と結果の関係を調べる研究デザイン
- 機械学習: データからパターンを学習し、予測や意思決定を行う人工知能の一分野
- Logistic Regression (LR): ロジスティック回帰、二値分類問題に用いられる統計モデル
- K-Nearest Neighbors (KNN): K近傍法、データ間の距離に基づいて分類する非線形モデル
- Random Forest (RF): ランダムフォレスト、複数の決定木を組み合わせて予測するアンサンブル学習モデル
- Gradient Boosting Decision Tree (GBDT): 勾配ブースティング決定木、弱い予測器(決定木)を順次学習して精度を高めるアンサンブル学習モデル
- XGBoost: GBDTを高速化・高精度化したアルゴリズム
- LightGBM: XGBoostをさらに高速化・大規模データに対応させたアルゴリズム
- Charlson Comorbidity Index (CCI): チャールソン併存疾患指数、対象者の持つ併存疾患の数を重み付けして、10年生存率を予測するスコア
- 感度: 実際に陽性であるものを陽性と正しく予測する割合
- 特異度: 実際に陰性であるものを陰性と正しく予測する割合
- 適合率: 陽性と予測されたもののうち、実際に陽性であった割合
- F1スコア: 適合率と感度の調和平均で、モデルのバランスの取れた性能を示す指標
- キャリブレーション曲線: 予測確率と実際の結果の一致度を示すグラフ
コメントを残す