
医療画像AIの未来を拓く:ワールドモデルの信頼性検証フレームワーク
解説対象論文: Toward Verifiable Medical Imaging World Models: An Engineering Framework for Evaluating Simulation Fidelity, Roll-Out Stability, and Clinical Plausibility
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年10月23日時点)
医療画像AIの進化は目覚ましく、単一の画像診断から、時間とともに変化する対象者の状態を予測し、治療介入の影響をシミュレーションする「ワールドモデル」へと関心が広がっています。しかし、その革新的な可能性を最大限に引き出すためには、モデルの予測が本当に信頼できるのか、どのように評価すればよいのかという根源的な問いに答える必要があります。本記事では、この重要な課題に取り組んだ最新の研究に基づき、医療画像ワールドモデルの信頼性を検証するための体系的なフレームワークとその評価基準について、専門家目線で深掘りします。
進化する医療画像AI「ワールドモデル」
どうも、Beyond the Pixelです。医療現場では、腫瘍の経過観察、以前の画像との比較による胸部X線読影、手術の進行状況を捉える連続的なビデオストリームなど、画像診断は本質的に時間経過を伴うプロセスです。しかし、これまでの多くの機械学習システムは、静的な画像から診断やリスクスコアを導き出すものが主流でした。つまり、「画像の状態が時間とともにどう変化するか」、そして「治療介入がその変化をどう変えるか」という、臨床的に極めて重要な問いに直接答えることはできませんでした。このギャップを埋めるために注目されているのが、「ワールドモデル」という新しいAIモデルのパラダイムです。これは、対象者の画像状態が時間とともにどのように進化するか、そして特定の臨床介入(アクション)によってどのように変化するかをシミュレーションするものです。ロボット工学やインタラクティブビデオの分野から生まれたワールドモデルは、内部に環境の学習済み表現を持ち、その状態がエージェント(この文脈では治療介入)の行動下でどのように進化するかを予測します。これにより、現実世界で行動を起こす前に、想像上のロールアウト(多段階のシミュレーション)を通じて、起こりうる未来をシミュレーションすることが可能になります。医療画像分野におけるワールドモデルの魅力は計り知れません。もしモデルが、対象者の画像状態が代替治療に対してどのように反応するかを忠実にシミュレーションできれば、それは単なる予測を超え、予知能力を提供し、「もしAではなくBの治療を行ったら、この対象者に何が起こるだろうか?」という反事実的な臨床推論を強力に支援します。最近では、放射線画像診断において、生成モデルが疾患の長期的な軌跡を予測し、治療計画に応じて腫瘍や病変がどのように進行するかを示す将来の画像を生成しています。また、手術分野では、行動条件付きビデオワールドモデルが手術シーンの plausible(もっともらしい)な継続を生成し、トレーニングや自律的な支援の基盤として検討されています。これらの活動は、時間予測、行動条件付き予測、反事実的評価、そして計画といった能力の階層(キャパビリティラダー)を網羅する、医療ワールドモデルの新たな分類体系としてまとめられています。しかし、この一連の研究が確立していないのは、これらのモデルを「信頼するための規律」です。医療画像ワールドモデルの価値は、主にその多段階で行動条件付きのロールアウトにありますが、現在の評価は依然として知覚的または単一ステップの指標に大きく依存しています。これらの指標は、出力がもっともらしく見えるか、次の観察と一致するかを示すことはできますが、シミュレートされた軌跡が臨床的に意味のある期間にわたって解剖学的および生理学的に一貫しているか、介入に合理的に反応するか、不確実性を適切に表現しているかについてはほとんど語りません。単一ステップの指標が良好であっても、ロールアウトがドリフトしたり破綻したりするモデルは、従来の評価では問題ないように見えてしまう可能性があります。最近のレビューでは、軌跡レベルの標準化された評価の欠如が未解決の問題として特定されていますが、これに対処するための専用の検証フレームワークは提供されていません。本論文は、医療画像ワールドモデルのシミュレーションされた画像シーケンスが、臨床的利益が考慮される前に「信頼できる」と評価するためにどのような証拠が必要か、という具体的な問いに対処します。著者らは、この評価を「検証問題」と捉え、3つの軸を中心に整理しています。
ワールドモデルの信頼性を測る3つの検証軸
この研究チームは、医療画像ワールドモデルの信頼性を評価するための工学的なフレームワークとして、以下の3つの検証軸を提案しています。これは、各モデルが主張する能力レベル(キャパビリティラダー)に応じて、検証要件が段階的に厳しくなるという原則に基づいています。
1. シミュレーションの忠実性(Simulation Fidelity)
最初の最も基本的な検証の問いは、「モデルが予測する状態が正しいか」です。これは現在の実践で最も多く報告されている軸ですが、報告されている数値が誤ったものを測定していることも少なくありません。忠実性の指標がないことが問題なのではなく、忠実性が単一の量として扱われているにもかかわらず、実際には層状に存在し、測定される層がモデルが動作し、主張する層と一致しないことが頻繁にあります。著者らは、予測される医療状態が正しいと判断できる4つの層を区別しています。低い方から順に説明します。
- 信号/知覚の忠実性(Signal or perceptual fidelity): 生成された出力がピクセルやボクセルレベルで実際のデータと類似しているか。フレシェット型距離や構造類似性指数がこれを定量化しますが、臨床的には最も情報が少ない層です。なぜなら、出力が知覚的に説得力があっても、解剖学的または生理学的に誤っている可能性があるためです。
- 構造/解剖の忠実性(Structural or anatomical fidelity): 予測された状態が、臓器の境界、組織の界面、器具の位置など、身体の空間的および関係的な構造を尊重しているか。例えば、手術ビデオの連続性がフレームごとに鮮明に見えても、器具が組織を通り抜けたり、解剖学的構造が不自然に再編成されたりする可能性があります。CheXWorldやXray2XrayのようなX線およびボリュームワールドモデルは、見た目だけでなく解剖学的構造と全体的な配置を捉えることを目指し、下流の解剖学的および診断タスクを通じて部分的に評価されています。
- 生理学/制約の忠実性(Physiological or constraint fidelity): 予測された状態が、基礎となる生物学の動的および恒常性(ホメオスタシス)制約に従っているか。EHR(電子カルテ)ワールドモデルの場合、シミュレートされた検査値が人間の生理学と両立する方法で変化し、連動する変数が正しく共変し、介入が合理的な方向と大きさの反応を生み出すことを意味します。知覚的な指標が何も語らないのはこの層であり、情報に富む失敗はここで発生します。
- 因果/メカニズムの忠実性(Causal or mechanistic fidelity): モデルが状態が変化する「理由」を捉えているか。これにより、新しい介入に対する反応が、記憶された相関ではなく、基礎となるメカニズムを反映します。これは、行動条件付きモデルや反事実モデルが暗黙的に主張する層であり、観察データからは最も確認しにくい層です。
中心的な問題は、どの層を測定することが間違っているわけではなく、モデルが動作する層よりも低い層で日常的に評価されていることです。例えば、治療条件付き画像モデルは、治療が疾患をどのように変化させるかという生理学的および因果的層での主張をしていますが、しばしば主に画像品質、つまり信号層で評価されています。この軸における検証には、モデルが主張する最高の忠実性層で評価し、各報告指標がそれが探る層を明記することが求められます。
2. ロールアウトの安定性(Roll-Out Stability)
シミュレーションの忠実性が単一の予測された状態が正しいかを問うのに対し、ロールアウトの安定性は、その正しさが反復によって維持されるかを問います。ワールドモデルは、自身の予測を次の入力としてフィードバックすることで、将来の軌跡を数ステップ先まで生成します(アンロール)。しかし、報告されている結果を支配する指標は、圧倒的に単一ステップのものです。単一ステップの正確性は必要ですが、それは多段階の挙動の貧弱で誤解を招く代理となることがよくあります。なぜなら、1つのステップでは些細なエラーも、モデルが自身の出力を消費し続けると複合的に影響するからです。このメカニズムは自己回帰的ロールアウトに固有であり、医療に特有のものではありません。各ステップでモデルは予測自体である状態に条件付けされるため、その状態のいかなるエラーも引き継がれ、次の遷移によって増幅される可能性があります。短期間ではその影響は目に見えないことが多く、これが単一ステップの指標が安心感を与える理由です。しかし、ワールドモデルが計画に有用となるより長い期間では、1ステップあたりの小さなエラーが蓄積し、生理学的または解剖学的に現実とはかけ離れた軌跡へと発展します。この問題は、行動条件付きモデルではさらに複雑になります。進化する状態の推定におけるエラーと、各行動に対する状態の応答をモデル化するエラーという2つのエラー源が同時に蓄積されるためです。個々の能力が高くても、多くのステップで両者が相互作用すると、信頼できない長期的なロールアウトを生み出す可能性があります。著者らは、医療ワールドモデルが報告すべき重要な要約量として「有効な計画期間(Effective Planning Horizon)」を提案しています。これは、モデルのロールアウトが信頼できる期間を非公式に表すものです。より正確には、モデルが初期状態 s0 からアクションシーケンス a1:H の下で生成したロールアウト軌跡 ˆs1:H を、参照軌跡 s1:H と比較します。モダリティに適したステップごとの忠実性損失 ℓ(ˆsh, sh) ≥ 0 を定義し、τ をその損失に対する臨床的許容誤差とします。ロールアウトは確率的であるため、期間 h における損失は確率変数です。これを、初期状態、行動シーケンス、ロールアウトのランダム性の分布に対する選択されたクォンタイル(Lq(h))で要約します。例えば、中央値(q = 0.5)や保守的な値(q = 0.9)です。このLq(h)が臨床的許容誤差 τ を初めて超える直前のステップが「有効な計画期間 Heff(τ, q)」と定義されます。
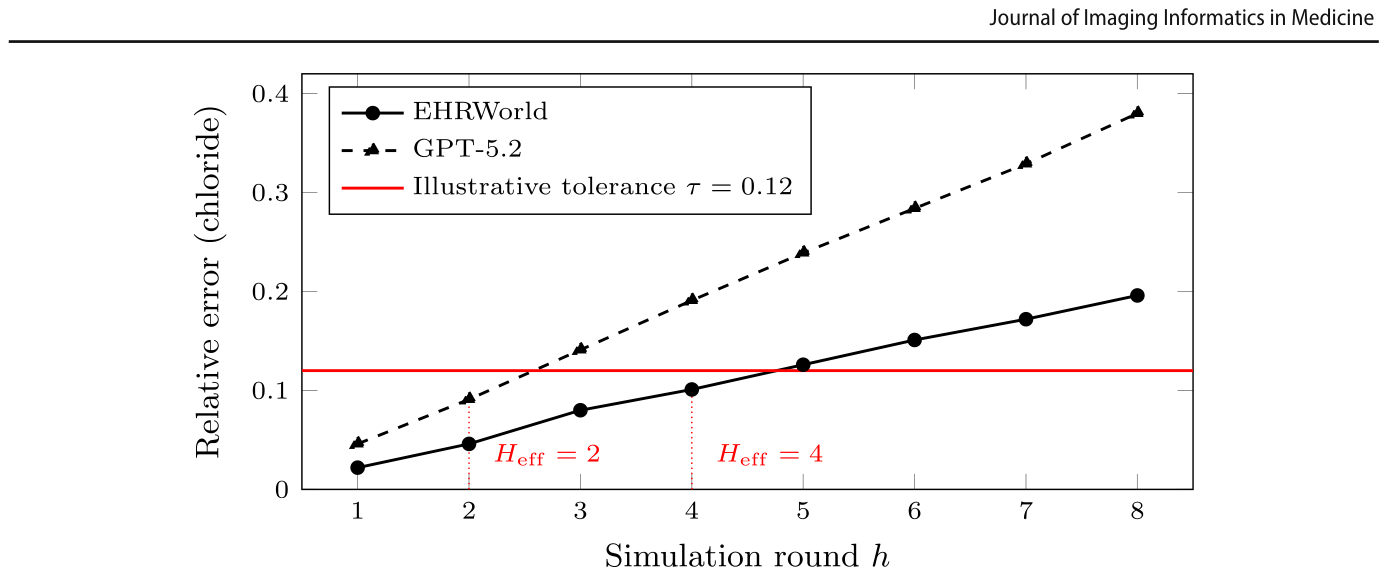
この図は、有効な計画期間の概念を、電子カルテ(EHR)のワールドモデルとGPT-5.2について、シミュレーションラウンドごとの塩化物相対誤差の近似値を使って示しています。許容誤差τ=0.12という仮定のもと、EHRWorldはラウンド4まで許容誤差内に留まり、ラウンド5で初めて超えるため、Heff=4となります。一方、GPT-5.2はラウンド3で初めて同じ許容誤差を超えるため、Heff=2と計算されます。この計算はファーストクロッシングルール(初めて許容誤差を超えた点が基準になる)を説明するためのものであり、EHRWorldがこれらの曲線を軌跡に対するクォンタイルとして報告しているわけではないため、厳密なHeff(τ,q)の経験的推定値として解釈すべきではありません。有効な計画期間を報告する際には、以下の6つの報告慣例が伴うべきだと著者らは述べています。①ステップごとの損失 ℓと許容誤差 τ を明記し、臨床設定に対して正当化すること。②要約統計量として平均値だけでなくクォンタイルを使用すること。③不規則な臨床間隔に対応する場合、シミュレーション時間でも期間を表現すること。④評価対象集団と観察された行動方針を明記し、臨床的に意味のあるサブグループ間で期間を層別化すること。⑤不確実性区間を含めること。⑥劣化曲線 Lq(h) とともに報告すること。注意すべきは、Heffは「観察された行動方針」の下で推定されるものであり、反事実的比較や計画に必要な「代替行動」の下での信頼性を確立するものではないということです。したがって、Heffはオフポリシーまたは反事実的計画期間の証拠として解釈すべきではありません。
3. 臨床的妥当性と信頼性(Clinical Plausibility and Reliability)
最初の2つの軸がモデルのシミュレーションが「内部的に健全か」を問うのに対し、3つ目の軸は、内部的に健全なシミュレーションが「行動を情報提供するのに適切か」を問います。これは、介入に対するモデルの反応が合理的か、その確信度が正確性と妥当な関係にあるか、そしてその能力が対象者サブグループ全体で維持されるか、という問いです。著者らは、医療ワールドモデルが理想的に持つべき特性を3つの認識論的カテゴリーに分類しています。
- 検証可能な特性(Testable properties): 保持されたデータに対して直接チェックでき、測定値や合格/不合格を判定できるもの。キャリブレーション(予測された不確実性が実際の誤差を追跡するか)やサブグループ性能(平均だけでなく、重症度や人口統計学的な層での性能)がこれに該当します。これらは、開発者が保持データを用いて達成可能であり、論文に記載されていない場合は報告のギャップとみなされます。
- 反証可能な条件のみ(Falsifiable-only consistency conditions): 予測が正しいことを確認することはできないが、明らかに間違っている予測を捕捉できるチェック。後述する反事実的整合性チェックがこれに該当します。これらに合格しても、モデルの介入応答が既知の臨床構造と矛盾しないということを確立するだけで、それが「正しい」ことを確立するものではありません。その価値は厳密には否定的です。つまり、誤りを反証できるだけで、確認はできません。
- 特定不可能な主張(Unidentified claims): 観察データからは原理的に確立できないもの。真の反事実的正確性や因果的/メカニズム的忠実性がこれに該当します。現実の対象者においては、とられた行動の下での軌跡は観察できますが、とられなかった行動の下での軌跡は観察できません。そのため、反事実的正確性をチェックするための真実のデータは存在しません。
これらの特性を適切なカテゴリーに位置づけることで、この軸は過度な主張をすることなく「検証」の範囲内に収まります。
- 反事実的整合性(Counterfactual Consistency): 介入に条件付けされたワールドモデルは、介入を変更すれば予測される軌跡が適切に変化することを暗黙的に約束します。これは反事実的推論を可能にする特性であり、前述のカテゴリー分類に従えば、その正確性は観察データから検証できないものです。しかし、観察データが利用できない場合でも、モデルの反事実的挙動が既知の臨床構造と内部的に整合しているかどうかは検証可能です。例えば、既知の単調効果を持つ薬剤の用量を増やした場合、予測される反応が確立された方向に動くか、介入を逆転させても軌跡が変化しないことはないか、既知の禁忌や相互作用が反映されているか、既知の相対的有効性を持つ介入がモデルのシミュレーション結果によって適切にランク付けされているか、などをテストできます。これらは「反証可能な条件のみ」であり、これらをクリアしたからといって反事実予測が正しいことを確立するものではなく、臨床的知識と矛盾しないことを示すにとどまります。
- キャリブレーションと不確実性(Calibration and Uncertainty): 意思決定を支援するワールドモデルは、予測内容だけでなく、その予測をどれだけ信頼できるかを示す必要があります。確信度の高い誤ったシミュレーションは、不確実なシミュレーションよりも危険です。ロールアウトによってエラーが複合的に増大するため、不確実性は一般的に期間とともに拡大すべきです。予測された不確実性が実際の誤差を追跡しているか、特にロールアウト期間の関数として示されるべきです。これは保持データに対して直接検証可能な特性です。
- サブグループ性能(Subgroup Performance): 全体的な性能は分布を隠蔽します。平均的には正確だと報告されているモデルでも、最も重症な対象者、稀な対象者、トレーニングデータで過小評価されている対象者といった、正確なシミュレーションが最も重要となるサブ集団では、その精度が著しく低い可能性があります。忠実性、安定性、キャリブレーションは、全体としてだけでなく、重症度、関連する人口統計学的グループ、データ可用性などによって定義された、臨床的に意味のある層別化されたデータに基づいて報告されるべきです。
既存のワールドモデルにおける検証の現状:監査結果から見えた課題
著者らは、提案されたフレームワークに基づき、放射線画像診断における長期的な疾患進行モデル4つと、手術および内視鏡ビデオモデル5つを含む合計9つの医療画像ワールドモデルのサンプルを監査しました。監査は、各モデルが自身の論文で報告している内容に基づいて評価され、その目的は、性能を競うのではなく、提示された検証証拠が主張する能力と一致しているかを診断することでした。
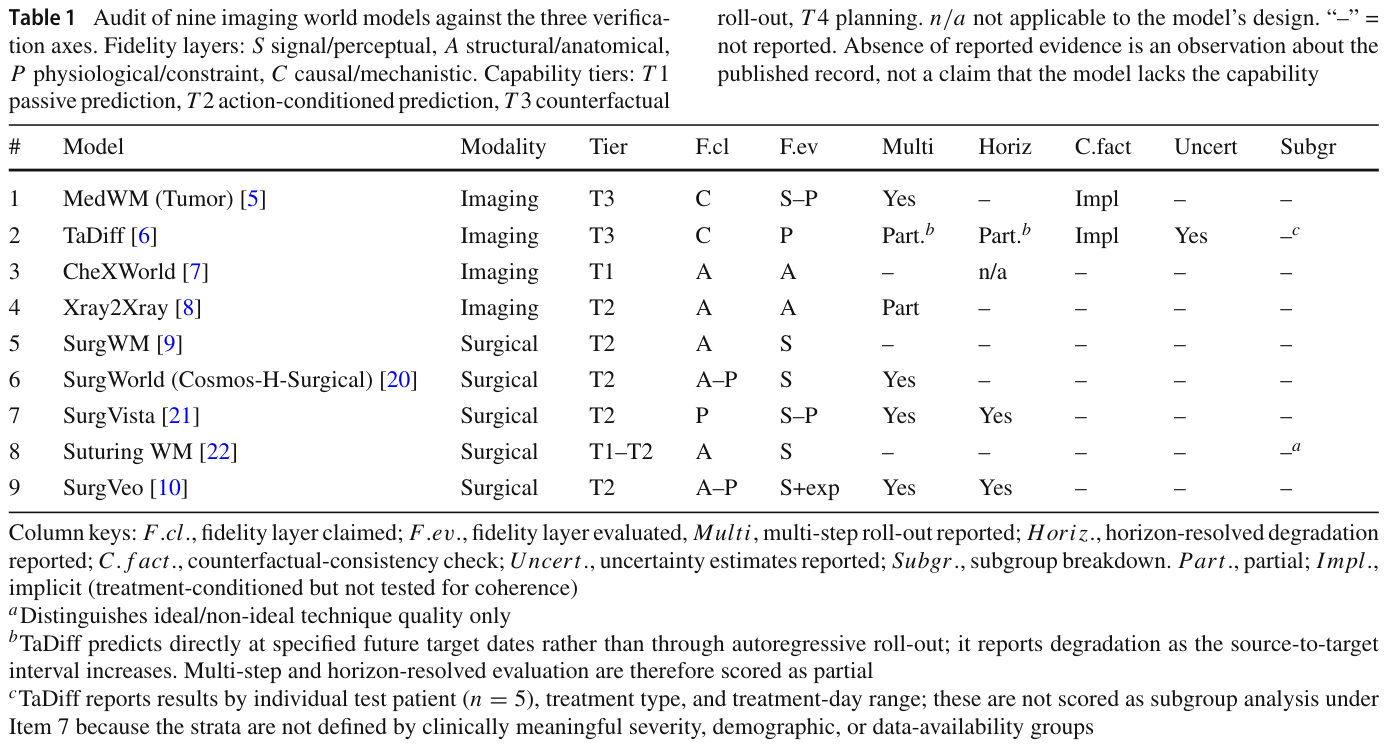
この表は、9つの医療画像ワールドモデルに対する3つの検証軸に基づく監査結果を示しています。各モデルについて、モダリティ、主張する最高能力層、主張する忠実性層と評価された忠実性層、多段階ロールアウト評価の有無、期間分解された劣化の報告有無、反事実的整合性チェックの有無、不確実性推定の報告有無、およびサブグループ分解の有無が記録されています。F.cl.は主張する忠実性層、F.ev.は評価された忠実性層、Multiは多段階ロールアウト、Horiz.は期間分解された劣化、C.fact.は反事実的整合性、Uncert.は不確実性、Subgr.はサブグループをそれぞれ示します。Yesは証拠が報告されていることを意味し、–は報告されていないことを意味します。Part.は部分的、Impl.は暗黙的(治療条件付きだが一貫性がテストされていない)を示します。n/aはモデルの設計に該当しないことを意味します。報告された証拠の欠如は、公開された記録に関する観察であり、モデルが基礎となる能力を欠いていると主張するものではありません。監査結果からは以下の4つのパターンが明らかになりました。
- 忠実性層のギャップ: モデルが主張する忠実性層と、証拠が報告されている層との間に体系的なギャップが見られます。特に手術ビデオで顕著であり、生理学的または因果的層を目的とするモデルが、多くの場合、信号または構造的層で最も強力な証拠を報告しています。例外的にSurgVeoは、自動指標を捨て、構造化された専門家評価によって生理学的および手順的層を直接検証しており、信号層の指標の欠点を明らかにしています。
- ロールアウト安定性への注目: 以前の状況よりも改善が見られ、最近のモデルの一部では、期間分解された劣化が明示的に報告されています。SurgVistaは多期間ベンチマークを導入し、予測期間が長くなるにつれてモデルの利点が広がることを報告しています。SurgVeoも、専門家によるもっともらしさの評価がシーケンス長とともに低下することを示しています。しかし、これらのモデルはいずれも、有効な計画期間を明示された臨床的許容誤差で表現しておらず、安定性の証拠は本物であるものの、モデル間で比較可能であったり、臨床的に解釈可能な形であったりしていません。
- 臨床的妥当性および信頼性証拠の継続的な不足: 生理学的層以上の臨床的妥当性および信頼性の証拠は依然として稀です。画像サンプル内では、反事実的整合性チェックは実質的に皆無であり、不確実性推定はTaDiffという単一のモデルのみが報告し、サブグループ分解はどのモデルも報告していません。
- 主張と証拠の関係: 報告された証拠は能力層とともに減少するわけではなく、反事実的層のモデル(MedWM-Tumor、TaDiff)は、ほとんどの行動条件付き手術モデルよりも多くの検証証拠を報告しています。しかし、すべての行動条件付き以上のモデルは、提案された報告基準(後述)で要求される少なくとも1項目を省略しています。具体的には、サブグループ分解、明示的な反事実的整合性チェック、明示された臨床的許容誤差での有効な計画期間を報告しているモデルはありません。
この選定されたサンプル内では、検証の証拠が不均一であり、行動条件付きまたは反事実的なすべてのモデルにおいて、その主張に対して不完全であることが示されています。安定性軸はますます注目されていますが、測定方法は非標準的であり、3つの軸すべてが1つのモデルで同時に報告されることはほとんどありません。これらの観察結果は、9つの選定されたモデルの公開報告書を記述するものであり、基礎となるシステムや広範な文献を記述するものではありません。そして、これらは「最小報告基準」が対処しようとするギャップを明確にしています。
ワールドモデルの標準化へ:最小報告基準の提案
臨床予測モデルも同様の報告問題に直面し、その解決のためにTRIPOD+AIガイドラインが開発されましたが、これは予測モデル向けであり、多段階ロールアウト、行動条件付け、反事実的シミュレーションには対応していません。そのため、著者らは既存の報告ガイドラインの拡張として、医療ワールドモデルのための報告項目セットを提案しています。報告基準の価値は、要求される証拠を明示し、その証拠をモデル自身の主張と関連付けることにあります。これにより、控えめな予測モデルと、反事実的比較や計画を目的とするモデルとでは、報告負担が異なるようになります。
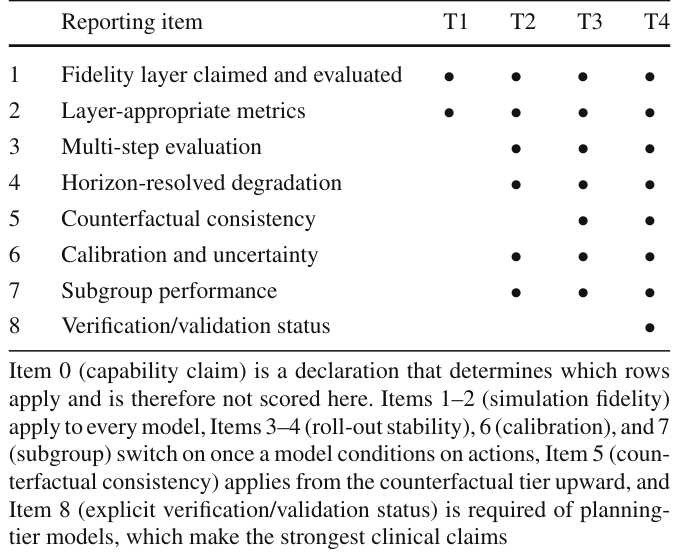
この表は、各能力層(T1:受動的予測、T2:行動条件付き予測、T3:反事実的ロールアウト、T4:計画)において義務付けられる報告項目を示しています。黒丸は、その項目が該当する能力層のモデルにとって必須であることを意味します。Item 0(能力主張)は、どの行が適用されるかを決定する宣言であり、ここでは採点されていません。Item 1〜2(シミュレーションの忠実性)はすべてのモデルに適用されます。Item 3〜4(ロールアウトの安定性)、Item 6(キャリブレーション)、およびItem 7(サブグループ)は、モデルが行動に条件付けし始めると適用されます。Item 5(反事実的整合性)は、反事実的層以上のモデルに適用されます。Item 8(明示的な検証/妥当性確認ステータス)は、最も強力な臨床的主張をする計画層のモデルに要求されます。提案された報告項目は以下の通りです。
- 項目0: 能力主張 モデルが主張する最高の能力層(受動的予測、行動条件付き予測、反事実的ロールアウト、計画)を述べます。これは検証項目自体ではありませんが、後続のどの項目が必須となるかを決定します。
シミュレーションの忠実性
- 項目1: 主張され評価された忠実性層 モデルの主張が示唆する最高の忠実性層(信号、構造、生理学、因果)と、実際に証拠が報告されている最高の層を述べます。両者が異なる場合は、そのギャップを読者が推測するのではなく、明示的に認めるべきです。
- 項目2: 層に適した指標 主張が示唆する最高の層で、少なくとも1つの指標を報告します。生理学的層以上の主張の場合、フレシェット距離や構造類似性などの知覚的指標だけでは不十分であり、制約充足の証拠、または自動測定が利用できない場合は構造化された専門家評価を伴う必要があります。
ロールアウトの安定性
- 項目3: 多段階評価 受動的予測層を超えるすべてのモデルについて、意図された使用が示唆する期間まで、単一ステップの性能だけでなく、多段階ロールアウトの下での評価を報告します。モデルが行動条件付きである場合、この評価は行動条件付きロールアウトの下で行われるべきです。
- 項目4: 期間分解された劣化 軌跡全体を単一の集計値としてではなく、ロールアウト期間の関数として忠実性を報告し、ドリフトや破綻を区別できるようにします。明示された忠実性尺度が明示された臨床的許容誤差を超える期間として定義される「有効な計画期間(Heff)」を、その背後にある劣化曲線とともに報告することを推奨します。許容誤差と忠実性尺度は、臨床設定に対して命名され、正当化されるべきです。報告されたHeffは、それが推定された観察された行動方針も明記し、臨床的に合意された許容誤差が存在しない場合は、単一の値としてではなく、範囲の許容誤差にわたってHeffを報告すべきです。
臨床的妥当性と信頼性
- 項目5: 反事実的整合性 反事実的または計画層のすべてのモデルについて、段階的介入に対する応答の方向と単調性、既知の禁忌の尊重、既知の有効性順序の維持など、少なくとも1つの反事実的整合性チェックを報告します。論文は、これらが観察データでは提供できない反事実的正確性の証明ではなく、臨床的知識に対する整合性チェックであることを明確に述べるべきです。
- 項目6: キャリブレーションと不確実性 受動的予測層を超えるすべてのモデルについて、予測された不確実性が実際の誤差を追跡しているかどうかを、理想的にはロールアウト期間の関数として報告します。計画に使用されるモデルが点予測のみを報告する場合、この項目を満たしません。
- 項目7: サブグループ性能 忠実性、安定性、キャリブレーションを、全体としてだけでなく、重症度、関連する人口統計学的グループ、データ可用性を含む臨床的に意味のある層で報告し、高急性度または過小評価された対象者に集中する劣化が平均によって隠蔽されないようにします。
- 項目8: 検証および妥当性確認の状況 どの主張が報告された検証証拠によって裏付けられているか、そしてどの主張が将来的な妥当性確認を必要とするかを明示的に述べ、生成的な忠実性やオフポリシーの価値が実証された臨床的利益として提示されないようにします。特に、オンポリシーの有効な計画期間は、反事実的比較や計画に必要な代替行動の下でモデルが信頼できるという証拠として提示されるべきではありません。
まとめ:医療AIの未来を築くために
この研究は、医療画像ワールドモデルの急速な進化に対応し、その信頼性を確立するための包括的な検証フレームワークと報告基準を提案しています。現状のモデルは素晴らしい可能性を秘めている一方で、その評価方法には課題が残されており、特に長期的なシミュレーションの安定性や臨床的な妥当性に関する証拠が不足していることが明らかになりました。有効な計画期間という新しい概念の導入や、層別の忠実性評価、そして主張のレベルに応じた検証要件の厳格化は、医療AIが安全かつ効果的に臨床現場で活用されるための重要なステップです。この報告基準が広く採用されることで、今後の医療画像ワールドモデルの研究は、より比較可能で検証可能なものとなり、最終的には対象者のケアと意思決定支援の質を向上させることに貢献するでしょう。
用語集
- ワールドモデル: 対象者の状態が時間とともにどのように変化するか、また特定の介入によってどのように変化するかをシミュレーションするAIモデル。未来を予測し、介入の影響を評価するために使用されます。
- ロールアウト: ワールドモデルが、自身の予測を次の入力として再利用し、多段階にわたって将来の状態変化をシミュレーションするプロセス。
- シミュレーションの忠実性: モデルが予測する状態が、信号/知覚、構造/解剖、生理学/制約、因果/メカニズムといった異なる層において、どの程度正確であるかを示す検証軸です。
- 有効な計画期間: モデルのシミュレーションされたロールアウトが、設定された臨床的許容誤差内で信頼できると見なされる最長の期間。
- ロールアウトの安定性: モデルの予測の正確さが、多段階のロールアウトを通じて維持されるかどうかを示す検証軸です。
- 臨床的妥当性: シミュレーションされたモデルの反応が、介入に対して合理的であり、その確信度が実際の精度と関連しているか、また対象者サブグループ全体で能力が維持されるかを示す検証軸です。
- 反事実的整合性: モデルが介入条件を変更した際に、予測される軌跡が既知の臨床的知識と矛盾なく変化するかどうかをチェックすること。
- キャリブレーション: モデルが示す予測の不確実性が、実際の誤差の大きさとどの程度一致しているかを示す特性。
- サブグループ性能: モデルの性能が、全体平均だけでなく、重症度、人口統計学的なグループ、データ可用性などの臨床的に意味のある対象者層でどのように異なるかを示す特性。
- キャパビリティラダー: ワールドモデルが持つ能力を段階的に示したもの。時間予測、行動条件付き予測、反事実的評価、計画などの階層があります。
コメントを残す