
AI生成胸部X線画像を人間とLLMは見分けられるか?精度とエラー特性の比較研究
解説対象論文: Complementary Error Profiles of Human Readers and Large Language Models in Detecting AI-Generated Chest Radiographs: A Comparative Reader Study
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年10月16日時点)
どうも、Beyond the Pixelです。AI技術の驚異的な進歩は、まるで本物と見分けがつかないような胸部X線画像を生成できるようになりました。しかし、これはデータの信頼性や整合性に新たな懸念をもたらします。AIが生成した画像と実際の画像を、専門家(ここでは放射線専門家と非放射線専門家)や最先端の大規模言語モデル(LLM)が見分けられるのか?そして、それぞれがどのように異なる間違いを犯すのか?この問いに答えるべく行われた比較読影研究をご紹介します。本研究は、AI生成画像の検出における人間とLLMの能力とそのエラー特性の補完性を深く掘り下げています。
AI生成画像の脅威と医療データ信頼性への懸念
どうも、Beyond the Pixelです。AI技術の驚異的な進歩は、まるで本物と見分けがつかないような胸部X線画像を生成できるようになりました。しかし、これはデータの信頼性や整合性に新たな懸念をもたらします。AIが生成した画像と実際の画像を、専門家(ここでは放射線専門家と非放射線専門家)や最先端の大規模言語モデル(LLM)が見分けられるのか?そして、それぞれがどのように異なる間違いを犯すのか?この問いに答えるべく行われた比較読影研究をご紹介します。本研究は、AI生成画像の検出における人間とLLMの能力とそのエラー特性の補完性を深く掘り下げています。AI技術、特に拡散モデルやLLMの進化により、非常にリアルな胸部X線画像が生成されるようになり、その出所を示すプロベナンス情報が欠如している場合に、データセットの整合性が懸念されています。意図的に生成され、合成として適切にラベル付けされた画像は、データ拡張や希少疾患のシミュレーション、教育、ベンチマークなどの用途に有用ですが、AI生成画像が本物と誤ってラベル付けされ、トレーニングデータやアーカイブに混入すると、モデルの崩壊という現象を引き起こし、AIの出力品質を低下させる可能性があります。このような問題は、根本的にデータガバナンスの問題であり、画像生成時に適切なプロベナンスメカニズムを適用することが重要です。しかし、そのような情報が欠落している場合、視覚的な真偽判定が最後の砦となります。過去の研究では、敵対的生成ネットワーク(GAN)を用いて生成された合成胸部X線画像について、放射線専門家が本物と合成を区別することが困難であったと報告されており、生成技術の進歩に伴い、この問題はさらに深刻化すると予測されます。Tordjmanらによる先行研究では、放射線専門家とマルチモーダルLLMの検出精度が重なる範囲にあることが示されていますが、本研究は、非放射線専門家も評価者として加えることで読影背景による比較を行い、3つの異なる合成画像生成パイプラインを評価し、自信度と精度の整合性、失敗の要因となる手がかりの分類、そして個々の評価者レベルでのエラープロファイルを詳細に分析することで、この先行研究をさらに拡張しています。特に、LLMが自身のモデルファミリーから生成された画像を識別する際に偏りを示すか、また異なる評価者(放射線専門家、非放射線専門家、LLM)間で真偽判定性能がどのように異なるかという疑問が、本研究の動機となっています。本研究は、誰が最も優れているかを問うのではなく、異なる評価者がどのように異なる失敗をするか、そしてその失敗のモードが、暗号によるコンテンツ認証情報や知覚できないウォーターマーキングといった非視覚的アプローチを含む、複合的なプロベナンス検証にどのように役立つかを問いかけています。
研究デザイン:多様な評価者と体系的な画像セット
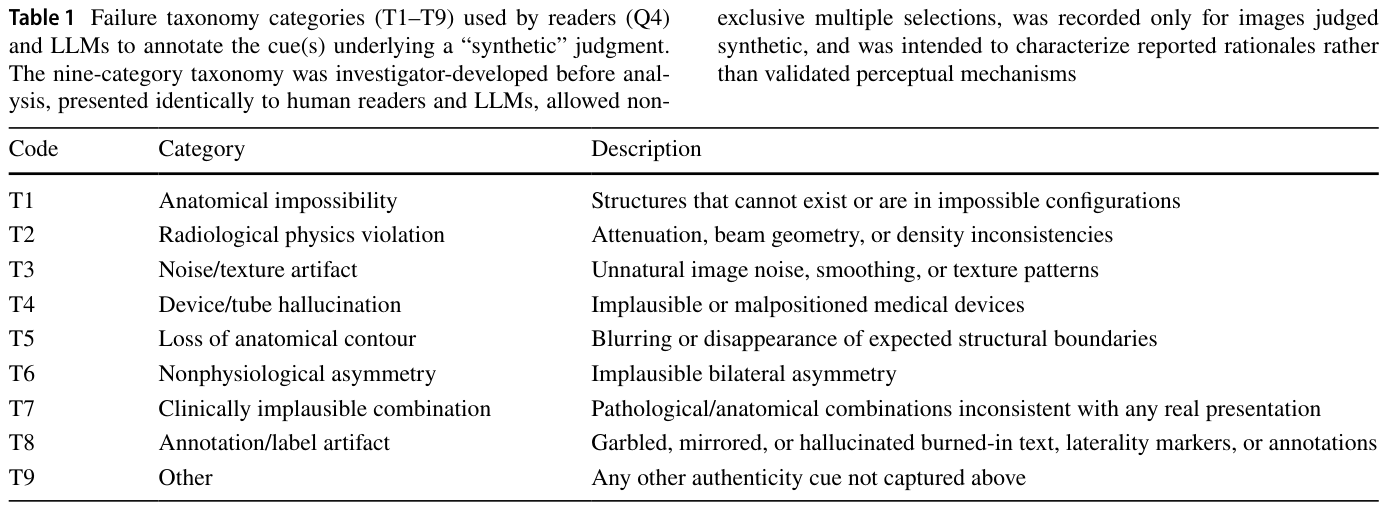
この研究は、人間の評価者とLLMが160枚の正面(後前)胸部X線画像に対して行った真偽判定性能を比較する比較読影研究として設計されました。研究の主眼は、最も正確な評価者を特定することではなく、異なる種類の評価者がどのように失敗するかを特徴づけることにありました。評価は、各評価者が共通の画像セットを独立して判定することで、画像ごとの比較を可能にするよう設計され、4つの並行した画像ソースが用いられました。これにより、性能を「合成」という一つのカテゴリにまとめるのではなく、ジェネレーター(生成元)ごとに評価することが可能となりました。実際の画像は、公開されている匿名化されたNIH ChestX-ray14データセットから40枚が層別無作為抽出されました。合成画像は120枚で、3つの異なるパイプラインによってテキストから生成されました。具体的には、ドメイン固有の拡散モデルであるRoentGen-v2、および汎用マルチモーダルLLMであるGemini 3.5 FlashとGPT-5.5が用いられました。各評価者は各画像を一度ずつ判定し、LLMによる評価は3ヶ月後に2回繰り返されました。主要な評価指標はバランス精度でした。これは、合成画像が75%という意図的なクラス不均衡がある状況で、評価者が単に「常に合成」と判定するだけで高い全体精度に達してしまうことを避けるため、真の識別能力を測定するのに適しているからです。バランス精度は、実際の画像の特異度と合成画像の感度の平均として計算されます。人間の評価者としては、2名の放射線専門家(RAD1、RAD2)と2名の非放射線専門家(GP1、GP2)が参加しました。彼らは、画像セットには本物とAI生成画像が含まれることを知らされていましたが、真のクラスの割合は知らされていませんでした。各画像について、評価者は真偽の二値判定、1~5の視覚的リアリズムスコア、4段階の自信度、多選択式の失敗要因**分類(
)、および自由記述の正当化を記録しました。LLMの評価では、GPT-5.5(OpenAI)、Gemini 3.5 Flash(Google DeepMind)、Claude Opus 4.8(Anthropic)の3つの最先端LLMが、人間と同じQ1-Q5スキーマを模倣した構造化されたプロンプトを受け取り、base64エンコードされたPNG画像が供給されました。LLMは分類タスクの被験者として評価され、この原稿の自律的なコンテンツ生成には使用されていません。人間の評価者とLLMの性能を、専用の検出器と比較するために、周波数領域フォレンジックベースライン**も実装されました。これは、各画像から40の特徴量を抽出し、L2正則化ロジスティック回帰でリアルか合成かを分類するものです。
人間とLLMの対照的な性能とエラープロファイル
この研究の最も顕著な発見は、最高の性能を発揮した人間とLLMの評価者が、ほぼ同等のバランス精度を達成したものの、その運用ポイントとエラープロファイルが対照的であったことです。75%の合成画像が含まれるこのデータセットにおいて、単に「常に合成」と判断するだけの分類器は75%の全体精度に達する中、RAD1が86.2%でこれを上回りました。しかし、主要な指標であるバランス精度で評価すると、Gemini 3.5 Flashが最高の点推定値(77.9%)を示し、RAD1が僅差でそれに続きました(75.8%)。
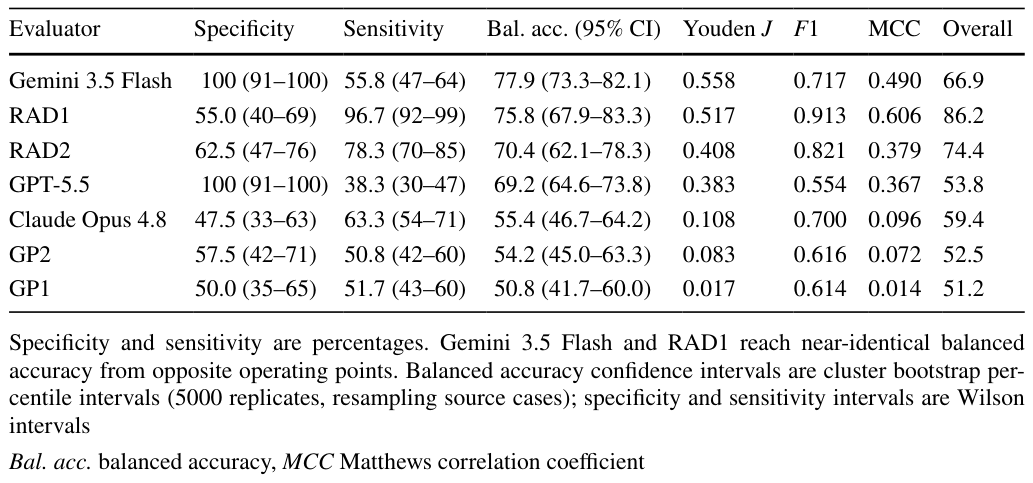
重要なのは、この2つの評価者がほぼ同じバランス精度に達したものの、そのアプローチは正反対であったことです。Gemini 3.5 Flashは、実際の画像に対する特異度が100%(本物の画像をAI生成と誤ることがなかった)と完璧でしたが、合成画像の感度は55.8%と控えめでした。一方、RAD1は合成画像の感度が96.7%と非常に高かったものの、実際の画像に対する特異度は55.0%と低く、本物の画像をAI生成と誤分類する傾向が強かったのです。この対照的な運用ポイントは、本研究の中心的知見です。 (図にはRAD1とGemini 3.5 Flashが対照的な動作点からほぼ同じバランス精度に達していることが示されています)。非放射線専門家であるGP1とGP2は、バランス精度がそれぞれ50.8%と54.2%と、ほぼ当てずっぽうに近い性能でした。評価者間の合意度も全体的に低く(放射線専門家間のコーエンのカッパは0.288、LLM間のフリース・カッパは0.213)
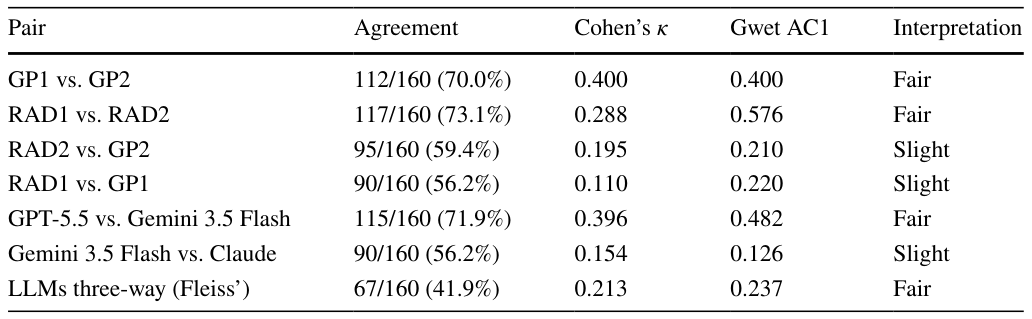
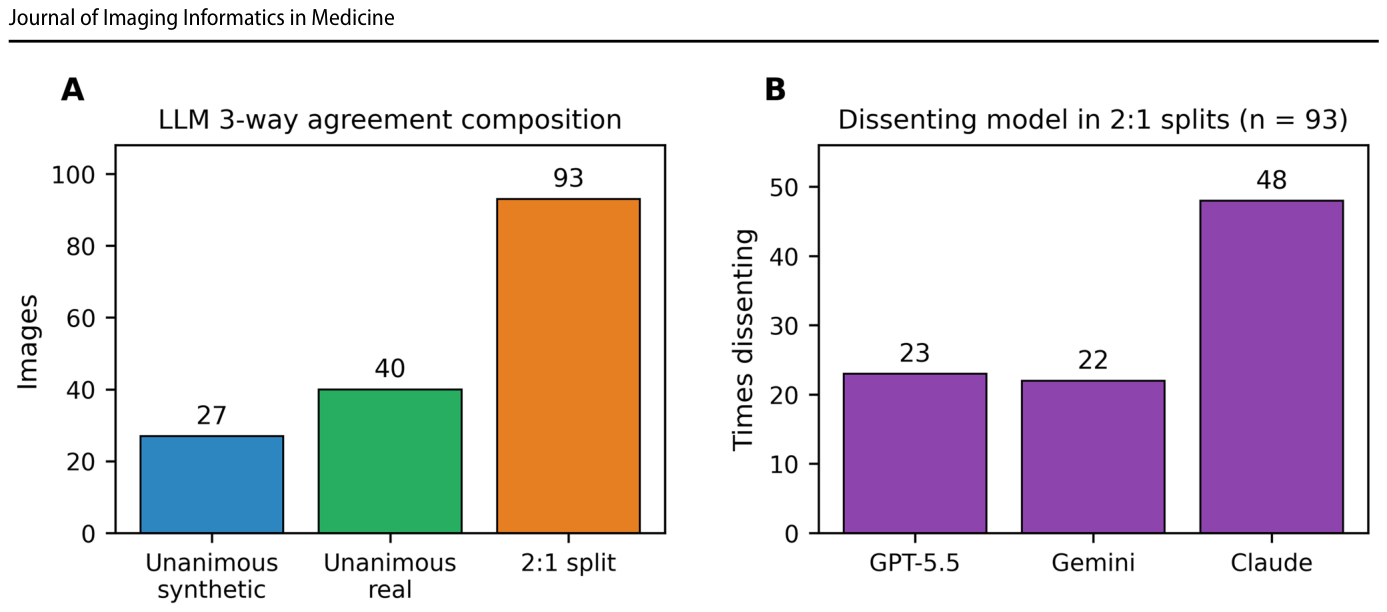
、これは評価者が異なる手がかりに基づいて判断していることを示唆しています。LLMの判断は完全には再現可能ではなく、3ヶ月後の繰り返し評価ではバランス精度や順位が変動しました。Gemini 3.5 Flashではバランス精度が72.1%から77.9%の範囲で変動し、LLM間の合意度も変動しました。
画像ソース別の検出率を見ると、人間とLLMの間で顕著な逆転パターンが確認されました。4人の人間の評価者全員が、拡散モデルによって生成された画像を82〜100%という高い感度で検出できたのに対し、LLMは38〜68%と検出率が低かったのです。逆に、放射線専門家は実際の画像を38〜45%の割合で誤分類したのに対し、保守的なLLMであるGPT-5.5とGemini 3.5 Flashは、実際の画像に対して100%の特異度を達成しました。
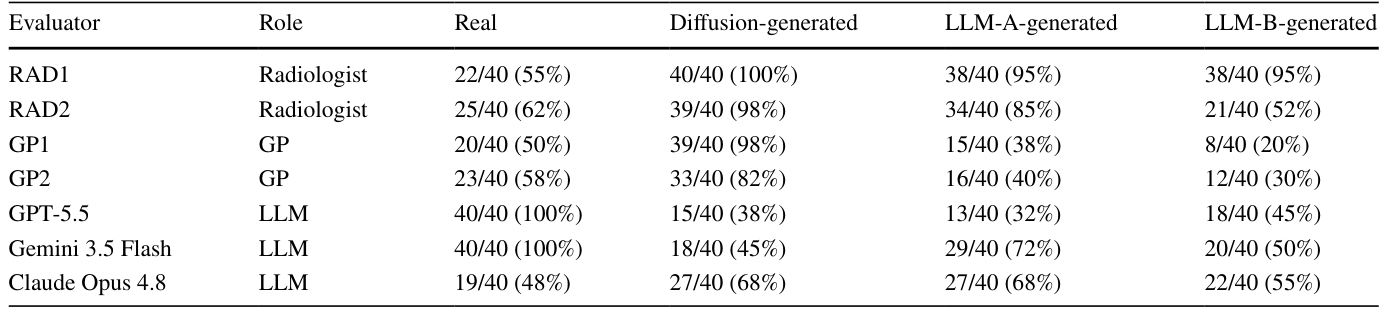
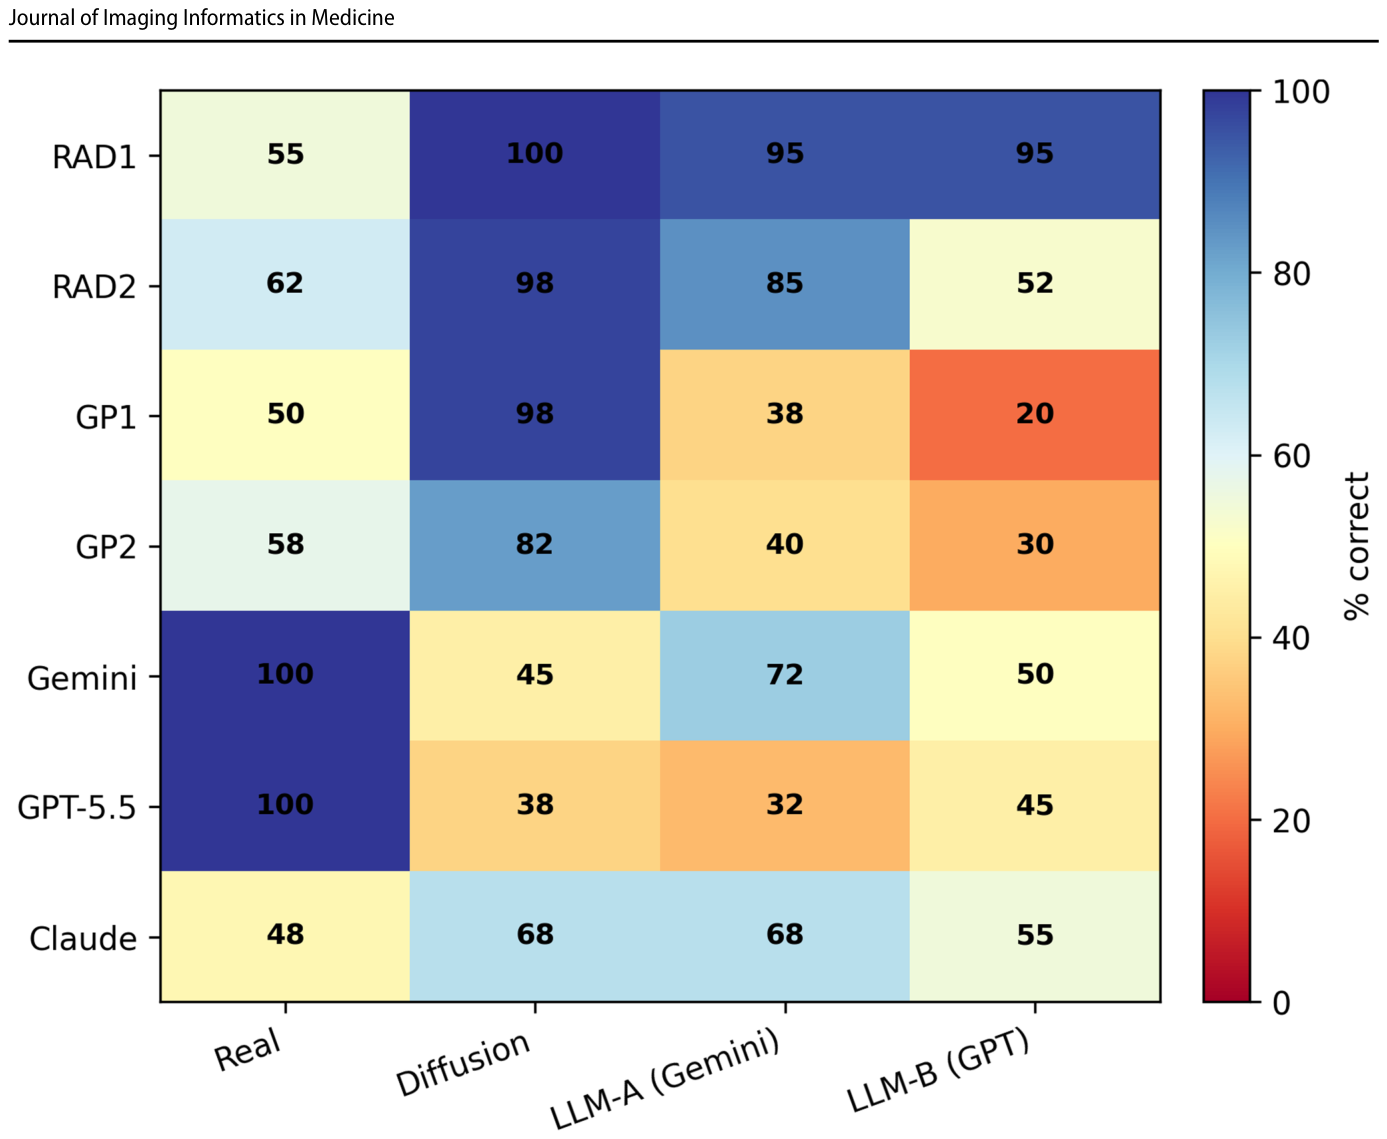
(図には、人間の評価者(高い合成画像感度、頻繁な実画像誤分類)と保守的なLLM(完璧な実画像特異度、控えめな合成画像感度)の間の逆パターンが示されています)。このことは、人間とLLMが異なる種類のエラーを犯すことを明確に示しています。特に、サイドマーカーや画像境界をマスクしたLLMの評価では、Gemini 3.5 Flashの特異度が低下したことから、LLMがアノテーションアーティファクトなどの低レベルな手がかりを利用していた可能性が示唆されました。
判定傾向と報告された失敗要因
評価者ごとに「合成画像である」と判定する割合(合成判定率)は大きく異なりました。放射線専門家は合成判定率が83.8%(RAD1)と68.1%(RAD2)と高く、合成と判定する傾向が強かったのに対し、LLMはClaude Opus 4.8を除いて、実際の画像と判定する傾向が強いことが示されました(Gemini 3.5 Flash 41.9%、GPT-5.5 28.7%)。
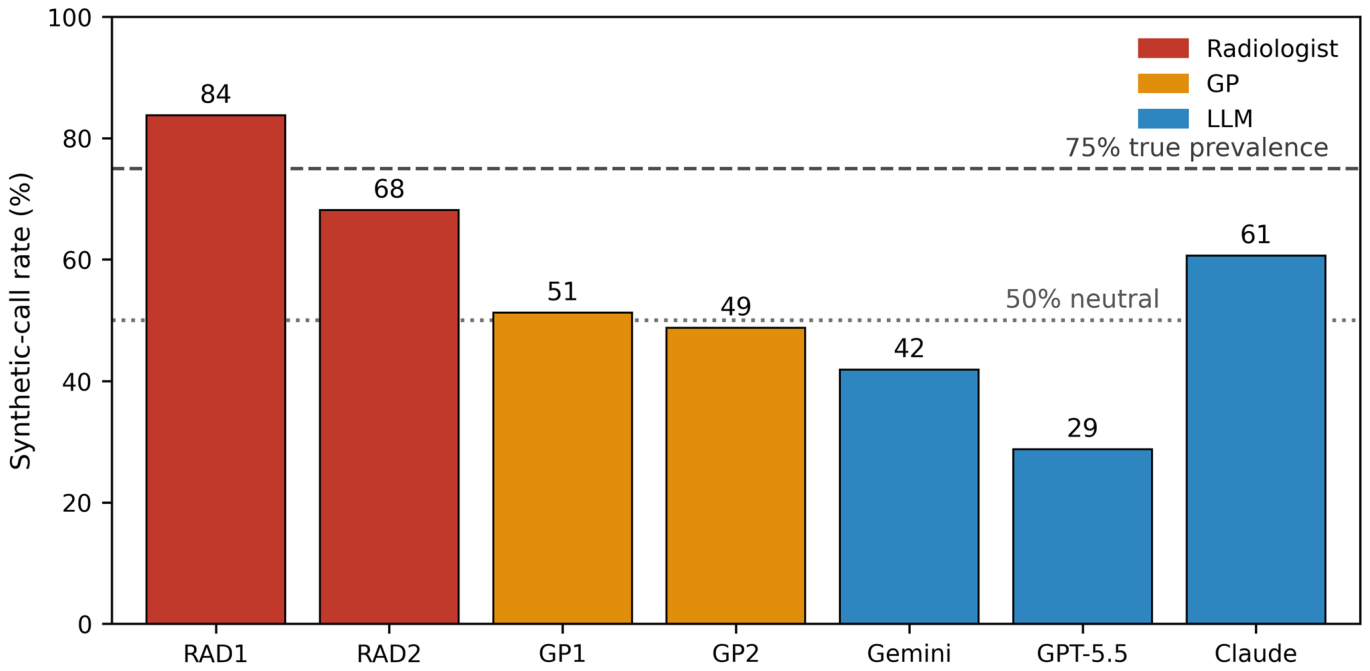
(図には、放射線専門家が中立値よりはるかに高い合成判定率を示し、GPT-5.5とGemini 3.5 Flashが実際の画像と判定する傾向が強いことが示されています)。また、人間の評価者のうちRAD1は、自身の自信度と実際の精度との整合性が最も高い(Brierスコアが0.124)結果を示しました。これは、RAD1が最も高い自信度で判断した際には100%の精度に達したことを意味します。LLMはほとんどの画像で単一の自信度レベルを使用したため、人間の評価者と比較可能な信頼度評価は行われませんでした。評価者が「合成である」と判断した際に報告した失敗要因のプロファイルも、評価者のタイプによって異なりました。RAD1は、真陽性検出(正しく合成画像を合成と判断)において「解剖学的不可能性(T1)」を最も頻繁に報告しました(53%)。一方、GPT-5.5は「ノイズ/テクスチャアーティファクト(T3)」(98%)や「解剖学的輪郭の喪失(T5)」(93%)を頻繁に報告しました。Gemini 3.5 Flashも「ノイズ/テクスチャアーティファクト(T3)」(70%)を最も多く報告しています。これは、人間とLLMが画像の異なる特性を合成の兆候として捉えていることを示唆しています。(表1) (表には、評価者が合成判断の根拠として使用した9つの失敗要因の分類が示されています)。興味深いことに、本物の画像に対する誤検出(偽陽性)の場合、RAD1の誤りの72%が「解剖学的不可能性(T1)」を原因としており、LLMであるClaude Opus 4.8では86%が「アノテーション/ラベルアーティファクト(T8)」を報告していました。Gemini 3.5 FlashとGPT-5.5は、実際の画像において偽陽性検出がなかったため、偽陽性のキュープロファイルは存在しません。これは、放射線専門家が解剖学的な特徴の不自然さを主な手がかりとするのに対し、LLMは画像内のマーカーや文字の異常に注目する傾向があることを示唆しています。
考察:AI生成画像の真偽判定における課題と今後の展望
本研究の核心は、どの評価者が最も優れているかではなく、「どのように失敗したか」という点にあります。放射線専門家とLLMは、AI生成胸部X線画像の真偽判定において異なる判断基準とエラープロファイルを示しました。放射線専門家は、保守的なLLMが本物と分類した合成画像をより頻繁に識別しましたが、保守的なLLMは、放射線専門家が合成と誤分類した本物の画像をより正確に分類しました。この「運用ポイントの逆転」は、両者が異なる種類のエラーを犯し、互いを補完する可能性を示唆しています。放射線専門家が比較的高頻度で本物の画像を合成と誤分類する(合成過剰警戒)傾向は、この実験設定において、良性の取得ばらつきや非典型的な解剖学的構造を疑わしいと解釈した結果である可能性があります。RAD1の偽陽性の72%が「解剖学的不可能性」を根拠としていたことは、この解釈と一致しています。この結果は、データセットのキュレーションや監査において、一人の専門家の真偽ラベルを未検証のリファレンスゴールデンスタンダードとして用いることへの注意を促します。非放射線専門家は、本研究の小規模な探索的サンプルでは、拡散モデル生成画像は比較的よく検出できたものの、LLM生成画像では専門家と比較して性能が低く、全体的には当てずっぽうに近い性能でした。これは、ドメイン固有の放射線学的専門知識が、特に特定の種類のAI生成画像の識別において重要である可能性を示唆しています。この研究結果は、マルチモーダルLLMが放射線画像の診断では一貫性のない性能を示すにもかかわらず、本研究のような真偽判定タスクでは専門家と比較しうるバランス精度を発揮しうることを示しています。これは、両タスクが異なる能力を必要とすることを示唆しており、診断に弱いモデルでも、保守的であれば真偽判定には強い可能性があります。モデルのバージョンは数ヶ月単位で変化するため、絶対的な精度数値はすぐに陳腐化しますが、本研究で採用された運用ポイント、応答傾向、ソース層別エラープロファイルなどの報告フレームワークは、モデルが更新されても適用可能な普遍的な知見を提供します。
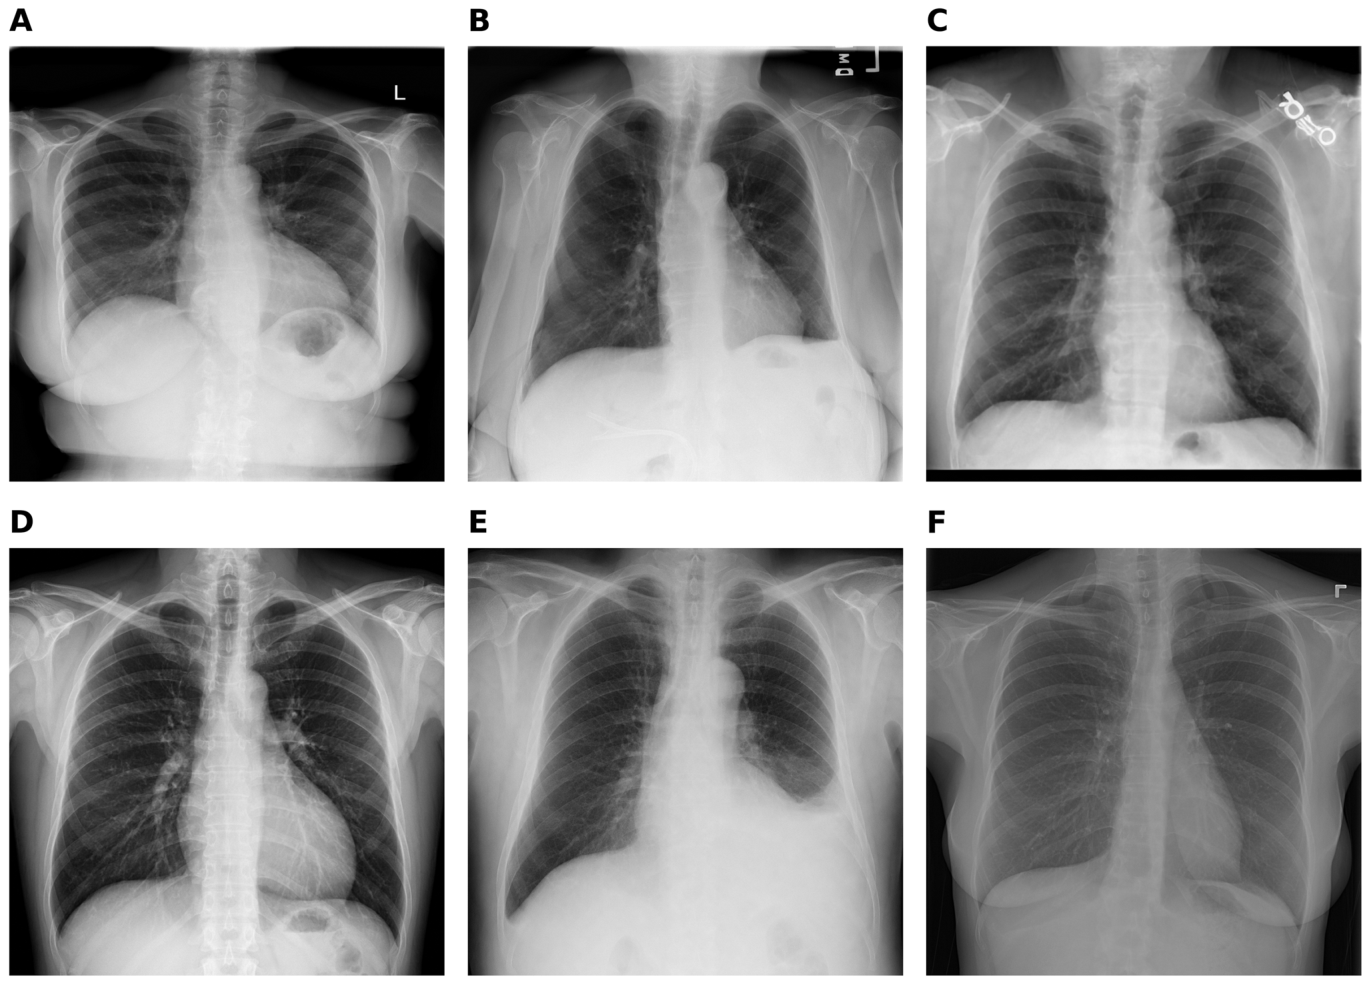
(図には、AI生成胸部X線画像と実際の胸部X線画像において、評価者間で分類パターンが異なった代表的な事例が示されています)。周波数領域のフォレンジックベースラインは、このデータセット内で98.3%という高いバランス精度を達成し、最高の人間評価者(RAD1)とLLM(Gemini 3.5 Flash)を約20%上回りました。このことは、このデータセットに非常に識別力の高い低レベルなレンダリングまたはソース固有の手がかりが存在したことを示しています。しかし、この検出器が未知のジェネレーターに対しては12%の感度しか示さなかったことから、フィンガープリントベースの検出は耐久性がなく、新しいジェネレーターごとに変化しうることも示されました。これらの知見は、プロベナンスを画像作成と転送の時点で対処されるべきデータガバナンスの問題として捉えることの重要性を示唆しています。具体的には、暗号によるコンテンツ認証情報やウォーターマーキングが主要な保護手段となり、視覚的レビューは二次的なコントロールと位置づけられるべきです。人間とLLMの間で合意度が低かったことも、単一の視覚的評価者のみでは決定的なプロベナンス判断が困難であることを裏付けています。視覚的および非視覚的信号を組み合わせて検証性能を向上させることができるかについては、今後の研究で検証されるべき課題です。
研究の限界
本研究にはいくつかの限界があります。サンプル数(n=160、各グループ40枚)が少ないため、精度が限定され、特に背景が異なる評価者(放射線専門家、非放射線専門家)の比較は、個々のレベルでの探索的な観察にとどまります。放射線専門家2名のサブスペシャリティが異なったことも、両者の間の性能差に影響した可能性があります。合成画像の割合が75%と現実世界の状況を反映していないため、特異度推定の精度が限定される点も挙げられます。また、画像処理による混同が完全に排除できない可能性もあります。例えば、拡散モデル生成画像はアップサンプリングされており、その際に補間によるテクスチャの痕跡が残っている可能性があります。実際のNIH画像には、AI生成画像にはない、焼き付けられた左右マーカーなどのアノテーションが含まれており、これがLLMの特異度(特にGemini 3.5 Flash)に大きく影響したことが、マスク処理後の評価で示唆されました。Gemini生成画像にはSynthIDが使用されたと報告されていますが、画像処理後に検出可能な信号が残存していたかどうかはテストされていません。読影者の事前知識、LLM間の推論パラメータの異質性、単一セッションでの読影なども、結果の一般化可能性を制限する要因です。LLMの判断は一部再現性が低く、単一の実行結果をモデルの固定特性として解釈すべきではない点も注意が必要です。最後に、本研究はNIH ChestX-ray14という単一の公開データセットに由来する実際の画像と、特定の生成パイプラインによって生成された画像を区別するタスクであり、認証関連の特性、レンダリングまたはウォーターマークの痕跡、およびソースドメインの違いの組み合わせを反映している可能性があり、純粋な合成対本物、またはジェネレーターファミリーの認識としてのみ解釈すべきではありません。
結論:データガバナンスと複合的アプローチの重要性
本研究のデータセットにおいて、放射線専門家とLLMは、AI生成胸部X線画像の真偽判定において異なる運用ポイントとソース固有のエラープロファイルを示しました。一人の放射線専門家が最高の全体精度を達成した一方で、Gemini 3.5 Flashは最高のバランス精度点推定値を示しました。これらの結果は、実際の画像の特異度と合成画像の感度の間で異なるトレードオフを反映しています。報告された失敗要因は評価者のタイプによって異なり、特徴的な偽陽性パターンと一致していましたが、これらは測定された意思決定メカニズムとして解釈すべきではありません。視覚的な真偽判定だけでは、胸部X線画像のプロベナンス検証としては不十分である可能性が高いことが示唆されました。今後の研究では、視覚的評価と、暗号によるコンテンツ認証情報やウォーターマーキングといった非視覚的なプロベナンス信号を組み合わせることで、検証性能が向上するかどうかを検証する必要があります。
補足図表
Table 5
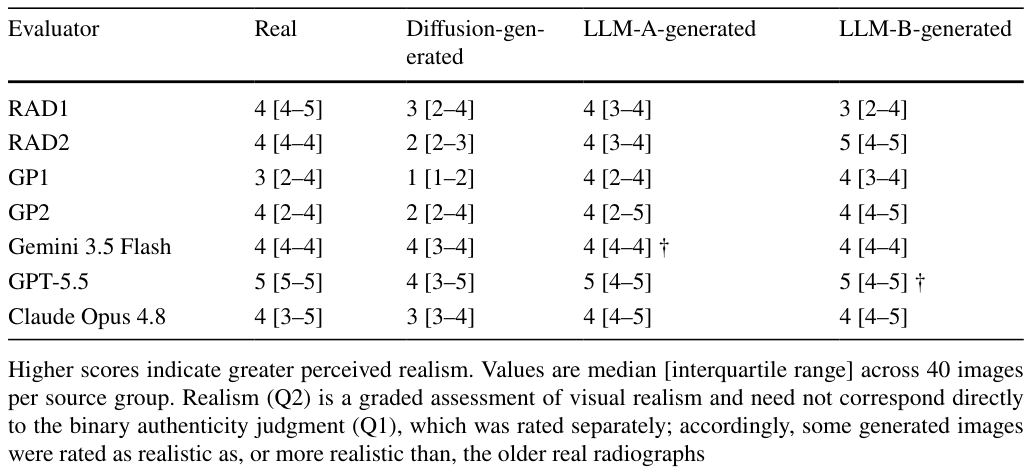
用語集
- 大規模言語モデル (LLM): 人間の言語を理解し、生成するよう訓練されたAIモデルです。
- 拡散モデル: ノイズから画像を段階的に生成するAIモデルの一種で、非常にリアルな画像を生成できます。
- プロベナンス: データの来歴や出所に関する情報で、医療画像においては、画像が本物かAI生成かを示すメタデータなどです。
- モデルの崩壊: AIモデルがAI生成データで再訓練され続けることで、出力の多様性や忠実度が徐々に低下する現象です。
- 比較読影研究: 複数の評価者や手法を比較して、画像などの解釈能力を評価する研究デザインです。
- バランス精度: 不均衡なデータセットにおいて、真陽性率(感度)と真陰性率(特異度)の平均値で計算される評価指標です。
- 感度: 実際の合成画像を正しく合成と識別する能力の指標です。
- 特異度: 実際の画像を正しく本物と識別する能力の指標です。
- アノテーションアーティファクト: 画像に書き込まれたマーカーや文字など、通常、実際の医療画像に存在するが、AI生成画像では不自然な形で現れることがある要素です。
- フリース・カッパ: 3人以上の評価者間の一致度を測る統計量です。
- コーエンのカッパ: 2人の評価者間の一致度を測る統計量で、偶然の一致を補正します。
- 周波数領域フォレンジックベースライン: 画像の低レベルな物理的特性(ノイズやテクスチャパターン)を周波数領域で分析し、画像が加工されたり生成されたりした痕跡を検出する技術です。
- 合成判定率: 評価者が画像を合成であると判定した全画像の割合です。
- Brierスコア: 評価者の自信度と実際の正誤との整合性(キャリブレーション)を定量化するスコアで、値が低いほど良いキャリブレーションを示します。
- 合成過剰警戒: 合成画像を検出することに過度に注意を払い、その結果、本物の画像を合成と誤って分類する傾向を指します。
- ゴールデンスタンダード: 比較対象となる最も信頼性の高い基準や参照点のことです。
- フィンガープリントベースの検出: AI生成モデルが生成する画像に固有の微細な痕跡(フィンガープリント)を検出し、その出所を特定する手法です。
- 暗号によるコンテンツ認証情報: 画像の作成者や来歴を暗号技術を用いて記録・検証する情報です。
- ウォーターマーキング: 画像に目には見えないが検出可能なデジタル情報を埋め込む技術で、コンテンツの出所や改ざんの有無を検証するために使われます。
- SynthID: Google DeepMindが開発した、AI生成画像に知覚できないウォーターマークを埋め込む技術です。
コメントを残す