🎧 この記事を音声で聴く(AI生成Podcast)
解説対象論文: D3MI: an efficient and powerful federated imputation method for bias reduction in the analysis of distributed incomplete data by accounting for within-site correlation and between-site heterogeneity
電子カルテ(EHR)データは、臨床研究にとって非常に貴重な情報源ですが、複数の医療施設に分散して保存され、プライバシー保護の観点から共有が難しいという課題があります。さらに、データには欠損値が含まれることが多く、これが分析結果に偏りをもたらす可能性があります。本記事では、この課題を解決するために開発された新しい手法D3MIについて深掘りします。
研究サマリー(FINER & PICO)
Feasible実施可能性
フェデレーテッドラーニング技術と多水準補完アルゴリズムを統合し、通信および計算効率を考慮した実用的な実装を提供します。
Ethical倫理面
プライバシー保護を重視し、機密性の高い対象者レベルの生データを共有することなく分散型EHRデータを分析可能にしました。
Interesting面白さ
既存の分散型補完法が無視していた、EHRデータに特有の部位内相関と部位間異質性を明示的に考慮する新規性を持ちます。
Novel新規性
分散型でプライバシーに配慮した設定における欠損データ処理において、重要な方法論的ギャップを埋める新しいフェデレーテッド多重補完法です。
Relevant切実さ
分散型でプライバシーに配慮した環境における協調的な臨床研究の厳密性と再現性を高め、多様な医療機関からのEHRデータの有効な分析に貢献します。
Measurable測定可能性
広範なシミュレーション研究と実世界データ分析により、既存の最先端(SOTA)分散型補完手法に対する精度と一貫性の優位性を実証しました。
Modifiable派生・改善
将来的に追加の変量効果(例:変量勾配)や正則化手法を組み込むことで、高次元データへの対応などさらなる拡張性を持つ可能性を秘めています。
Structured文章構造
データの複雑な構造(特に部位内相関と部位間異質性)を施設固有の変量効果を用いて明示的にモデル化し、より正確な欠損値補完を実現します。
PICO / PECO対象・介入・比較・結果
(P)複数の医療施設に分散し欠損値を含む電子カルテデータ、(I)D3MI手法による補完、(C)既存の分散型欠損値補完手法、(O)分析結果のバイアス低減と精度・一貫性の向上。
はじめに:分散型EHRデータの課題
どうも、Beyond the Pixelです。電子カルテ(EHR)データは、臨床研究にとって非常に貴重な情報源ですが、複数の医療施設に分散して保存され、プライバシー保護の観点から機密性の高い対象者レベルの情報を共有することが難しいという課題があります。このため、フェデレーテッドラーニング(連合学習)などの手法が開発され、生データを共有せずに分散型データを分析できるようになりました。しかし、分散されたデータには欠損値が含まれることが多く、これが適切に対処されないと、分析結果に大きな偏り(バイアス)をもたらす可能性があります。既存の分散型欠損値補完手法は、EHRデータに特有の二つの重要な側面、すなわち「部位内相関(同一施設内の対象者間のデータの類似性)」と「部位間異質性(異なる施設間でのデータのばらつき)」を十分に考慮できていませんでした。本記事では、この重要な方法論的ギャップを埋めるために提案された新しいフェデレーテッド補完手法であるD3MIについて深掘りします。D3MIは、これらの複雑なデータ構造を明示的にモデル化することで、既存アプローチの主な限界に対処し、分散型でプライバシーに配慮した環境における欠損データ処理に対して、強力かつ効率的なソリューションを提供します。
D3MIとは? 分散型欠損値補完の新手法
D3MIは「Distributed Mixed Model-based Multiple Imputation」の略であり、分散型EHRデータの偏りを減らすために設計された新しいフェデレーテッド欠損値補完手法です。この手法は、フェデレーテッドラーニング技術、相関データのための統計学習手法、および多水準補完アルゴリズムの強みを統合しています。これにより、施設固有の変量効果(ランダム効果)を用いて、部位内相関と部位間異質性の両方を明示的に考慮します。D3MIは「Missing at Random(MAR)仮定」の下で動作し、生データを共有することなくプライバシーを保護し、通信と計算の効率性にも優れています。
具体的には、D3MIは欠損値のある各共変量に対し、施設固有の変量切片(ランダムインターセプト)を持つ「一般化線形混合モデル(GLMM)」を適合させます。GLMMは、バイナリ変数に対するロジット関数や連続変数に対する恒等リンク関数などのリンク関数を使用して、共変量とアウトカムの間の関連性を推定する統計モデルです。各施設内の対象者間で観測されない施設固有の特性を共有する可能性を考慮し、ランダムインターセプトを組み込むことで、施設間の潜在的な違いをモデルが調整し、推定精度を向上させます。このモデルは、privacy-preserving distributed PQL(dPQL)アプローチを用いてプライバシーを保護しつつ効率的に推定されます。補完された複数の完全なデータセットが構築された後、最終的な分析も分散型GLMMで行われ、結果は「Rubinのルール」に従って統合されます。
D3MIのアルゴリズムは以下の3つの主要なステップで構成されます。
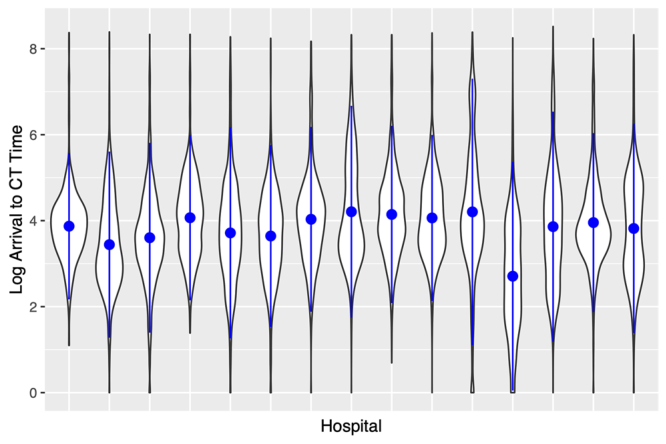
Figure 1. Fig. 1 Distribution of log arrival-to-computed tomography time at the 15 largest hospitals in the Georgia Coverdell Acute stroke Registry data解説: ジョージア州カバーデル急性脳卒中レジストリにおける15の大規模病院における、ログ変換された到着からCTまでの時間の周辺分布を示すバイオリンプロットです。各バイオリンは各病院のデータ分布を表し、施設間で到着からCTまでの時間にばらつきがあることを示唆しています。は、特定の医療施設におけるログ到着からCTまでの時間の周辺分布を示しており、施設間でばらつきがあることを示唆しています。
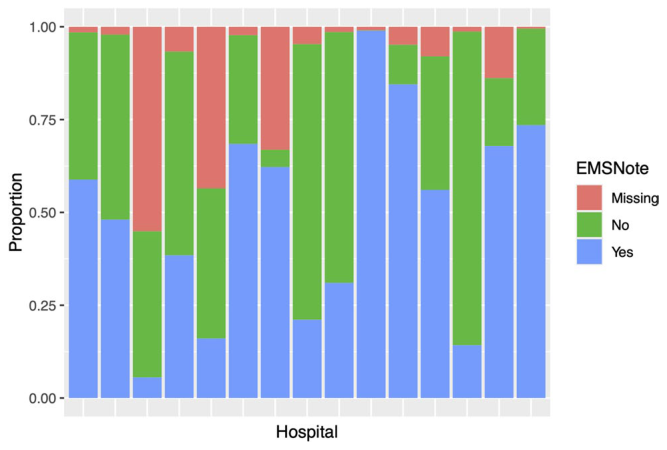
Figure 2. Fig. 2 Distribution of the binary variable indicating whether the hospi tal received advance notice from emergency medical services (EMSnote) and the missing proportions at the 15 largest hospitals in the Georgia Coverdell Acute stroke Registry data解説: ジョージア州カバーデル急性脳卒中レジストリにおける15の大規模病院での、緊急医療サービス(EMS)からの事前通知の有無を示す二値変数(EMSnote)の分布と欠損割合を示す棒グラフです。このグラフは、欠損割合が1%未満から55%を超えるまで病院間で大きく異なり、EMSnoteを受け取った対象者の割合も12%からほぼ100%まで広範囲にわたることを示しています。は、EMS(緊急医療サービス)からの事前通知の有無を示す二値変数の分布と、ジョージア州カバーデル急性脳卒中レジストリにおける15の大規模病院での欠損割合を示しており、欠損割合と各カテゴリの割合が施設間で大きく異なることがわかります。
シミュレーション研究でD3MIの優位性を検証
著者らは、広範なシミュレーション研究を通じてD3MIの性能を評価しました。比較対象として、既存の最先端(SOTA)分散型補完手法(AVGM、CSL)と、複数のベンチマーク手法(lme4、PQL、CD、CC)が用いられました。評価指標には、「相対バイアス(Relative Bias)」、「1000回の推定の標準偏差(SD)」、「二乗平均平方根誤差(rMSE)」が使用されました。
シナリオa):1つの二値変数に欠損がある場合
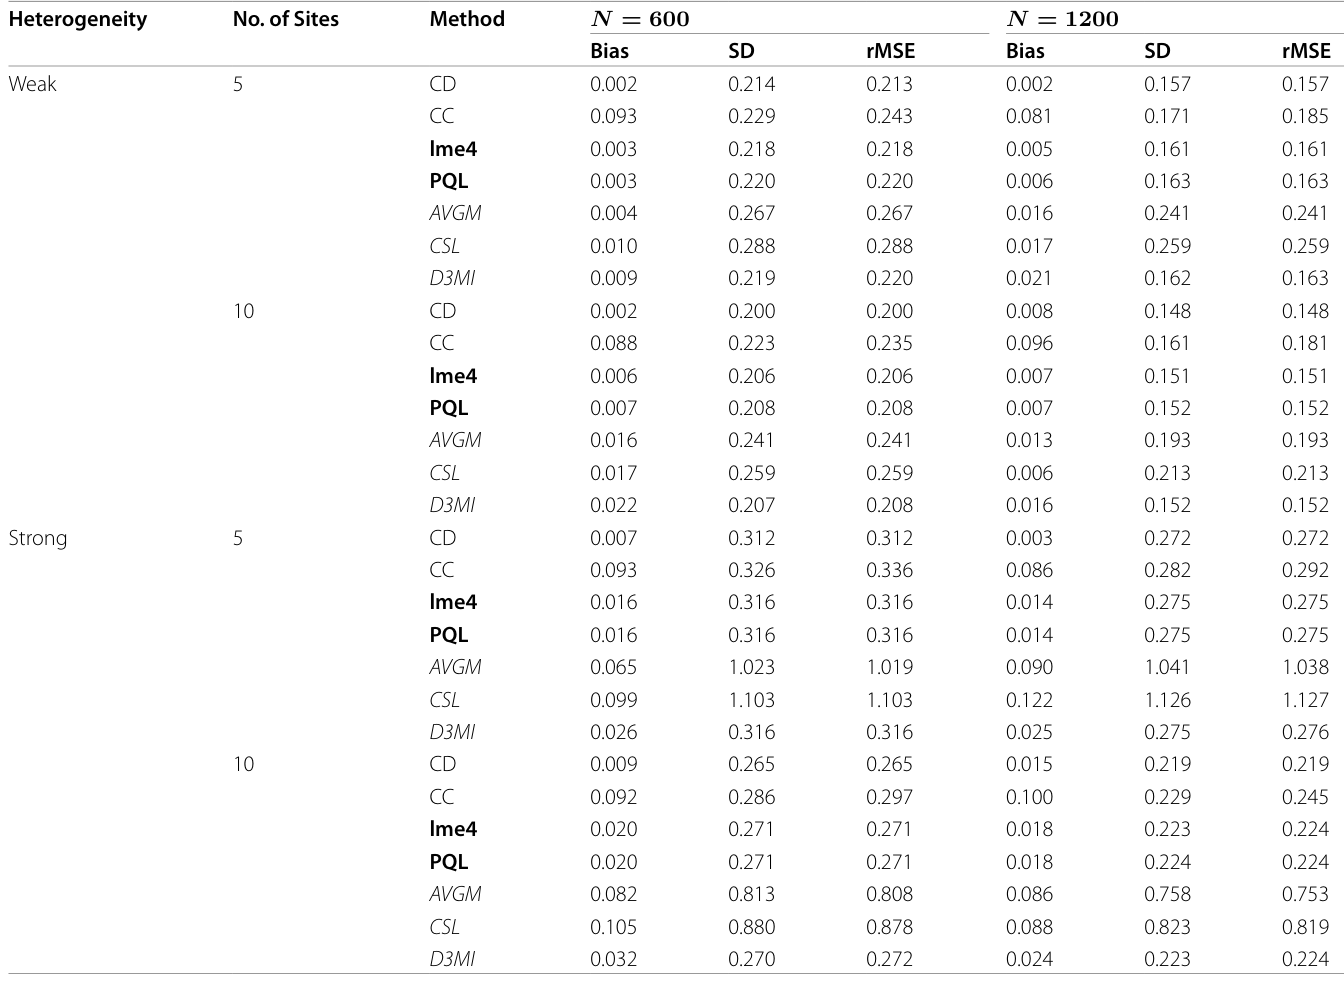
Table 1. Table 1 Simulation scenario a) one binary variable has missingness. Mixed model-based imputation methods are in bold, distributed imputation methods are in italics. Benchmark methods are in shaded cells, including two analyses without imputation and two centralized imputation methods Heterogeneity No. of Sites Method i n line-eq-IEq78 i n line-eq-IEq79 Bias SD rMSE Bias SD rMSE Weak 5 CD 0.002 0.214 0.213 0.002 0.157 0.157 CC 0.093 0.229 0.243 0.081 0.171 0.185 lme4 0.003 0.218 0.218 0.005 0.161 0.161 PQL 0.003 0.220 0.220 0.006 0.163 0.163 AVGM 0.004 0.267 0.267 0.016 0.241 0.241 CSL 0.010 0.288 0.288 0.017 0.259 0.259 D3MI 0.009 0.219 0.220 0.021 0.162 0.163 10 CD 0.002 0.200 0.200 0.008 0.148 0.148 CC 0.088 0.223 0.235 0.096 0.161 0.181 lme4 0.006 0.206 0.206 0.007 0.151 0.151 PQL 0.007 0.208 0.208 0.007 0.152 0.152 AVGM 0.016 0.241 0.241 0.013 0.193 0.193 CSL 0.017 0.259 0.259 0.006 0.213 0.213 D3MI 0.022 0.207 0.208 0.016 0.152 0.152 Strong 5 CD 0.007 0.312 0.312 0.003 0.272 0.272 CC 0.093 0.326 0.336 0.086 0.282 0.292 lme4 0.016 0.316 0.316 0.014 0.275 0.275 PQL 0.016 0.316 0.316 0.014 0.275 0.275 AVGM 0.065 1.023 1.019 0.090 1.041 1.038 CSL 0.099 1.103 1.103 0.122 1.126 1.127 D3MI 0.026 0.316 0.316 0.025 0.275 0.276 10 CD 0.009 0.265 0.265 0.015 0.219 0.219 CC 0.092 0.286 0.297 0.100 0.229 0.245 lme4 0.020 0.271 0.271 0.018 0.223 0.224 PQL 0.020 0.271 0.271 0.018 0.224 0.224 AVGM 0.082 0.813 0.808 0.086 0.758 0.753 CSL 0.105 0.880 0.878 0.088 0.823 0.819 D3MI 0.032 0.270 0.272 0.024 0.223 0.224解説: シミュレーションシナリオa)における結果をまとめた表で、1つの二値変数に欠損がある場合の、異なる手法によるバイアス、標準偏差(SD)、二乗平均平方根誤差(rMSE)が示されています。部位間異質性の強弱(Weak/Strong)とサイト数(5/10)の条件下での性能が比較されており、D3MIが既存のSOTA手法と比較して優れた性能を示すことが示されています。はこのシナリオでの結果をまとめており、特に異質性が強い条件下でのD3MIの優位性が顕著です。
シナリオb):1つの連続変数に欠損がある場合
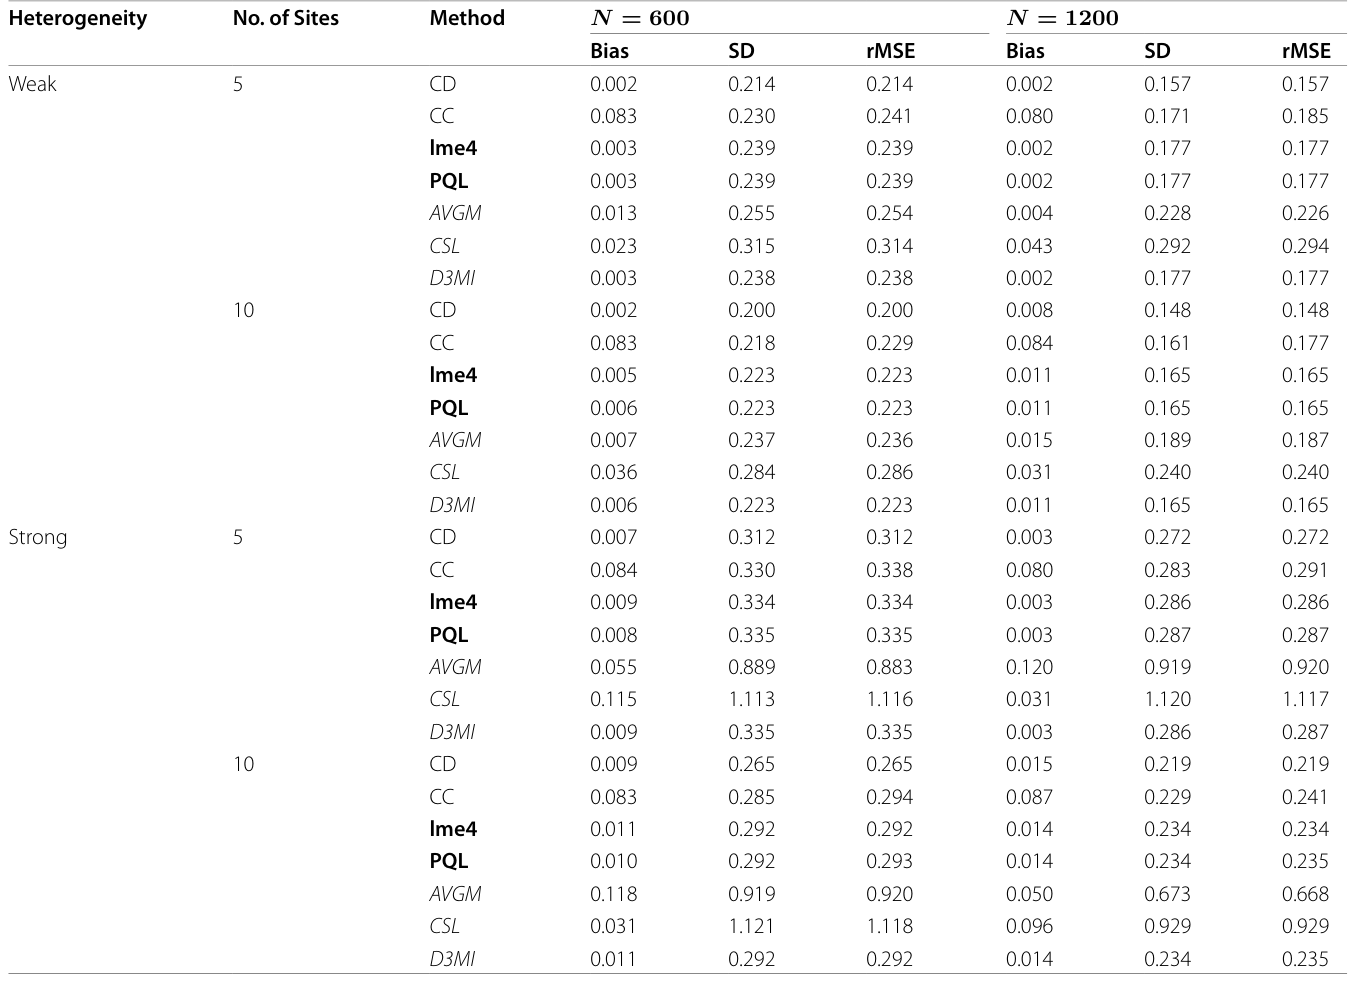
Table 2. Table 2 Simulation scenario b) one continuous variable has missingness. Mixed model-based imputation methods are in bold, distributed imputation methods are in italics. Benchmark methods are in shaded cells, including two analyses without imputation and two centralized imputation methods Heterogeneity No. of Sites Method i n line-eq-IEq74 i n line-eq-IEq75 Bias SD rMSE Bias SD rMSE Weak 5 CD 0.002 0.214 0.214 0.002 0.157 0.157 CC 0.083 0.230 0.241 0.080 0.171 0.185 lme4 0.003 0.239 0.239 0.002 0.177 0.177 PQL 0.003 0.239 0.239 0.002 0.177 0.177 AVGM 0.013 0.255 0.254 0.004 0.228 0.226 CSL 0.023 0.315 0.314 0.043 0.292 0.294 D3MI 0.003 0.238 0.238 0.002 0.177 0.177 10 CD 0.002 0.200 0.200 0.008 0.148 0.148 CC 0.083 0.218 0.229 0.084 0.161 0.177 lme4 0.005 0.223 0.223 0.011 0.165 0.165 PQL 0.006 0.223 0.223 0.011 0.165 0.165 AVGM 0.007 0.237 0.236 0.015 0.189 0.187 CSL 0.036 0.284 0.286 0.031 0.240 0.240 D3MI 0.006 0.223 0.223 0.011 0.165 0.165 Strong 5 CD 0.007 0.312 0.312 0.003 0.272 0.272 CC 0.084 0.330 0.338 0.080 0.283 0.291 lme4 0.009 0.334 0.334 0.003 0.286 0.286 PQL 0.008 0.335 0.335 0.003 0.287 0.287 AVGM 0.055 0.889 0.883 0.120 0.919 0.920 CSL 0.115 1.113 1.116 0.031 1.120 1.117 D3MI 0.009 0.335 0.335 0.003 0.286 0.287 10 CD 0.009 0.265 0.265 0.015 0.219 0.219 CC 0.083 0.285 0.294 0.087 0.229 0.241 lme4 0.011 0.292 0.292 0.014 0.234 0.234 PQL 0.010 0.292 0.293 0.014 0.234 0.235 AVGM 0.118 0.919 0.920 0.050 0.673 0.668 CSL 0.031 1.121 1.118 0.096 0.929 0.929 D3MI 0.011 0.292 0.292 0.014 0.234 0.235解説: シミュレーションシナリオb)における結果をまとめた表で、1つの連続変数に欠損がある場合の、異なる手法によるバイアス、標準偏差(SD)、二乗平均平方根誤差(rMSE)が示されています。部位間異質性の強弱とサイト数の条件下での性能が比較されており、D3MIが特に異質性が強い場合にSOTA手法よりも優れた精度と一貫性を示すことが示されています。にこのシナリオの結果が示されています。
シナリオc):二値変数と連続変数の両方に欠損がある場合
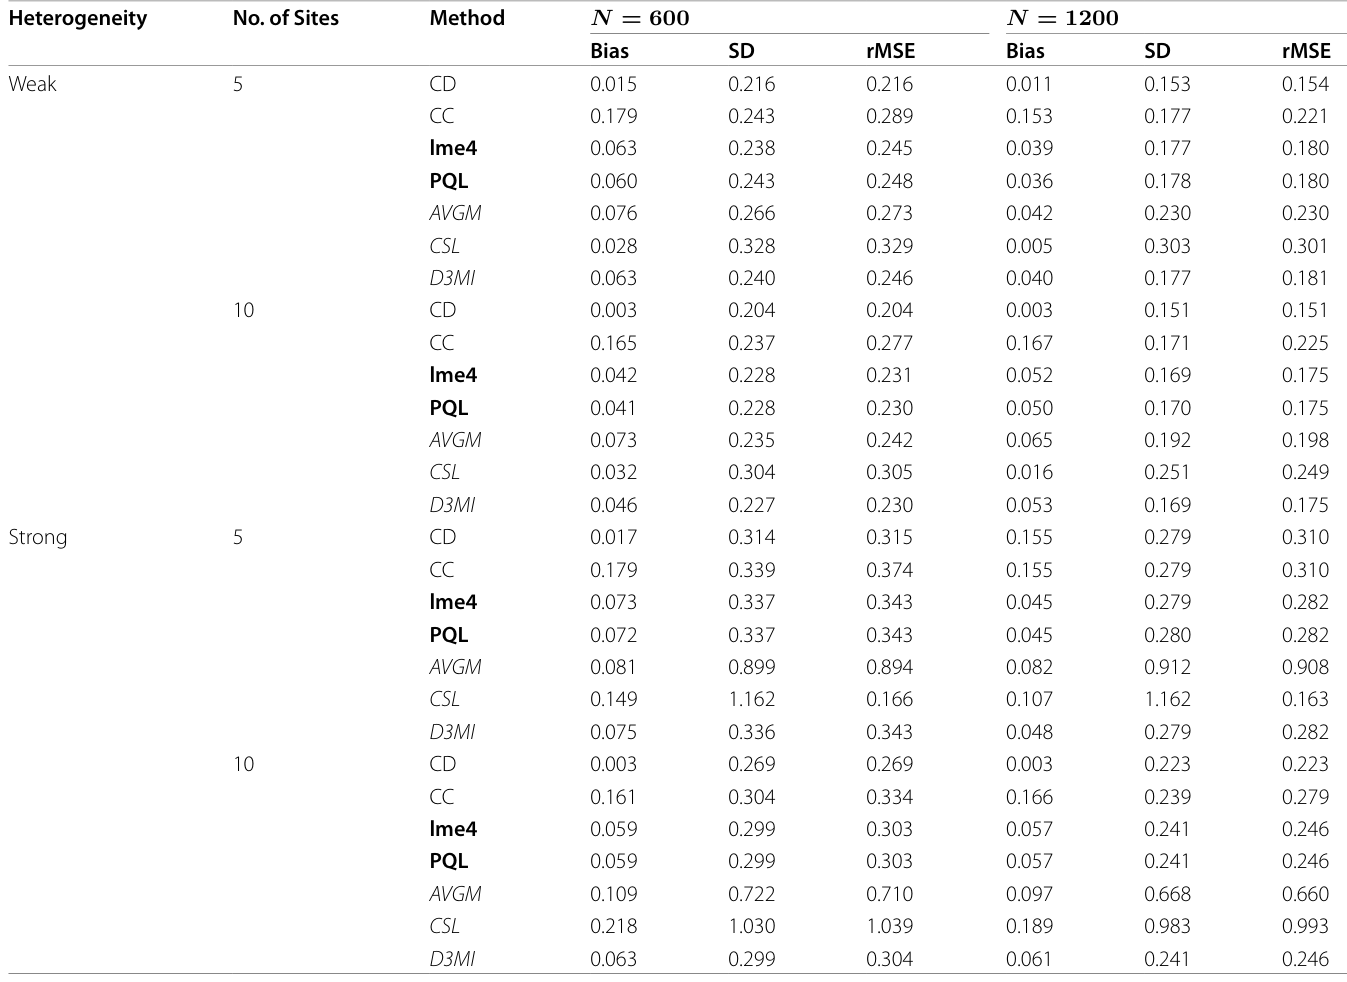
Table 3. Table 3 Simulation scenario c) both the binary variable and the continuous variable have missingness. Mixed model-based imputation methods are in bold, distributed imputation methods are in italics. Benchmark methods are in shaded cells, including two analyses without imputation and two centralized imputation methods Heterogeneity No. of Sites Method i n line-eq-IEq76 i n line-eq-IEq77 Bias SD rMSE Bias SD rMSE Weak 5 CD 0.015 0.216 0.216 0.011 0.153 0.154 CC 0.179 0.243 0.289 0.153 0.177 0.221 lme4 0.063 0.238 0.245 0.039 0.177 0.180 PQL 0.060 0.243 0.248 0.036 0.178 0.180 AVGM 0.076 0.266 0.273 0.042 0.230 0.230 CSL 0.028 0.328 0.329 0.005 0.303 0.301 D3MI 0.063 0.240 0.246 0.040 0.177 0.181 10 CD 0.003 0.204 0.204 0.003 0.151 0.151 CC 0.165 0.237 0.277 0.167 0.171 0.225 lme4 0.042 0.228 0.231 0.052 0.169 0.175 PQL 0.041 0.228 0.230 0.050 0.170 0.175 AVGM 0.073 0.235 0.242 0.065 0.192 0.198 CSL 0.032 0.304 0.305 0.016 0.251 0.249 D3MI 0.046 0.227 0.230 0.053 0.169 0.175 Strong 5 CD 0.017 0.314 0.315 0.155 0.279 0.310 CC 0.179 0.339 0.374 0.155 0.279 0.310 lme4 0.073 0.337 0.343 0.045 0.279 0.282 PQL 0.072 0.337 0.343 0.045 0.280 0.282 AVGM 0.081 0.899 0.894 0.082 0.912 0.908 CSL 0.149 1.162 0.166 0.107 1.162 0.163 D3MI 0.075 0.336 0.343 0.048 0.279 0.282 10 CD 0.003 0.269 0.269 0.003 0.223 0.223 CC 0.161 0.304 0.334 0.166 0.239 0.279 lme4 0.059 0.299 0.303 0.057 0.241 0.246 PQL 0.059 0.299 0.303 0.057 0.241 0.246 AVGM 0.109 0.722 0.710 0.097 0.668 0.660 CSL 0.218 1.030 1.039 0.189 0.983 0.993 D3MI 0.063 0.299 0.304 0.061 0.241 0.246解説: シミュレーションシナリオc)における結果をまとめた表で、二値変数と連続変数の両方に欠損がある場合の、異なる手法によるバイアス、標準偏差(SD)、二乗平均平方根誤差(rMSE)が示されています。部位間異質性の強弱とサイト数の条件下での性能が比較されており、D3MIが既存のSOTA手法よりも優れた性能を示し、中央集権型「ゴールデンスタンダード」に近い結果を達成できることが示されています。はこのシナリオにおけるD3MIの優れた性能を示しています。
実世界データでの応用:脳卒中レジストリ事例
著者らはD3MI手法を、実世界の事例研究としてGeorgia Coverdell Acute Stroke Registry(GCASR)データに適用しました。GCASRは、参加病院からの急性脳卒中ケアを改善するための情報を提供しています。この事例研究の主な目的は、異なる欠損値補完アルゴリズムが最終的な推定値にどのように影響するかを探ることでした。D3MIは、施設固有のデータが共有できないと仮定して適用されました。分析には、到着からCTまでの時間(arrival-to-CT time)と、EMSからの事前通知(EMSnote)の関連性を推定し、潜在的な交絡因子と病院間の異質性を調整するGLMMが用いられました。このコホートは67の参加病院から36,422人の対象者で構成され、保険加入状況、人種、性別、到着曜日、到着時間帯、EMSによる脳卒中教育の有無に欠損データが含まれていました(それぞれ1%、1%、8%、14%)。
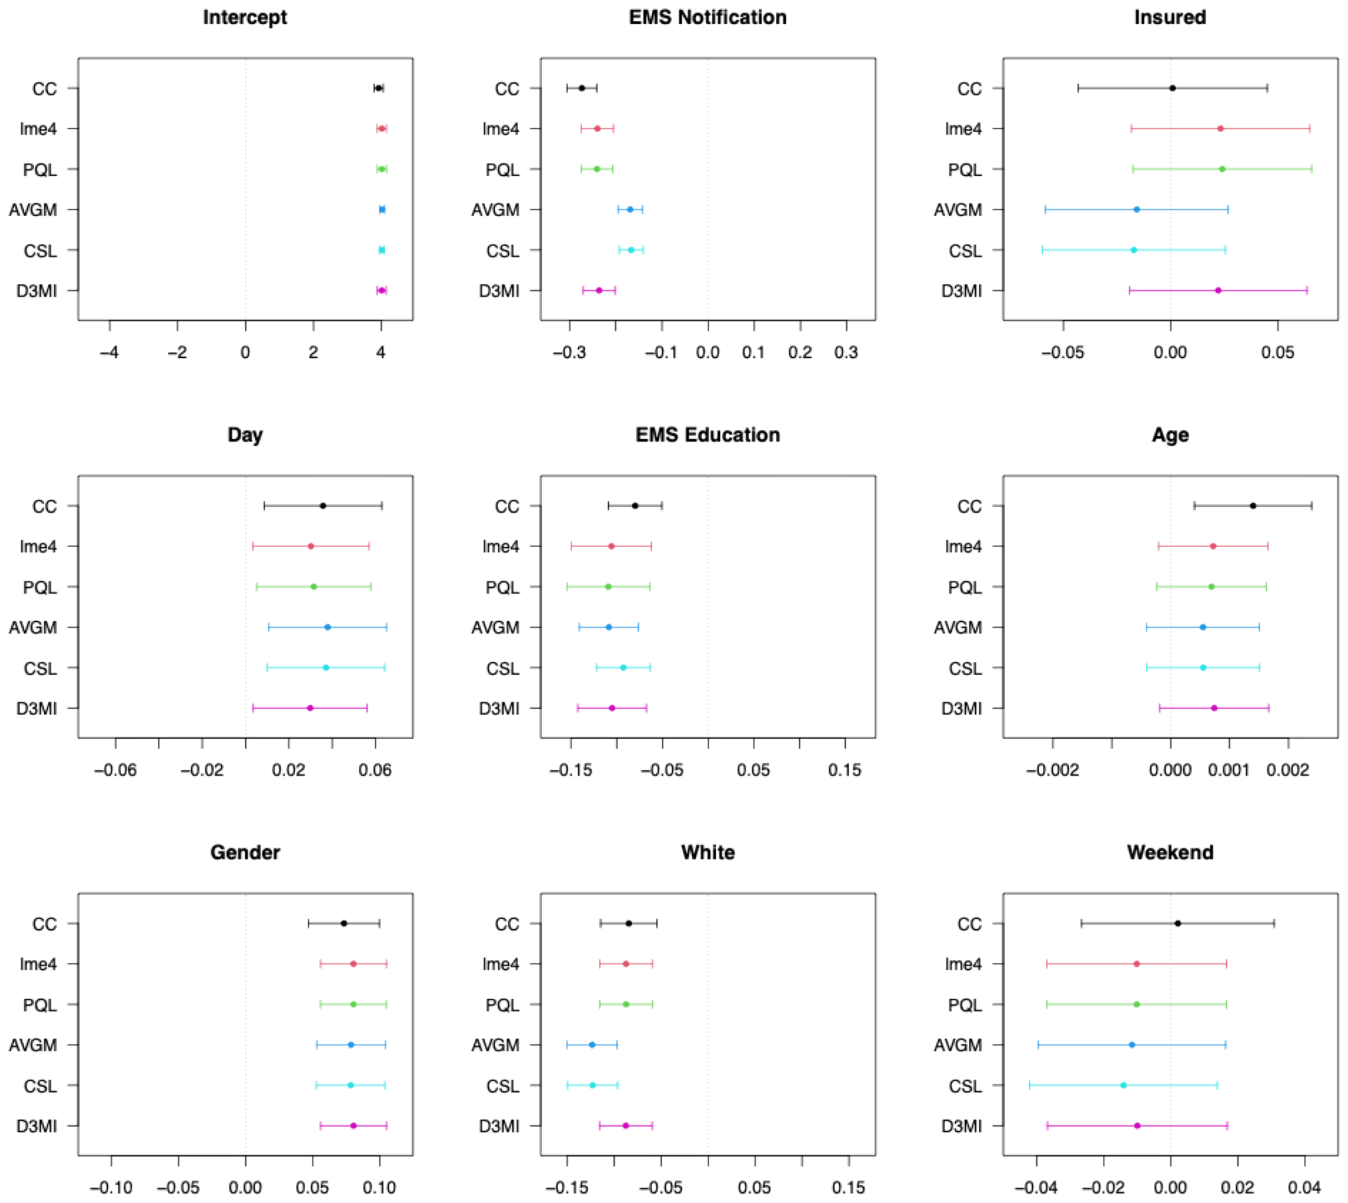
D3MIは、中央集権型の「ゴールデンスタンダード」であるGLMMソルバー(lme4など)を用いた補完と非常に類似した結果を生成しました。この結果は、シミュレーション研究の結果と一致し、D3MIが最小限の計算および通信コストで非常に満足のいく補完結果を生成できることを示唆しています。一方で、AVGMとCSLはGLMMベースの補完および完全症例(CC)分析とは大きく異なる推定値を生成しました。これは、病院間の異質性に対処していないこと、および分散型補完中の情報損失の結果である可能性があります。
結果として、潜在的な交絡因子を調整した後、EMSnoteはログ到着からCTまでの時間の0.24単位の減少(95%信頼区間:0.20から0.27)と関連していました。これは、EMSの事前通知が画像検査を大幅に迅速化し、脳卒中のアウトカムを改善する可能性を示唆しています。
Figure 3. Fig. 3 Estimated model parameters using different imputation and analysis models解説: 異なる欠損値補完および分析モデルを使用して推定されたモデルパラメータを示したグラフです。各点と線は、対応する共変量(切片、EMS通知、保険、曜日、EMS教育、年齢、性別、白人、週末)の推定値とその95%信頼区間を表しています。D3MIの結果は、lme4やPQLといった中央集権型GLMMベースの補完結果と非常に類似している一方で、AVGMやCSLといったGLMベースの分散型補完結果とは異なっていることが示されています。は、異なる補完および分析モデルを用いた推定モデルパラメータを示しています。D3MIの結果はlme4やPQLといった中央集権型手法の結果と非常に近く、AVGMやCSLの結果とは異なっていることがわかります。これらの知見は、欠損値や施設レベルの異質性がある場合でも、D3MIが分散型EHRデータにおける臨床的に意味のあるパターンを解明するためにどのように使用できるかを示しています。
D3MIの強みと今後の展望
D3MIにはいくつかの強みがあります。第一に、分散型D3MIは、分散型データのクラスタリング構造を無視する既存の最先端(SOTA)分散型補完手法と比較して、推定値のバイアスと変動を低減できるという中央集権型GLMMベース多水準補完手法の利点を享受します。シミュレーションは、特に異質性が強い条件下でD3MIが優れた性能を発揮することを示しました。第二に、D3MIは、「ゴールデンスタンダード」のGLMMアルゴリズムを用いた中央集権型GLMMベース補完と同等の結果を生成できることを示しており、既存の多水準補完手法を分散型設定に成功裏に拡張したことを証明しています。最後に、D3MIの計算効率の高さは、将来の研究で追加の変量効果(例:変量勾配)を組み込むことを可能にします。
一方で、D3MIも限界を継承しています。他のGLMMベースの補完手法と同様に、正規分布する変量効果、リンクスケールでの線形予測子、およびMAR(Missing at Random)仮定といったモデルの仮定に敏感です。これらの仮定からの逸脱は結果のロバスト性に影響を与える可能性があり、実世界データにD3MIを適用する際には感度分析が強く推奨されます。また、既存の回帰ベース補完手法と同様に、モデルの誤った特定化にも敏感であり、MNAR(Missing Not At Random:非ランダム欠損)メカニズムの下では性能が限定的である可能性があります。
プライバシー保護の観点では、D3MIは個々の対象者レベルのデータを共有せずにGLMMを適合させますが、差分プライバシーやセキュア多者間計算のような厳密なプライバシー保護手法ではありません。リスクを軽減するためには、小規模集計の抑制、ランダム初期化の使用、高次元モデルの回避といった実用的な安全対策が推奨されます。今後の研究では、D3MIとより強力なプライバシー保護技術の統合が検討されるでしょう。さらに、十分なサイト数が必要であるというGLMMの特性をD3MIも継承しており、部位間異質性が弱い場合には、より単純なGLMベースの補完に対して明確な優位性を示さない可能性があります。これらの限界に対処するためのさらなる研究が期待されています。
まとめ
D3MIは、分散型EHRデータに存在する部位内相関と部位間異質性の両方を考慮に入れる、効率的なフェデレーテッド欠損値補完手法です。欠損値補完の精度を向上させつつ、プライバシーを保護することで、D3MIは分散型医療やその他の多施設共同研究における、より妥当で再現性の高い分析を支援します。これにより、大規模かつ多様なEHRデータを活用した臨床研究の可能性が大きく広がることが期待されます。
用語集
フェデレーテッドラーニング(連合学習) : 生データを共有することなく、複数の分散したデータソース(医療施設など)間で機械学習モデルを共同で訓練する技術。プライバシー保護に貢献します。欠損値補完 : データセット中の未記録または利用できない値(欠損値)を、既存の観測値に基づいて統計的に推定・埋めるプロセス。分析結果の偏りを防ぎます。EHR(電子カルテ) : 電子的な形式で記録・管理される対象者の健康情報。診断、治療、投薬履歴などが含まれます。部位内相関 : 同一の施設やグループに属する対象者のデータが、他の施設やグループの対象者のデータよりも互いに類似している傾向のこと。部位間異質性 : 異なる施設やグループ間で、データの特性や分布にばらつきや違いがあること。一般化線形混合モデル(GLMM) : データが複数のレベル(例:対象者と施設)で構造化されている場合に、ランダム効果(変量効果)を導入して分析する統計モデル。相関データや異質なデータに適しています。MAR(Missing at Random)仮定 : データの欠損が、観測されているデータのみに依存し、欠損しているデータ自体には依存しないという仮定。多くの欠損値補完手法の基盤となります。ゴールデンスタンダード : 比較対象となる最高水準や最も信頼性の高い標準のこと。ここでは、中央集権型で理想的な条件下での最良の性能を指します。Rubinのルール : 複数の補完されたデータセットから得られた推定値を結合し、最終的な結果と信頼区間を算出するための統計的手法。
powered by visionary imaging services, inc.

コメントを残す