
医療情報の標準化を加速!SNOMED CTマッピングにおける人間とAIの協調ワークフロー
解説対象論文: Development and Validation of Human-AI Collaborative Workflow in SNOMED CT Mapping of Bilingual Clinical Text
Journal of Medical Systems|被引用数: 0(2026年10月4日時点)
医療現場で生成される膨大な量の自由記述式テキストを、標準化された医療用語体系であるSNOMED CTに正確かつ効率的にマッピングすることは、長年の課題でした。この最新の研究では、大規模言語モデルを活用したAIエージェントシステムが、人間の専門家との協調ワークフローにおいて、マッピングの精度と効率性をどのように向上させるかを検証しました。
はじめに:医療情報標準化の重要性とSNOMED CTの課題
どうも、Beyond the Pixelです。医療情報のセマンティックインターオペラビリティ(異なるシステム間で情報の意味を正確に共有・理解できること)の国際標準として、SNOMED CT(Systematized Nomenclature of Medicine–Clinical Terminology)が広く利用されています。SNOMED CTは、診断、処置、所見にわたる階層的および連想的関係のセマンティックネットワークを持つ包括的な多言語臨床用語集であり、電子カルテ、臨床意思決定支援システム、公衆衛生インフラ全体で一貫したドキュメント作成、多施設データ統合、および研究のための健康データの二次利用の基盤となります。しかし、自由記述式の臨床テキストをSNOMED CTの概念にマッピングする作業は、これまで膨大な労力を必要とする作業でした。手作業によるアノテーションは労働集約的であり、特に臨床記述があいまいまたは文脈依存的である場合、アノテーター間のばらつきが頻繁に発生し、下流システムにエラーが伝播したり、再現性を妨げたりする可能性があります。このような課題を解決するため、スケーラブルで再現性のある概念マッピングのフレームワークが求められています。本研究では、バイリンガル(二言語対応)の臨床テキストをSNOMED CTの概念にマッピングする大規模言語モデル(LLM)エージェントシステムを開発し、人間とAIの協調ワークフロー内でのマッピング精度と効率に対するその効果を評価しました。
革新的なAIエージェントシステムのアーキテクチャ
この研究チームは、SNOMED CTへのマッピングを支援するエージェントシステムを開発しました。このシステムは、LangChainフレームワークに基づいて構築されており、GPT-4 Turboを基盤LLMとして使用しています。システムは、生の臨床テキストを受け取り、以下の3つのモジュールを通して順次処理します。
1. 翻訳モジュール: 入力テキストの言語を検出し、韓国語のみ、または韓国語と英語が混在する非英語の文章を英語に翻訳します。臨床用語、薬剤名、処置名など、すでに英語で書かれているものは、医療の具体性を保つためにそのまま保持されます。
2. 略語展開モジュール: カテゴリと部門のメタデータを活用して、ドメイン固有の略語や頭字語を識別し、展開します。例えば、「PCI」は循環器内科の文脈では「Percutaneous Coronary Intervention(経皮的冠動脈インターベンション)」と展開されますが、他の臨床文脈では異なる展開がされる可能性があります。
3. リトリーバーモジュール: 処理されたテキストを、生物医学ドメイン固有のTransformerモデルであるMedCPT-Query-Encoderを使用してエンコードし、事前に埋め込まれたSNOMED CT概念データベース(ChromaDB)に対してコサイン類似度検索を実行します。このモジュールは、後続の評価または人間のレビューのために、上位20件の候補SNOMED CT概念(概念識別子と完全指定名)を返します。
これらのモジュールが連携して、バイリンガルの臨床テキストからSNOMED CTの概念を効率的に検索する仕組みを構築しています。SNOMED CTの概念埋め込みはオフラインで生成され、用語の更新に合わせて定期的にリフレッシュされるため、再トレーニングなしで持続可能なソリューションを提供します。
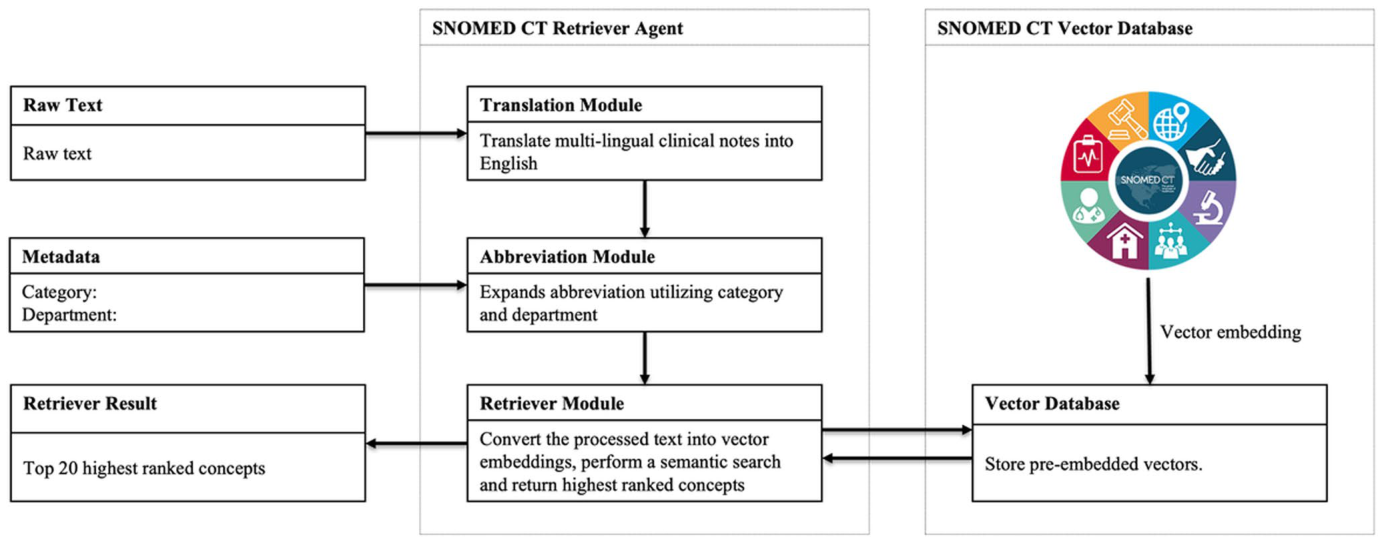
は、このAIエージェントシステムのアーキテクチャを示しています。
研究デザインと評価方法
この研究では、韓国の三次医療施設で収集された2,261の匿名化されたバイリンガル臨床テキストセグメントを使用しました。これらのセグメントは、9つの臨床カテゴリ(検査、高度処置、高度治療、基礎疾患、病変特性、投薬、再発性疾患、症状、病歴)にわたるもので、各カテゴリからバランスよく収集されました。
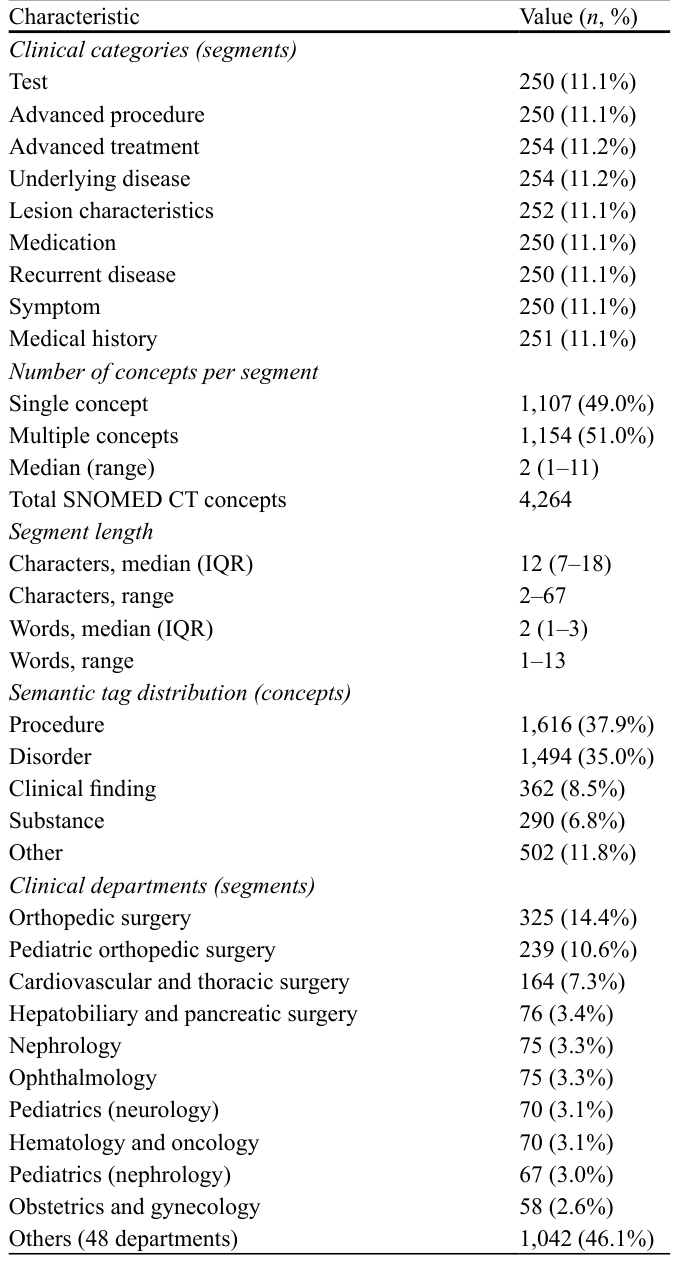
は、この研究で用いられたデータセットの特性をまとめたものです。
研究チームは、以下の3つのマッピングアプローチを評価しました。
* 人間のみ(Human-only): 3人の健康情報管理専門家が、AIエージェントの提案なしに、SNOMED CTブラウザを使用して手動でコーディングを行いました。
* エージェントのみ(Agent-only): 翻訳モジュール、略語展開モジュール、リトリーバーモジュールからなるAIエージェントパイプラインを人間による介入なしで実行し、リトリーバーモジュールが返す上位20件のSNOMED CT概念を最終出力としました。
* エージェント支援人間(Agent-assisted human): ウェブベースのインターフェースを通じて、AIエージェントが提示するSNOMED CT候補リストを健康情報管理専門家が利用しました。専門家は、候補を選択、修正、または拒否する完全な権限を持ちました。このインターフェースには、カテゴリによるフィルタリング、手動入力、完全一致の強調表示、外部SNOMED CTブラウザへの直接統合などの機能が含まれていました。
マッピングのパフォーマンスは、ヒット率、精度、再現率、F1スコア(k=1およびk=5で計算)、およびR-precision(参照概念の数と同じカットオフで評価する指標)を用いて評価されました。また、人間のみのアプローチと人間とAIの協調アプローチの間でマッピング時間の比較も行われました。
人間とAIの協調ワークフローがもたらす効果
この研究の結果は、人間とAIの協調ワークフローがSNOMED CTマッピングの精度と効率性の両方を大幅に向上させることを明確に示しました。
1. 精度の大幅な向上
AIエージェント支援型の人間のアプローチは、プールされたヒット率@1(上位1つの候補に正解が含まれる割合)で0.868を達成し、人間のみのアプローチ(0.837)とエージェントのみのアプローチ(0.701)を上回りました。また、R-precisionも人間のみの0.632に対し、エージェント支援型では0.674に向上しました。これは、各マッピング決定時に有効なSNOMED CT候補のセットを拡張するAIエージェント支援ワークフローが、専門家がより正確な概念を特定するのに役立ったことを示唆しています。
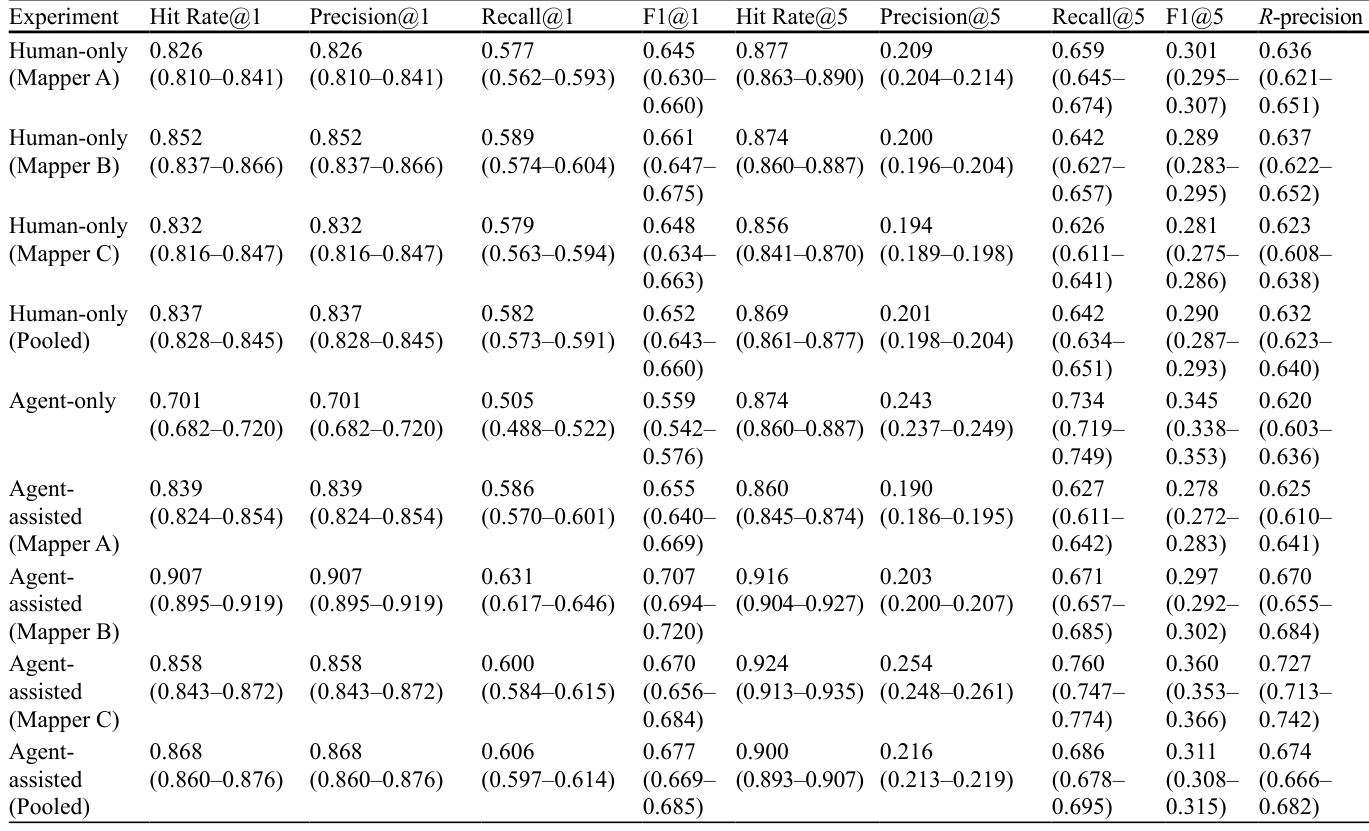
は、3つのマッピングアプローチにおけるパフォーマンス比較を示しています。
2. マッピング時間の劇的な短縮
合計マッピング時間は、人間のみのアプローチが3,551.0分(約59.2時間)であったのに対し、AIエージェント支援型では1,638.9分(約27.3時間、エージェントの処理時間431.1分を含む)となり、53.9%の時間短縮が認められました(p < 0.001)。セグメントあたりの平均マッピング時間は、専門家の作業時間で1.57分から0.53分に減少しました。エージェントの処理時間を含めても、1.57分から0.72分に短縮されました。この時間短縮は、9つの臨床カテゴリすべてで一貫して見られ、最も大幅な削減は症状関連テキスト(64.6%減)、最も小さな削減は高度治療(35.8%減)でした。
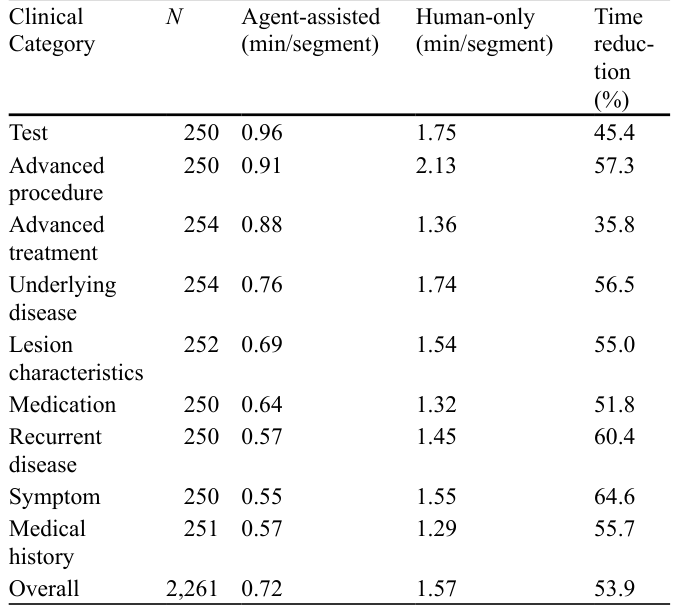
は、臨床カテゴリごとのSNOMED CTマッピング時間の比較をまとめたものです。
3. AI支援の活用と専門家の判断
AIエージェントが提示した候補リストから、約79%の概念が選択されました。これは、エージェントが専門家の作業を効果的に支援していることを示しています。しかし、残りの21%の概念はSNOMED CTブラウザを通じて独立して特定されており、専門家がエージェントの提案を超えた判断を行っていることが分かります。これは、SNOMED CTの階層的および属性関係をナビゲートするには、引き続き専門家の判断が不可欠であることを裏付けています。
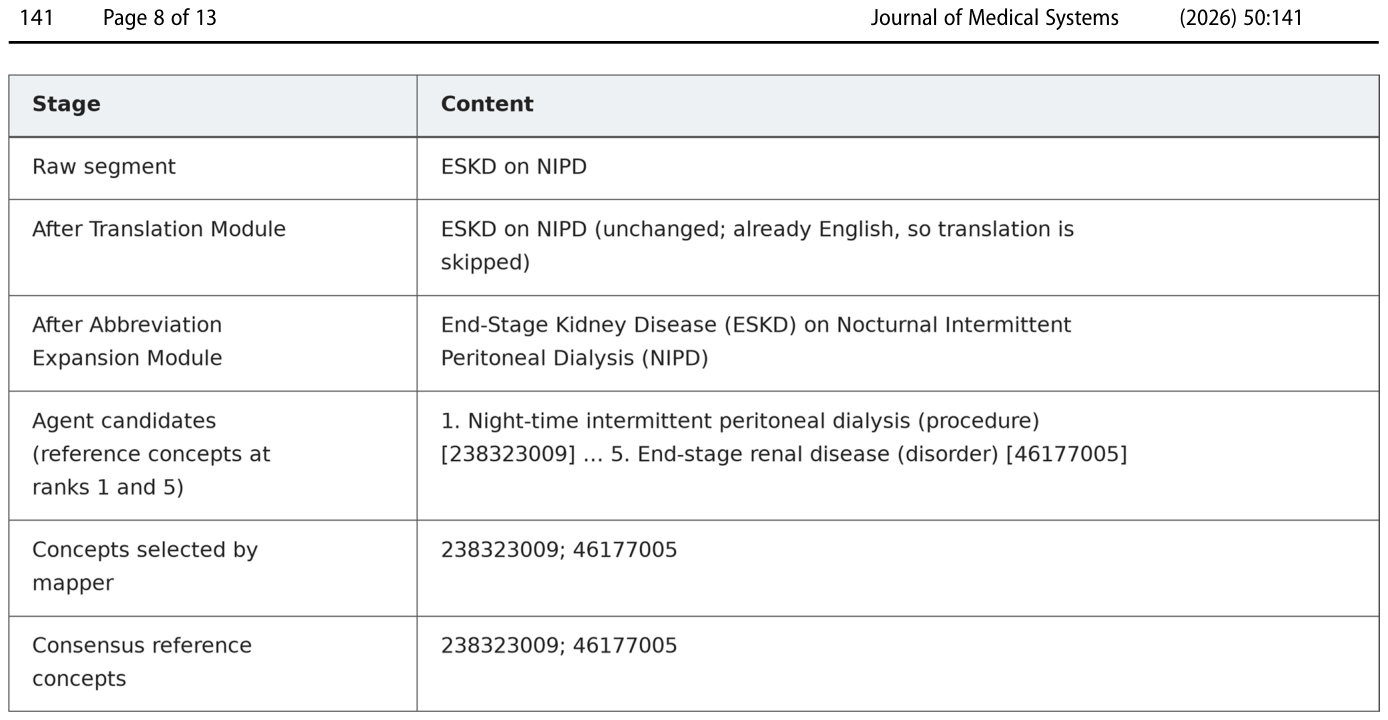
は、「ESKD on NIPD」という臨床テキストセグメントが、翻訳、略語展開、リトリーバーモジュールによってどのように処理され、正しい参照概念が候補リストの上位に提示されるかを示す具体例です。
サブグループ解析では、単一概念レコードと複数概念レコードの間でパフォーマンスに違いが見られましたが、エージェント支援マッピングは、概念数別およびほとんどの臨床カテゴリで、F1スコアおよびR-precisionにおいて人間のみのマッピングを上回りました。
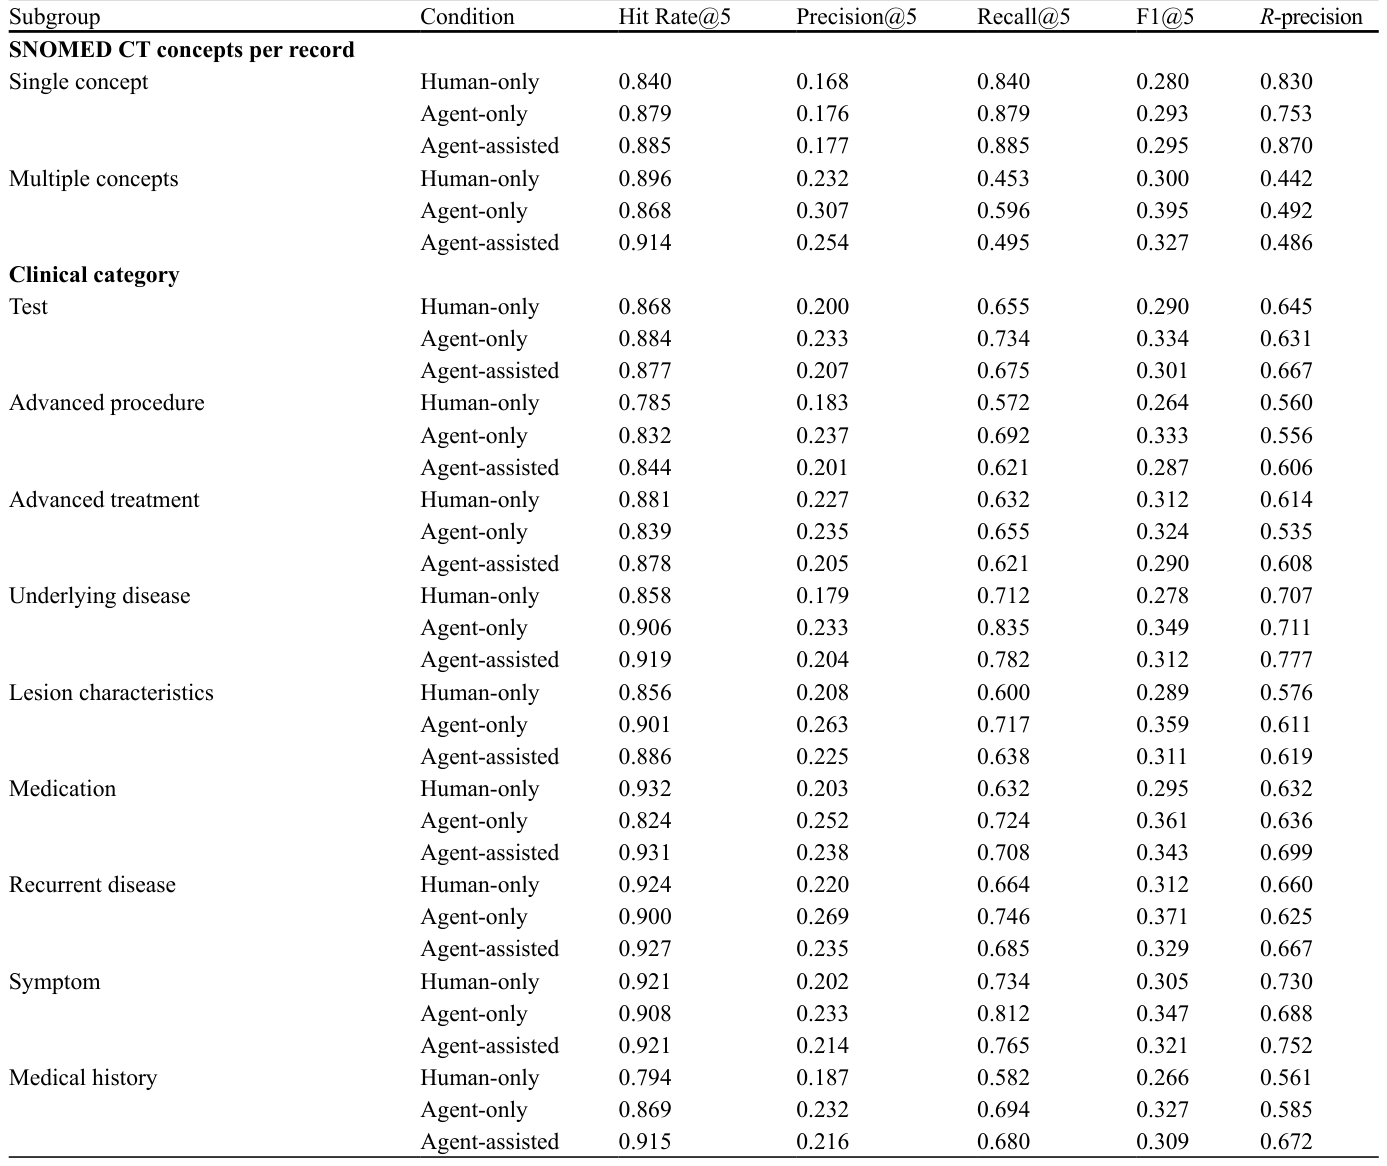
は、SNOMED CT概念数および臨床カテゴリ別のマッピングパフォーマンスのサブグループ解析を示しています。
研究の意義と持続可能性
この研究の最も重要な成果の一つは、人間とAIの協調アプローチが、専門家が利用できる有効なSNOMED CT候補の「空間」を拡張することで、マッピング精度を向上させつつ、時間を約半分に短縮したことです。特に、SNOMED CT国際版が毎月更新されることに対応し、再トレーニングなしでベクトルデータベースを定期的に更新できるモジュール型アーキテクチャは、バイリンガル臨床用語の標準化にとって持続可能かつ効率的なソリューションを提供します。
また、このシステムは、ローカル環境内で完全に動作する事前に埋め込まれたSNOMED CTベクトルデータベースを使用しており、検索中に外部APIを呼び出す必要がありません。これにより、対象者データがオンプレミス(医療施設内)に保持される必要がある病院にとって、セキュリティとプライバシーの面で有利な設計となっています。翻訳および略語モジュールは現在、外部LLM APIを呼び出していますが、完全にオンプレミスで展開するには、ローカルでホストされるモデルが必要となるでしょう。
プロンプトベースのアーキテクチャは、プロンプトを変更することで特定の専門分野や文書スタイルに適応させることができ、翻訳モジュールはバイリンガル機能を提供し、主に英語テキスト用に設計されたツールにおける既知のギャップを埋めます。この研究で示された53.9%という全体的なマッピング時間の削減は、手動コーディングが主要なリソースのボトルネックとなっている用語標準化プログラムにとって、実用上大きな意味を持ちます。
限界と今後の展望
この研究にはいくつかの限界も存在します。まず、単一の医療施設(三次医療機関)における退院記録と手術記録を使用して評価されたため、他の医療現場における臨床文書の多様性を完全に代表しているとは限りません。また、韓国語と英語のバイリンガル環境でシステムは良好なパフォーマンスを示しましたが、他の言語ペアへの汎用性は別途調査が必要です。第二に、評価者のプールが3人の専門家に限定されており、より広範な評価が必要となります。各セグメントは周囲の臨床記録なしで単独でマッピングされたため、実世界のパフォーマンスの変動を過小評価している可能性があります。第三に、翻訳モジュールと略語モジュールは独自のLLM APIに依存しており、厳格なデータガバナンス下ではオープンソースの代替品が必要となるでしょう。第四に、マッピング時間の測定に非対称性がありました(エージェント支援では自動記録、人間のみでは自己申告)。今後の評価では、すべての条件で自動時間記録を使用する必要があります。第五に、参照パネルとマッパーが同じ機関とマッピングガイドラインを共有していたため、エラーが条件付きで独立していない可能性があります。最後に、両条件は固定順序で実行され、順序の調整(カウンターバランシング)が行われなかったため、先行するセッションからの残留的な影響を排除することはできません。
今後の研究では、この単一の三次医療機関を超えた多施設および前向きな検証、追加の言語ペアへの拡張、厳格なデータガバナンス要件下での独自LLM APIのオープンソース代替品への置き換えなどが含まれるべきです。複雑な略語やネストされた略語でのパフォーマンス、およびユーザーフィードバックメカニズムの価値も研究に値します。
結論として、この人間とAIの協調アプローチは、SNOMED CTマッピングの精度を向上させ、コーディング時間を約半分に削減する、持続可能で適応可能なソリューションを提供します。
用語集
- SNOMED CT: 「Systematized Nomenclature of Medicine–Clinical Terminology」の略で、医療情報を標準化するための包括的な多言語臨床用語体系です。
- LLM: 「Large Language Model」の略で、大量のテキストデータで学習された、人間のようなテキストを理解・生成できるAIモデルです。
- ベクトルデータベース: テキストなどの情報を数値のベクトル(数値列)として保存し、意味的な類似性に基づいて高速に検索できるデータベースです。
- セマンティックインターオペラビリティ: 異なるシステムやアプリケーション間で、共有される情報の意味を正確に解釈し、利用できる能力を指します。
- RAG: 「Retrieval-Augmented Generation」の略で、大規模言語モデルが外部の知識源(データベースなど)から情報を検索し、その情報に基づいて応答を生成する技術です。
- ヒット率: 検索結果や候補リストの中に、少なくとも1つの正解が含まれている割合を示す指標です。
- 精度: 検索システムやマッピングシステムが返した結果のうち、実際に正しいものの割合を示す指標です。
- 再現率: 存在するすべての正解(参照概念)のうち、システムがどれだけ多くを正確に識別できたかを示す指標です。
- F1スコア: 精度と再現率の調和平均であり、両方のバランスを考慮した総合的な評価指標です。
- R-precision: 参照概念の数と同じ数だけ候補を考慮し、その中に含まれる正しい概念の割合を評価する指標です。
- 自由記述式臨床テキスト: 電子カルテなどに記録される、定型化されていない専門家による自然言語での記述です。
コメントを残す