
聴覚専門家が導くマルチモーダルAI:聴力検査報告の精度向上と課題
解説対象論文: Audiologist-Guided Multimodal AI for Pure-Tone Audiometry and Tympanometry Interpretation and Reporting
Journal of Medical Systems|被引用数: 0(2026年10月3日時点)
聴覚検査の報告書作成において、AIの活用は大きな可能性を秘めています。特に、画像情報とテキスト情報を組み合わせる「マルチモーダルAI」は、聴覚専門家の業務負担を軽減し、報告の質を高めることが期待されています。しかし、AIが生成する最終的な報告書の精度だけでは、エラーの原因が画像の読み取りにあるのか、専門的な判断ルールにあるのか、あるいはコミュニケーションの段階にあるのかを特定することは困難です。本記事では、聴覚検査におけるAI支援の課題と可能性を探るため、純音聴力検査とティンパノメトリーの解釈と報告に焦点を当てた、聴覚専門家主導のマルチモーダルAIの研究について詳しく解説します。
はじめに:聴覚検査とAI活用の重要性
どうも、Beyond the Pixelです。
聴覚検査の分野では、純音聴力検査(PTA)やティンパノメトリーといった評価が、難聴や中耳の健康状態を診断するための基礎となります。これらの検査では、周波数ごとの気骨導閾値、マスキング、応答なし(N/NR)、気骨導ギャップ(ABG)、ティンパノグラムの曲線と測定値、アコースティックレフレックスのスクリーニング、既往歴、耳鏡検査などの多様な情報を統合して解釈する必要があります。そして、その結果を専門家と対象者の双方に、それぞれに適した形で分かりやすく伝えることが求められます。
近年、医療分野における人工知能(AI)の活用は目覚ましく、聴覚分野でも自動評価、専門知識を要する言語モデル(LLM)タスク、チャットボットの性能向上など、多岐にわたる研究が進んでいます。しかし、AIが最終的に生成する報告書のエンドツーエンドのスコアだけでは、エラーが画像転記、専門的なルール実行、あるいは情報伝達のどの段階で発生したのかを明確に特定することは困難でした。このような背景から、本研究では、聴覚検査の報告書作成を支援するマルチモーダルAIが、エラーの発生源を隠すことなく、それぞれのモジュールでどのように機能するかを評価することを目的としました。モジュール式の評価を行うことで、聴覚専門家の専門知識がAIの精度向上にどのように貢献するのか、また、どのような課題が残されているのかを明らかにしています。
研究デザイン:モジュール式アプローチでAIを評価
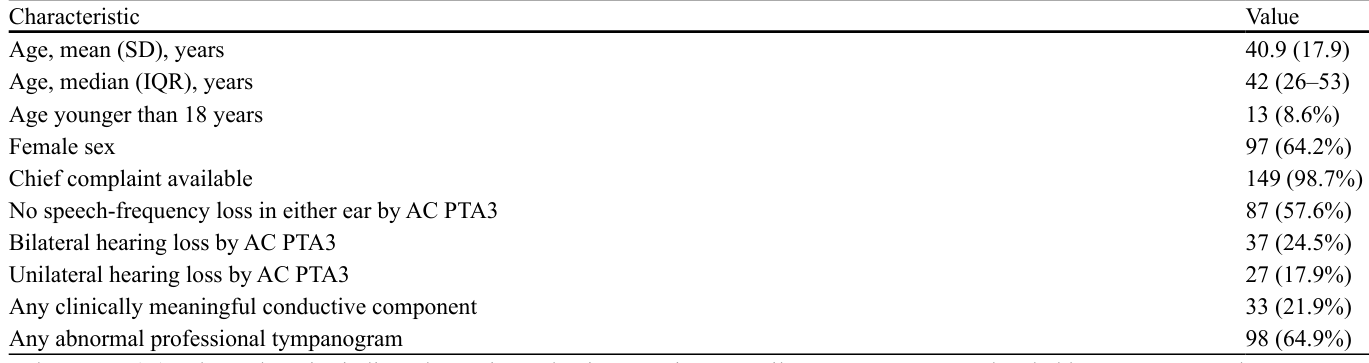
この研究では、純音聴力検査(PTA)とティンパノメトリーの画像転記および解釈、さらに構造化された入力からの報告書作成を、それぞれ独立したAIモジュールとして評価しました。対象となったのは、中国の統合医療施設から収集された2024年12月から2025年3月までの158件の外来聴覚検査記録です。このうち、適格基準を満たさない3件と、重複した対象者の4件を除外し、最終的に151名の独立した対象者(計302耳)の記録が使用されました。倫理的な配慮として、すべての直接識別情報は削除され、匿名化された記録のみが人間評価者やAIシステムによってアクセスされました。倫理承認は、香港大学と寧波病院の統合医療倫理委員会から得られています。
本研究は大きく2つのモジュールに分かれています。
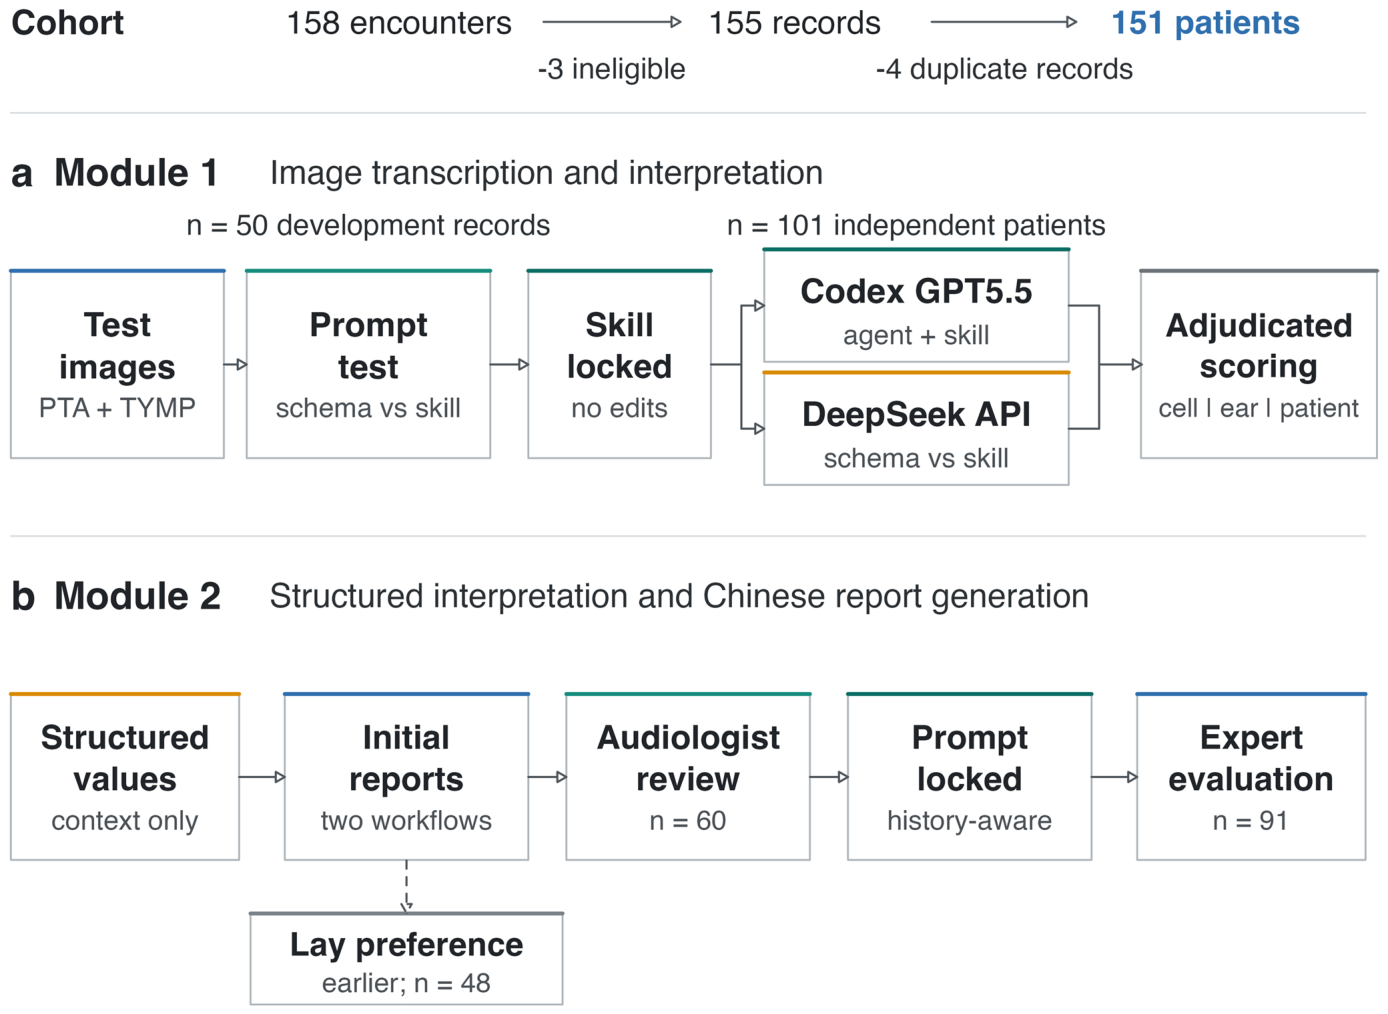
まず、モジュール1では、純音聴力検査とティンパノメトリーの画像からの転記と解釈に焦点を当てました。ここでは、専門的な知識なしのスキーマのみのプロンプトと、聴覚専門家のスキルを組み込んだプロンプトの性能が比較されました。次に、モジュール2では、モジュール1の出力を使用せず、専門家が調整した構造化された入力値から、中国語の専門家向けおよび対象者向けの報告書を作成するAIワークフローのルール遵守性と評価が行われました。
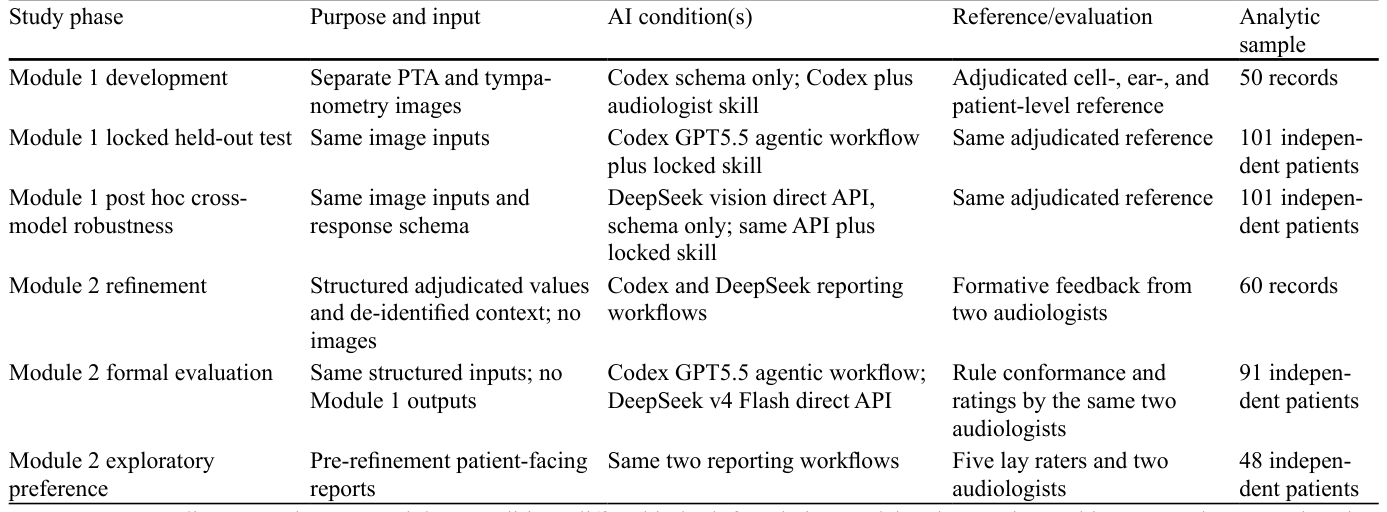
このようなモジュール式の評価は、エラーの原因を明確にし、AI支援が実際にどこで価値を付加できるのかを深く理解するために不可欠です。
モジュール1:画像の転記と解釈の精度
モジュール1では、聴覚検査画像の転記と解釈におけるAIの性能が評価されました。まず、50件の開発記録を用いて、専門知識を付与しない「スキーマのみ」のプロンプトと、聴覚専門家のスキルを組み込んだプロンプトの性能が比較されました。この開発フェーズでスキルが固定された後、101名の独立した対象者の記録に対し、Codex GPT5.5を搭載したエージェントワークフローでテストされました。さらに、Codexとは異なるモデルであるDeepSeek-V4-Flash-Vision-Expを用いて、同じ101名の対象者に対してスキル有無の頑健性分析も実施されました。
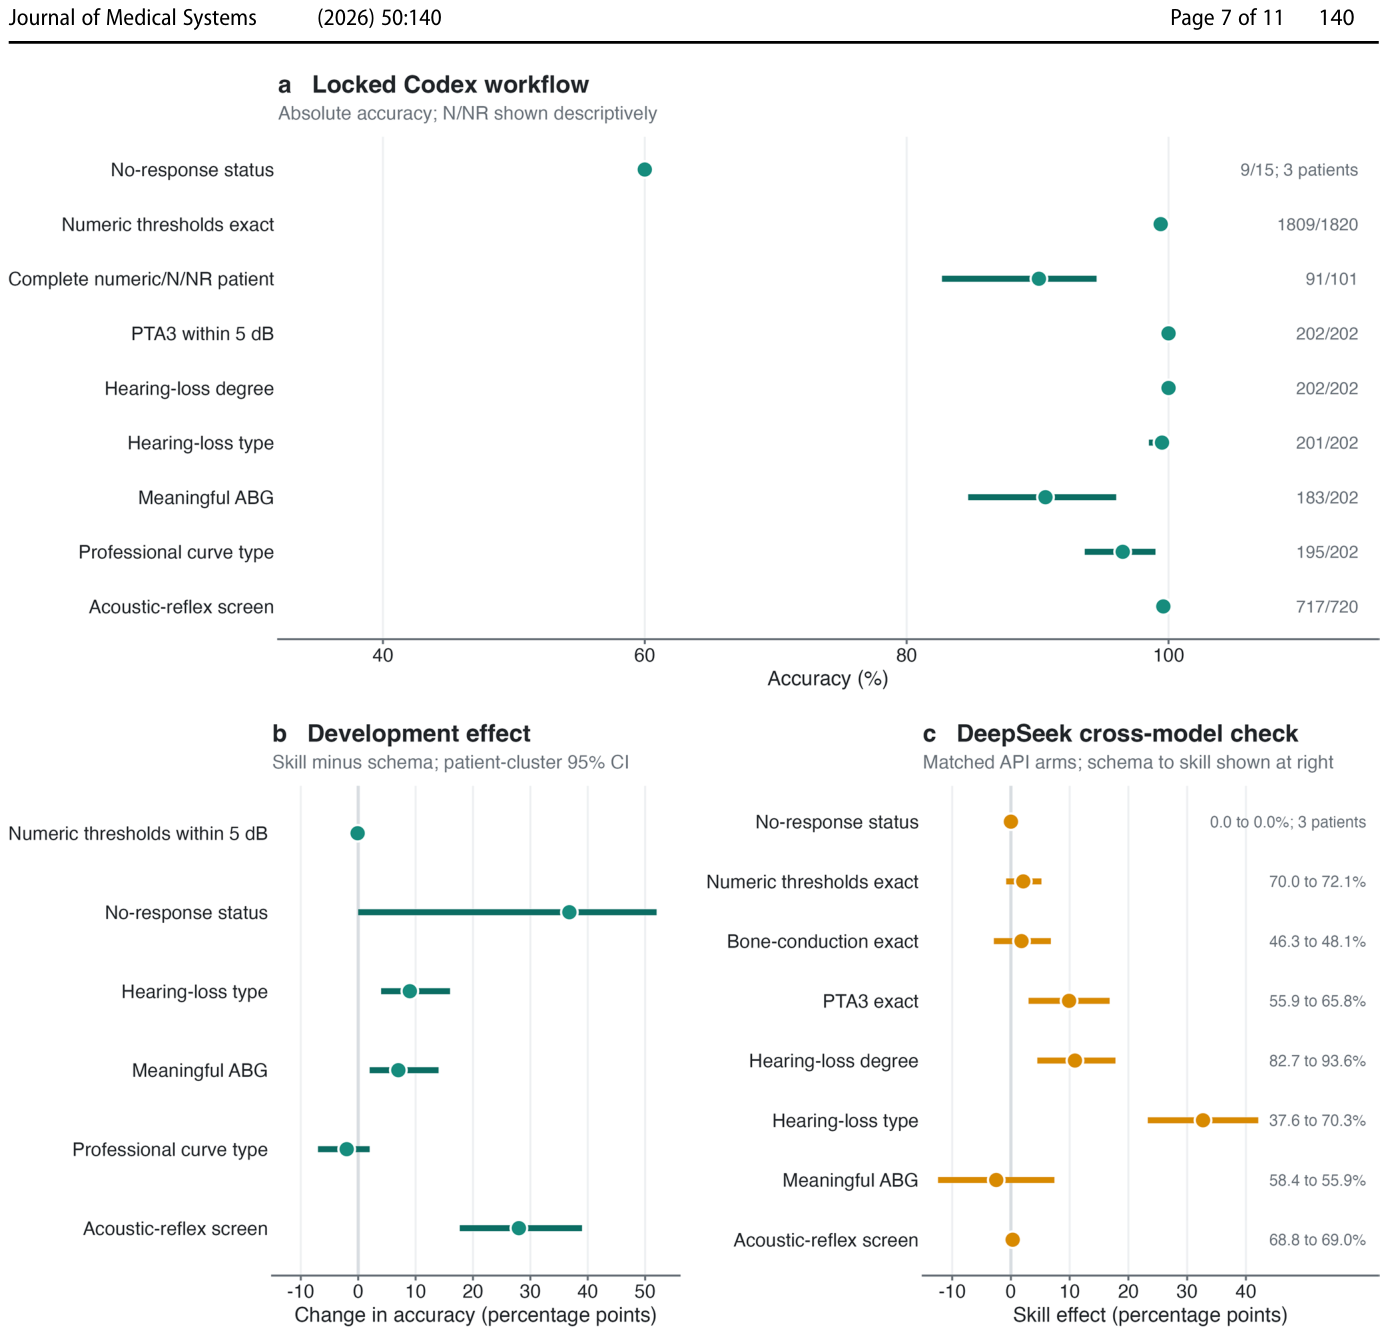
開発フェーズでは、聴覚専門家のスキルを導入することで、聴力損失タイプの合致率が85.0%から94.0%に、アコースティックレフレックスの合致率が70.4%から98.4%へと大幅に向上しました。Codexを用いた検証では、数値閾値の99.4%が正確に抽出されました。しかし、「応答なし(N/NR)」の項目では、15件中9件(60.0%)しか正しく認識されませんでした。DeepSeekを用いた頑健性分析では、スキルが聴力損失タイプの合致率を37.6%から70.3%に向上させましたが、正確な数値閾値の合致率は72.1%、応答なしの合致率は0%にとどまり、モデルや実装環境によって画像認識の性能に差があることが示唆されました。
モジュール2:構造化された解釈と報告書作成
モジュール2では、聴覚専門家が調整した構造化された入力値を受け取り、そこから専門家向けおよび対象者向けの中国語の報告書を生成するAIワークフローが評価されました。このモジュールは、モジュール1で得られた画像からの抽出結果ではなく、専門家が精査したデータを使用する点で独立しています。まず、2名の聴覚専門家が60件の記録を用いてAIが作成した初期の報告書をレビューし、低周波数や高周波数の損失の見落とし、既往歴と結果の統合の不足といった改善点を特定しました。これらのフィードバックを基にプロンプトが改良された後、91名の独立した対象者の記録を用いて正式な評価が行われました。
その結果、Codexワークフローでは25のルールに基づくすべてのフィールドが91件中91件で正しく、DeepSeekワークフローでは91件中87件で正しく、非常に高いルール遵守性を示しました。両ワークフローが生成した中国語の報告書は、2名の聴覚専門家のいずれからも「正確」または「ほぼ正確」と評価され、「明らかなエラー」や「誤解を招く可能性のある深刻なエラー」は認められませんでした。
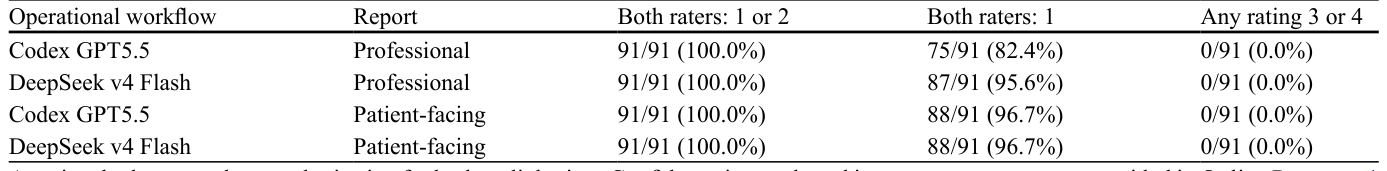
これは、構造化されたデータが与えられれば、AIが専門家のルールに沿って正確な報告書を作成できる可能性を示しています。
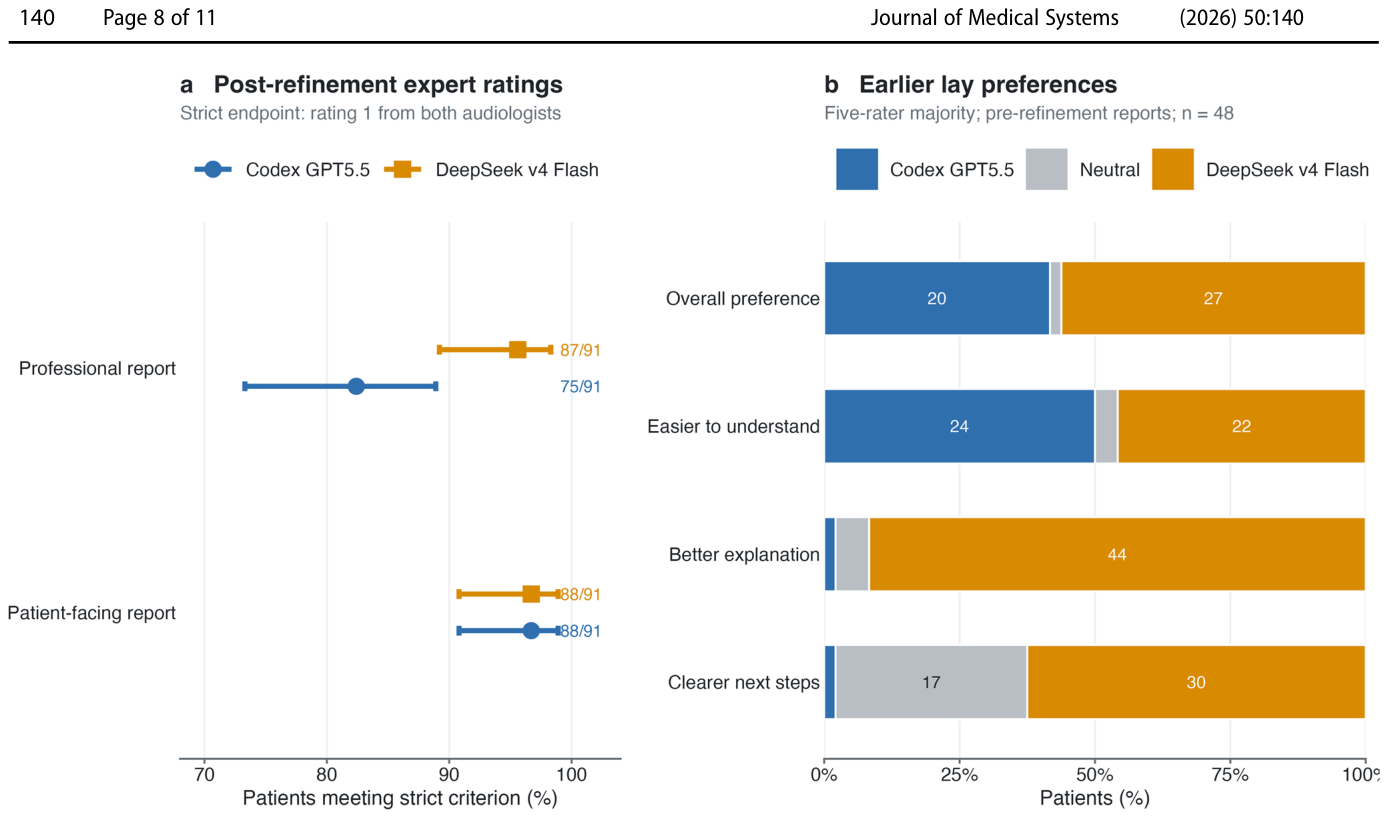
ただし、これらの評価は異なる運用ワークフローを比較したものであり、基盤モデルそのものの直接比較ではない点に留意が必要です。
研究結果の詳細:AIの強みと限界
この研究は、聴覚検査のAI支援における重要な知見を提供しています。まず、モジュール1の画像転記と解釈において、聴覚専門家の専門知識をプロンプトに組み込むことで、特に専門的な慣習に大きく左右される「聴力損失タイプ」や「アコースティックレフレックス」の解釈においてAIの精度が大幅に向上しました。一方で、一般的な数値閾値の読み取りタスクでは、Codexがすでに非常に高い精度(99.4%)を達成しており、専門家スキルの導入によるさらなる改善は限定的でした。
しかし、異なるAIモデルであるDeepSeekを用いた頑健性分析では、専門家スキルが聴力損失の程度やタイプの改善に寄与したものの、Codexと同レベルの転記精度は再現されませんでした。これは、専門家のガイドラインがルールに基づいた解釈を向上させても、画像認識自体の精度は使用されるAIモデルや実装環境に強く依存することを示唆しています。
「応答なし(N/NR)」の項目に関しては、Codexの検証で60.0%の合致率にとどまり、DeepSeekでは0%と、両モデルともに信頼性に課題が残りました。これは、数値データがない場合の処理や、あいまいなマスキング情報、十分な骨導データがない場合のABG(気骨導ギャップ)の判定など、特殊な臨床的状況への対応がAIにとって依然として難しいことを示しています。聴覚専門家は、測定可能な閾値と「応答なし」を明確に区別し、曖昧なデータに対しては「判断不能」とすることを重視しますが、AIは時に不正確な結論を導き出す可能性がありました。
ティンパノメトリーの解釈もまた、AIにとっての境界線を示しました。印刷されたラベルや測定値は正確に転記されましたが、聴覚専門家による曲線の分類精度は、開発フェーズで改善が見られませんでした。印刷ラベルは単なる転記対象ですが、専門的な曲線分類には、形態、ピークの位置、静的アドミタンス(コンプライアンス)、外耳道容積といった複数の要素を統合した判断が求められます。このような複雑な臨床的推論は、AIが模倣するのが難しい領域であり、境界線上の曲線は、たとえ聴覚専門家間であっても調整が必要であり、臨床的には再検査が推奨されるケースもあります。したがって、AIツールが導入される場合でも、機器のラベル、測定値、専門家の解釈、そして「不確実性/再検査」のオプションを別々のフィールドとして維持することが重要です。
モジュール2の報告書生成では、AIがルールに基づいた計算を正確に実行し、専門家向けおよび対象者向けの両方の報告書において、聴覚専門家から「明らかなエラーなし」との高い評価を得ました。これは、画像からの抽出という不確実な段階を取り除き、構造化された入力データを与えれば、AIがルール遵守性の高い報告書を生成できることを示しています。しかし、このモジュールは「独立した診断の妥当性」を検証するものではなく、あくまで与えられたルールに対するAIの適合性を評価するものです。報告書作成プロセスにおける専門家のフィードバックがAIの性能向上に貢献した一方で、その後の評価には専門家が持つ期待や「組み込みバイアス」が影響している可能性も指摘されており、独立した臨床的検証の必要性が今後の課題として挙げられます。また、事前改良段階の一般の人々による報告書の評価では、DeepSeekが説明や次のステップで好まれる傾向があったものの、生成される文章が長く、全体的な好みや理解のしやすさには大きな差がないことも示されました。これは、報告書の「読みやすさ」だけでなく、「理解度」そのものを客観的に評価する重要性を示唆しています。
考察と今後の展望:AI支援の安全性と課題
このモジュール式の研究デザインは、将来の安全なAIアーキテクチャの可能性を示しています。具体的には、画像転記、決定論的な検証と計算、報告書の下書き、不確実性のフラグ付け、そして専門家による承認といった各段階を明確に分離することで、エラーの伝播を抑え、問題発生時に原因を特定しやすくなります。この区分は、中国の聴覚専門家がAIに期待する役割とも一致しています。すなわち、AIは反復的な技術作業を担い、専門家は文脈的な判断、カウンセリング、および最終的な責任を保持するというものです。
実用化においては、AIアシスタントは転記された値、ルールに基づく出力、および不確実性を示す情報を、診断に統合するのではなく、承認のために明確に提示すべきです。これらの目に見える「引き渡しポイント」は、報告書生成や対象者とのコミュニケーションの前に修正を行うことを可能にします。しかし、本研究における再現性は、プロプライエタリなAIサービスへの依存によって一部制約されています。プロンプト、出力スキーマ、モデル識別子、日付、再試行手順は報告されていますが、Codexの正確なスナップショットやサンプリング設定は利用できず、報告書生成に使用されたプロバイダーも独立して検証できませんでした。また、画像転記の要求が「ゼロ保持プロバイダー」に限定されていなかったため、データ保持や再利用の可能性も排除できませんでした。これらの要因は、サービスが進化するにつれて再現性やガバナンスに影響を与える可能性があります。
研究の限界としては、単一の医療施設、2種類の機器、4か月間のデータ収集期間、特に「応答なし(N/NR)」の項目が3名の対象者で15件と少なかったこと、過去の代替ファイルの利用、小児対象者の少なさ、非ランダムに選ばれた開発セット、そして2名の聴覚専門家評価者と5名の一般評価者による評価などが挙げられます。91名の対象者全員で評価が「3(明らかなエラー)」または「4(深刻な/誤解を招く可能性のあるエラー)」でなかったとしても、約4.1%の割合で不利な報告が発生する可能性は依然として残されています。
ワークフローの時間、修正の負担、公平性、理解度、管理上の変更、およびアウトカムについては測定されていません。今後の展望として、モジュールを接続しつつ中間出力を維持した「サイレントデプロイメント」を実施し、AIが判断を控える(abstention)ケース、修正、レビュー時間、対象者の理解度、およびその後の意思決定への影響を測定することが重要です。AIインターフェースは、説明されない最終的な回答を提示するのではなく、不確実性や中間的な推論プロセスを検査可能にすべきです。さらに、外部検証では、複数の施設や機器を用い、「応答なし」、マスキング、重度難聴、境界線上のティンパノグラム、小児症例、不完全な既往歴などの多様なケースを網羅することで、より包括的な評価が求められます。
まとめ
本研究は、聴覚専門家の専門知識を組み込んだAIが、純音聴力検査とティンパノメトリーの画像解釈において、特に専門的な慣習に依存するタスクの精度を向上させることを示しました。ただし、その効果や絶対的な精度はAIの実装方法に依存し、「応答なし(N/NR)」の処理には依然として課題が残されています。一方、構造化された入力データから報告書を作成するワークフローは、高いルール遵守性を示し、聴覚専門家からも良好な評価を得ました。これらの知見は、AIが聴覚分野において「自律的な診断」を行うのではなく、「専門家を支援する監査可能な補助ツール」としての大きな可能性を秘めていることを示唆しています。今後の展望として、接続されたモジュール、独立したユーザー、対象者の理解度、そして適切なガバナンスの下での導入について、さらなる前向きな評価が不可欠です。本研究は、AIのエンドツーエンドの性能や臨床的有効性を確立するものではなく、あくまでその可能性と課題を提示するものです。
用語集
- 純音聴力検査(PTA): 様々な周波数の純音を用いて聴力閾値(音が聞こえる最小の音量)を測定する基本的な聴力検査。
- ティンパノメトリー: 中耳の圧力と動き(コンプライアンス)を測定し、中耳の機能を評価する検査。
- マルチモーダルAI: 複数の異なる種類のデータ(この研究では画像とテキストなど)を組み合わせて処理し、理解する人工知能。
- Codex GPT5.5: OpenAIによって開発された大規模言語モデル(LLM)の一種であり、コード生成やテキスト処理能力を持つ。
- DeepSeek-V4-Flash-Vision-Exp: DeepSeek社によって開発された視覚処理能力を持つ大規模言語モデルの実験的なバージョン。
- アコースティックレフレックス: 大きな音に反応して中耳の筋肉が収縮する現象。鼓膜の動きを測定することで、聴覚経路の異常を評価する。
- 聴力損失タイプ: 難聴の種類を指し、伝音難聴、感音難聴、混合難聴などに分類される。原因や治療法が異なるため、正確な分類が重要。
- 応答なし(N/NR): 聴力検査において、特定の最大音量でも音が聞こえなかった場合に記録される項目。
- 気骨導ギャップ(ABG): 気導聴力と骨導聴力の間の差。この差が大きい場合、中耳の異常(伝音難聴)を示唆する。
- 聴覚専門家: 聴覚障害の診断、評価、リハビリテーションを専門とする医療専門職。本研究ではAudiologistに相当。
コメントを残す