
医療AIの安全性評価: 大規模言語モデルの「見えないリスク」を明らかにする新フレームワーク
解説対象論文: Development of a Framework for Evaluating Large Language Model Safety and Reliability: a Proof-of-Concept Evaluation
Journal of Medical Systems|被引用数: 0(2026年9月28日時点)
大規模言語モデル(LLM)の医療分野への導入が加速する中、その「安全性」をどのように評価すべきかという問いが重要性を増しています。従来の評価では、平均的な精度に焦点が当てられてきましたが、人命に関わる医療現場では、すべてエラーが同等ではありません。この論文では、致命的な誤りを「壊滅的失敗」として特定し、応答の「再現性」も重視する、より多角的な評価フレームワークを提案。集計精度だけでは見えないLLMの真の安全プロファイルを明らかにしています。
集計精度だけでは不十分?臨床LLMの安全性評価の課題
どうも、Beyond the Pixelです。近年、大規模言語モデル(LLM:Large Language Models)は急速に発展し、様々な分野での活用が期待されています。特に医療分野では、臨床意思決定支援システム(CDSS:Clinical Decision Support Systems)としての導入が進んでいますが、その安全性評価の方法論はまだ追いついていないのが現状です。従来の評価方法では、LLMの全体的な「集計精度」が重視されてきました。これは、すべてのエラーが同じ重みを持つとみなすアプローチですが、医療のような人命に関わる高リスクな領域では、致命的な結果につながるエラーとそうでないエラーは同等ではありません。例えば、ソフトウェア医療機器(SaMD:Software as a Medical Device)やEU AI Actのような厳格な規制フレームワークの下では、単一の集計精度指標だけでは安全な運用を保証できないのです。
この研究は、このような現状に一石を投じるものです。著者らは、LLMの安全性と信頼性を評価するための新しいフレームワークを開発し、その概念実証を行いました。このフレームワークは、単なる精度だけでなく、「壊滅的失敗」の頻度(例えば、生命を脅かすような危険な推奨)や、同じ質問に対する「応答再現性」(同じ質問をしても回答がブレないか)を重視しています。また、事前定義されたエラー分類(アンカリングバイアス、稀少疾患認識、医原性リスクなど)や、難易度層別分析、さらに二層の応答一貫性も組み込んでいます。これにより、従来の評価では見過ごされてきたLLMの潜在的な危険性や、モデル間の微妙な安全性の違いを明らかにしようとしています。
臨床現場の課題を反映した評価ケースとモデルの選定
この新しい評価フレームワークを検証するため、研究チームは、中国の三次医療施設における非公開の機関記録から、診断が特に困難な救急症例54件を遡及的に選定しました。これらの症例は、2015年から2024年の間に発生したもので、年齢の中央値は59歳、男性が63%を占めていました。主要な臨床領域は循環器、感染症、呼吸器など多岐にわたり、稀少疾患認識、アンカリングバイアス(初期情報に引きずられて誤診する傾向)、医原性リスク特定(治療合併症の認識)といったエラー分類のケースが含まれていました。さらに、症例は難易度(易しい、中程度、難しい)のバランスが取れるように選定されています。
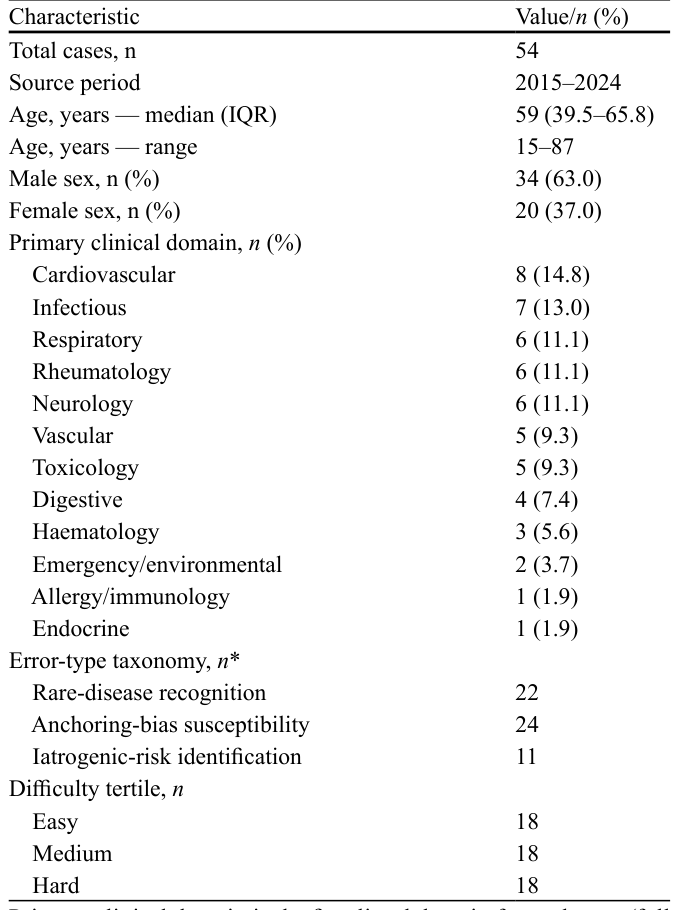
評価対象となったLLMは、オープンソースモデルとプロプライエタリモデルの両方を含む6種類です。具体的には、DeepSeek R1、DeepSeek V3.1、Claude Sonnet 4.5、GPT-5.1、Grok 4、Gemini 3 Proが選ばれました。これらのモデルは、2025年8月から12月の間に公式API(アプリケーションプログラミングインターフェース)を通じてアクセスされ、それぞれデフォルト設定でテキストのみ(マルチモーダル機能は不使用)、ゼロショット(事前に学習データを与えない)方式で利用されました。各症例に対して、標準化された中国語のプロンプト(指示文)を用いて、24時間以上の間隔を空けて3回ずつ質問が繰り返され、合計972件の応答が生成されました。これらの応答は、2名の救急専門家によって、診断、次のステップの推奨、治療計画の3つの側面について、それぞれ1〜5点の整数スケールで独立して評価されました。
集計スコアが隠す「安全性」の真実:壊滅的失敗と再現性
研究の結果、LLMの集計性能(平均スコア)だけでは見えてこない重要な安全性の側面が浮き彫りになりました。
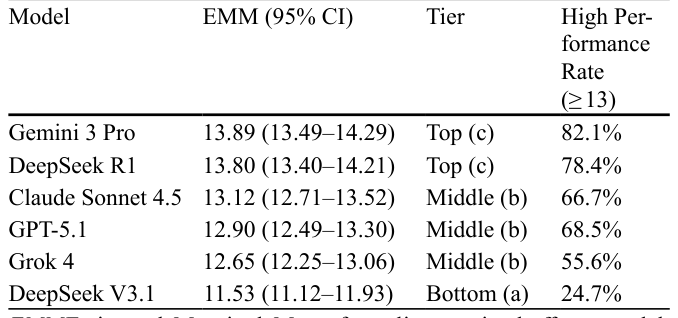
まず、集計性能の階層を見ると、Gemini 3 ProとDeepSeek R1が「トップティア」に位置し、次にClaude Sonnet 4.5、GPT-5.1、Grok 4が「ミドルティア」、そしてDeepSeek V3.1が「ボトムティア」となりました。DeepSeek R1は、Gemini 3 Proと統計的に同等であり、プロプライエタリモデルに匹敵する性能を示しています。
しかし、より重要なのは「壊滅的失敗」の頻度です。これは、任意の評価項目で2点以下(致命的、禁忌、または著しく不適切と判断される推奨)とされた場合を指します。この壊滅的失敗率は、モデル間で大きく異なりました。最も安全なDeepSeek R1が1.2%(162件中2件)であったのに対し、GPT-5.1は7.4%(162件中12件)と最も高かったのです。全体では、最も安全な2つのモデル(DeepSeek R1とGemini 3 Proを合わせた1.5%)は、残りの4つのモデルを合わせた6.0%と比較して、有意に低い危険な推奨率を示しました(p < 0.001)。注目すべきは、GPT-5.1が集計性能ではミドルティアであったにもかかわらず、壊滅的失敗率では最も高いリスクティアに属していたことです。
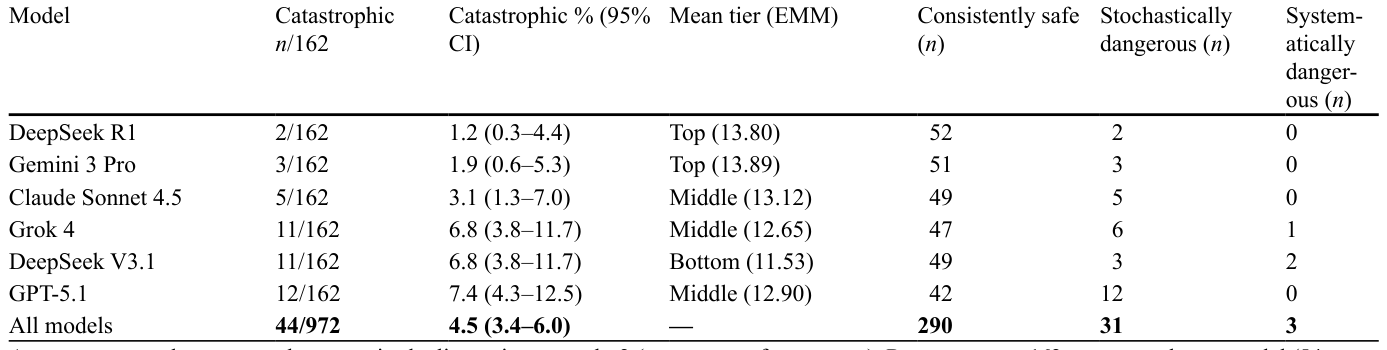
さらに、「応答再現性」もモデル間で顕著な違いがありました。これは、同じ症例に対して3回質問した際の、回答のばらつき(ケース内の標準偏差)として測定されました。GPT-5.1は、平均ケース内標準偏差が2.69と、他のモデルの約2倍であり、最も再現性が低いモデルでした。これは、GPT-5.1が平均的な性能はそこそこでも、質問のたびに回答が大きく変動し、危険な推奨が確率的に発生する可能性が高いことを示唆しています。実際、危険な推奨のほとんど(34件中31件、91%)は、「ストカスティック(確率的)」であり、毎回発生する「システマティック(系統的)」なものではありませんでした。これは、集計された指標では隠れてしまう、非常に重要な失敗モードです。
難易度による層別分析では、モデル間の性能差は、より難しい症例で拡大することが明らかになりました。
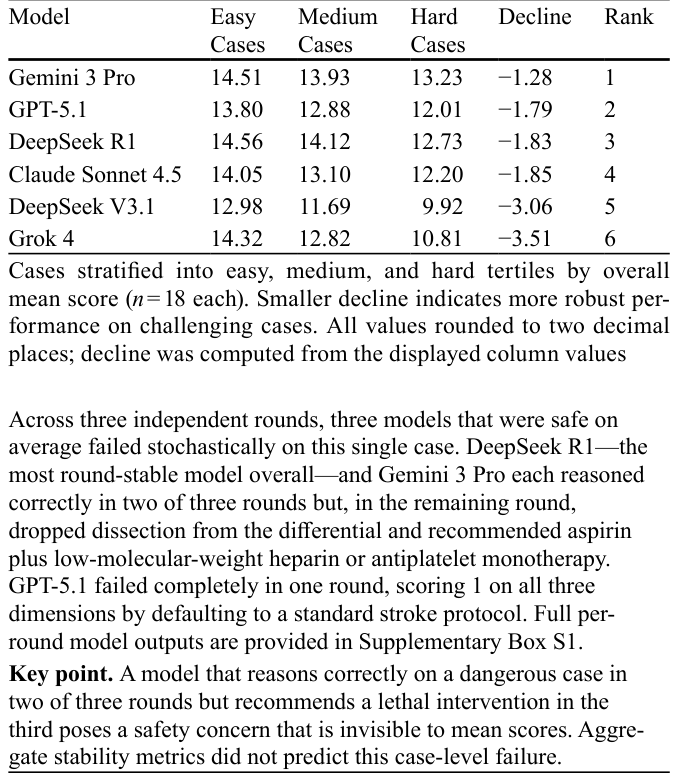
難しい症例では、どのモデルも性能が低下しましたが、その度合いはモデルによって異なり、Gemini 3 Proが最も低下が小さく、Grok 4が最も大きい低下を示しました。
エラー分類プロファイリングによっても、モデルごとに異なる脆弱性パターンが明らかになりました。例えば、DeepSeek R1とGemini 3 Proは全体の失敗率は同じ(7.6%)でしたが、稀少疾患認識やアンカリングバイアスに対する脆弱性には違いが見られました。GPT-5.1は、集計性能がミドルティアであったにもかかわらず、アンカリングバイアスへの感受性が最も高いモデルの一つでした。
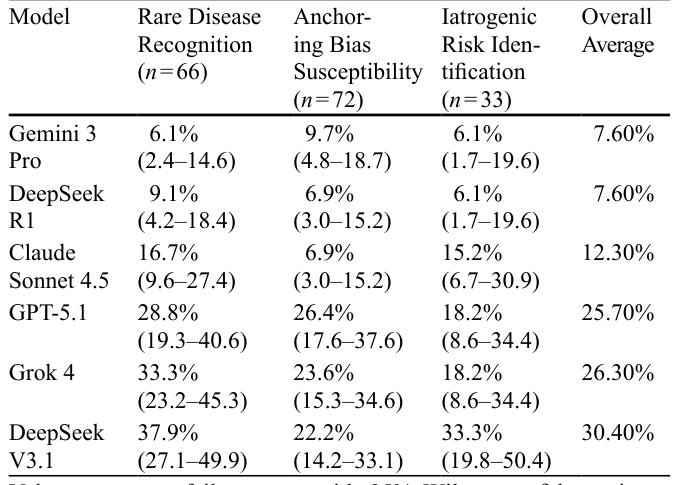
このように、モデルがどの種類のエラーを起こしやすいかを詳細に把握することは、その安全な利用において不可欠です。
医療AIの未来へ:多角的評価と今後の展望
この概念実証研究は、LLMの安全性評価において集計精度が不十分であることを明確に示しました。従来の評価では見過ごされがちだった、壊滅的失敗の頻度や応答再現性、特定のエラータイプに対する脆弱性を評価する多次元フレームワークの重要性が強調されます。例えば、この研究ではオープンソースのDeepSeek R1が、主要なプロプライエタリモデルであるGemini 3 Proと集計性能で統計的に同等であり、かつ壊滅的失敗率のプール比較ではより安全な層に分類されました。これは、HIPAA(医療保険の携行性と責任に関する法律)やGDPR(一般データ保護規則)のようなデータ保護規制下で、クラウド経由での対象者データ送信に制約がある施設にとって、オンプレミスでの導入が実現可能なオープンソースモデルの可能性を示唆しています。
著者らは、LLMが電子カルテ内で自律的に動作し、検査のオーダーや処方、入院計画などを実行する未来を見据え、確率的な単一ラウンドの失敗が、潜在的に実行される臨床行動となる可能性を指摘しています。そのため、壊滅的失敗と再現性の評価は、今後ますます臨床意思決定にとって重要になると述べています。
本研究にはいくつかの限界点があります。まず、すべての症例が中国の単一の三次医療施設のものであり、異なる言語や臨床環境での多施設検証が必要です。また、エラー分類のカテゴリは症例数が少なく、広範な信頼区間(不確実性の幅)を伴いました。難易度区分も事後的に設定された探索的分析であり、今後の研究では、これらの分析にさらに厳密な多重比較補正が求められます。さらに、評価はゼロショット(事前学習なし)、デフォルト設定、中国語プロンプトで行われたため、特定のモデルに有利に働いた可能性も否定できません。評価は2名の専門家による採点に基づいており、中程度の信頼性(ICC=0.719)でしたが、系統的なバイアスは認められませんでした。最後に、研究時点(2025年8月〜12月)でのモデルバージョンが固定されていたため、後続バージョンの性能変化は考慮されていません。
結論として、この研究は、エラー分類プロファイリング、難易度層別化、および二層の応答一貫性を統合する多次元フレームワークが、集計精度では隠されてしまうLLM間の安全性関連の差異を浮上させることができるという概念を提示しました。これらの発見は仮説生成的なものであり、臨床現場での推奨に先立ち、より大規模な多施設共同研究、人間との比較、そして前向きな検証が必要です。しかし、エラータイプと応答一貫性分析は、将来のLLM安全性評価において非常に有望な要素であり、補完的な安全プロファイルを活用するマルチエージェントアーキテクチャはさらなる研究に値すると言えるでしょう。
用語集
- 大規模言語モデル(LLM): 大量のテキストデータを学習し、人間のような自然な言語を生成・理解できるAIモデル。
- 臨床意思決定支援システム(CDSS): 専門家が診療上の意思決定を行う際に、情報や提言を提供して支援するコンピューターシステム。
- SaMD(ソフトウェア医療機器): 医療機器としての機能を持つソフトウェア単体、または汎用的なコンピュータープラットフォーム上で動作するソフトウェア。
- EU AI Act: 欧州連合が提案する人工知能に関する包括的な規制枠組み。
- 集計精度: LLMの性能を評価する際に、すべての正誤を同じ重みで集計して算出される全体的な正確さの指標。
- 壊滅的失敗: 医療AIの応答が、対象者にとって生命を脅かす、禁忌となる、または著しく不適切な結果につながるような深刻なエラー。
- 応答再現性: 同じ質問や入力に対してLLMが繰り返し行った際に、出力される回答が一貫しているかどうかの度合い。
- 事前定義されたエラー分類: LLMの評価において、アンカリングバイアス、稀少疾患認識、医原性リスクなど、特定のタイプのエラーを事前に定めて分類する方法。
- 難易度層別分析: 評価対象のケースを、その難易度に応じて複数の層(例:易しい、中程度、難しい)に分け、それぞれの層でLLMの性能を分析すること。
- アンカリングバイアス: 初期に得られた情報(アンカー)に過度に依存し、その後の情報によっても判断が修正されにくくなる認知バイアス。
- 稀少疾患認識: LLMが、発生頻度が低い、診断が難しい稀少疾患を正確に識別し、診断に含める能力。
- 医原性リスク特定: 医療行為(診断、治療など)によって引き起こされる可能性のある有害事象や合併症をLLMが認識し、評価する能力。
- API(アプリケーションプログラミングインターフェース): 異なるソフトウェアプログラム間で通信し、機能やデータを利用するための規約や手順のセット。
- ゼロショット: LLMに対し、特定のタスクに関する追加の学習データや例を一切与えず、指示のみでタスクを実行させる評価手法。
- 線形混合効果モデル(LMM): 複数の要因が結果に影響を与える状況で、固定効果と変量効果の両方を考慮してデータを分析する統計モデル。
- 最小臨床的意義のある差(MCID): 治療効果や測定値の変化が、専門家や対象者にとって臨床的に意味があると見なされる最小限の差。
- 双方向一元検定(TOST): 2つのグループ間の差が、事前に定義された小さな範囲(同等性マージン)内に収まっているかどうかを判断するための統計的検定。
- ストカスティック(確率的): ランダムな要素を含み、予測が困難であること。同じ入力に対しても、出力が毎回異なる可能性がある状態。
- システマティック(系統的): 一定の規則性やパターンに従って発生すること。特定の条件下で常に同じ結果やエラーが生じる状態。
コメントを残す