
足関節骨折の診断と治療予測:臨床文書から大規模言語モデル(LLM)が読み解く新たな可能性
解説対象論文: Large Language Models for Ankle Fracture Classification and Management Prediction from Routine Clinical Documentation: A Single-Center Exploratory Study
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月20日時点)
足関節骨折の診断と治療計画は、X線画像や専門家の記録など複数の情報源を統合する複雑なプロセスです。最新の研究では、大規模言語モデル(LLM)が非構造化された臨床テキストから、骨折分類や治療管理に関する構造化された情報を効果的に抽出できる可能性が示されました。このブログ記事では、この革新的な研究の内容と、その医療画像インフォマティクスにおける意義について深く掘り下げて解説します。
はじめに:医療現場におけるLLMの潜在力
どうも、Beyond the Pixelです。足関節骨折は外傷外科で最も一般的な損傷の一つであり、正確な分類、一貫した記録、そして個別化された治療管理が求められます。しかし、放射線レポートや専門家の診療記録は非構造化された自由形式のテキストで書かれることが多く、その情報を効率的に構造化し、活用することは長年の課題でした。近年、大規模言語モデル(LLM)の発展により、このような非構造化された臨床テキストから、構造化された治療関連情報を抽出する可能性が注目されています。本記事では、この領域における最新の探索的研究についてご紹介します。
論文の概要:足関節骨折の診断と治療予測へのLLM活用
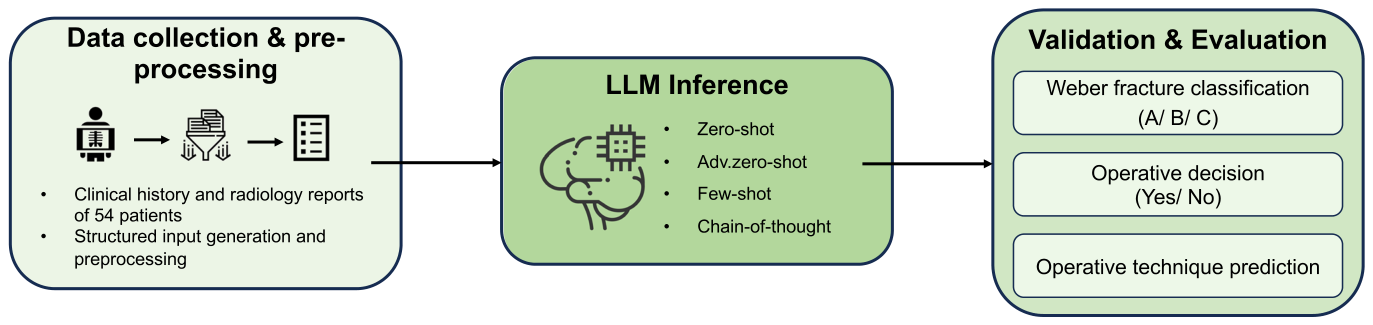
この研究は「Large Language Models for Ankle Fracture Classification and Management Prediction from Routine Clinical Documentation: A Single-Center Exploratory Study」と題され、Journal of Imaging Informatics in Medicineに掲載されました。著者らは、ルーチンの臨床文書(放射線レポートや診療記録)から足関節骨折の情報を抽出し、LLMがそれをどのように分類し、治療方針を予測できるかを評価しました。研究のワークフローは以下の通りです。
研究の背景と目的
足関節骨折は年間人口10万人あたり約180件発生すると報告されており、罹患率が高く、医療負担も大きいです。ウェーバー分類(Weber classification)は、足関節の安定性に重要な脛骨と腓骨を結合する靭帯構造である脛腓結合(syndesmosis)に対する腓骨骨折のレベルに基づいて、骨折をA、B、Cのいずれかに分類する標準的な方法として広く受け入れられています。しかし、関連情報がX線画像、診察、対象者固有の要因、そして自由形式のテキスト文書に分散しているため、評価と管理は複雑で多様です。これまでの整形外科外傷分野におけるAI研究は画像ベースの機械学習モデルに集中しており、ルーチンの臨床テキストが骨折評価にどのように役立つかについては十分に調査されていませんでした。本研究は、Llama 3.1(70B Instruct)という大規模言語モデル(LLM)の性能を評価し、テキストベースのウェーバー骨折分類、初期の手術管理予測、および手術手技カテゴリの探索的予測を行いました。
研究デザインと対象
この研究は、2020年2月から2025年10月までに単一の医療施設で診断された、急性足関節骨折を持つ54人の対象者のデータを用いて実施された、後ろ向き探索的計算研究です。評価には、ルーチンの放射線レポート、臨床病歴、および基本的な人口統計情報が使用されました。情報漏洩や分類バイアスを防ぐため、ウェーバー分類や治療に関する明示的な言及は、分析前に手作業でテキストから削除されました。モデルへの入力には、元のX線画像やCT画像は提供されず、テキスト情報のみが使用されました。ウェーバー分類(A/B/C)、手術的か非手術的かの初期管理予測、および手術管理されたケースにおける探索的な手技カテゴリ予測という3つのタスクに基づいてLLMの性能が評価されました。プロンプト戦略として、ゼロショットプロンプティング、高度なゼロショットプロンプティング、フューショットプロンプティング、Chain-of-thoughtスタイルのプロンプティングの4種類が体系的に評価されました。
LLMの性能評価:主要な結果
本研究では、ウェーバー骨折分類、手術的か非手術的かの管理予測、および探索的な手術手技カテゴリ予測という3つの主要なタスクでLLMの性能が評価されました。
ウェーバー骨折分類の精度
ウェーバー分類は主要な分析課題として、詳細に評価されました。全体的な正答率(Accuracy)は、4つのプロンプト戦略で0.759から0.815の範囲でした。これは、常に最も頻繁なカテゴリ(ウェーバーB型)を予測する多数派クラスベースライン(0.556)を大幅に上回る結果です。マイクロ平均F1値は正答率と同一でした。プロンプト戦略間で数値的に最も高い正答率を示したのはフューショットプロンプティング(0.815)でしたが、統計的に有意な差は認められませんでした。つまり、ウェーバー分類の精度はプロンプト戦略の選択に対して頑健であることが示唆されました。
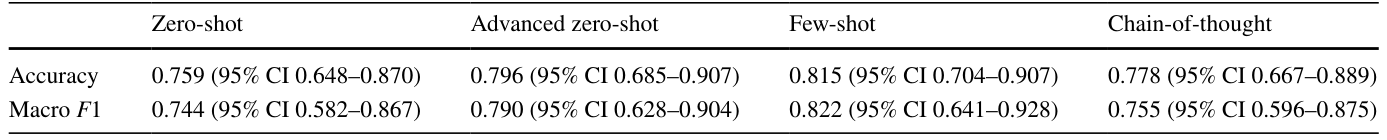
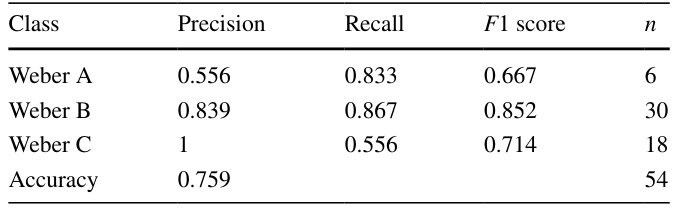
クラス別の性能では、ウェーバーB型骨折で一貫して高いF1値が観察されました(ゼロショットで0.852、高度なゼロショットで0.889、フューショットで0.867、Chain-of-thoughtで0.881)。一方で、ウェーバーA型骨折では性能が低く、プロンプト戦略間でF1値の幅が広くなりました。ウェーバーC型骨折では中程度の性能が観察されました。詳細なクラス別の結果は以下の表に示されています。
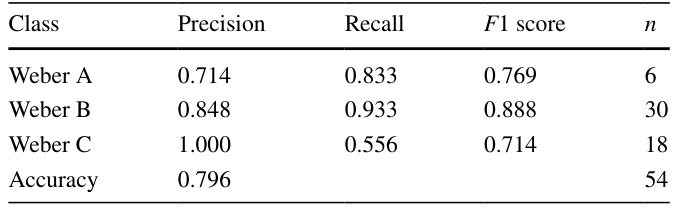
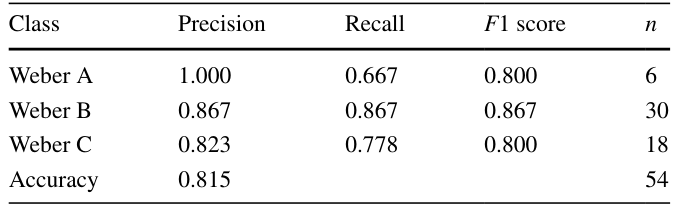
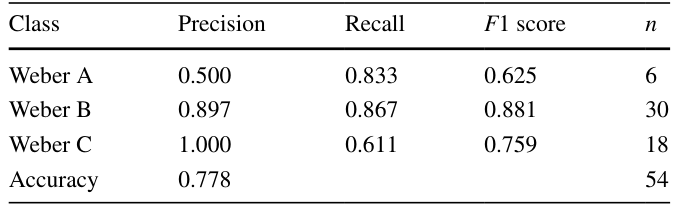
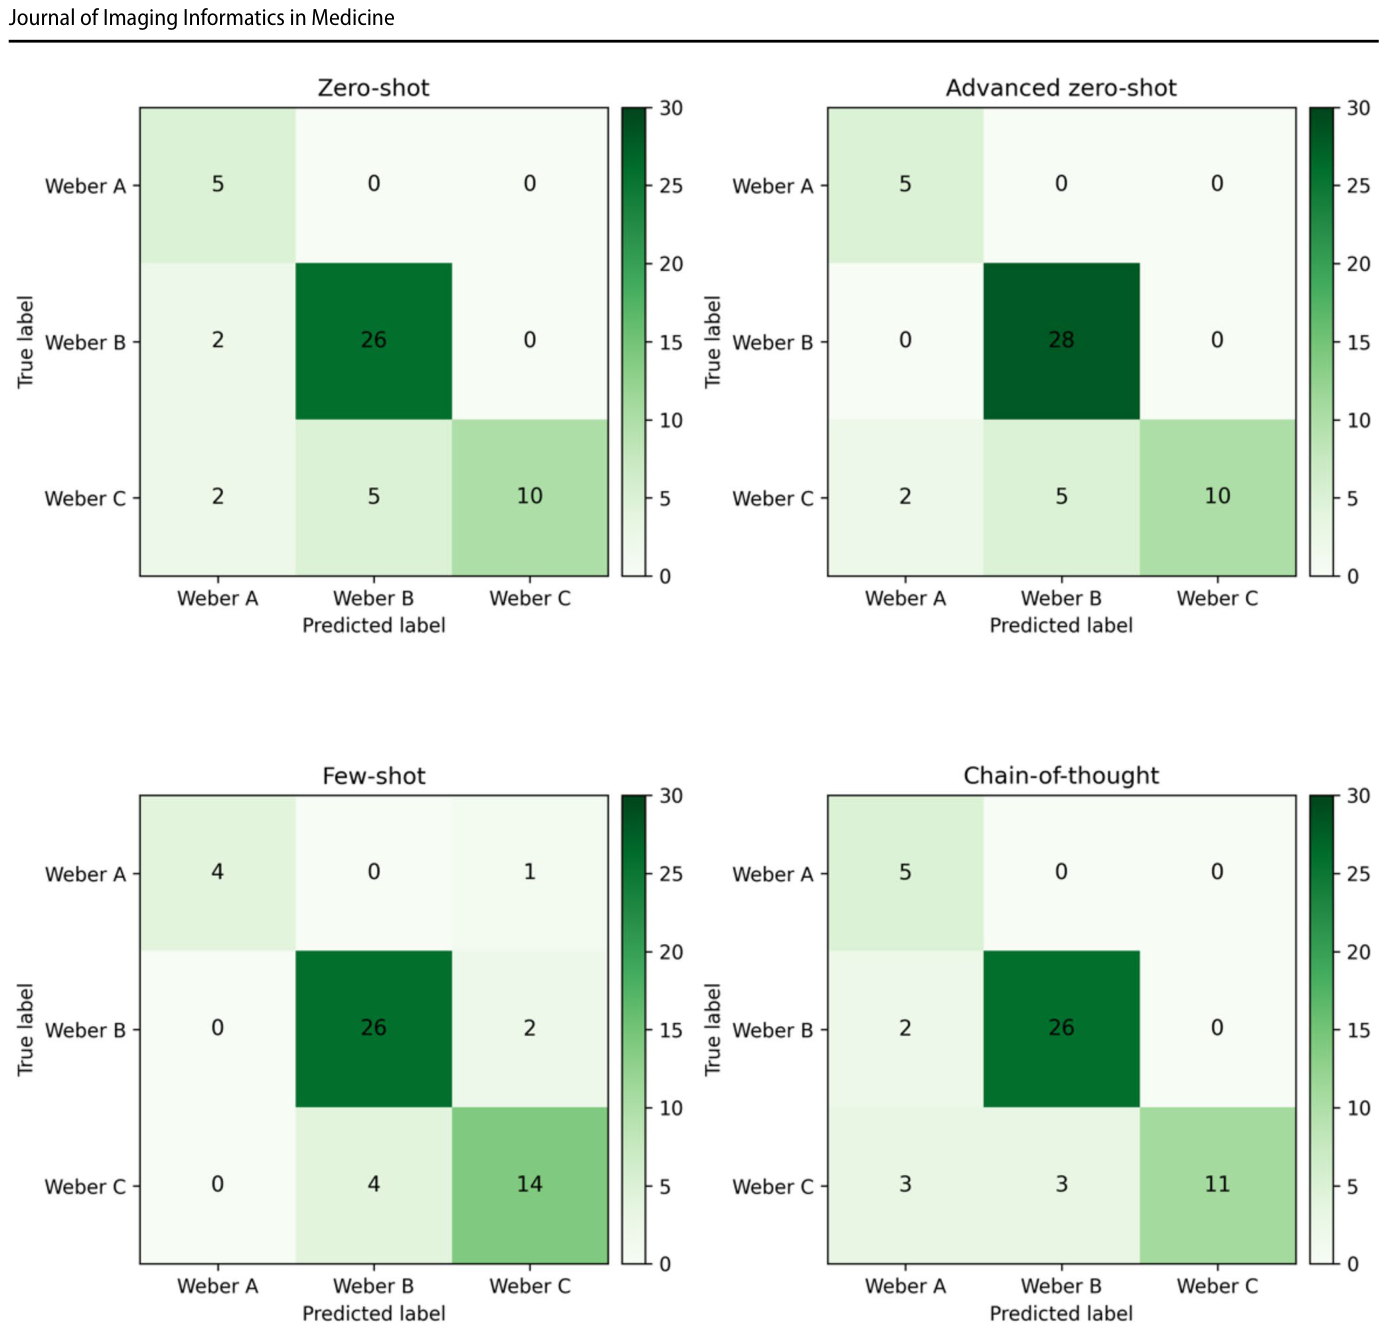
ウェーバー分類の混同行列分析(Confusion Matrix Analysis)では、プロンプト戦略全体で一貫した誤分類パターンが示されました。ほとんどの誤分類は隣接する骨折カテゴリ間、特にウェーバーC型とウェーバーB型の間で発生し、ウェーバーA型とウェーバーC型の間では頻度が低かったです。
手術的治療管理予測の精度
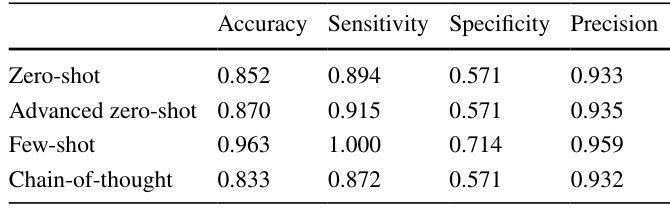
手術的か非手術的かの管理予測に関する性能指標は、表にまとめられています。正答率(Accuracy)は0.833から0.963、感度(Sensitivity)は0.872から1.000、特異度(Specificity)は0.571から0.714の範囲でした。フューショットプロンプティングが最も高い正答率(0.963)を示しましたが、多重比較補正後には統計的に有意な差は残りませんでした。非手術的ケースは7例のみであったため、特異度(Specificity)は高い不確実性を示しました。LLMは、多数派クラスベースラインが持つ特異度ゼロを上回り、非手術的少数派からも臨床的なシグナルを捉えられたことが示されました。
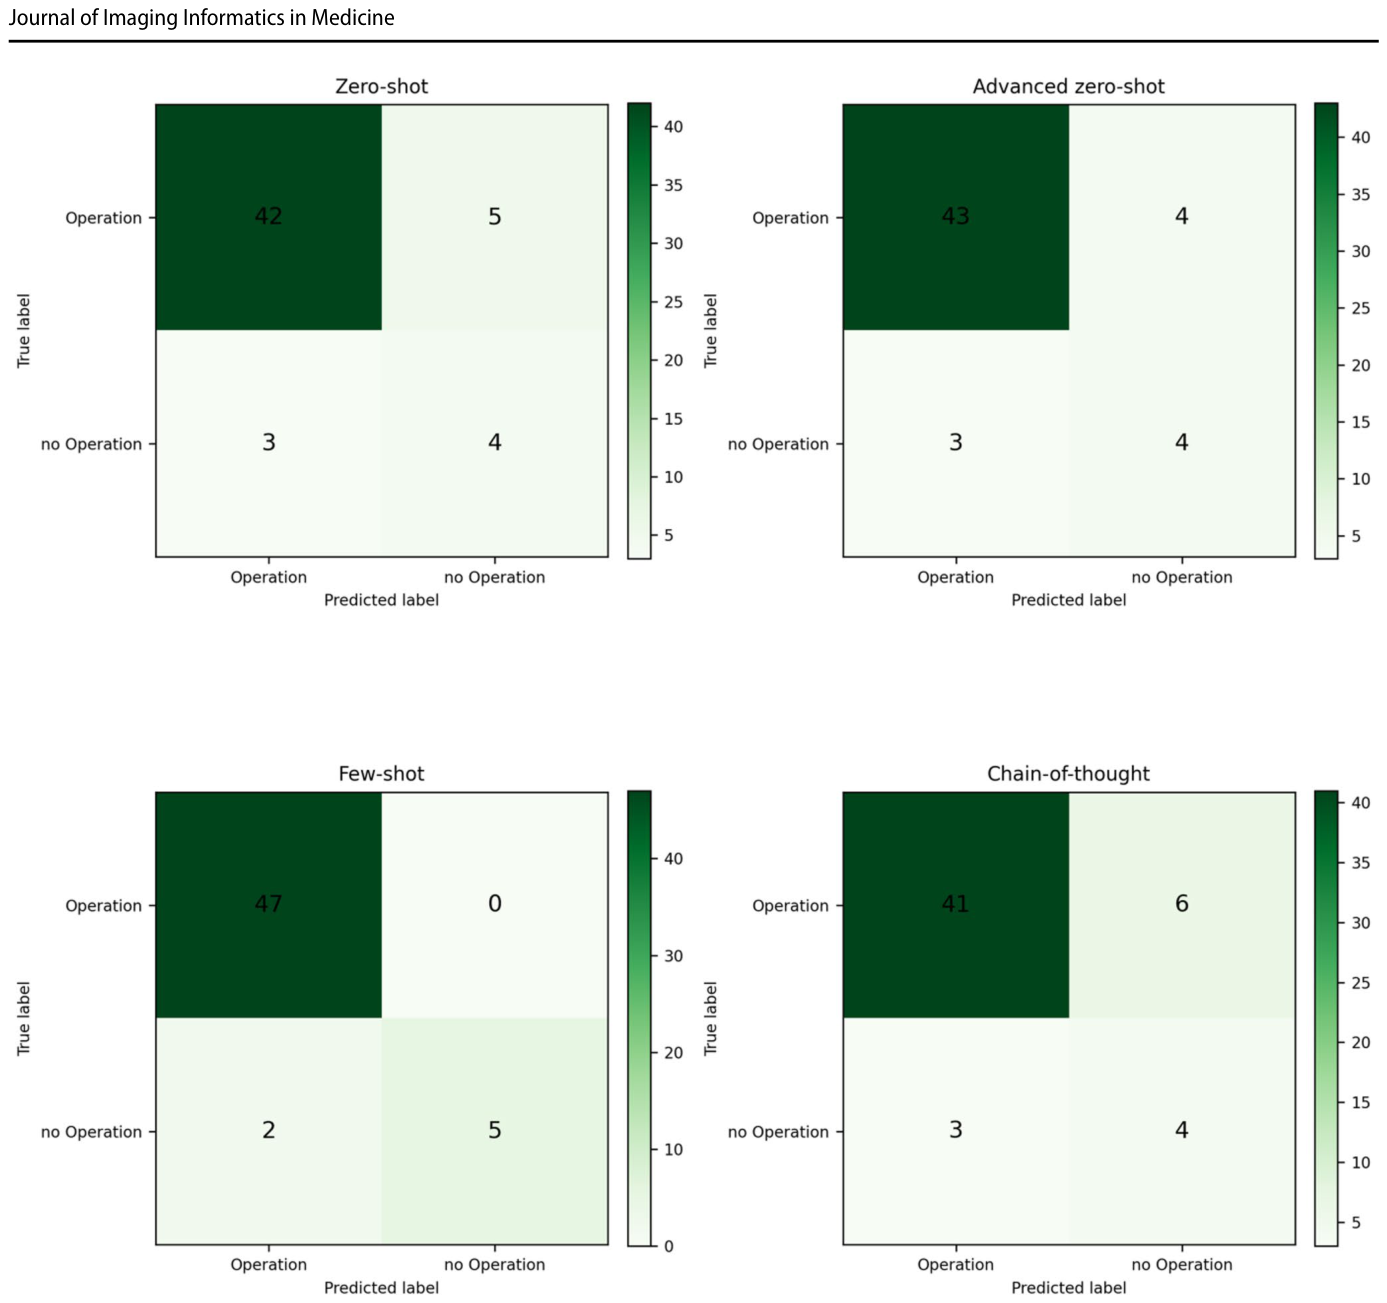
手術管理予測タスクの混同行列分析(Confusion Matrix Analysis)は、プロンプト戦略全体で非常に一貫した分類パターンを示しました。手術的に管理されたケースはすべての設定で高い精度で識別されましたが、ほとんどの誤りは非手術グループで発生しました。
手術手技カテゴリ予測の限界
手術手技カテゴリ予測は、手術的治療が確認された47症例に限定された探索的評価でした。手技の分布には、脛骨腓骨観血的整復内固定術と脛腓結合スクリュー固定(Fibula ORIF+SS)が26例、脛骨腓骨観血的整復内固定術のみ(Fibula ORIF-SS)が19例、一時的固定術が2例と、クラス間の不均衡が大きかったです。階層的経路精度は0.426から0.532の範囲で、多数派クラスベースライン(0.553)と同等かそれ以下でした。手技選択精度は0.426から0.610の範囲で、Chain-of-thoughtプロンプティングのみが多数派クラスベースラインを上回りました。一時的固定術はどのプロンプト設定でも一度も正確に特定されず、特定の外科手技カテゴリはルーチンのテキストのみからは確実に導き出せないことが示唆されました。
研究の考察と今後の展望
この探索的研究は、大規模言語モデルが足関節骨折治療における非構造化されたルーチンの文書から構造化された情報を抽出できることを示唆していますが、その性能は評価された3つのタスクで大きく異なりました。ウェーバー骨折分類と手術管理予測で最も高い性能を示した一方で、特定の手術手技カテゴリの予測は著しく低い精度でした。ウェーバー骨折分類の全体的な正答率は0.759~0.815、手術管理予測は0.833~0.963に達しましたが、手技カテゴリ予測の階層的経路精度は0.426~0.532、手技選択精度は0.426~0.610にとどまり、多数派クラスベースライン(0.553)と同等かそれ以下の結果でした。プロンプト戦略間の差は小さく、ウェーバー分類では統計的に有意ではありませんでした。
テキスト情報からの構造化データ抽出の可能性
骨折分類の誤りは主にカテゴリ境界で発生し、特にウェーバーB型とC型、およびウェーバーA型とC型の間で誤分類が観察されました。これは、脛腓結合との正確な関係がテキスト文書だけでは明確に識別できない境界線上の骨折パターンを反映していると考えられます。一方、明確な骨折パターンでは、腓骨骨折の解剖学的レベルが放射線レポートに明示的に記述されることが多く、これがウェーバー分類の高い性能に寄与したと考えられます。手術管理予測の誤りは非手術ケースに集中し、手術的に治療されたケースの一致はプロンプト戦略全体で安定していました。手術ケースが多数を占めたため、手術的決定の高い正答率は、タスクの難易度だけでなく、このクラスの不均衡も部分的に反映しています。この研究は、ルーチンの放射線レポートや専門家の文書に直接作用することで、現実世界の文書条件を密接に反映し、知見の応用可能性を高めています。このようなシステムは、文書の標準化、研究データの抽出、レジストリワークフロー、品質保証に特に役立つ可能性があります。
研究の限界と今後の課題
この探索的研究にはいくつかの限界があります。54人の対象者という比較的小規模なコホートと単一施設での実施は、統計的検出力と結果の一般化可能性を制限します。また、ルーチンの自由形式テキスト文書の内容と詳細レベルのばらつきもモデルの性能に影響を与えた可能性があります。重要な点として、モデルにはX線画像やCT画像は提供されておらず、後方内果の損傷、脛腓結合の不安定性、軟部組織の状態、併存疾患、対象者固有のリスク因子などの臨床的に関連する要因が、利用可能なテキストでは不完全にしか捕捉されていない可能性があります。この後ろ向き研究デザインでは、将来的な設定での臨床的影響、安全性、およびワークフローへの統合を評価することはできません。また、性能を比較するための対照群が欠如しており、このタスクにおけるモデルの精度が人間の専門家のパフォーマンスとどのように関連するかは不明です。唯一のオープンウェイトモデルが評価され、フロンティアモデルや従来の自然言語処理(NLP)ベースラインはテストされていません。したがって、エラーがこのモデルの限界を反映しているのか、それともソーステキストに必要な情報が存在しないためなのかを判断することはできません。将来の研究では、自由形式テキスト文書とともに画像データを統合することで診断精度と手技予測を向上させることが不可欠です。また、大規模で多様な訓練例を用いたフューショットアプローチの拡大、プロンプト戦略の継続的な改善とタスク固有の最適化が必要です。より大規模なコホートでの検証と、ルーチンの外傷治療における実際の性能、ワークフロー統合、潜在的な臨床的影響を評価するための前向き多施設研究が必要となります。
まとめ
この探索的研究は、大規模言語モデルが足関節骨折治療における非構造化されたルーチンの文書から構造化された情報を抽出できることを示唆しており、その性能は評価された3つのタスクで大きく異なりました。ウェーバー骨折分類において最も強力な性能を示し、テキストベースのLLMが将来的に文書標準化、構造化された骨折評価、および二次データ抽出をサポートする可能性を示唆しています。手術管理予測は、ほとんどのケースで文書化された治療経路と一致しましたが、統計的に有意に多数派クラスベースラインを上回るものではなく、自律的な臨床意思決定の検証としては解釈すべきではありません。手技カテゴリ予測の性能は限定的であり、ほとんどの場合、多数派クラスベースラインと同等かそれ以下にとどまり、手術計画におけるテキストのみのアプローチの限界を浮き彫りにしました。臨床導入を検討する前に、画像データやより広範な対象者固有のコンテキストを組み込んだ、より大規模な多施設コホートおよびマルチモーダルモデルの評価が今後の研究で必要とされます。
用語集
- 大規模言語モデル(LLM): 非構造化されたテキストを処理し、構造化された情報に変換する能力を持つAIモデルです。
- ウェーバー分類: 足関節骨折を腓骨骨折のレベルと脛腓結合(脛骨と腓骨を結合する靭帯)への関与に基づいてA、B、Cに分類する標準的なシステムです。
- 脛腓結合(syndesmosis): 下腿の脛骨と腓骨を結合する靭帯性の構造で、足関節の安定性に重要な役割を果たします。
- プロンプト戦略: 大規模言語モデルから特定のタスクの出力を得るために、モデルに与える指示(プロンプト)の設計方法です。ゼロショット、フューショット、Chain-of-thoughtなどがあります。
- ゼロショットプロンプティング: モデルにタスクの例を与えずに、指示のみで出力を求めるプロンプトの手法です。
- フューショットプロンプティング: モデルにいくつかのタスク例(入力と期待される出力)を与えてから指示することで、性能を向上させるプロンプトの手法です。
- Chain-of-thoughtプロンプティング: モデルにステップバイステップで推論するよう指示することで、複雑な問題解決能力を高めるプロンプトの手法です。
- 正答率(Accuracy): モデルの予測が実際の値とどれだけ一致したかの割合を示す指標です。
- F1値(F1 score): 精度(Precision)と再現率(Recall)の調和平均で、分類モデルの性能を示す指標の一つです。
- 感度(Sensitivity): 実際に陽性であるもの(例:手術が必要なケース)を、モデルが正しく陽性と予測できた割合です。
- 特異度(Specificity): 実際に陰性であるもの(例:手術が不要なケース)を、モデルが正しく陰性と予測できた割合です。
- 多数派クラスベースライン: 常に最も頻繁に出現するクラスを予測した場合に得られる基準となる性能値です。
- 観血的整復内固定術(ORIF): 骨折を外科的に開いて整復し、プレートやスクリューなどのインプラントで固定する手術手技です。
コメントを残す