
3D肺結節CADのリアルワールドにおけるAI性能低下を克服するMedStyle-3DGフレームワーク
解説対象論文: Understanding and Mitigating Distribution Shifts in Volumetric Lung Nodule CAD Using a 3D Vision-Language Framework
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月12日時点)
人工知能(AI)は医療画像診断に革命をもたらしていますが、その診断性能が現実世界の多様な臨床環境で維持できるかという課題に直面しています。CTにおける肺結節分析を行う3D AIモデルは、撮影プロトコルやスキャナーメーカー、地理的要因といった「分布シフト」によって性能が著しく低下する可能性があります。本記事では、これらのシフトが引き起こすAIモデルの性能低下を定量的に評価し、その課題を克服するために開発された新しい3D Vision-Languageフレームワーク「MedStyle-3DG」の革新的なアプローチとその成果について解説します。
医療AIの広がりとリアルワールドでの課題
どうも、Beyond the Pixelです。医療画像診断における人工知能(AI)の導入は目覚ましく、2025年末までに1000を超えるFDA認可デバイスが登場し、米国の病院の最大90%がAIベースの画像ツールを導入していると報告されています。しかし、これらのAIシステムが多様で予測不可能な現実世界の環境下で診断性能を維持できるかという根源的な疑問が大きな課題として残っています。AIモデルは、異なる臨床環境に適用されると、性能が著しく低下することが確立されています。例えば、X線画像における気胸検出モデルの性能は、異質な設定間で評価すると最大22.7%も低下する可能性が示されています。これは、AIの恩恵を研究段階から実際の臨床現場へと完全に移行させる上での重要な課題となっています。この課題に対する決定的な解決策はまだありません。現在の戦略としては、訓練データに展開環境の変動を明示的に表現すること、あるいはより優れた訓練手法を開発することの2つが挙げられます。特に後者は、AI研究における重要なギャップであり、さらなる研究が求められています。本論文は、このギャップに対処するため、肺結節の検出・分析を行う3D AIモデルが、現実世界の多様な条件下でどのように影響を受けるかを定量的に評価し、これらの分布シフト(Distribution Shift)を緩和するための新しいオープンソースの3D Vision-Languageフレームワーク「MedStyle-3DG」を開発・評価しました。
現実世界の「分布シフト」を定量化する
本研究では、3D肺結節コンピュテーショナル・アシステッド・ディテクション(CAD)における現実世界での分布シフトの影響を体系的に調査しました。分布シフトとは、AIモデルの訓練データと実際の運用データの統計的特性が異なる場合に生じる現象です。この研究では、遡及的多施設研究として、2010年から2025年にかけて収集された2679件の胸部CTスキャンデータが使用されました。このデータセットは、複数の公的リポジトリとプライベートな多施設コレクションから意図的に異質なデータを集めて構築されており、概念シフト(ラベル定義の不一致)を最小限に抑えるため、5人の放射線専門家がダブルブラインド方式で再アノテーションを実施しました。
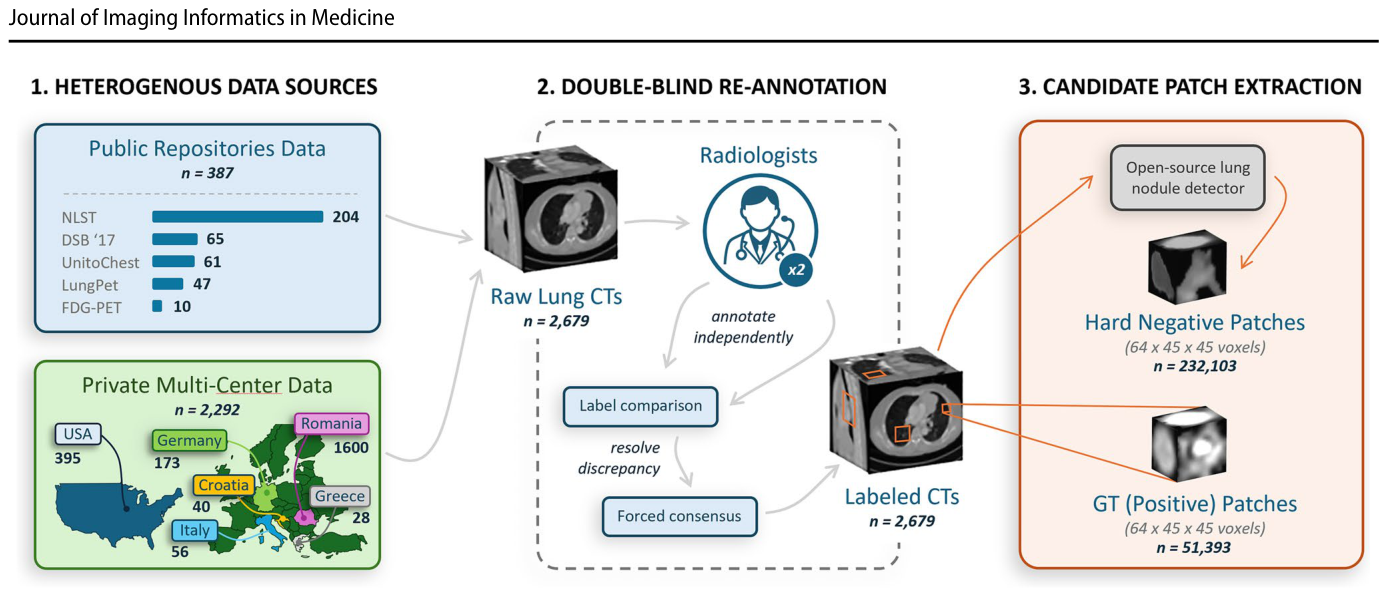
研究は2段階で設計されました。第一に、臨床的に現実的な分布シフト下で、In-Distribution(ID)からOut-of-Distribution(OOD)への性能低下の程度を定量化すること。第二に、ドメイン汎化(Domain Generalization)戦略がこれらのギャップを緩和できるかを検証することです。データは訓練、検証、Test-ID、Test-OODに分割され、現実世界で起こりうる3つの主要な分布シフトをモデル化しました。
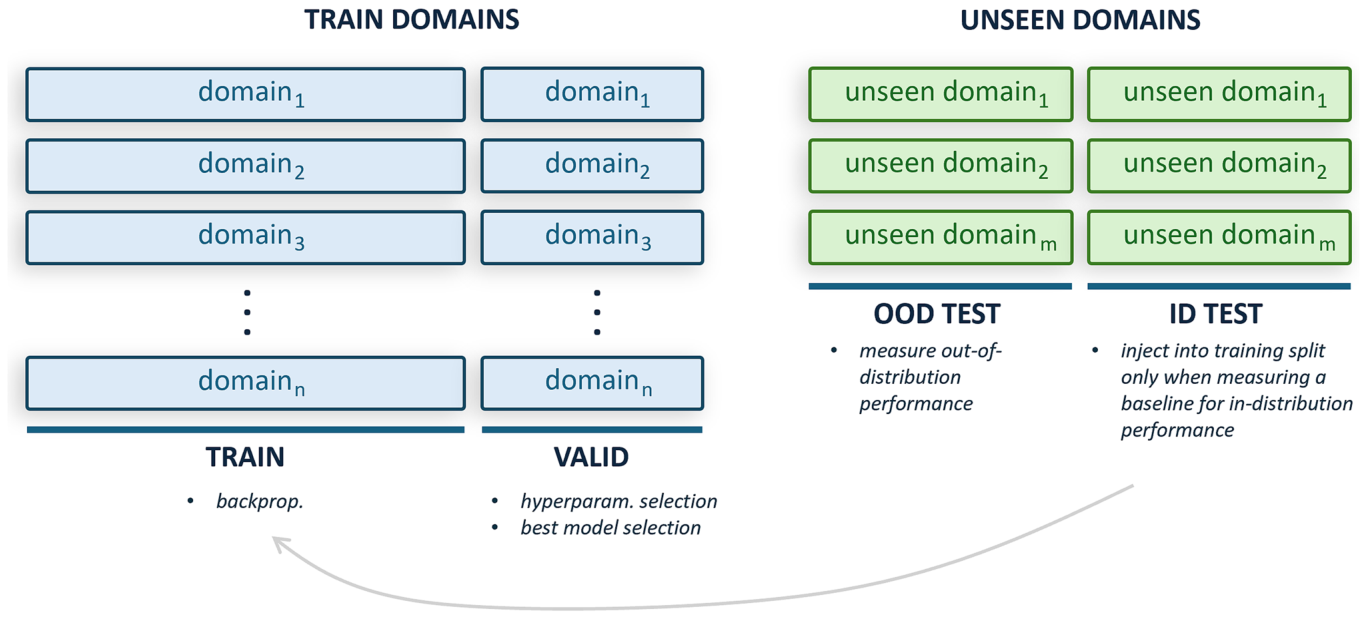
これらのシフトは以下の通りです。
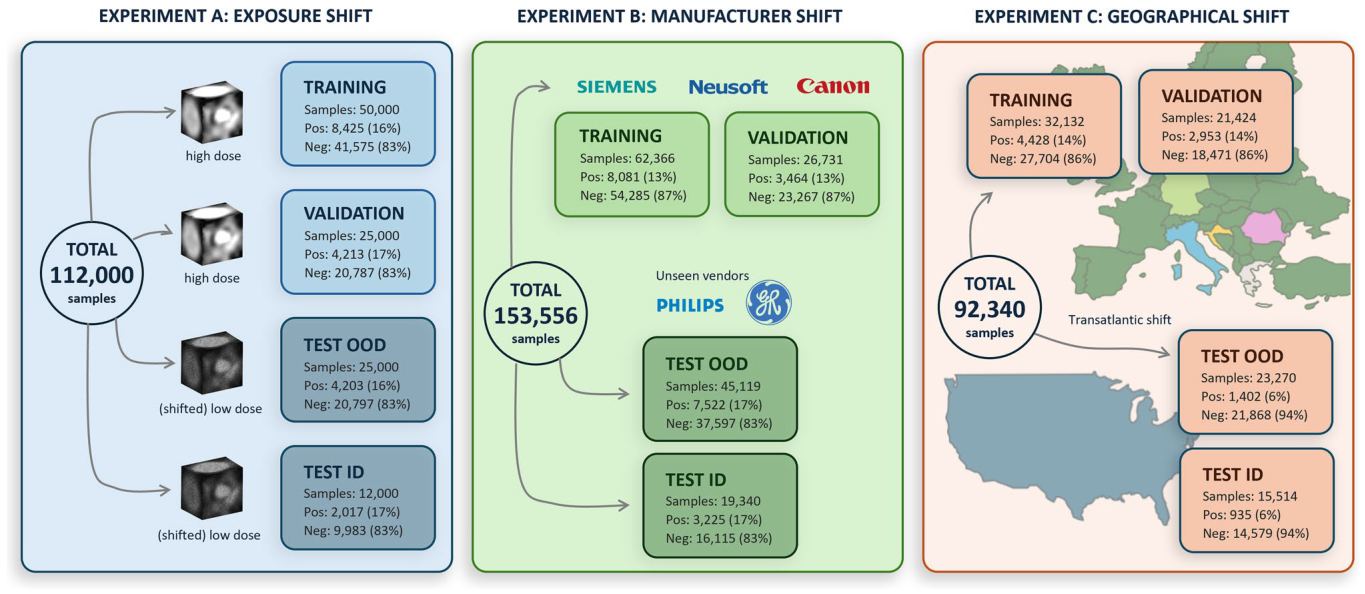
- 露光量変動(Exposure Variations):CT撮影時の管電流時間積(mAs)が標準的なスキャンと、大幅に低減されたスキャンとの間の性能変化を評価しました。訓練・検証セットは高mAs(平均152.7 mAs)、Test-ID・Test-OODは低mAs(平均34.4 mAs)で構成され、約77%の管電流時間積の削減に対応します。2. デバイスメーカー(Device Manufacturer):Siemens、Neusoft、Canon製のスキャナーで訓練されたモデルが、GE HealthCare、Philipsといった未見のメーカー製スキャナーでどれだけ精度を維持できるかを評価しました。3. 地理的変化(Geographic Changes):欧州の集団(ルーマニア、ドイツ、クロアチア、イタリア、ギリシャ)で訓練されたモデルが、米国の集団に対してどれだけ汎化できるかを検証しました。これは、対象者層の特性、結節の有病率(欧州13.78%に対し米国6.02%)、スキャナーの種類、取得プロトコルなど、大陸横断的な複合的な変動を反映しています。これらの要因を意図的に維持することで、単一要因の実験を補完し、現実的な多要因評価を行いました。評価指標としては、偽陽性削減タスクにおけるF1スコアが採用されました。この研究の主な関心事は、絶対的なF1性能ではなく、F1汎化ギャップ(Δ = F1{ID} −F1{OOD})でした。これは、モデルの性能が未見の分布に曝露されたときにどれだけ低下するかを測定する相対的な指標であり、ドメインシフトの影響を文脈化するのに役立ちます。
MedStyle-3DG:3D医療画像汎化のための統合フレームワーク
研究者らは、分布シフトに対抗するため、コントラスト学習を用いたVision-Languageモデル(VLM)であるCLIPと、専門的な医療画像ドメイン汎化技術を統合した汎化訓練フレームワーク「MedStyle-3DG」を開発しました。このフレームワークは、3段階の連続的な訓練パイプラインを通じて動作し、各段階でドメイン汎化の補完的な側面に対処します。
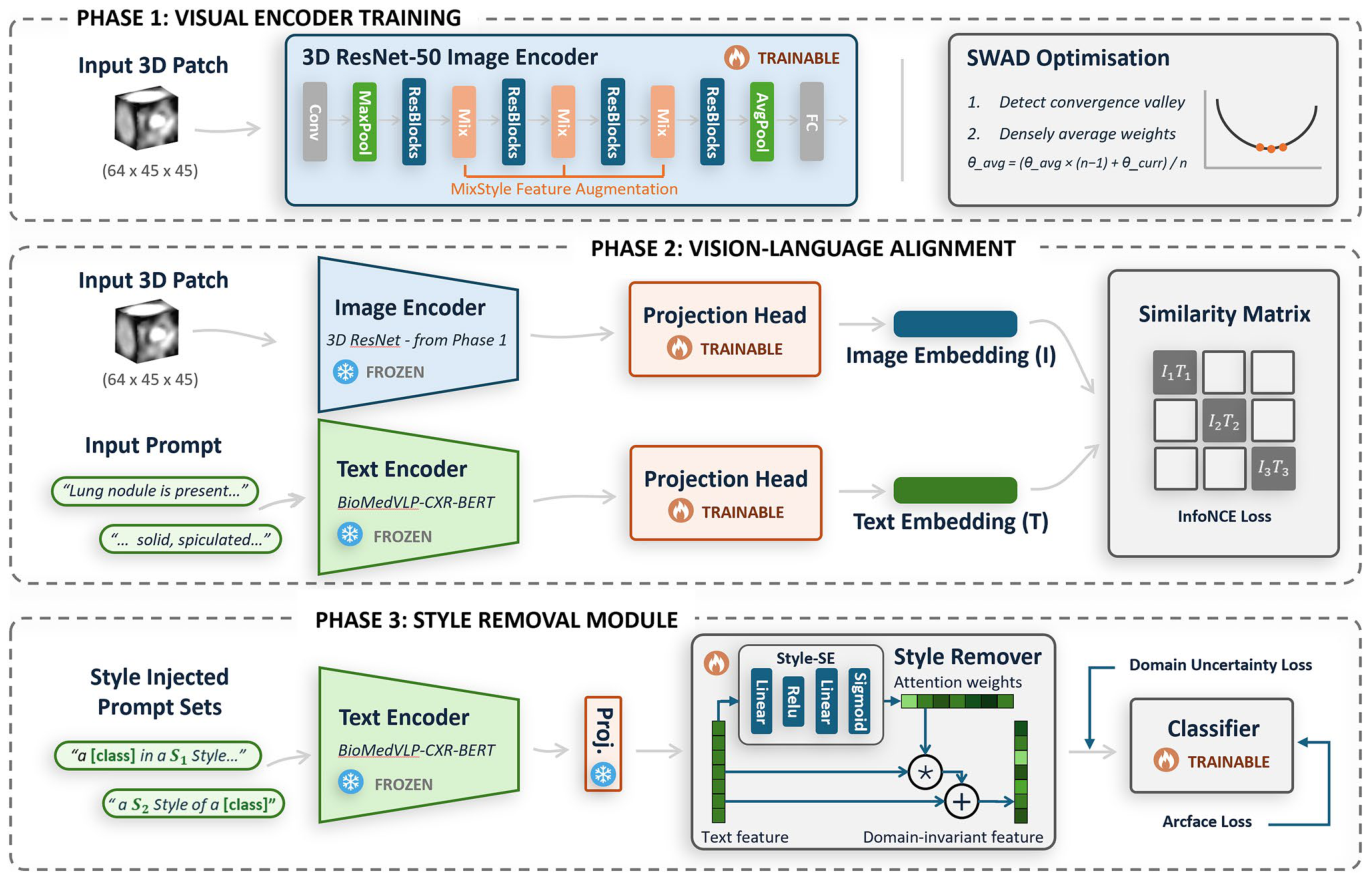
フェーズ1:視覚エンコーダ訓練
3D ResNet50視覚エンコーダが、特徴レベルでのドメイン増強のためのMixStyleと、ロバストな特徴抽出を目的とした確率的重み平均化(SWAD)戦略を用いて、ゼロから訓練されます。MixStyleは、スキャナーメーカーの違い、画像取得プロトコルの変動、露光量に関連する外観シフトにロバストな表現を学習することを可能にし、SWADはより平坦な損失ランドスケープ領域から重みを平均化することで、堅牢なモデル選択を保証します。
フェーズ2:Vision-Languageアライメント
フェーズ1で事前学習された3D ResNet50視覚特徴抽出器を固定し、事前学習済みの医療テキストエンコーダ(BiomedVLP-CXR-BERT)とアライメントさせ、マルチモーダルなCLIPスタイルの共同埋め込み空間を作成します。ここでは、エンコーダ自体は微調整せず、特徴を共有された512次元潜在空間にマッピングする射影層のみがコントラスト学習によって訓練されます。これにより、視覚とテキストのモダリティを橋渡しし、フェーズ3でテキストベースのスタイル除去手法を視覚表現に適用できるようになります。
フェーズ3:スタイル除去モジュール
フェーズ2で作成されたVision-Language共同空間の上に、スタイル除去モジュールが追加されます。Style-SEアダプターと分類器を固定されたテキストエンコーダの上に適合させ、合成的に様々なスタイル(例:「Reduced-Exposure」「Siemens」)をテキストプロンプトに注入することでドメインシフトをシミュレートします。このモジュールは、スタイル相関のあるチャネルを共同埋め込み空間で抑制することを学習します。ロバストネスを最大化するため、推論時には3分岐アンサンブルが採用されます。
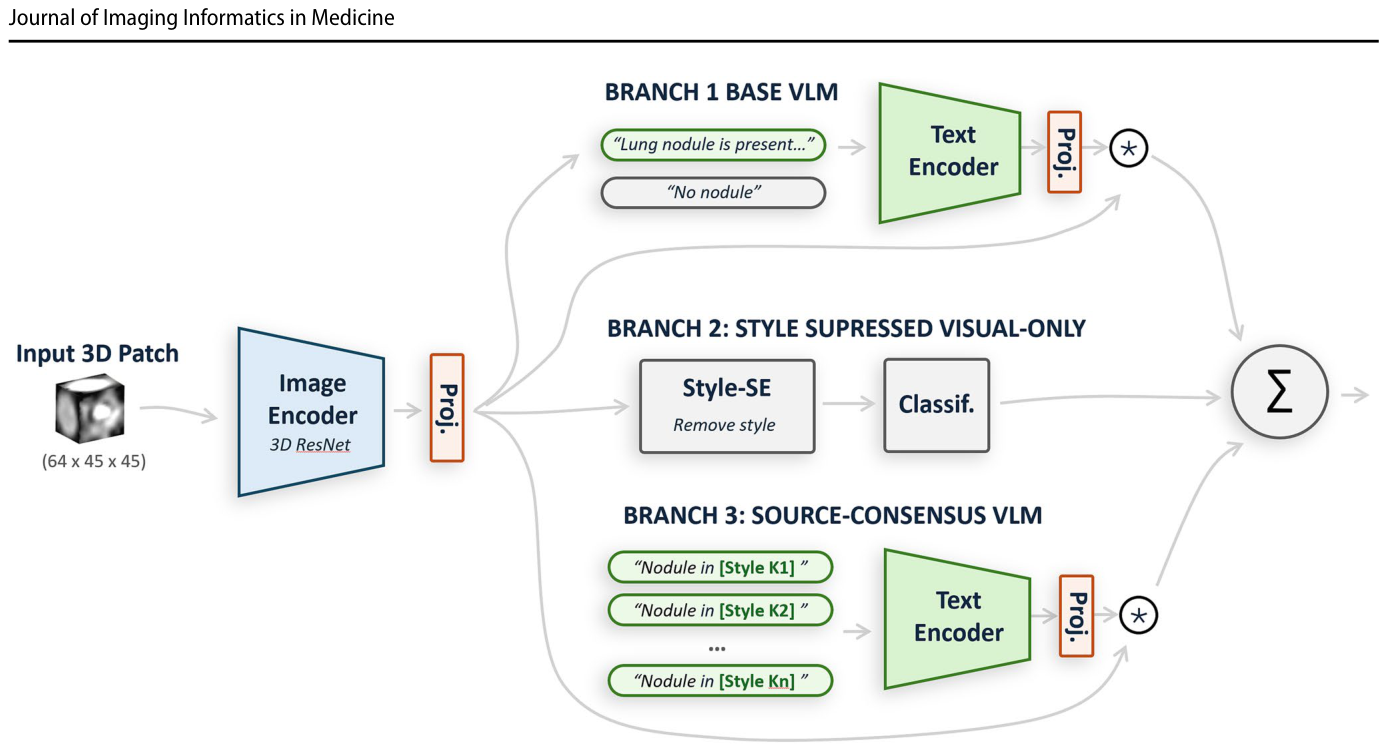
これにより、相補的な意思決定経路(安定したセマンティックベースライン、テクスチャ正規化された視覚分類器、多様性認識型コンセンサス機構)が融合され、最終的な予測はこれら3つの経路の重み付け統合として行われます。
MedStyle-3DGが示す汎化性能の改善
まず、3D ResNet50ベースラインモデルの現実世界の分布シフト下での性能を評価しました。その結果、すべてのシフトにおいて一貫した性能低下が観察されました。特に露光量シフトが最も厳しく、OOD F1スコアは大幅に低下し(P < 0.001)、ID-OOD汎化ギャップは0.109でした。メーカーシフトでは0.060、地理的シフトでは0.090の汎化ギャップが観察され、現実世界のプロトコル、ベンダー、および対象者集団の変化が、3D肺結節CADの性能を著しく低下させることが示されました。
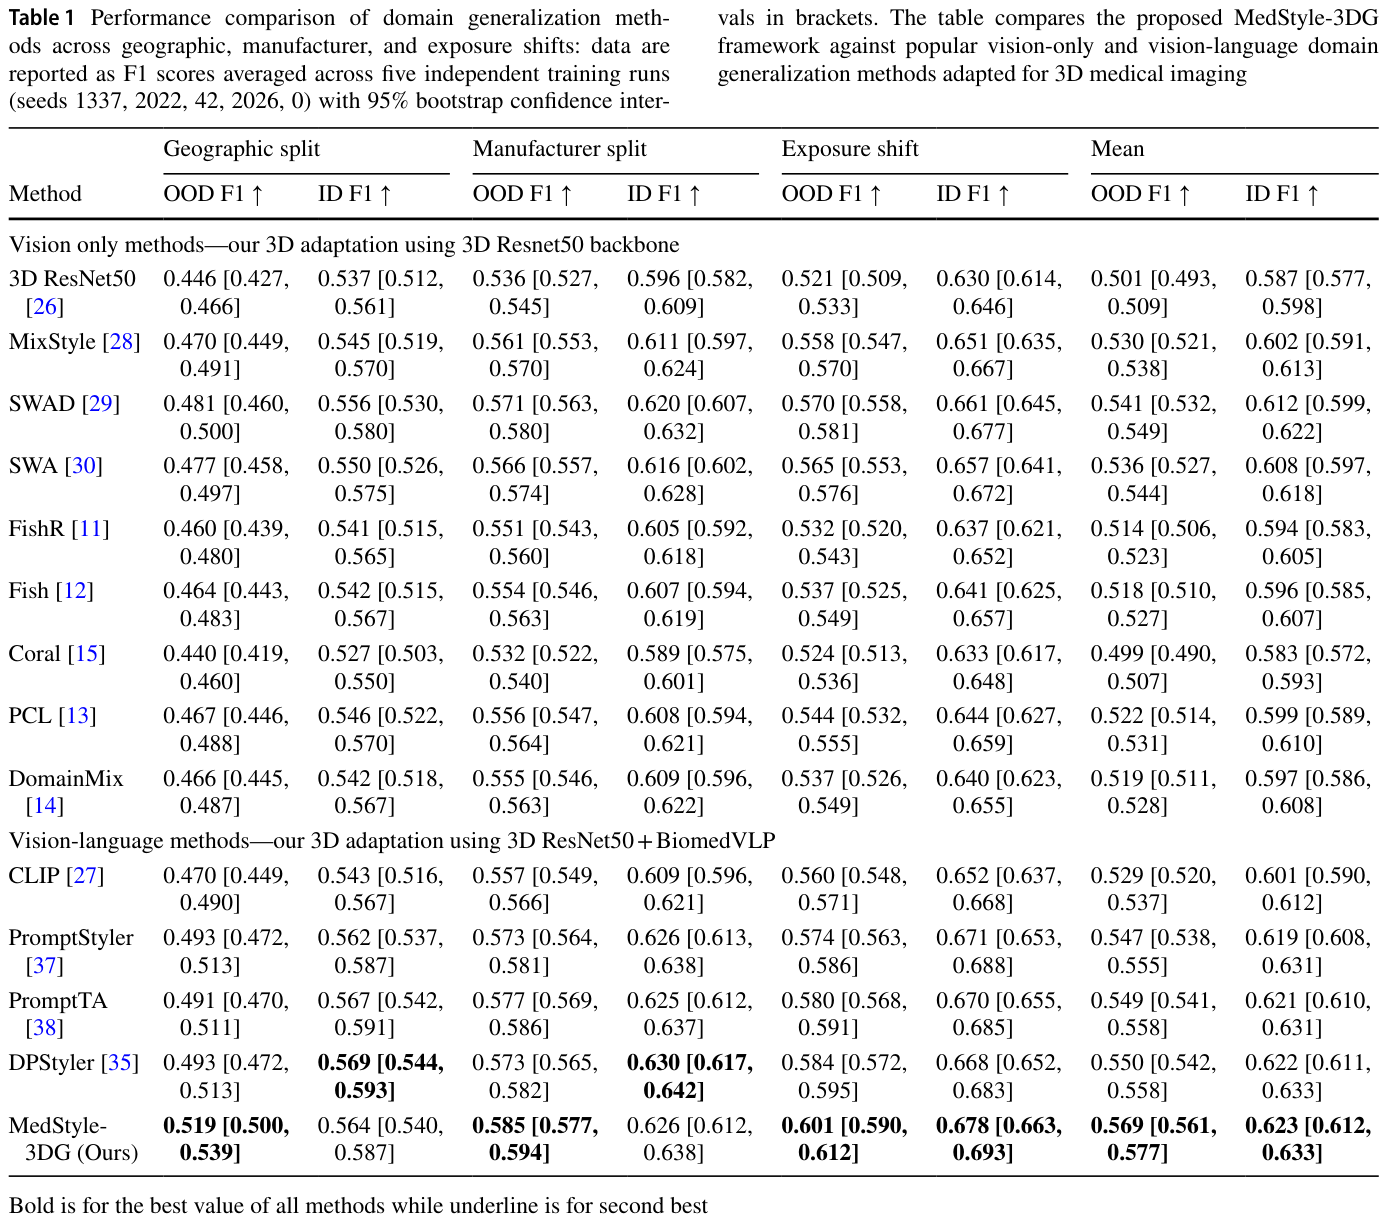
次に、提案されたMedStyle-3DGフレームワークの性能を評価しました。MedStyle-3DGは、評価されたすべてのシフトにおいて、最も高い平均OOD F1スコアを達成し、ID-OOD汎化ギャップを最も縮小しました。(表1)露光量シフトでは、MedStyle-3DGはOOD F1スコアを0.601に向上させ(ベースラインは0.521)、汎化ギャップをベースラインの0.109から0.077に削減しました。メーカーシフトではOOD F1スコアが0.585(ベースラインは0.536)に、汎化ギャップは0.040(ベースラインは0.060)に改善。地理的シフトではOOD F1スコアが0.519(ベースラインは0.446)に、汎化ギャップは0.045(ベースラインは0.090)に縮小しました。
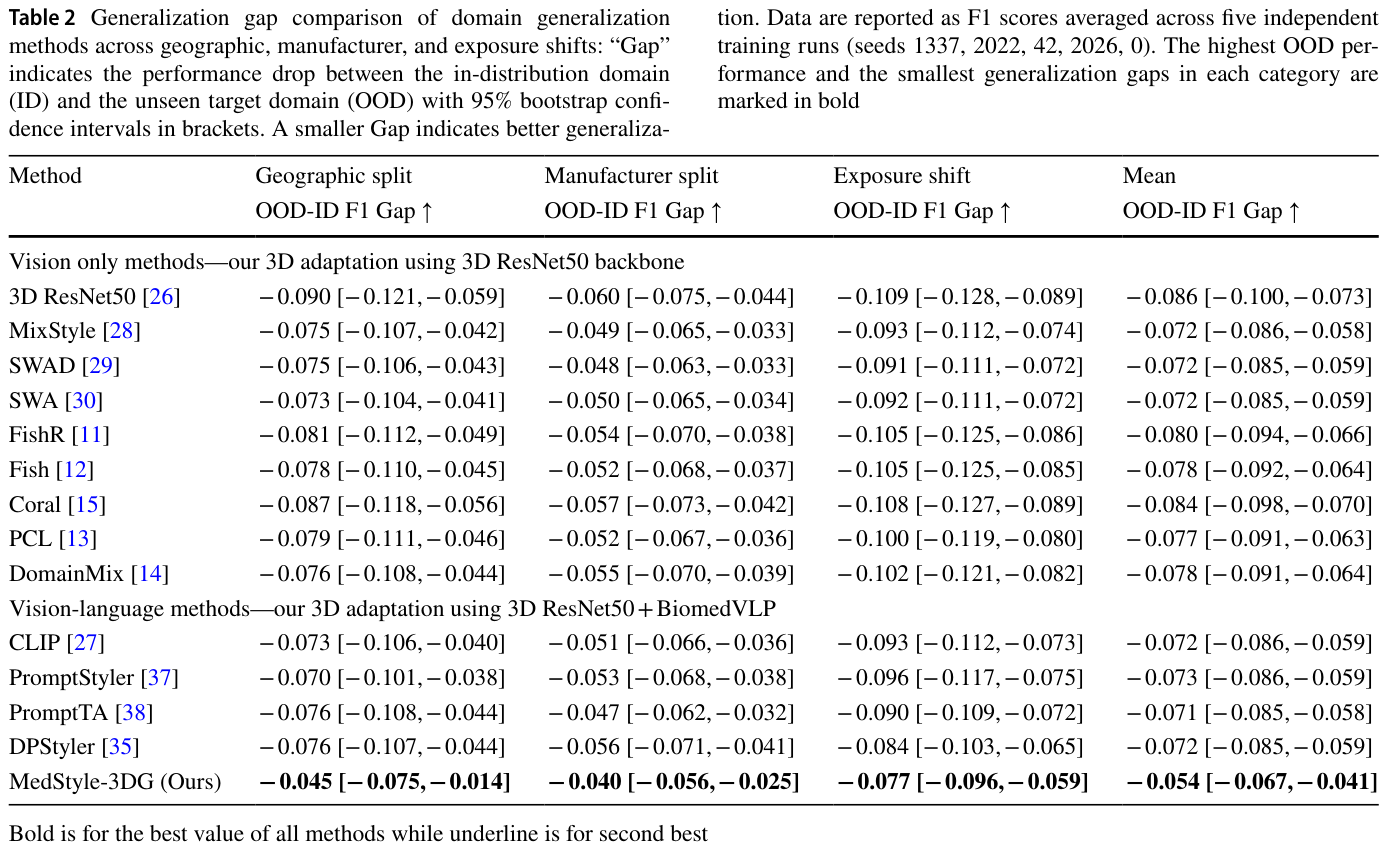
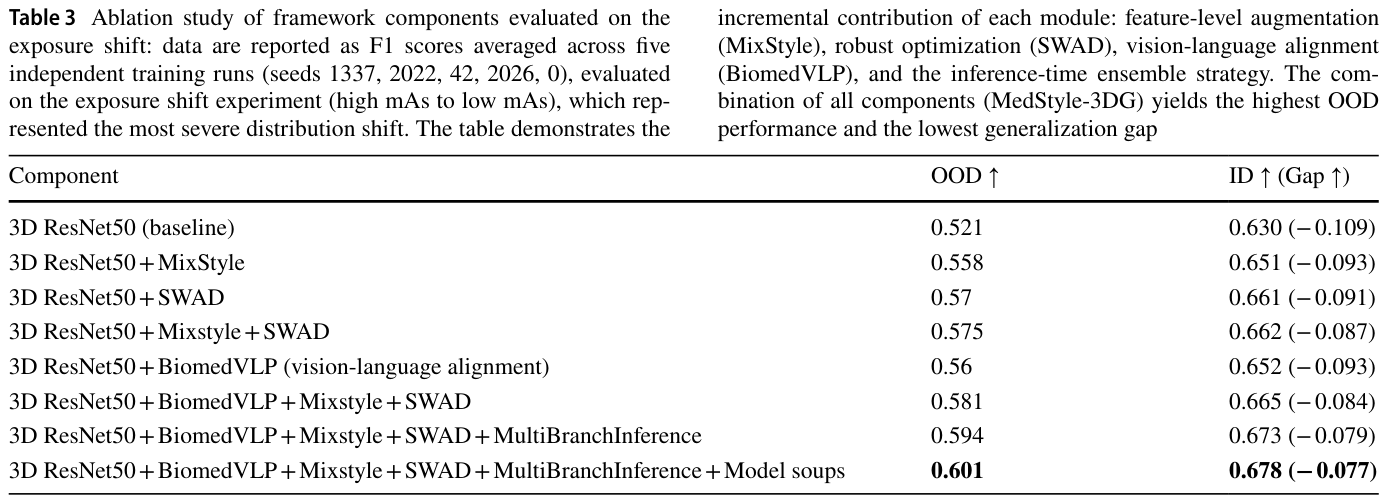
これら3つのシフト全体で平均すると、MedStyle-3DGは3D ResNet50ベースラインと比較してOOD F1を大幅に改善し(差0.067、Holm調整P < 0.001)、ID-OOD F1汎化ギャップを著しく減少させました(差0.032、Holm調整P < 0.001)。また、PromptTA、DPStyler、PromptStylerといった他の強力なVision-Language手法と比較しても、MedStyle-3DGは有意に優れた性能を示しました。本研究では、最も厳しい分布シフトであった露光量シフトについて、各コンポーネントの貢献を評価するアブレーションスタディも実施しました。結果として、MixStyle、SWAD、BiomedVLPとのVision-Languageアライメント、マルチブランチ推論、そしてモデルスープという各モジュールが段階的に貢献し、最終的なMedStyle-3DGが最高のOOD性能と最小の汎化ギャップを達成することが示されました。
データスケーリングと今後の展望
データスケーリングに関する実験も行われ、訓練データ量を2倍、3倍に増やした場合の露光量シフトに対するモデルの汎化性能を評価しました。結果として、ベースラインモデルもMedStyle-3DGもデータ量が増えるにつれて性能は向上しましたが、その転送挙動は異なりました。ベースラインのOOD F1は緩やかに上昇したものの、ID-OOD汎化ギャップはむしろ拡大しました(0.108から0.118へ)。これは、明示的な正則化なしに標準モデルが大規模なソースデータセットの特異性に過適合する可能性を示唆しています。対照的に、MedStyle-3DGは追加データを効果的に活用し、OOD F1を大幅に向上させ(0.601から0.714へ)、汎化ギャップを着実に縮小させました(0.077から0.055へ)。
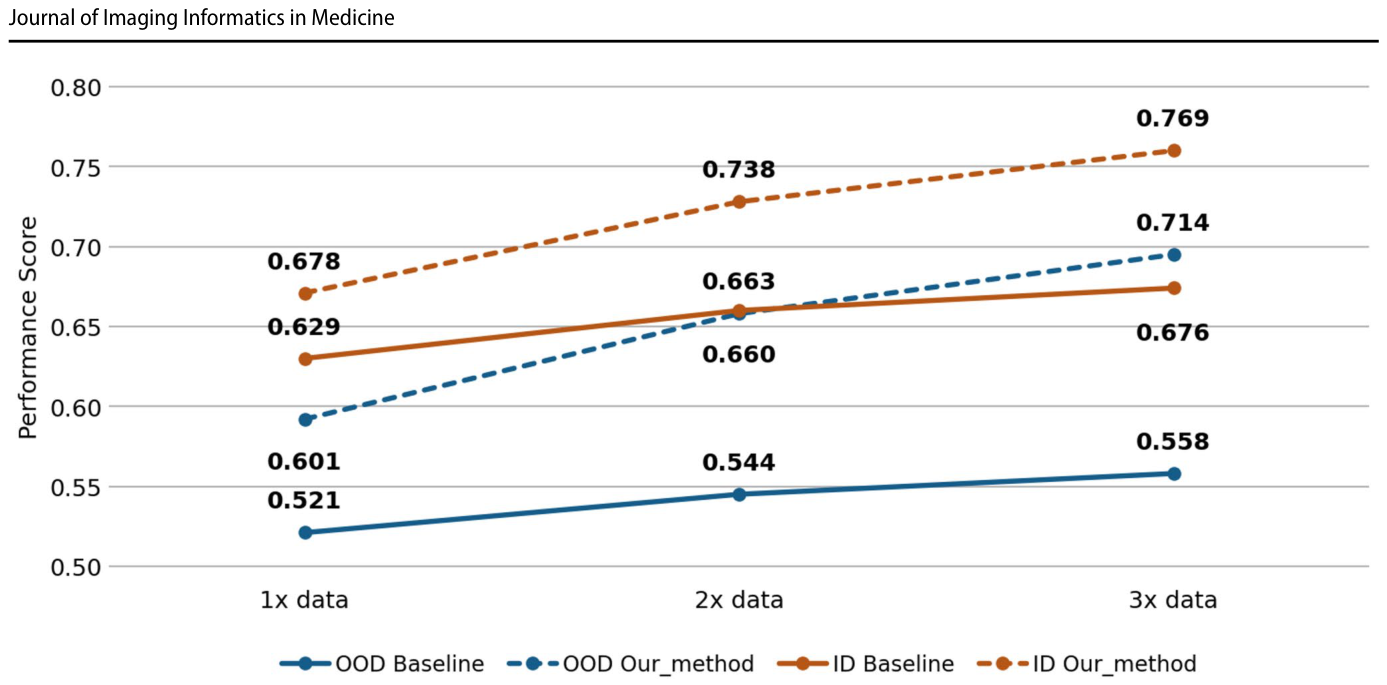
これは、効果的なデータスケーリングには堅牢性が前提条件であることを示唆する重要な知見です。本研究のMedStyle-3DGは、堅牢な特徴学習、Vision-Languageアライメント、スタイル抑制、およびアンサンブルベースの推論を組み合わせることで、スキャナー、プロトコル、および対象者集団のシフトによって引き起こされる性能低下を効果的に緩和しました。これは、より堅牢なCADシステムを開発するための実用的な道筋を提供するものです。ただし、本フレームワークの限界として、Vision-Languageアライメント中のテンプレートベースのプロンプトへの依存が挙げられます。これは有用な意味的アンカーを提供する一方で、実際の放射線専門家の言語の豊かさや多様性を捉えきれていません。今後は、匿名の臨床レポートを統合して、よりニュアンスのある記述子をエンコードし、性能を向上させることが考えられます。また、F1カットオフキャリブレーションのドリフトと表現ドリフトを性能低下の根本原因として区別していません。これらは現実世界の展開において汎化問題に寄与する可能性のある要因です。今後の研究では、提案されたドメイン汎化フレームワークが、肺結節以外の他の3D画像診断タスク(例:リンパ節検出、MRI、セグメンテーション)にも転送可能であるかを検討する必要があります。MedStyle-3DGの完全なフレームワークと訓練コードは、再現性を促進し、ドメイン堅牢な医療AIの開発を加速させるために、論文受理後にGitHubで公開される予定です。
用語集
- 分布シフト: AIモデルの訓練データと実際の運用データの間で統計的特性が異なる現象。AI性能低下の主要因。
- ドメイン汎化: AIモデルが訓練で遭遇しなかった新しい(未見の)データドメインに対しても、高い性能を維持できる能力。
- F1スコア: 分類モデルの精度を評価する指標の一つで、適合率と再現率の調和平均。バランスの取れた性能を示す。
- F1汎化ギャップ: In-Distribution(ID)データでのF1スコアと、Out-of-Distribution(OOD)データでのF1スコアの差。性能低下の度合いを示す。
- MixStyle: 特徴レベルでのドメイン増強手法。異なるサンプル間でチャネルごとの統計量(平均と標準偏差)を混合する。
- SWAD: Stochastic Weight Averaging Discoveryの略。モデルの重みを確率的に平均化することで、損失関数の平坦な最小値を見つけ、ロバスト性を向上させる最適化戦略。
- Vision-Languageモデル (VLM): 画像(視覚情報)とテキスト(言語情報)の両方を理解し、関連付けることができるAIモデル。
- コンピュテーショナル・アシステッド・ディテクション (CAD): 画像から疾患の病変を検出したり、診断を支援したりするためにコンピュータを用いる技術。
- In-Distribution (ID): モデルの訓練データと同じ統計的分布を持つデータのこと。訓練時に見られたドメイン内のデータ。
- Out-of-Distribution (OOD): モデルの訓練データとは異なる統計的分布を持つデータのこと。訓練時に見られなかったドメイン外のデータ。
- mAs: CT撮影時の管電流時間積を示す物理量。X線の量に影響し、画像のノイズレベルや被ばく線量に関連する。
- ゴールデンスタンダード: 特定の評価や診断において、最も信頼性が高く、比較の基準となる方法やデータのこと。
- ブートストラップ法: 統計的推測手法の一つ。観測データから反復的に再サンプリングを行うことで、統計量の標本分布を推定する。
コメントを残す