
胸部X線画像から脳卒中と心不全を検出:DINOv2とVision Transformerが拓く診断の新境地
解説対象論文: DINOv2-Pretrained Vision Transformers for Stroke and Heart Failure Detection from Chest X-rays with Limited Labeled Data
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月11日時点)
世界中で主要な死因となっている心血管疾患と脳血管疾患の早期スクリーニングは重要ですが、深層学習モデルの訓練には大量のラベル付き医用データが必要で、その収集とアノテーションは大きな課題です。本記事では、この課題を解決するため、DINOv2自己教師あり学習とVision Transformerを組み合わせた3段階フレームワークをご紹介します。この革新的なアプローチにより、限られたラベル付きデータから胸部X線画像を用いて脳卒中と心不全を高精度に検出できることが示されました。本研究は、低コストでスケーラブルな疾患スクリーニングの新たな可能性を拓きます。
限られたデータで疾患検出を可能にする革新的アプローチ
どうも、Beyond the Pixelです。心血管疾患と脳血管疾患は、世界中で死因の上位を占める重大な疾患であり、スケーラブルで非侵襲的なスクリーニング手法が求められています。胸部X線(CXR)は広く利用可能ですが、従来の深層学習モデルは、臨床現場での取得が困難で費用のかかる大量のラベル付きデータに依存するという課題がありました。本記事では、この課題を克服するために提案された、DINOv2自己教師あり学習とVision Transformer(ViT)を組み合わせた革新的な3段階フレームワークに関する論文をご紹介します。この研究は、限られたラベル付きデータで胸部X線画像から脳卒中と心不全を高精度に検出する可能性を示しています。
既存手法の課題:ラベル付けデータとそのコスト
これまでの医用画像分野の研究では、主に教師あり学習手法が採用されてきました。しかし、教師あり学習モデルの訓練には、膨大なラベル付きデータが必要であり、データの収集やアノテーション(注釈付け)に多大な時間と計算リソース、そして高い人件費がかかります。さらに、医用画像データは機密性の高い個人情報を含むため、その取得と収集には多くの制約が伴います。これらの課題が、効率的で高精度な深層学習モデルの開発を複雑で時間のかかるものにしていました。
自己教師あり学習と転移学習の台頭
近年、この課題を解決する手法として、自己教師あり学習(SSL)と転移学習が注目を集めています。自己教師あり学習は、ラベルなしデータから有用な特徴表現を抽出することで、膨大な未ラベル医用画像データを効果的に活用します。一方、転移学習は、大規模なデータセットで事前学習されたモデルの重み(学習済みの知識)を特定の医用画像分析タスクに転移させることで、モデルの訓練時間を大幅に短縮し、汎化性能を向上させます。本研究は、これら二つの強力な手法を組み合わせることで、限られたラベル付きデータでの疾患検出を目指しました。特に、脳卒中は脳血管イベントですが、その主要な病型である心原性脳塞栓症は、心臓の構造的病変(例:左心房拡大、駆出率低下、弁膜症)に起因し、これらは胸部X線画像に直接現れる可能性があります。これにより、胸部X線画像からの脳卒中検出は、心原性リスクのスクリーニングとして低コストで利用できると考えられています。
提案された3段階フレームワークの詳細
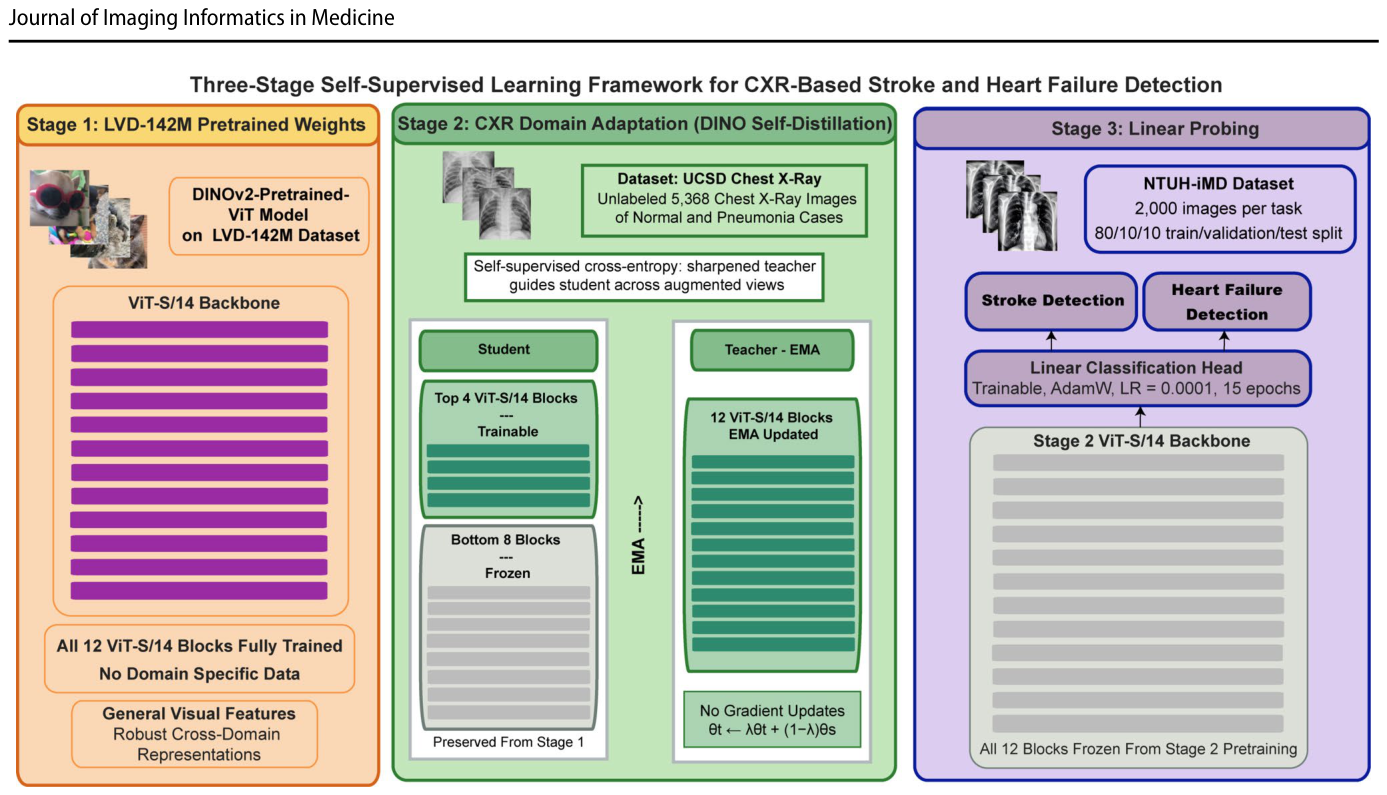
本研究で提案されたフレームワークは、以下の3つの段階で構成されます。(図1)このアプローチにより、モデルは少ないラベル付きデータと短い訓練時間でも、様々な病変を正確に検出できるようになります。
ステージ1:DINOv2による大規模データでの初期事前学習
まず、Vision Transformer(ViT-Small/14)のバックボーンは、DINOv2自己教師あり学習フレームワークを用いて、LVD-142Mと呼ばれる1億4200万枚の画像からなる大規模データセットで事前学習された重みで初期化されます。この段階では、特定の医用画像に特化しない汎用的な視覚的特徴が学習されます。
ステージ2:胸部X線画像へのドメイン適応
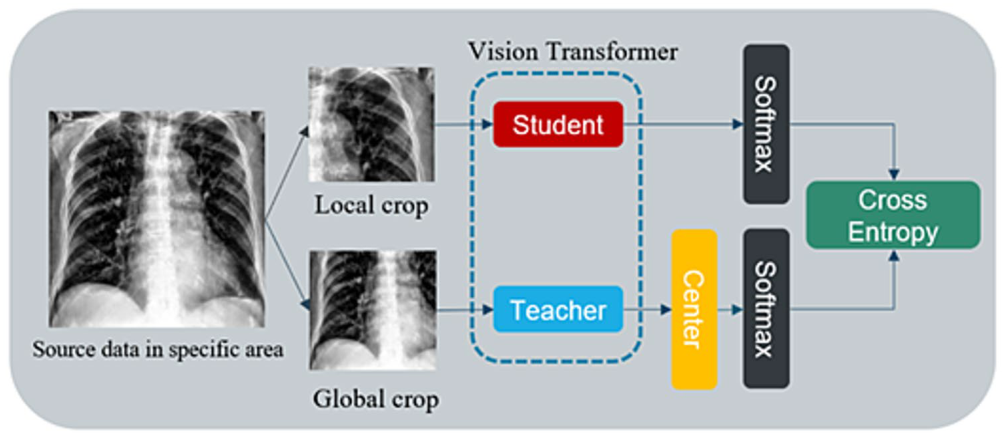
次に、モデルはUCSD(カリフォルニア大学サンディエゴ校)データセットに含まれる5,368枚のラベルなし胸部X線画像を用いて、自己教師あり事前学習を継続します。このデータセットには小児の肺炎と正常な胸部X線画像が含まれており、脳卒中や心不全のケースは含まれていません。この段階では、胸部X線画像特有の構造的・テクスチャ的特徴(例:肺の境界、心臓のシルエット、血管パターン)に適応するようにモデルの表現が調整されます。特に、ViTバックボーンの下位8層のTransformerブロックは凍結され、汎用的な視覚表現が保持されつつ、より高次の特徴が胸部X線画像に特化するよう学習されます。
ステージ3:限られたラベルデータでの線形プローブ評価
最後に、モデルはNTUH-iMD(台湾大学病院統合医療データベース)から提供された、専門家によってアノテーションされた(注釈付けされた)ラベル付きデータを用いて、脳卒中と心不全の二値分類タスクに対して線形プローブにより評価されます。線形プローブとは、事前学習されたモデルのバックボーンを固定し、その上にシンプルな線形分類器のみを訓練する手法です。これにより、モデルが学習した特徴表現の品質を直接評価することができます。この研究では、各タスクにつき2,000枚のラベル付き画像が使用されました。
データセットと前処理
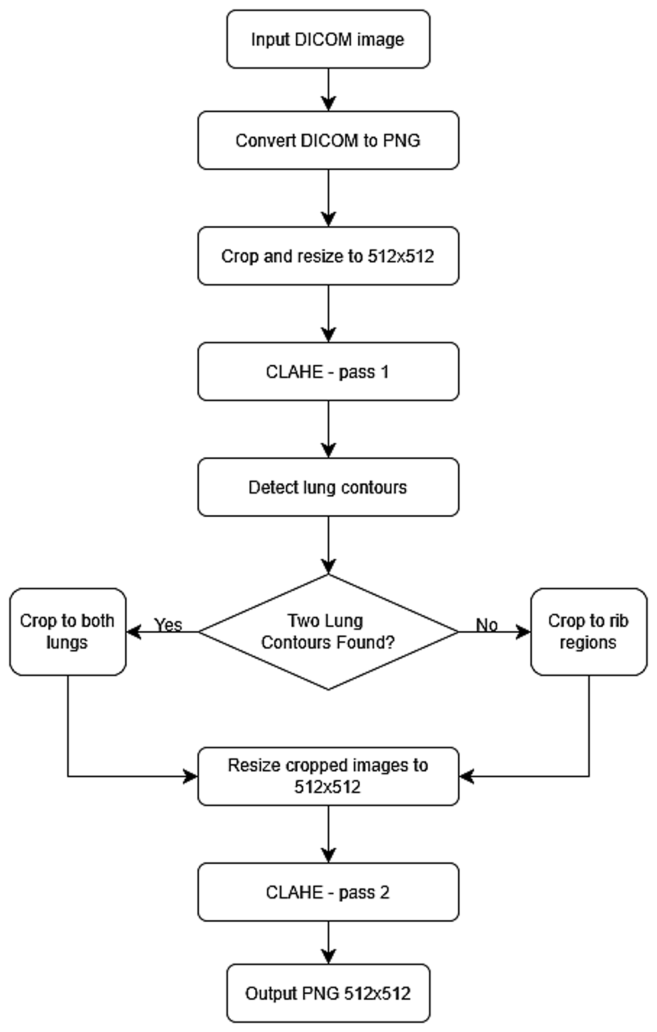
本研究で使用された主要なデータセットはNTUH-iMDで、脳卒中および心不全の胸部X線画像が含まれます。また、自己教師あり事前学習の第2段階では、UCSDのオープンソース胸部X線データセットが使用されました。さらに、モデルの汎化性能を向上させるため、KaggleのCOVID-19 Radiography Databaseから健康な(正常な)胸部X線画像が組み込まれました。データの前処理では、DICOM形式の画像をPNG形式に変換し、512×512ピクセルに統一的にクロップしました。さらに、CLAHE(Contrast Limited Adaptive Histogram Equalization)と呼ばれる技術を用いて、画像のコントラストを局所的に強調し、特徴をより際立たせています。
重要な知見と性能評価
本研究では、複数の実験を通じて提案フレームワークの有効性を検証しました。
陰性クラスにおける正常胸部X線画像の割合の影響
NTUH-iMDデータセットには「正常な」胸部X線画像が含まれていないため、非脳卒中/非心不全のカテゴリに正常サンプルを含めることがモデルの汎化性能に与える影響を評価しました。Kaggleのデータベースから選択された正常画像を、陰性クラスに10%、20%、50%、80%の割合で混合し、モデル性能を検証しました。
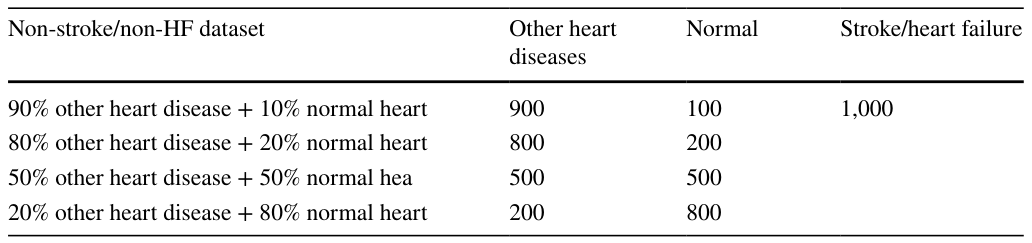
その結果、正常胸部X線画像の割合が増加するにつれて、モデルは疾患画像と非疾患画像との間の識別境界をより明確に学習できるようになり、性能が向上することが示されました。
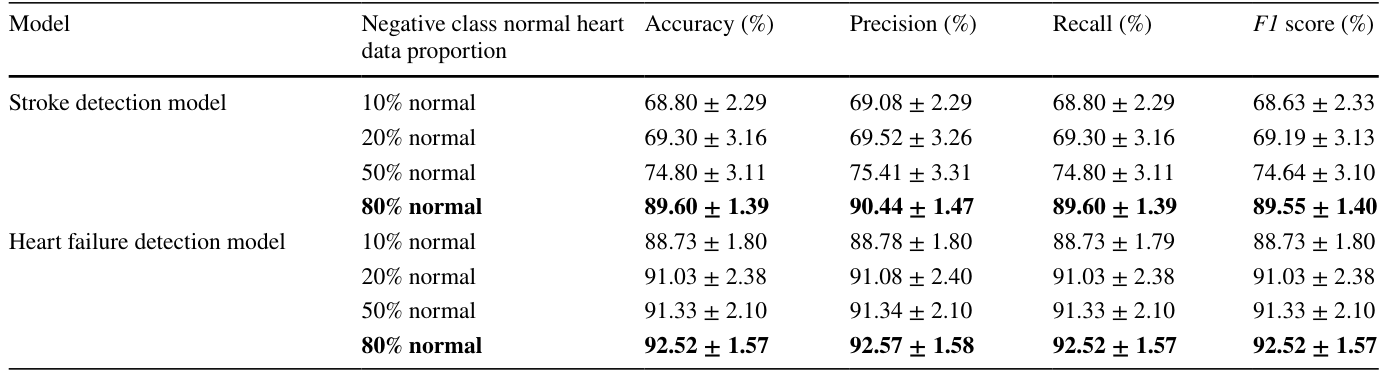
特に80%の正常割合が両タスクで最適な結果をもたらしました。これは、正常な胸部X線画像が他の心疾患よりも視覚的に明確に異なること、そしてモデルが多様な非疾患像に触れることで、よりシャープな判別学習ができたためと考えられます。
事前学習パイプラインの各段階の寄与
3段階フレームワークの各ステージの効果を理解するため、アブレーションスタディを実施しました。ランダム初期化、LVD-142M事前学習のみ、そしてLVD-142MとUCSD CXR事前学習を順次適用した構成を比較したところ、事前学習戦略がドメインに近づくにつれて、一貫して性能が向上することが確認されました。
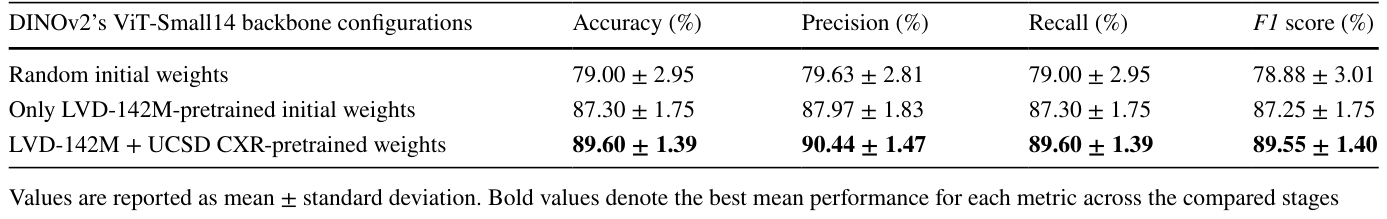
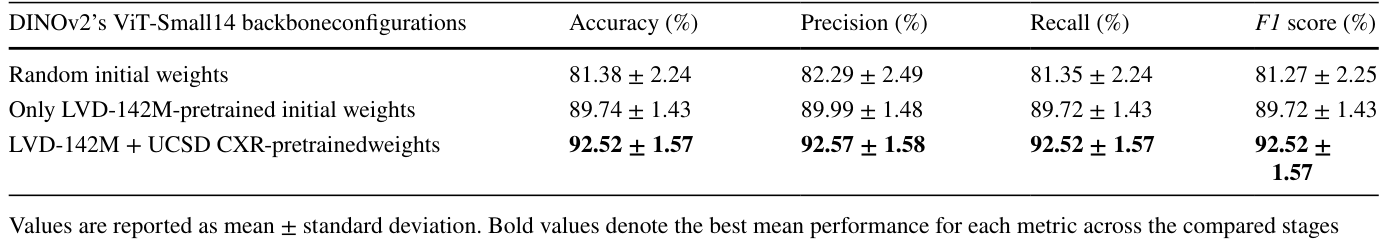
ランダム初期化が最も性能が低く、LVD-142Mからの初期化で大幅な改善が見られ、さらにUCSD CXRによる事前学習を加えることで心不全検出タスクで最も大きな改善が見られました。これは、胸部X線画像特有の特徴へのドメイン適応が効果的であることを示唆しています。
他の自己教師あり学習モデルとの性能比較
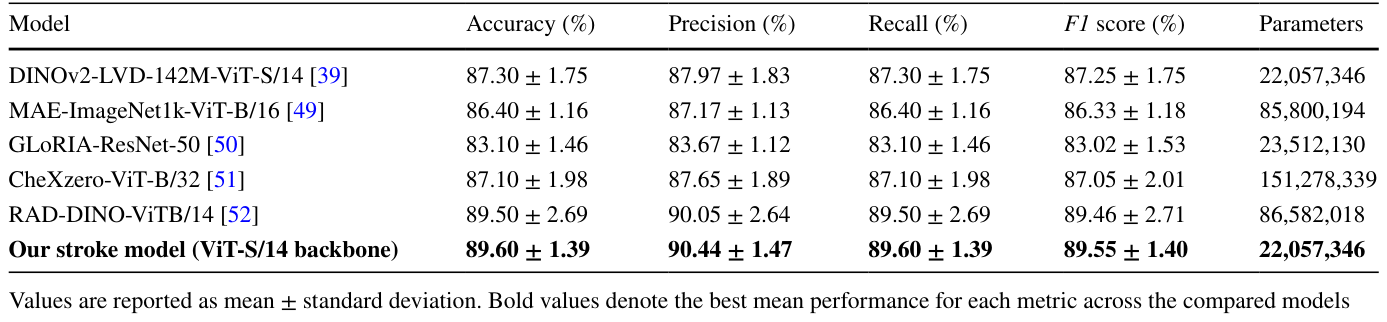
本研究のモデルは、他の5つの自己教師あり学習ベースラインモデルと比較されました。脳卒中検出タスクにおいて、本モデルは89.60%の精度と89.55%のF1スコアを達成し、ViT-B/14バックボーンを持つRAD-DINO(89.50%)を含む全てのベースラインを上回りました。RAD-DINOが本モデルの約4倍のパラメータ数を持つことを考慮すると、これは特筆すべき結果です。
心不全検出タスクでも、本モデルは92.52%の精度と92.52%のF1スコアで全体の1位を獲得し、GLoRIA、CheXzero、RAD-DINOを大幅に上回りました。
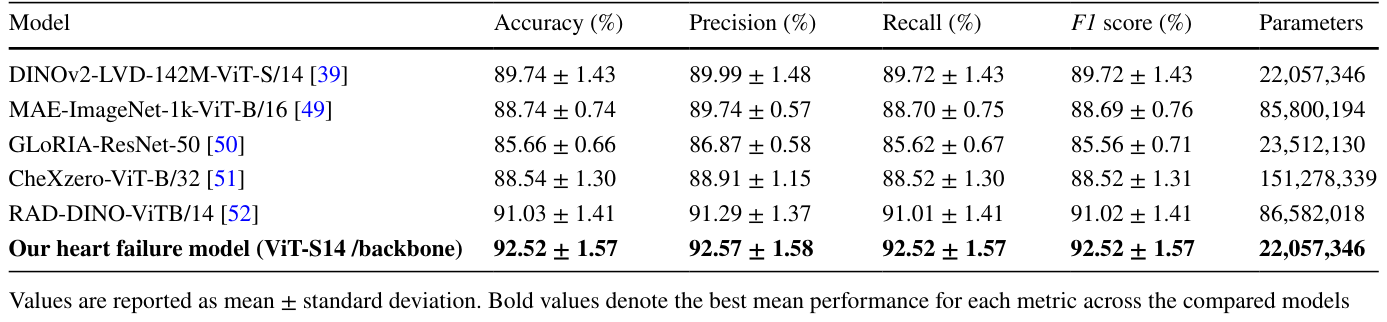
これらの結果は、本研究の3段階事前学習パイプラインが、少ないパラメータ数で、他の大規模なドメイン特化型モデルにも匹敵する、あるいはそれ以上の性能を達成できることを示しています。
臨床的解釈可能性を高めるアテンション可視化
モデルの臨床的解釈可能性を高めるため、マルチヘッドアテンション可視化が用いられました。これにより、モデルが画像内で最も注目している領域をハイライトすることができます。正常データの割合が増加するにつれて、アテンションパターンがより焦点を絞り、臨床的に意味のある領域に集中するようになることが示されました。これは、モデルの決定プロセスが解剖学的に意味のある心臓および肺領域に集中していることを裏付けており、本フレームワークの臨床応用における信頼性を高めます。
結論と今後の展望
本研究は、自己教師あり学習とVision Transformerを組み合わせることで、限られたラベル付きデータから胸部X線画像による脳卒中および心不全の正確な検出が可能であることを実証しました。提案された3段階フレームワークは、DINOv2 LVD-142MでのViT-Small/14バックボーンの初期化、そして下位8層のTransformerブロックを凍結した未ラベルの小児胸部X線画像でのドメイン適応自己教師あり事前学習を通じて、低レベルの視覚表現を保持しつつ、高レベルの特徴を胸部X線形態に適応させます。
各事前学習段階が測定可能な性能向上に寄与することが確認され、完全な3段階初期化はランダム初期化やLVD-142Mのみの初期化と比較して一貫して優れた性能を示しました。本研究の脳卒中モデルは、約4倍のパラメータを使用するRAD-DINOを含む全ての測定された自己教師あり学習ベースラインを上回り、89.60%の精度を達成しました。心不全モデルも92.52%の精度を達成し、GLoRIA、CheXzero、RAD-DINOを大幅に凌駕しました。
陰性クラスにおける正常胸部X線画像の割合が分類性能に大きく影響することも明らかになりました。80%の正常構成が最適な結果をもたらしましたが、この改善は視覚的に異なる正常X線画像とのより明確な識別境界とタスク難易度の変化の両方を反映していると解釈されるべきです。アテンション可視化により、両モデルが解剖学的に意味のある心臓および肺領域に焦点を当てていることが確認され、臨床的解釈可能性を支持しています。これらの知見は、ターゲットを絞った胸部X線ドメイン適応を備えた軽量でパラメータ効率の良い自己教師あり学習パイプラインが、より少ないパラメータで大規模なドメイン特化型基盤モデルに対して競争力のある性能を達成できることを確立します。
一方で、限界として、陰性クラスの正常胸部X線画像がNTUH-iMDとは異なる取得設定の外部データベース(Kaggle COVID-19 Radiography Database)から供給された点が挙げられます。ヒストグラム均等化により強度分布は正規化されましたが、残存するドメインの違いが存在する可能性があります。また、両タスクは単一の独自NTUH-iMDデータセットで評価されたため、独立した多施設コホートでの外部検証が臨床応用への重要な次のステップとなります。胸部X線からの脳卒中検出は、直接的な脳血管画像化ではなく、間接的な心原性脳塞栓リスク信号を反映するものであり、診断を確定するツールではなく、機会的なスクリーニングツールとして位置付けられるべきです。
用語集
- DINOv2: 教師なしで視覚的特徴を学習する自己教師あり学習フレームワークの一種で、大規模な画像データセットから汎用的な視覚表現を獲得します。
- Vision Transformer (ViT): Transformerモデルを画像処理タスクに適用したもので、画像をパッチに分割し、それぞれのパッチ間の関係性(アテンション)を学習することで画像全体を理解します。
- 自己教師あり学習 (Self-supervised learning, SSL): 大量のラベルなしデータから、データ自体が持つ構造やパターンを利用して特徴表現を学習する機械学習手法です。
- 転移学習 (Transfer learning): あるタスクで学習した知識(モデルの重みなど)を、関連する別のタスクに再利用する機械学習の手法です。
- 線形プローブ (Linear probing): 事前学習済みのモデルの基盤部分(バックボーン)を固定し、その上にシンプルな線形分類器を接続して少量のラベル付きデータで訓練することで、事前学習された特徴表現の品質を評価する手法です。
- 胸部X線 (Chest X-ray, CXR): 肺や心臓など胸部の内部構造を画像化する一般的なX線検査で、診断やスクリーニングに広く用いられます。
- LVD-142M: DINOv2の事前学習に用いられた、1億4200万枚の画像から構成される非常に大規模な画像データセットです。
- NTUH-iMD: National Taiwan University Hospital–integrated Medical Databaseの略で、台湾大学病院が保有する統合医療データベースです。
- CLAHE (Contrast Limited Adaptive Histogram Equalization): 画像のコントラストを改善する技術で、特に局所的な領域でコントラストを調整することで、過度な強調を防ぎながら特徴を鮮明にします。
- マルチヘッドアテンション (Multi-head attention): Transformerモデルの主要な構成要素の一つで、複数のアテンション機構を並行して実行し、異なる視点から入力データの関係性を捉えることで、より豊かな特徴表現を獲得します。
- Attention Rollout: Vision Transformerにおいて、複数の層とヘッドにわたるアテンションメカニズムを統合し、モデルが画像内でどこに注目しているかを示す単一のアテンションマップを生成する可視化手法です。
- EMA (Exponential Moving Average): 指数移動平均の略で、過去のデータにより重みを与えながら平均を計算する手法。自己教師あり学習のTeacherモデルのパラメータ更新に用いられ、安定した学習を促します。
コメントを残す