
放射線専門家が選ぶ!LLMによる診療歴要約の最適な形は「短く要領を得た」もの
解説対象論文: Less Is More: Radiologists Prefer Brief Narratives in LLM-Generated Clinical History Summaries
Journal of Imaging Informatics in Medicine|被引用数: 0(2026年9月5日時点)
日々増加する放射線専門家の業務負担の中で、迅速かつ正確な診断には詳細な診療歴の把握が不可欠です。しかし、既存の診療記録は膨大になりがちで、そのレビューに要する時間は無視できません。本記事では、大規模言語モデル(LLM)がこの課題にどのように貢献し、特にどのような形式の要約が放射線専門家にとって最も有用であるかを探る画期的な研究を紹介します。驚くべきことに、放射線専門家が最も求めたのは、極めて「簡潔」な要約でした。
はじめに: 放射線専門家の情報過多とLLMの可能性
どうも、Beyond the Pixelです。医療現場で日々増加する情報量に、専門家たちはどう向き合っているのでしょうか。特に放射線診断においては、正確な診断を下すために対象者の詳細な診療歴が不可欠です。しかし、多くの診療歴は膨大で、多忙な放射線専門家にとってそのすべてを確認するのは時間のかかる作業であり、大きな負担となっています。ここに、大規模言語モデル(LLM)が解決策として期待されています。LLMは既存の診療記録から、臨床的に焦点を絞った簡潔な要約を生成する可能性を秘めているのです。
研究の目的と方法:2段階要約パイプラインの検証
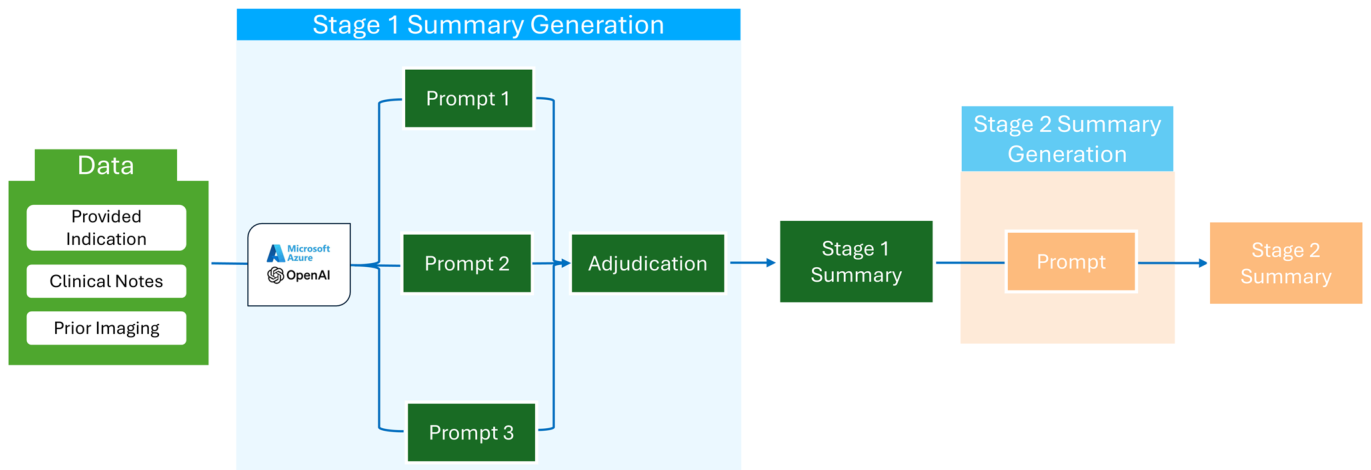
本研究では、放射線専門家にとって最適な診療歴要約形式を特定するため、LLMを用いた2段階の要約パイプラインの可読性、効率性、および専門家の好みを評価しました。救急外来(ED)、入院(IP)、外来(OP)の3つのケア環境と、X線(XR)、CT、MRの3つのモダリティにわたる90の画像診断ケースが分析されました。これらの症例から、ステージ1で構造化された時系列要約、ステージ2で簡潔なナラティブ要約が生成されました。
この研究は、HIPAAに準拠し、機関審査委員会の承認を得て、匿名化されたデータを使用した後向き研究として実施されました。
2段階要約プロセスとは?
この研究で用いられた2段階の要約プロセスは、Azure OpenAI GPT-4oモデルを基盤としています。まず、ステージ1では、関連する臨床記録と以前の画像診断報告書を統合し、構造化された時系列の要約を作成します。これには、臨床イベント、主訴、以前の検査結果、治療決定などが詳細に盛り込まれます。次に、ステージ2では、ステージ1で生成された要約をさらに凝縮し、迅速な確認に最適化された簡潔な単一パラグラフのナラティブ要約が作成されました。このアプローチは、網羅性と明示的な構成を重視するアプローチと、迅速な理解と情報負担の軽減を重視するアプローチの2つを比較することを意図しています。診療記録の抽出は、
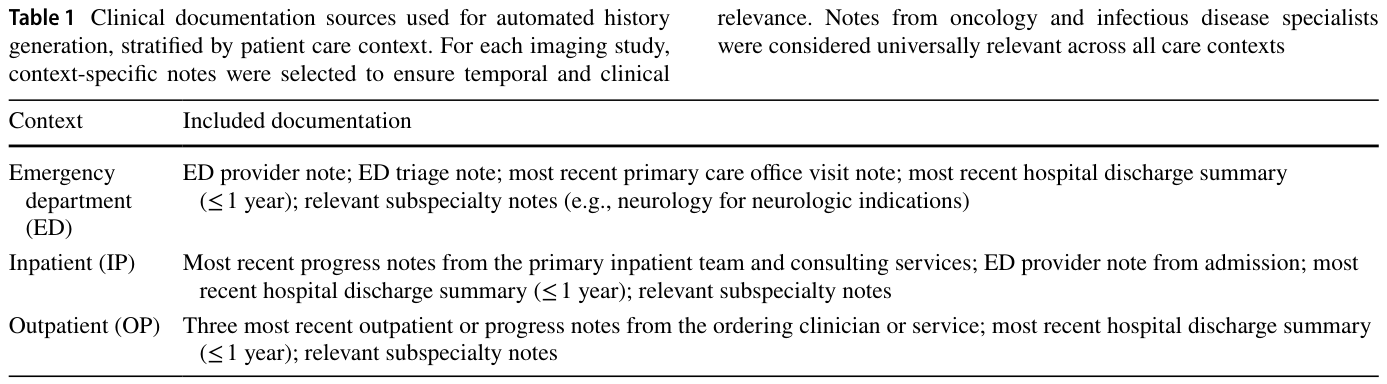
に示されるように、ケア環境に応じて系統的に行われました。また、分析された症例の分布は
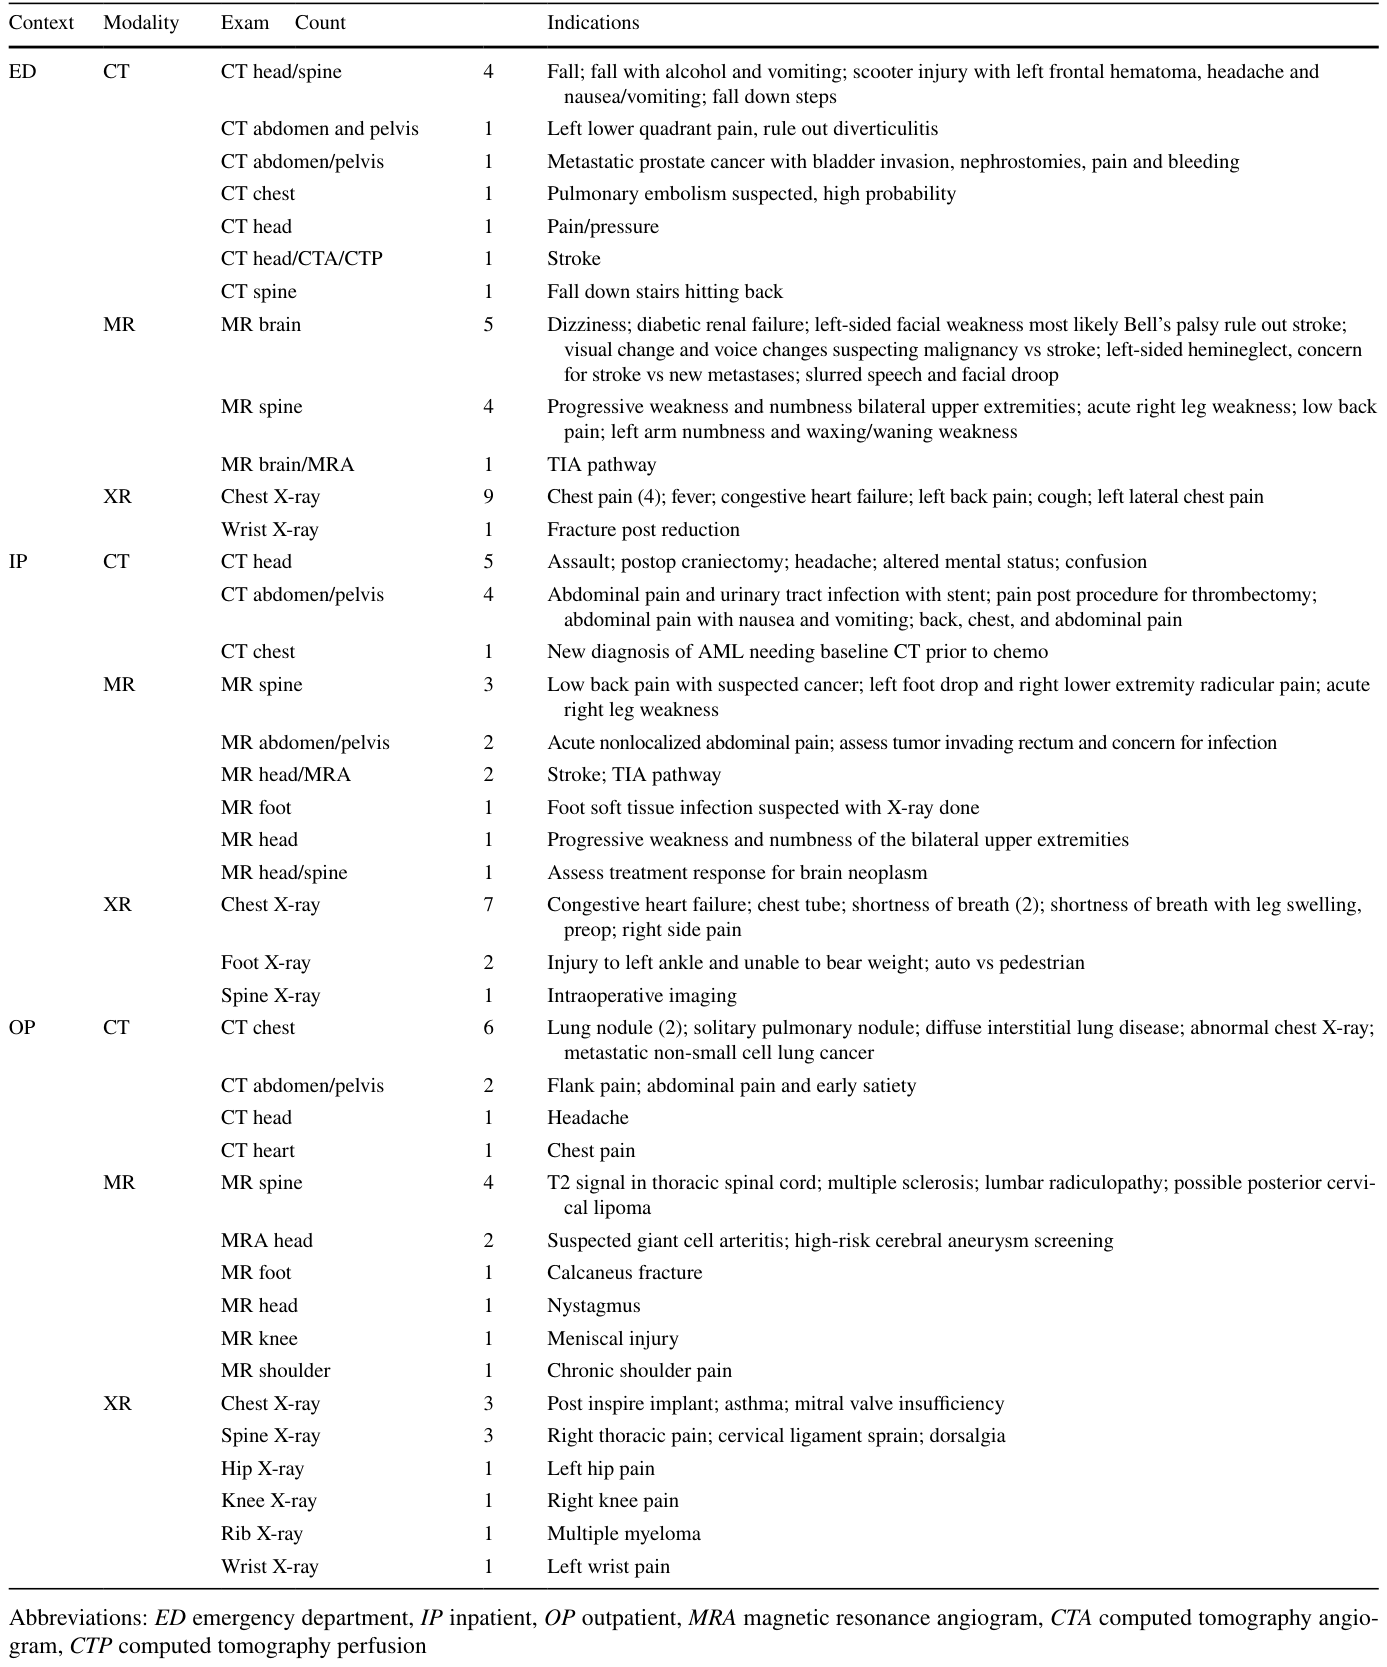
にまとめられています。
驚くべき要約効果と専門家の選好
LLMを用いた要約は、テキストの長さを劇的に削減しました。元の診療記録の平均テキスト長は2696.5語でしたが、ステージ1の要約では平均357.3語(約86.8%削減)、ステージ2の要約ではさらに短縮され平均130.1語(約95.2%削減)となりました。
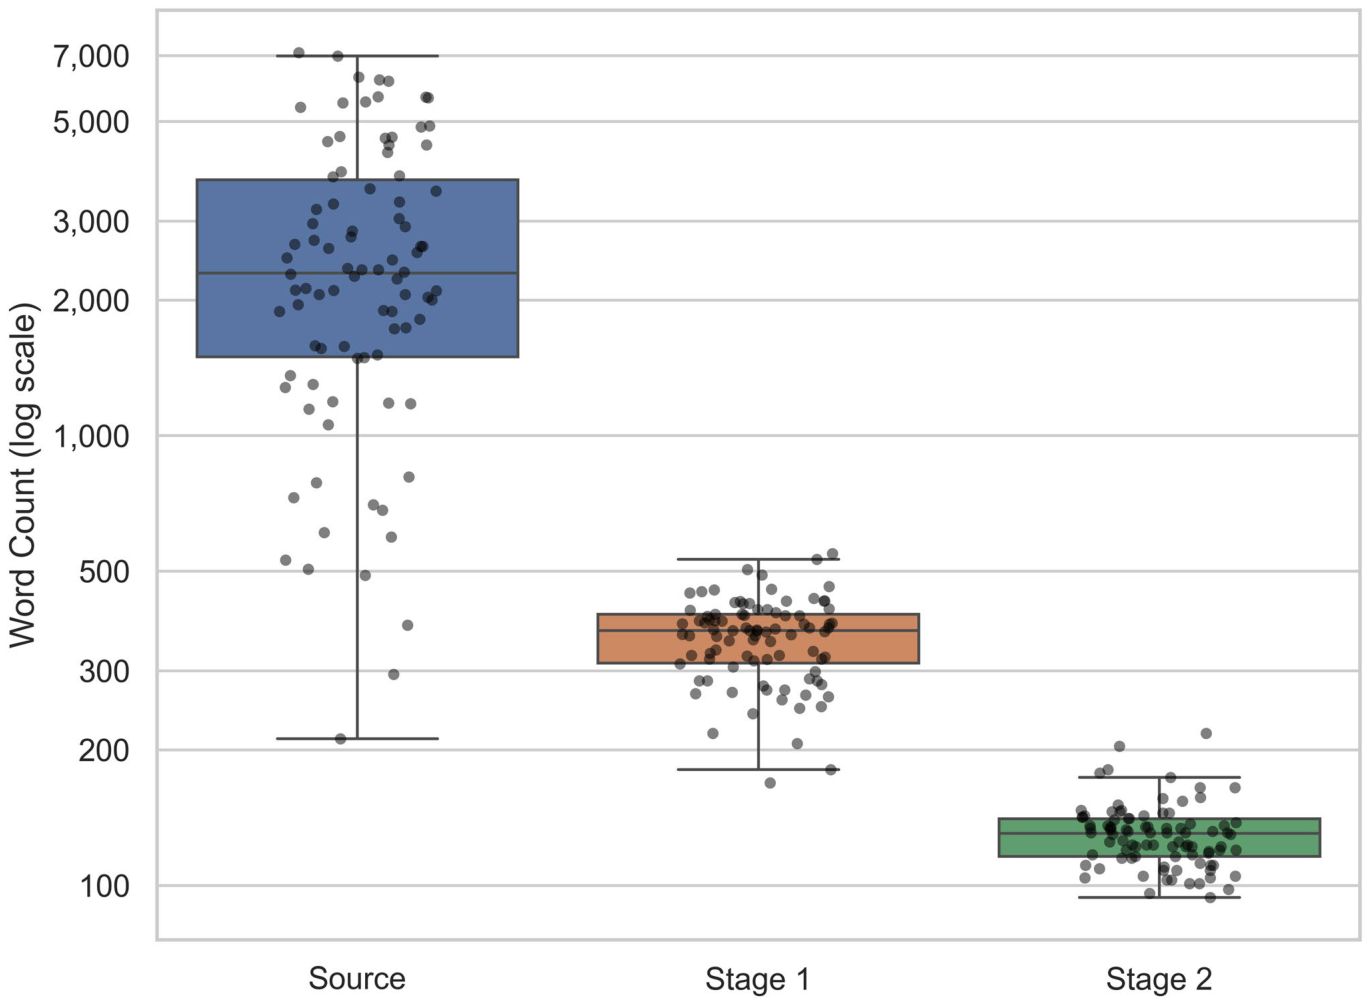
放射線専門家たちは、圧倒的に簡潔なステージ2の要約を好み、評価の89%で最も高い順位をつけました。ステージ1の要約は、どのケースでも最も良い選択肢とはされませんでした。ステージ2の要約は、明瞭さ、関連性、有用性においてステージ1の要約よりも有意に高く評価されましたが(p < 0.0001)、網羅性に関しては同等でした。
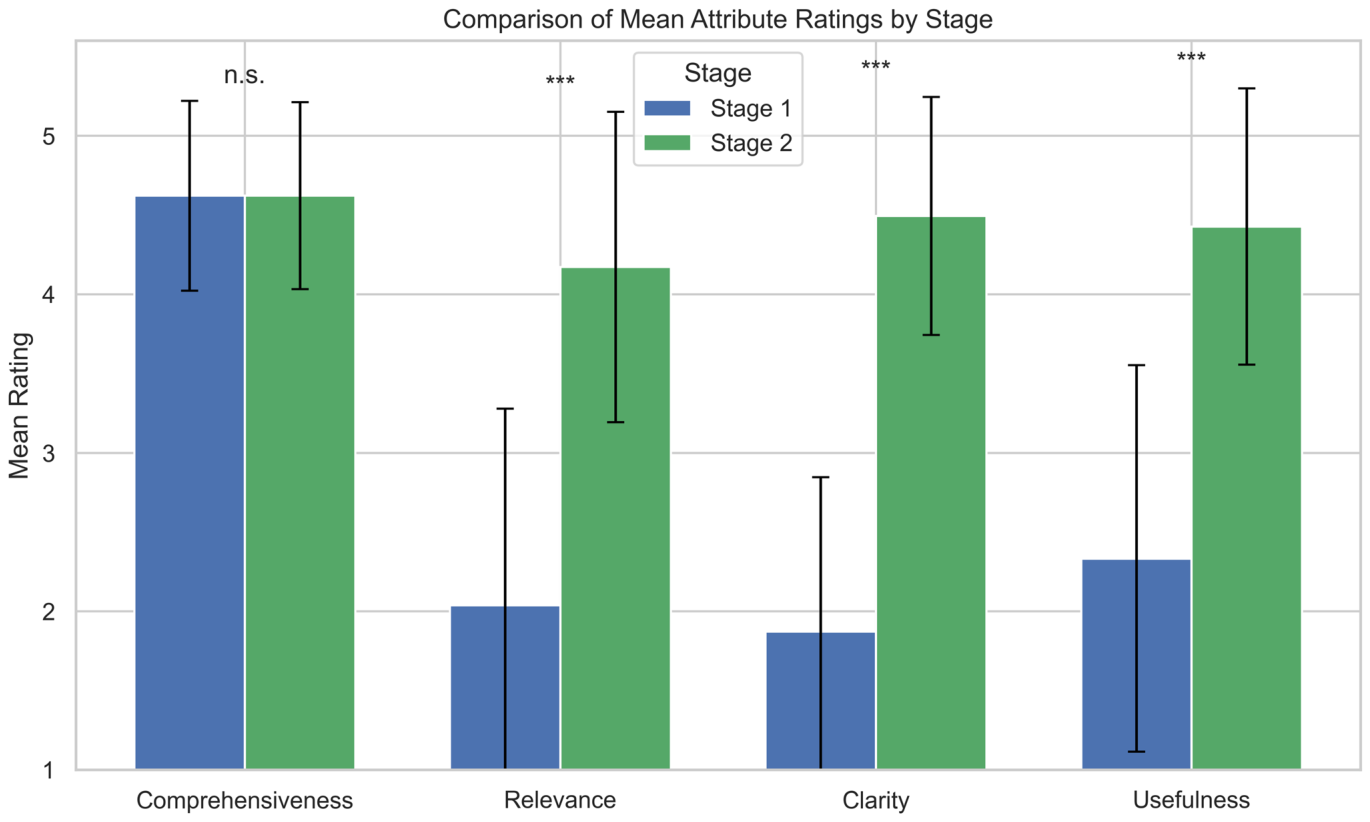
この結果は、要約形式、特に簡潔さが可読性と放射線専門家の好みを最適化するために重要であることを示しています。また、元の文書が長いほど、詳細なステージ1の要約の評価は低くなる傾向がありましたが、簡潔なステージ2の要約ではそのような関連性は見られませんでした。
可読性スコアが示す専門性の維持
興味深いことに、Flesch-Kincaid Grade LevelやSMOG Indexといった可読性スコアは、元のテキストと比較して要約テキストで上昇しました。これは、LLMが関連情報を抽出する際に、専門用語を維持し、情報密度が高い、より洗練された言語を使用していることを示唆しています。医療の文脈では、この可読性スコアの上昇は、情報の単純化ではなく、焦点を絞った洗練を意味すると解釈できます。
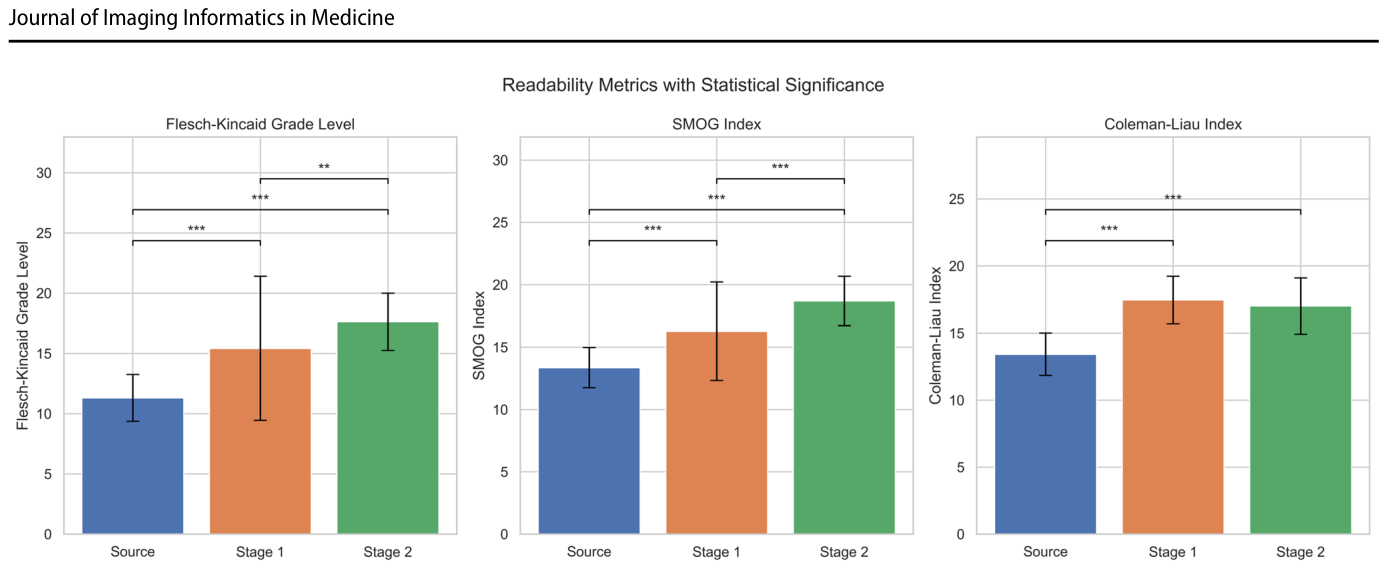
簡潔なナラティブ要約は、最も情報が豊富であり、放射線専門家によって好まれた形式でした。
「幻覚」問題への対応と評価
LLMの出力には「ハルシネーション(幻覚)」と呼ばれる、元の情報源にない事実が含まれるリスクがあります。本研究では、手動レビューにより90ケースで合計25件のハルシネーションが確認されました。そのうち20件は、元の文書からステージ1への要約生成時に発生し、5件はステージ1からステージ2への凝縮時に新たに発生しました。興味深いことに、ステージ1で導入された20件のハルシネーションのうち、12件はステージ2への凝縮プロセスで削除されました。結果として、最終的なステージ2の要約に含まれるハルシネーションは合計13件となり、ステージ1と比較して全体的なハルシネーションの負担が減少しました。
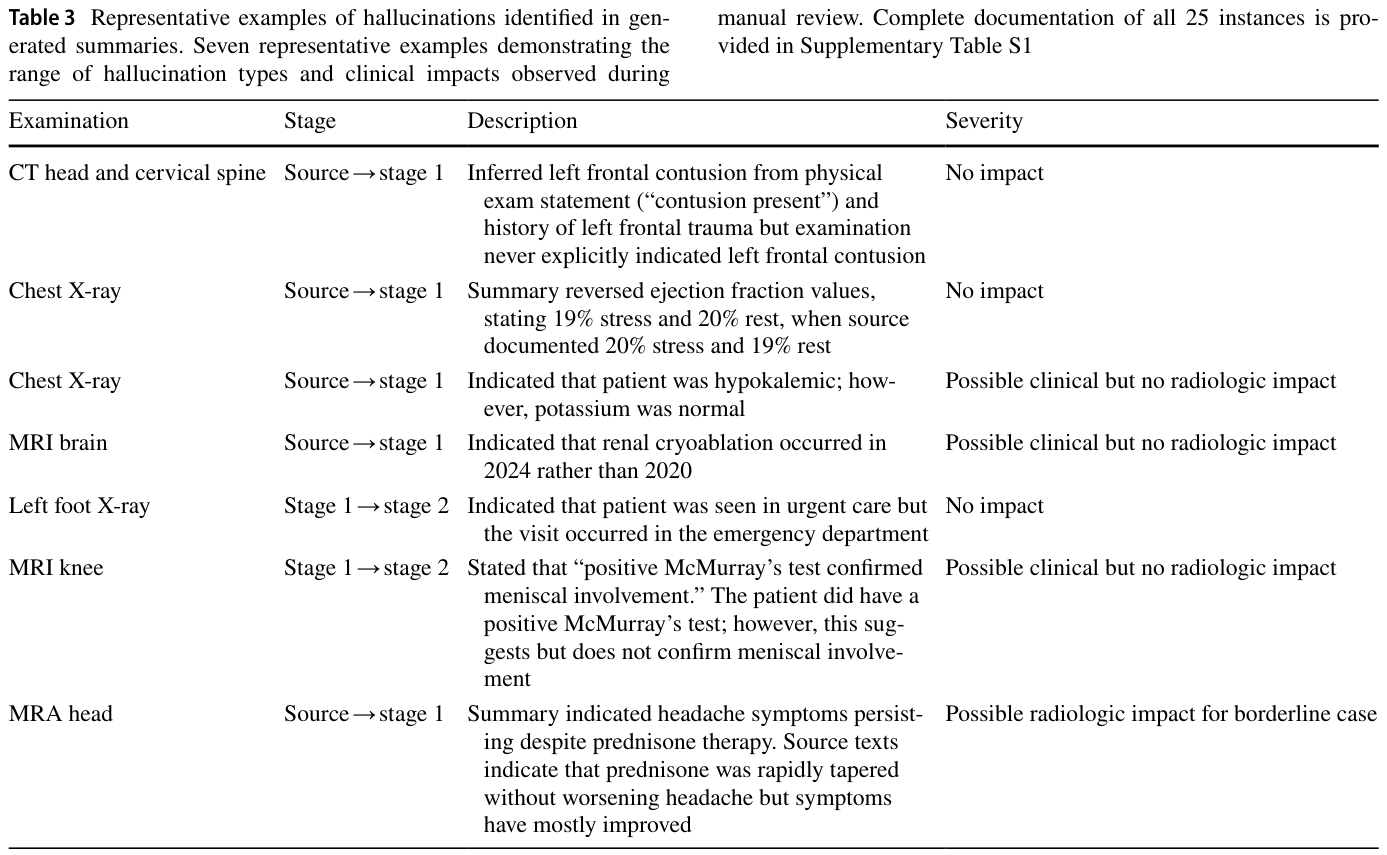
これらのハルシネーションの大部分(17件)は、臨床的または放射線診断への影響がないと判断されました。7件は臨床的理解や管理に影響を与える可能性はあるものの、画像診断の解釈には影響しないとされました。ただし、1件は、画像所見が境界線上の場合に、放射線診断の解釈を変える可能性のあるものと分類されました。このハルシネーションはステージ1で発生し、最終的なステージ2の要約には伝播しませんでした。ハルシネーションは主に日付の誤りや、関連するものの不完全な情報源からの裏付けのない推論として現れました。
研究の限界と今後の展望
本研究にはいくつかの限界があります。データセットは単一施設のものであり、症例数と評価専門家の数は限定的であるため、結果の一般化には注意が必要です。また、後向き研究であるため、実際のワークフロー効率や診断精度の向上を直接測定することはできませんでした。ハルシネーションのレビューは単一の放射線専門家による手動レビューであり、検出漏れや放射線診断上の重要性の評価に主観性が含まれる可能性があります。さらに、本研究では情報の欠落(errors of omission)ではなく、生成された情報の誤り(errors of commission)に焦点を当てています。今後の研究では、より大規模な多施設共同研究による前向き検証を行い、自動化された診療歴が診断時間、診断精度、放射線専門家の認知負荷に与える影響を評価する必要があります。また、Retrieval-Augmented Generation (RAG)のようなハルシネーション軽減戦略や、事実検証アルゴリズムの組み込み、出所のタグ付けなども重要となります。LLMの出力における「幻覚」は固有のリスクであるため、検出と検証のための構造化されたフレームワークの開発が不可欠です。
まとめ:簡潔さがもたらす未来
この研究は、LLMが生成する診療歴要約が、元の記録の長さを90%以上も削減しつつ、必要な臨床情報を維持できることを示しました。放射線専門家は、明瞭さ、関連性、使いやすさの点で、詳細な時系列バージョンよりも、凝縮された単一パラグラフのナラティブ要約を一貫して好むことが明らかになりました。ハルシネーションは存在しますが、このLLM固有のリスクに対する継続的な警戒は極めて重要です。これらの知見は、自動要約が放射線専門家による関連情報へのアクセスを改善する大きな可能性を秘めていることを強調しており、実世界での実践における前向きな多施設評価が期待されます。簡潔な情報提供が、多忙な医療現場における情報アクセシビリティと認知負荷の軽減に貢献する未来が、目の前まで来ているのかもしれません。
用語集
- 大規模言語モデル(LLM): 大量のテキストデータで学習し、人間のような自然言語を生成・理解できるAIモデル。
- ハルシネーション(幻覚): LLMが生成したテキストに、元の情報源に存在しない、誤った情報が含まれる現象。
- 後向き研究(レトロスペクティブ研究): 過去のデータを収集・分析する研究デザイン。特定の介入が行われた後にその結果を評価する際に用いられる。
- PICO: 臨床疑問を明確に構造化するためのフレームワーク。(P:対象者、I:介入、C:比較、O:結果)
- 認知負荷: 特定のタスクを処理するために脳が使う精神的労力の量。情報過多などで増加する。
- 抽象的要約: 元のテキストの内容を理解し、新しい言葉で要約文を生成する手法。要約されたテキストは元の文とは異なる表現になる。
- Flesch-Kincaid Grade Level: 英文の可読性(読みやすさ)を学年レベルで示す指標。数値が高いほど難易度が高い。
- SMOG Index: 英文の可読性を示す指標の一つで、3音節以上の単語数に基づいて学年レベルを算出する。
- Coleman-Liau Index: 英文の可読性を示す指標の一つで、単語あたりの文字数と文あたりの単語数に基づいて学年レベルを算出する。
- Wilcoxon signed-rank test: 対応のある2群間の順位に基づいたノンパラメトリックな差の検定方法。
- Gwet’s AC1: 複数の評価者間の一致度を測定する統計指標。高い一致度がある場合に信頼性が高いとされる。
- Retrieval-Augmented Generation(RAG): LLMが外部の情報源から関連情報を検索し、それを基にテキストを生成する手法。ハルシネーション対策に有効。
コメントを残す