
診断放射線学における生成AIと専門家(専門家)の診断精度比較:システマティックレビューとメタアナリシス
解説対象論文: Generative AI versus physicians in diagnostic radiology: a systematic review and meta-analysis
Japanese Journal of Radiology|被引用数: 0(2026年10月5日時点)
生成AIが放射線診断の分野で注目されていますが、その診断精度はどの程度なのでしょうか?本記事では、包括的なシステマティックレビューとメタアナリシスに基づき、生成AIの診断能力を専門家(専門家)と比較した最新の研究結果を解説します。
はじめに:放射線診断における生成AIの台頭
どうも、Beyond the Pixelです。生成AIが急速に医療分野、特に放射線診断タスクで活用が模索されています。診断の補助、鑑別診断の生成など、多くの可能性が指摘される一方で、その精度や評価方法には課題があります。研究デザインや評価指標が多様であるため、統一的な見解を得るのが難しいのが現状です。本論文は、これまでの研究を包括的に分析し、放射線診断における生成AIの診断精度を統合し、専門家である専門家のパフォーマンスと比較することを目的としたものです。
研究の概要:生成AIと専門家(専門家)の診断能力を徹底比較
厳格な手法で論文を収集・分析
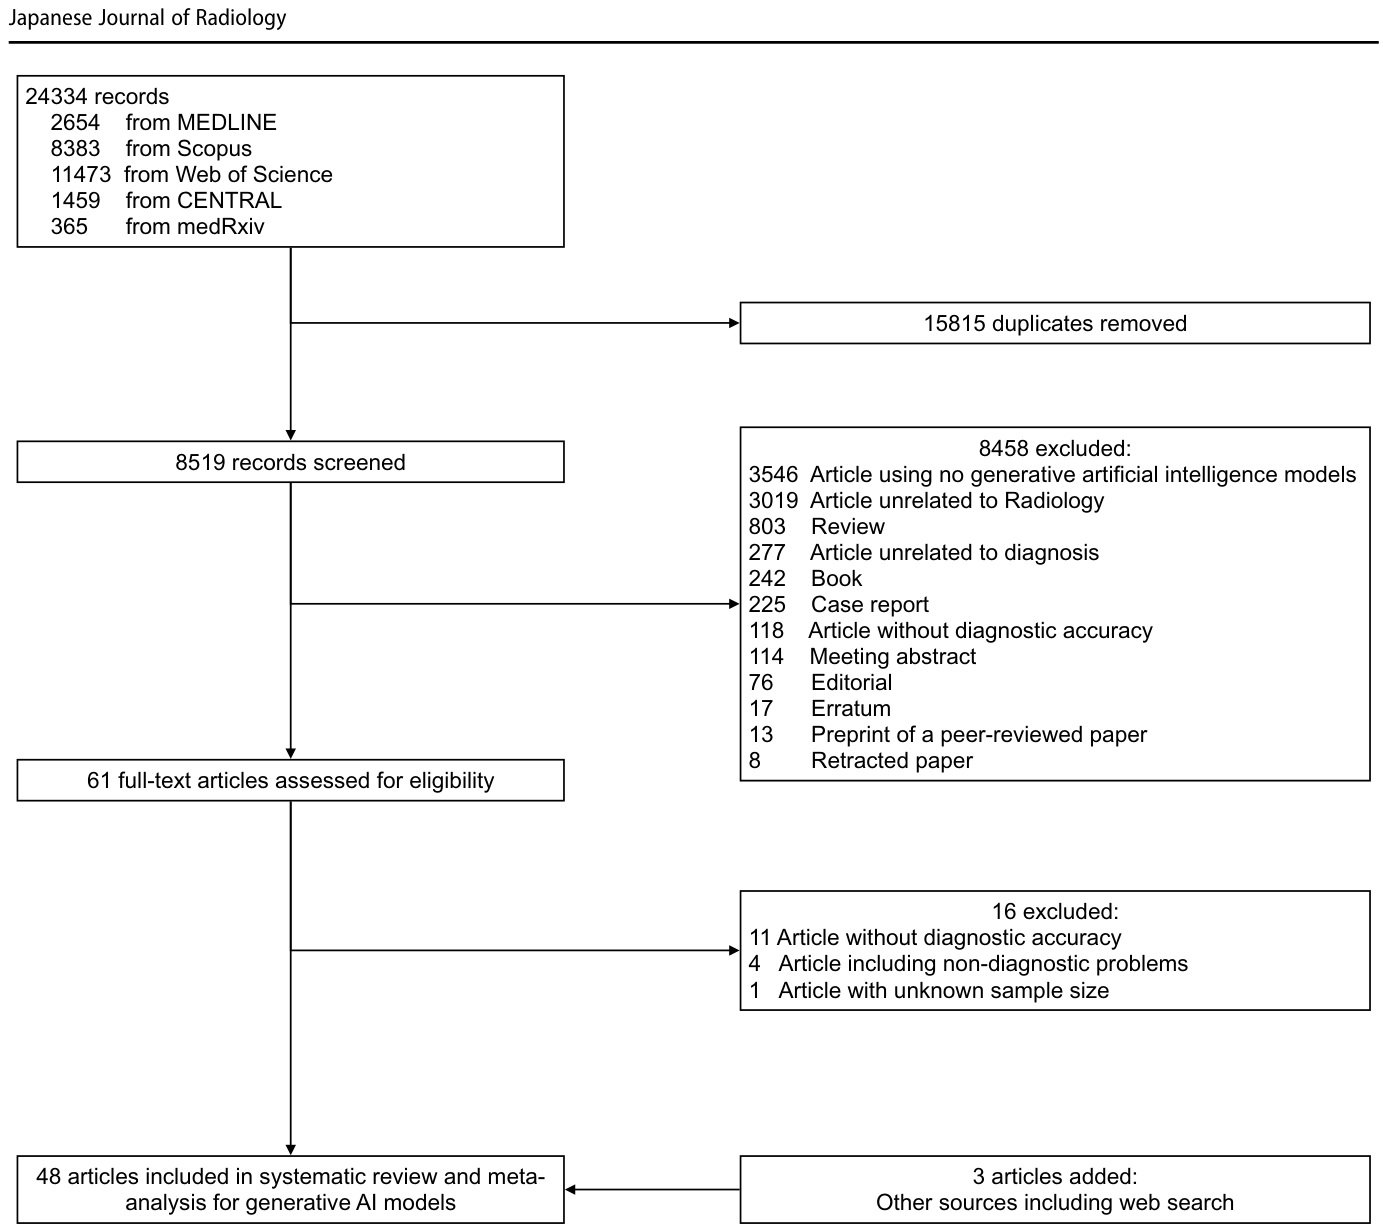
本研究は、PROSPEROに事前登録されたシステマティックレビューとメタアナリシスとして実施されました。PRISMA-DTAガイドラインに準拠し、Medline、Scopus、Web of Scienceなど複数のデータベースを検索し、2018年6月から2025年3月までに発表された放射線診断タスクにおける生成AIの妥当性評価研究を特定しました。合計24,334件の記録が特定され、重複を除いた8,519件がスクリーニングされました。最終的に、48件の研究がメタアナリシスの対象として含まれました。
データの抽出とバイアス評価は2名の査読者により独立して行われ、意見の相違は3人目の査読者によって解決されました。AIのパフォーマンスと専門家(専門家)のパフォーマンスを比較し、不均一性の原因を特定するために、多レベルランダム効果メタ回帰が実施されました。
生成AIの診断精度は専門家(専門家)に及ばず
全48件の研究を統合した結果、生成AIの診断精度は、自由記述形式のタスクで42.9%(95%信頼区間: 35.8–50.1%)、選択形式のタスクで58.1%(95%信頼区間: 50.0–66.2%)でした。専門家である専門家の診断精度は、自由記述形式で48.4%(95%信頼区間: 37.2–59.5%)、選択形式で70.8%(95%信頼区間: 61.8–79.9%)でした。生成AI全体の診断精度は、専門家である専門家と比較して有意に低いことが示されました(専門家(専門家)からAIを引いた精度差は+13.0パーセンテージポイント [95%信頼区間: 0.9–25.2]; P = .038)。ただし、専門家ではない専門家との間には有意な差は見られませんでした。GPT-4Vなどの特定のモデルでも、全体的な専門家(専門家)の診断精度より低い結果が示されました。診断タスクへの入力モダリティ(データの種類)を分析したところ、テキストのみの入力は、画像のみの入力(精度差は画像のみからテキストのみを引くと-25.9パーセンテージポイント [95%信頼区間: -39.1–-12.8]; P = .001)およびテキストと画像の両方の入力(精度差はテキストと画像の両方からテキストのみを引くと-10.6パーセンテージポイント [95%信頼区間: -20.8–-0.3]; P = .046)と比較して、より高い診断精度と関連していました。
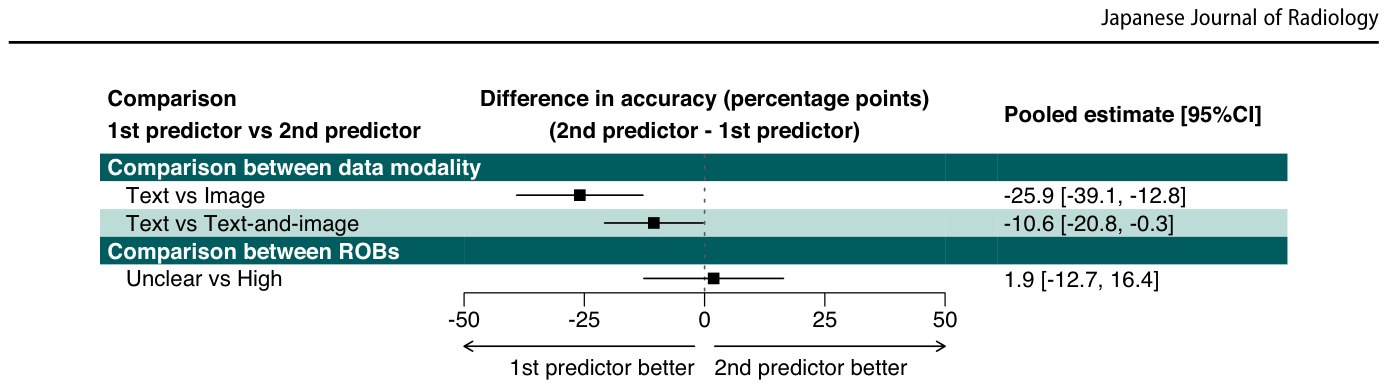
これは、よく構造化されたテキスト情報が、画像単体やテキスト・画像併用よりも、生成AIの診断精度向上に寄与する可能性を示唆しています。この関連性は、入力モダリティ自体よりも、タスクの難易度や情報内容を反映している可能性も指摘されています。
研究の質と評価されているAIモデル
本研究で評価された生成AIモデルには、GPT-4、GPT-4V、GPT-4o、GPT-3.5、Claude 3.5 Sonnet、Claude 3 Opus、Gemini 1.5 Proなどが含まれており、GPT-4が最も頻繁に評価されていました。専門分野は一般放射線学が最も多く、次いで神経放射線学、胸部放射線学、骨格放射線学などが続きました。モデルのタスクとしては、自由記述形式が優勢でした。
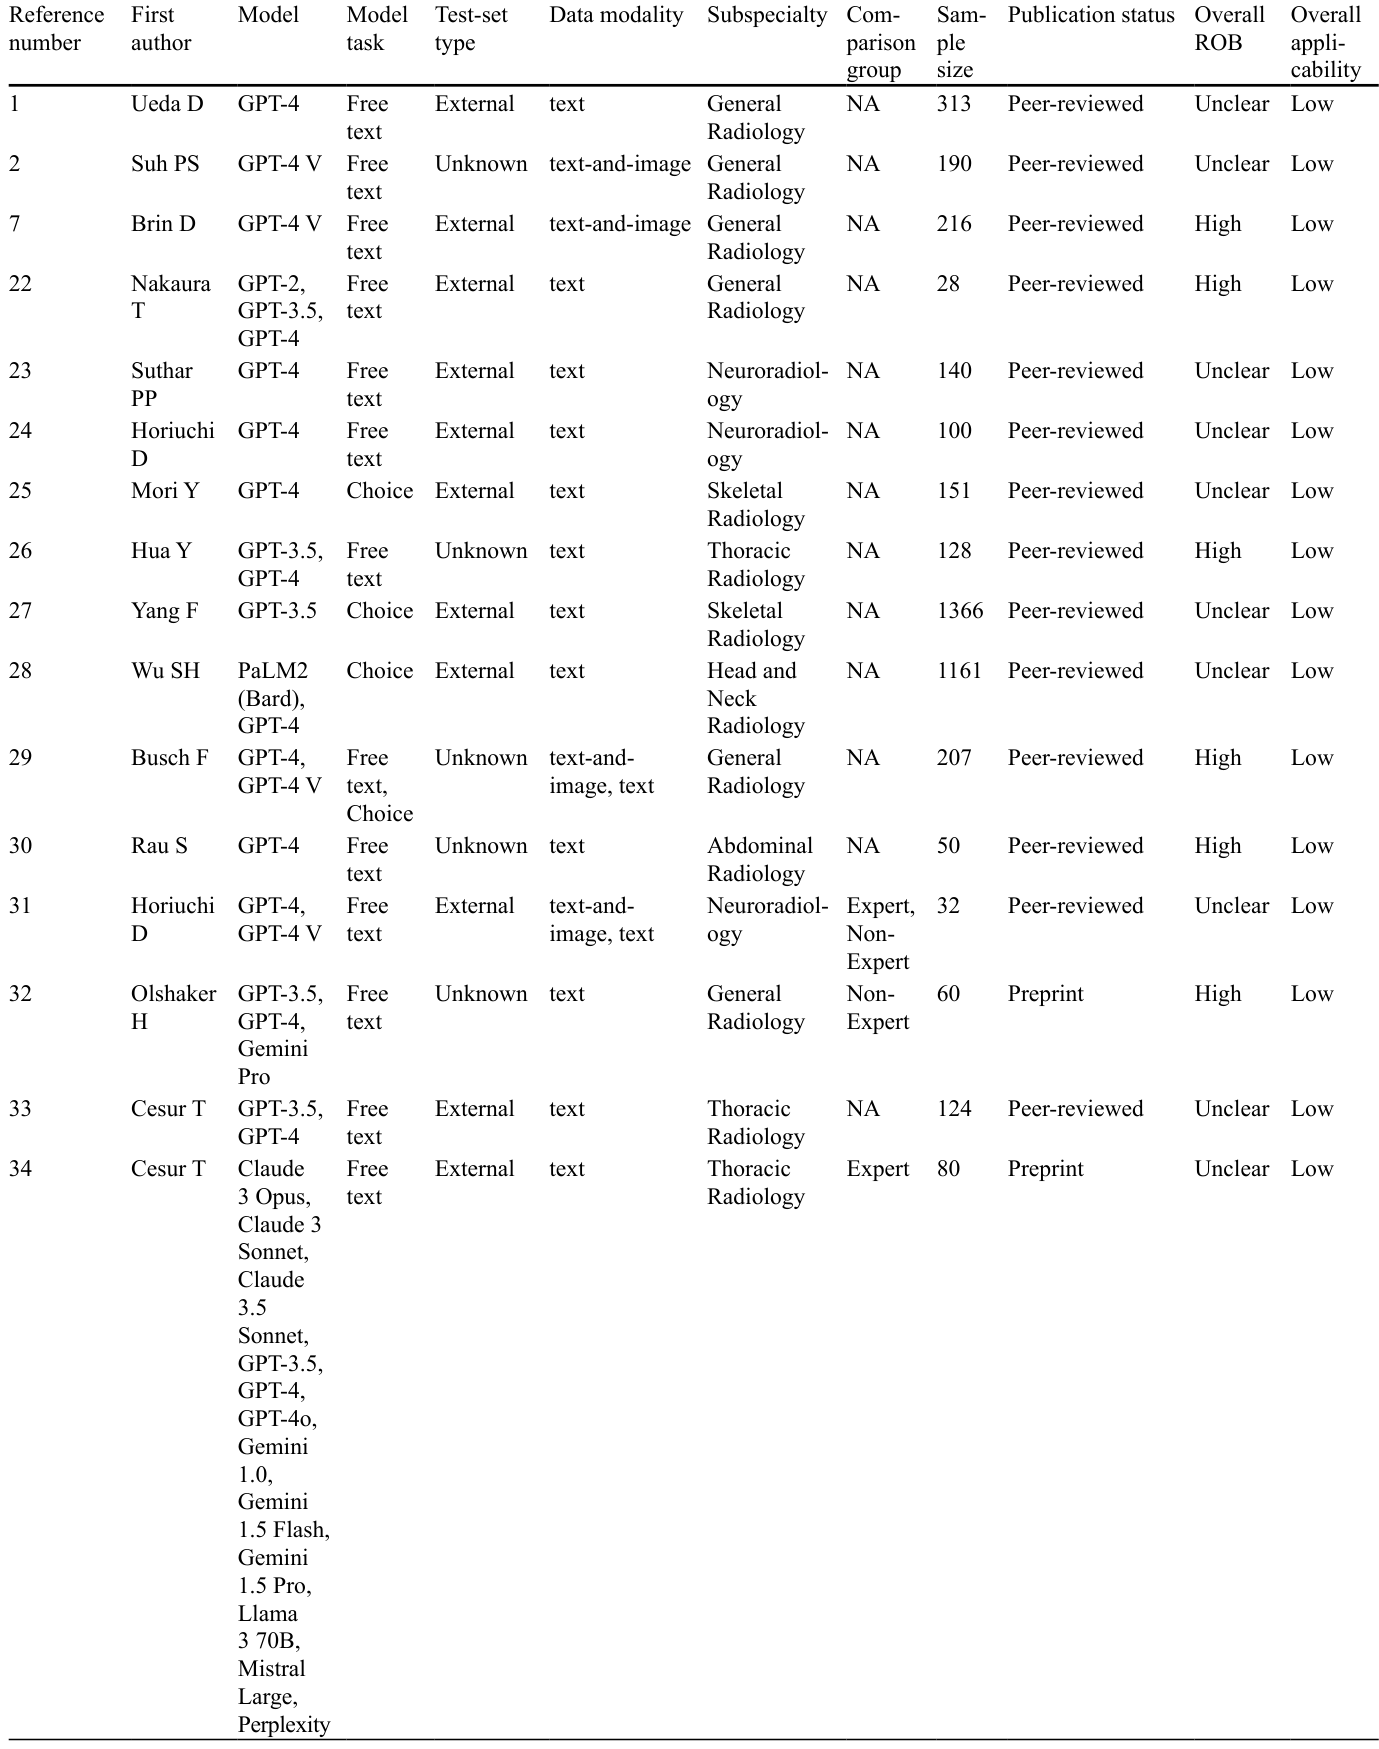
研究の質の評価(PROBAST+AIツールを使用)では、48件の研究のうち13件(27%)が高いバイアスリスク、34件(71%)が不明瞭なリスク、1件(2%)が低いリスクと評価されました。
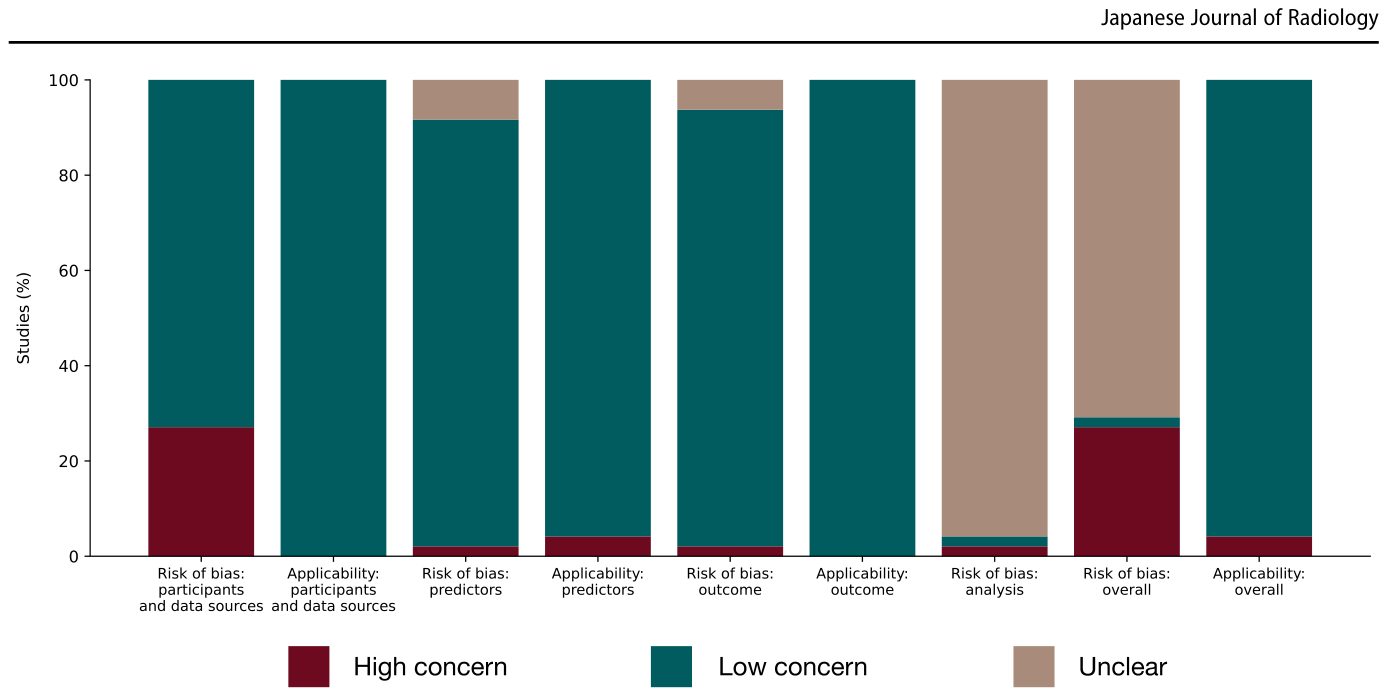
主な不明瞭なリスク要因は、事前のサンプルサイズ計算がなされていなかったことでした。これは、予測モデルの研究においてしばしば見られる課題であり、楽観的な精度評価や汎化能力の限界につながる可能性があります。
考察:生成AIの役割と今後の課題
本メタアナリシスは、放射線診断における生成AIモデルの能力と限界を明らかにしました。全体として、生成AIは専門家である専門家よりも診断精度が低いものの、専門家ではない専門家との比較では有意な差は認められませんでした。この結果は、生成AIが診断の初期段階でのトリアージや、専門家が不足する時間帯の補助、あるいは鑑別診断の生成支援といった補助的なツールとしての活用に焦点を当てるべきであることを示唆しています。入力モダリティに関する分析は、マルチモーダル生成AIモデルの臨床導入に対する実用的な指針を提供します。テキストのみの入力が画像のみまたはテキストと画像の両方の入力よりも高い診断精度と関連しているという発見は、構造化された詳細な画像所見や臨床的背景をテキストとして提供することの重要性を示しています。これは、画像そのものを追加するよりも、テキスト情報がAIの診断精度に大きく貢献する可能性を示唆しています。将来的には、大規模な医療画像コレクションで訓練され、適応されたビジョン・言語基盤モデルや、標準化されたテキスト指向の入力構造化によって、さらなる精度向上が期待されます。しかし、生成AIの評価における方法論的厳格さは依然として重要な課題です。多くの研究がバイアスリスクが高いか不明瞭と判断されたことは、この分野における今後の研究がSTARD-AIやTRIPOD-LLMといったガイドラインに準拠し、評価セットのサンプルサイズを正当化し、外部の複数施設でのテストセットを使用し、プロンプトや推論設定を透明に報告する必要があることを強調しています。これらの課題に対処することで、放射線科における生成AIの安全で効果的な統合をサポートする、より信頼性の高いエビデンスが構築されるでしょう。
用語集
- 生成AI: 大量のデータから新しいテキストや画像を生成できる人工知能モデル。
- システマティックレビュー: 特定の問いに対し、関連する研究を網羅的に収集・評価し、統合する研究手法。
- メタアナリシス: 複数の独立した研究結果を統計的に統合し、より信頼性の高い結論を導き出す分析手法。
- PROSPERO: システマティックレビューのプロトコルを事前に登録する国際的なデータベース。
- PRISMA-DTAガイドライン: 診断テスト精度に関するシステマティックレビューとメタアナリシスの報告を標準化するための指針。
- PROBAST+AI: 予測モデル(AIを含む)のバイアスリスクと適用可能性を評価するためのツール。
- 入力モダリティ: AIモデルに与えられるデータの形式(例: テキストのみ、画像のみ、テキストと画像)。
- 自由記述形式タスク: AIが診断結果をテキストで自由に記述する形式のタスク。
- 選択形式タスク: AIが与えられた選択肢の中から診断結果を選ぶ形式のタスク。
コメントを残す