
前立腺MRIにおけるAIの性能過大評価を防ぐには?研究の質を見抜く視点
解説対象論文: Critical appraisal of artificial intelligence studies for prostate cancer detection on MRI
European Radiology|被引用数: 0(2026年10月9日時点)
人工知能(AI)は、前立腺MRIによる臨床的に重要な前立腺がん(csPCa)の検出において、活発な研究分野です。しかし、発表されている多くの研究には方法論的な欠陥があり、その信頼性や臨床への応用可能性が損なわれる可能性があります。この記事では、前立腺MRIにおけるAI研究の体系的な評価について、主要な6つの評価領域を中心に解説します。
はじめに:AIと前立腺がん検出の進展
どうも、Beyond the Pixelです。人工知能(AI)は、前立腺MRIを用いた臨床的に重要な前立腺がん(csPCa)の検出において、非常に活発な研究分野となっています。過去10年間で、前立腺がん検出を目的としたAI研究の数は著しく増加しました。初期の畳み込みニューラルネットワークからTransformerベースの自己教師あり学習モデルに至るまで、報告される性能は向上傾向にあり、最新の論文では受信者動作特性曲線下面積(AUC)が理論上の最大値である1.0に近づくか、到達する例も見られます。これらの研究は、かなりの規模と努力を反映していますが、研究環境で「ほぼ完璧」な性能を示す指標は、慎重な文脈化が必要です。これらの結果を裏付ける方法は、臨床実践への応用可能性を外挿する前に、体系的な精査を必要とします。このニーズを認識し、PI-RADS(Prostate Imaging Reporting and Data System)運営委員会は、生検を受けていない男性におけるMRIに基づくcsPCa検出のためのAI開発と報告に関する正式な要件を最近発表しました。これは、参照ゴールデンスタンダード、コホート構築、性能ベンチマーク、および報告の透明性に関する最低限の基準を定義し、発表された研究を評価するための標準化されたチェックリストを提供します。この観点からの報告は、前立腺MRIにおけるAI研究の体系的な批判的評価を提供し、6つの評価領域にわたって構成されています。私たちの分析は、見かけ上ほぼ完璧な性能が、技術的進歩よりも、特定可能で予防可能な研究デザインの選択から生じる可能性があることを示唆しています。
AI研究の信頼性を評価する6つの領域
前立腺MRIにおけるAI研究の質、信頼性、および臨床への準備状況を専門家、査読者、研究者がどのように判断すべきか、6つの評価領域について詳しく見ていきましょう。
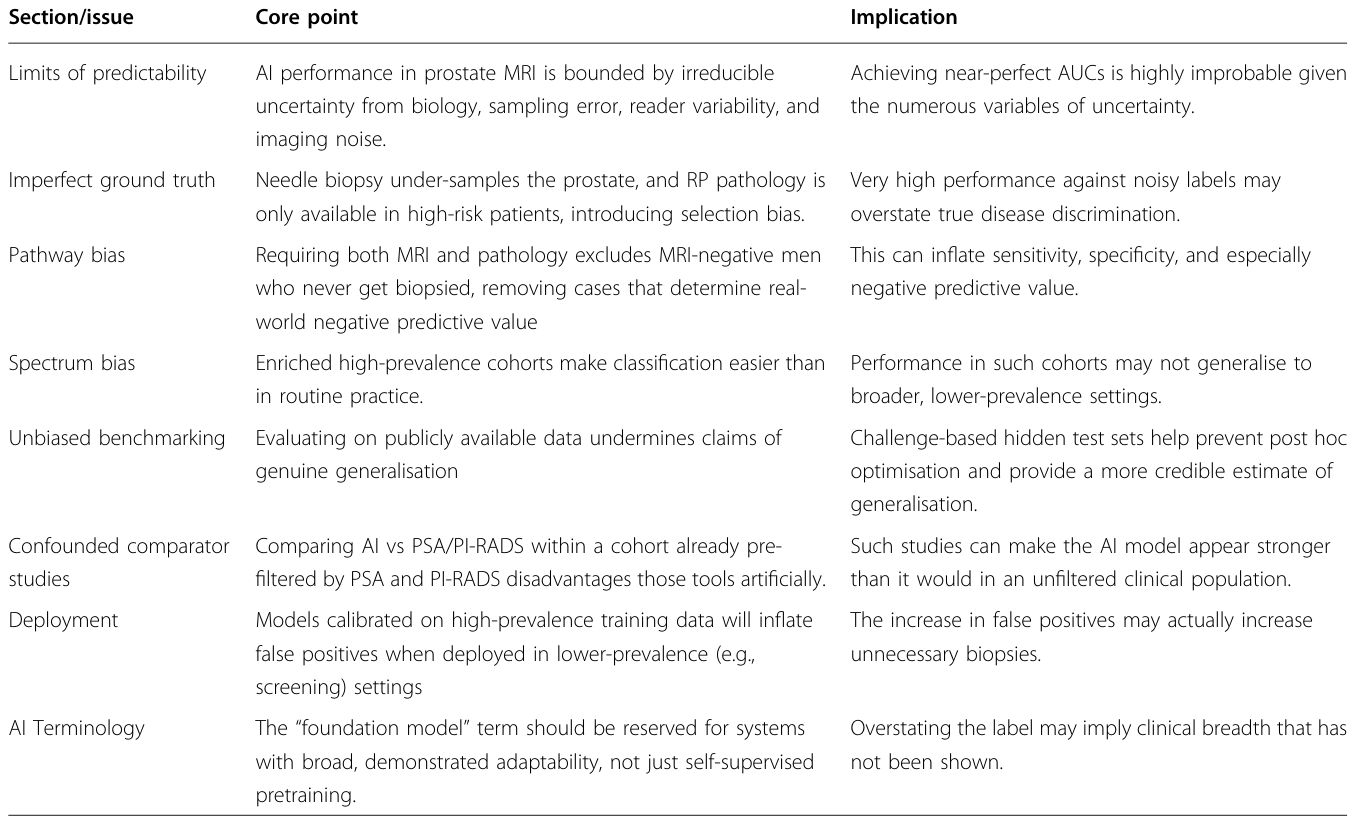
この表は、AI研究における主要な方法論的問題を要約しています。中心的な懸念事項と、それらが解釈、ベンチマーク、臨床応用にもたらす実際的な影響が記載されています。
1. 予測可能性の限界
機械学習研究には、「進歩の幻想」という傾向が見られます。これは、標準化されたベンチマークで最先端の性能をわずかに上回るインセンティブが、現実世界では応用できない限界的な性能向上しかもたらさないというものです。前立腺MRIにおけるAIの性能は、生物学的な腫瘍の多様性、針生検に固有の空間的なサンプリング誤差、MRI読影と病理学的グレード分類における専門家間のばらつき、およびMRI取得における有限な信号対ノイズ比といった、還元不可能な不確実性によって制約されます。これらの要因は合わせて、理想的なモデルが最高のデータで動作したとしても、1.0を大幅に下回る実効的な性能上限を定義します。したがって、報告されたAUC値が1.0に近づくことは、臨床診断における還元不可能な不確実性を排除した技術的進歩としてではなく、対象集団、エンドポイントの定義、コホート選択、および参照ゴールデンスタンダードの質との関連で解釈されるべきです。
2. ゴールデンスタンダードの質
「不完全なゴールデンスタンダード」の問題は、AIモデルの性能評価に大きな影響を与えます。針生検は前立腺容積の一部しか採取せず、ターゲティング誤差の影響を受けやすく、前立腺前方や先端の病変を体系的に見逃す傾向があります。その結果、偽陰性やグレード分類の不正確さが生じます。全摘標本病理はより完全ですが、手術を受けた対象者でしか得られず、高リスク疾患への選択バイアスが導入されます。このような不完全なゴールデンスタンダードを基準とした場合、たとえ完璧な分類器であっても、測定された精度は1.0を下回る可能性があります。生検と全摘標本の病理学的グレード不一致はよく報告されており、MRIターゲット生検の時代においても臨床的に重要です。例えば、あるテストセットでは、モデルがcsPCaを特定するタスクで生検由来のラベルに対してAUC 0.999を報告しましたが、全摘標本が利用可能だった場合の生検と全摘標本間のグレード一致は48.1%でした。この文脈において、報告されたほぼ完璧なAUCは慎重に解釈する必要があります。PI-RADS委員会は、性能推定の妥当性を強化するために、2つの異なる確認経路を推奨しています。陽性症例では、指標MRIから6ヶ月以内に組織サンプリング(ターゲット、系統的+ターゲット、または全摘術)を行うことが理想的です。PI-RADSスコアが3未満で生検に進まない陰性症例については、遅延病理学的サンプリングまたは2年間の陰性(PI-RADS < 3)フォローアップMRIによる確認が推奨されます。この検証がない場合、MRIで検出されず生検も行われなかったMRI非可視症例は、デフォルトで真の陰性と仮定されますが、この仮定は常に正しいとは限りません。
3. コホート設計と対象集団の選択
研究対象となるコホートの設計と対象集団の選択は、AIモデルの評価結果に大きく影響します。
経路バイアス
特定のバイアスは、臨床診断経路そのものによって導入されます。前立腺がんの文脈では、MRI陰性の男性は生検を免れ、病理学的評価はMRIで疑わしいとされた対象者においてのみ行われます。mpMRIと病理学的評価の両方を対象者要件とすることは、生検を受けないMRI陰性の対象者をほとんど除外してしまいます。これは、実世界の負の予測値やスクリーニング性能を決定する症例を体系的に取り除くことになります。
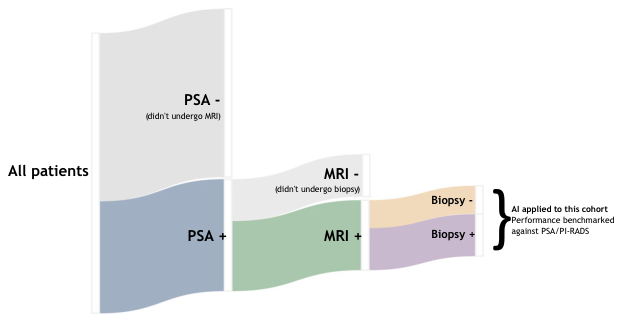
この図は、前立腺がんの臨床診断経路を示しています。PSA検査でスクリーニングされた対象者がMRI検査を受け、MRI所見(PI-RADSスコア)が生検の必要性を判断します。このシーケンシャルな構造が、病理学的確認が必要な検証データセットに経路バイアスを生じさせることを説明しています。その結果、有病率が膨らみ、分類の分離可能性が高まる可能性があります。生検がMRI陰性症例で回避される場合、検証バイアスと確認バイアスが導入されるため、報告された精度は研究内での比較に最もよく解釈され、実世界の負の予測値を確立するものではありません。
スペクトラムバイアス
スペクトラムバイアスは、対象集団の疾患重症度が極端に偏ることで、AI手法の診断性能指標を過大評価させ、実世界の臨床環境への一般化可能性を低下させる可能性があります。現代のMRI情報に基づくスクリーニングでは、臨床的に前立腺がんが疑われる男性におけるcsPCaの有病率は約27~38%と報告されています。しかし、一部の研究では、csPCaの有病率が62.5%という非常に高い数値が報告されており、これはスクリーニングのようなコホートではなく、非常に有病率の高い、病理学的に確認された集団であることを示しています。このような集団で訓練・検証されたモデルを一般的な臨床集団に適用することは容易ではなく、不必要な生検を増加させる可能性があります。PI-RADS委員会は、AI研究におけるがん有病率(csPCa症例数/全対象者数)の明示的な報告を推奨しています。また、期待されるがん検出率のベンチマークとして、PI-RADSスコアが3以上の場合は32~58%、4以上の場合は40~70%を対象者レベルで定めています。もし検証コホートがこの範囲をはるかに超える検出率を報告している場合、そのコホートは意図された臨床集団と比較して偏りが大きい可能性があり、報告された性能数値は臨床的期待に応じて下方修正されるべきです。
4. ベンチマークと比較の妥当性
公平なベンチマークは、後付けの最適化を防ぐ必要があります。PI-CAIチャレンジでは、隠しテストセットを通じてこれを実現しています。これは、チャレンジ主催者によって厳密に管理され、参加チームには一切公開されないデータセットです。研究者はアルゴリズムをプラットフォームに提出して性能指標を受け取ることができますが、テストデータやラベルに直接アクセスすることはできません。しかし、最近の注目度の高い研究の中には、この保護策を異なる方法で回避しているものがあります。公開されているPI-CAIトレーニングデータのサブセットで評価を行ったり、公開されている全1,500ケースをモデルのトレーニング/検証に組み込み、隠しテストのAUC 0.91を性能比較のベンチマークとして引用するものの、隠しテストセット自体では評価を行わないといった例が見られます。公開ケースは研究コミュニティ全体でオープンにアクセス可能であるため、それらに対する評価は、未知の対象者への真の一般化を確立するものではありません。
交絡した比較研究
AI研究では、PSA検査やPI-RADSスコアのようなより広範な臨床スクリーニングツールとモデル性能を比較することが頻繁に行われます。これらは表面上は有益ですが、診断経路の連続的な構造によって交絡されています。臨床実践では、まずPSA検査がMRI検査の対象者を選定するために使用され、次にPI-RADSスコアリングが生検の対象者を選定するために適用されます。したがって、mpMRIと病理学的評価の両方を要求する研究コホートは、すでにPSAとPI-RADSの両方によってフィルタリングされています。結果として、比較は高度に事前選択されたMRI陽性グループ内で行われます。これは、PSAとPI-RADSが最も効果を発揮しにくいと予想される集団であり、容易に陰性と判断できるケースはすでに除外されています。これらの結果は、新しいモデルが真の集団レベルのスクリーニングツールとしてPSAやPI-RADSを独立して上回ることを示唆するものとして外挿すべきではありません。利用可能なエビデンスは、モデルが訓練および評価されたフィルタリングされた集団(PSAおよびPI-RADSによってすでに生検候補として選択された男性)内での性能を支持しています。
5. 臨床導入
運用ポイントの選択と有病率の変化は、AIモデルの臨床導入において重要な課題です。出力スコアの分布はトレーニングデータの有病率に従うため、スクリーニング設定(csPCa有病率約27%)に再調整なしで直接導入すると、偽陽性率が上昇し、不必要な生検が増加する可能性があります。このようなモデルを低有病率の設定に直接導入するには、慎重な再調整と前向きな閾値調整が必要です。これらの調整は実行可能であり、対象コホートにおける臨床的有用性を維持しながら、偽陽性と不必要な生検を減らすことができます。この有病率の変化は、分類閾値(運用ポイント)と専門家へ伝えられる予測確率の両方に影響します。対象有病率に合わせて調整する再調整方法は確立されており、少量の展開対象集団データのみで十分です。これらの適用は安全な臨床使用の前提条件であり、事前に指定された閾値を用いて前向き検証を行うべきです。
前向き検証の重要性
PI-RADS委員会は、AIの臨床的有用性を実証するための推奨される標準として、前向きな多施設臨床ワークフロー研究を挙げています。大規模なサンプルサイズと複数の外部テストセットを持つ後ろ向きの横断研究であっても、日常的な臨床ワークフローにおける前向き評価の代わりにはなりえません。後ろ向き研究は、データの取得、品質フィルタリング、アノテーションにおいて選択バイアスの影響を受けやすく、AIシステムと臨床的意思決定の間の相互作用(実世界の有用性を決定する要因)を捉えることができません。一部の研究では前向きコホートも含まれていますが、これらも高有病率の環境を反映しており、評価の独立性には限界がある場合があります。
6. AI用語の適切な使用
「ファウンデーションモデル」という用語は、医療AIの分野で注目されていますが、特定の定義的意味合いを伴います。現在の定義では、ファウンデーションモデルは広範なデータ(通常は大規模な自己教師あり学習)で訓練され、多様な下流タスクに適応可能であると説明されており、単一のドメインやタスクファミリーを超えた規模と汎用性が強調されています。大規模言語モデルやビジョンファウンデーションモデルがこのパラダイムの典型であり、事前学習タスクから大きく離れたドメイン間での転移可能性を示しています。自己教師あり学習はファウンデーションモデルで一般的ですが、それが単独でこのラベルを正当化するのに必要十分ではありません。事前学習データが狭く、その有用性が単一ドメイン内の少数の密接に関連するタスクに限定される場合、多くの自己教師ありモデルはファウンデーションモデルとは見なされません。臨床的に重要な集団を除外する基準に基づいて訓練され、評価されたエンドポイントがすべて病理学的分類タスクである場合、それはファウンデーションモデルと見なすべきでしょうか。他のタスク(例:病変検出/セグメンテーション、縦断的リスクモデリング、治療反応予測)への転移の証拠がなく、他のドメインにおける現在のファウンデーションモデルの用語使用と一致する幅広い適応性が実証されていない場合、保守的な説明は「[タスク]のための自己教師あり事前学習戦略」とするべきです。「ファウンデーションモデル」という用語は、広範で異質なデータで訓練され、複数のコホートでクロス・タスク適応性が実証されたシステムのために残しておくべきです。この枠組みは、報告されたエビデンスベースと期待を一致させ、現在のトレーニング規模とコホート選択が裏付けていないスクリーニングへの準備状況や集団全体への汎用性を暗示することを避けます。PI-RADS委員会は、意図された用途と範囲を明確に定義することを要求しており、意図された集団とタスクを明示的に指定し、性能の主張は検証されたユースケースに限定されなければならないと述べています。用語がモデルのデモンストレーションされた能力を過度に表現すると、臨床的期待を過大に膨らませるリスクがあります。システムが広く検証されたファウンデーションモデルと認識されると、意思決定者が元の包含/除外基準が適用されない一般的な臨床集団でそれを導入する可能性があります。このような集団のミスマッチは性能を低下させ、対象者の安全とAI導入に直接的な影響を及ぼす可能性があります。したがって、正確な用語の使用は、時期尚早な臨床導入を防ぐのに役立ちます。
結論と今後の展望
本報告書で述べられた方法論的懸念事項(不完全なゴールデンスタンダード、経路バイアスとスペクトラムバイアス、交絡した比較、キャリブレーションのミスマッチ、および用語の過大表現)は、特定の研究に固有のものではありません。これらは、医療画像AI文献、特に前立腺MRI研究におけるAIにおいて認識されるパターンを表しています。ここで概説され、PI-RADS委員会フレームワークによっても示された基準を満たす研究は、臨床応用にとって信頼できる根拠となります。そうでないものは、予備的なエビデンスとして解釈されるべきです。今後は、単一施設内での新しいモデルの反復的な後ろ向き評価から、大規模な前向き多施設共同研究へと研究の焦点を移すべきです。これらの技術が成熟するにつれて、その範囲は初期検出を超えて、積極的監視、治療反応評価、および病期分類を含むように拡大する必要があります。臨床的有用性を向上させるには、モデルが失敗する条件やエッジケースを体系的に特定することも必要です。前立腺MRIにおけるAIの価値は、キュレーションされたデータセットでの性能によってではなく、日常的な臨床集団における診断精度によって決定されます。これを達成するためには、ここで概説したような透明性のある報告、前向き検証、および批判的な評価が不可欠です。
用語集
- AI (人工知能): コンピュータが人間のように学習・推論・判断を行う技術。
- MRI (磁気共鳴画像法): 磁場と電波を利用して体内の詳細な画像を生成する検査。
- csPCa (臨床的に重要な前立腺がん): 治療が必要とされる可能性のある、悪性度の高い前立腺がん。
- AUC (Area Under the Curve): 診断モデルの性能を示す指標の一つで、1.0に近いほど高精度。
- PI-RADS (Prostate Imaging Reporting and Data System): 前立腺MRIの所見を標準化し、がんの可能性を評価するシステム。
- ゴールデンスタンダード: 疾患の有無や状態を確定するための最も信頼性の高い診断基準や方法。
- 生検: 組織の一部を採取し、病理学的に検査すること。
- 全摘標本: 前立腺がんの治療として前立腺全体を切除した組織標本。
- 経路バイアス: 診断プロセス(経路)の特性により、特定の結果を持つ対象者が研究コホートから除外されることで生じる偏り。
- スペクトラムバイアス: 研究対象となる疾患の重症度や進行度が、実臨床の多様な対象者集団と異なることで生じる偏り。
- 有病率: ある集団において、特定の時点や期間に疾患を持つ対象者の割合。
- 偽陽性: 実際には疾患がないにもかかわらず、検査で陽性と判断されること。
- ファウンデーションモデル: 大規模なデータで学習され、様々な下流タスクに応用可能な汎用性の高いAIモデル。
- PSA (前立腺特異抗原): 前立腺の細胞から作られるタンパク質で、血液検査で測定される。前立腺がんの可能性を示す指標の一つ。
コメントを残す