
全身FDG PET/CTにおけるAI多病変検出の進化:マルチモーダルとファウンデーションモデルの力
解説対象論文: Quantifying multi-lesion detection and localization in whole-body FDG PET/CT with a multimodal foundation model
Physics in Medicine and Biology|被引用数: 0(2026年11月10日時点)
FDG PET/CTは、がんの診断、病期分類、治療効果評価に広く用いられる強力な画像診断法です。しかし、全身に分布する多数の病変を正確に検出・局所化することは、専門家にとって大きな負担となります。本記事では、この課題に対し、三次元AIフレームワークとマルチモーダルファウンデーションモデルを用いた最新の研究を紹介します。特に、事前学習済みモデルがいかに検出性能を向上させるか、また病変の大きさによる検出の難しさについても掘り下げていきます。
はじめに:全身PET/CTにおけるAIの新たな挑戦
どうも、Beyond the Pixelです。FDG PET/CTは、がんの診断、病期分類、治療効果評価、経過観察において不可欠な画像診断法として広く利用されています。この検査では、代謝情報を示すPETと、解剖学的情報を提供するCTが統合され、専門家が全身の病変を詳細に評価します。しかし、全身に散在する未知数の病変を、数百ものスライスの中から見つけ出し、正常な生理的活動や良性の異常と区別し、正確に局所化することは、専門家にとって大きな負担となります。特に、小さかったり、FDGの集積が低かったり、解剖学的に曖昧な病変は検出が難しく、見落としや読影者間のばらつき、そして読影の負担増大につながる可能性があります。このような課題に対し、三次元AI(人工知能)フレームワークとマルチモーダルファウンデーションモデルを活用した新しい研究がPhysics in Medicine and Biology誌に発表されました。本記事では、この研究が全身FDG PET/CTにおける多病変検出と局所化の精度をどのように向上させたのか、その詳細を分かりやすく解説します。
病変検出のためのAIフレームワーク:セグメンテーションとの違い
本研究では、全身FDG PET/CTにおける多病変の検出と局所化のために、三次元AIフレームワークを開発しました。従来の多くの深層学習研究が、病変の正確な輪郭を描出する「セグメンテーション」に焦点を当ててきたのに対し、この研究では「検出」に特化しています。検出の主な目的は、疑わしい病変が存在するかどうか、そしてどこにあるのかを特定することであり、これは専門家の支援ツールとして重要です。バウンディングボックス(病変を囲む直方体)による検出は、病変の有無、位置、おおよその範囲をコンパクトに表現し、偽陽性(誤って病変と判断されるもの)の数を明確に定量化できる利点があります。これにより、モデルがすべての境界ボクセルを予測する前に、候補を提示することが可能になります。
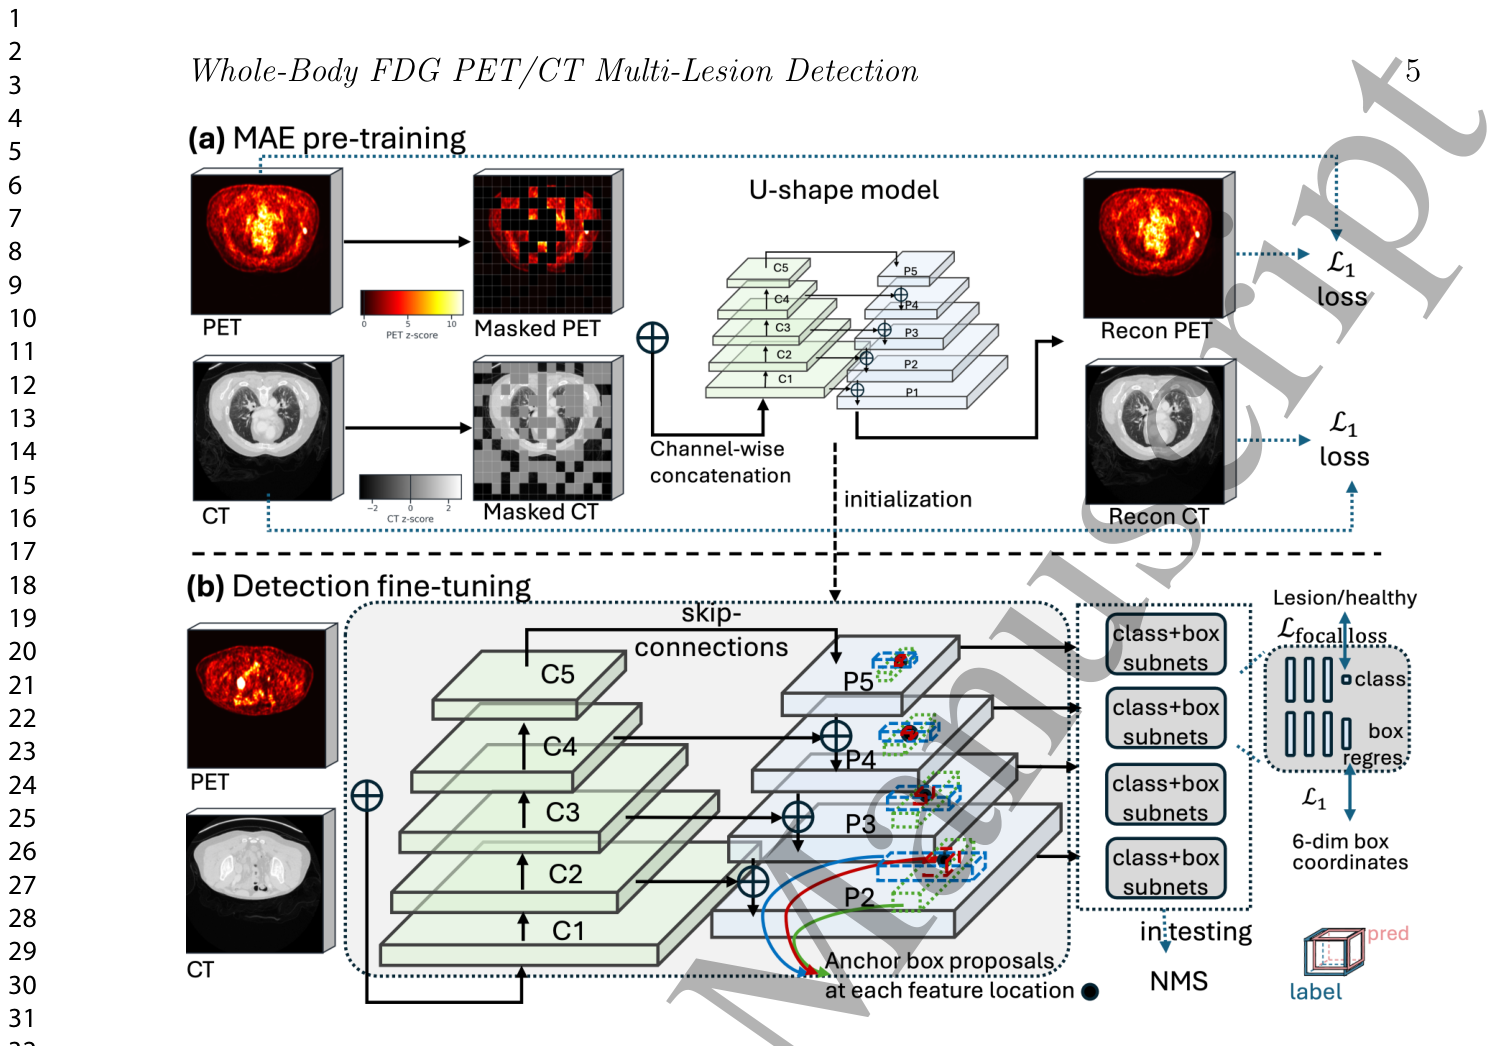
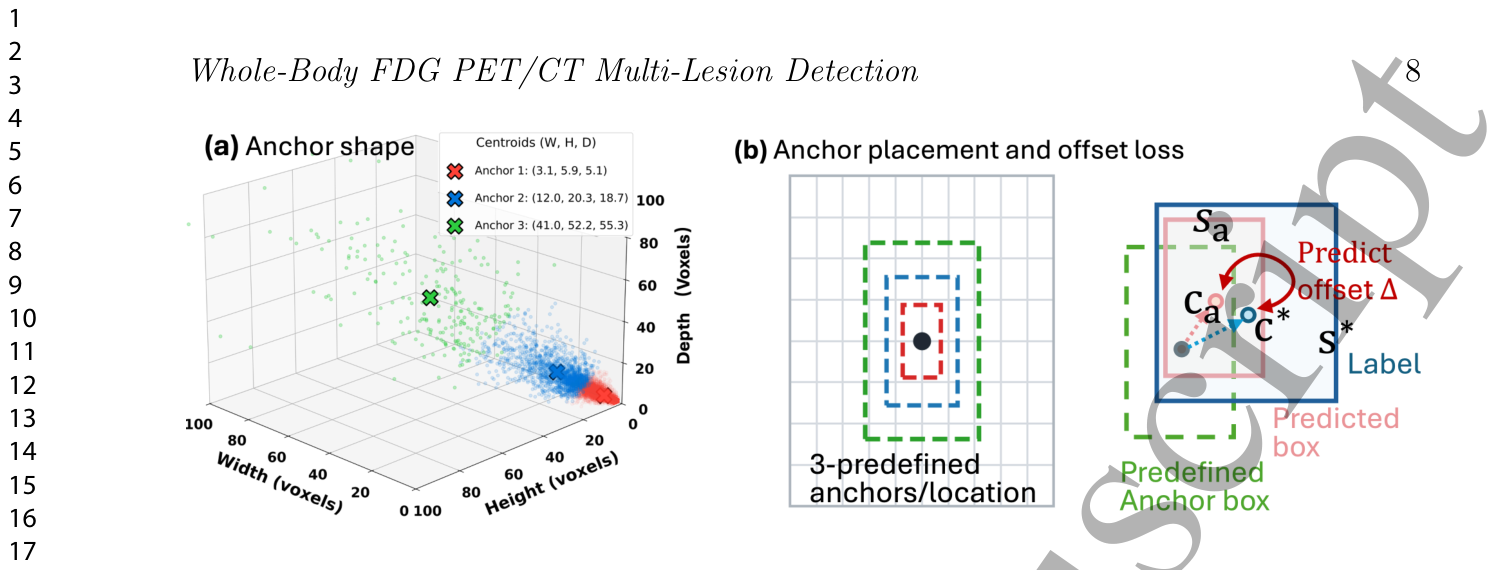
このフレームワークでは、PlainConvUNetと呼ばれるU字型ネットワークをバックボーンとして使用し、病変の分類とボックス回帰(バウンディングボックスの正確な位置とサイズを予測すること)のための多スケール特徴を抽出します。また、一般的なアンカーボックスではなく、学習データから直接病変に特化した三次元アンカー(予測の基準となるあらかじめ定義されたボックス)を推定する「データ駆動型アンカー設計」を採用しています。これにより、小さな病変から大きな病変まで、様々なサイズの病変に対応できるよう工夫されています。
さらに、RetinaNetスタイル検出パラダイムを拡張し、適応的トレーニングサンプル選択(ATSS)や焦点損失(Focal Loss)といった技術を取り入れることで、高密度なアンカー予測における前景と背景の深刻な不均衡に対応し、検出精度を向上させています。予測された複数の重複するボックスは、三次元非最大抑制(NMS)によって整理され、最も確信度の高いものだけが残されます。
研究のアプローチ:マルチモーダル情報とファウンデーションモデルの活用
この研究では、AutoPETコホートと呼ばれる公開データセットから1,014件のFDG PET/CT検査データを使用しました。これらのデータは、学習用、検証用、テスト用に分割され、特にテストセットはモデルの選択やハイパーパラメータの調整、自己教師あり事前学習には一切使用されず、独立性が保たれました。研究チームは、以下の4つの異なるモデル設定で検出性能を比較しました。(i) PET+CTをゼロから学習(スクラッチ学習)、(ii) PET画像のみをスクラッチ学習、(iii) CT画像のみをスクラッチ学習、そして(iv) 事前学習済みのマルチセンターPET/CTマルチモーダルファウンデーションモデルから初期化されたPET+CT。このファウンデーションモデルは、マスク付きオートエンコーダー(MAE)という手法を用いて、多施設由来の4,797件のPET/CTスキャンで事前学習されたものです。これにより、広範な画像から一般的な特徴表現を学習し、その知識を今回の病変検出タスクに転移させることを目的としています。すべての設定において、PlainConvUNetアーキテクチャや検出ヘッド、アンカー設定、損失関数の定式化、そして後処理手順は同じに保たれ、異なる初期化戦略が検出性能にどのような影響を与えるかを制御された条件下で比較しました。スクラッチ学習のモデルには十分な最適化期間を与えるため、事前学習済みモデルのファインチューニングよりも長い学習エポックが割り当てられました。
AIの検出性能:PET/CTと事前学習の効果
全体的な検出性能を評価するために、FROC曲線とAFROC曲線が用いられました。FROC曲線は偽陽性(FP)数あたりの病変レベルの感度を示し、AFROC曲線はスキャンレベルの偽陽性割合あたりの病変局所化割合を示します。
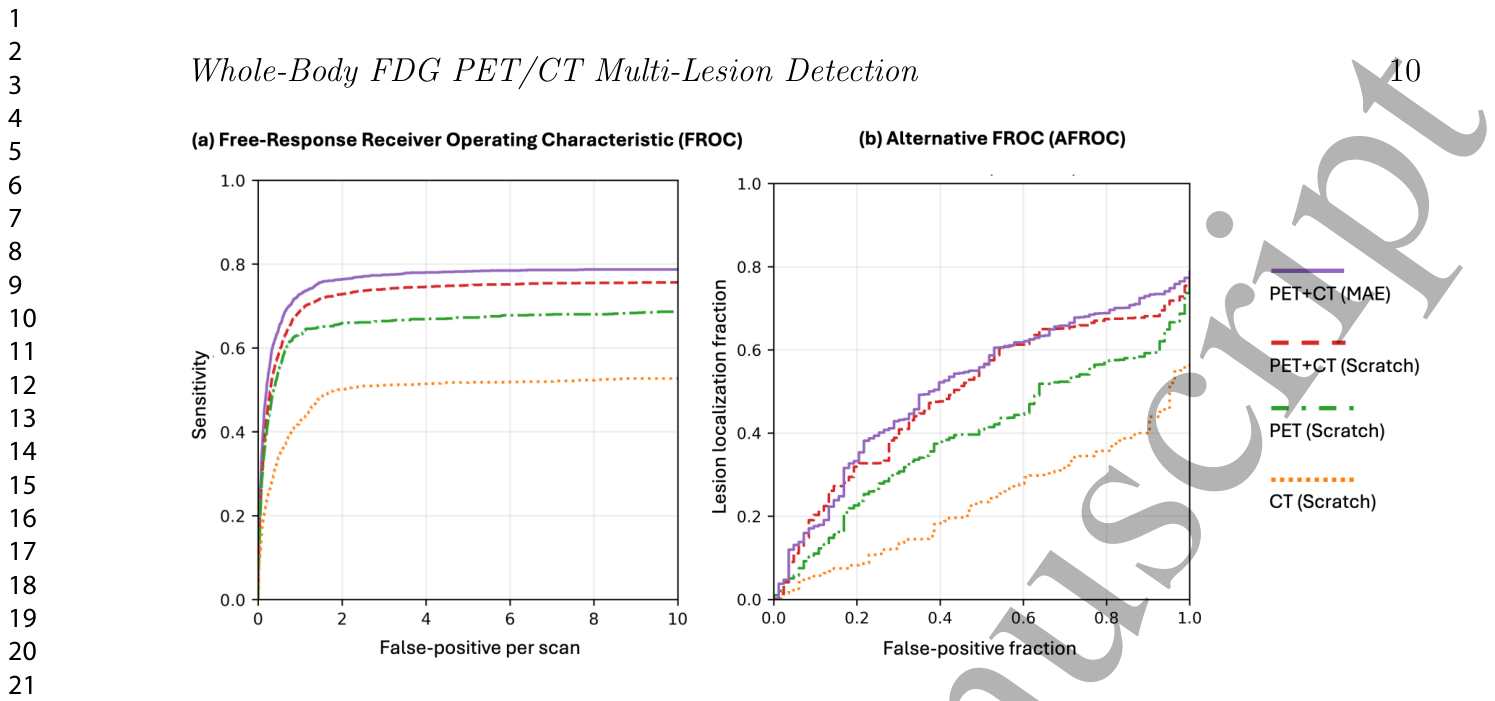
結果として、マルチモーダルPET+CTは、PET単独やCT単独と比較して、一貫して優れた病変検出能力を示しました。これは、PETが提供する代謝情報とCTが提供する解剖学的情報が相補的に機能し、病変の検出と局所化に貢献することを示唆しています。特に、事前学習済みPET+CTファウンデーションモデルから初期化されたモデル(PET+CT–Pretrained)は、同じPET+CT検出器をゼロから学習した場合(PET+CT–Scratch)と比較して、病変検出性能をさらに向上させました。FROC感度では、評価範囲の1~4偽陽性/スキャンにおいて0.034~0.041の絶対的な向上、AFROC AUCでは0.028の向上が見られました。
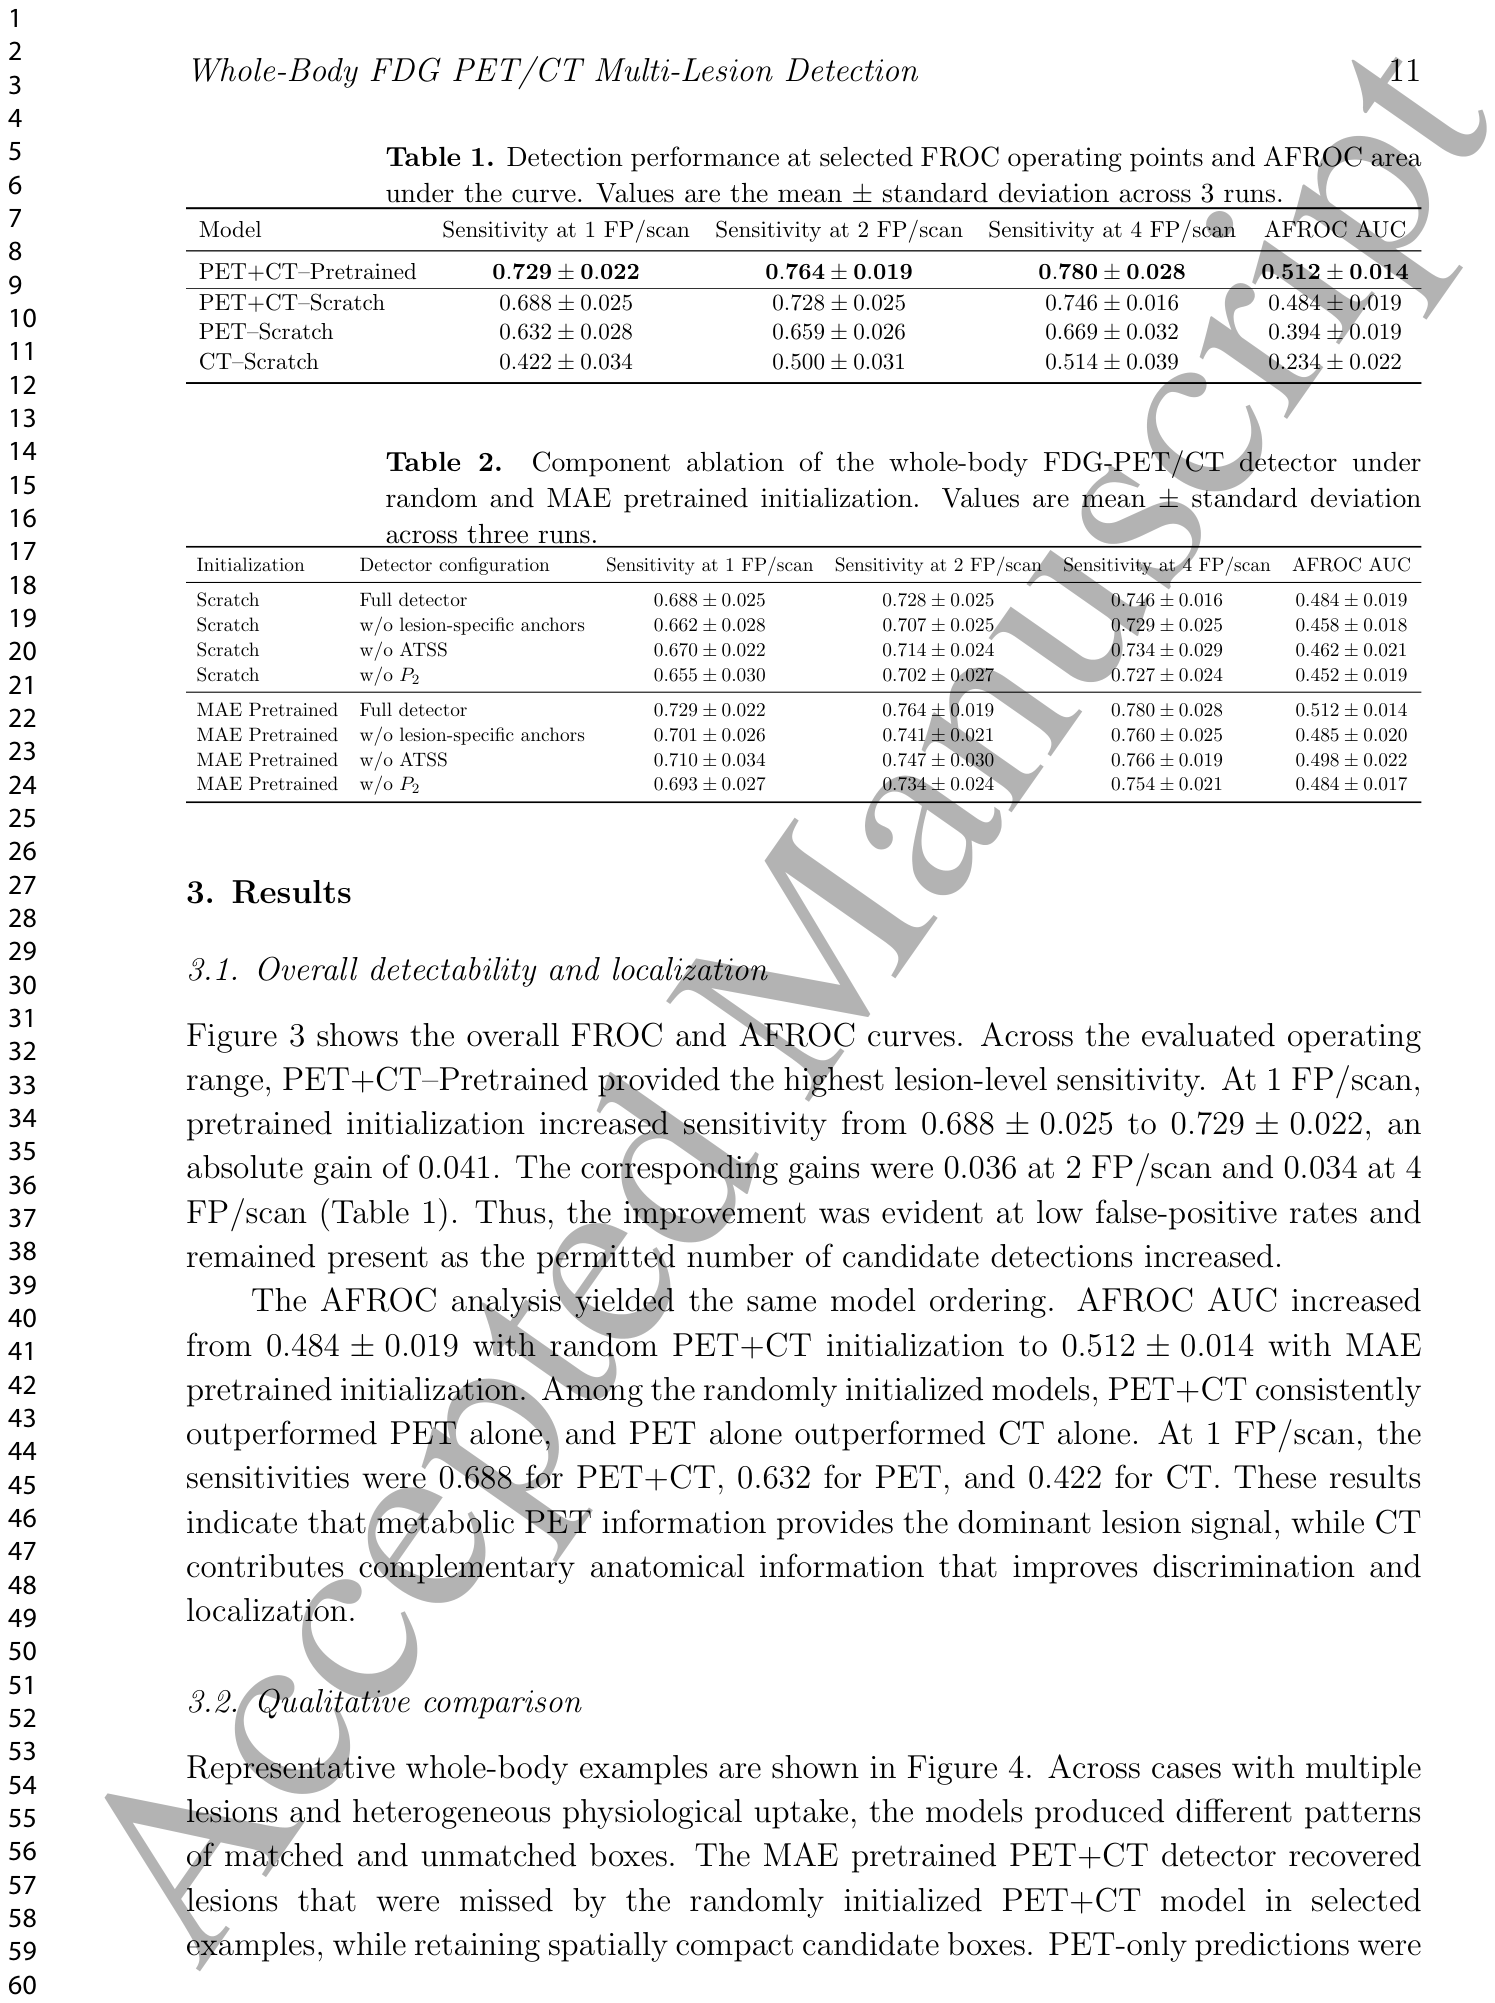
また、定性的な比較では、事前学習済みPET+CT検出器が、ゼロから学習したモデルでは見落とされがちな病変を、より空間的にコンパクトな候補ボックスで検出する例が示されています。
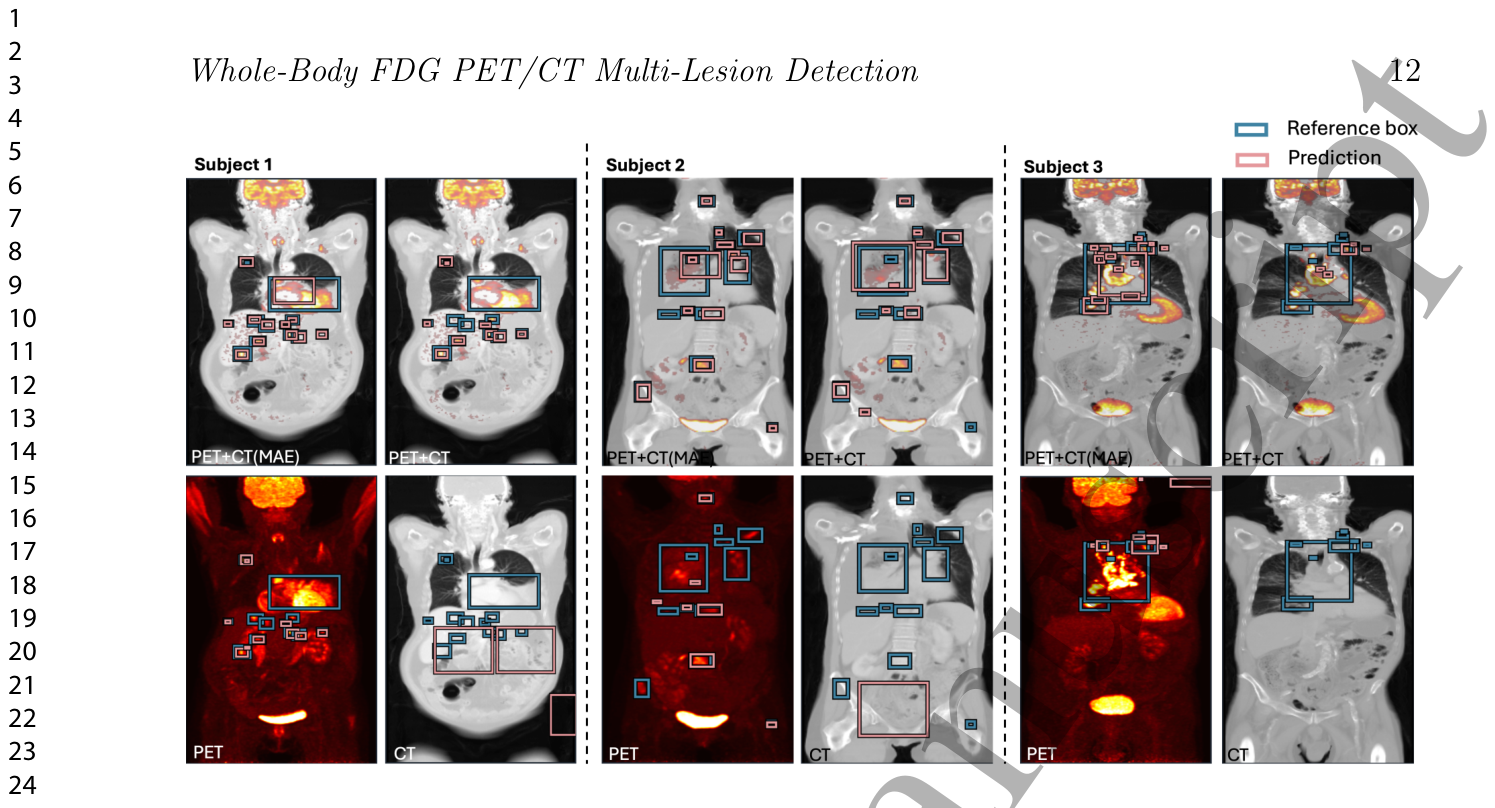
さらに、病変に特化したアンカー、適応的トレーニングサンプル選択(ATSS)、高解像度のP2検出レベルといった検出器固有の設計が、事前学習の有無にかかわらず性能向上に寄与することが、アブレーション分析によって確認されました。特にP2レベルの除去が最大の性能低下をもたらし、病変の局所化における高解像度特徴の重要性が浮き彫りになりました。
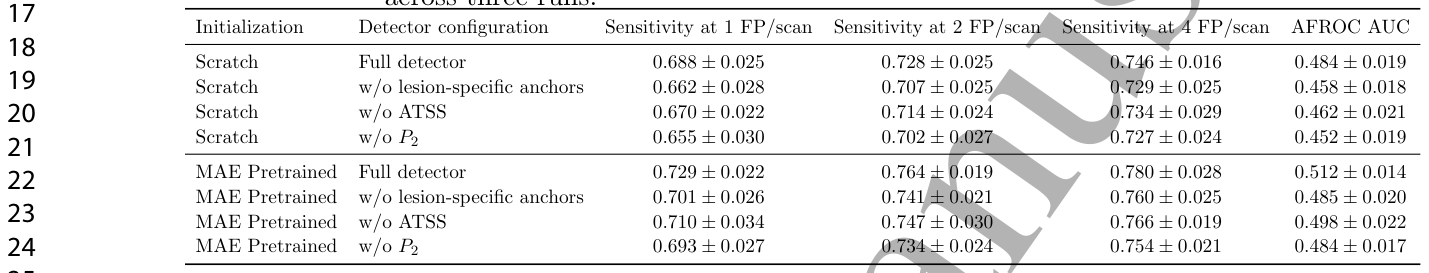
病変のマッチング基準となるIoU閾値の頑健性分析でも、PET+CT–Pretrainedモデルが一貫して優れた性能を示しており、事前学習の恩恵が特定の閾値に依存しないことが示されました。
病変のサイズが検出に与える影響
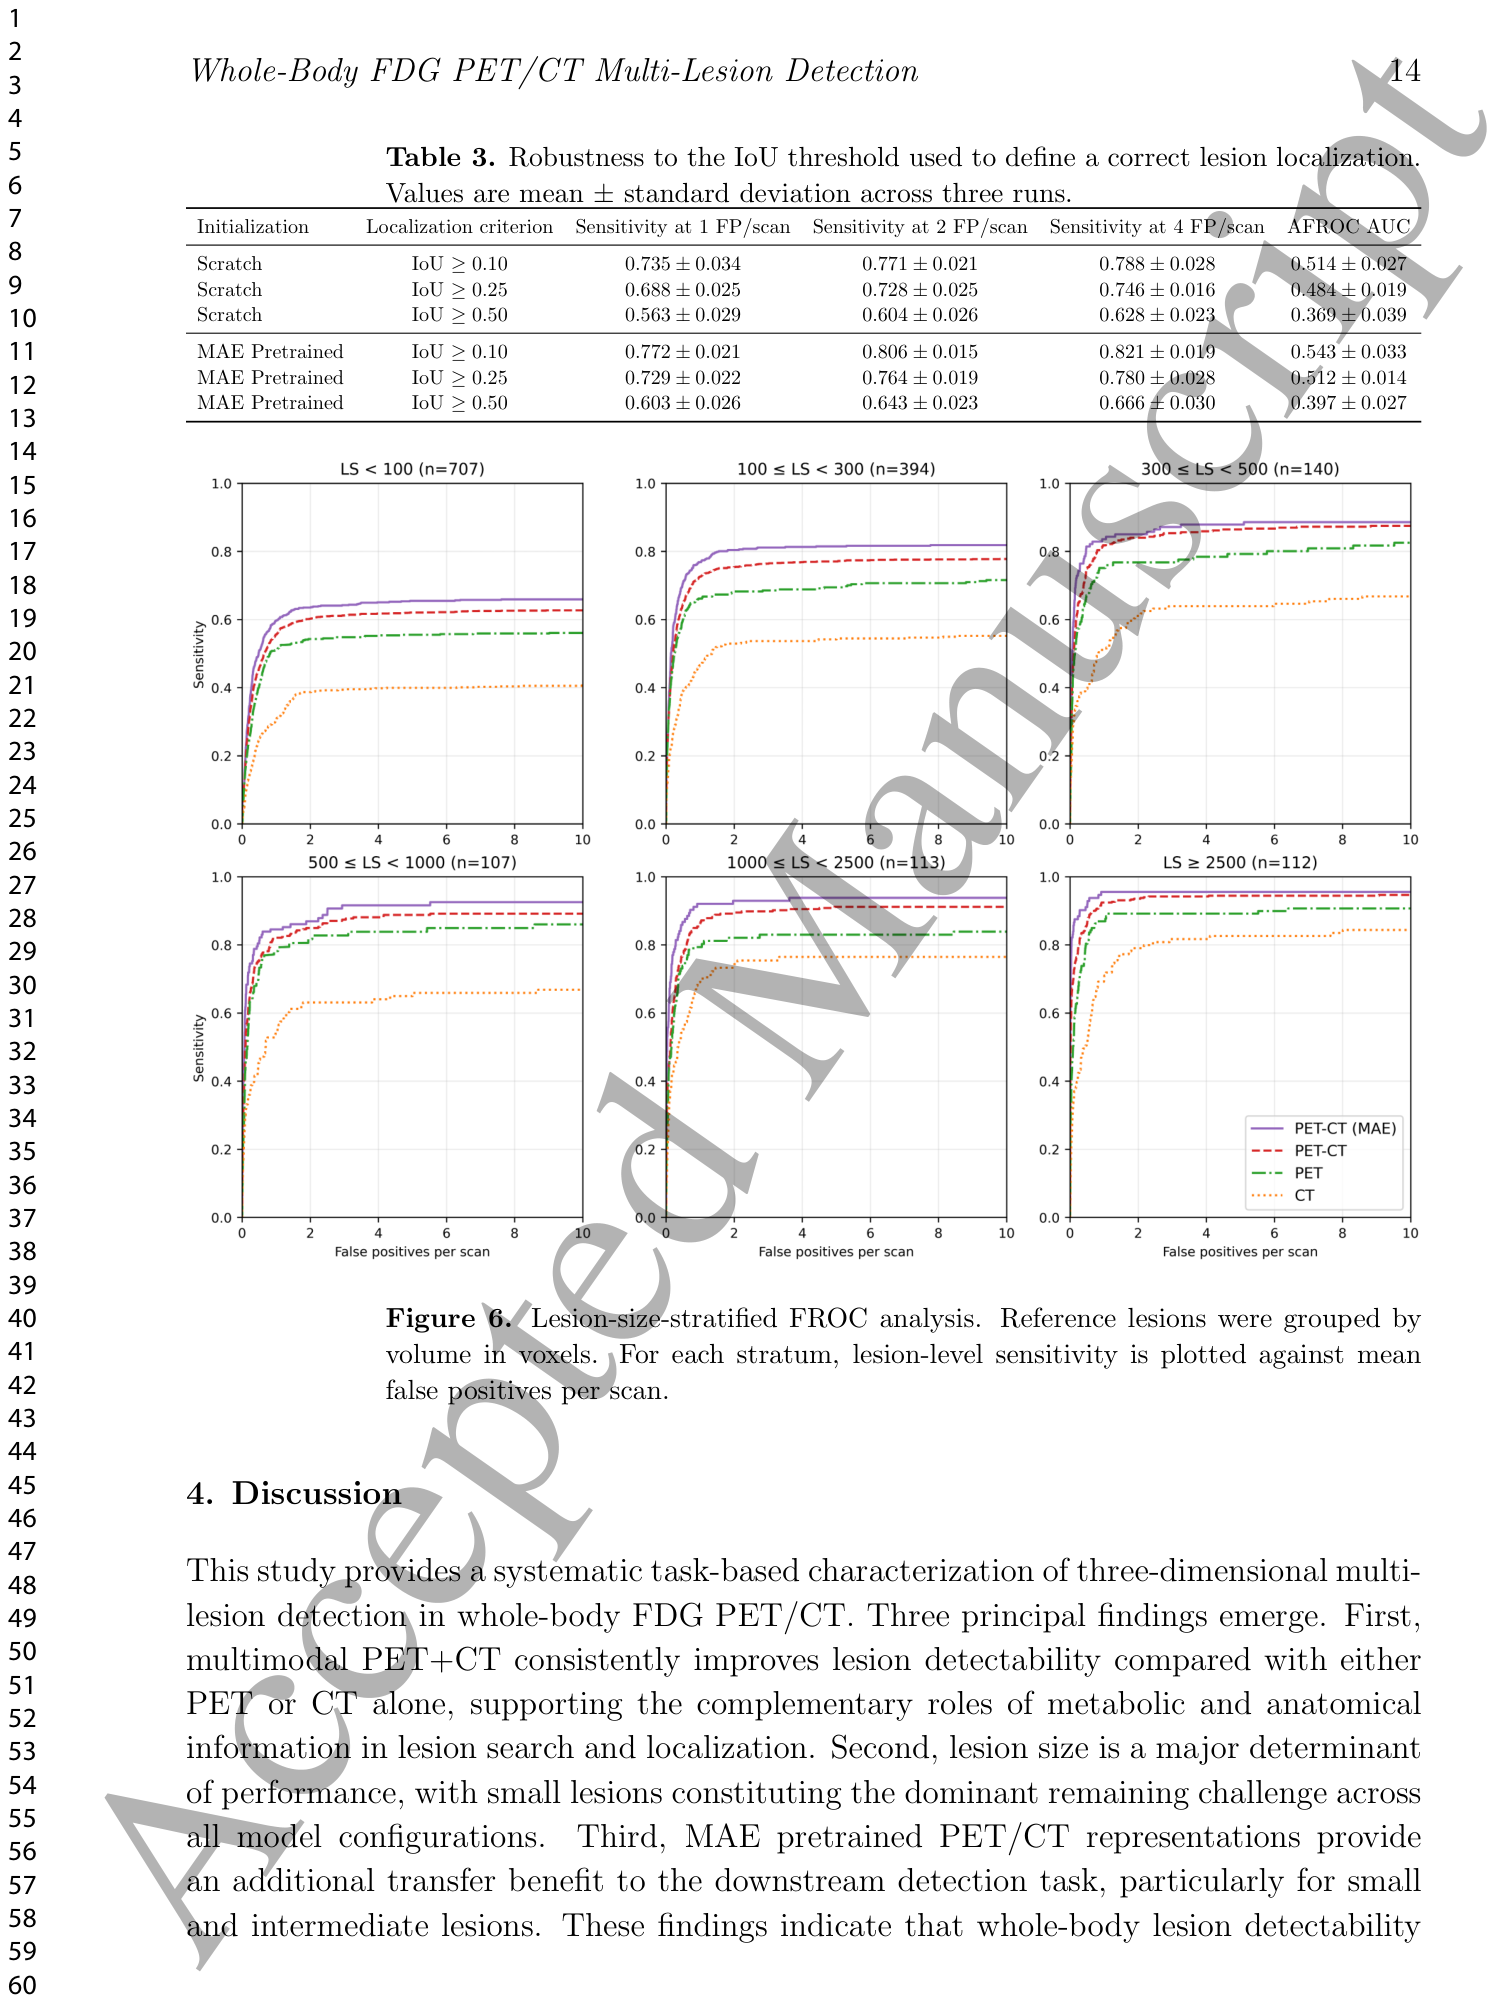
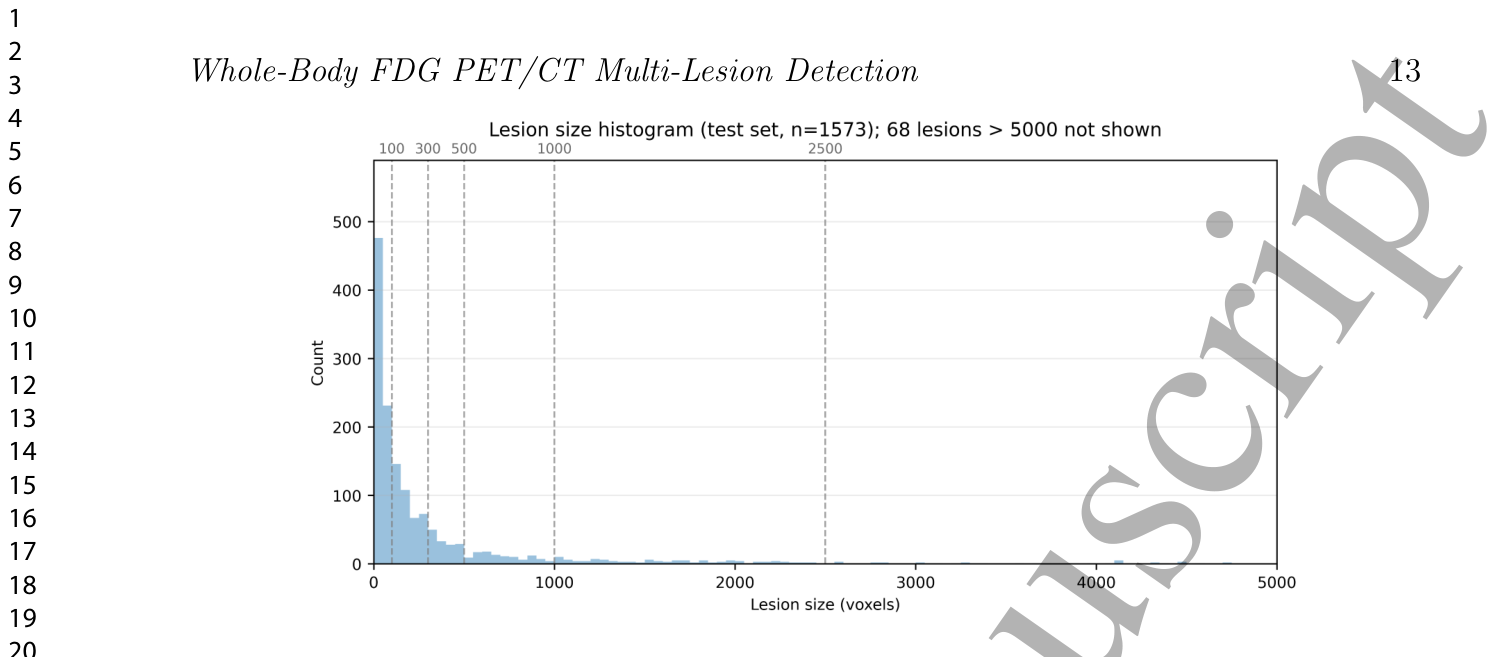
テストセットの病変分布を分析すると、全体の1,573個の病変のうち、約44.9%が100ボクセル未満、約70.0%が300ボクセル未満と、小さな病変が多数を占めていることが分かりました。
すべてのモデルにおいて、病変検出能力は病変サイズに強く依存し、サイズが大きくなるほど検出率が大幅に向上することが示されました。100ボクセル未満の小さな病変はFROC感度とAFROC局所化割合が最も低く、1,000ボクセル以上の病変はかなり高い検出率を示しました。これは、小さな病変の検出が最も困難な課題であることを強調しています。特に、事前学習済みPET+CT検出器は、小さな病変や中程度の病変において、ゼロから学習したPET+CTモデルからの分離がより顕著でした。しかし、大きな病変になるにつれて、これらのモデル間の性能差は小さくなる傾向がありました。
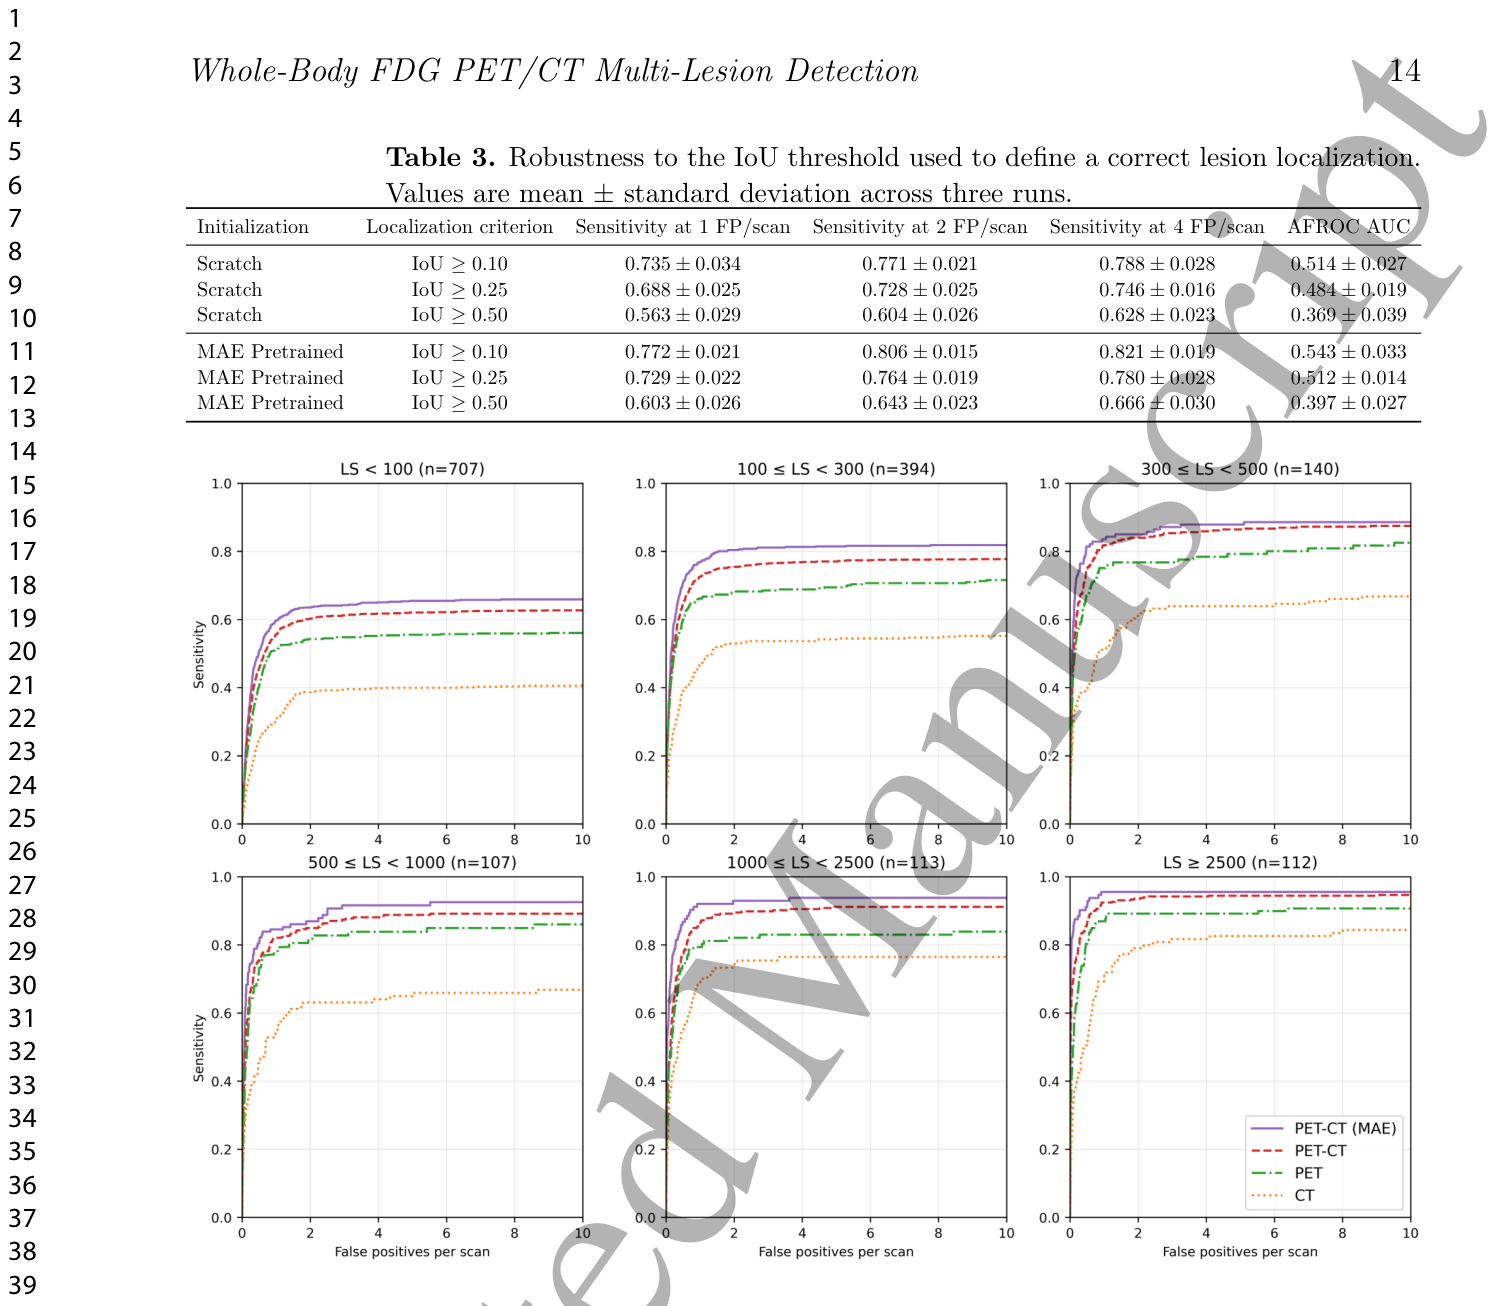
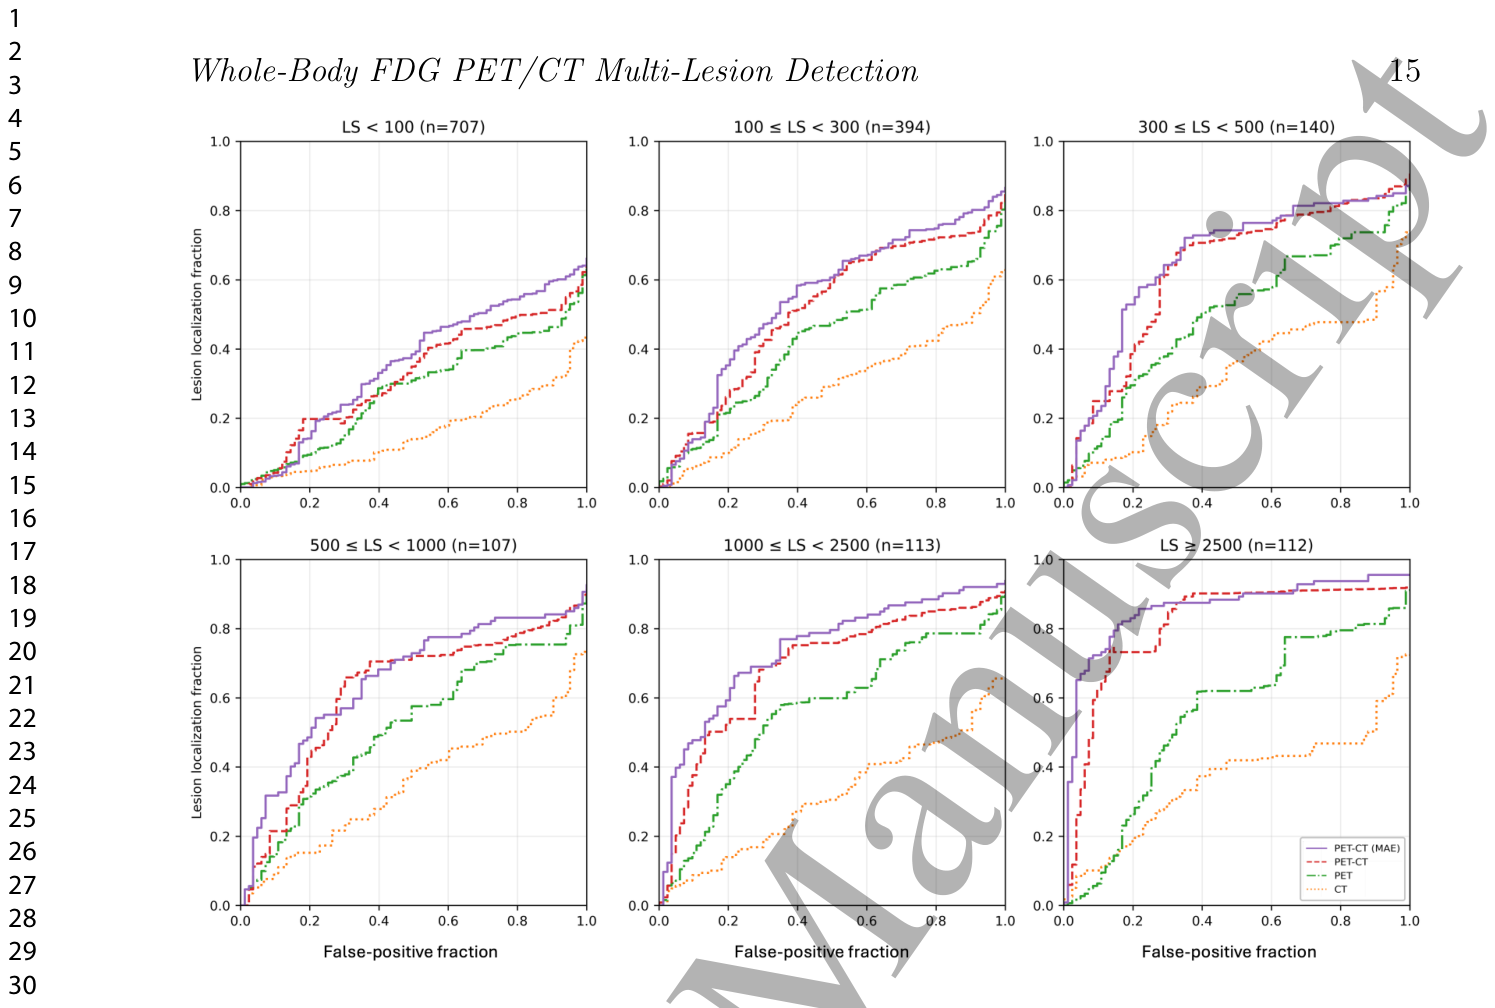
この結果は、病変のサイズが検出性能の主要な決定要因であるとともに、事前学習が特に検出が難しい小さな病変に対して追加的なメリットをもたらすことを示しています。
研究の限界と今後の展望
本研究は、全身PET/CTにおける多病変検出において重要な進歩を示しましたが、いくつかの限界と今後の展望があります。まず、本研究で検出された病変は、病理学的に確定された腫瘍ではなく、専門家による手動アノテーション(注釈付け)に基づいています。これはFDG PET/CTの臨床解釈における特定の慣習を反映しており、検出器の出力はあくまで専門家による確認が必要な候補として解釈されるべきです。また、FDGは腫瘍に特異的なものではなく、炎症や感染など良性プロセスでも集積が見られるため、すべてのTP(真陽性)が病理学的に悪性であるとは限りません。第二に、この研究で用いられたAutoPETデータセットは、単一の医療施設で単一のPET/CTスキャナーで取得されたものです。事前学習に多施設データが使用されたとはいえ、結果として得られる病変検出器の外部妥当性が確立されたわけではありません。異なるスキャナー、再構成設定、投与放射能、撮像時間、対象者集団、腫瘍タイプ、施設の解釈慣習などが、画像の外観とアノテーションの両方に影響を与える可能性があります。したがって、臨床での利用を主張する前に、多施設での独立したテストが不可欠です。第三に、病変サイズはPET検出能力の主要な決定要因ですが、SUV(標準化取込値)のようなトレーサー集積、病変と背景のコントラスト、解剖学的部位、呼吸性移動、画像ノイズなども影響します。今後は、病変サイズだけでなく、これらの要因を考慮した統合的な分析が重要になるでしょう。最後に、本研究は技術的な検出性能を示しましたが、診療上の実際の有用性を確立するためには、対象者レベルのエンドポイント(例:病期分類の一致、読影時間の短縮、臨床的に重要な見落としの頻度)を用いた多読影者研究や読影支援研究が必要です。
まとめ
この研究は、全身FDG PET/CTにおける三次元AIフレームワークを用いた多病変検出と局所化について、体系的なタスクベースの特性評価を行いました。主な結論として、マルチモーダルPET+CT入力は、PET単独またはCT単独と比較して病変検出性能を一貫して向上させ、代謝情報と解剖学的情報の相補的な価値を示しました。FROC、AFROC、および病変サイズ層別化分析により、検出性能が病変サイズに強く依存することが明らかになり、特に小さな病変が最も困難な課題であることが示されました。さらに重要なことに、我々の事前学習済みマルチセンターPET/CTマルチモーダルファウンデーションモデルからの初期化は、同じ検出器をゼロから学習するよりも検出性能をさらに向上させ、特に小さな病変や中程度の病変で最大の改善が見られました。これらの結果は、全身の多病変検出におけるマルチモーダルPET/CT情報とPET/CTファウンデーションモデル表現の価値を支持するものです。しかし、単一施設のコホートにおける手動アノテーションに対する性能評価であるため、臨床的有用性を確立するためには、多施設での外部検証と対象者レベルのエンドポイントを用いた読影者研究が今後必要とされます。
用語集
- FDG PET/CT: (2-デオキシ-2-[18F]フルオロ-D-グルコース陽電子放出断層撮影/X線CT)放射性薬剤FDGを用いた代謝情報とCTによる解剖学的情報を組み合わせた画像診断法。
- AIフレームワーク: 人工知能(AI)を構築するためのソフトウェア構造。
- ファウンデーションモデル: 大規模なデータで事前学習され、多くの下流タスクに応用できる基盤となるAIモデル。
- PlainConvUNet: U字型ネットワーク構造を持つ畳み込みニューラルネットワークの一種で、医用画像解析でよく用いられる。
- FROC曲線: (Free-Response Receiver Operating Characteristic)偽陽性数あたりの病変検出感度を示す評価指標。
- AFROC曲線: (Alternative FROC)偽陽性割合あたりの病変局所化割合を示す評価指標。
- MAE (Masked AutoEncoder): 入力データの一部を隠蔽し、それを再構築するようモデルを学習させる事前学習手法。
- IoU (Intersection over Union): 予測されたバウンディングボックスと参照ボックスの重なり具合を示す指標。
- アンカーボックス: 物体検出において、予測の基準となるあらかじめ定義されたボックス。
- ATSS (Adaptive Training Sample Selection): 病変ごとに最適なIoU閾値を用いてアンカーボックスを割り当てる手法。
- NMS (Non-Maximum Suppression): 重複する検出結果から最も確信度の高いものだけを残す後処理技術。
コメントを残す