
放射線検査の説明、ChatGPTが公式サイトより対象者に好まれる理由
解説対象論文: Patients prefer ChatGPT to institutional websites for questions on radiation-based imaging exams: international mixed-methods study
Radiology Advances|被引用数: 0(2026年9月2日時点)
医療情報がデジタル化する現代において、放射線検査に関する情報源としてChatGPTが従来の医療機関ウェブサイトよりも対象者から高い評価を得ていることが、国際的な混合研究で明らかになりました。この研究は、対象者中心のコミュニケーションの重要性を示唆し、AIを活用した情報提供の可能性を探るものです。
導入: 放射線リスク情報と対象者のニーズ
どうも、Beyond the Pixelです。近年、デジタル技術の進化に伴い、対象者はインターネットやAIベースのツールを健康情報源として活用する機会が増えています。特に、ChatGPTのような大規模言語モデル(LLM)の普及は、この傾向を加速させています。放射線を使用する画像診断は、放射線科、核医学、透視ガイド下インターベンション、放射線治療など、多くの医療分野に関わるため、放射線被ばくに関するリスクコミュニケーションは非常に重要です。専門家や医療機関は教育資料を提供していますが、それでも対象者は不安や疑問を抱き、さらなる説明をオンラインに求めることがあります。これまで、専門家による評価では、ChatGPTが生成する放射線リスクに関する回答と、公式機関の回答とで同等の性能が示されていました。しかし、対象者の視点からの評価は不足していました。本稿では、この重要なギャップを埋める国際的な混合研究の結果をご紹介します。
研究の目的と方法: ChatGPT vs. 人間生成情報
本研究の目的は、ChatGPTが生成した放射線リスク情報と、人間が生成した情報に対する対象者の認識を評価することでした。具体的には、満足度、理解度、信頼性、安心感の側面から比較が行われました。研究は、米国、スイス、レバノンにある3つの病院で、2024年12月から2025年3月にかけて実施されました。参加対象者は、一般的な放射線リスクに関する5つの質問のうち1つにランダムに割り当てられました。回答がChatGPT-3.5と人間生成のどちらであるかは対象者には知らされず、それぞれ「著者A」または「著者B」として提示されました。評価は、満足度(主要評価項目)、理解度、信頼性、安心感について、7段階のリッカート尺度を用いて行われました。加えて、自由記述コメントも収集され、テーマコーディングという手法を用いて質的に分析されました。合計328名の対象者が参加し、その内訳は18~39歳が34%、40~59歳が33%、60~79歳が31%、80歳以上が3%でした。また、188名が女性でした。本研究の参加者のフローは
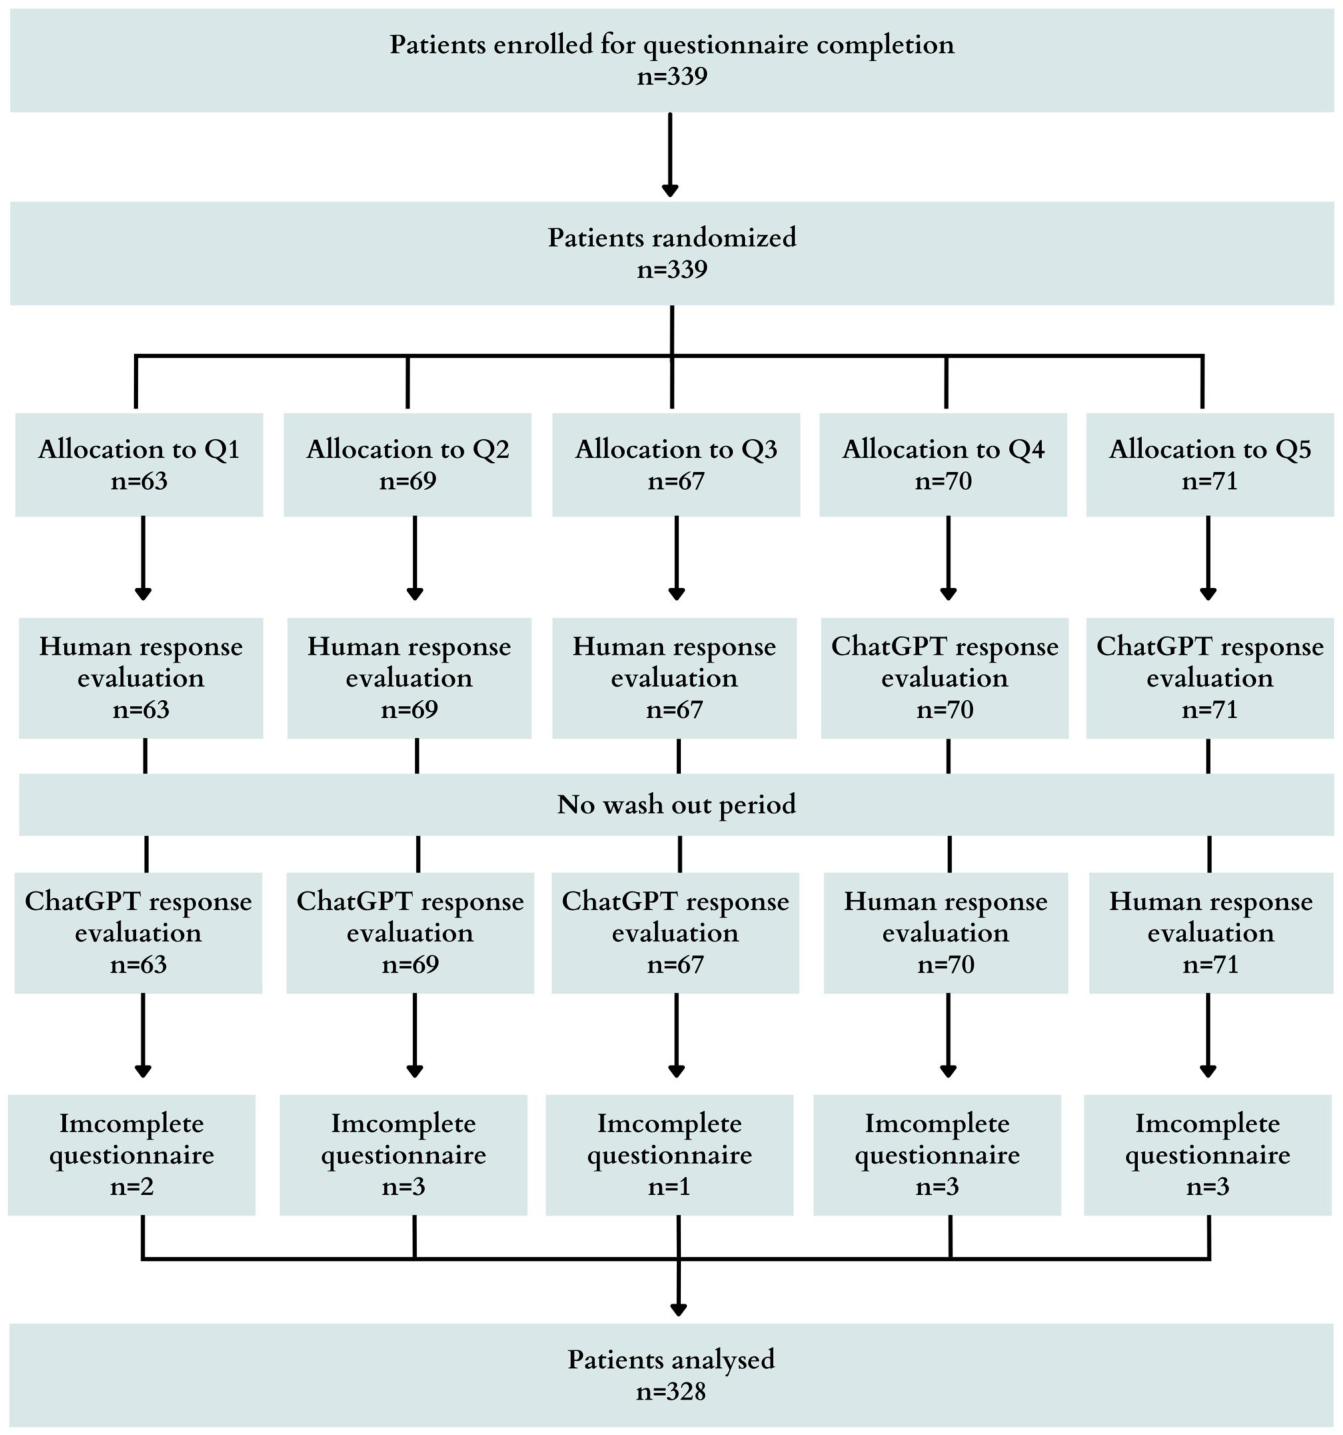
のようになっています。研究対象者の詳細な属性は
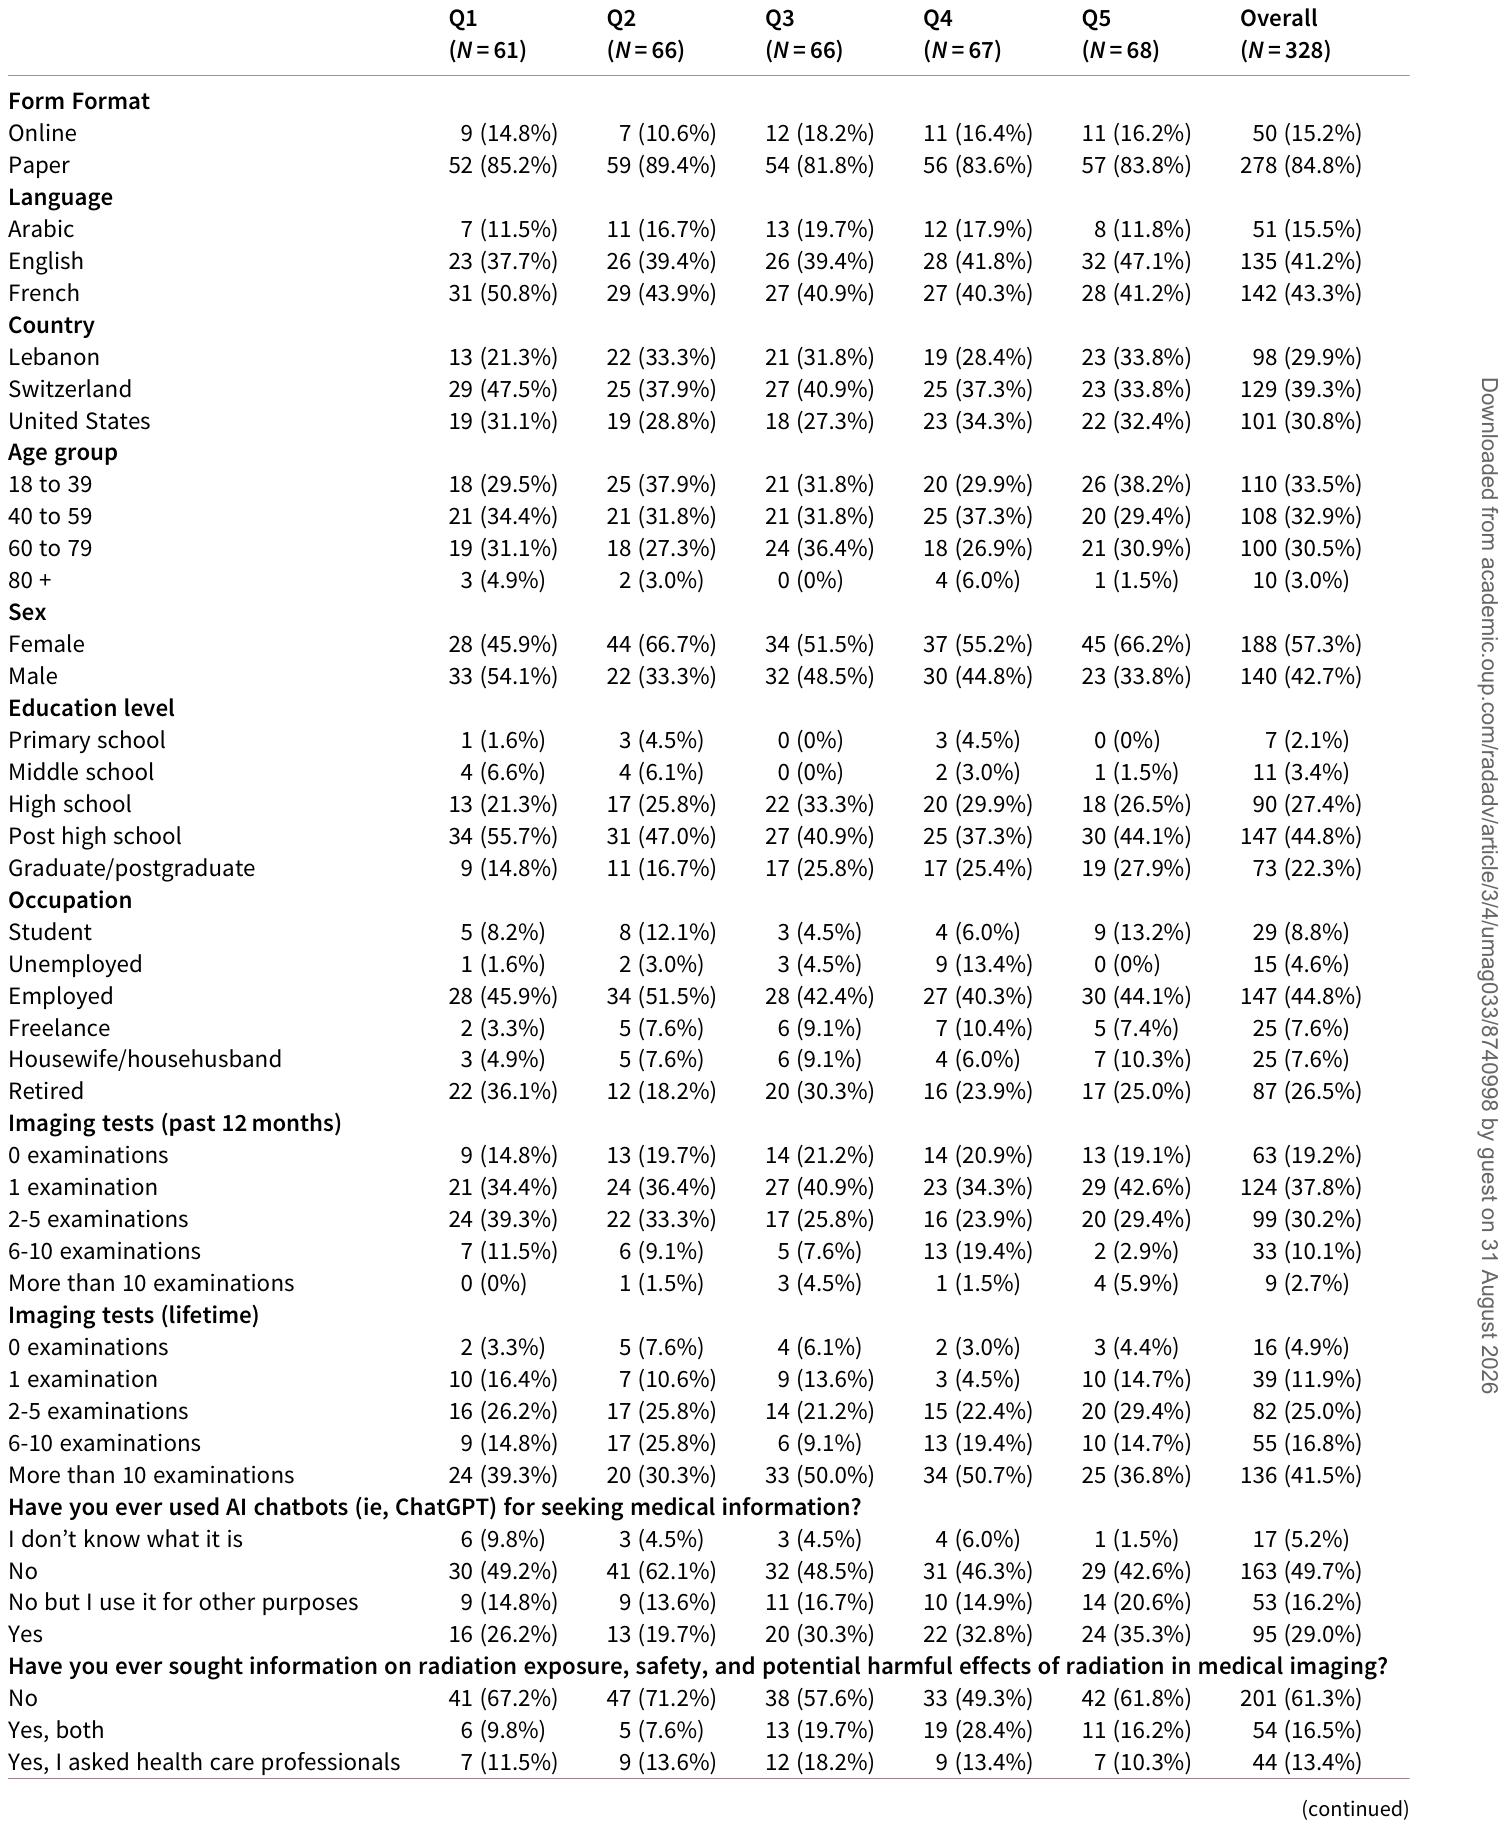
に示されています。本研究で評価された具体的な質問と、ChatGPTおよび人間生成の回答例は
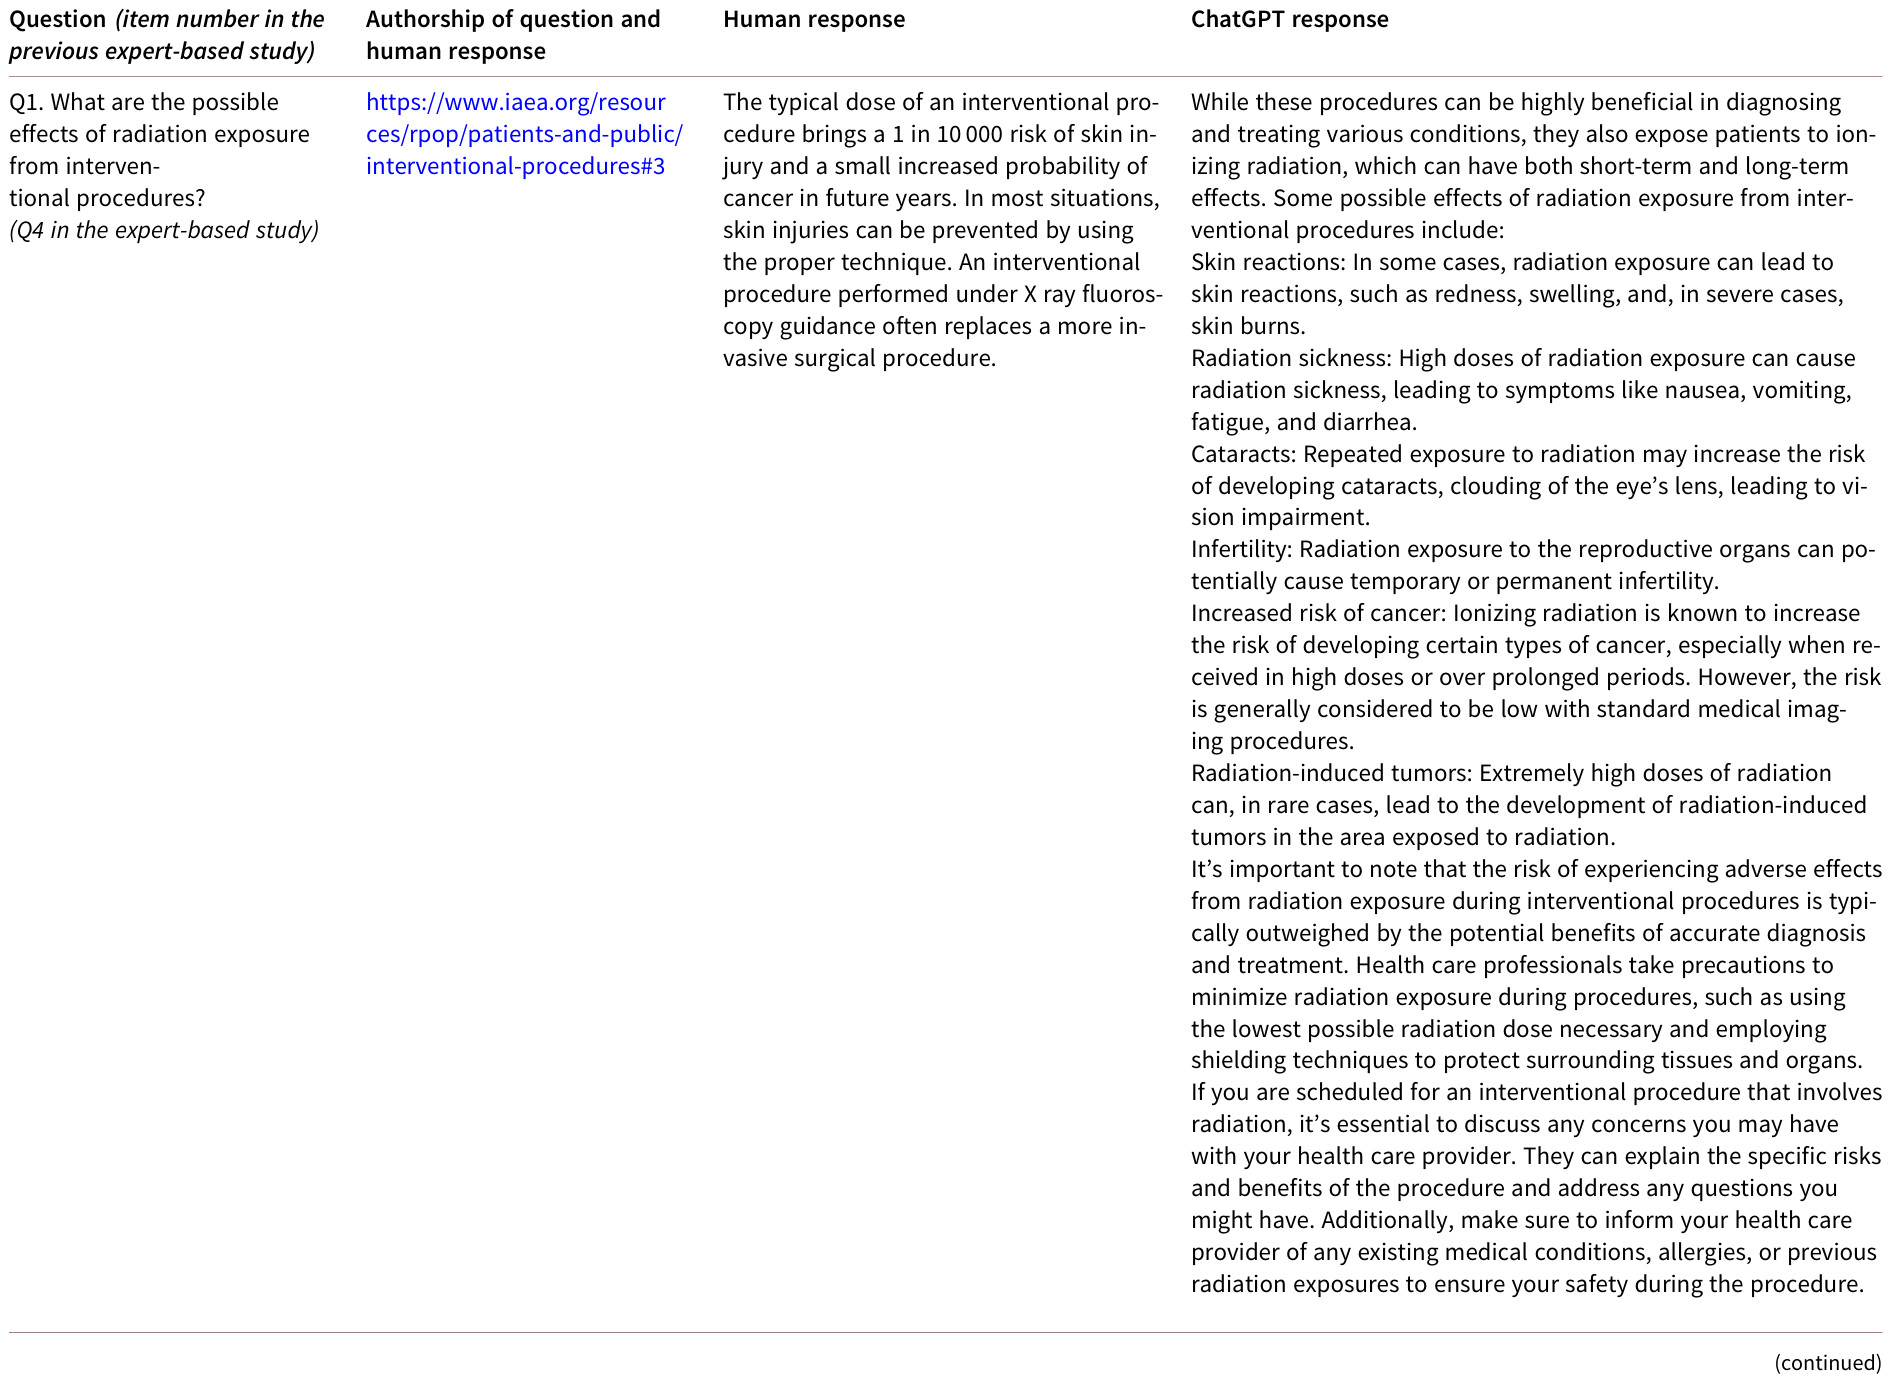
にて確認できます。
驚きの結果: ChatGPTが全項目で優位
定量分析の結果、ChatGPTの回答は人間が生成した回答と比較して、すべての評価項目で有意に高いスコアを獲得しました。具体的には、満足度で0.70ポイント、理解度で0.27ポイント、信頼性で0.65ポイント、安心感で0.51ポイントの優位性が認められました(すべてP < .01)。対象者のリッカート尺度の評価は
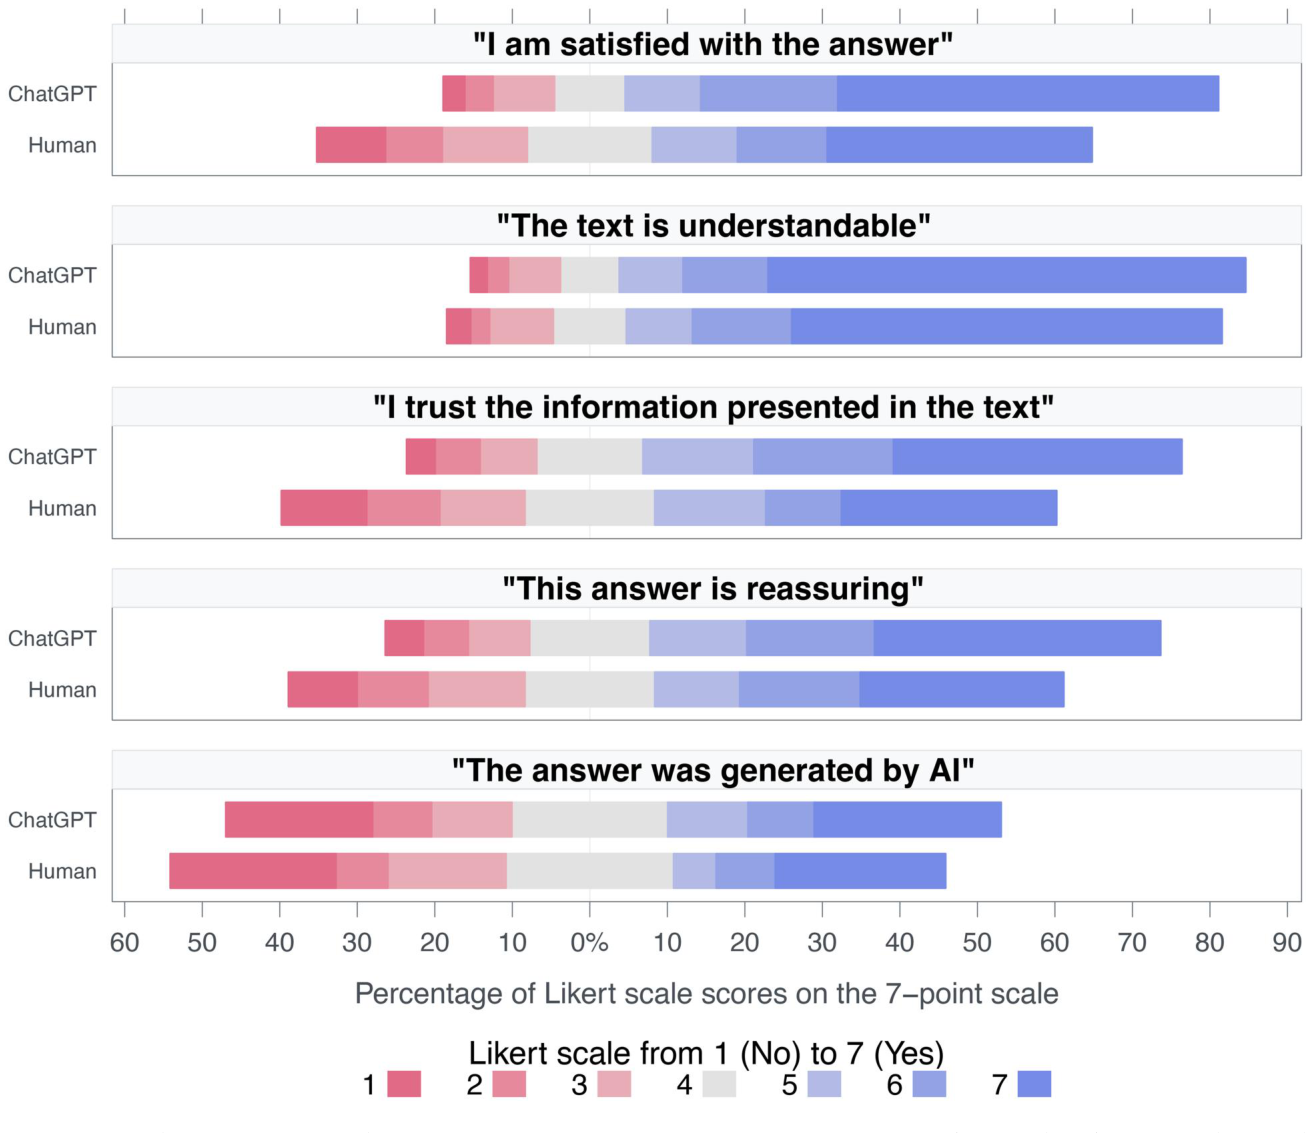
に示されています。質的分析においても、この結果は裏付けられました。ChatGPTの回答にはポジティブなコメントが2.3倍多く寄せられた一方で、人間が生成した回答にはネガティブなコメントが1.7倍多く寄せられました。定性的な分析結果をまとめたフレームワークは
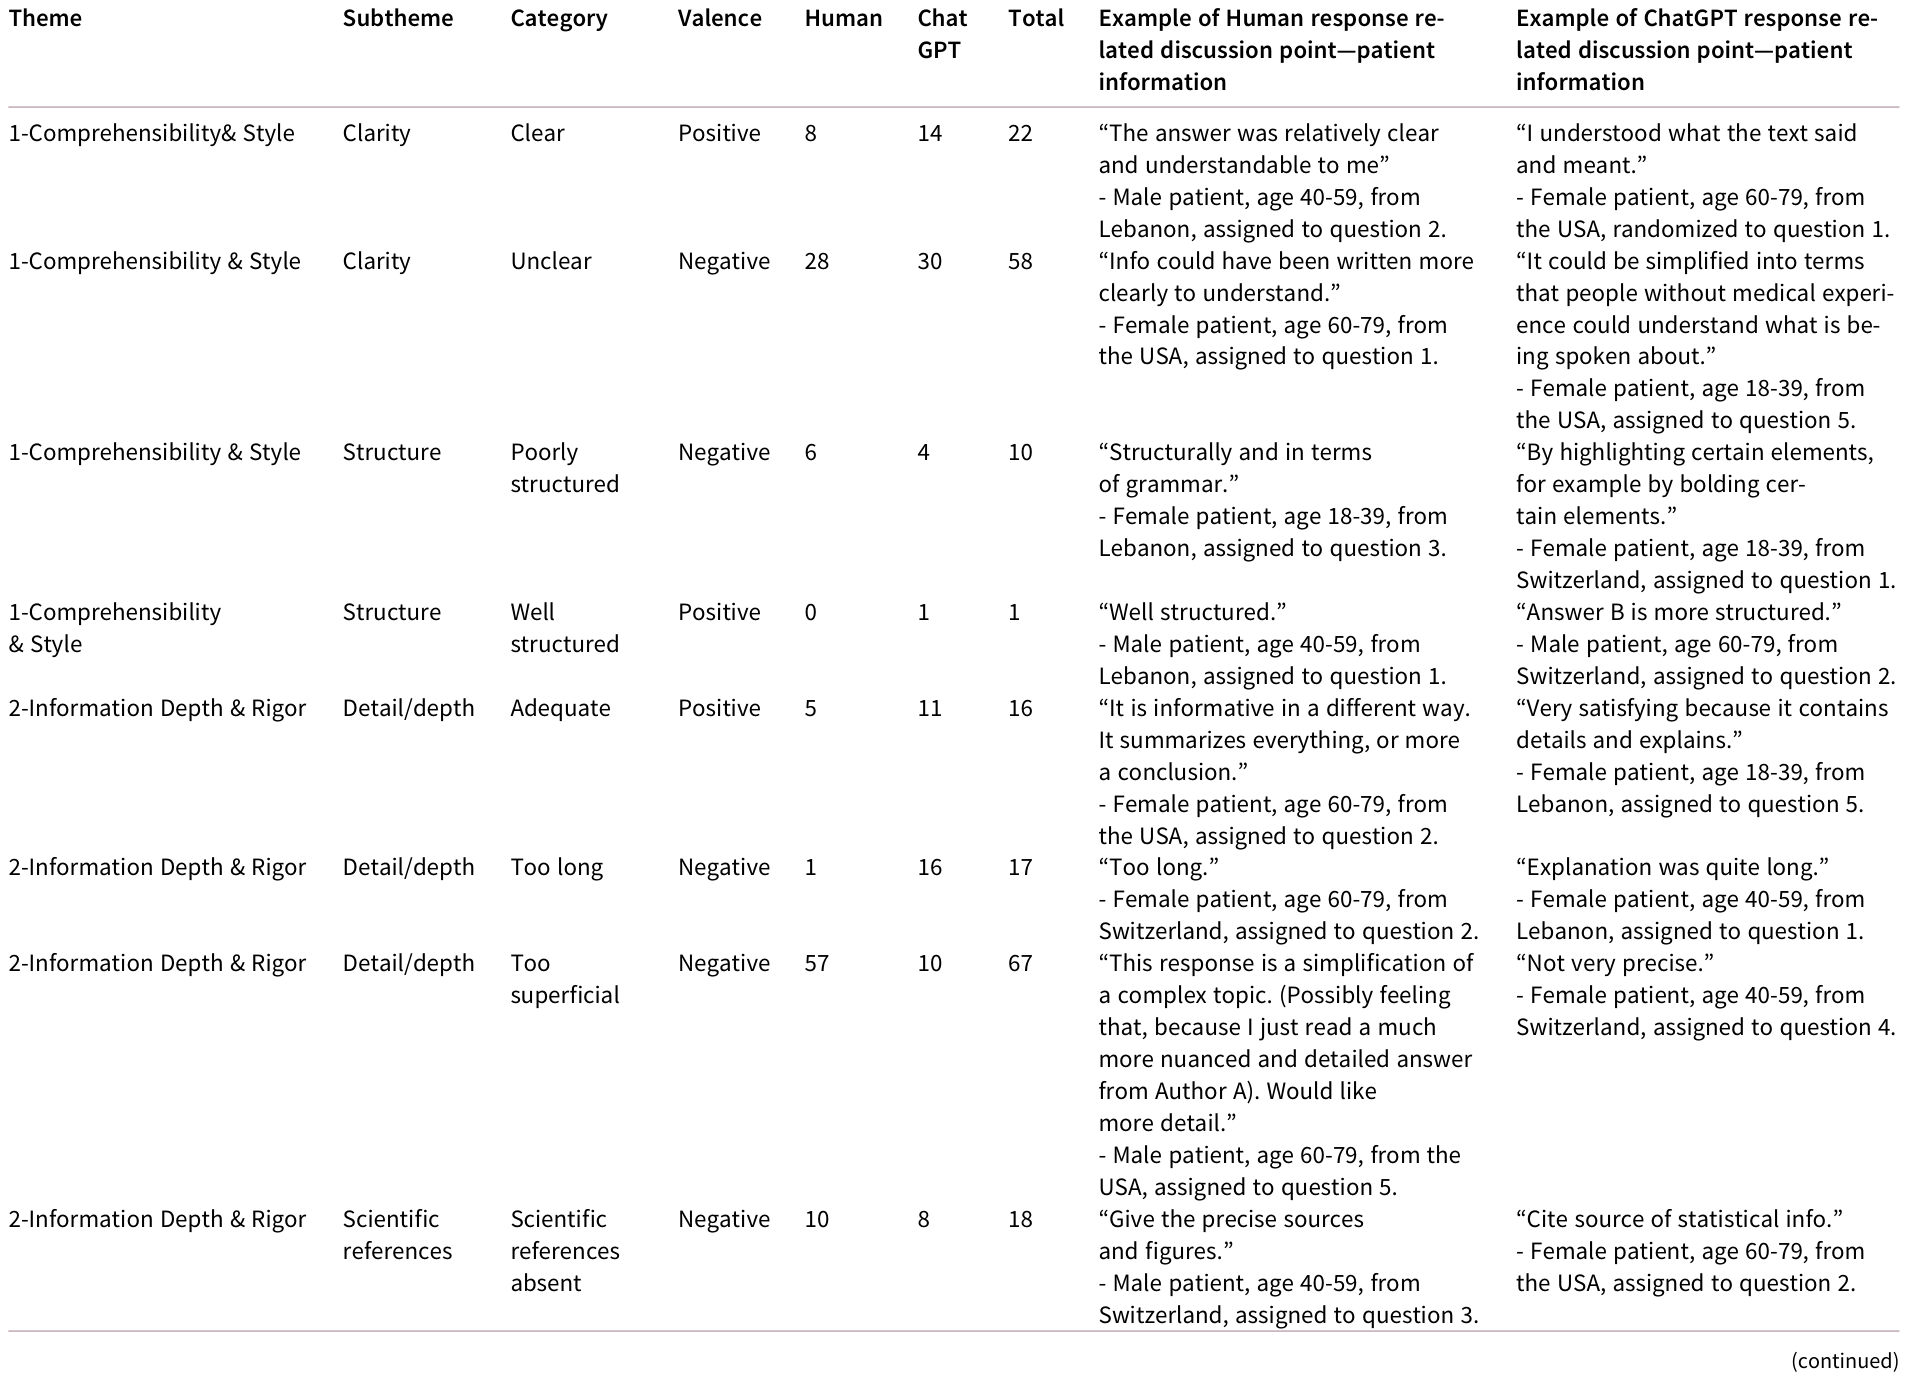
で確認できます。興味深いことに、ChatGPTと人間生成の回答に対する評価の差は質問によって異なりましたが、全体的にChatGPTの優位性が明確でした。この定量的・定性的な評価の統合は
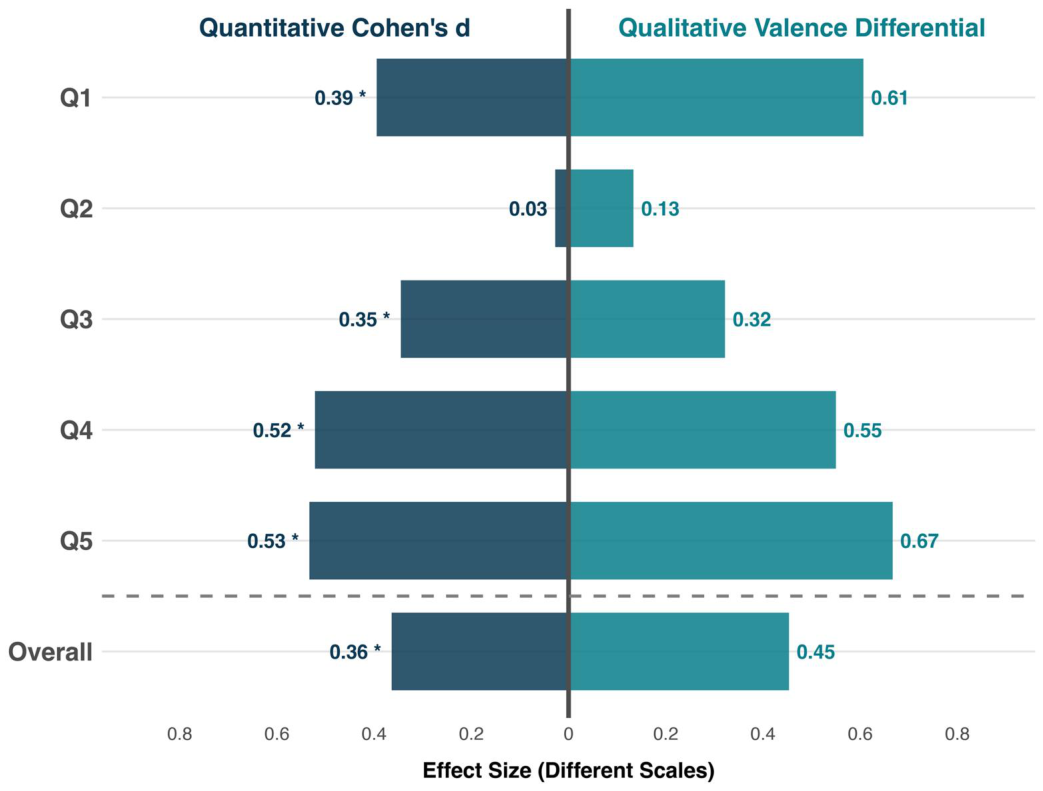
にて確認できます。人口統計学的要因(年齢や性別)は評価に統計的に有意な影響を与えませんでしたが、米国居住の参加者は他の国の参加者よりも全体的に高い評価をする傾向がありました。また、対象者は回答がAIによって生成されたかどうかを明確に識別することはできませんでした。
対象者がChatGPTを好む理由: 明確さ、詳細、そして「人間らしさ」?
自由記述コメントからは、対象者がChatGPTを好む具体的な理由が浮かび上がってきました。人間生成の回答は「表面的すぎる」「詳細に欠ける」といった批判が多く寄せられました。対照的に、ChatGPTの回答は「詳細な説明を提供している」として一貫して高く評価されました。これは、待合室という限られた時間の中で、対象者がより深い情報を求めている可能性を示唆しています。ChatGPTの回答は「長すぎる」という意見も一部ありましたが、それは大きな欠点とは認識されませんでした。特に注目すべきは、ChatGPTの回答がより「安心感がある」「信頼できる」と評価されたことです。研究者らは、ChatGPTの共感的で丁寧な言葉遣いが、この認識に大きく貢献したと推測しています。例えば、人間生成の回答がチャットボットのような共感的スタイルに最も近かったQ2では、ChatGPTとの間に評価の差がほとんど見られませんでした。ただし、両方のタイプの回答に対して、科学的な参考文献が明示されていないことについては、対象者から等しく批判的な意見がありました。これは、情報源の透明性に対する対象者のニーズがあることを示しています。
今後の展望と課題: 対象者中心のAIコミュニケーションへ
専門家による評価と対象者による評価との間に見られた乖離は、対象者中心のコミュニケーションの必要性を強く浮き彫りにしています。本研究の結果は、対象者向けの資料がどのように作成・簡素化されるべきかについての従来の仮説に挑戦するものかもしれません。対象者の45%が大規模言語モデルに以前から親しんでいたこと、そして機関ウェブサイトの資料に対する批判的な意見を考慮すると、検証されていないデータソースや「ハルシネーション(AIが事実ではない情報を生成すること)」、応答の変動性、プライバシーや倫理的な問題といったリスクにもかかわらず、対象者がLLMを医療情報源として利用する傾向が今後ますます高まる可能性があります。本研究の結果は、専門家の監督下で臨床的に検証されたLLMが、放射線リスクコミュニケーションを支援する効果的なツールとなりうることを示唆しています。医療専門家は、このようなモデルの責任ある開発において積極的な役割を果たし、誤報のリスクを軽減するための明確な規制枠組みを確立する必要があります。そして最も重要なのは、対象者を巻き込み、彼らのフィードバックを教育資料の開発に体系的に統合することが不可欠であるということです。これにより、対象者にとって本当に価値のある、明確で信頼性の高い医療情報が提供される未来が築かれるでしょう。
用語集
- AI (Artificial Intelligence): 人間が持つ知能を、コンピューターを使って人工的に再現する技術のこと。
- LLM (Large Language Model): 大規模言語モデル。大量のテキストデータを学習し、人間のような自然な文章を生成したり理解したりできるAIモデル(例: ChatGPT)。
- 放射線リスクコミュニケーション: 放射線被ばくの潜在的な危険性や利益について、対象者に分かりやすく伝えること。
- リッカート尺度: 調査などで意見や態度を測定するために用いられる心理尺度の一種。この研究では7段階で評価を行った。
- 盲検デザイン: 研究の参加者や評価者が、どの介入グループに属するかを知らない状態で行うこと。この研究では、回答がAIと人間どちらによって生成されたかを対象者に伏せた。
- Inverse Normal Transformation (INT): データの分布が正規分布でない場合に、正規分布に近づけるための統計的手法。
- テーマコーディング: 自由記述などの質的データから、共通するパターンや主要な概念(テーマ)を識別し、分類する分析手法。
- Valence Index (ヴァレンスインデックス): 定性的コメントにおけるポジティブな意見とネガティブな意見のバランスを示す指標。
- Cohen’s d (コーエンのd): 2つのグループ間の平均値の差の大きさを標準化した効果量。
コメントを残す