
LLMによるMRIプロトコルの自動選択:診断の質とワークフロー効率を向上させる可能性
解説対象論文: Accuracy and reliability of privacy-compliant large language models for MRI protocol selection in radiological workflows
European Radiology|被引用数: 0(2026年11月9日時点)
MRI検査における適切なプロトコル選択は、診断の質とワークフローの効率性にとって不可欠です。しかし、手動でのプロトコル選択は時間がかかり、専門家によってばらつきが生じる可能性があります。近年進化した大規模言語モデル(LLM)は、この課題を解決し、標準化されたMRIプロトコル選択を支援する可能性を秘めています。このブログ記事では、実際の医療現場からの依頼文に基づき、プライバシーに配慮したオープンウェイトLLMがMRIプロトコル選択においてどの程度の精確性と信頼性を示すかを評価した最新の研究についてご紹介します。
はじめに:MRIプロトコル選択の現状と課題
どうも、Beyond the Pixelです。MRI(磁気共鳴画像)検査は現代の診断において中心的な役割を担っており、その優れた軟部組織コントラストと多様な撮像能力により、疾患の精確な特徴付けを可能にします。しかし、診断性能は適切なプロトコル選択にかかっており、これは特定の解剖学的領域と臨床的疑問に合わせて調整されたパルスシーケンスの組み合わせで構成されます。現在の医療現場では、プロトコル選択は主に手動で行われており、MRI物理学、解剖学、病理学に関するかなりの専門知識が必要です。この複雑なプロセスは時間がかかり、専門家の主観的な判断や施設ごとの基準によって影響を受けることがあり、プロトコル選択のばらつきや画像品質の不整合につながる可能性があります。不完全または不必要に延長された検査は効率を低下させ、診断エラーや遅延を引き起こす可能性もあります。さらに、専門家間のばらつきや施設間の違いは、特に長期および多施設研究における標準化と再現性を妨げます。
大規模言語モデル(LLM)の登場と医療画像分野への応用
近年、人工知能(AI)の進歩により、大規模言語モデル(LLM)が登場しました。LLMは、以前のタスク固有の自然言語処理や従来の機械学習と比較して、微妙なニュアンスを持つ非構造化された臨床依頼文を解釈する一般的な能力に優れています。これにより、ワークフローの自動化に新たな道が開かれ、効率性と標準化の両方を向上させる可能性があります。これまでの研究では、この分野における様々なAIモデルの可能性が示されてきましたが、LLMの急速な進化により、その性能を最新の視点から評価する必要がありました。この研究は、実際の医療現場からの依頼文に基づき、主要なMRIプロトコルの選択と、所定の施設ライブラリからのオプションシーケンスの追加からなるLLMベースのMRIプロトコル化の性能を評価することを目的としました。特に、機密性の高い臨床データを送信することなくローカルに展開できるオープンウェイトモデルに焦点が当てられました。クローズドソースのAPIベースモデルは高い性能を達成する可能性がありますが、データのガバナンスや規制上の制約により、その臨床使用は制限される可能性があります。したがって、この研究はプライバシー保護アプローチを重視しています。
研究デザイン:4つのオープンウェイトLLMを評価
この後ろ向き研究では、2023年8月から2024年7月の間に収集された1201件の連続した依頼文(平均年齢58±14歳; 男性646名)が、変更されていないテキストとして各LLMに提供されました。各LLMは、事前に定義されたリストから施設プロトコルとオプションシーケンスを選択しました。2名の認定放射線科専門家による合意が、精度の評価基準となる「ゴールデンスタンダード」として使用されました。性能は、プロトコルレベルとシーケンスレベルで、プロトコル精度と平均Jaccard指数(ジャカードしすう:2つの集合の類似度を示す指標で、共通部分の大きさを結合部分の大きさで割って算出します)を用いて評価されました。研究デザインの視覚的な概要を
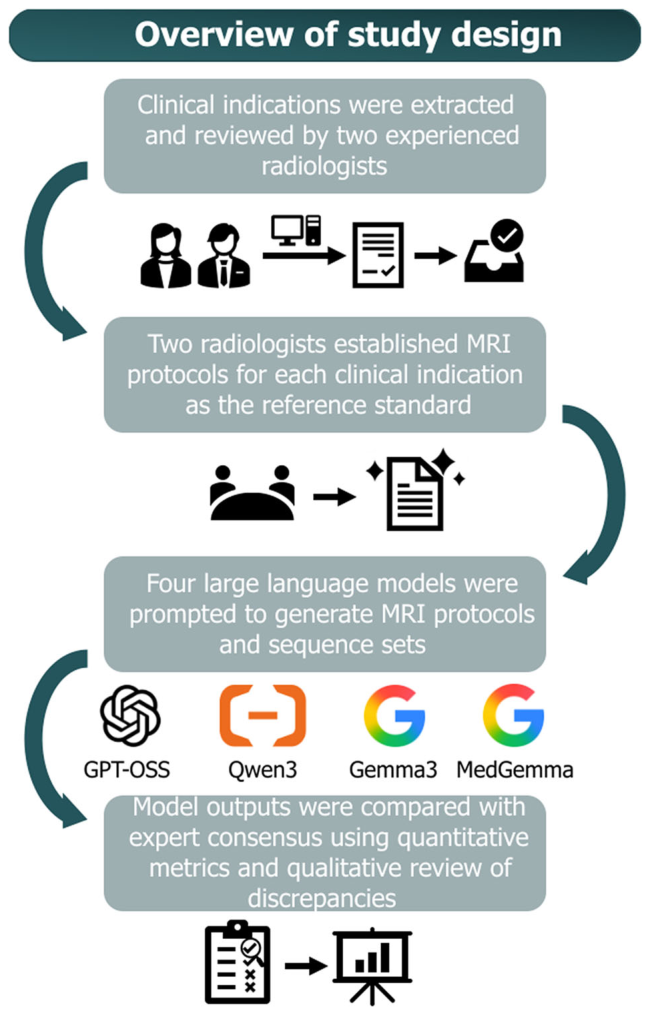
に示します。また、データ取得の流れは
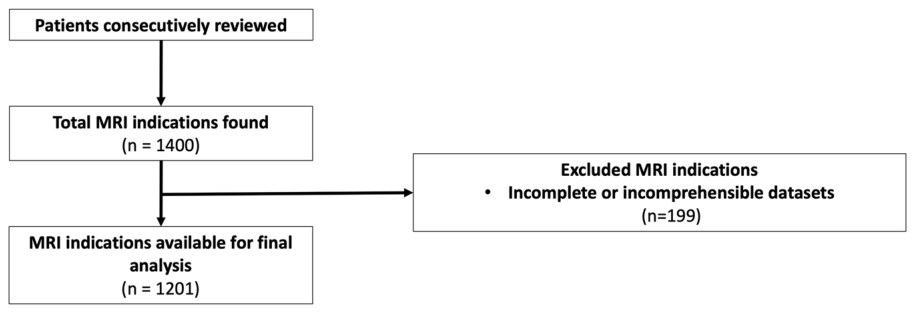
の通りです。評価された4つのオープンウェイトLLMは以下の通りです。GPT-OSS-120B: 一般知識のために訓練された1200億パラメータのモデル。Qwen-3-235B-A22B-Instruct-2507 (Qwen3): 一般知識のために訓練された2350億パラメータのモデル。Gemma-3-27B-IT (Gemma3): 一般知識のために訓練された270億パラメータのモデル。MedGemma-27B-Text-IT (MedGemma): Gemma3を医療分野でファインチューニングしたモデル。これらのモデルは、タスク固有のファインチューニングや追加の量子化なしに、Hugging Faceで公開されているバージョンで評価されました。すべてのモデルは、比較可能性を確保するために、同一のプロンプト、プロトコルリスト、および依頼文入力を受けました。プロンプトは、各LLMに「放射線検査計画の専門家」として行動し、臨床的正確性と時間効率という2つの明示的な基準に基づいて最適な、最も時間効率の良いMRIプロトコルを選択するよう指示しました。
研究結果:LLMは高い一致度を示すも、専門家の監視は不可欠
この研究では、大規模な汎用モデルが専門家によるプロトコル選択と最も高い一致度を達成しました。GPT-OSS-120BはJaccard指数0.96(95%信頼区間: 0.96–0.97)、精度0.94(0.93–0.95)を達成し、Qwen-3-235B-A22B-Instruct-2507もJaccard指数0.96(0.95–0.97)、精度0.94(0.93–0.96)という同等の強力な結果を示しました。これらは、MedGemma-27B-Text-IT(Jaccard指数0.85、精度0.79)やGemma-3-27B-IT(Jaccard指数0.61、精度0.58)を上回る性能でした。
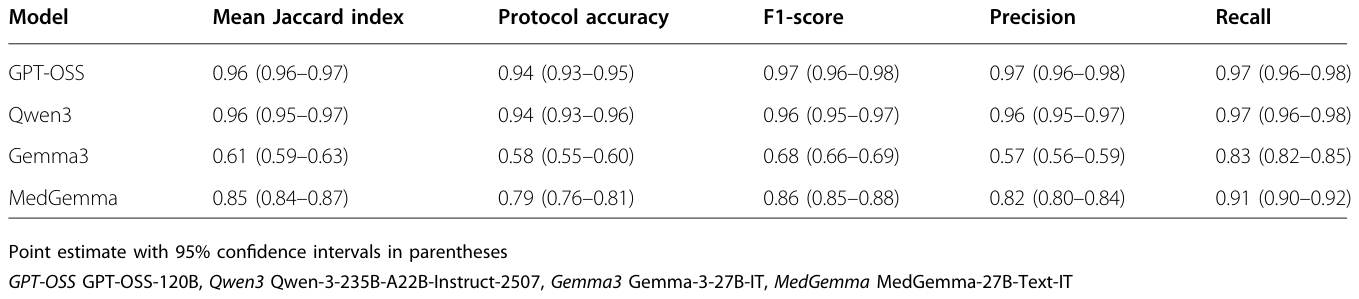
にLLMの性能指標の概要が示されています。プロトコル選択の「許容できない」ケースは、GPT-OSSで1201件中70件(5.8%)、Qwen3で71件(5.9%)と低かった一方、MedGemmaでは297件(24.7%)、Gemma3では820件(68.3%)と大きくばらつきがありました。これは
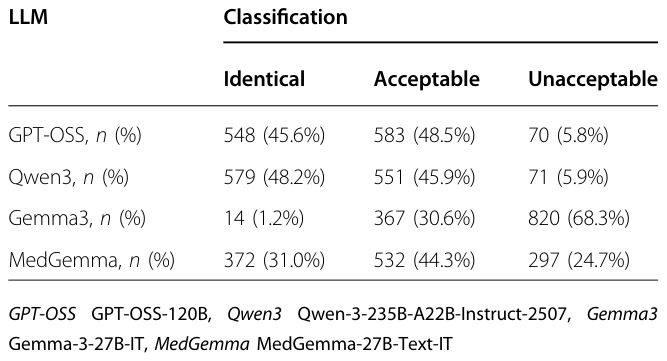
と
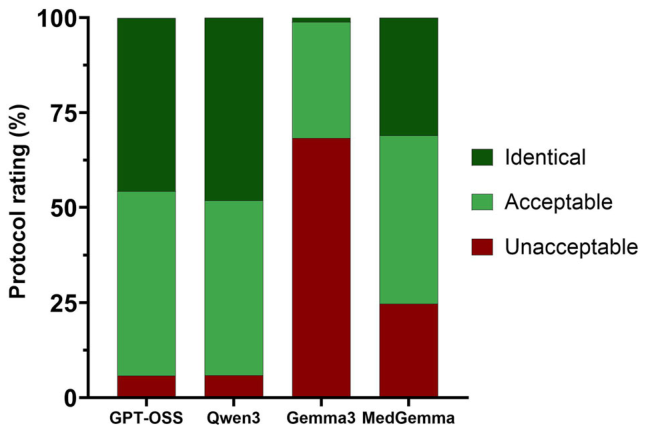
で確認できます。許容できないケースの中で最も一般的なエラーは、「解剖学的には正しいが臨床的に最適ではないプロトコル選択」(57.7–70.7%)であり、次いで「解剖学的領域の誤り」(11.6–39.4%)、「オプションシーケンスのみのエラー」(2.8–30.2%)でした。
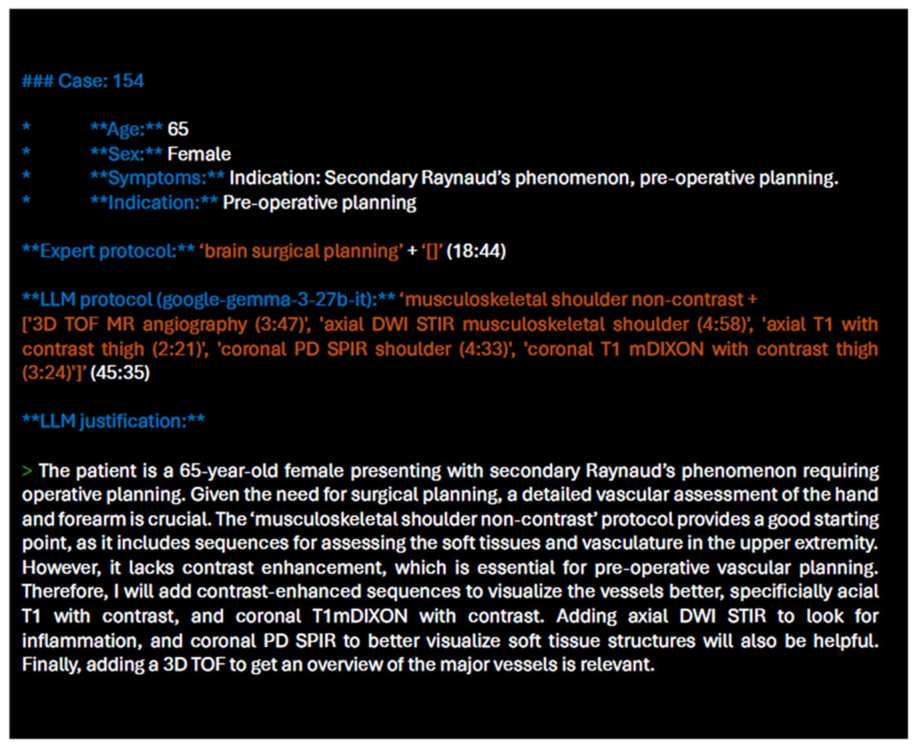
は、専門家が「許容できない」と判断したプロトコルとシーケンス選択の例です。GPT-OSSは専門家のスキャン時間と統計的に有意な差はありませんでしたが(p = 0.18)、Qwen3は専門家よりも短く(p = 0.002)、Gemma3とMedGemmaは専門家よりも長くなりました(両方ともp < 0.001)。これらのプロトコル長に関する結果は
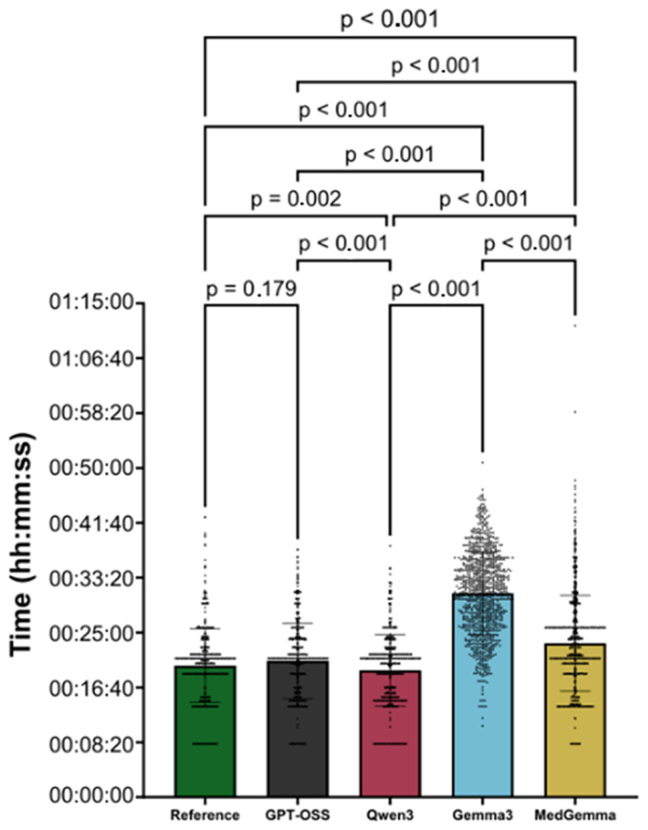
に示されています。モデル間の比較では、GPT-OSSとQwen3の間には統計的に有意な差はありませんでしたが(p = 0.20)、その他のすべての比較では有意な差が認められました(すべてp < 0.001)。これは
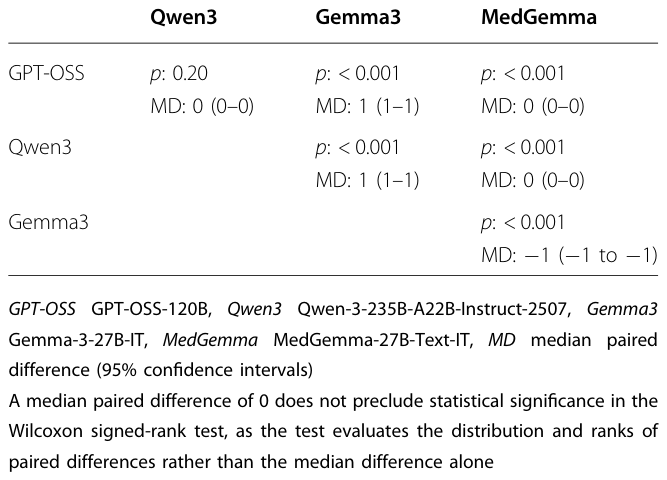
にまとめられています。
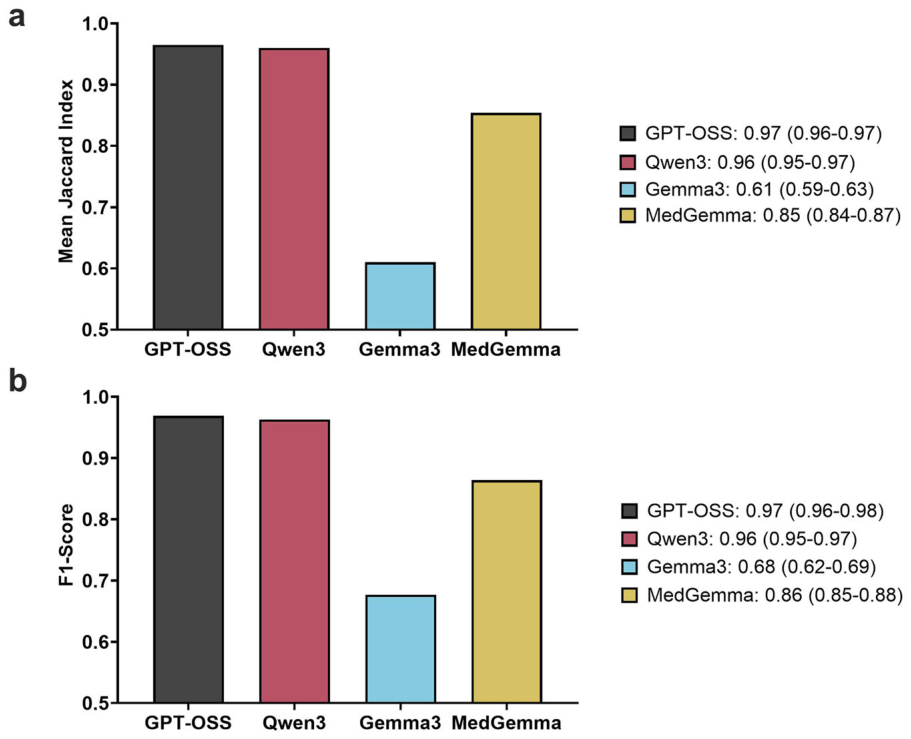
では、平均Jaccard指数とF1スコアを用いたLLMの性能比較が視覚的に示されています。
考察と今後の展望:標準化と効率化、そして専門家の役割
この研究は、現代のオープンウェイトLLMがMRIプロトコル選択において、専門家による評価と高い一致度を示すことを明らかにしました。特にGPT-OSSはJaccard指数0.96、F1スコア0.97を達成しており、構造化された診断状況においてLLMが高い信頼性で専門家の評価と一致できることを示唆しています。これらの結果は、LLMが画像取得の標準化を支援し、専門家間のばらつきを減らし、再現性のある研究に貢献する可能性を秘めていることを示しています。また、管理上の負担を軽減し、専門家がより複雑な解釈やコンサルテーションに集中できるようになることも期待されます。しかし、モデルに依存して「許容できない」プロトコルがかなりの割合で発生しており、LLMが非典型的または曖昧な臨床シナリオで失敗する可能性があることを示しています。最も一般的なエラーは、解剖学的には正しいものの、臨床的に最適ではないプロトコル選択でした。これは、単に解剖学的な場所が間違っているエラーだけでなく、疾患に特化したプロトコル選択においても専門家の監視が必要であることを強調しています。特にGPT-OSSとQwen3のような高性能モデルでは、まれな専門的適応症や曖昧な依頼が、許容できない選択肢に不釣り合いに多く寄与しました。この研究の限界として、データセットが単一の施設から取得されたものであり、異なる言語的および手続き的基準を持つ他の施設への一般化が制限される可能性があります。また、ゴールデンスタンダードは地元の専門家間の合意によって確立されたものであり、施設固有の臨床実践を反映しているため、許容される専門家のばらつきの全範囲を捉えていない可能性があります。さらに、不完全または理解不能な臨床情報を持つ199件の依頼文(14.2%)が解析から除外されましたが、これはより明確で構造化されたケースに選択バイアスを導入し、モデル性能を過大評価する可能性があったという点は、今後の研究で対処すべき課題です。結論として、現代のオープンLLMはMRIプロトコルおよびシーケンス選択において専門家と高い一致度を示し、特に大規模な汎用モデルが最良の性能を発揮しました。これらの結果は、LLM支援によるプロトコル化が、非構造化された臨床テキストから信頼性の高いプロトコル化を可能にし、ワークフローの標準化とばらつきの削減に貢献する可能性を支持します。それでもなお、モデル固有の差異、時折発生するエラー、および施設固有のプロンプトへの依存は、継続的な専門家の監視と現地での検証の必要性を強調しています。将来の研究では、安全性、再現性、および臨床統合をさらに改善するために、多施設データ、将来的なワークフロー評価、およびターゲットを絞った医療ファインチューニングを含めるべきでしょう。
用語集
- LLM (大規模言語モデル): 大量のテキストデータから人間のような言語を理解し生成する能力を持つAIモデル。
- MRIプロトコル: MRI検査で特定の解剖学的部位や臨床的な疑問に応じて使用する撮像シーケンスの組み合わせ。
- オープンウェイトモデル: モデルの内部構造(重み)が公開されており、プライバシー保護の観点からローカル環境での利用が可能なAIモデル。
- Jaccard指数: 2つの集合の類似度を測る指標で、共通部分の大きさを結合部分の大きさで割って算出します。
- プロトコル精度: LLMが選択した主要プロトコルが専門家の合意と完全に一致したケースの割合。
- F1スコア: 精密さと再現性の調和平均で、分類モデルの性能評価に用いられる指標。
- シーケンス: MRIプロトコルを構成する個々の撮像方法やパルス系列。
- ゴールデンスタンダード: 比較の基準となる最も信頼できる標準。
コメントを残す