
地域ホスト型AIで医療画像診断報告書を分かりやすく:データプライバシーと安全性を両立する可能性
解説対象論文: Generating patient-friendly radiology reports with a local large language model: expert evaluation of quality and readability
European Radiology|被引用数: 0(2026年10月31日時点)
医療画像診断報告書は、専門家間の正確な情報共有を目的としており、その複雑さから対象者にとって理解が難しいという課題があります。大規模言語モデル(LLM)は、これらの報告書を対象者向けに分かりやすく翻訳する可能性を秘めていますが、クラウドベースのLLMはデータプライバシーの懸念があります。この研究は、地域でホストされたLLMを用いてオランダ語の放射線診断報告書を対象者向けに翻訳する実現可能性を評価し、その品質、網羅性、可読性、および幻覚(誤情報)の発生について専門家が検証しました。結果として、特に報告書の結論セクションにおいて高い翻訳品質が示された一方で、臨床的に関連する幻覚の発生が課題として浮上しました。
はじめに:難解な医療報告書とAIの可能性
どうも、Beyond the Pixelです。医療の世界では、専門家と対象者間のコミュニケーションが非常に重要です。特に、放射線診断報告書は、専門家間で正確な情報を共有するために書かれており、複雑な医学用語や略語が多用されています。そのため、対象者が自身の検査結果を理解するのが難しいという課題がありました。この理解の障壁は、対象者の不安を増大させたり、不適切な情報探索につながったり、さらには専門家への追加的な問い合わせによって業務負担を増やす原因にもなっています。{{FIGURE_GRAPHICAL_ABSTRACT}}このような課題に対し、人工知能(AI)、特に大規模言語モデル(LLM)は、標準的な医療情報を対象者にとって分かりやすい形式に自動変換する大きな可能性を秘めています。しかし、これまでの研究は主に英語の報告書に限定されており、また、多くのLLMがクラウドベースであるため、機密性の高い医療データのプライバシーとセキュリティに関する懸念がありました。今回ご紹介する研究は、これらの課題に対処するため、地域ホスト型LLMを用いてオランダ語のX線および超音波診断報告書を対象者向けに翻訳する実現可能性を評価しました。データプライバシーを保護しつつ、その品質、網羅性、可読性、および「幻覚(hallucinations)」と呼ばれる誤情報の発生について、専門家が詳細に評価しました。
研究方法:地域ホスト型LLM「Gemma-3」の活用
この研究では、オランダのプライマリケアで頻繁に依頼される胸部、膝、腰椎、肩のX線、および肩と腹部の超音波検査報告書から、合計360件をレトロスペクティブに収集しました。これらの報告書の主要な記述部分(n=359)と結論部分(n=350)を、地域でホストされた大規模言語モデル「Gemma-3」(120億パラメータ)を用いて対象者向けに翻訳しました。クラウドへのデータ転送を避けることで、データプライバシーを確保しています。翻訳された報告書は、正確性(技術的な正しさ)と網羅性(情報の保存)を5段階のリッカート尺度で評価しました。可読性は、テキストの長さとフレッシュ-ドゥーマ読解容易性(FDRE)スコアを用いて評価されました。特に重要な点として、LLMが生成した誤った、または文脈に合わない情報である「幻覚」も系統的に文書化されました。統計分析には、クルスカル・ウォリス検定、ウィルコクソン符号順位検定、対応のあるt検定が用いられました。
研究結果:結論セクションの翻訳がより高品質
この研究の主要な発見は、対象者向けの報告書の品質、特に結論セクションにおいて、高い性能が示されたことです。
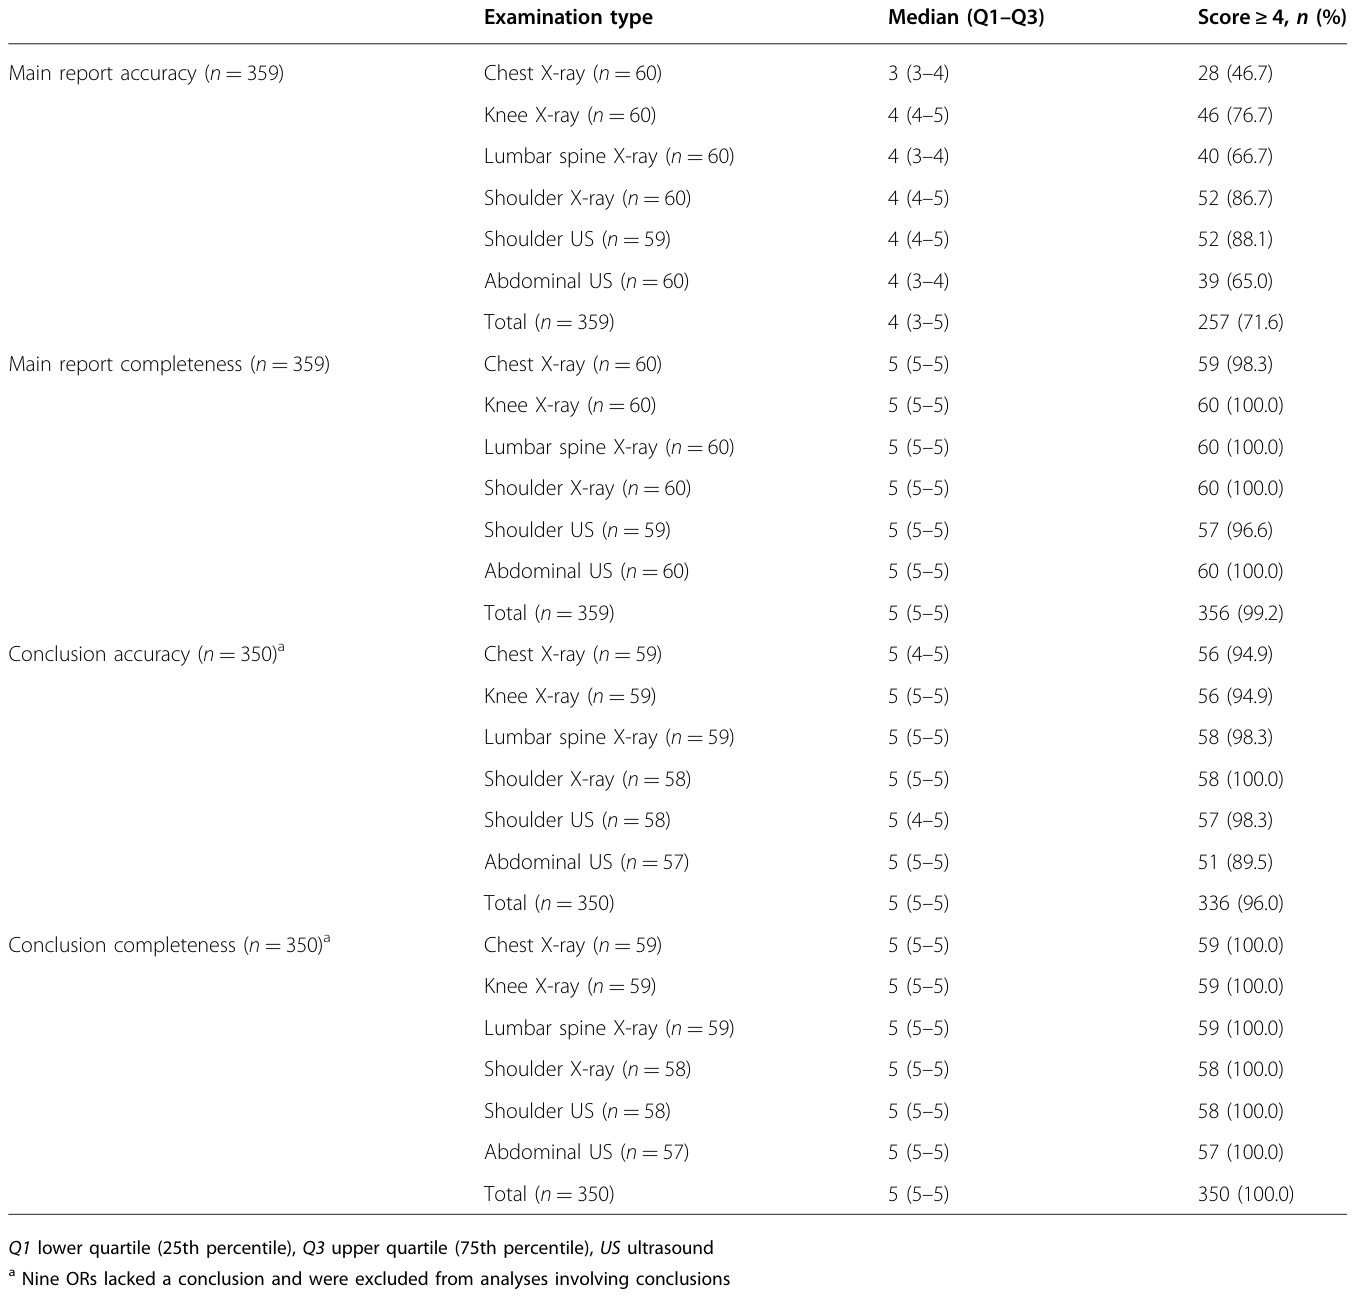
表1に示されているように、対象者向けに翻訳された結論セクションは、主要な記述部分よりも高い中央値の正確性スコア(5点満点中5点対4点)を達成しました。また、網羅性スコアは両セクションで非常に高く、ほとんどの重要な情報が保持されていることが示されました。全体として、主要な記述部分の71.0%と結論セクションの96.0%が、事前に定義された品質基準(正確性と網羅性が4以上)を満たしました。しかし、地域ホスト型LLMで生成された対象者向け報告書は、元の報告書と比較して平均65語長くなり、可読性を示すFDREスコアは平均54.2ポイント上昇しました。
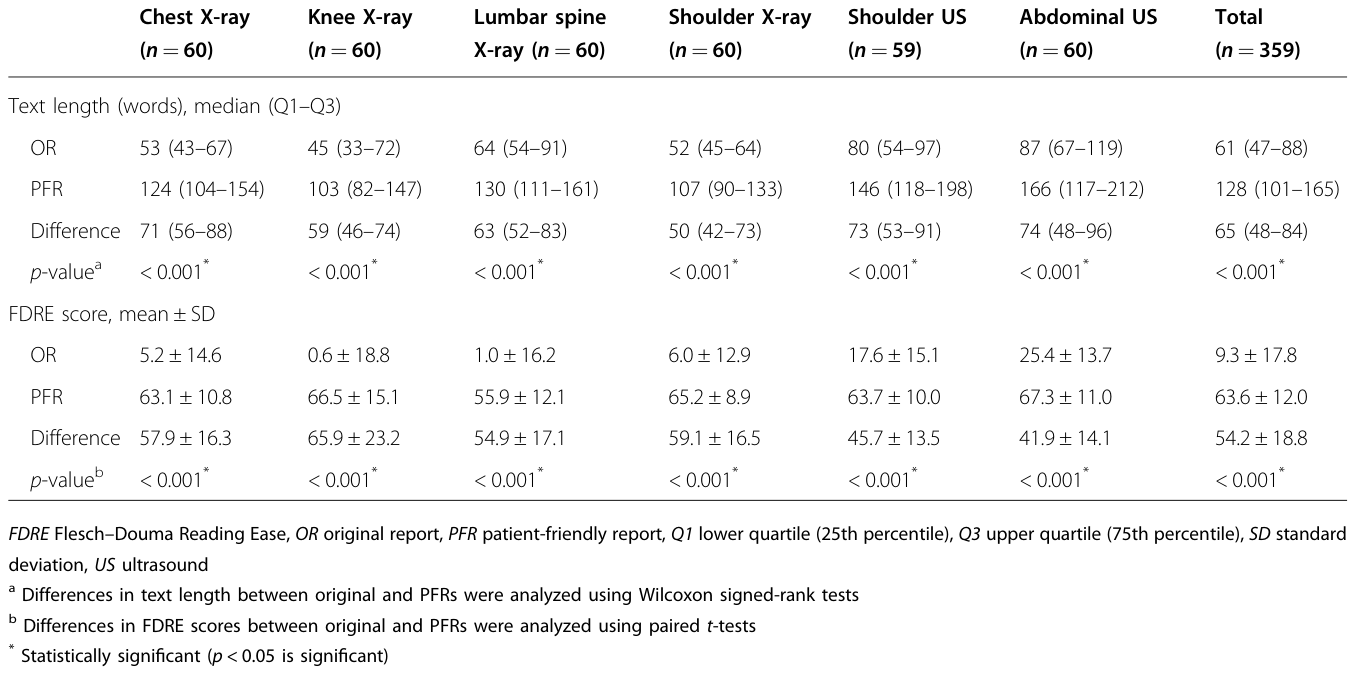
表2は、元の報告書と対象者向け報告書のテキストの長さとFDREスコアの比較を示しており、すべての検査タイプで対象者向け報告書が有意に長く、FDREスコアが高い(可読性が高い)ことがわかります。品質と可読性の両基準(FDREスコアが60を超えること)を満たした報告書は、主要な記述部分と結論セクションを合わせた全体の48.0%でした。
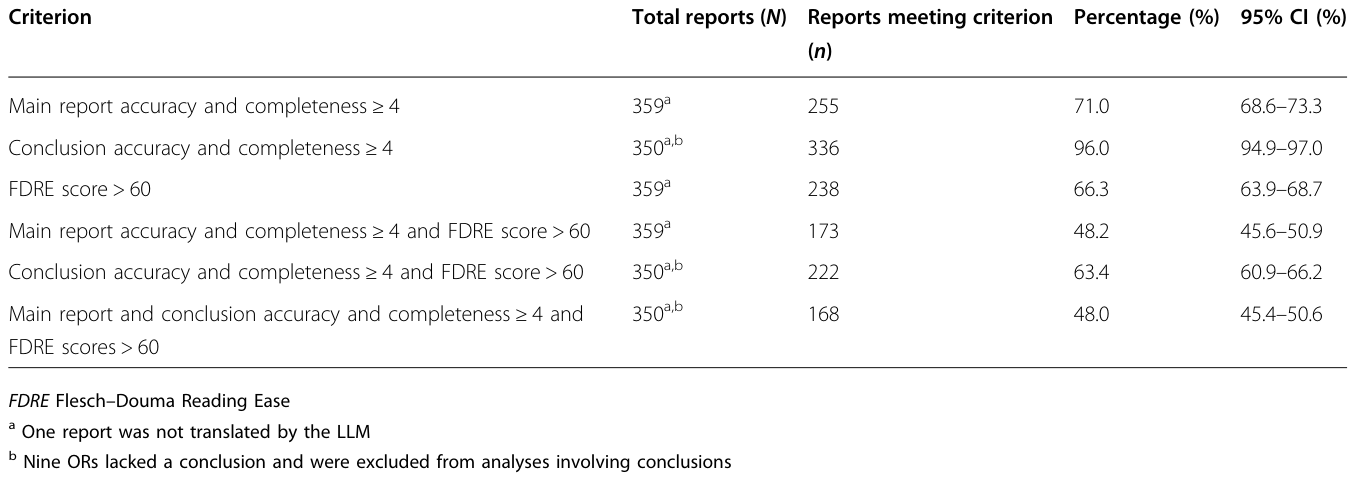
表3は、品質基準と可読性基準を満たした報告書の割合を示しており、結論セクションが単独で評価された場合に96.0%が品質基準を満たし、63.4%が品質と可読性の両方を満たしていることが際立っています。これは、結論セクションの翻訳が最も有望な初期応用である可能性を示唆しています。しかし、重要な懸念事項として、臨床的に関連性のある幻覚が45件の報告書(12.5%)で発生しました。
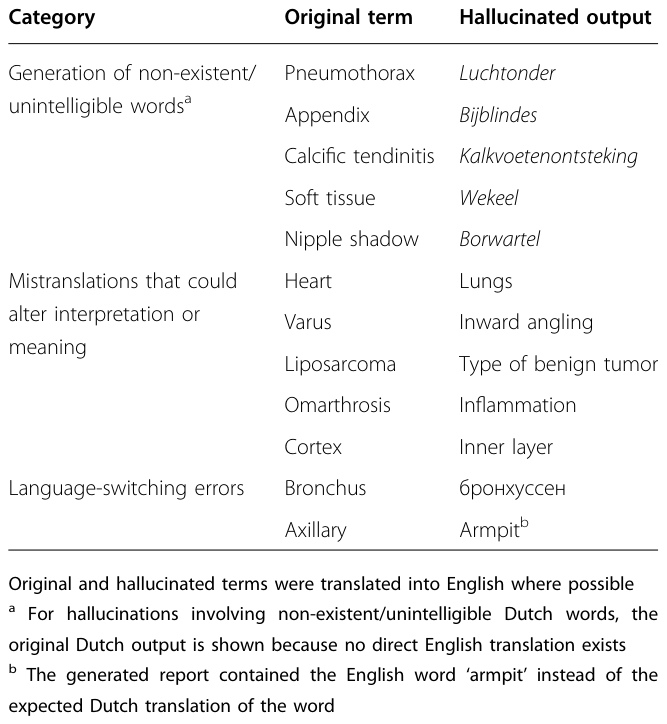
表4は、Gemma-3によって生成された臨床的に関連する幻覚の例を示しており、存在しない単語の生成や解釈を変更する誤訳、言語切り替えのエラーなどが含まれています。これらの幻覚は、LLMの臨床導入前にさらなる評価と専門家の監視が必要であることを強く示唆しています。
考察と今後の展望:安全なAI導入への道のり
今回の研究で、地域ホスト型LLMが対象者のプライバシーを保護しつつ、放射線診断報告書を対象者向けに翻訳する実現可能性が示されました。特に、結論セクションは高い品質スコアを達成し、臨床的に関連する幻覚の発生も主要な記述部分より少なかったことから、対象者向け応用にとって最も有望な初期ターゲットであると考えられます。結論は通常、より簡潔で診断に焦点を当てており、言語的に標準化されているため、モデルがより正確に処理できた可能性があります。一方で、主要な記述部分はより詳細な記述と複雑な専門用語を含むため、翻訳エラーや情報歪曲のリスクが高まります。対象者向け報告書が元の報告書よりも長くなったのは、医学用語の明示的な説明や複雑な概念の明確化を促すプロンプト戦略によるものです。これは可読性を向上させますが、対象者の読解時間と認知負荷を増大させる可能性も指摘されており、分かりやすさと簡潔さのバランスが重要です。可読性スコアの向上は言語的な読みやすさを示すものであり、対象者の理解度そのものを直接評価するものではない点には注意が必要です。用語や文脈化が理解度、重症度の認識、意思決定に影響を与えるため、今後は対象者による直接的な評価が不可欠です。この研究の重要な限界は、単一のLLM(Gemma-3)のみを評価した点です。モデルの選択は厳密なベンチマークに基づいたものではないため、他の地域展開可能なモデルと比較してGemma-3が優れているという証拠ではありません。また、評価者の間での信頼性(inter-rater reliability)が中程度から低かったことも、スコアの精度を限定する可能性があります。ただし、スコアの変動性が低かったことが原因である可能性も示唆されています。さらに、この研究では自由記述形式の報告書のみを使用しており、より構造化された報告形式でのモデル性能は異なるかもしれません。最も重要な点は、幻覚、特に臨床的に関連する幻覚の発生です。これは対象者向けコンテンツにおいて深刻な安全上の懸念であり、診断情報の誤解釈につながる可能性があります。現在の性能レベルでは、厳格な検証と専門家による監視が、生成されたコンテンツの臨床的正確性と完全性を確保するために不可欠です。結論として、地域ホスト型LLMは対象者向け放射線診断報告書翻訳の可能性を示し、特に結論セクションは有望な出発点となるでしょう。しかし、臨床実装に先立ち、モデルのさらなる改善、専門家による継続的な検証と監視、そして対象者中心の評価が不可欠です。
まとめ
この研究は、地域ホスト型LLMがデータプライバシーを維持しつつ、放射線診断報告書を対象者向けに翻訳する実現可能性を示しました。特に、結論セクションはより高い品質と低い幻覚発生率を示し、対象者向けアプリケーションの最も有望な初期ターゲットとなることが示唆されました。しかし、臨床的に関連する幻覚は重要な安全上の懸念であり、臨床実装前の継続的な検証と専門家による監視が必要であることを明確にしています。今後、対象者の理解度、満足度、および有用性の認識が向上するかどうかを判断するために、さらなる対象者中心の研究が求められます。プライバシーを保護しつつ、AIの力を活用して医療コミュニケーションを改善する道のりは、まだ始まったばかりです。
用語集
- LLM(大規模言語モデル): 大量のテキストデータで訓練され、人間のような文章を生成したり、複雑な言語を簡素化したりできるAIアプリケーションです。
- リッカート尺度: 回答者の意見や態度を「強くそう思う」から「全くそう思わない」までのように、段階的な選択肢で評価する心理測定尺度です。
- フレッシュ-ドゥーマ読解容易性(FDRE)スコア: テキストの可読性(読みやすさ)を測る指標の一つで、文の長さや単語の音節数などに基づいて計算されます。数値が高いほど読みやすいとされます。
- 幻覚(Hallucinations): AIモデルが生成する、事実と異なる、文脈に合わない、または誤解を招くような誤情報のことを指します。
- プライマリケア: 地域で身近に受けられる初期の医療サービスで、専門家(例:一般開業医)が総合的な健康管理を行います。
- Q1–Q3(四分位範囲): データセットを4等分した際の、下位25%点(Q1)から上位25%点(Q3)までの範囲で、データのばらつきを示します。
- ウィルコクソン符号順位検定: 対応のある2つのグループ間の中央値の差を比較するノンパラメトリック検定です。
- クルスカル・ウォリス検定: 3つ以上の独立したグループ間の中央値の差を比較するノンパラメトリック検定です。
- 対応のあるt検定: 同じ対象者から得られた2つの測定値(例:介入前と後)の平均値の差を比較する統計検定です。
- 分散分析(ANOVA): 3つ以上のグループの平均値を比較し、それらの間に統計的に有意な差があるかを評価する統計手法です。
コメントを残す